要把一个开放权重模型打磨成在你的任务上表现出色的模型,需要一系列经过精确衡量的实验。团队需要了解模型将在什么数据上训练,跟踪每次运行的进展,调整训练方案,并找出表现最好的检查点。
今天,我们围绕这一整套工作流扩展了 Together Fine-Tuning。本次发布增加了对最新开放权重模型的支持、实时实验跟踪、对训练和数据处理更精细的控制,以及部分模型的降价。
你还可以在训练前检查并验证数据集,在运行过程中对比各次运行,并在验证损失趋于平稳时停止。
新增模型
新的开放权重模型正以前所未有的速度涌现,几乎每次发布都在质量、效率或两者上抬高了门槛。团队希望尽快把这些进步带入生产,而不必花上数周去应对每种新架构的技术难题。
对于需要前沿性能的任务,你可以选用 GLM-5.3 和 Kimi K2.7 等最大、最强的模型。例如,GLM-5.3 在 Terminal-Bench 2.1 上得分 88.2,与领先的闭源模型相差不到一分。另一些团队更看重性能与成本,会选择 Qwen 3.8-27B 或 Gemma 4 等模型。对于本地和端侧应用,Qwen 3.5 系列提供了从 0.8B 到 9B 参数的多种选择。
Together Fine-Tuning 支持所有这些不同规模的模型,并内置了系统和算法层面的领先优化。提交一个训练任务,针对特定架构的复杂性由我们在幕后处理。最新新增的模型包括:
- GLM 5.3
- GLM-5.2
- GLM-5.1
- DeepSeek-V4-Flash-0731
- DeepSeek-V4-Flash
- Kimi K2.7-Code
- Kimi K2.6
- Qwen 3.8-27B
- Qwen 3.6-35B-A3B
- Qwen 3.6-27B
- Qwen 3.5-27B
- Qwen 3.5-9B
- Qwen 3.5-4B
- Qwen 3.5-2B
- Qwen 3.5-0.8B
- Gemma 4-31B
- Gemma 4-26B-A4B
实验跟踪
越早看到一次运行的走势,就能越早做出下一个决定:调整数据、修改超参数,或是让它跑完。微调任务现在会在每个训练和评估步骤记录指标,并通过 Together API、CLI 和 UI 仪表盘直接提供。指标、任务状态和产物都集中在一处,因此在整个模型开发过程中你都可以留在同一个平台上。
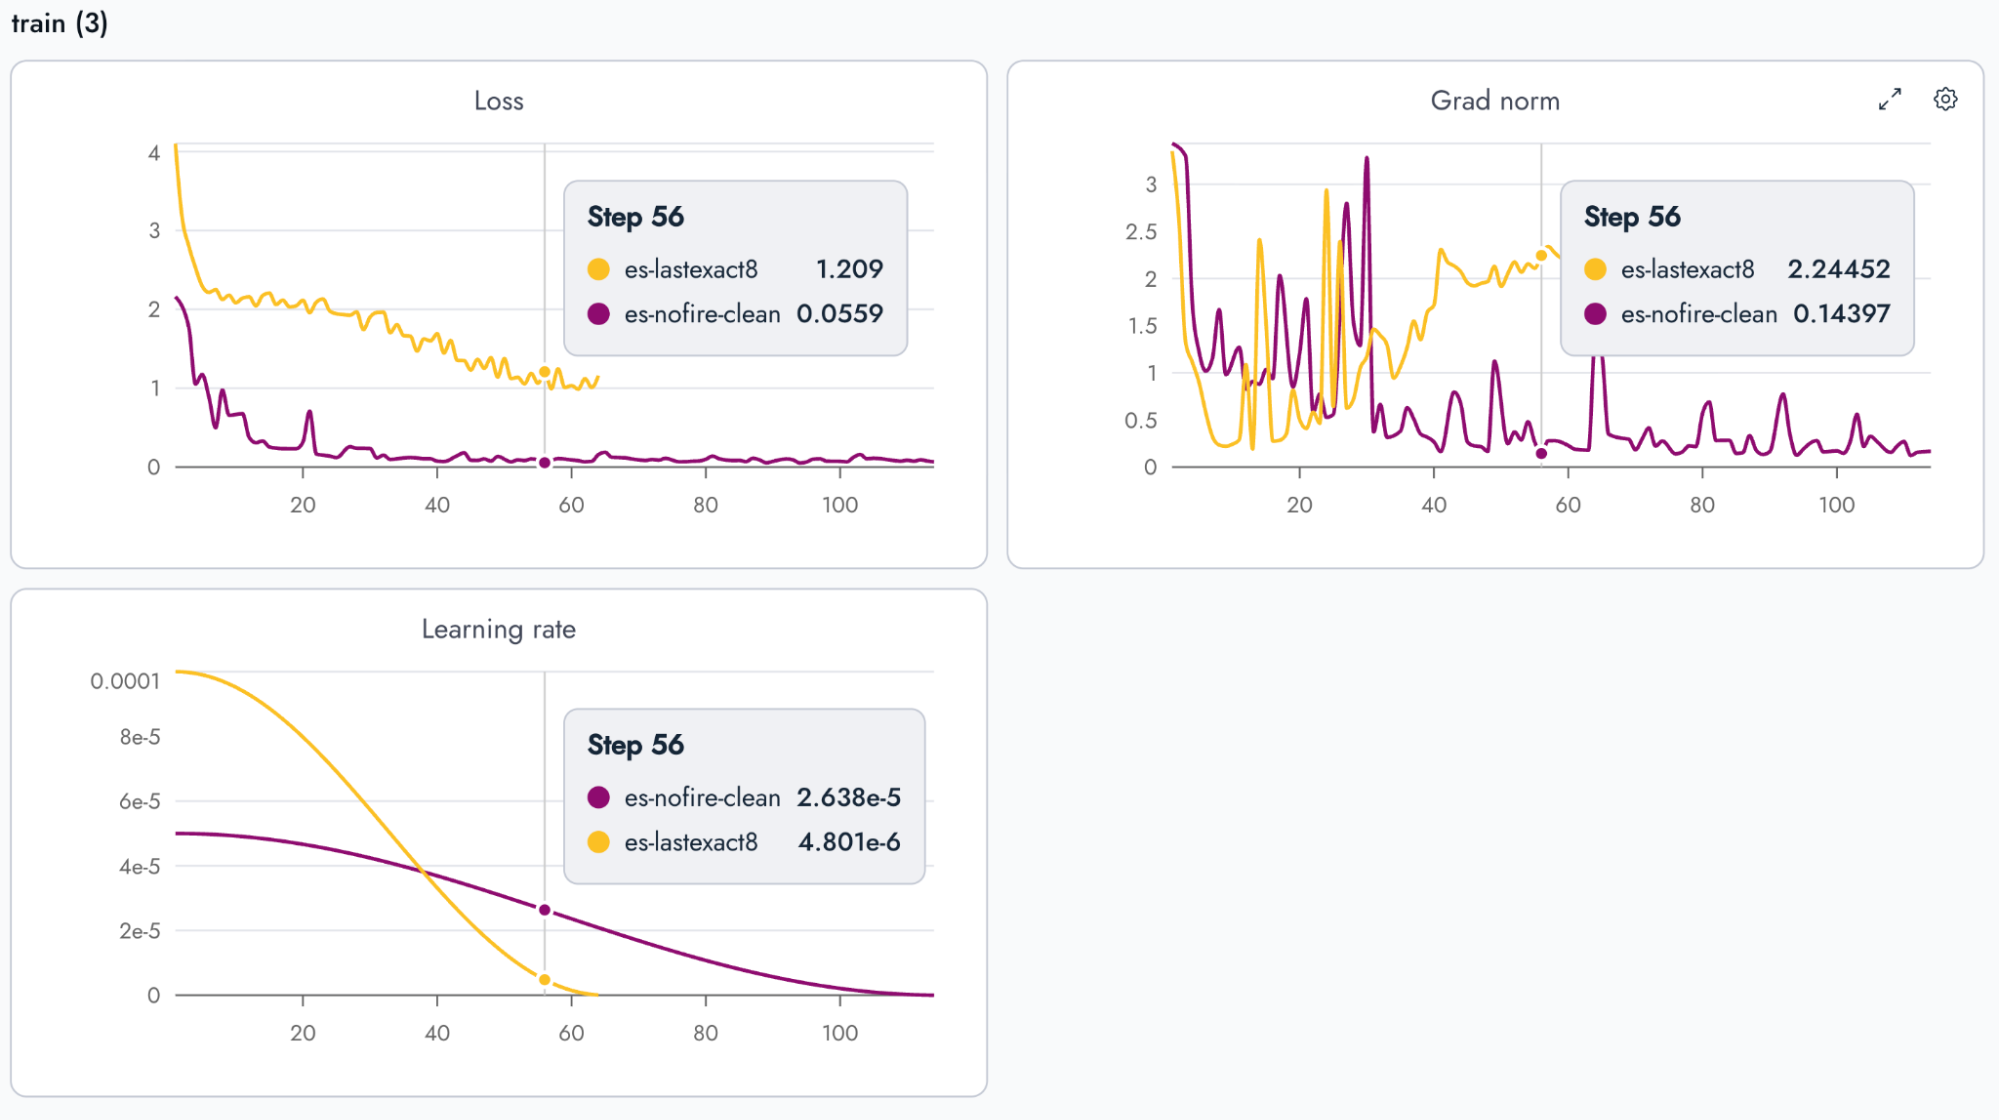
每次运行都会记录核心训练信号:损失、梯度范数、学习率。添加验证集后,评估损失和指标也会与训练指标一起被跟踪。
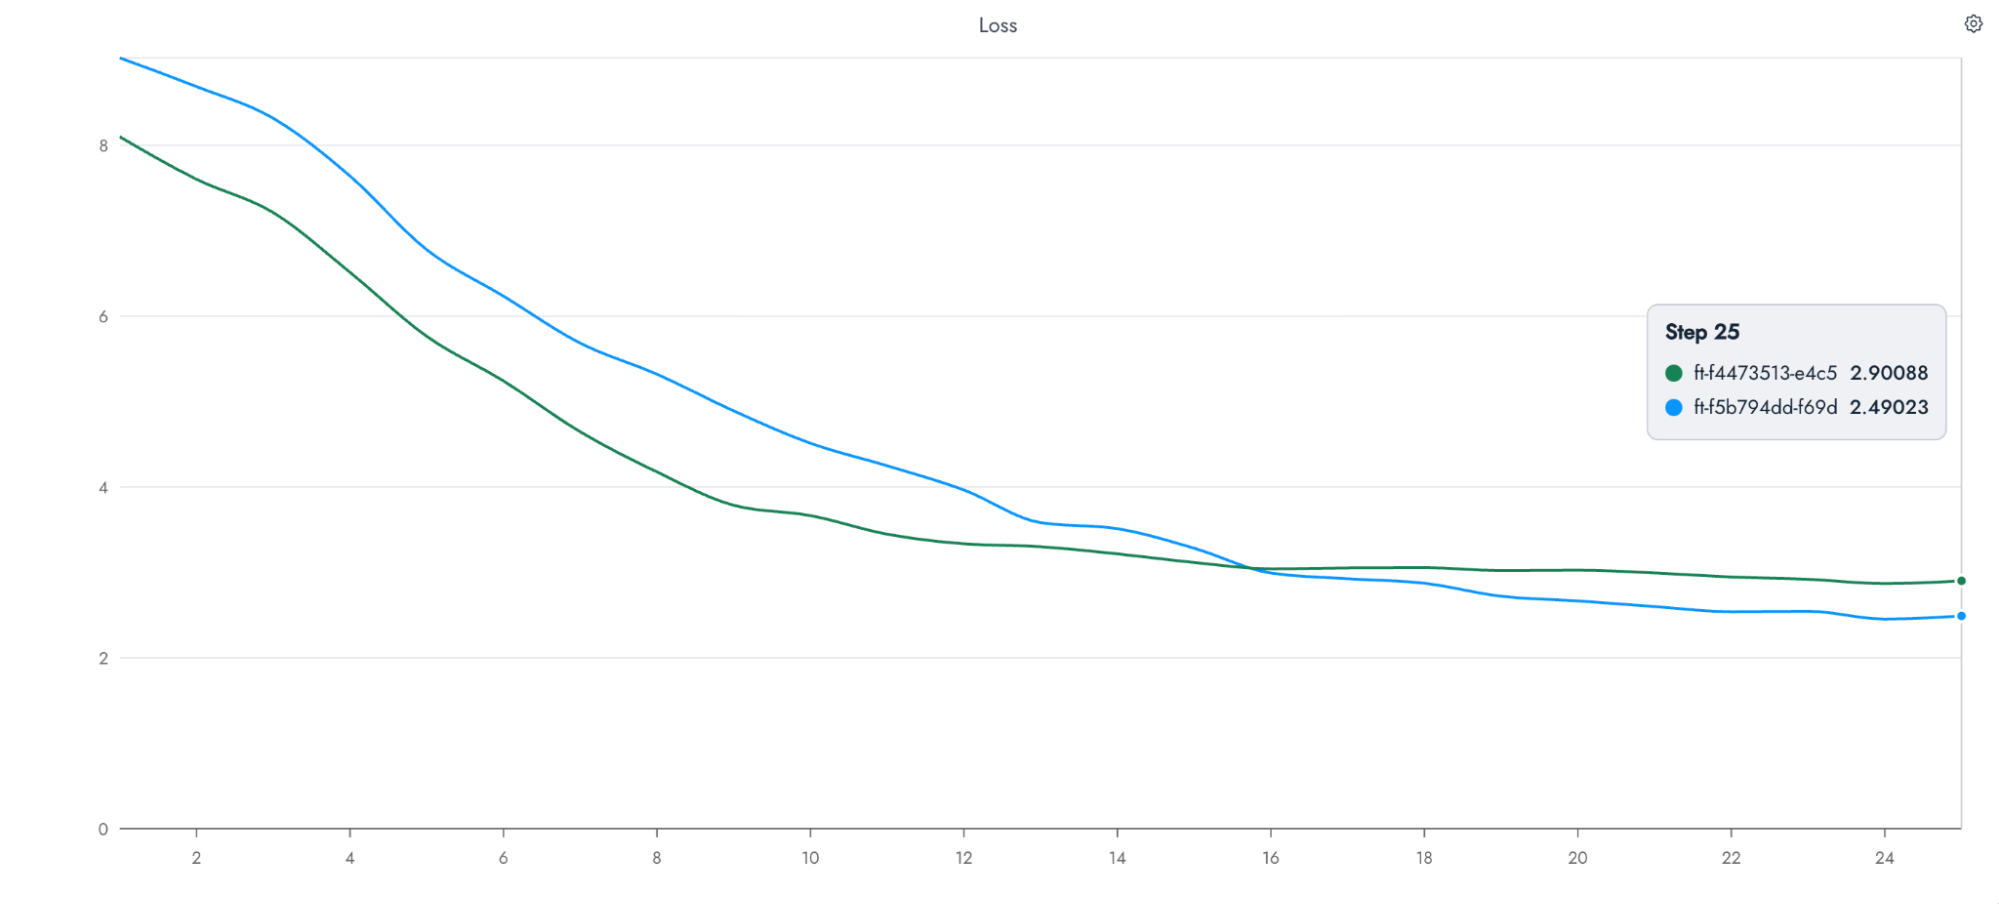
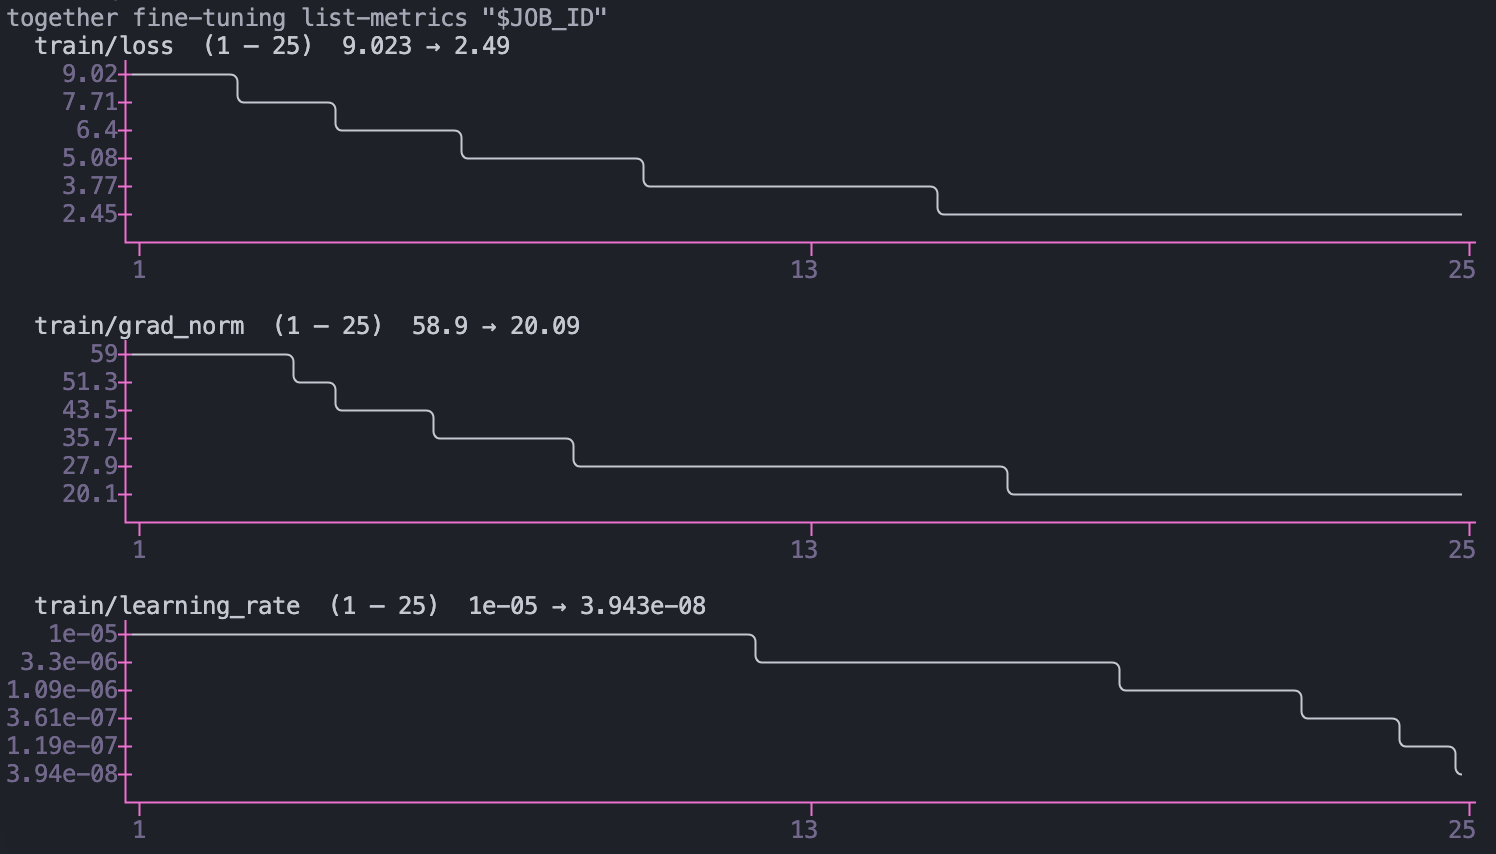
在仪表盘中,每个任务都有一个 Metrics 标签页,曲线会在运行过程中实时更新。你还可以选择多个任务,把它们绘制在同一组坐标轴上,这样一次超参数扫描就能看成一幅图,而不是十几个浏览器标签页。你也可以通过我们的 Python SDK 做同样的事:一条命令,终端里直接出曲线,无需切换上下文。
API 会返回底层的数据序列,即每个已记录的步骤,可按范围过滤或降采样。这样你可以把指标拉取到 notebook、你已有的内部仪表盘或任何其他目的地。
对训练的更多控制
Expert LoRA
在混合专家(Mixture-of-Experts)模型中,超过 90% 的参数以及模型实际掌握的大部分知识都位于专家层中。标准的 LoRA 微调从不触及它们:适配器挂在注意力层上,专家层保持冻结。现在你可以把 LoRA 适配器加到专家层本身,让你的任务训练知识所在的那些层。
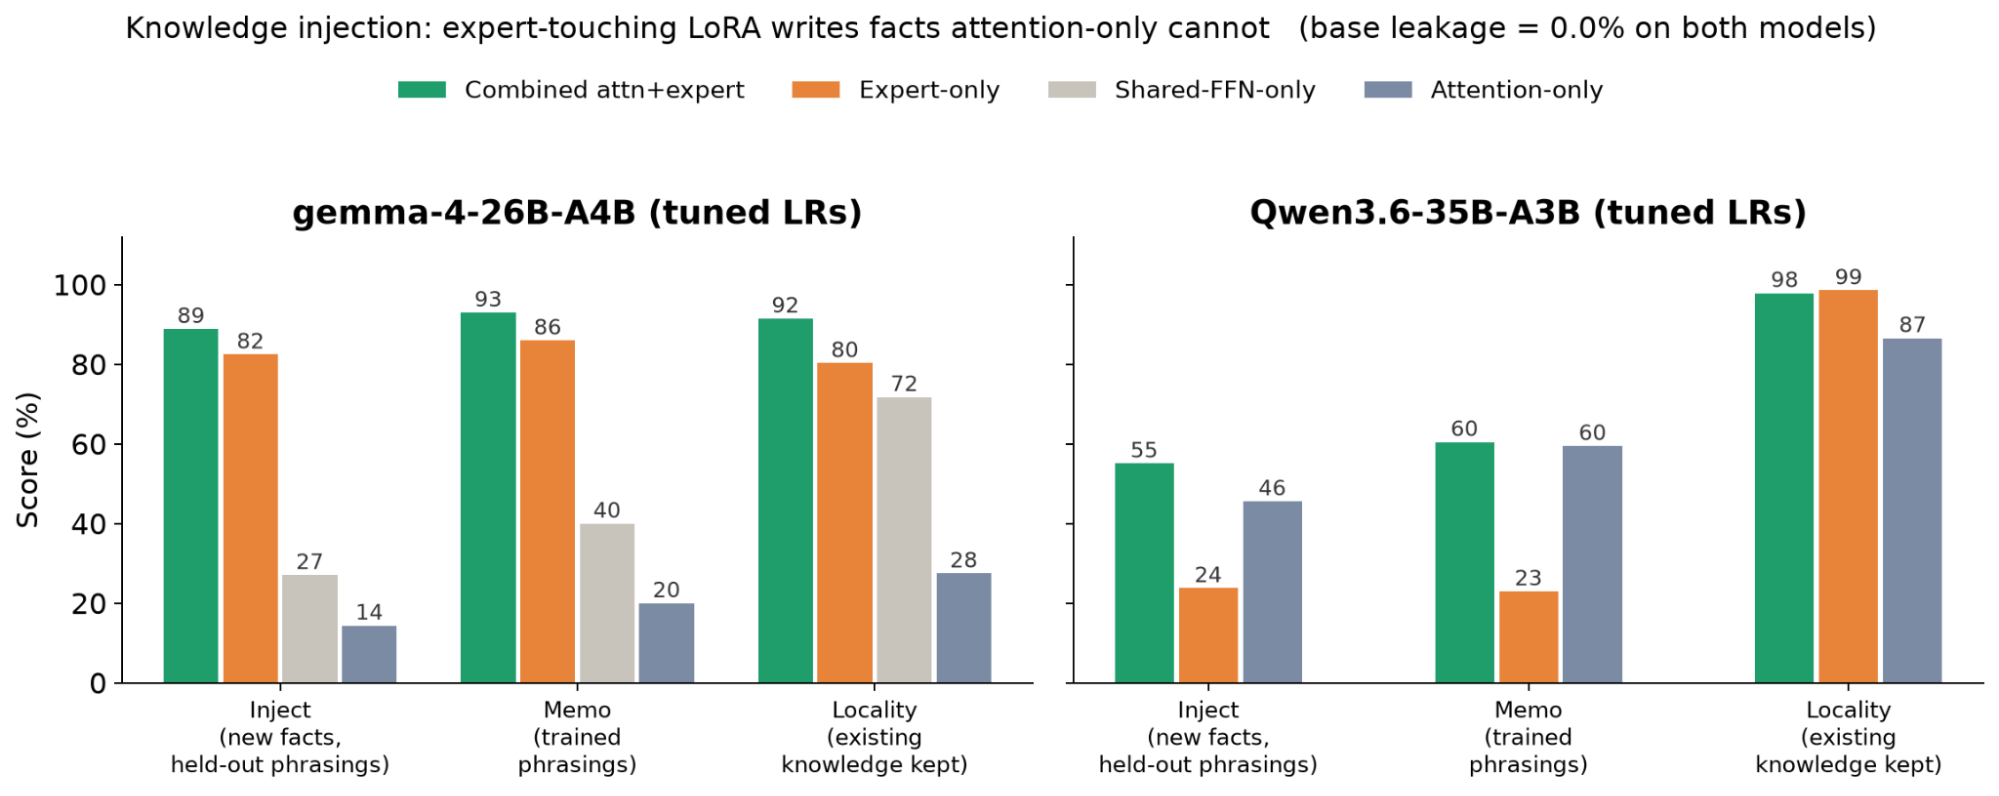
凡是任务需要模型学到真正全新的东西,差别就会显现出来。我们让模型学习 200 条虚构的事实(因此基础模型一条都不知道):包含专家层的适配器最多能回忆起 89% 的新知识,而在同一模型上只作用于注意力层的适配器最高只有 15%。它们还保留了更多模型原有的知识,并在 MMLU-Pro 上直接胜出,为 75.3% 对 71.5%。
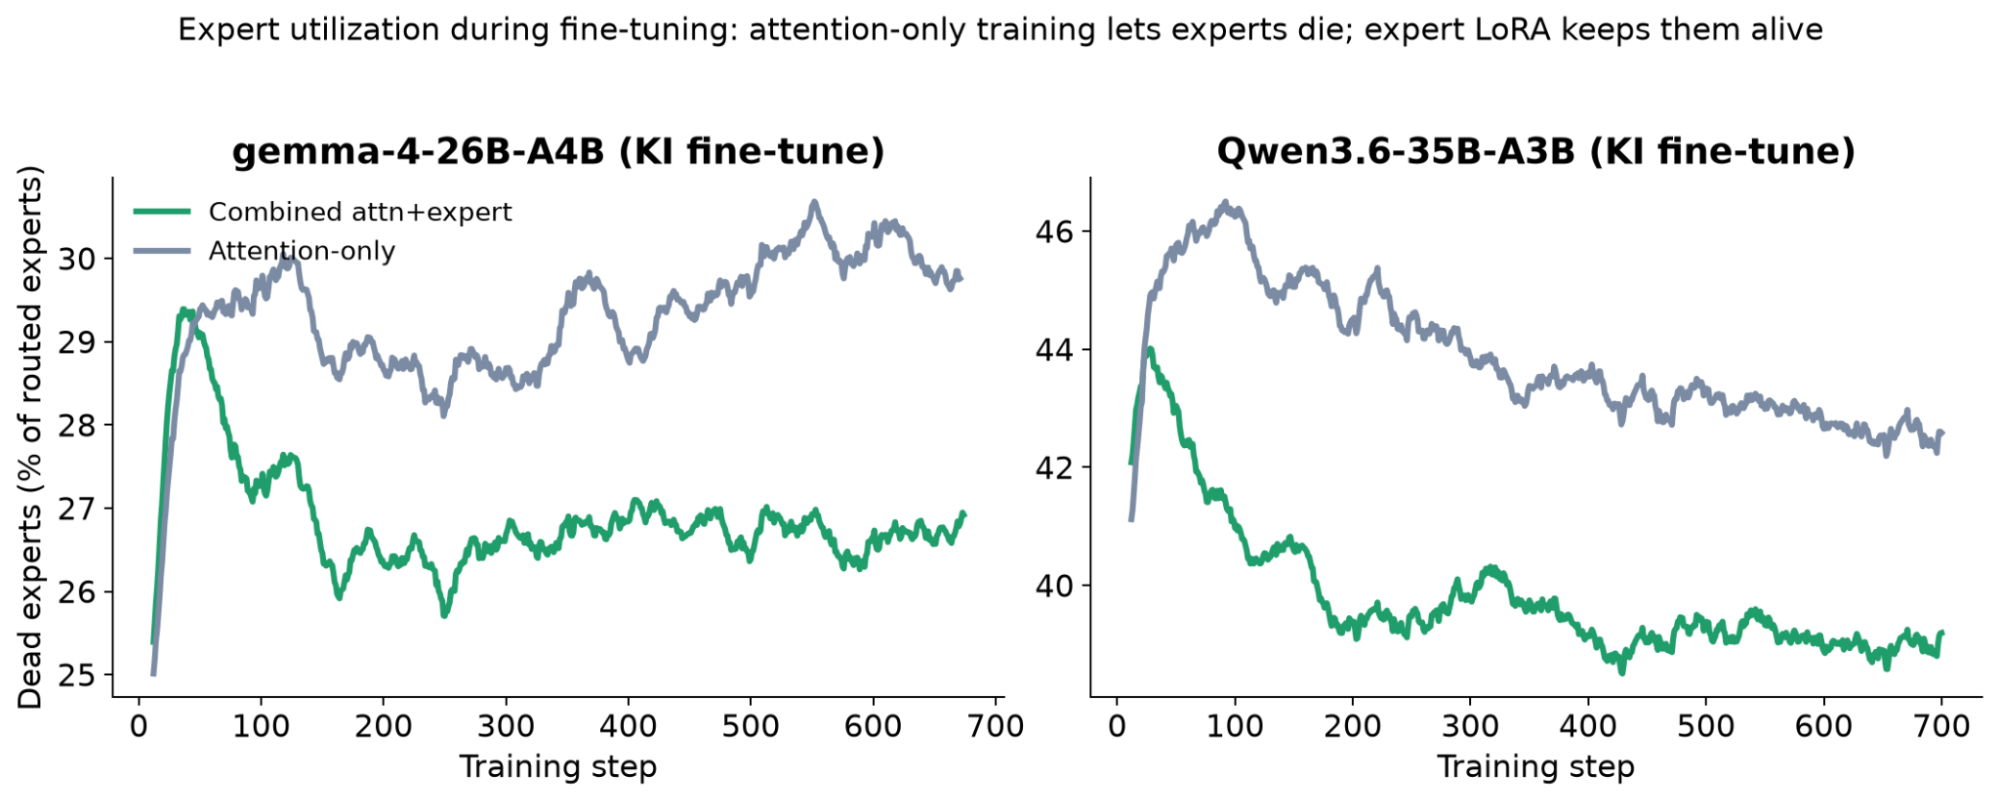
训练动态解释了这一差距:使用仅作用于注意力层的适配器时,微调期间被路由到的专家中有越来越大的比例干脆不再被使用,而专家适配器则让整个混合体保持参与。
启用专家适配器很简单:只需把专家模块添加到 lora_trainable_modules。其余微调工作流与任何其他 LoRA 任务相同。
提前停止
微调任务现在可以在不再提升时自动结束。这意味着你得到的是最佳模型,而不仅仅是最后一个,也不必为不再有帮助的训练付费。启用提前停止并提供验证集,我们会在每次评估时监测你的验证损失。当曲线趋于平稳,我们就停止运行,将验证损失最低的检查点作为你的最终模型,并自动退还你未使用的每一个训练步骤。
如果你想要更精细的控制,patience、对微小改进的敏感度和 warmup 都是可调的。完整的参数参考见文档。
支持任意批大小
有些任务需要的批大小在 GPU 显存里放不下:长序列、大模型,或是为大全局批大小调优的方案。现在无论单次前向能放下多少,你都可以用任意想要的有效批大小来训练。设置 gradient_accumulation_steps 后,梯度会在每次优化器更新之前跨微批累积,得到的有效批大小为 batch_size x gradient_accumulation_steps。详情见文档。
降价
在 Together,我们相信智能应当充裕丰沛,并利用一切可用的系统和算法优化,为客户提供最大的价值。我们会持续优化训练技术栈,并希望把任何成本降低都让利给用户。因此,我们下调了所支持的大多数模型的训练价格,降幅从 30% 起步,gpt-oss 系列等模型最高可达 70%。
以下是训练 LoRA 适配器每 100 万 token 的部分价格变化:
| 模型 | 原 SFT 价格 | 新 SFT 价格 | 原 DPO 价格 | 新 DPO 价格 |
|---|---|---|---|---|
| Qwen/Qwen3.5-9B | 0.48 | 0.34 | 1.20 | 0.84 |
| Qwen/Qwen3.8-27B | 1.50 | 1.05 | 3.75 | 2.62 |
| google/gemma-4-31B-it | 1.50 | 1.05 | 3.75 | 2.62 |
| openai/gpt-oss-120b | 5.00 | 2.50 | 12.50 | 6.25 |
| openai/gpt-oss-20b | 1.50 | 0.40 | 3.75 | 1.00 |
完整价格表见我们的定价页面。
案例研究:Adaption 如何在 Together 上为最大 1T 的开放模型自动化训练
Adaption 是一家前沿 AI 研究公司,致力于构建能持续学习的智能,让其通过实时数据和环境不断演进,而不是依赖静态训练和代价高昂的重训周期。其研究涵盖三大支柱:
- Adaptive Data,大规模塑造数据
- Adaptive Intelligence,让模型跨行业、跨语言演进
- Adaptive Interfaces,重新构想人与 AI 的交互
AutoScientist 属于 Adaptive Intelligence,它将模型训练背后的完整研究循环自动化。Adaptive Data 塑造输入,而 AutoScientist 塑造模型本身:你设定目标,这个循环就会搜索训练方案、优化数据、训练并评估,在这四个环节之间循环往复,而不是默认使用通用超参数。
它在每次运行后优化自己的选择,直到质量收敛到你的目标。它支持对最大 1T 参数的主流开放模型进行 LoRA 和全量微调,训练由 Together 的微调平台驱动,评估则运行在 Together 的专用端点上。其结果是一个持续改进模型的闭环,而无需承担否则所需的人工投入或重训成本。
“我们与 Together 合作,在最高达 1 万亿参数的模型上运行 Adaption 的 AutoScientist 完整自我改进训练循环。这让我们能够借助可靠交付的工具,为全球的公司大规模提供能自我改进的智能。”——Sara Hooker,Adaption 联合创始人
灵活透明的数据处理
检查分词后的数据
以前,数据处理在微调任务内部像黑盒一样运行:你看不到数据是如何被分词和打包的。当结果与你的预期不同时,比如聊天模板的应用方式和你设想的不一样、标签在错误的位置被掩码、行被悄悄截断,你就会遇到质量下降,而且很难追溯到原因。
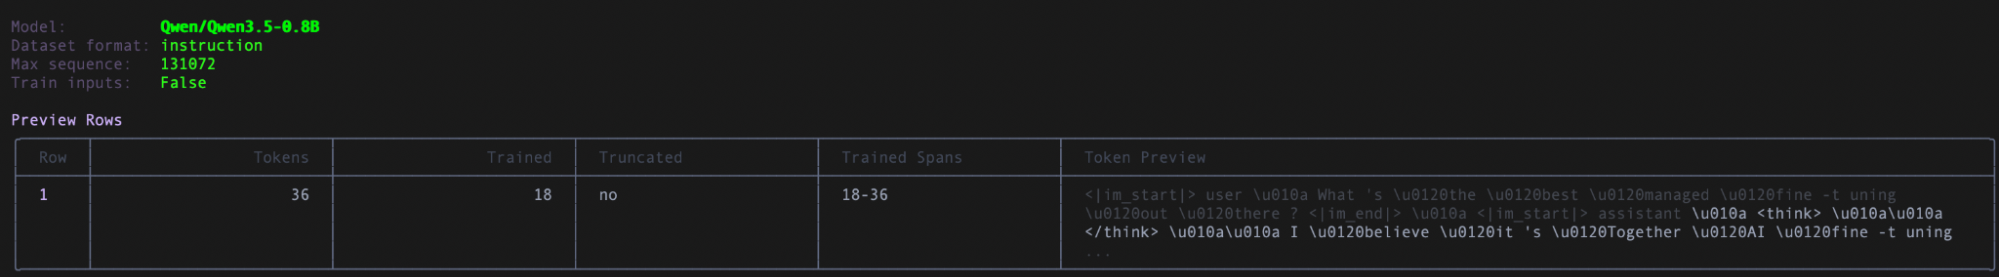
现在你可以在启动任务之前检查分词后的数据。预览任何已上传文件中的行,使用你即将微调的基础模型确切的分词器和聊天模板进行分词,并清楚看到训练将消费的内容:token ID、token 字符串、逐 token 的标签、参与损失计算的片段,以及该行是否在模型最大序列长度处被截断。预览只需几秒钟。
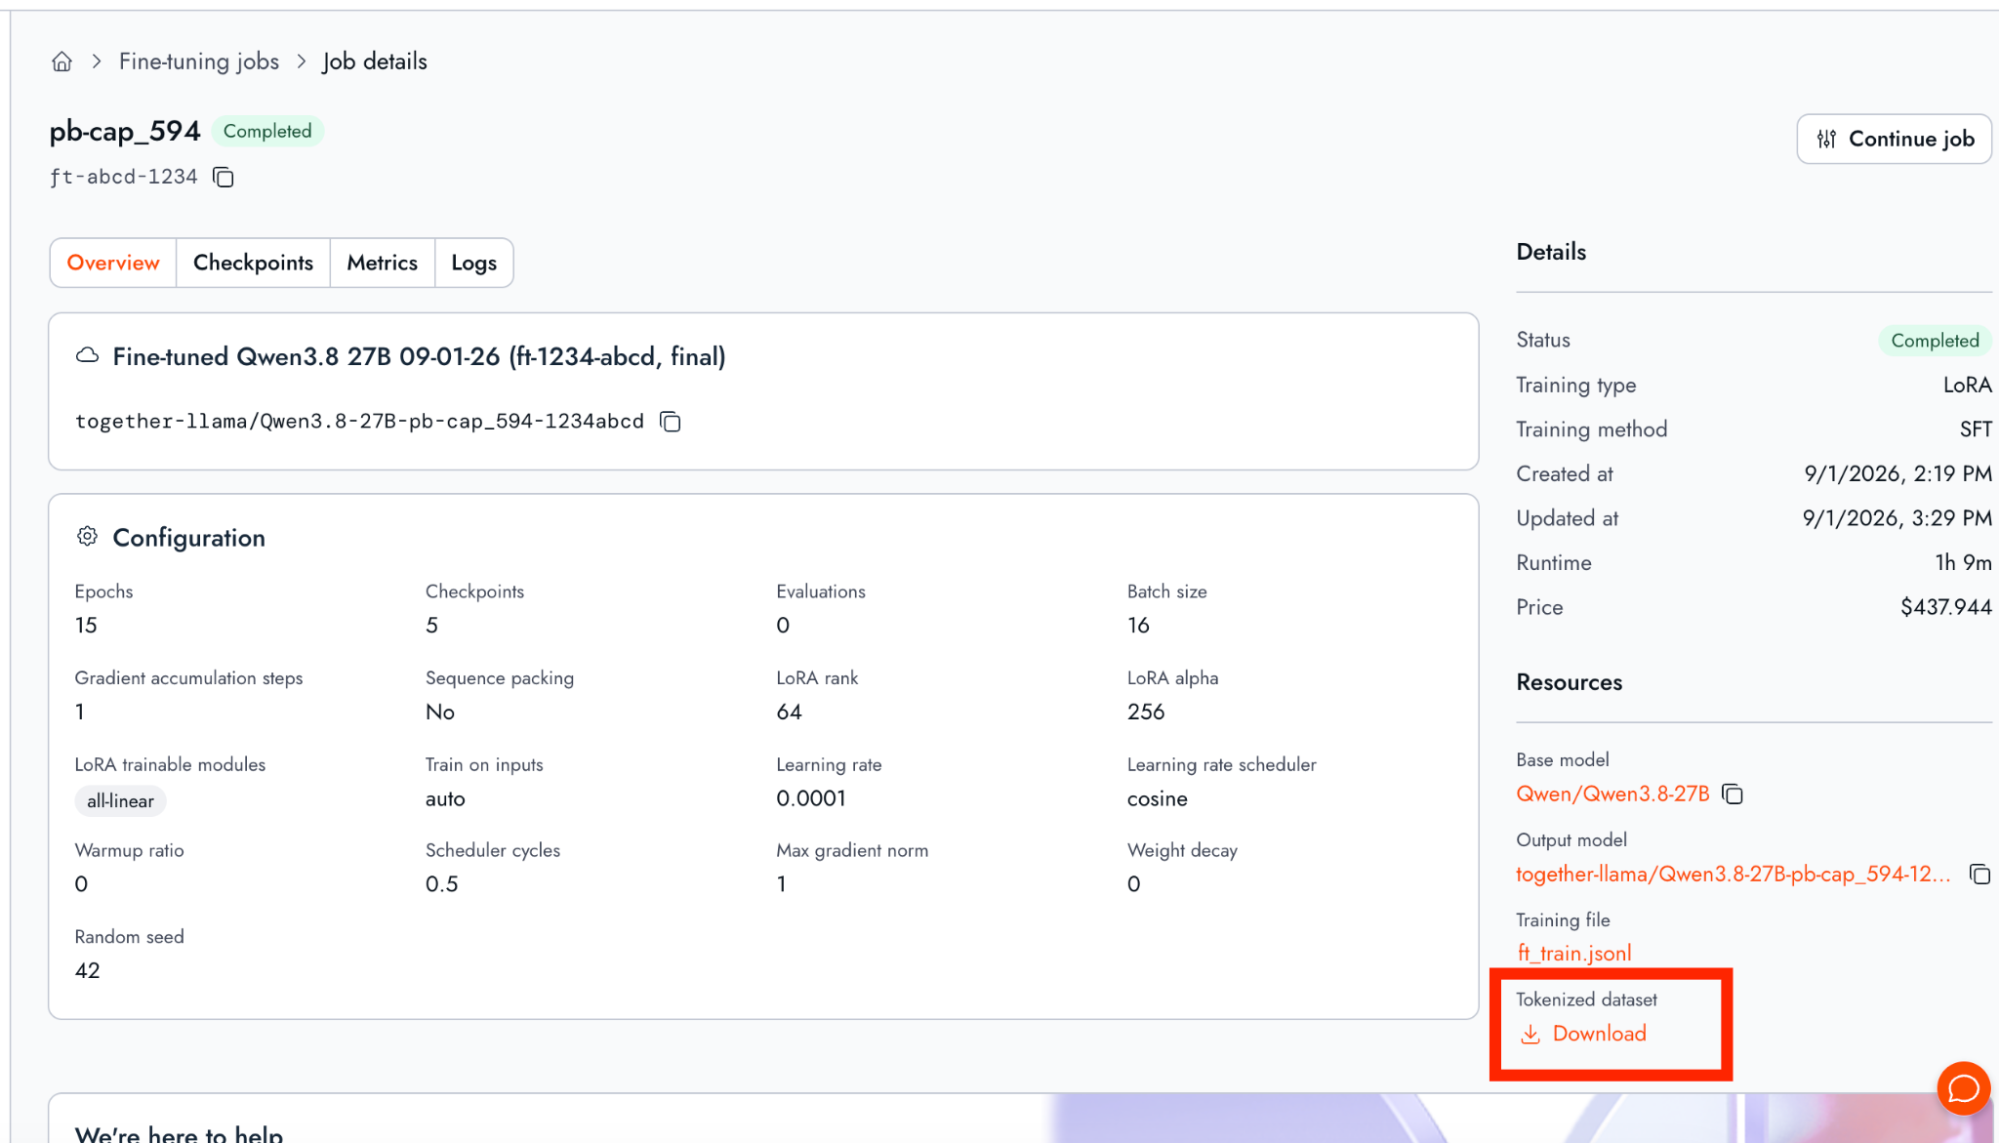
你还可以检查训练循环实际消费了什么。现在每个微调任务都会公开其完整预处理数据集的一个子集,其分词、打包和整理方式与训练器收到时完全一致。你可以通过 Python SDK,或控制台任务页面上的下载链接获取。
样本权重
并非每个训练样本都应得到同样的对待。现代数据集往往混合了多个来源和领域,比如人工标注数据与合成数据并存,一个领域与另一个领域并存,然而默认情况下,不论质量或重要性如何,每个样本对训练的影响都相同。
Together Fine-Tuning 现在支持逐样本加权,让你能精确控制每个数据点的影响。在 JSONL 文件的任何样本中添加一个 weight 字段,训练就会据此缩放该样本对损失的贡献。权重适用于所有受支持的 JSONL 数据格式和所有训练方法。
预检文件验证
数据集验证过去是在训练任务内部运行的。如果你文件的第 59,000 行有一个格式错误的工具调用,你要等任务排队、调度并启动之后才会发现,为了得知一个拼写错误要白等好几分钟。
现在,微调 JSONL 文件一上传完成,就会启动完整的服务端检查,结果直接写在文件对象上,因此你在创建任务之前就能看到任何问题。检查覆盖完整的模式:消息结构和角色、工具定义以及工具调用与响应的配对、推理字段、多模态内容和图像解码、偏好对结构,以及样本权重的类型和范围,错误信息中还会给出出问题的样本索引。
验证成功后,还会报告我们对你数据的识别结果,包括数据集格式、行数,以及是否包含样本权重、消息权重、工具、并行工具调用、推理轨迹或图像,让你确认平台是按你的本意读取了数据集。
打包控制
序列打包是一种把多个序列拼接成一个序列的技术,以避免在填充 token 上浪费计算。它能大幅提高吞吐量并缩短训练时间,因此在 Together Fine-Tuning 中默认启用。尽管有效率上的好处,它并不总是正确的选择:数据集较小时,打包可能导致每个 epoch 的优化步数太少。
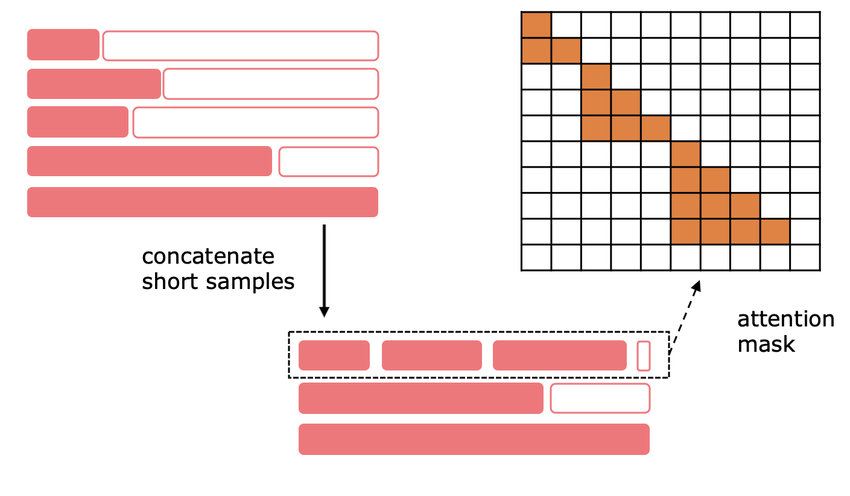
现在你可以完全控制序列打包:用一个标志彻底禁用它,或在预分词数据格式中使用 position_ids 来设定你想要的打包程度。
即将推出:从微调到推理的更快路径
每个中间的 LoRA 适配器都将可以在微调仍在进行时部署。你无需等待整个训练任务结束,在任务开始后不久就能开始评估结果,每次迭代可节省数小时甚至数天。第一个适配器一保存,你就可以通过 Dedicated Model Inference 部署它,或在 Multi-LoRA 设置中把它挂载到已运行的端点上,从而避免为每个实验单独建立端点的成本和启动时间。
首批支持计划用于 GLM-5.3,随后是 Kimi K3。随着新工作流临近发布,我们将分享可用性细节、受支持模型的完整列表以及完整的 API 使用演练。
结论
Together Fine-Tuning 现在让你对整个实验周期有更高的可见性和更强的控制力,从模型看到的数据,到你部署的检查点。你可以在运行前验证数据集,在训练时跟踪并对比指标,并通过更精细的控制调整方案。
对最新开放权重模型的支持,以及部分模型的降价,让这一循环在新模型出现时更容易重复进行。