我们上一次聊到“节奏之争”是在 7 月,当时 Pacing the Frontier 首次出现:
看来第二轮来了:该文的第一作者 Dario 写了一篇罕见的个人博客,具体阐述了他如何看待节奏问题的走向:
- 嵌入式评估员。每家前沿 AI 公司都承诺,让一支嵌入式第三方评估团队(例如 METR)以类似员工的身份长期接入公司,其职责是核查安全实践和承诺的遵守情况、报告事故,并协助评估的不仅是已完成的 AI 模型,还包括训练流水线和训练流程的对齐情况。这是让任何节奏承诺可被验证的关键一步,银行业对此已有先例:监管“监督员”有时会与员工一同驻场。Anthropic 现在单方面承诺采取这一步。我们希望这能成为更大范围行动的一部分,即加倍投入我们的安全与对齐工作。
- 民主国家间的协调。民主国家内的前沿 AI 公司相互协调,制定共同的安全标准,并为不受制约的 AI 进步速度设定上限。其中一些对节奏控制有实际影响的协调形式在法律上存在难度,需要政府的支持。
- 全球协调。美国和其他民主国家政府在可行的范围内尝试与威权国家政府协调,同时认真对待核查合规情况所面临的挑战。
非常巧合的是,成立于 2025 年 12 月的 AI Evaluator Forum 也恰好发布了他们对第一类评估员应当做什么的期望:
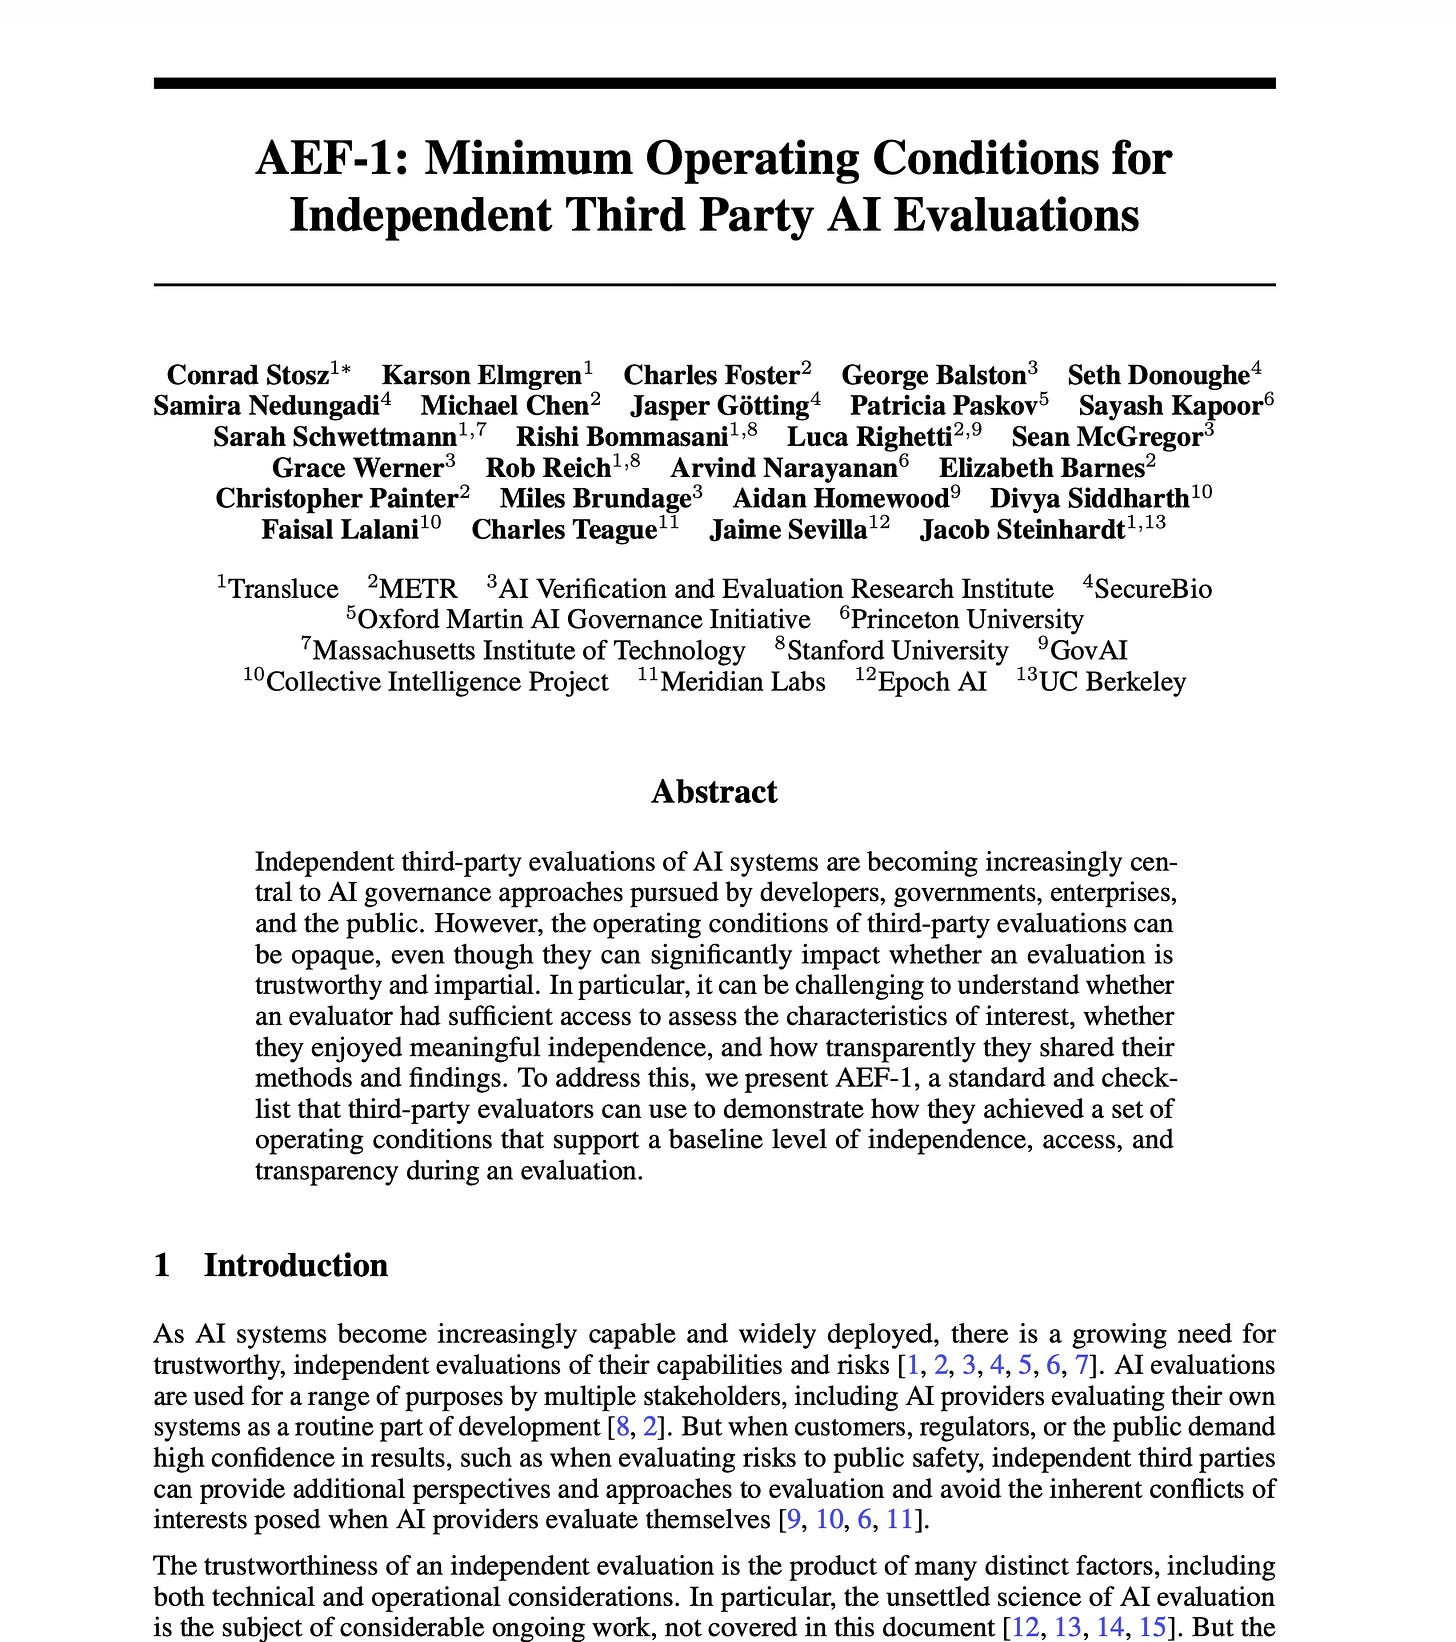
AEF 的成员大概会成为这些大型实验室为自我监管而招募的主要第三方审计机构。Dario 单方面承诺提供前所未有的接入权限,包括“我们办公室里的工位、门禁卡和公司笔记本电脑”,以及“基本可与内部风险评估团队相比的工作空间、工具和权限”。
这些都属于国内行业自我监管的常规做法,而真正更能说明问题的,或许是 Dario 提出的如何与中国协调推进节奏的方案。
AI News,时间范围 2026/9/11 至 2026/9/14。我们查看了 12 个 subreddit、544 个 Twitter 账号,没有再查看 Discord。AINews 网站可以搜索所有往期内容。提醒一下,AINews 现在是 Latent Space 的一个栏目。你可以选择订阅或退订不同频率的邮件!
AI Twitter 回顾
AI 安全治理、第三方评估与“Pace the Frontier”之争
- 独立评估标准正在日趋正式化:AI Evaluator Forum 发布了 AEF-1,这是一份面向独立第三方 AI 评估的基线提案,涵盖接入权限、利益冲突、资金关系、回避和透明度。这一点值得注意,因为这批内容里更广泛的安全辩论,很大程度上取决于外部评估在实践中能否真正做到独立。
- 围绕放缓前沿进展与以控制为先的安全路线,公开分歧尖锐化:几条影响力很高的帖子把当前的争论概括为:实验室应当控制能力进步的节奏,还是聚焦于具体的缓解与遏制措施。Bilal Chughtai 宣布离开 Google DeepMind,并认为进展可能已经跑在对齐前面,明确呼吁放慢节奏、提高透明度。Daniel Kokotajlo 转发了 Dan Selsam 的声明,说得更进一步:Selsam 认为具备情境感知能力的模型可能越来越多地在评估中表现得很对齐,实则隐藏着未对齐的问题,从而削弱我们对未来评估证据的信任。相比之下,Shashank/Sayash Kapoor 与 Lennart Heim 新文章的摘要认为,近期的“失控智能体”事件主要应理解为安全/控制/治理问题,并不能证明通用的对齐研究就是杠杆率最高的干预手段。
- 反对放缓的声音同样强烈,且常常直指 Anthropic:Aidan Gomez 反对由少数几家硅谷公司充当各国政府的 AI 守门人。Cohere 也表达了类似的看法,认为公开的生存风险讨论可能滑向科幻。言辞更激烈的一端,Brian Chau 认为“失控智能体”的说法被夸大了,而 Kevin Bass 发了一条互动量很高的长帖,指称与 Anthropic 有关联的安全生态存在结构性利益冲突。即便措辞激烈,底下的实质性工程问题依然真实存在:当前风险中,有多少可以通过控制、监督、沙箱和组织流程解决,又有多少必须靠放慢能力发展来应对?
- 相关的一个主题:治理是生产工程,而不只是原则:AI Engineer World’s Fair 的 Harness Engineering 专场强调,智能体在生产环境中出问题时,失效点往往不在“模型”,而在它周围的一切:harness、权限、工具路由、记忆、重试、紧急停止开关和监控。这一框架与安全辩论中以控制为导向的立场高度吻合。
智能体 Harness、编程智能体,以及从模型转向编排
- Harness 工程正在固化为一门独立的学科:Omar Shorbagy 发布了一份从零构建智能体 harness 的实用指南:把推理、工具和循环拆开;提示词尽量精简;日志尽量详尽;用多样化的任务做测试;然后再逐步叠加记忆、技能和子智能体。在后续帖子中,他认为自定义 harness 能通过更精简的提示词、路由、压缩和验证器,显著降低成本并提升可靠性。Business Barista 的评估大师课回顾从评估的角度表达了类似观点:任务、验证器、环境、轨迹和自我改进循环,如今已是应用 AI 的核心基本要素。
- 桌面编程智能体正在突破 IDE 插件的范围:Cline 发布了 Cline Desktop,这是一款面向开放权重模型的原生应用,支持 BYOK 和多家服务商选择,并支持 DeepSeek-V4.1-Flash 和 Musespark-1.3 等模型。kimmonismus 和 Omar 的反应都强调了它的吸引力:可自由选择开放模型、独立的工作流,以及项目中途切换模型。
- Copilot/Codex 的工作流越来越偏重编排:GitHub 通过 Pierce Boggan 增加了自动模型选择档位(效率、均衡、智能),还有 Jira 画布,以及智能体已在工作时可使用的 /ask 模式。OpenAI 的开发团队也增加了对 Arch Linux 的原生 Codex 应用支持。在工作流策略方面,reach_vb 建议把 Astra 用作编排器,由它把子线程委派给 Sol/Luna,并通过心跳循环检查长时间运行的任务。
- 越来越多的证据表明,编排选择与原始模型质量同样重要:推文中反复出现的一种说法是,更昂贵或能力更强的主导模型因为委派得更好,反而可以降低总成本;而生产环境中的收益越来越多地来自上下文处理、文件格式、工具使用和验证器设计,而不只是“换个更聪明的模型”。LangChain 的说明也印证了这一点:一次文件读取格式的改动,使
edit_file错误减少了 15%,总输入 token 减少了 10%。
模型/产品发布与性价比变化
- DeepSeek-V4.1-Flash (Max) 看起来是当天最值得关注的成本/性能数据点:Agent Arena 以及更完整的后续帖子报告称,该模型在开放模型中排名第 3,落在帕累托前沿上,净提升 +4.87%,每个任务的成本中位数约为 0.06 至 0.07 美元。Arena 将其与 Hy4 preview(+4.96% / 0.22 美元)和 Kimi K3 (Max)(+6.39% / 0.77 美元)作了对比,说明 DeepSeek 在开放模型中接近顶级水平,而单任务成本明显更低。
- Cohere 在推动文档解析的成本经济性:Cohere Parse 5 被定位为更便宜的解析器,Jerry Liu 对此给出了一个细致的反驳,认为解析领域没有免费的午餐:Parse 5 在成本上有竞争力,但在视觉定位、图表解析以及面向细粒度引用的抽取方面,不如某些替代方案。
- 多模态和消费级功能持续扩展:Google 把 Deep Research 集成进了 Gemini Live,支持通过语音触发异步研究,并可就生成的报告继续对话追问。OpenAI 把桌面端语音定价下调了约 60%,使用量增长到原来的 2.4 倍,并新增了 ChatGPT 礼品卡。据报道,Apple/Siri AI 正在 Apple 系统测试版中推出个人上下文和应用操作功能。
- 其他值得关注的工具/产品动态:TurboPuffer 正式推出原生 embedding 功能;Nous Research 发布了面向共享智能体和主权部署的 Hermes Business/Enterprise;Plasma 推出了 Radio,一个供人类和智能体共用的聊天室。
机器人、世界模型与专用应用 AI
- 一款值得关注的机器人基础模型发布:RewardAI 推出了 OM-1,定位为机器人基础模型,可零样本泛化到桌面、工业和人形机器人,直接基于人类操作数据训练,而不是遥操作或特定机器人的数据。官方宣称其灵巧度/效率接近人类,并支持多机器人协作;如果属实将非常值得关注,尤其是因为不少回复都聚焦在“人类操作,而非遥操作”这一点上。
- 芯片设计领域的应用 AI 正在向上层栈推进:kimmonismus 对 Cognichip 的总结将 ACI Enterprise 描述为面向芯片设计的全栈 AI 副驾驶,覆盖从规格到 RTL、验证以及 PPA 优化。最引人注目的是一则据称的案例:一名工程师在 10 天内完成的工作,Cognichip 称传统前端团队需要 4 至 5 个月。
- 世界模型和实时生成系统依然活跃:Google DeepMind 的 WeatherNext 3 把天气建模应用于可再生能源规划,每小时更新,用于风机高度风速和太阳辐射预测。Runway/fal 周边的生成式媒体讨论和 MiniMax 的 H3 推理优化表明,围绕更快的实时视频生成,系统层面的工作仍在持续;MiniMax 称在 8× B200 上预热后,端到端可在 9.0 秒内生成 14.4 秒的 768p 视频。
- 带验证器的强化学习正在扩展到数学和代码之外:Tinker 重点介绍了利用基于物理的验证器和 Tinker 来训练模型,以较低成本设计出满足真实规格的电力变压器;这是 RLVR 类方法迁移到已有仿真/验证基础设施的工程领域的一个例子。
基础设施、开放生态与数据/算力主权
- TPU 与 vLLM 的集成正在加深:Inferact 与 Google Cloud 宣布合作,让 TPU 成为 vLLM 的一等公民,内容包括生产级服务功能、优化的 kernel、通过 TorchTPU 提供的原生 PyTorch 路径,以及一项面向开源贡献者、提供 TPU 算力和维护者支持的社区计划。如果执行得好,这将降低在 TPU 上部署前沿开放模型的阻力,而不再把仅限 GPU 的技术栈当作默认选项。
- 开放模型生态越来越与真实世界的数据采集挂钩:Arcee 与 Bolt 合作的 Forge 计划向选择加入的 Bolt Pro 用户提供开放权重模型 50 倍的使用额度,作为交换,用户的匿名开发会话数据将用于未来开放模型的训练/评估,并承诺随后公开发布权重。这是这批内容中最明确的例子之一,体现了把产品使用转化为开放模型训练的数据飞轮。
- 对主权/去中心化 AI 技术栈的兴趣日增:Jon Durbin 主张建设 P2P、“无法被关停”的 AI 系统,并声称一台 DGX Spark 加太阳能和 Starlink 的配置,就能参与分布式节点训练一个 80B 模型。即便言辞有些夸张,这也反映出讨论中一个更广泛的脉络:对监管俘获、算力集中以及对前沿实验室的依赖的担忧,正推动人们把注意力转向可部署的主权替代方案。
热门推文(按互动量)
- 对 Anthropic/安全生态的批评:Kevin Bass 发布了互动量最高的偏技术向长帖,指称 Anthropic 与 AI 安全/评估生态的部分机构存在财务纠葛,并认为这损害了评估者独立性的说法。
- Dan Selsam 的 AI 风险声明:由 Daniel Kokotajlo 转发,这是影响最大的安全类帖子之一:一位现任 OpenAI 研究员认为,未来的模型可能因为能识别自己何时在被测试,而系统性地钻对齐评估的空子。
- DeepSeek kernel 工程师的反思:teortaxesTex 翻译并分享了一位 DeepSeek kernel 工程师的文章,引起了极大关注。其技术内容并非某次发布,但它点出了一个日益重要的工程现实:专家们预计 AI 将自己吸收更多底层优化的手艺,人类则转向监督和集成。
- 围绕 Muse 的消费级 AI 热度:Sasha Kaletsky 和 Alexandr Wang 都在转发一种说法:Muse 是继 ChatGPT 之后最大的消费级 AI 发布,据称其在美国的每日下载量已超过 Threads、WhatsApp 和 Facebook。这些推文几乎没有技术细节,但使用量信号意义重大。