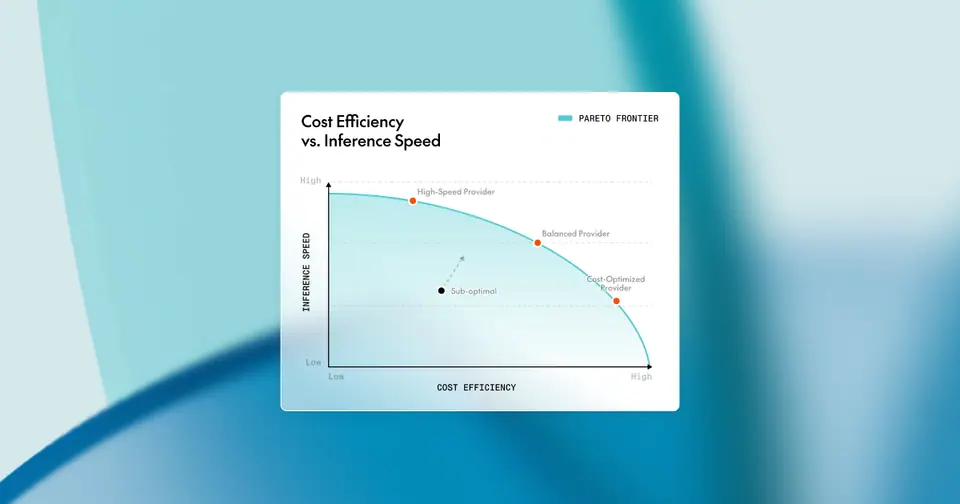
团队如何在不大幅增加成本的前提下降低推理延迟?
更快的推理并不总是意味着要花钱买更大的集群。在 Together AI,我们发现那些能持续做到低延迟、低成本的团队,有这样几个共同习惯:
- 他们让每块 GPU 都榨出尽可能多的有效工作量
- 他们主动消除看不见的计算停顿
- 他们根据自身的流量模式,有策略地选择解码技术
- 他们把性能调优视为一项持续的工作,而不是一次性的配置任务
在这些方面做到位,你的集群就能在更快响应的同时,降低每个 token 的成本。
推理成本效率为何重要
AI 产品的竞争一周比一周激烈,用户的期望也在同步攀升。
对于领先的 AI 原生公司而言,比如需要在不牺牲速度的前提下获得海量吞吐量的 Cursor,以及需要在流量难以预测的情况下做到实时响应的 Decagon,面临的压力如出一辙:
- 要快。TTFT 低于 500ms,解码速度快
- 要可预期。没有出人意料的尾延迟
- 要划算。GPU 账单不能随流量线性增长
- 要能应对突发。因为流量从不按你预想的方式变化
在各个客户身上,我们一再看到同一个硬性要求:实现亚秒级响应,同时不让 GPU 账单翻倍。好消息是,要保持推理成本效率,你不需要奇特的架构,也不需要额外增加数百块 GPU。
大多数团队的显著收益,来自优化推理如何运行,而不单纯是购买多少硬件。
推理优化是如何起作用的
以下这些手段能可靠地让速度和成本同时朝好的方向变化。
1. 从模型层面入手:量化与蒸馏
量化
降低精度(FP16 → FP8 → FP4)能让模型占用更少内存、运行更快;做得好的话,几乎没有质量损失,就像我们在 Together 的做法一样。
这会带来:
- 每秒生成 token 数明显提升
- 在相同 GPU 占用下支持更大的批大小
- 每个 token 的成本更低
- 实时工作负载的扩展更平滑
我们在许多生产部署中看到,FP8 或 FP4 量化能带来 20–40% 的吞吐量提升,且不损害输出质量。
蒸馏
并非每种工作负载都需要前沿模型的全部分量。蒸馏是训练一个较小的模型去模仿较大的模型,在保留推理模式的同时大幅削减计算成本。
DeepSeek-R1 就是一个很好的例子。它的蒸馏版本速度快、体积轻,推理能力依然出色,非常适合:
- 交互式聊天
- 编程助手
- 路由与分类
- 高并发的企业级工作负载
- 边缘推理或延迟预算很紧的场景
你可以在这篇文章中了解团队如何在 Together AI 上安全地部署 R1 及其蒸馏版本。
R1 蒸馏版本提供的质量与延迟之比,对生产工作负载极具吸引力——在许多任务上,往往能在相近质量区间内实现 2–5 倍的成本降低。
量化和蒸馏相结合,是在触碰硬件或集群架构之前,所能获得的最大幅度的成本削减手段之一。
2. 在边缘降低网络延迟(区域推理代理)
有时最大的延迟收益并不在计算,而在地理位置。即便模型速度极快,网络距离往往仍是请求路径上最慢的一环。
在推理集群所在的同一区域部署一个轻量级代理,可以在生成开始之前就省掉冗长的往返路径。
仅此一项就能让 TTFT 缩短 50–100 ms,并使尾延迟更可预期。
3. 减少不必要的计算(内存停顿、KV 低效、碎片化)
大多数模型本身并不慢,慢的是它们周围的流水线。于是 GPU 大量时间什么也没做,只是在……等待。最主要的几个罪魁祸首往往是:
- 彼此配合效率低下的 kernel,迫使 GPU 在 prefill、注意力和解码之间暂停
- 花在等待内存上的时间多于做有用功的 MoE 层,在专家路由不均衡时尤其如此
- 处理长提示词吃力的 prefill 路径,导致启动缓慢、性能不稳
- 批处理或调度上的空档,使 GPU 的一部分在仍有任务可做时处于闲置
在 Together AI,我们针对 Llama、Qwen、Mistral 和 DeepSeek 系列做过基准测试(详见我们的主流开源模型最快推理博客),结果表明:kernel 融合、更聪明的 MoE 执行、精简的分词流程以及更好的调度,可以消除被浪费的时间,从而带来更快的响应和更高的吞吐量。
4. 使用合适的解码优化(MTP、推测解码、草稿模型)
解码是大量时间流失的地方,也是一些最容易拿到的收益所在。
- MTP:一次预测多个 token,提高解码速度和 GPU 效率
- 推测解码:使用一个小的“草稿”模型,为可预测的工作负载加速生成
调优得当时,这些技术往往能带来 20–50% 的解码加速,以及显著更高的单 GPU 吞吐量。
5. 为你的工作负载选对硬件(并使用合适的并行方式)
大约每年就有一种新硬件问世,硬件选择对成本和延迟的影响也越来越大。
- Blackwell GPU 在每 token 吞吐量和注意力 kernel 速度上都有大幅提升。
- NVIDIA Grace Blackwell(GB200)系统将 CPU 与 GPU 内存紧密耦合,减少了数据搬运开销,提升了大批量和长上下文场景下的吞吐量。
但要充分发挥这类硬件的优势,大模型需要被拆分并在各设备间智能调度。这就是并行策略的用武之地:
- 张量并行把单个层拆分到多块 GPU 上,让超大模型高效运行而不受内存带宽限制。
- 专家并行把 MoE 模型中的不同专家分布到各块 GPU 上,让每块 GPU 专精于一部分专家,而不是什么都做。
每天处理数十亿 token 的团队,在配合合适的并行策略、将重负载迁移到 NVIDIA Blackwell 级硬件后,通常会看到每 token 成本明显下降。
6. 在各端点之间动态调配 GPU 容量
流量很少在所有服务之间均匀分布。例如:
- 功能:根据实时并发和需求,在端点之间动态伸缩
- 工作方式:GPU 会自动重新分配给最繁忙的端点,而闲置的端点则释放容量。
- 结果:整体利用率更高,闲置 GPU 更少,并且无需过度配置也能应对突发流量。
这对于混合负载的客户尤其有价值:编程、聊天、RAG、批处理和长文本生成。Together AI 允许客户通过一次简单的 API 调用更新其端点的容量。
更好的推理优化能带来什么
实施这些优化的团队可以获得:
- 更低的 TTFT 和更快的解码
- 更高的 GPU 利用率和更少的空闲周期
- 更低的每 token 成本
- 更好的可预期性和尾延迟表现
- 在交互式和实时产品中带来更好的用户体验
快速上手
下面是一种务实、阻力小的起步方式:
- 测量你的基线(TTFT、解码 TPS、每 GPU 的 TPM、网络 RTT)
- 如果请求来源离推理集群很远,就部署区域代理
- 启用自适应连续批处理,并监控 GPU 利用率
- 根据工作负载开启 MTP 或推测解码
- 随着流量变化动态调配 GPU 容量,重新平衡各端点
常见问题
吞吐量优化会增加延迟吗?
不会。连续批处理加融合 kernel,可以在提升吞吐量的同时降低延迟。
NVIDIA Blackwell 只适合超大规模工作负载吗?
不是。任何具有可观并发或长上下文的工作负载,都能从它的带宽和内存改进中受益。
如何判断我的 GPU 是否未被充分利用?
留意解码 TPS 偏低、活跃批大小偏小,或 token 生成之间出现较长间隔。