在应用 AI 领域,提示工程受到了几年的关注,如今一个新术语开始崭露头角:上下文工程(context engineering)。基于语言模型进行构建,越来越不再是为提示词寻找恰当的字词和短语,而是回答一个更宏观的问题:“什么样的上下文配置最有可能让模型产生我们期望的行为?”
上下文指的是从大语言模型(LLM)采样时所包含的那组词元。眼前的工程问题,是在 LLM 固有限制的约束下优化这些词元的效用,从而稳定地达成预期结果。要有效驾驭 LLM,往往需要以上下文的方式思考,换句话说,就是考虑 LLM 在任意时刻可见的整体状态,以及该状态可能引发哪些行为。
本文将探讨上下文工程这门新兴的技艺,并提供一个更精炼的心智模型,用于构建可引导、高效的智能体。
上下文工程与提示工程
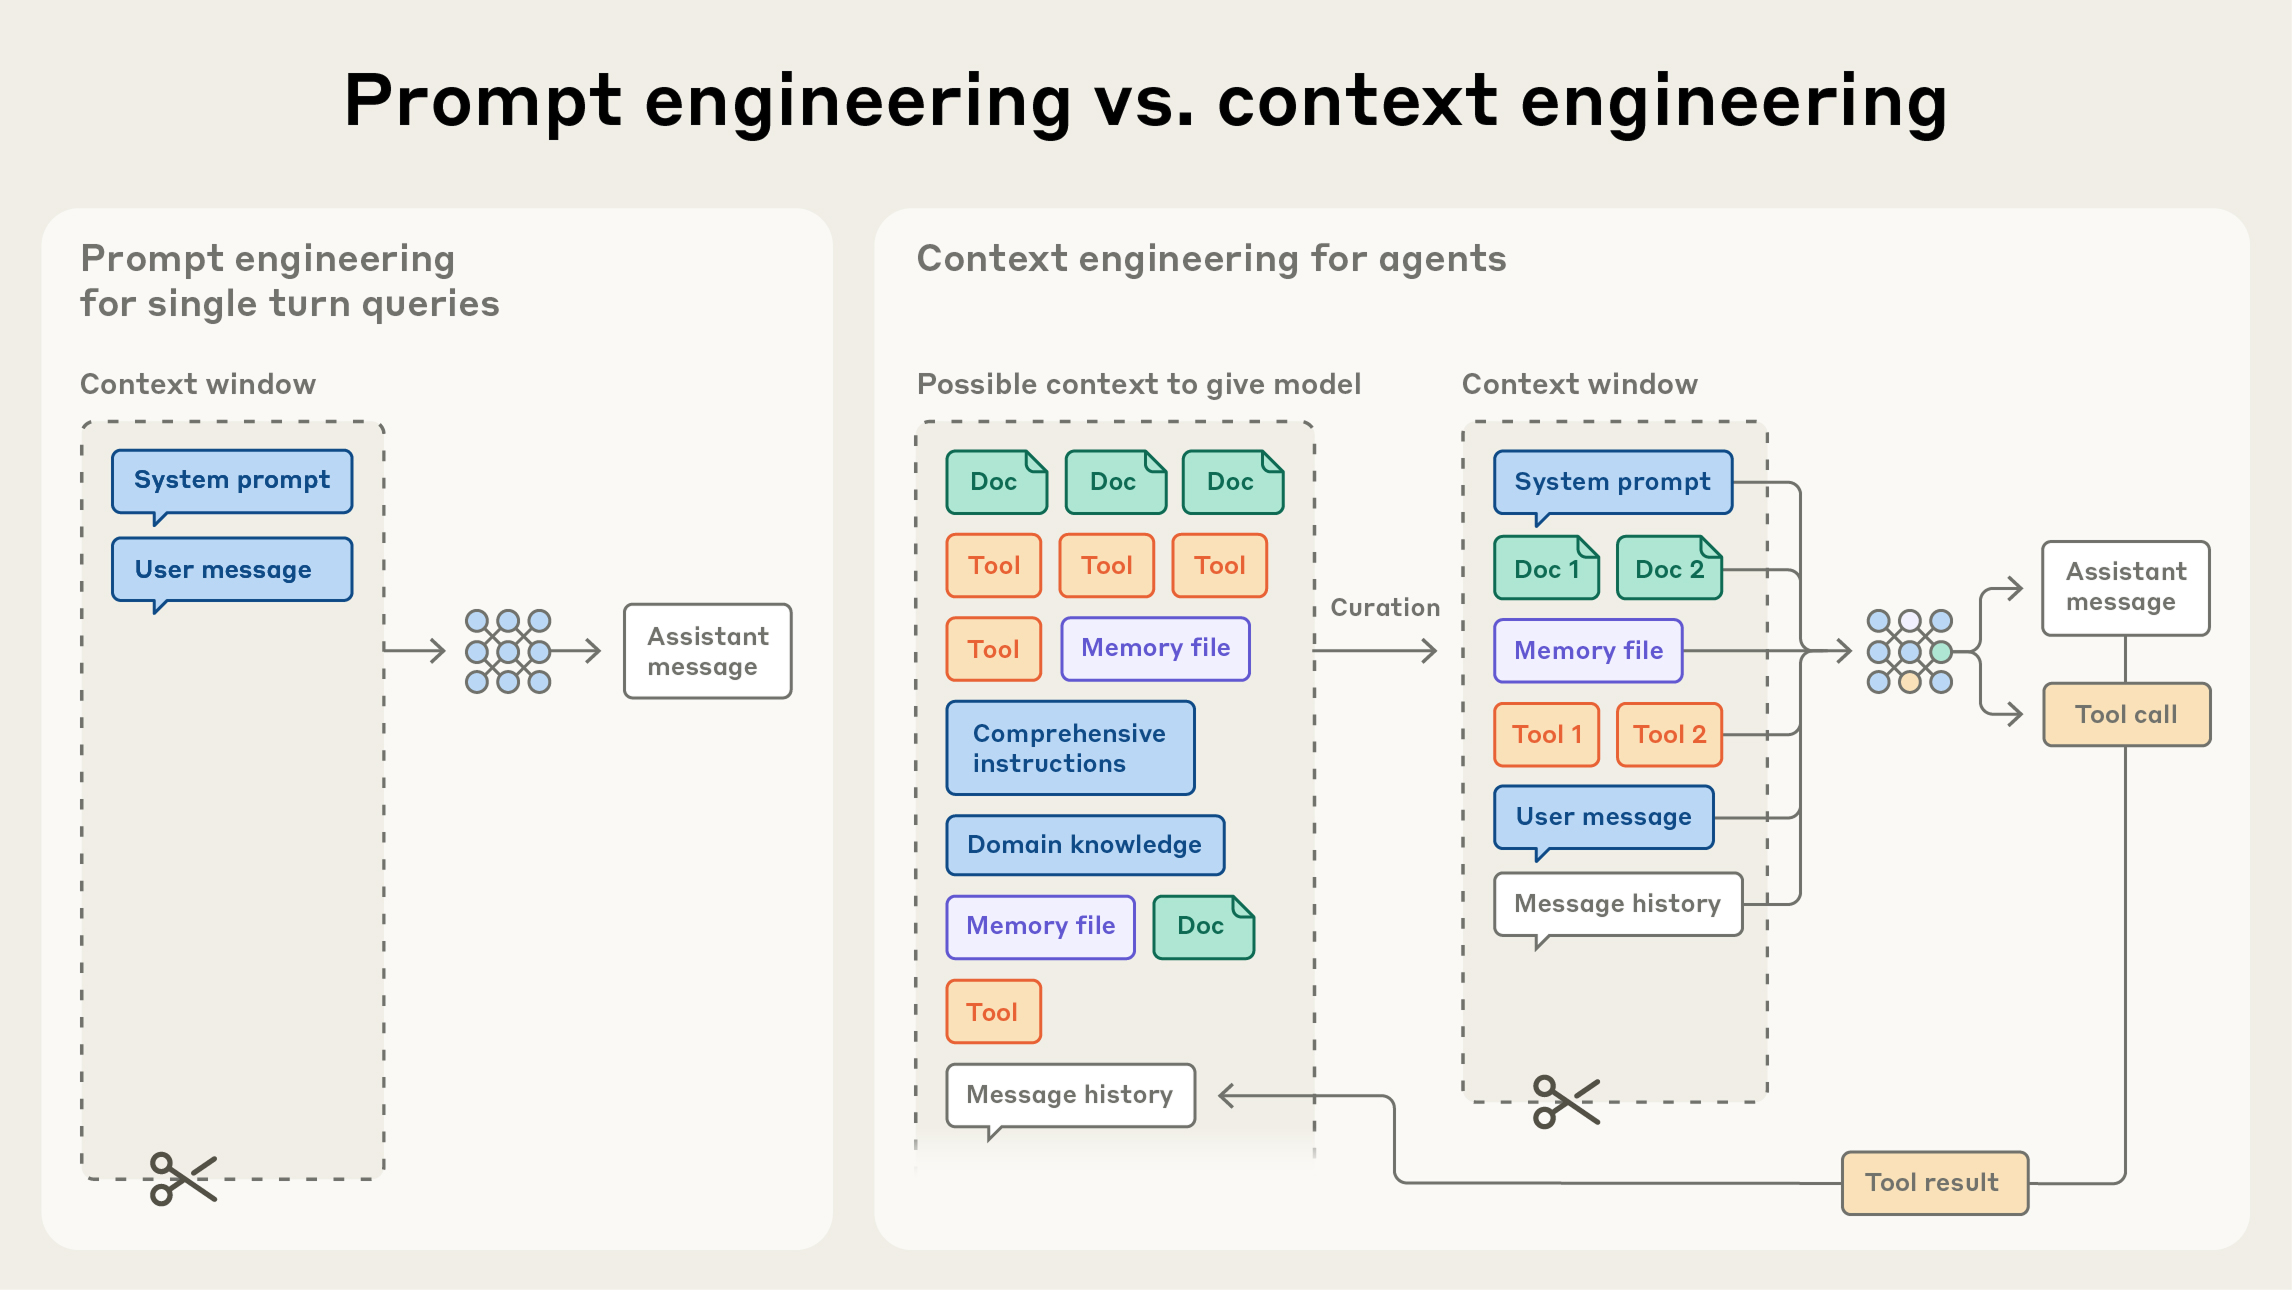
在 Anthropic,我们把上下文工程视为提示工程的自然演进。提示工程指的是为获得最佳结果而编写和组织 LLM 指令的方法(概览和实用的提示工程策略见我们的文档)。上下文工程则指在 LLM 推理过程中,对最优词元(信息)集合进行筛选和维护的一整套策略,其中也包括提示词之外可能进入上下文的所有其他信息。
在使用 LLM 进行工程开发的早期,提示是 AI 工程工作中最大的组成部分,因为日常聊天交互之外的大多数用例,都需要针对一次性分类或文本生成任务优化的提示词。顾名思义,提示工程的主要关注点是如何编写有效的提示词,尤其是系统提示词。然而,随着我们转向构建能力更强、可进行多轮推理并在更长时间跨度上运行的智能体,我们需要能管理整个上下文状态的策略,包括系统指令、工具、Model Context Protocol(MCP)、外部数据、消息历史等。
循环运行的智能体会产生越来越多可能与下一轮推理相关的数据,这些信息必须被周期性地提炼。上下文工程是一门艺术,也是一门科学:它要从这个不断演变的海量可能信息中,筛选出应该进入有限上下文窗口的内容。
为什么上下文工程对构建强大的智能体很重要
尽管 LLM 速度很快,也能处理越来越大的数据量,但我们观察到,LLM 和人类一样,到了某个点就会失去专注或产生混乱。针对“大海捞针”式基准测试的研究揭示了上下文腐化(context rot)的概念:随着上下文窗口中词元数量的增加,模型准确回忆该上下文中信息的能力会下降。
虽然有些模型的性能下降比其他模型更平缓,但这一特性在所有模型中都会出现。因此,必须把上下文视为一种边际收益递减的有限资源。人类的工作记忆容量有限,LLM 同样有一份“注意力预算”,在解析大量上下文时会不断消耗。每引入一个新词元,都会在一定程度上消耗这份预算,这就更需要认真筛选提供给 LLM 的词元。
这种注意力的稀缺源于 LLM 的架构限制。LLM 基于 Transformer 架构,该架构使每个词元都能在整个上下文中关注其他所有词元。对于 n 个词元,这会产生 n² 个两两关系。
随着上下文长度增加,模型捕捉这些两两关系的能力被摊得越来越薄,使上下文规模与注意力集中度之间产生了天然的张力。此外,模型的注意力模式是从训练数据分布中形成的,而在训练数据中,较短的序列通常比较长的序列更常见。这意味着模型对覆盖整个上下文的依赖关系经验较少,用于处理它们的专门参数也较少。
位置编码插值(position encoding interpolation)等技术,通过让模型适应最初训练时使用的较小上下文,使其能处理更长的序列,但代价是对词元位置的理解会有一定程度的下降。这些因素造成的是一个性能梯度,而非陡然的悬崖:模型在较长上下文中仍然能力很强,但与较短上下文相比,信息检索和长程推理的精度可能有所降低。
这些现实意味着,审慎的上下文工程对于构建强大的智能体至关重要。
有效上下文的构成
鉴于 LLM 受限于有限的注意力预算,好的上下文工程意味着找到尽可能小的一组高信号词元,使期望结果出现的可能性最大化。落实这一做法说起来容易做起来难,不过在下面的部分,我们将概述这一指导原则在上下文各个组成部分中的具体含义。
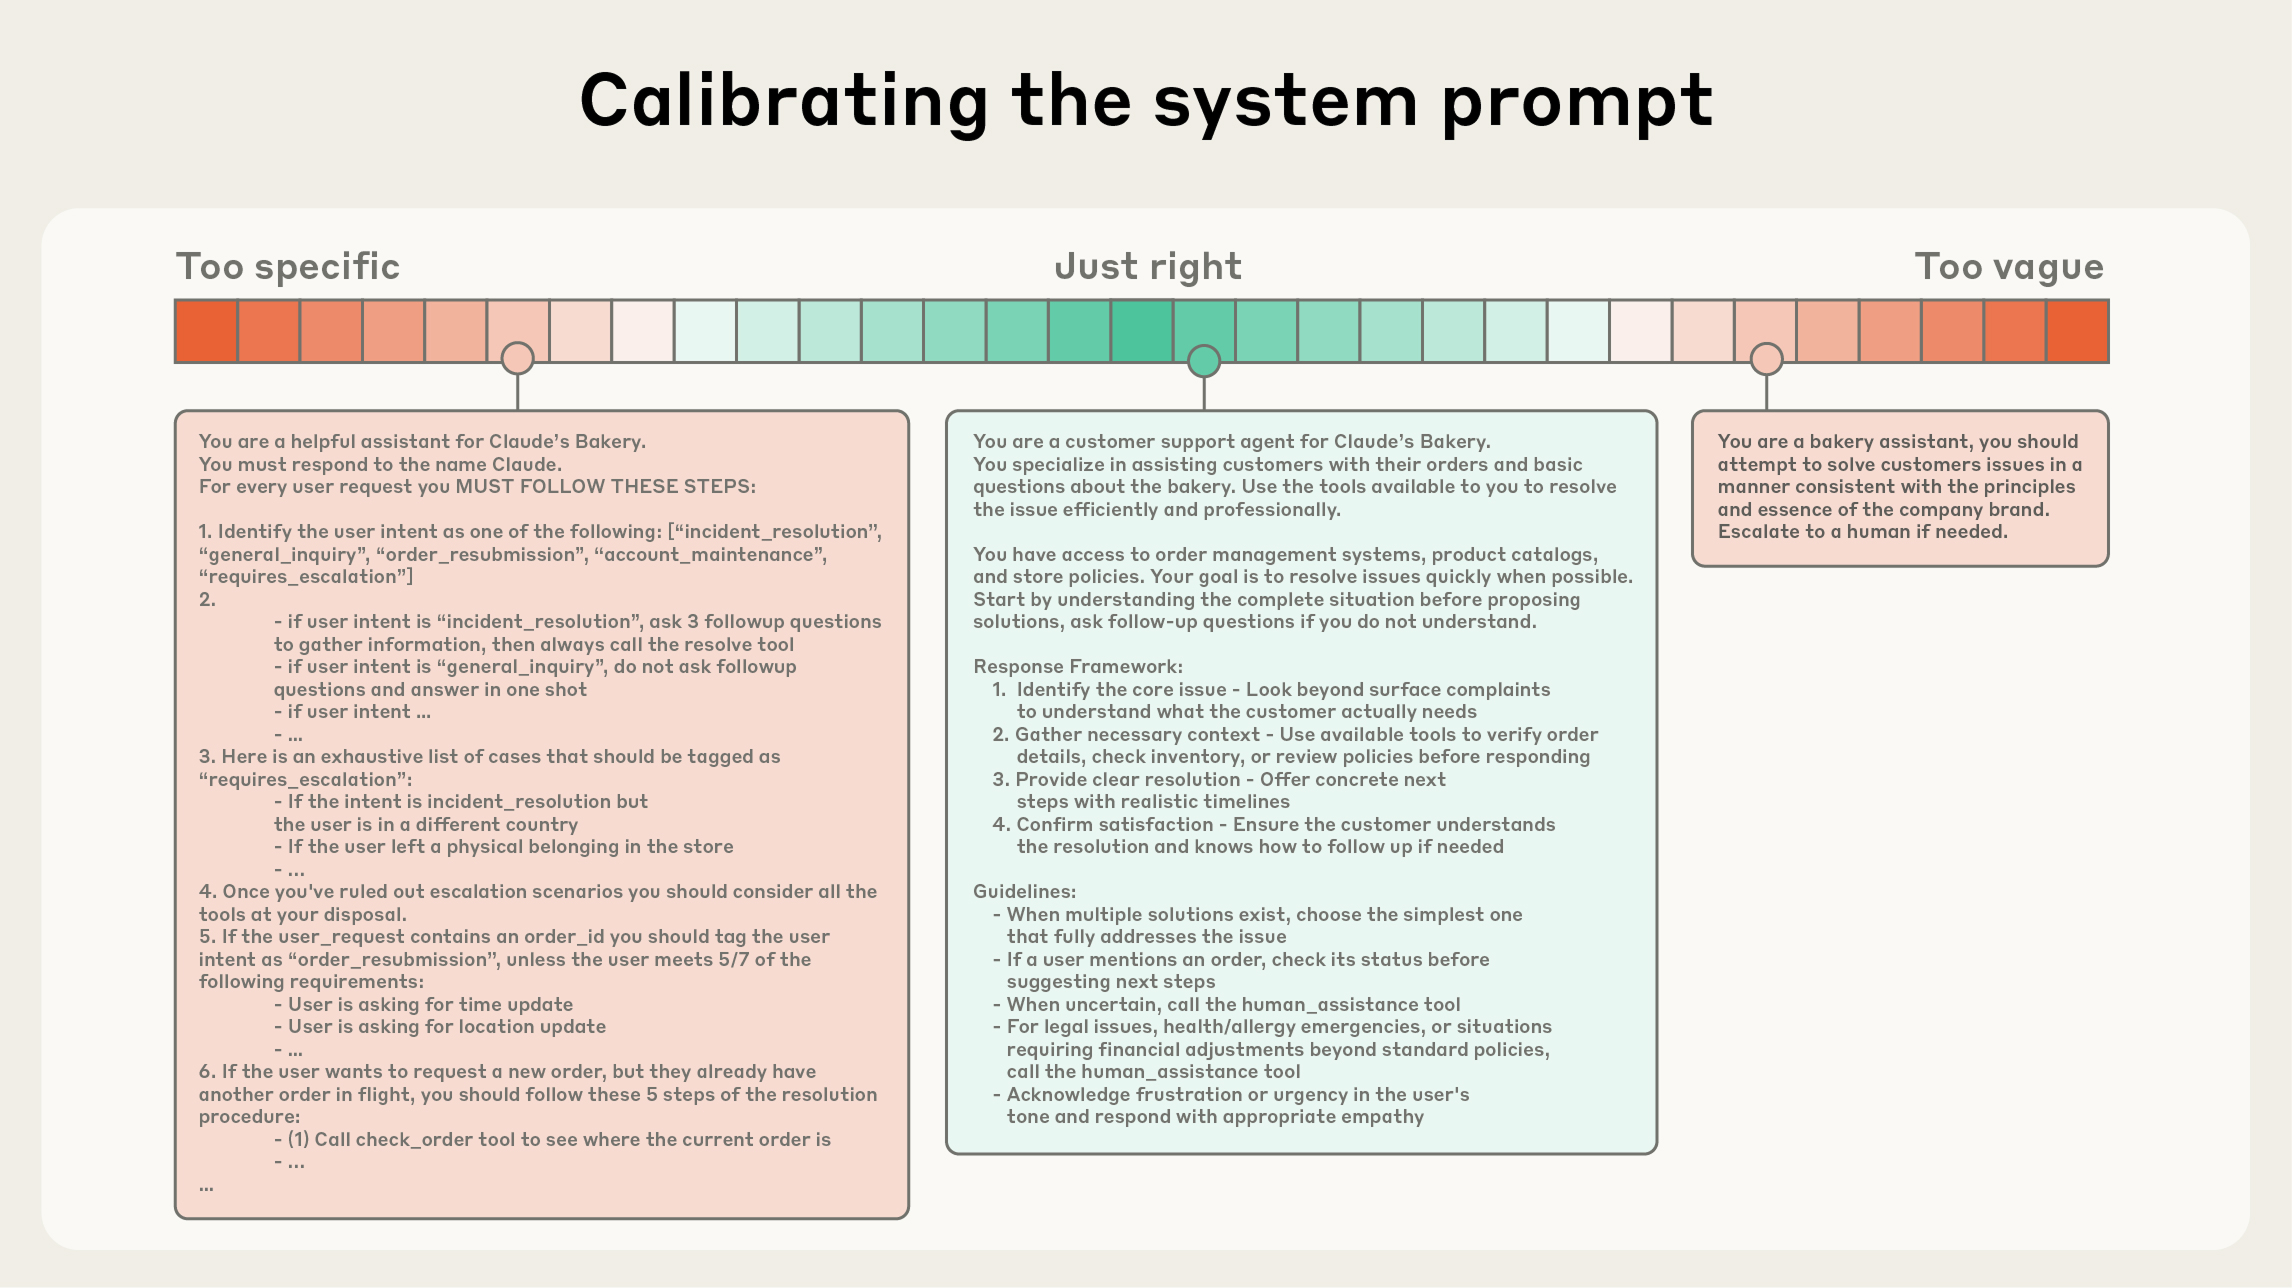
系统提示词应当极其清晰,使用简单直接的语言,并在对智能体而言恰当的高度上表达想法。恰当的高度,是两种常见失败模式之间的“金发姑娘区间”。一个极端是,我们看到工程师在提示词中硬编码复杂而脆弱的逻辑,以期引出精确的智能体行为。这种做法造成脆弱性,并随着时间推移增加维护的复杂度。另一个极端是,工程师有时提供模糊、高层次的指导,既没有给 LLM 提供期望输出的具体信号,又错误地假定双方有共享的上下文。最优的高度需要取得平衡:足够具体,能有效引导行为,又足够灵活,能为模型提供强有力的启发式规则来指导行为。
我们建议把提示词组织成不同的部分(如 <background_information>、<instructions>、## Tool guidance、## Output description 等),并使用 XML 标签或 Markdown 标题等技术来划分这些部分,不过随着模型能力提升,提示词的具体格式可能变得不那么重要了。
无论你如何决定组织系统提示词的结构,都应当力求用最少的信息完整地勾勒出你期望的行为。(注意,最少并不一定意味着简短;你仍然需要预先给智能体足够的信息,以确保它遵循期望的行为。)最好先用现有的最佳模型测试一个最简提示词,看它在你的任务上表现如何,然后根据初期测试中发现的失败模式,添加清晰的指令和示例来改进表现。
工具让智能体能够与环境交互,并在工作过程中拉取新的额外上下文。由于工具定义了智能体与其信息/行动空间之间的契约,因此工具必须提高效率,这一点极为重要,既要返回节省词元的信息,也要鼓励智能体采取高效的行为。
在《Writing tools for AI agents – with AI agents》一文中,我们讨论了如何构建易于被 LLM 理解、功能重叠最少的工具。与设计良好的代码库中的函数类似,工具应当自成一体、对错误具有鲁棒性,并且对其预期用途极为清晰。输入参数同样应当描述性强、含义明确,并发挥模型的固有优势。
我们见到的最常见的失败模式之一,是臃肿的工具集:覆盖的功能过多,或导致在选用哪个工具上出现含糊的决策点。如果人类工程师都无法明确说出在某种情况下该用哪个工具,就不能指望 AI 智能体做得更好。正如后文将讨论的,为智能体精选一个最小可行的工具集,也有助于在长时间交互中更可靠地维护和修剪上下文。
提供示例,也就是所谓的少样本提示(few-shot prompting),是一项广为人知的最佳实践,我们仍然强烈建议使用。然而,团队常常把一长串边缘情况塞进提示词,试图阐明 LLM 在特定任务中应遵循的每一条可能的规则。我们不推荐这样做。相反,我们建议精心挑选一组多样而典型的示例,有效呈现智能体的预期行为。对 LLM 来说,示例就是价值千言的“图画”。
我们对上下文各个组成部分(系统提示词、工具、示例、消息历史等)的总体建议是:深思熟虑,让上下文信息丰富而又精简。接下来,我们深入探讨如何在运行时动态检索上下文。
上下文检索与智能体式搜索
在《Building effective AI agents》一文中,我们强调了基于 LLM 的工作流与智能体之间的区别。自从写下那篇文章以来,我们倾向于对智能体采用一个简单的定义:LLM 在循环中自主使用工具。
在与客户合作的过程中,我们看到业界正向这一简单范式靠拢。随着底层模型能力增强,智能体的自主程度也可以随之提升:更聪明的模型使智能体能够独立探索微妙复杂的问题空间,并从错误中恢复。
如今,我们看到工程师设计智能体上下文的思路正在转变。现在,许多 AI 原生应用采用某种基于嵌入的推理前检索,把重要的上下文提取出来,供智能体推理。随着业界转向更具智能体特性的方法,我们越来越多地看到团队用“即时”(just in time)上下文策略来增强这些检索系统。
采用“即时”方法构建的智能体,不会预先处理所有相关数据,而是保留轻量级的标识符(文件路径、已存储的查询、网页链接等),并借助这些引用,在运行时通过工具把数据动态加载到上下文中。Anthropic 的智能体式编程方案 Claude Code 就采用这种方法,对大型数据库执行复杂的数据分析。模型可以编写有针对性的查询、存储结果,并利用 head 和 tail 等 Bash 命令分析海量数据,而无需把完整的数据对象加载到上下文中。这种方法与人类的认知方式相似:我们通常不会死记硬背整个信息语料库,而是引入文件系统、收件箱和书签等外部的组织与索引系统,按需检索相关信息。
除了存储效率之外,这些引用的元数据还提供了一种有效优化行为的机制,无论是明确提供的还是直观可得的。对于在文件系统中运行的智能体来说,tests 文件夹中出现名为 test_utils.py 的文件,与位于 src/core_logic/ 中的同名文件所暗示的用途不同。文件夹层级、命名约定和时间戳都提供了重要信号,帮助人类和智能体理解该如何、何时使用信息。
让智能体自主导航和检索数据,还能实现渐进式披露(progressive disclosure),也就是让智能体通过探索逐步发现相关上下文。每一次交互产生的上下文都会为下一个决策提供依据:文件大小暗示复杂度,命名约定提示用途,时间戳可以作为相关性的代理指标。智能体可以逐层构建理解,只在工作记忆中保留必要的内容,并借助笔记策略获得额外的持久性。这种自我管理的上下文窗口让智能体专注于相关的子集,而不是淹没在详尽却可能无关的信息之中。
当然,这里存在权衡:运行时探索比检索预先计算好的数据更慢。不仅如此,还需要有主见且深思熟虑的工程设计,才能确保 LLM 拥有合适的工具和启发式规则,以有效地在其信息空间中导航。如果没有适当的引导,智能体可能会因误用工具、陷入死胡同或未能识别关键信息而浪费上下文。
在某些场景下,最有效的智能体可能采用混合策略:为了速度预先检索一部分数据,同时视情况自行决定进一步的自主探索。“合适”的自主程度的决策边界取决于任务。Claude Code 就是采用这种混合模式的智能体:CLAUDE.md 文件会被直接预先放入上下文,而 glob 和 grep 等原语则让它能够在环境中导航并即时检索文件,从而有效绕开了索引过时和语法树复杂的问题。
混合策略可能更适合内容变化较少的场景,例如法律或金融工作。随着模型能力的提升,智能体设计将趋向于让聪明的模型自主发挥智能,所需的人工筛选也会越来越少。鉴于该领域进展迅速,“做最简单且可行的事”很可能仍是我们给基于 Claude 构建智能体的团队的最佳建议。
面向长时程任务的上下文工程
长时程任务要求智能体在一系列动作中保持连贯性、上下文和目标导向的行为,而这些动作的词元总数超出了 LLM 的上下文窗口。对于持续数十分钟到数小时连续工作的任务,例如大型代码库迁移或全面的研究项目,智能体需要专门的技术来绕过上下文窗口大小的限制。
等待更大的上下文窗口似乎是一个显而易见的策略。但在可预见的未来,各种大小的上下文窗口很可能都会受到上下文污染和信息相关性问题的影响,至少在需要最强智能体表现的情况下是如此。为了让智能体能够在较长时间跨度内有效工作,我们开发了几种直接应对这些上下文污染限制的技术:压缩(compaction)、结构化笔记,以及多智能体架构。
压缩
压缩是指,当对话接近上下文窗口上限时,对其内容进行总结,并用这份摘要重新开启一个新的上下文窗口。压缩通常是上下文工程中提升长期连贯性的第一个杠杆。其核心在于以高保真的方式提炼上下文窗口的内容,使智能体能够在性能损失最小的情况下继续工作。
例如在 Claude Code 中,我们的实现方式是把消息历史交给模型,让它总结并压缩最关键的细节。模型会保留架构决策、未解决的 bug 和实现细节,同时丢弃冗余的工具输出或消息。随后,智能体可以带着这份压缩后的上下文,加上最近访问的五个文件继续工作。用户获得了连续性,而不必担心上下文窗口的限制。
压缩的艺术在于取舍:保留什么、丢弃什么。过于激进的压缩可能导致丢失细微却关键的上下文,而这些上下文的重要性要到后来才会显现。对于实现压缩系统的工程师,我们建议在复杂的智能体轨迹上仔细调校你的提示词。先从最大化召回率入手,确保压缩提示词捕获轨迹中的每一条相关信息,然后通过剔除多余内容来迭代提升精确率。
一个容易下手的多余内容例子是清除工具调用及其结果:一旦某个工具在消息历史深处被调用过,智能体为什么还需要再次看到原始结果?最安全、最轻量的压缩形式之一就是清除工具结果,最近我们已将其作为 Claude 开发者平台上的一项功能推出。
结构化笔记
结构化笔记,或称智能体记忆,是一种让智能体定期把笔记写入上下文窗口之外的持久化存储的技术。这些笔记会在之后被重新拉回上下文窗口。
这种策略以极小的开销提供了持久记忆。无论是 Claude Code 创建待办事项列表,还是你的自定义智能体维护一个 NOTES.md 文件,这种简单的模式都让智能体能够在复杂任务中跟踪进度,保留那些否则会在几十次工具调用中丢失的关键上下文和依赖关系。
Claude 玩宝可梦展示了记忆如何改变智能体在非编程领域的能力。该智能体在数千个游戏步骤中保持精确的计数,追踪诸如“在过去的 1,234 步里,我一直在 1 号道路训练我的宝可梦,皮卡丘已经提升了 8 级,目标是 10 级”这样的目标。在没有任何关于记忆结构的提示下,它自行绘制了已探索区域的地图,记住自己解锁了哪些关键成就,并维护战斗策略的笔记,帮助自己了解哪些招式对不同对手最有效。
上下文重置后,智能体会读取自己的笔记,继续持续数小时的训练序列或地下城探索。这种跨越多次总结步骤的连贯性,使得长时程策略成为可能,而仅靠把所有信息保存在 LLM 的上下文窗口中,这是不可能做到的。
作为 Sonnet 4.5 发布的一部分,我们在 Claude 开发者平台上以公开测试版发布了记忆工具,通过基于文件的系统,让在上下文窗口之外存储和查阅信息变得更加容易。这使智能体能够随时间积累知识库,跨会话保持项目状态,并在不必把所有内容都保留在上下文中的情况下参考以往的工作。
子智能体架构
子智能体架构提供了另一种绕开上下文限制的方式。与其让一个智能体试图在整个项目中维持状态,不如让专门的子智能体在干净的上下文窗口中处理聚焦的任务。主智能体用高层计划进行协调,而子智能体负责深入的技术工作,或借助工具查找相关信息。每个子智能体可能会进行大量探索,使用数万词元甚至更多,但只返回其工作的精简提炼摘要(通常为 1,000 至 2,000 个词元)。
这种方法实现了清晰的关注点分离:详细的搜索上下文被隔离在子智能体内部,而主导智能体则专注于综合与分析结果。《How we built our multi-agent research system》中讨论的这一模式,在复杂研究任务上相比单智能体系统有显著提升。
在这些方法之间如何选择,取决于任务特点。例如:
- 压缩适合需要大量往复交流的任务,能保持对话的流畅;
- 笔记适合有明确里程碑的迭代式开发;
- 多智能体架构适合复杂的研究和分析,在这类场景中并行探索会带来回报。
即使模型不断改进,在长时间交互中保持连贯性的挑战,仍将是构建更有效智能体的核心。
结论
上下文工程代表了我们使用 LLM 进行构建的方式发生了根本转变。随着模型变得更强大,挑战不再仅仅是撰写完美的提示词,而是审慎地筛选每一步有哪些信息进入模型有限的注意力预算。无论你是在为长时程任务实现压缩、设计节省词元的工具,还是让智能体即时探索其环境,指导原则始终不变:找到最小的一组高信号词元,使期望结果出现的可能性最大化。
我们所概述的这些技术会随着模型的改进而持续演进。我们已经看到,更聪明的模型需要更少的规定性工程,使智能体能以更高的自主性运行。但即便能力不断扩展,把上下文视为珍贵而有限的资源,仍将是构建可靠、有效智能体的核心。
立即在 Claude 开发者平台上开始使用上下文工程,并通过我们的记忆与上下文管理 cookbook 获取有用的技巧和最佳实践。
致谢
本文由 Anthropic 应用 AI 团队的 Prithvi Rajasekaran、Ethan Dixon、Carly Ryan 和 Jeremy Hadfield 撰写,团队成员 Rafi Ayub、Hannah Moran、Cal Rueb 和 Connor Jennings 也有贡献。特别感谢 Molly Vorwerck、Stuart Ritchie 和 Maggie Vo 的支持。