摘要
多租户 GPU 集群让 AI 原生公司可以在团队之间共享算力,同时不牺牲隔离性与控制力。合理的架构是在基础设施层汇聚 GPU,同时为每个团队提供专属节点、存储和自助调度,既消除闲置容量的浪费,又避免真正共享基础设施所带来的内部博弈。本指南涵盖核心设计原则、常见失败模式,以及 Together AI 等平台在实践中如何实现多租户。
为什么多租户 GPU 集群设计是 AI 原生公司的核心基础设施问题
AI 原生公司的扩张速度超过了其基础设施策略的跟进速度。每个新团队都会启动新的模型实验和训练任务,并对共享算力提出需求。AI 平台工程师对此再熟悉不过:组织对 GPU 的需求不断叠加,而 GPU 依然稀缺且昂贵。
人们的本能往往是隔离,即给每个团队各自的集群和资源。但这种做法在经济上无法扩展。专属集群会在夜间、周末以及训练任务提前结束时闲置。你为没人使用的容量付费,而其他团队却在排队等待自己无法使用的资源。
更好的架构是共享,但要让团队感觉集群就是自己的。这就是 AI 原生规模下多租户的核心设计挑战:享受池化带来的经济性,却没有池化带来的混乱。
什么是多租户 GPU 集群?
多租户 GPU 集群是一种共享计算环境,多个团队在同一套底层硬件上运行,同时保持合理的隔离,包括数据访问边界、凭据、存储卷和计费可见性。
与传统的共享集群不同,多租户集群保证隔离。在设计良好的多租户集群中,一个团队的训练任务不会影响另一个团队。硬性配额、预留窗口和调度护栏可以防止资源过度使用演变成跨团队问题——当模型、推理和研究团队都在争抢同一批 GPU 时,这一点至关重要。
多租户的核心要求是什么?
要让多租户行之有效,需要同时满足三项要求:
- 池化容量:跨团队共享一个统一议定的 GPU 池,可以消除闲置容量的浪费。只有在训练、微调和推理等各类工作负载之间汇总 GPU 利用率,而不是按团队隔离时,单位经济性才成立。
- 租户隔离:每个团队都需要专属节点、专属存储、独立凭据,以及直接面向租户的计费可见性。当每个租户都觉得自己在运营独立的集群,并且有任何相邻工作负载都无法越过的清晰边界时,共享基础设施的效果最好。
- 自助访问:团队需要能直接预订容量、查看实时可用情况,并在几分钟而不是几天内拉起环境。
应该如何构建基础设施层?
对 AI 原生基础设施而言,最清晰的模式是两层:底层是共享基础设施,上层是每个租户各自的基础设施。
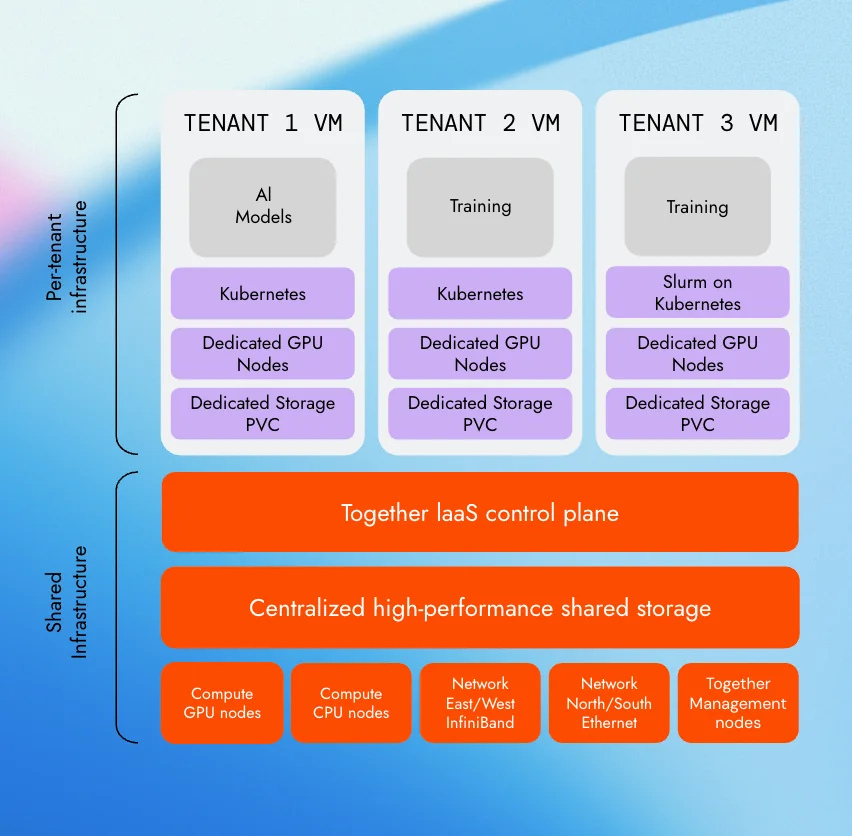
在共享层,集中式控制平面位于高性能共享存储和统一网络结构之上,集群内东西向流量通常使用 InfiniBand(这对大规模分布式训练至关重要),南北向流量使用以太网。GPU 和 CPU 计算节点由中心统一管理,Together AI 的 IaaS 控制平面就是这一模式的优秀参考实现。
在这一共享基础之上,每个团队获得完全隔离的虚拟环境:专属 GPU 节点、专属存储 PVC,以及可按工作负载类型自选的编排层——Kubernetes、Slurm 或其他配置。运行基础模型训练、微调或推理工作负载的团队各自在自己的集群中运行,完全看不到相邻租户。
Together AI 的多租户集群就是这一模式的具体实现,展示了裸金属性能加云般灵活性在 AI 原生团队实践中的样子,并按实际用量直接向每个租户计费。
如何防止某个团队占满所有 GPU 容量?
这正是基于配额的分配在任何 AI 原生环境中不可或缺的原因。管理员为每个团队设置护栏,按 GPU 数量、总支出或预留窗口时长设定上限,并在调度器层面强制执行,而不仅仅是一项软性策略。
调度器还应处理内置冲突预防的提前预订。团队为特定时间窗口预留集群(比如为期一个月的预训练,或两周的微调冲刺),系统会防止重复预订。实时容量可用情况会显示在界面中,让团队在承诺之前就能看清有哪些可用资源。具备容量感知的调度意味着可预测的规划:运行中途不会出现意外或跨团队干扰。
对于需要突破配额进行突发使用的团队,合理的设计应支持自动溢出到按需公开价格。Together AI 无需管理员审批即可处理这种情况,因此生产节奏不会被基础设施的繁文缛节拖慢。
多租户平台应为 AI 团队提供怎样的配置灵活性?
共享基础设施的一种常见失败模式是带有强烈倾向性的默认配置。强制指定编排层、驱动版本或存储配置的平台会带来隐性的取舍——AI 原生团队最终是让自己的工作流去适应平台,而不是平台适应团队,这恰恰本末倒置。
正确的模式是在预订时按需选配:编排层、CUDA 驱动版本、共享内存大小和存储卷,全部由团队根据自己的工作负载需求指定。没有默认配置,也没有被迫的取舍。在 Slurm 上微调 Llama 的团队,不应该被迫使用与在 Kubernetes 上提供推理端点的团队相同的配置。
集群一旦开通,应当支持自动创建和销毁,通过 Grafana 提供开箱即用的可观测性,并可立即进行 SSH 访问。
在多租户环境中,GPU 健康检查和节点修复应如何运作?
共享集群中的硬件故障会产生连锁反应。它们不只影响一个训练任务,还可能在共享同一物理层的各团队之间级联扩散。必须有一套健全的健康检查与修复生命周期。
最佳实践是在每个节点交付给租户集群之前自动进行验收测试。测试应包括 DCGM 诊断、GPU 烧机测试、单节点和多节点 NCCL 测试,以及覆盖 CPU-GPU 延迟和带宽维度的 NVBandwidth 测量。
团队还应能在集群生命周期的任何时刻,直接从界面触发按需健康检查,而不仅仅是在开通时。检测到问题时,响应应分级:软件问题触发快速重新开通,硬件故障则进行集群迁移。在整个修复生命周期中,租户都应完全可见——不用去猜训练变慢究竟是模型问题还是节点问题。
多租户 GPU 基础设施适合你的团队吗?
当你有多个 AI 团队,工作负载各不相同——基础模型训练、微调、推理和研究——并且同时运行时,多租户集群能带来最大的价值。对 AI 原生组织而言,从账面上看,池化优势明显。
关键问题不在于是否共享基础设施,而在于你的 AI 平台把隔离执行得有多好。当流程顺畅运转时,你既能获得数据中心级的单位经济性,又没有公有云在性能上的妥协,还能拥有 AI 原生团队所期望的自助服务速度。
立即开始在多租户 GPU 基础设施上构建
Together 的多租户集群专为需要共享 GPU 基础设施却不想共享烦恼的 AI 原生组织打造。汇聚你的容量,隔离你的团队,以模型所需的速度前进。
常见问题
多租户集群中的团队能看到彼此的模型、数据或训练任务吗?
不能,在架构正确的环境中不能。每个租户都使用专属 GPU 节点、专属存储卷和独立凭据运行。
当团队需要的容量超出配额时会怎样?
设计良好的平台支持在团队超出其池分配额度时自动突发到按需价格,无需管理员手动审批。AI 原生的节奏不应在计划容量的边缘被基础设施的繁文缛节拖慢。
多租户平台应为 AI 工作负载支持哪些编排框架?
至少要支持:用于推理和服务的 Kubernetes,以及用于分布式训练的 Kubernetes 上的 Slurm。AI 原生团队往往需要两者同时运行,因此平台需要支持混合配置