模态很重要
一个 100 万 token 的文本提示词,能装下整套《哈利·波特》,体积却只有大约 5 MB。这个规模听起来庞大,但输入本身其实很紧凑。文本到手后几乎可以直接推理:分词、批处理,然后送入模型即可。
音频改变了问题的形态。同一套《哈利·波特》若是有声书,体积为 5 到 10 GB,比文本大了大约三个数量级。在这些数据抵达 GPU 之前,服务器还得先解码容器格式、重采样、滤除噪声、运行 VAD、切分语音,并计算音频特征。
模型这一侧的情况也反过来了。如今的 LLM 动辄有数千亿乃至万亿参数,所以服务端的工作自然集中在 GPU 内部:量化、KV 缓存、注意力内核、批处理和并行。而语音转文本模型要小得多,通常只有数亿到几十亿参数,因此周边的数据通路重要得多。
这使得 ASR 服务成为一个贯穿全链路的系统问题,涉及 GPU 执行、CPU 预处理、内存搬运、传输、连接调度和运行时行为。同一套技术栈还得同时应对两种不同的场景:离线转写最看重吞吐量,流式转写则由延迟和抖动主导。
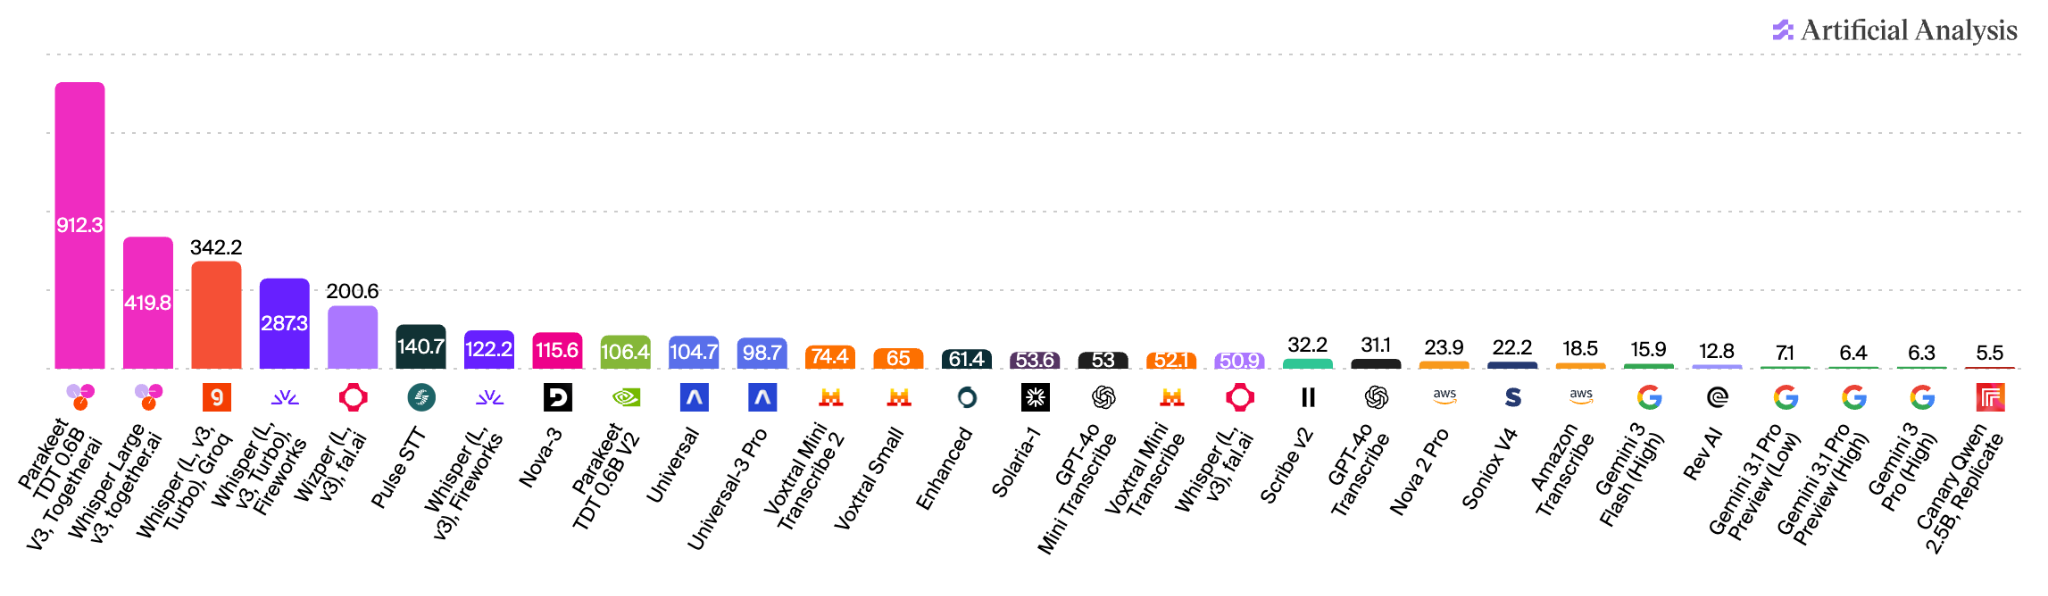
Together 的 ASR 技术栈提供了 Artificial Analysis 排名中延迟最低的两个语音转文本模型:NVIDIA 的 Parakeet-TDT 0.6B v3 和 OpenAI 的 Whisper Large v3。两者中更快的 NVIDIA Parakeet-TDT 0.6B v3,能在 10 秒内转写大约 20 小时的语音,差不多是《哈利·波特》系列电影的总时长。
本文接下来将拆解这一成绩背后的生产环境改动:针对真实音频形状的 TensorRT profile、GPU 侧的解码器控制流、更少拷贝的 CPU 路径、事件驱动的流式 I/O,以及运行时的 GC 控制。
针对真实音频形状编译编码器
Parakeet 采用编码器-解码器架构,大约 95% 的权重位于编码器中。编码器接收变长的语音片段,并为解码器生成声学帧,因此它是我们最先优化的地方。
音频输入的长度跨度很大,从 200 ms 的流式数据包到 30 秒不间断的语音都有。针对某一种输入形状调好的内核计划,换到另一种形状时可能慢很多,所以引擎在编译时就需要知道它将遇到的形状分布。
在使用 TensorRT 之前,我们已经在用带有 torch.compile 和 CUDA graph 的优化版 PyTorch 路径,并针对同样的形状 profile 做了调优。这为我们提供了一条很强的基线:不离开 PyTorch 技术栈,也能做到感知 profile 的执行。
TensorRT 为生产环境带来了更快的编码器路径。它会提前构建优化的执行计划:尽可能融合内核、调优内存布局,并针对我们预期要服务的形状范围对各种内核变体做基准测试。
关键细节在于 profile 调优。如果只针对最大输入形状调优一个引擎,较短的音频片段就只能走填充(padding)路径,这对流式分块和短语音的代价尤其高。多 profile 的 TensorRT 引擎让我们在内存中只保留一份编码器权重,同时按请求选择合适的优化 profile。
内存节省不算多,大约从 6 GB 降到 5 GB。更大的收益在于避免了不合适的形状匹配,并且让调优过的 profile 从优化版 PyTorch 迁移到了 TensorRT。在小输入场景下,感知 profile 的 TensorRT 可以比把这些请求送进一个大的填充 profile 快好几倍。
编码器优化完毕后,解码器循环成了下一个瓶颈。
把 CPU 从解码器循环中移除
Parakeet 的解码器会遍历编码器输出的声学帧,对于不推进转写内容的帧,则输出一个 token 或 BLANK。代码大致如下:
state = init()
for frame in encoder_output:
token = predict(frame, state)
if token != BLANK:
emit(token)
state = update(state, token)
做性能分析时我们发现,predict 和 update 都很快,每次迭代的 GPU 工作耗时以微秒计。
真正耗时的是这一行分支:
if token != BLANK:
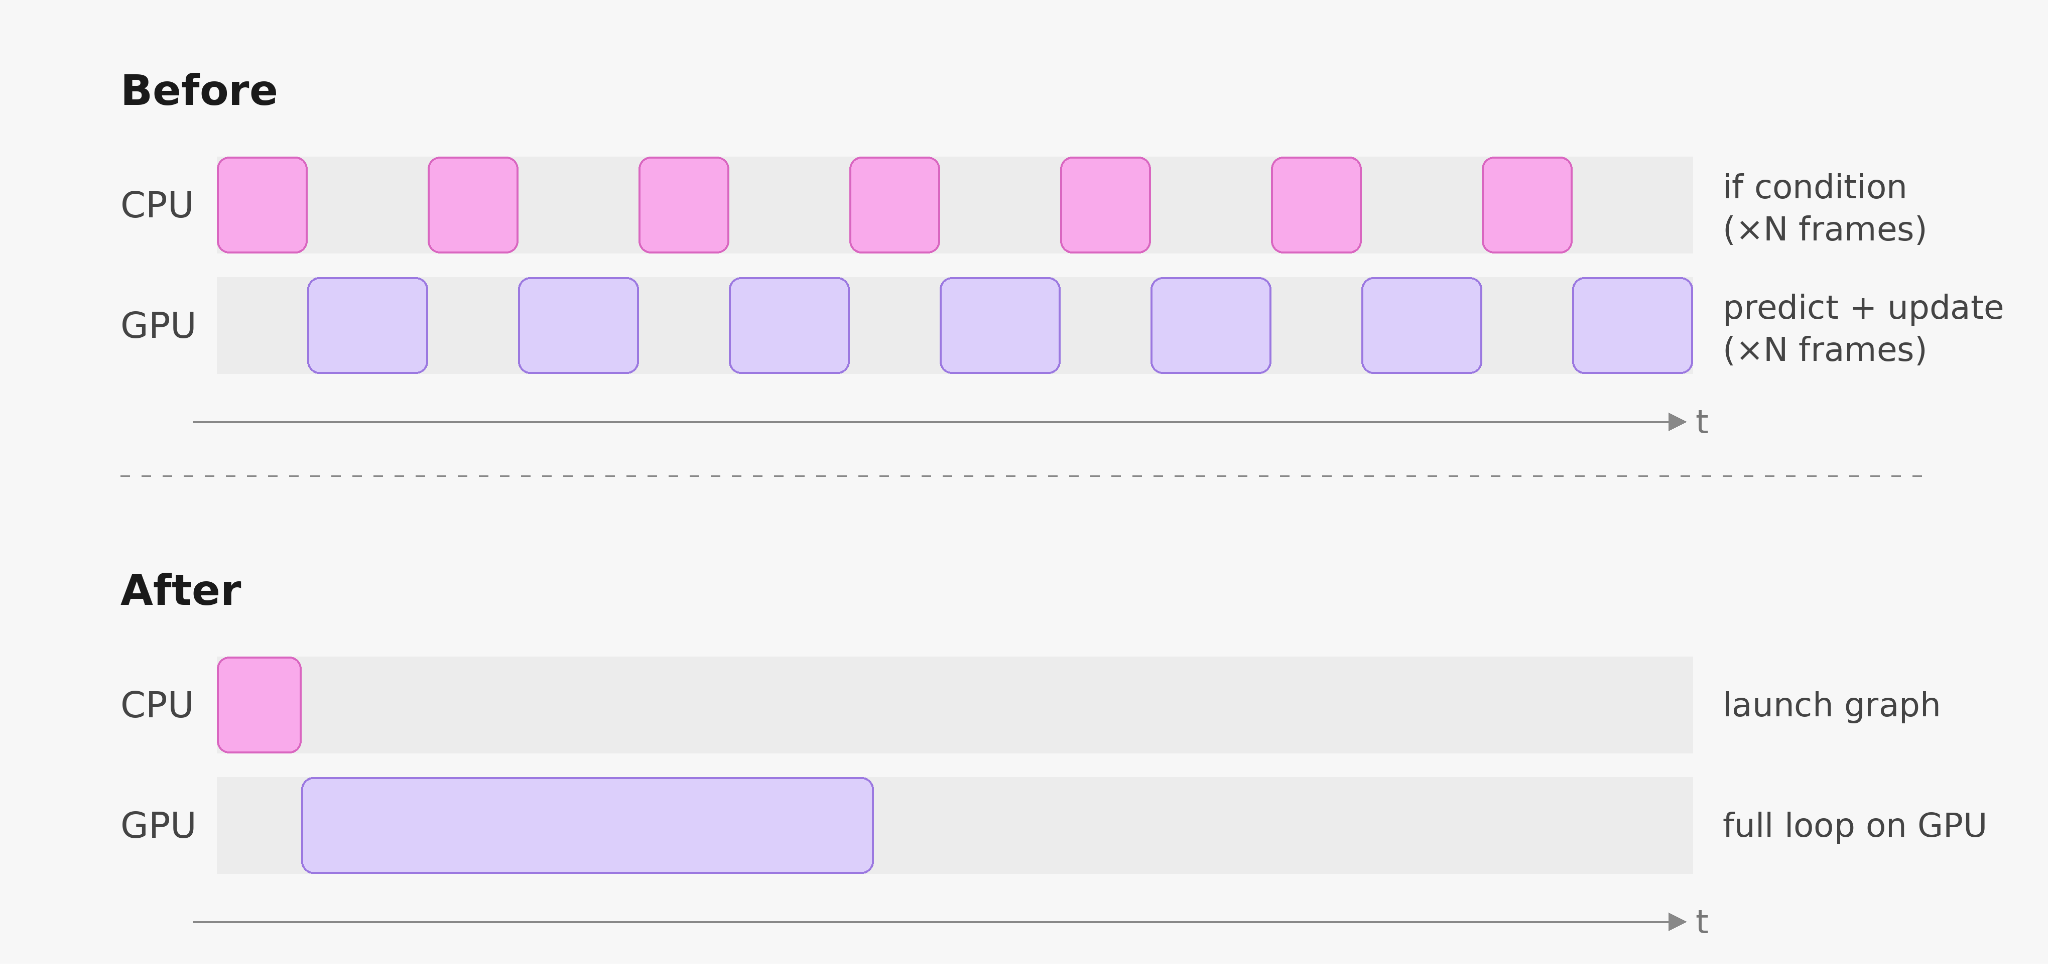
这个分支需要 CPU 从 GPU 内存中读回 token,才能决定走哪条路径。这种主机同步使解码循环无法被捕获为单个 CUDA graph,并迫使每次迭代都要经过 Python 往返一趟。GPU 做几微秒的工作,然后等 CPU,再启动下一个内核,如此循环往复,每个请求要重复成千上万次。
条件式 CUDA graph 节点把这个分支搬到了 GPU 上。一个很小的设备端内核负责判断条件,并告诉 CUDA 运行时是否进入输出 token 和更新状态的子图。分支判断无需离开 GPU,因此整个解码器循环,包括计数器、条件判断、输出和状态更新,都可以被捕获并作为一个 CUDA graph 启动。
CPU 退出了解码器的内层循环,结果是解码器提速 2 到 3 倍。
不再拷贝音频字节
编码器和解码器都跑得很好之后,剩下的延迟来自模型周围的 CPU 路径。在我们审查过的大多数 ASR 代码中,延迟预算都花在了这里:冗余的拷贝、热路径上不必要的进程跳转,以及本可从更高并行度中受益的单线程函数。
第一个着力点是消除不必要的进程边界。
音频预处理,无论是文件解码、重采样、语音活动检测(VAD)、特征提取还是分块处理,大多是 I/O 或原生 C/C++ 工作,会释放 Python 全局解释器锁(GIL)。典型的微服务架构会把预处理拆到三四个独立进程中,为这个工作负载并不需要的隔离性白白付出代价。把大部分工作合并到更少的进程中,可以去掉内核拷贝以及序列化/反序列化环节,这些开销在大文件上可能高达数百毫秒。
在确实需要进程间通信时,ZeroMQ 这类常见方案同样有不小的开销。在我们的工作负载中,基于持久 Unix 域套接字、传输原始音频字节的简单自定义协议,在高并发下表现最好,因为它让帧格式保持最简,还避免了反复建立连接。
对于大文件,套接字仍然要拷贝两次:发送方用户空间到内核缓冲区,再从内核缓冲区到接收方用户空间。为了避开这条路径,我们使用共享内存。有了共享内存,两个进程映射同一块物理区域,生产者写入的数据无需经过内核往返,消费者就能看到。这就是一条零拷贝的数据通路。
复杂度的代价是实实在在的,所以只有数据量值得时,才值得用共享内存。
流式场景使用事件驱动 I/O
流式 ASR 还带来另一个问题:连接生命周期。
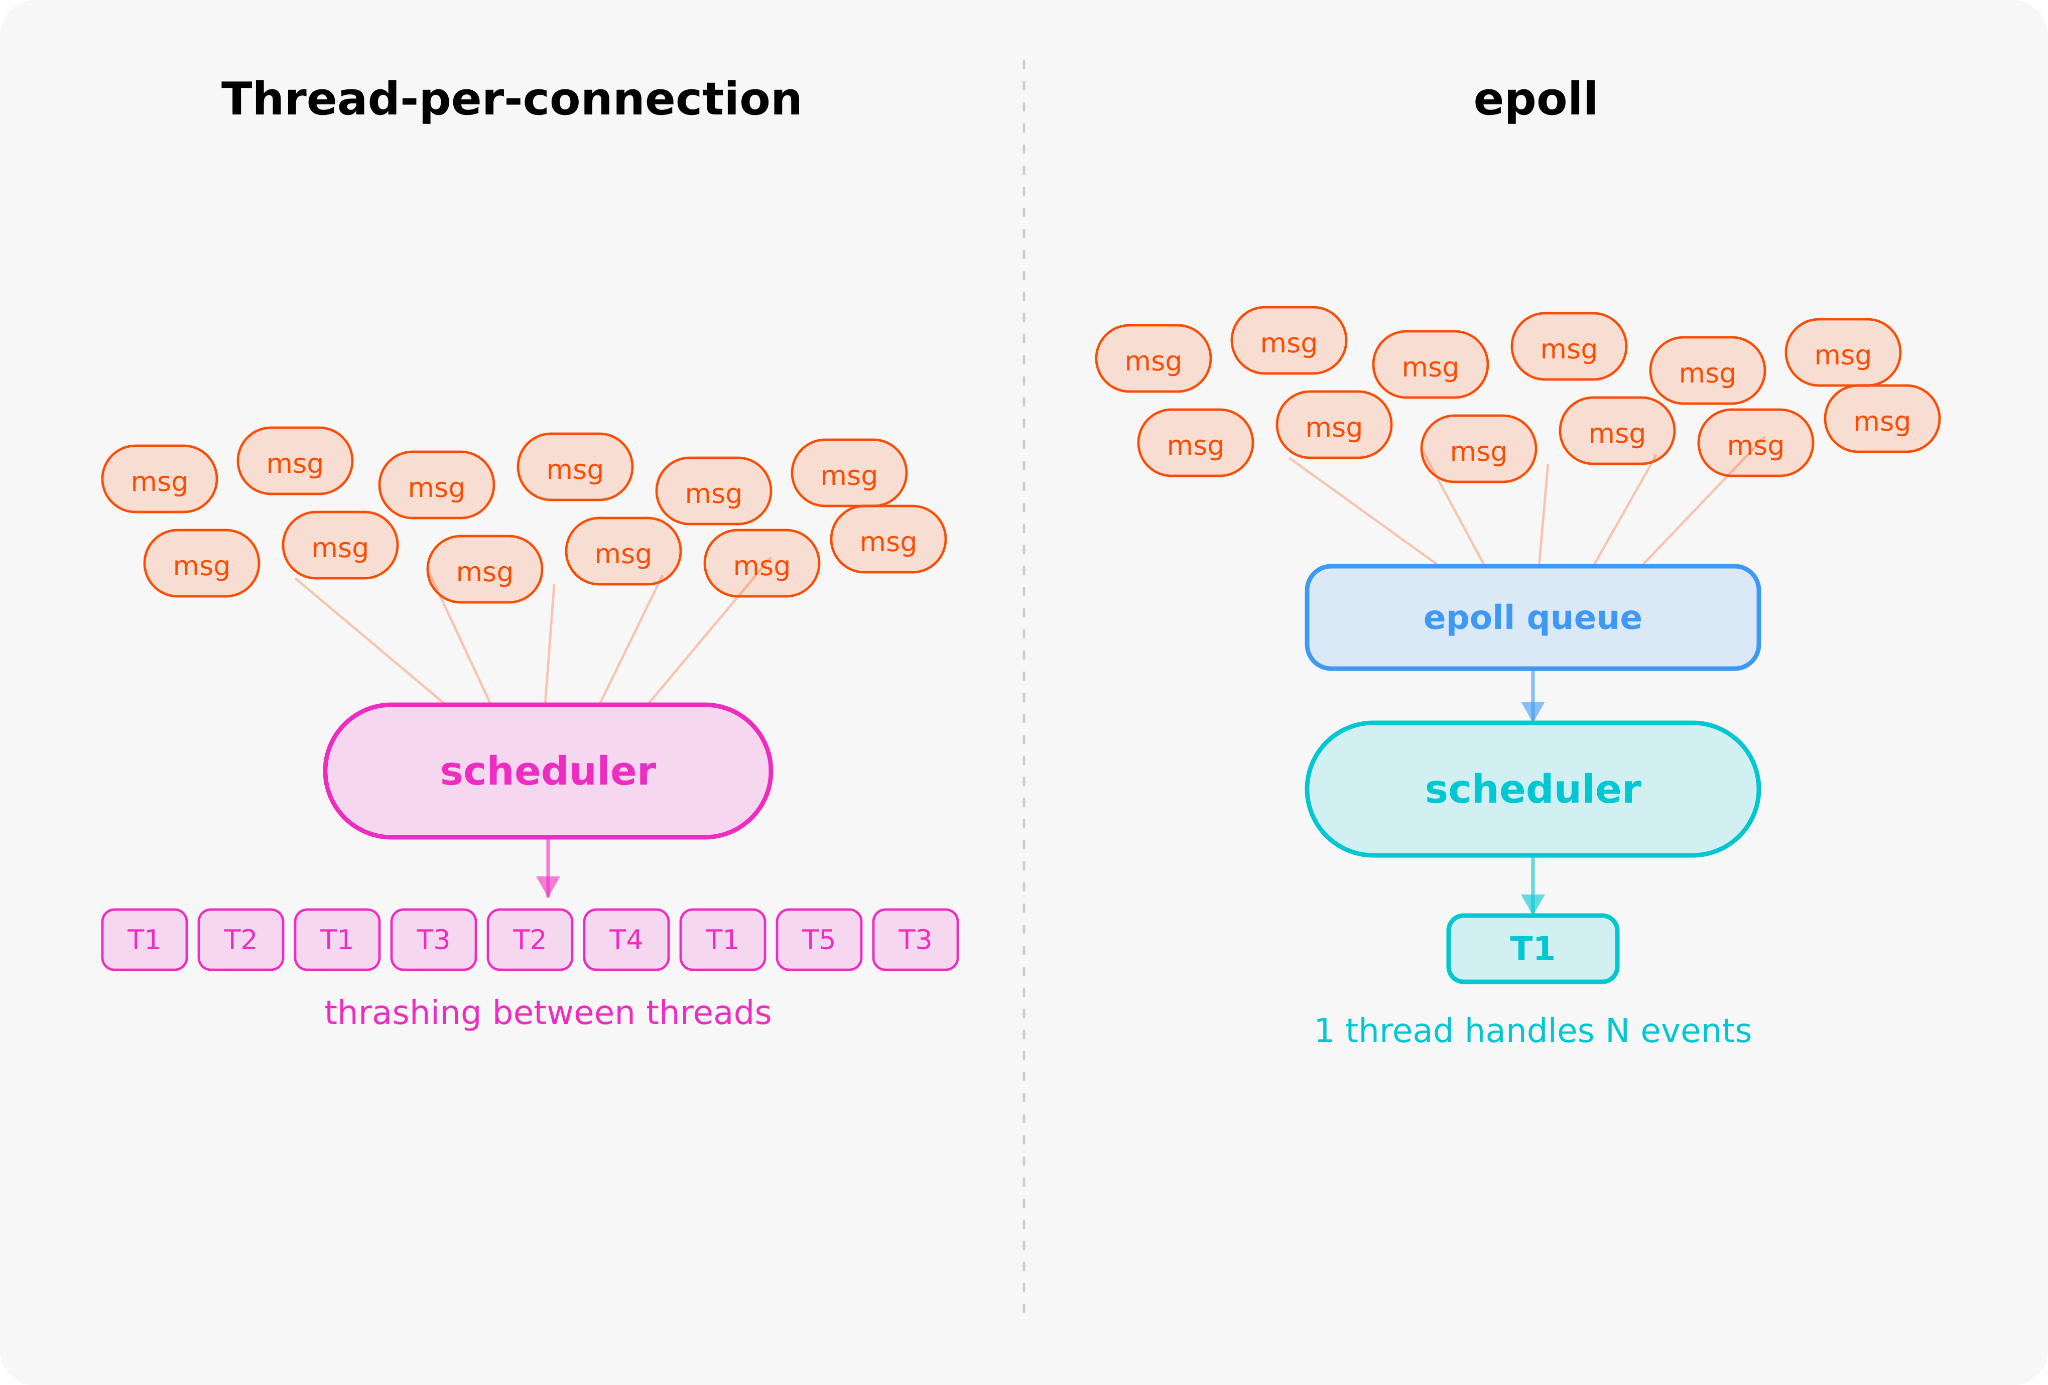
我们最初的流式实现是每个连接一个线程。当数百路流同时发来数据块时,数百个线程同时被唤醒,GIL 争用激增,尾部延迟随之飙升。
我们改成了让一个线程阻塞在 epoll 上。
epoll 让一个线程注册成千上万个连接,并通过一次系统调用询问内核:“这些连接中只要有任何一个有数据,就叫醒我。”消息到达时,内核会返回完整的就绪集合,该线程处理完活跃的套接字后再回去休眠。
同样的工作负载,调度器的压力小得多。对流式 ASR 来说,这种可预测性很重要,因为即便平均延迟看起来没问题,部分转写结果的延迟也会让语音系统显得很慢。
冻结启动状态以消除 GC 尾部延迟
这个问题我们差点就漏掉了。
在流式工作流的负载下,p50 和 p90 延迟看起来都很健康,但 p95 会周期性地飙升约 200 ms。日志显示队列深度很小,GPU 耗时也正常,但平时耗时不到 5 ms 的 CPU 函数突然要花上 100 多毫秒。
后台有什么东西在偷走请求循环的时间。
性能分析指向了 Python 的垃圾回收器(GC)。Python 的大部分内存管理采用引用计数,另有一个循环检测回收器来处理引用循环。这个回收器是分代运行的。最老的一代包含长寿命对象,而完整回收可能需要遍历一张庞大的对象图。
我们在启动时预分配了一大批缓冲区、模型状态和查找表,目的正是避免稳态下的分配延迟。这些长寿命对象都落在了最老的一代,因此每次完整 GC 都要遍历数十万个引用。这就是那次 200 ms 的停顿。
修复方法是在启动预分配之后加一行代码:
gc.freeze()
gc.freeze() 告诉 Python 在今后的 GC 扫描中排除这些预分配的状态,这样普通的请求级对象仍会被回收,而庞大的初始状态则不会被碰。
p95 的尖峰消失了,p50 也有所改善,因为系统可以承受更平滑的流量模式。
这个教训是:性能分析不能只盯着模型。GPU 耗时、队列深度和模型执行看起来都正常,延迟尖峰其实藏在 Python 运行时里。
语音延迟是端到端的系统问题
语音智能体通常以级联方式运行:ASR 生成转写文本,LLM 生成回复,TTS 生成音频。ASR 是这条链路的第一个环节,因此它的延迟和抖动决定了用户可感知响应时间的最早下限。
上述优化针对的是这条链路的不同部分。TensorRT 多 profile 引擎针对真实音频形状调优编码器的执行。条件式 CUDA graph 消除了解码器循环中 CPU 的往返。持久 Unix 域套接字、共享内存和 epoll 降低了 CPU 路径的开销。gc.freeze() 则消除了一种运行时层面导致 p95 恶化的故障模式。
同样的约束也适用于技术栈的其余部分:每个环节都必须在模型执行、预处理、传输、调度和运行时行为上同时控制好中位延迟和尾部延迟。
NVIDIA Parakeet-TDT 0.6B v3 和 OpenAI Whisper Large v3 已在 Together 上线。如果你正在生产环境中扩展语音 AI,欢迎联系我们。
Parakeet v3 是 v2 的后继版本。v2 是仅支持英语的模型,在 Hugging Face Open ASR Leaderboard 的单语言吞吐量方面一直领跑。v3 在此基础上大幅扩展:语言支持从英语扩展到 25 种欧洲语言,新增无需语言提示的自动语种检测,并在 170 万小时的音频数据上训练而成,其中包括 NVIDIA 的 Granary 多语种语料库。