摘要
LLM 编写 GPU 内核的能力已经好得出人意料[1][2][3],但目前衡量这一进展的基准测试几乎都是单 GPU 的。在生产环境中,通信往往是瓶颈:通信开销可能占推理延迟的 20% 以上[4],而且随着算力增长快于互连带宽,这一差距还在不断扩大。
ParallelKernelBench(PKB)提供了一个面向多 GPU 内核生成的基准测试与评估框架,包含 87 个来自真实代码库的问题,任务是把 PyTorch + NCCL 替换成直接通过 NVLink 搬运数据的 CUDA 内核。我们测试了 GPT-5.5、Gemini 3 Pro、Opus 4.7 等前沿编码模型。评估揭示了全面的显著性能差距:不到三分之一的问题被正确解决,而其中不足四分之一的解决方案优于朴素基线。
我们将介绍它们为何失败、失败呈现什么模式,以及几个模型出人意料地写出了比任何公开可得实现都更快的内核的案例,其中包括一个用于 NVIDIA NeMo-RL 的 GRPO 训练循环的内核,此前并没有经过优化的公开参考实现。
为什么多 GPU 与单 GPU 内核生成不同
LLM 在 GPU 内核生成上取得了进展,但这一进展主要是在单 GPU 上衡量的。生产环境的 AI 负载已不再适用这个框架:它们横跨多块 GPU,性能越来越多地由通信而不仅仅是本地计算和内存决定。这一转变使多 GPU 内核生成在三个方面成为不同的问题:
- 设计空间呈组合式膨胀。从业者会组合张量并行、专家并行、数据并行、上下文并行和序列并行来适配硬件,每种组合都会产生不同的通信模式。
- 性能模型发生变化。单 GPU 的 roofline 模型围绕计算和内存带宽构建。而在多 GPU 代码中,瓶颈往往是互连。
- 多 GPU 内核生成引入了一个关键的新设计选择:如何在 GPU 之间搬运数据(通过拷贝引擎、TMA、SM load/store 还是 NVLS),以及是否把这种搬运与计算融合。
ParallelKernelBench
我们构建 PKB,是为了检验模型能否超越单纯的 torch.dist,真正写出生产级的多 GPU 内核。每个问题都从标准的 PyTorch + NCCL 实现和一份硬件拓扑描述出发。模型随后必须用一个 CUDA 内核替换该参考实现,这个内核使用对称内存(symmetric memory)在 GPU 之间直接通信。
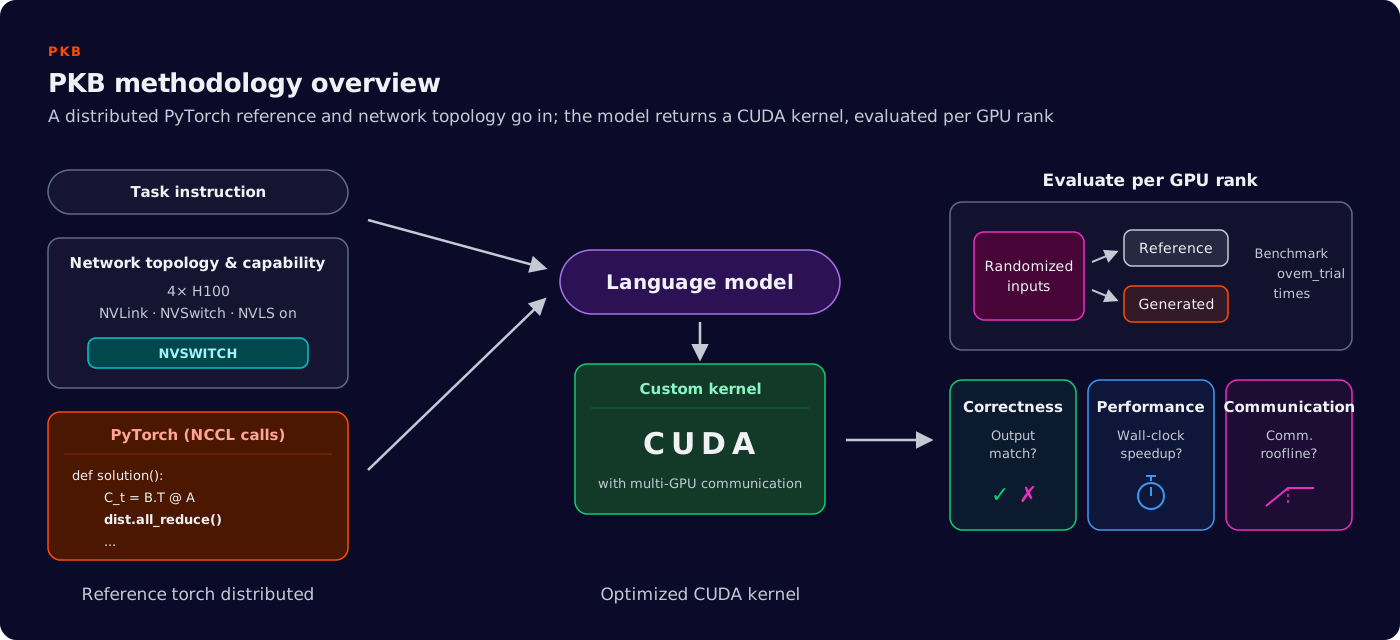
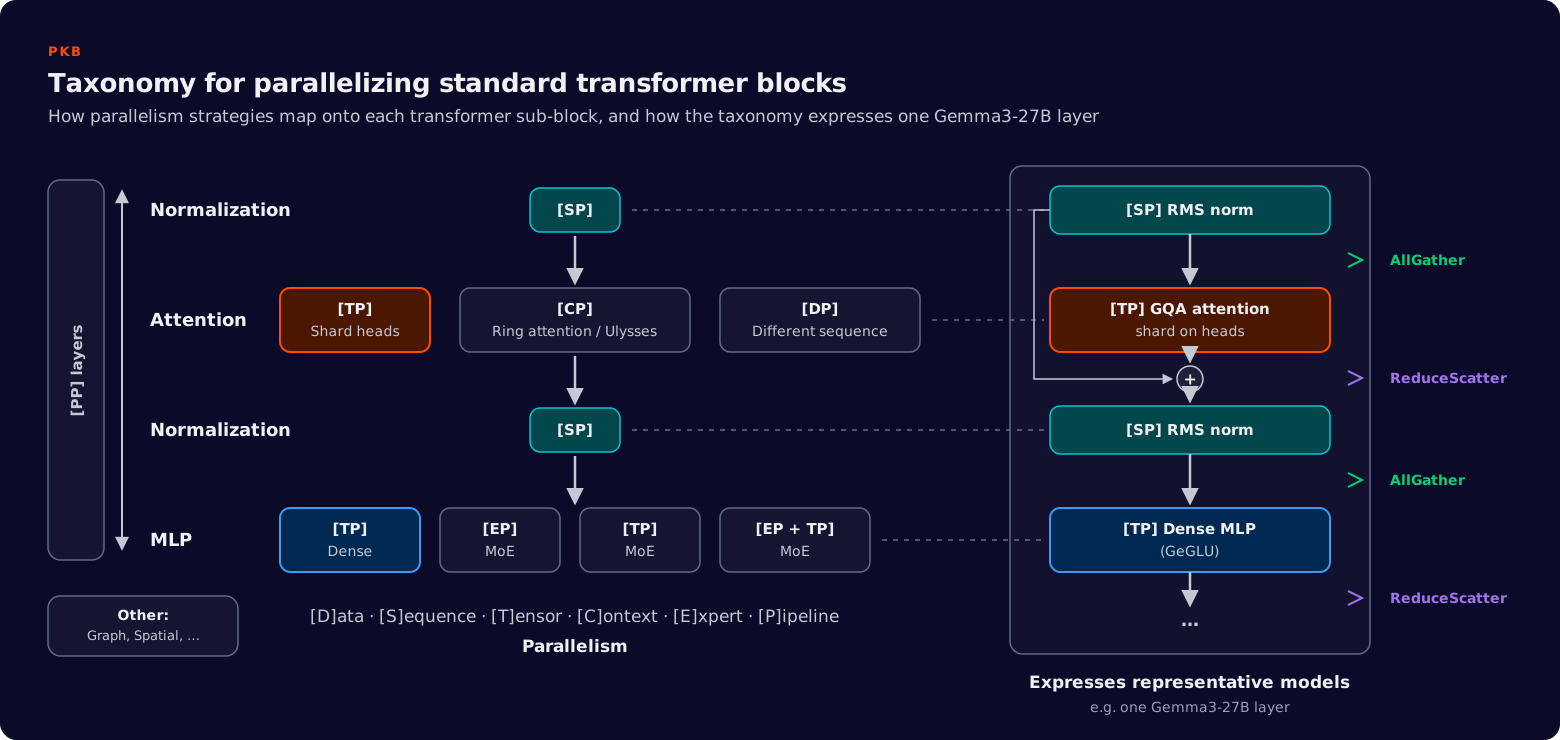
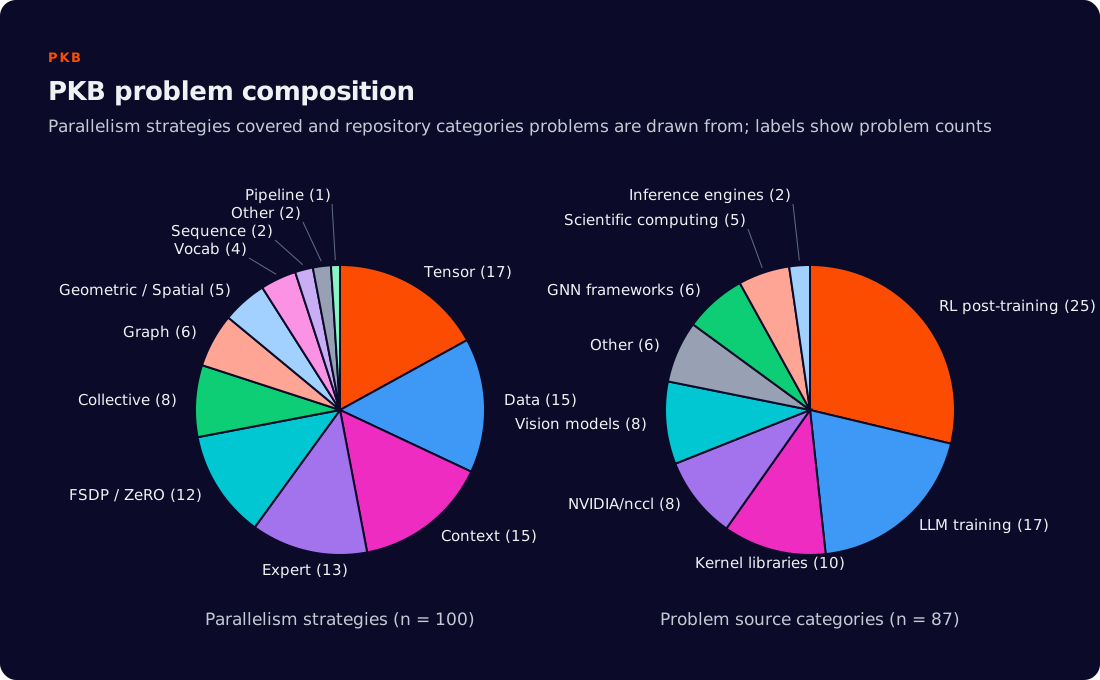
为了确保这 87 个问题覆盖生产环境中并行类型的真实空间,我们依据分布式负载的分类体系来构建它们。首先,我们梳理了模型被切分的主要方式(张量、上下文、数据、专家、序列以及 FSDP/ZeRO)以及每种方式产生的通信模式。然后,我们选出 87 个问题来覆盖这一空间,它们取自 Megatron-LM、DeepSpeed、DeepEP、TensorRT-LLM、NeMo-RL 等系统的代码库,以及一长串非 LLM 负载:GNN 路由、分布式 FFT、Gaussian splatting 等。另一个好处是,由于 PKB 的参考实现是用标准 PyTorch + NCCL 编写的,这个基准不会绑定在某一代特定的硬件上。相反,它被设计为可以随下一代硬件架构自然演进。
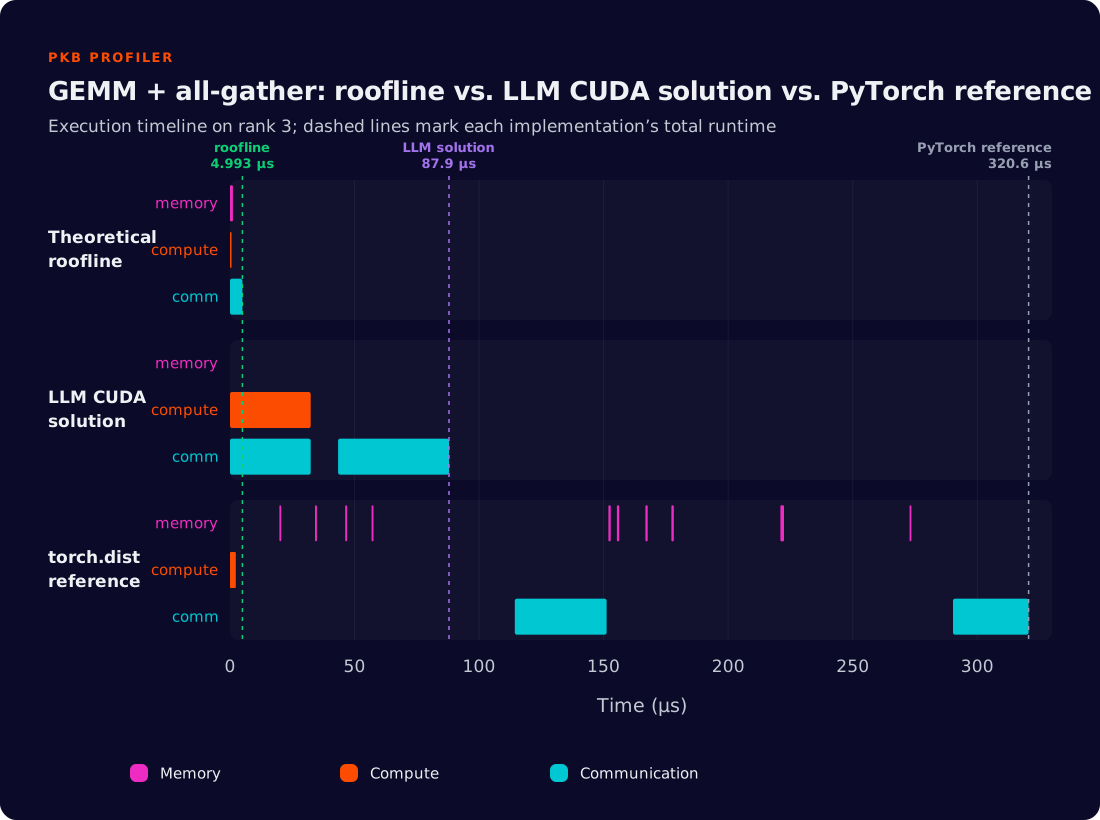
在评估模型之前,我们先检查了 PyTorch + NCCL 基线是否留有真实的提升空间。一个考虑通信的 roofline 给出了肯定的答案:PKB 的大多数问题都受限于 NVLink,基线的运行水平远低于硬件上限。于是下一个问题很简单:模型能弥合这一差距吗?
前沿模型在 PKB 上的表现
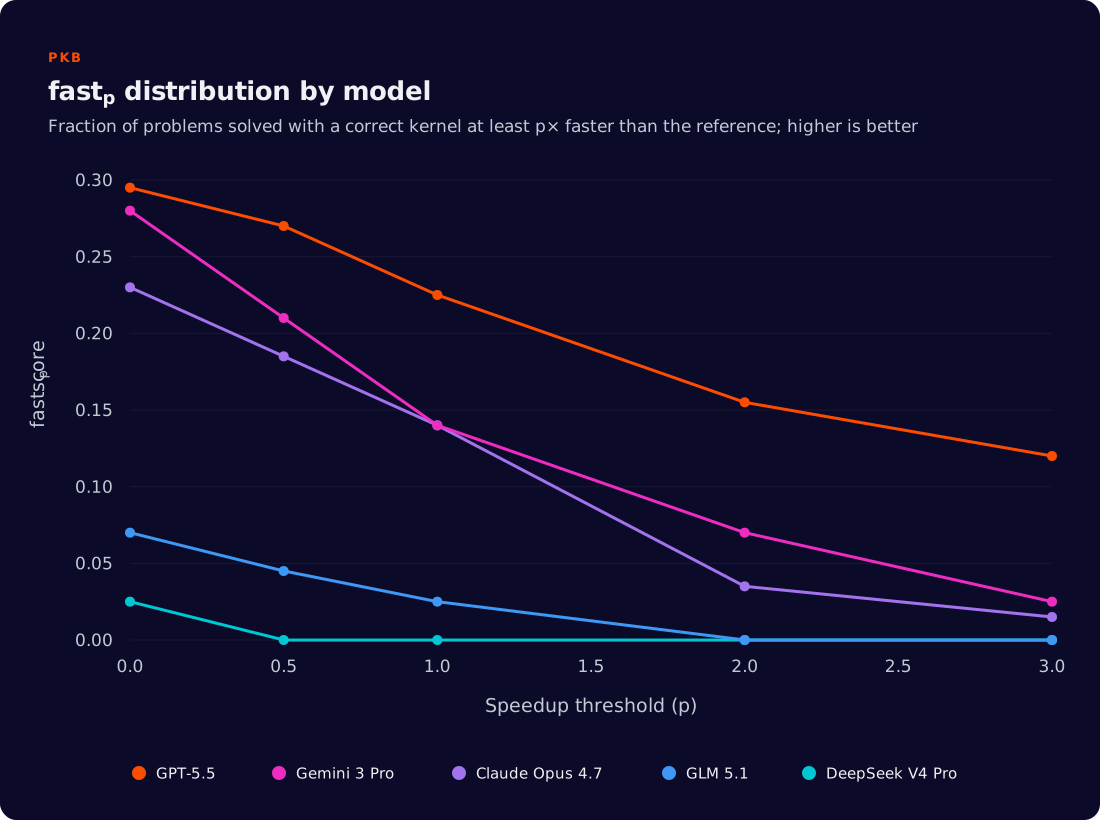
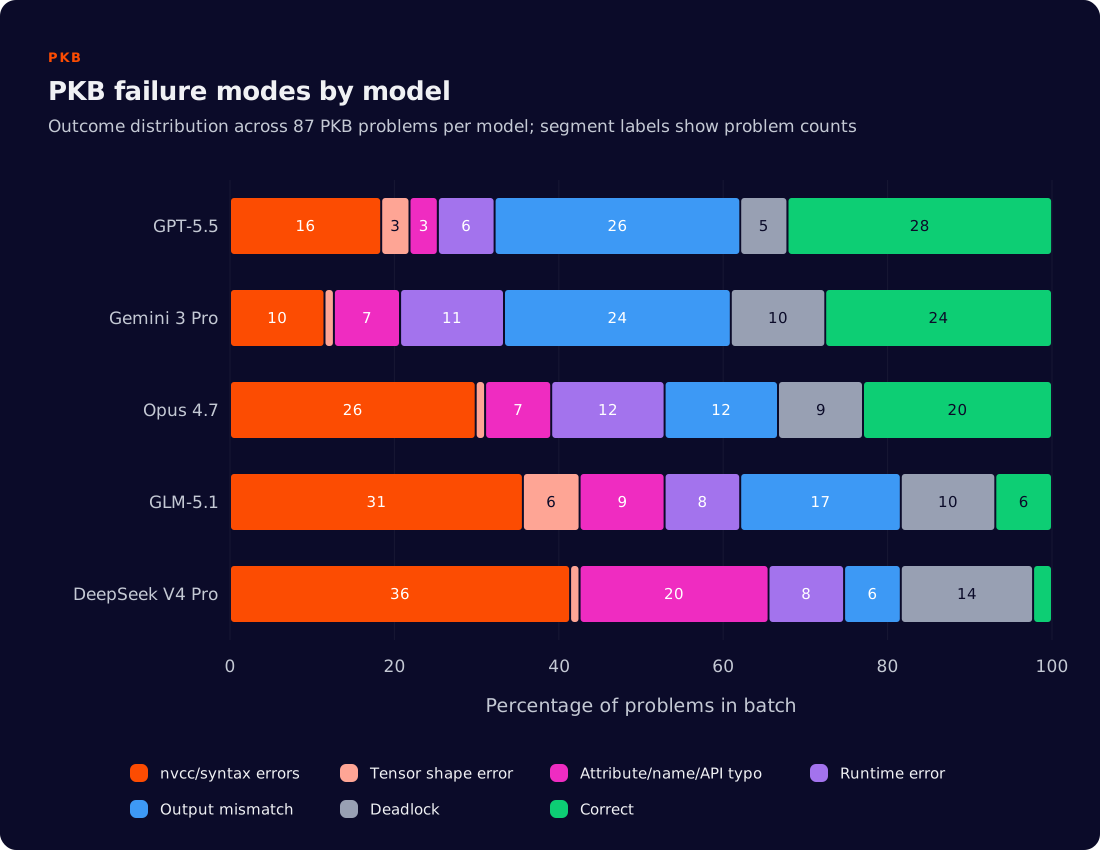
不太好。在零样本(zero-shot)设置下,最好的模型解决了 87 个问题中的 28 个,其中只有 22 个解法比 PyTorch + NCCL 基线更快。采样三次后,最佳结果提升到 36 个正确解和 27 个快于基线的解,但 fast1@3 仍然最高只有 31%。
| 类别 | # | GPT-5.5 | Claude Opus 4.7 | Gemini 3 Pro | GLM-5.1 | GLM-5.2 | DeepSeek V4 Pro | ||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| pass @1→3 | fast1 @1→3 | pass @1→3 | fast1 @1→3 | pass @1→3 | fast1 @1→3 | pass @1→3 | fast1 @1→3 | pass @1→3 | fast1 @1→3 | pass @1→3 | fast1 @1→3 | ||
| 集合通信原语 | 8 | 3→5 | 3→4 | 4→5 | 3→4 | 6→6 | 2→2 | 2→3 | 2→3 | 1→3 | 1→1 | 0→0 | 0→0 |
| 张量并行 | 17 | 2→2 | 1→2 | 1→3 | 1→3 | 3→3 | 1→1 | 1→1 | 0→0 | 0→1 | 0→0 | 0→0 | 0→0 |
| 序列并行 | 2 | 1→1 | 1→1 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 |
| 上下文并行 | 12 | 7→8 | 5→6 | 7→7 | 3→4 | 7→9 | 5→7 | 2→2 | 0→0 | 2→2 | 0→0 | 2→3 | 0→1 |
| 流水线并行 | 1 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 |
| 数据并行 | 9 | 1→2 | 1→2 | 1→1 | 1→1 | 0→1 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 |
| 专家并行 | 11 | 3→3 | 2→3 | 2→6 | 0→1 | 3→4 | 0→1 | 0→0 | 0→0 | 1→1 | 0→0 | 0→0 | 0→0 |
| FSDP / ZeRO | 9 | 3→4 | 3→4 | 3→3 | 3→3 | 1→1 | 0→1 | 1→1 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 |
| 词表并行 | 4 | 2→2 | 1→1 | 1→2 | 1→2 | 2→2 | 2→2 | 0→0 | 0→0 | 0→1 | 0→1 | 0→0 | 0→0 |
| 图并行 | 6 | 2→4 | 2→3 | 0→2 | 0→2 | 1→1 | 1→1 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 |
| 几何 / 空间 | 5 | 3→3 | 3→3 | 1→2 | 0→0 | 0→1 | 0→1 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 | 0→0 |
| 其他 | 2 | 1→2 | 0→1 | 0→0 | 0→0 | 1→2 | 1→2 | 0→0 | 0→0 | 0→1 | 0→0 | 0→0 | 0→0 |
| 总计 | 87 | 28→36 | 22→27 | 20→31 | 12→20 | 24→30 | 12→19 | 6→7 | 2→3 | 4→9 | 1→2 | 2→3 | 0→1 |
更多模型 →
单次生成的 LLM 在 PKB 上表现吃力。pass@k 报告 k 次尝试中最佳一次的正确性;fast1@k 统计既正确又优于 PyTorch + NCCL 基线的解法。重复采样能同时改善这两个指标,但 fast1@3 的峰值仍只有 31%(GPT-5.5),说明存在超出采样噪声的根本性局限。
成功案例集中在熟悉的模式上:集合通信原语、张量并行的 GEMM,以及 Ulysses 风格的上下文并行,后者通过 all-to-all 通信把序列维度切分到各个注意力头上。这些是多 GPU 技术栈中在开源代码里最常见的部分,因此模型对它们很可能有更强的先验。
失败暗示的问题比 CUDA 语法更深。较弱的模型往往连编译都过不了,而较强的推理模型则常常生成能编译但返回错误结果的内核。难点在于推理 rank 之间的协调、数据划分和集合通信的顺序。
生成的内核使用的通信机制也非常单一。大多数依赖拷贝引擎或 SM load/store 指令,而 TMA 和 NVLS 这类更专门的机制几乎看不到。在许多情况下,模型没有选择达到峰值性能所需的机制。我们将其归因于数据稀缺和硬件复杂性的共同作用:TMA 和 NVLS 等较新的原语需要处理错综复杂、依赖具体硬件的抽象,例如异步拷贝描述符或较新的 NVLink 拓扑,而模型在这些方面缺乏强先验。这就在“能跑”的分布式内核与真正优化过的内核之间留下了很大差距(这显然是未来工作的目标!)
自然的下一步,是给模型提供与人类内核编写者相同的反馈循环。我们把 Gemini 3 Pro 包装进一个智能体 harness,让它可以访问代码仓库、终端、编译器输出、正确性测试、速度测量以及它之前的尝试。模型不再是生成一个内核就结束,而是可以编译、运行基准测试、检查失败并修改。
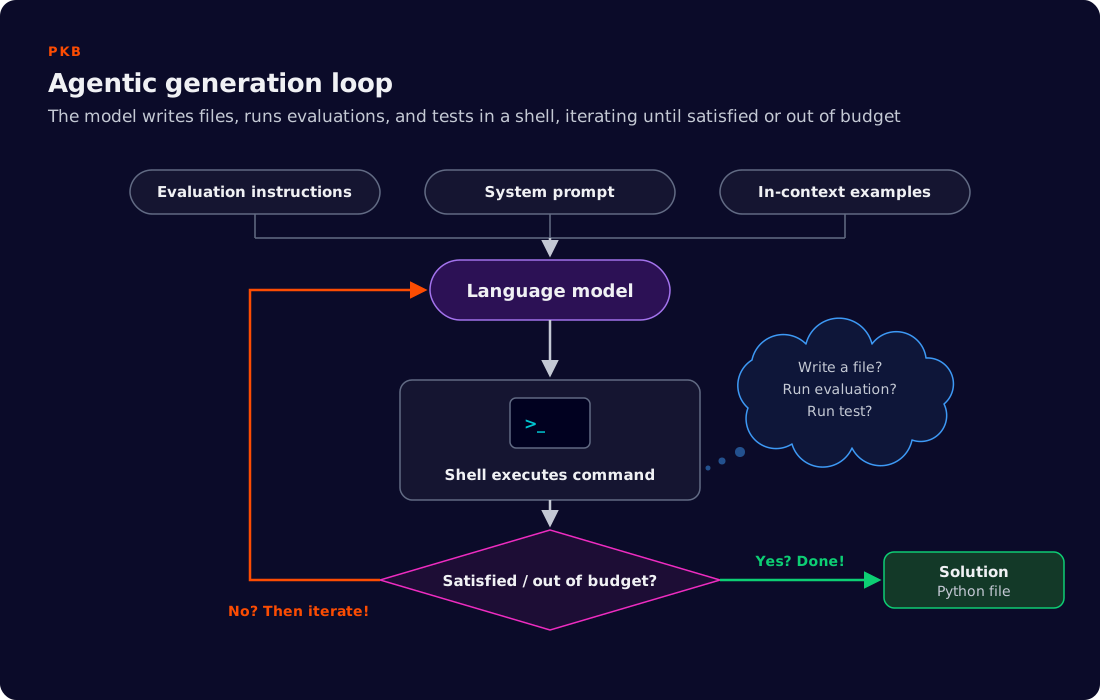
这确有帮助,但实际收益有限。Gemini 3 Pro 的正确解从单次生成设置下的 24 个提升到 87 个中的 35 个,其中 26 个内核优于 PyTorch + NCCL 基线。这些收益来自修复语法错误、形状错误和简单的运行时 bug。经过大约 20 步改进后,性能进入平台期。反馈能帮助模型调试分布式内核,但剩下的失败凸显出一个大得多的差距:无法推理 rank 之间的协调、通信顺序,以及 GPU 到 GPU 传输机制的最优选择。
全新的内核
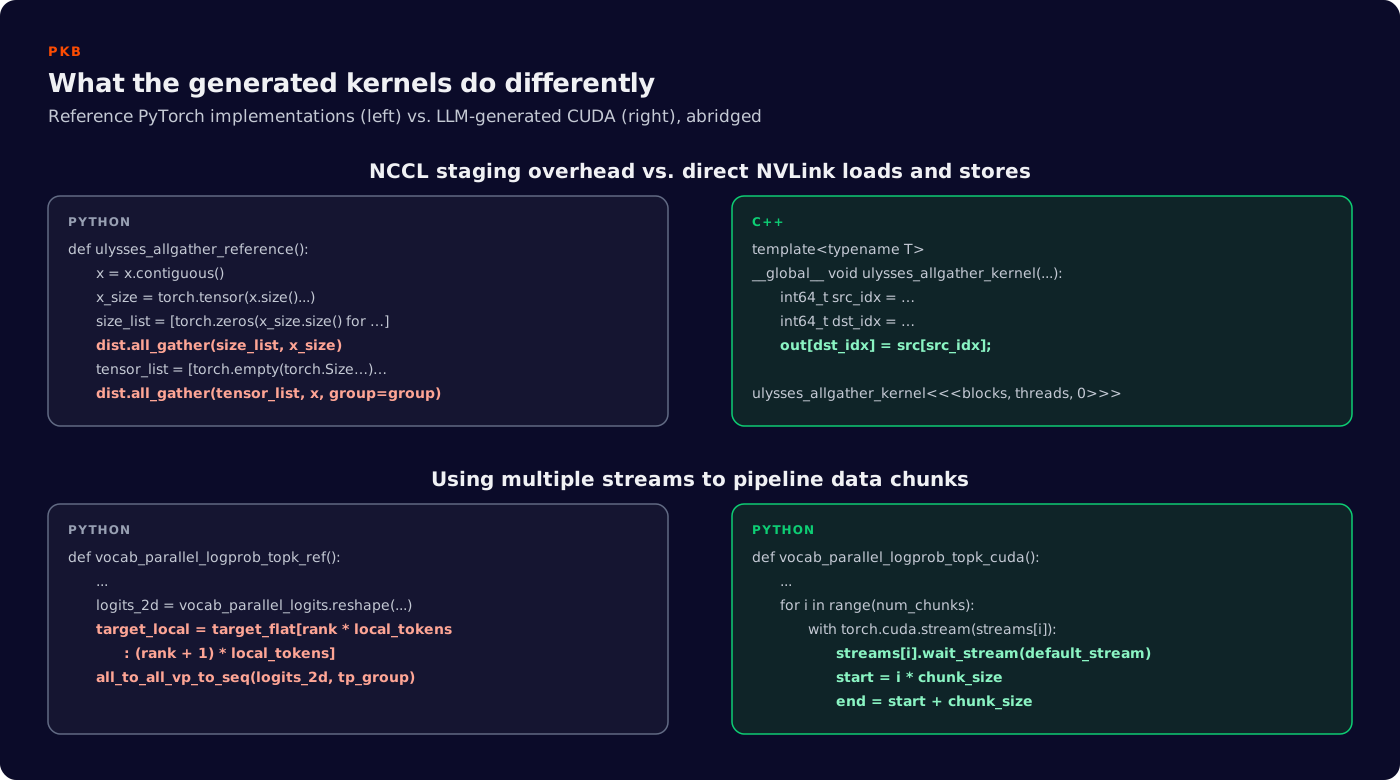
除了在标准集合通信上的加速之外,单次生成偶尔还能为没有优化过的公开参考实现的负载,产出真正全新的高性能内核。这种能力预示着 AI 驱动优化的更广阔潜力;收益并不局限于 Transformer,模型在状态空间模型、基因组流水线和多模态 RL 循环上也能表现出色,而在这些领域,与主流 LLM 技术栈相比,专用内核仍基本未经优化。
下面是三个例子,每一个都用融合的对称内存内核替换了 NCCL 集合通信,直接通过 NVLink 搬运数据。每个内核都在 4 块 H100 GPU 上经过 100 次随机化运行验证了正确性;速度测量遵循 ThunderKittens 2.0[5] 中的基准测试方法(逐位相同的输入、感知 L2 的输入分组、500 次预热迭代和 100 次连续的性能分析迭代)。
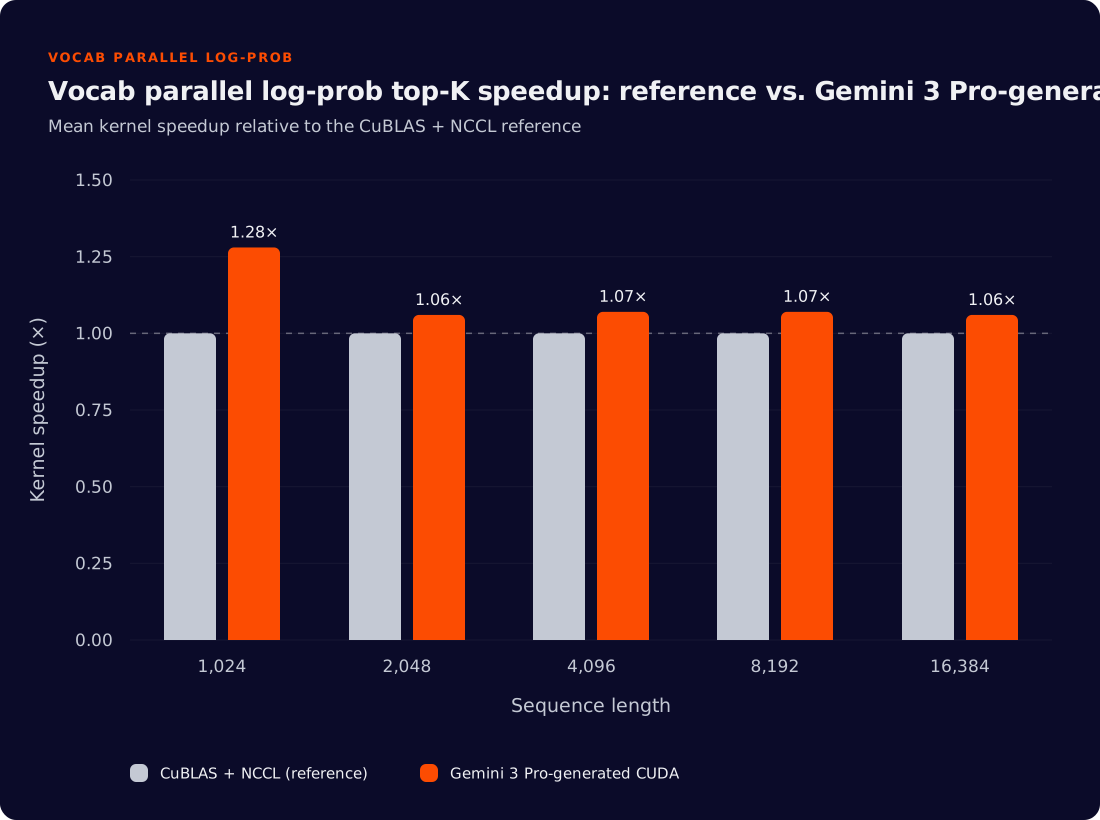
带 top-k/top-p 过滤的 NeMo 词表并行 log-prob(Gemini 3 Pro)
这是 NVIDIA NeMo-RL 的 GRPO 训练循环中的一个核心步骤:在经 top-k/top-p 过滤的分布下,计算按词表切分的对数概率。PyTorch + NCCL 基线在过滤之前先把完整词表跨 rank 聚合;生成的内核则完全跳过这些集合通信,用对称内存就地置换分片,同时把 log-softmax、token 提取和目标 gather 融合成一次 warp-shuffle 归约。
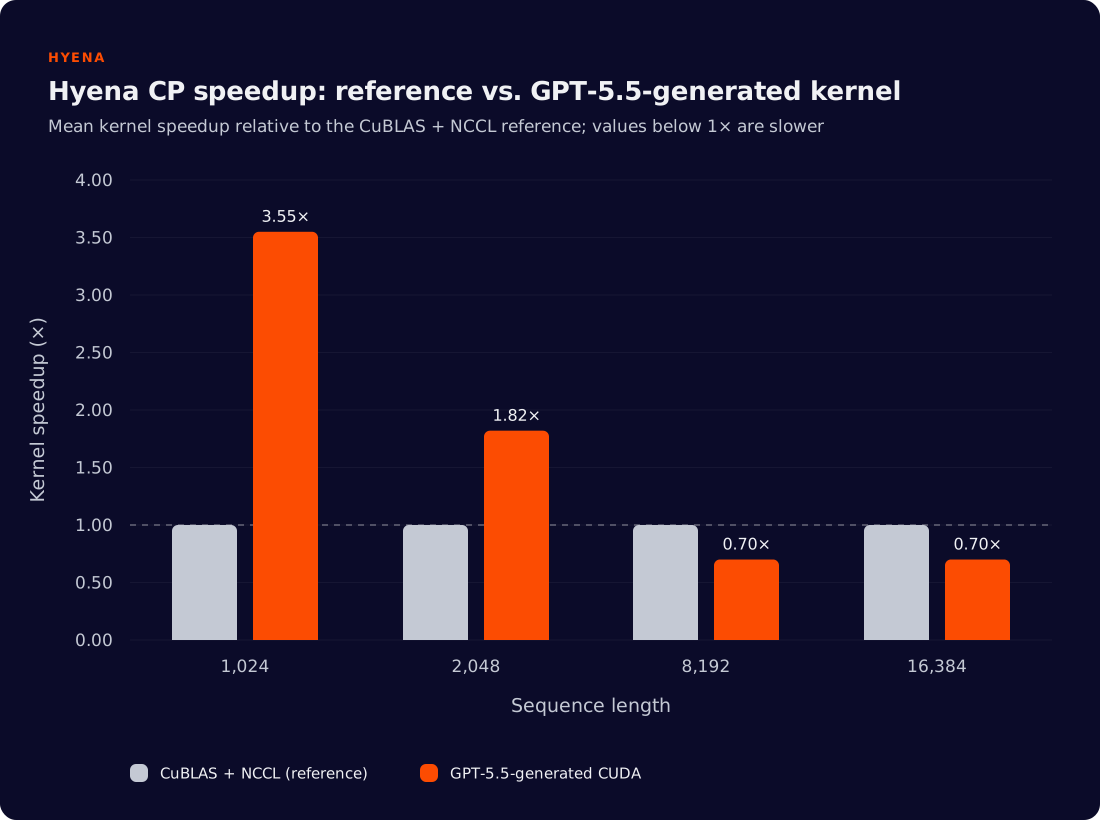
Hyena 前向上下文并行(GPT-5.5)
Hyena 算子的上下文并行前向传播,其中 FFT 卷积需要序列全局的上下文。参考实现通过反复调用 all_to_all 在按序列切分和按通道切分的布局之间来回切换;生成的内核把输入打包进一块对称分配,并通过 NVLink 流式读取远端切片,在统一的一趟中完成门控和重新索引。值得注意的是,序列长度较长时性能会下降。
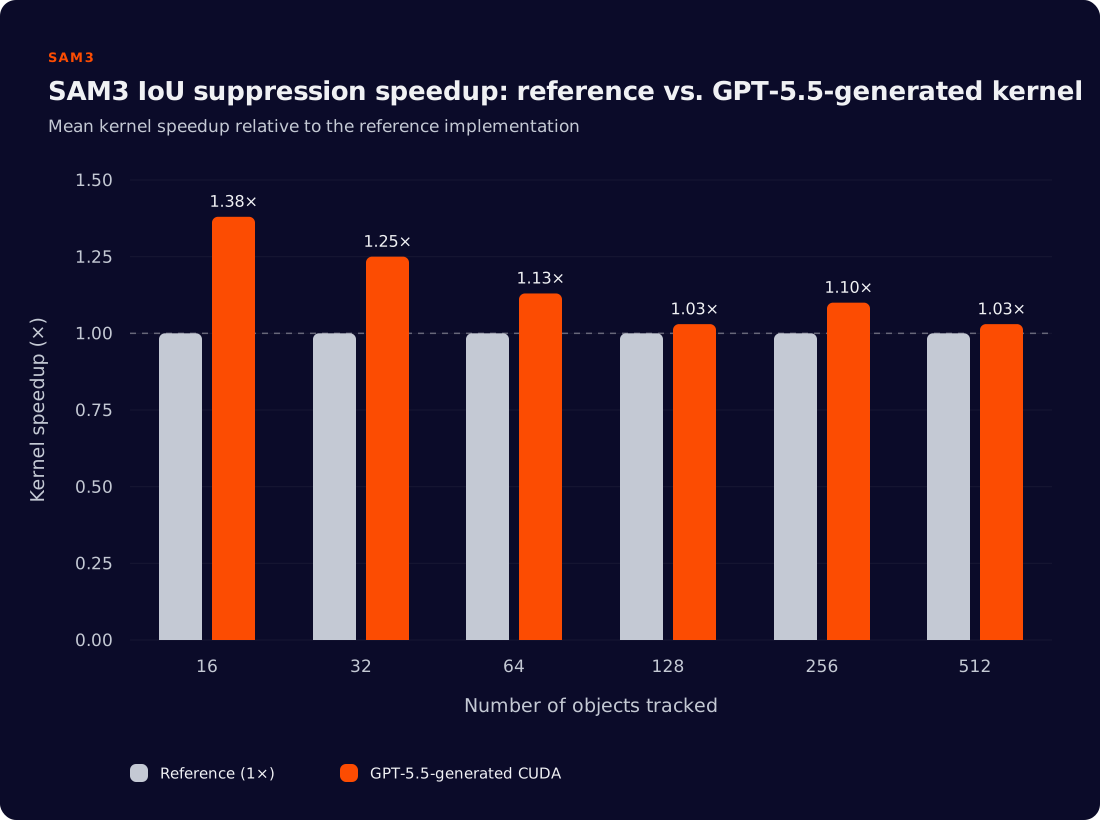
SAM 3 all-gather 掩码 IoU 抑制(GPT-5.5)
SAM 3 视频分割的跨 GPU 重复抑制:每一帧之后,各 rank 通过交并比(intersection-over-union)比较预测区域,并将重叠的掩码清零。基线使用变长的 all_gather 集合通信加一次稠密 matmul;生成的方案把这些合并成一条对称内存内核的流水线,对掩码做位打包,并用硬件 popcount 计算两两重叠。
进一步研究
PKB 目前有意将范围限定在节点内 NVLink。自然的扩展方向包括节点间互连(RoCE、InfiniBand),那里的设备端 API 生态更年轻,以及 TPU 等其他加速器和拓扑。我们还想知道更高层的抽象是有帮助还是有妨碍:PKB 已经接受 Triton 和 ParallelKittens 的解法,而 NCCL GIN 和 NVSHMEM 等新兴接口也值得作为目标来研究。扩展对这些范式的支持,将推动对 AI 智能体如何驾驭多样的编程模型和硬件抽象的进一步研究。
更宏大的目标,是为这一切背后更难的问题提供一个具体的靶子:能够自主优化和管理大规模分布式基础设施的 LLM 系统。对于专为语言模型训练和推理定制的基础设施,实现这种自主性最终可能弥合通往 AI 智能体的差距,使其能够自己承担端到端的研究工程工作。
我们将 PKB 作为开放基准发布,以推动这一方向。如果你想深入研究或贡献问题,尤其是节点间的问题,我们很期待听到你的声音。欢迎发邮件到 willychan2022@gmail.com 或 npaek@together.ai!
参考文献
- Standard Kernel。在 PTX 层重新构想 Kernel 生成:一个向 DSL 学习并超越它们的 LLM 系统(Reimagining Kernel Generation at the PTX Layer: An LLM System Learning from DSLs to Outperform Them)。Standard Kernel 博客,2026 年 4 月。
- Robert Tjarko Lange、Qi Sun、Aaditya Prasad、Maxence Faldor、Yujin Tang 和 David Ha。迈向稳健的智能体式 CUDA Kernel 基准测试、验证与优化(Towards Robust Agentic CUDA Kernel Benchmarking, Verification, and Optimization)。arXiv:2509.14279,2025 年。
- Carlo Baronio、Pietro Marsella、Ben Pan、Simon Guo 和 Silas Alberti。Kevin:用于生成 CUDA Kernel 的多轮强化学习(Kevin: Multi-Turn RL for Generating CUDA Kernels)。arXiv:2507.11948,2025 年。
- Raja Gond、Nipun Kwatra 和 Ramachandran Ramjee。TokenWeave:面向分布式 LLM 推理的高效计算-通信重叠(TokenWeave: Efficient Compute-Communication Overlap for Distributed LLM Inference)。arXiv:2505.11329,2026 年。
- Stuart Sul 和 Chris Ré。ThunderKittens 2.0:为你的 GPU 带来更快的 Kernel(ThunderKittens 2.0: Even Faster Kernels for Your GPUs)。Hazy Research,2026 年 2 月。
BibTeX 引用:@misc{chan2026parallelkernelbench, title = {ParallelKernelBench: Can LLMs Write Fast Multi-GPU Kernels?}, author = {Willy Chan and Nathan Paek and Simon Guo and Simran Arora and Daniel Y. Fu}, year = {2026}, url = {https://nathanjpaek.github.io/parallel-kernel-bench/} }