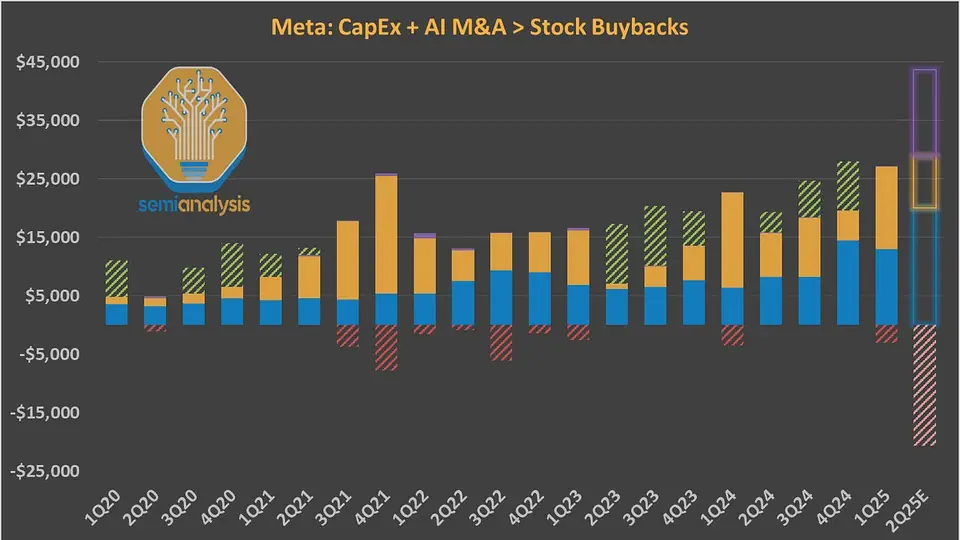
Meta 以约 300 亿美元的估值购入 Scale AI 49% 的股份,这一惊人之举表明,对于年现金流达 1000 亿美元的广告印钞机来说,钱不是问题。尽管资源看似无穷无尽,Meta 在模型性能上却一直落后于基础模型实验室。
真正的警钟是 Meta 在开放权重模型上的领先地位被 DeepSeek 夺走。这惊醒了沉睡的巨人。如今,马克·扎克伯格(Mark Zuckerberg)全面进入创始人模式,亲自带领 Meta 冲锋,并认定了 Meta 的两大核心短板:人才和算力。作为仍在执掌科技巨头的少数创始人之一,Mark 不需要 SemiAnalysis 来告诉他放慢股票回购、为未来筹措资金!
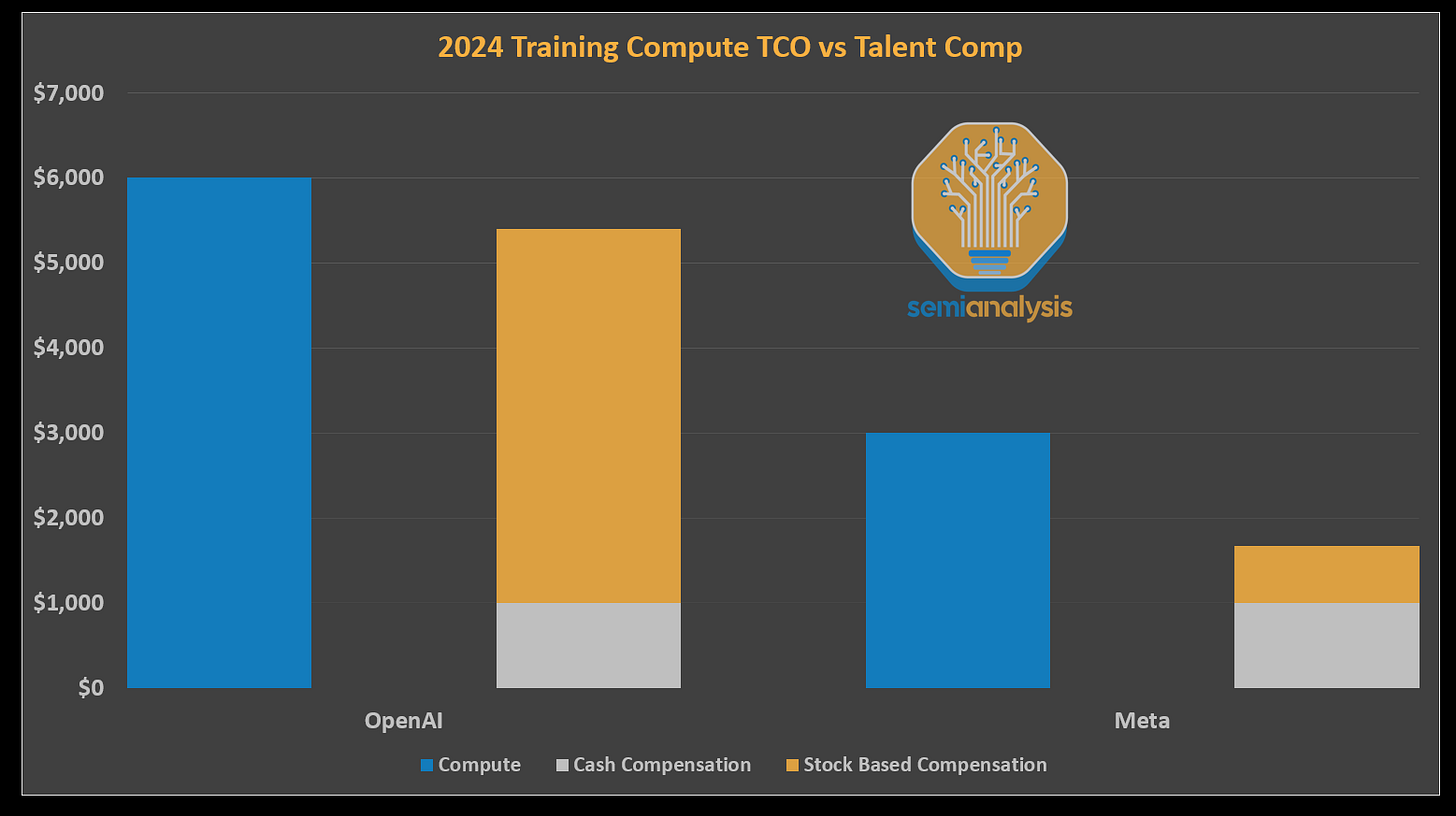
除了砸钱解决问题,他还在从根本上重新思考 Meta 的 GenAI 路线。他从零开始组建了一支新的“超级智能”团队,并亲自挖角顶尖 AI 人才,开出的薪酬让顶级运动员的收入相形见绌。为这支团队挖角的人才,典型报价是 4 年 2 亿美元,是其同行的 100 倍。此外,还有一些十亿美元级别的报价,被 OpenAI 的研究/工程负责人拒绝了。虽然这些报价并非都能成功,但扎克伯格通过大幅推高竞争对手每名员工的成本,正在碾压对手。
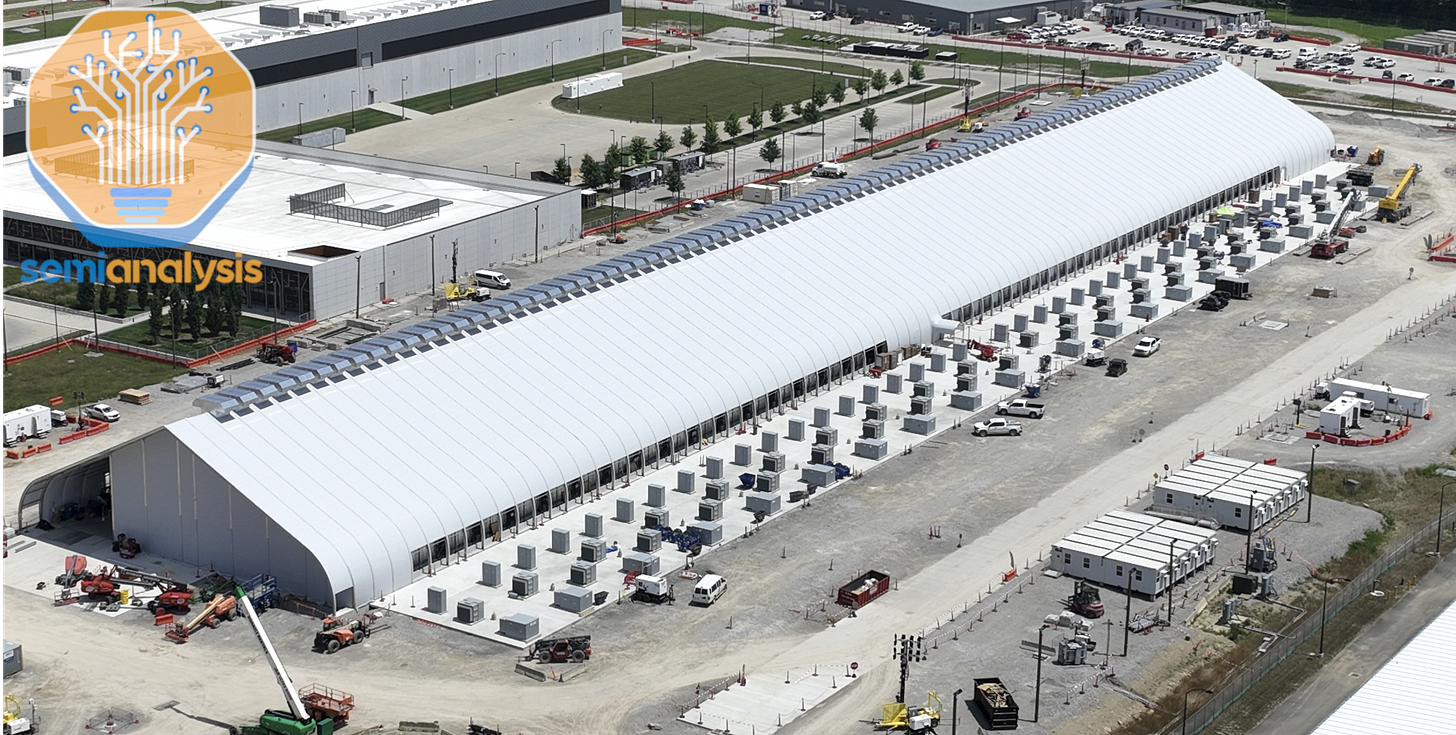
也许更具标志性的是,扎克伯格把他整套数据中心的方案扔进了垃圾桶,现在正在“帐篷”里建设价值数十亿美元的 GPU 集群!
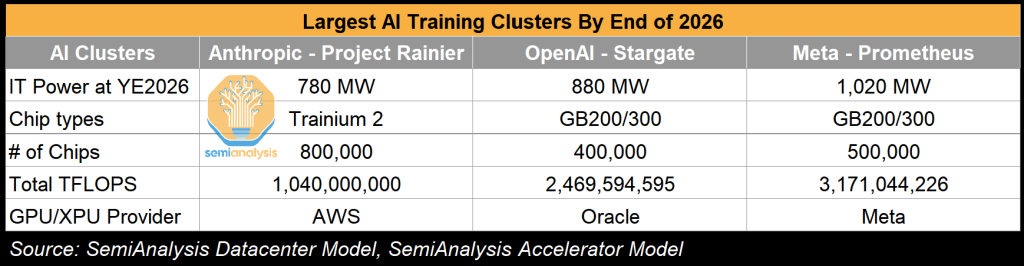
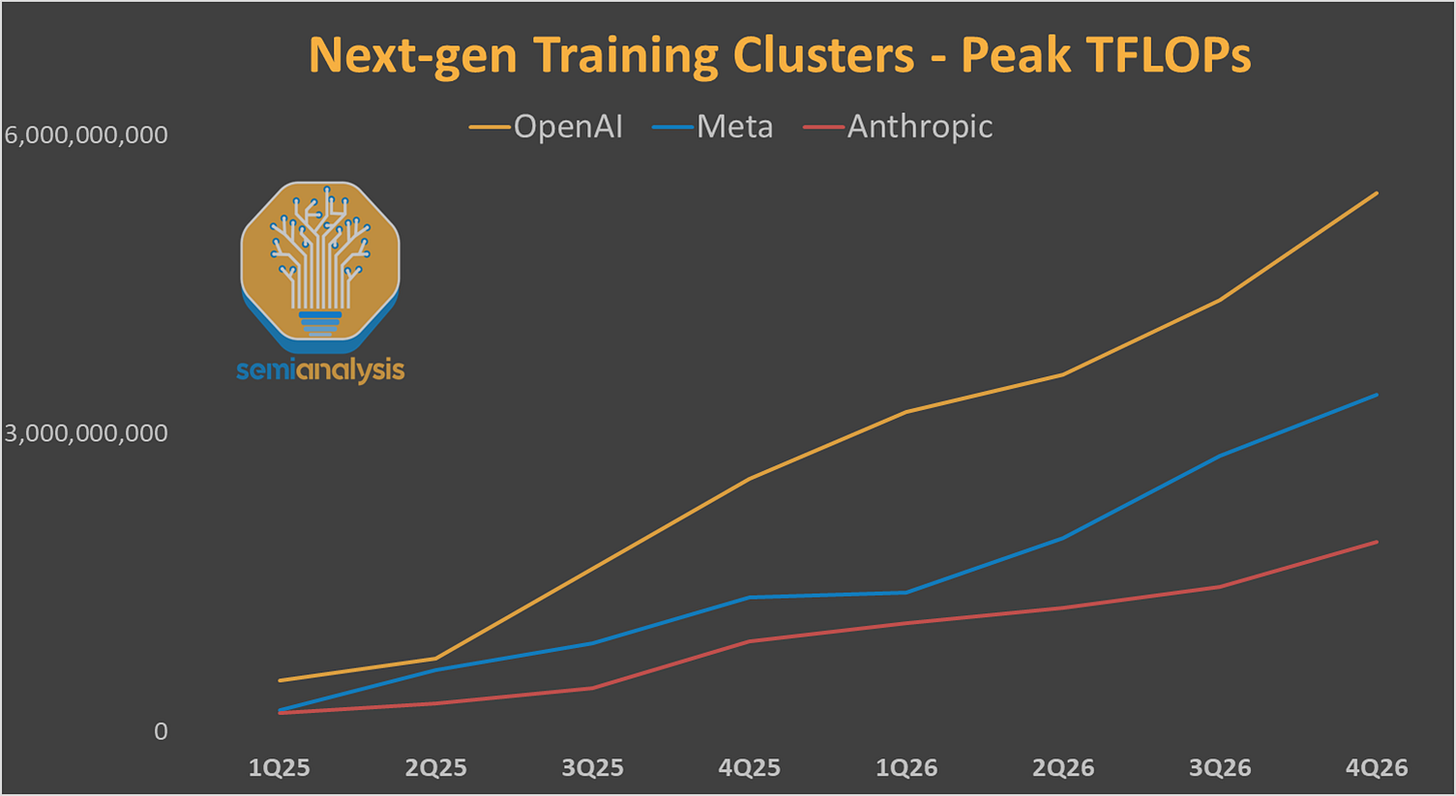
正如本报告所详述的,一切皆有可能。我们剖析了 Meta 在追求超级智能的道路上,从算力到人才的前所未有的重塑,以及它如何走到今天的故事。从 Llama 3.0 开源称雄,到 Llama 4 Behemoth 的惨败,这位 AI 泰坦虽然倒下,但并未出局。事实上,我们认为 Meta 在训练 FLOPS 上的爬坡速度甚至可以媲美 OAI。按每位研究员计算,公司正从 GPU 匮乏转变为 GPU 极度富裕。
Meta GenAI 1.0:AI 渐进主义
与 OpenAI 这类纯粹的 AI 实验室相比,Meta 和 Google 等公司奉行的是“AI 渐进主义”策略:用更好的推荐系统和 GenAI 来增强现有产品,改进广告定向、内容标注和内部工具。这在财务业绩上取得了丰厚回报,使 Meta 得以无视苹果在 iOS 14.5(2021 年底至 2022 年初)中通过推出 App 跟踪透明度(ATT)功能阻止其跟踪用户的企图。
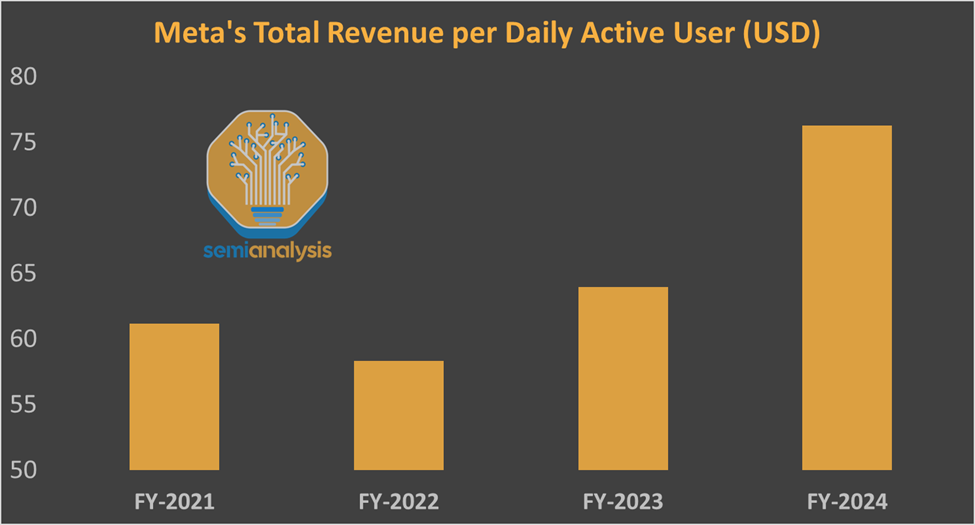
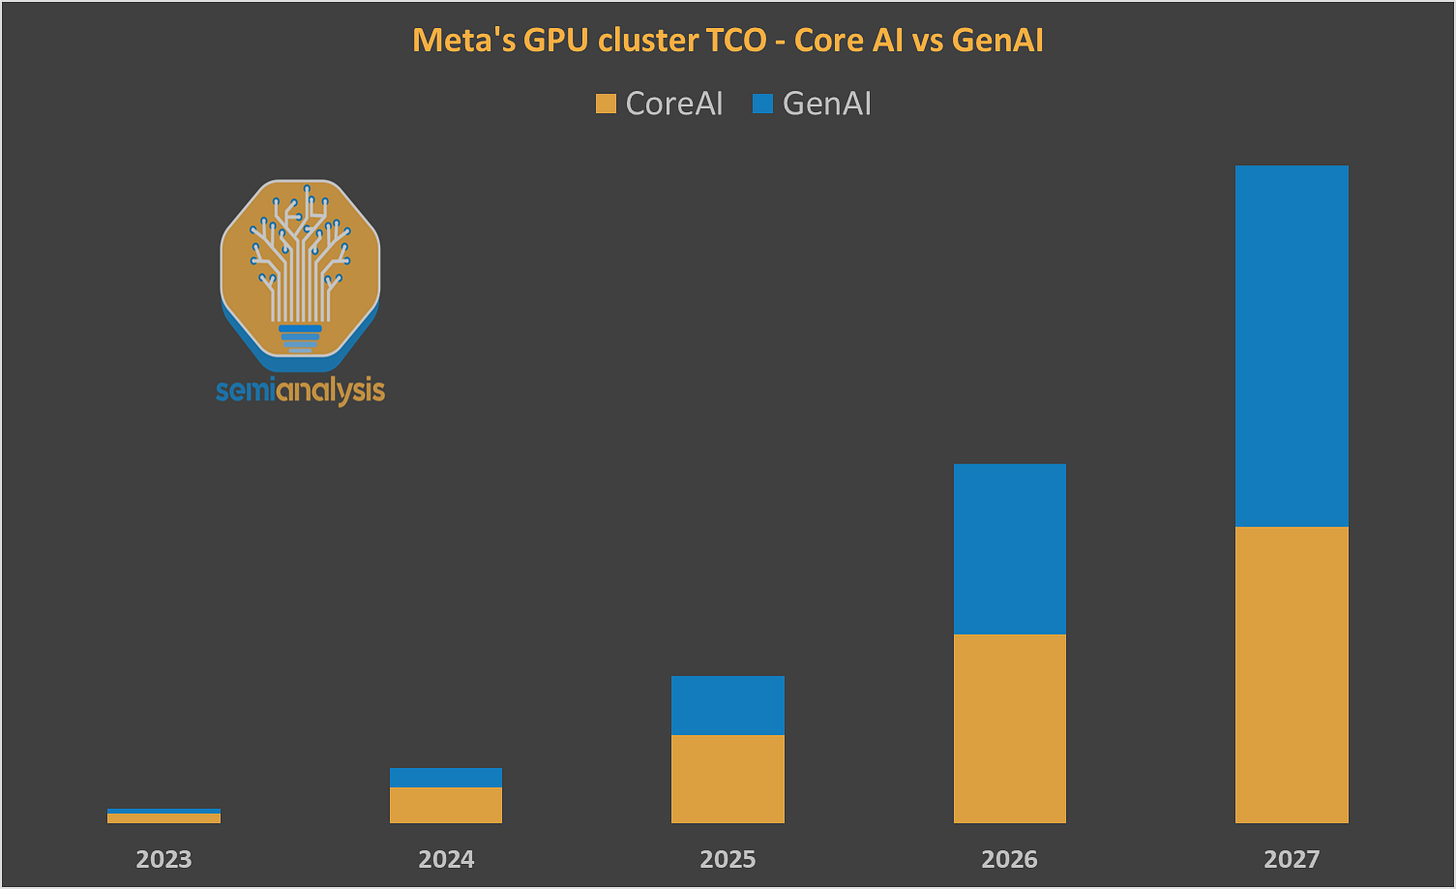
尽管 Meta 可以说比 Google 更不容易受到 GenAI 的冲击,但两家公司在大语言模型上的努力都有些令人失望。原因之一是资本主要分配给了核心业务,而不是追求超级智能。
“我们今年的资本支出增长将同时用于生成式 AI 和核心业务需求,其中整体资本支出的大部分 用于支持核心业务。”
来源:Meta 2025 年第一季度财报电话会议,着重标注为 SemiAnalysis 所加
对这些科技巨头而言,GenAI 只是其业务的延伸。它们不像 OpenAI 在聊天机器人领域、Anthropic 在编程 API 领域那样,有着必须称霸新用例的生存需求。对比 OpenAI 这样的领先 AI 基础实验室与 Meta 在算力和人力资本上的配置,这一点显而易见。扎克伯格对竞争性报价和薪资膨胀的影响将带来严重的伤害。
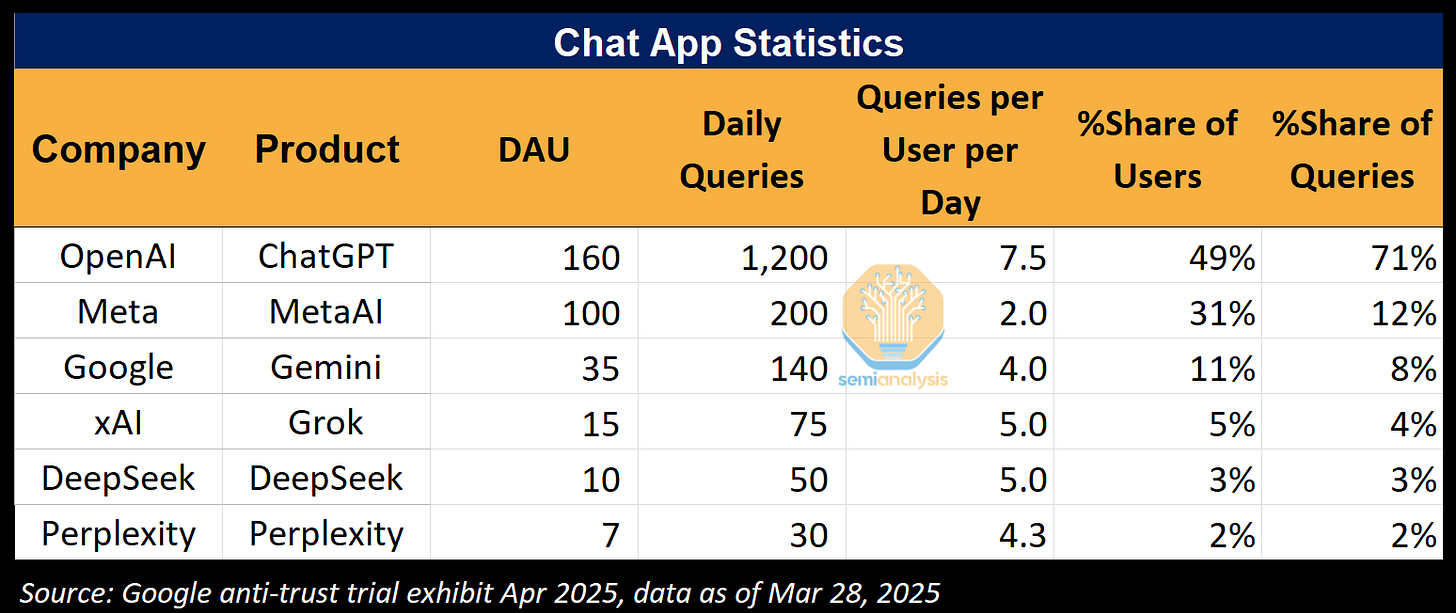
因此,在衡量 GenAI 消费级应用的吸引力时,Meta 和 Google 在覆盖面和用户参与度上都明显落后于 ChatGPT。
但这种情况正在改变。借助我们专有的加速器行业模型和数据中心行业模型,我们预测 Meta 在未来几年将大幅提高 GenAI 投资。
Meta GenAI 2.0 第一部分:(再次)重塑数据中心战略
从建筑到帐篷
就在一年前,Meta 废弃了沿用十年的“H”形数据中心蓝图,改用一种为 AI 优化的新设计。
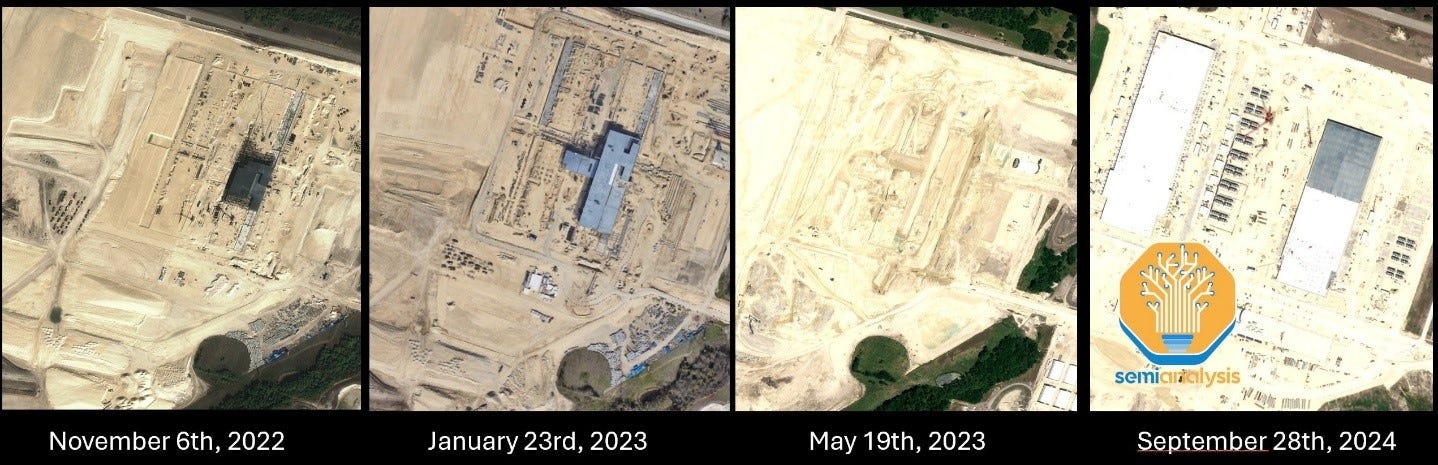
如今到了 2025 年,扎克伯格决定再次重塑这一战略。受 xAI 前所未有的上线速度启发,Meta 正在采用一种把速度置于一切之上的数据中心设计。他们已经在建更多这样的设施了!传统的数据中心和房地产投资者仍对 xAI 的孟菲斯基地及其上线速度心有余悸,这次又将再度震惊。

这种设计不追求美观或冗余,只追求让算力尽快上线!从预制的供电和冷却模块到超轻型结构,速度至关重要,因为这里没有备用发电设施(即看不到柴油发电机)。
目前的供电使用 Meta 附近的自有变电站。Meta 很可能采用了复杂的工作负载管理,以最大限度利用从电网获得的每一瓦电力。在最热的夏日,它甚至可能需要关停部分工作负载。
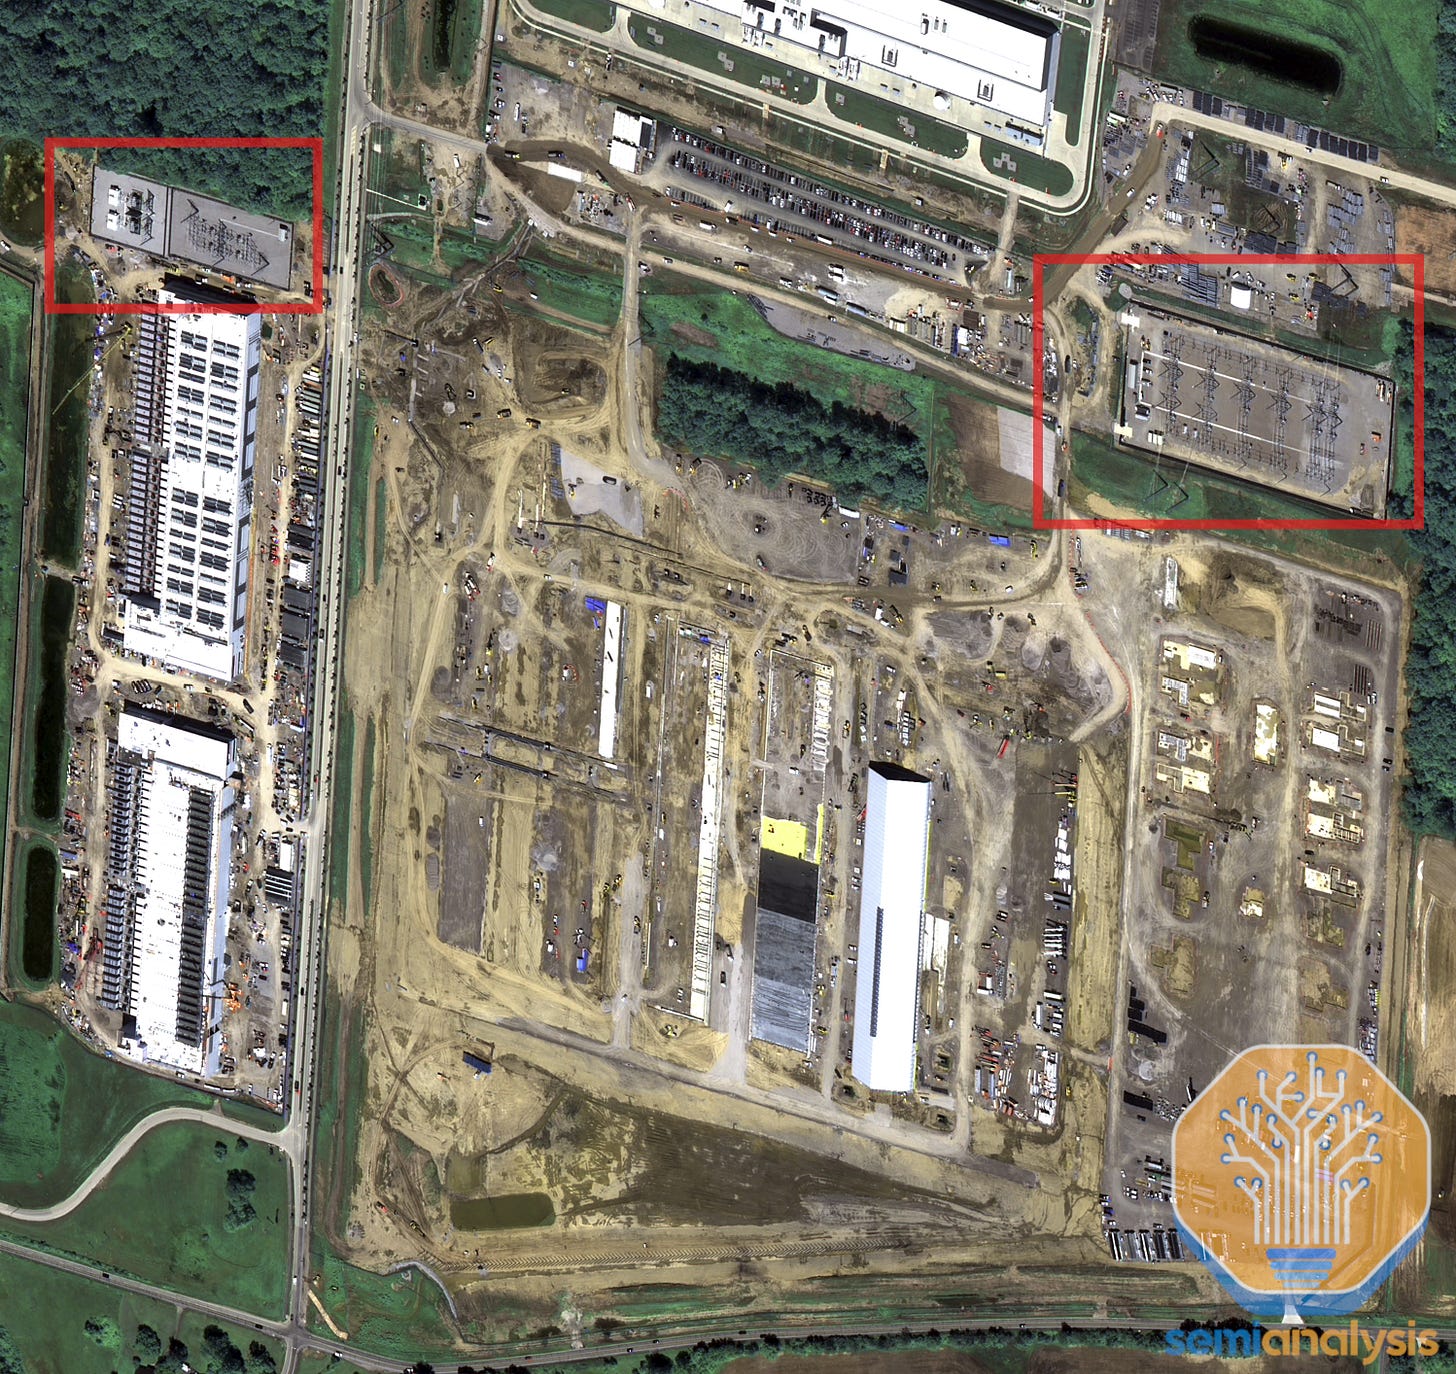
Prometheus 1GW AI 训练集群:“一切手段并用”的基础设施战略
Meta 正在俄亥俄州悄悄建设全球最大的 AI 训练集群之一。我们从其基础设施部门的消息来源得知,他们把这个集群称为 Prometheus。为了击败对手 AI 实验室,Meta 实行了“一切手段并用”的基础设施战略:
- 自建园区。
- 向第三方租赁。
- AI 优化设计。
- 跨多数据中心园区训练。
- 现场的表后(behind-the-meter)天然气发电。
从下面的 Prometheus 训练集群来看,我们认为 Meta 正在用超高带宽网络把所有这些站点连接起来,全部接入同一张后端网络,由搭载 Broadcom Jericho 和 Ramon ASIC 的 Arista 7808 交换机驱动。

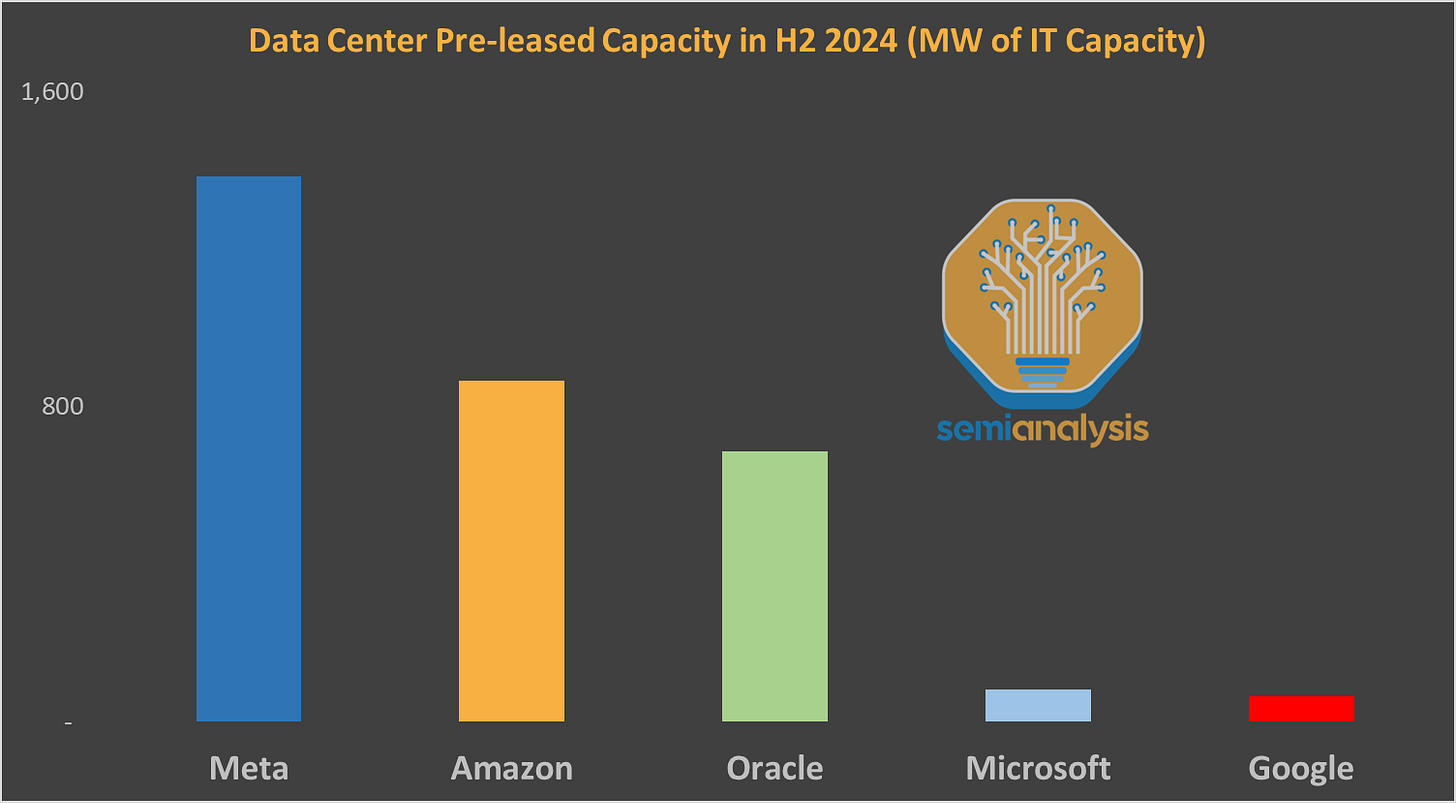
通过自建与租赁相结合,Meta 的爬坡速度更快。事实上,2024 年下半年它预租的容量超过任何一家超大规模云厂商,主要集中在俄亥俄州。
此外,当当地电网跟不上时,Meta 进入了彻底的马斯克模式。在 Williams 的协助下,他们正在建设两座 200MW 的现场天然气电厂。第一座的设备构成包括:
- 3 台 Solar Turbines 的 Titan 250 燃气轮机
- 9 台 PGM 130 燃气轮机
- 3 台 Siemens Energy 的 SGT400 燃气轮机
- 15 台 CAT 3520 往复式发动机

SemiAnalysis 后续的报告将针对为数据中心供电这一用途,更深入地剖析这些系统:成本、优缺点 & 其他。这对某家现场天然气解决方案供应商有重大的负面影响。
OpenAI 的这种总算力优势很重要,因为强化学习的兴起意味着,分布在美国各地的许多大型数据中心可以异步地为后训练提升模型智能做出贡献。
Meta 不甘示弱,其第二个前沿集群 Hyperion 的目标是抹平与 OpenAI 的这一差距。
规模上击败 Stargate:Meta 的 Hyperion 2GW 集群
在所有人的目光都集中在阿比林备受瞩目的 Stargate 数据中心时,Meta 已经为此筹划应对超过一年,并取得了巨大进展。位于路易斯安那州的集群预计将在 2027 年底成为全球最大的单体园区,第一期 IT 功率就超过 1.5GW。消息人士告诉我们,其内部代号为 Hyperion。
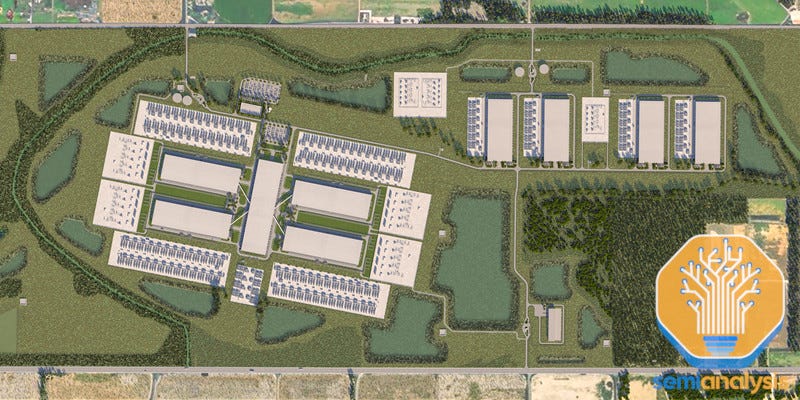
Meta 于 2024 年底破土动工,目前正在积极推进电力基础设施和数据中心园区的建设。
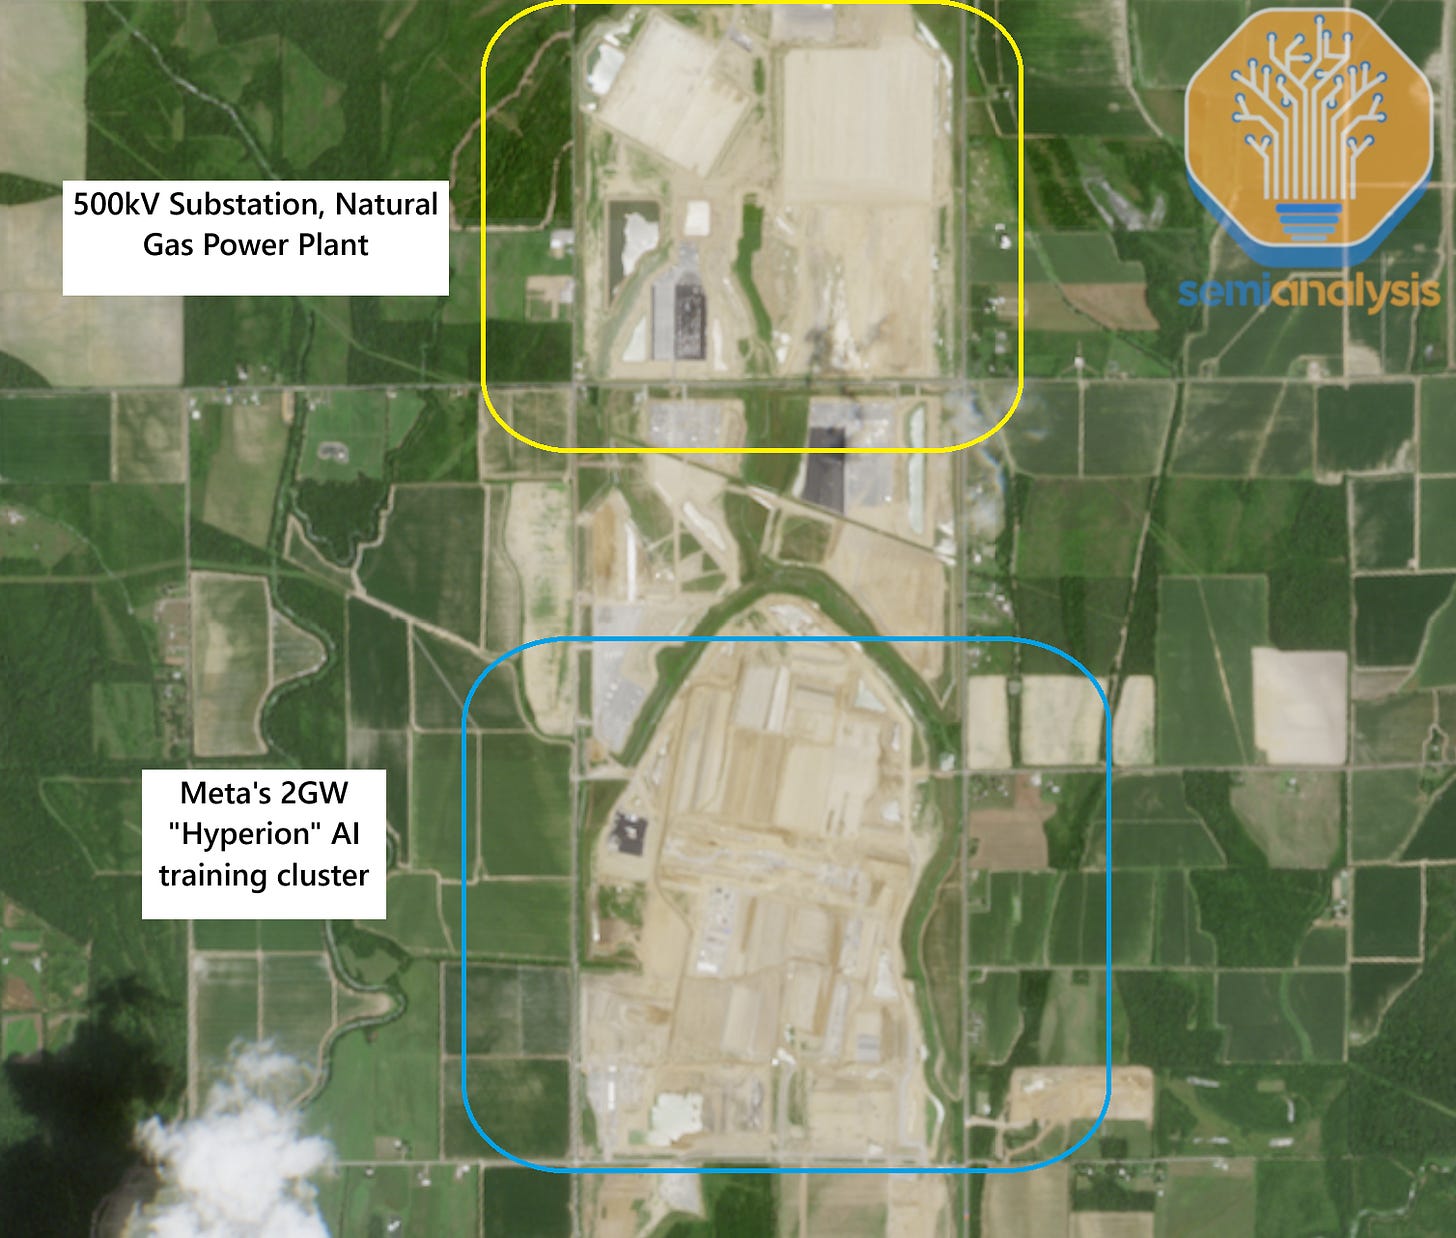
需要说明的是,Meta 还有许多其他数据中心正在建设和爬坡中。Meta 所有 AI 数据中心的完整清单、预计完工日期以及按季度划分的各栋楼的功率,可以在我们的数据中心行业模型中找到。
Llama 4 的失败:从开源王子到 Behemoth 穷光蛋
在深入探讨超级智能人才竞赛之前,我们应该先看看 Meta 是如何陷入这一尴尬境地的。在凭借 Llama 3 引领开源前沿之后,Meta 如今发现自己落后于中国的 DeepSeek。
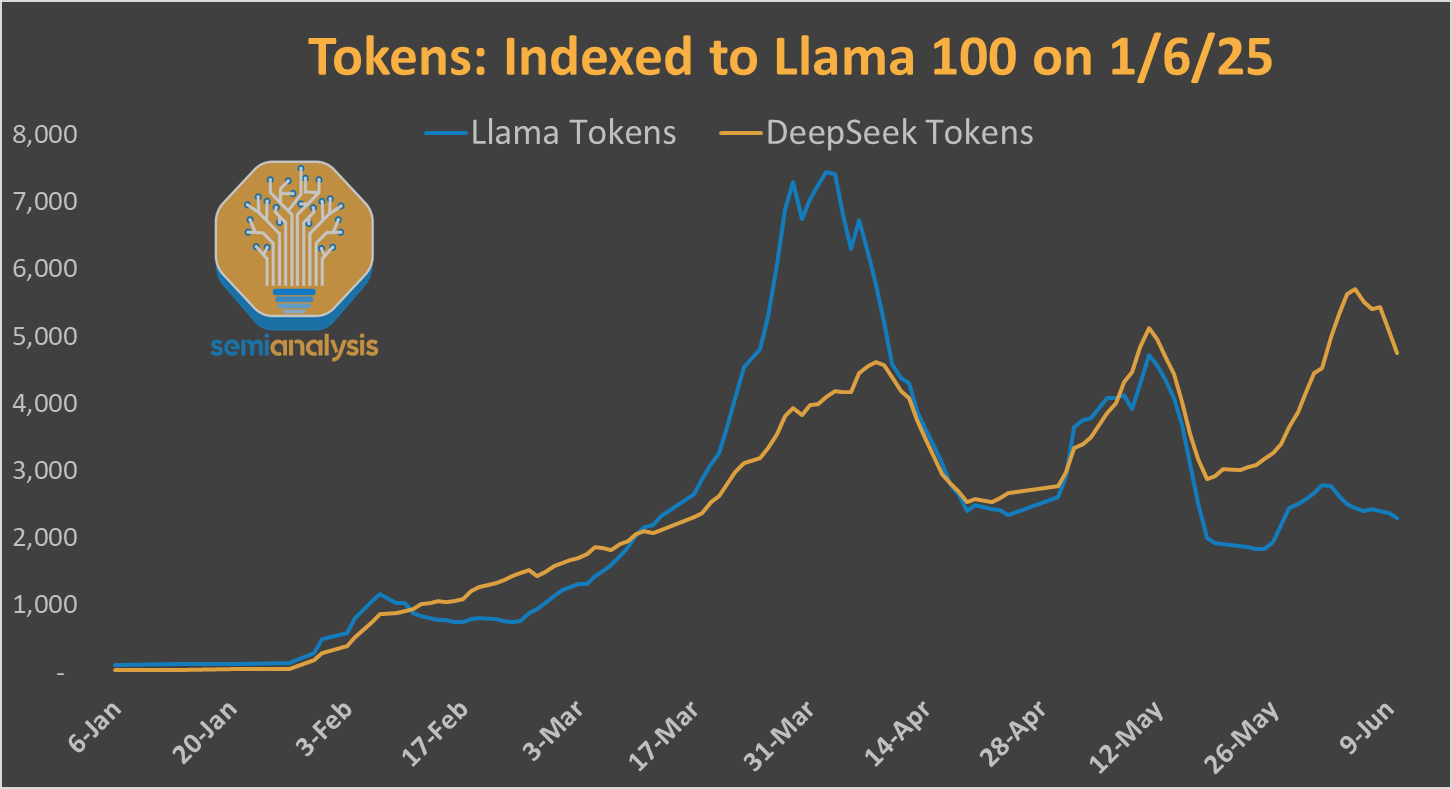
在技术层面,我们认为导致这次训练失败的主要因素如下:
- 分块注意力(Chunked attention)
- 专家选择路由(Expert choice routing)
- 预训练数据质量
- 扩展策略与协调
分块注意力
如果按朴素方式实现,大语言模型中的注意力计算量随 token 数量呈二次方增长。为了解决这个问题,研究人员提出了节省内存的机制。Meta 为 Behemoth 选择了分块注意力,而这可能是个错误。
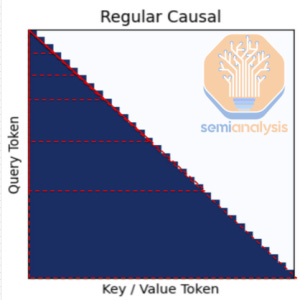
标准因果注意力:想象一系列从左上角向外扩展的三角形,代表后续每个 token 的注意力范围。token 数量翻倍,三角形的面积就变为四倍。
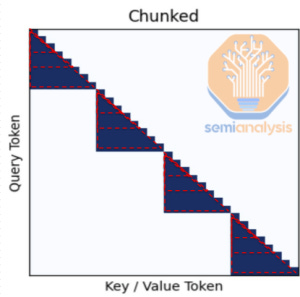
分块注意力把这个三角形拆成固定大小的块。每个块都会把注意力重置到一个新的“第一个”token。由于内存占用减少、效率提高,它可以支持更长的上下文。Meta 认为需要借此实现长上下文,但这种取舍并不划算。每个块中的第一个 token 无法访问之前的上下文。虽然有一些全局注意力层,但这还不够,下文将展开说明。
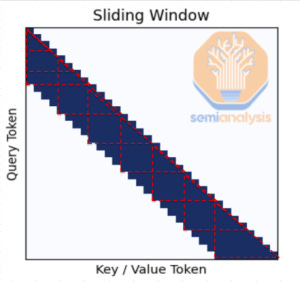
滑动窗口注意力(其他模型中有使用)提供了更平滑的替代方案:注意力窗口逐 token 向前滑动。这保持了局部连续性,不过远距离推理仍需要多层来传递上下文。
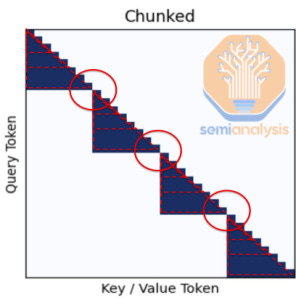
Behemoth 为追求效率而实现的分块注意力造成了盲区,在块边界处尤其明显。当思维链的长度超过一个块时,这会影响模型发展推理能力。模型难以跨越更长的范围进行推理。虽然事后看来这似乎显而易见,但我们认为问题的一部分在于,Meta 甚至没有搭建好合适的长上下文评测或测试基础设施,因而无法判断分块注意力不适合用于开发推理模型。Meta 在强化学习和内部评测方面落后很多,但新挖来的员工将大大帮助弥合推理方面的差距。
专家选择路由
大多数现代大语言模型使用混合专家(Mixture of Experts)架构,在模型的每两层之间,由路由器把 token 路由给不同的专家。在现代 MoE 模型中,大多数采用 token 选择路由训练,即路由器给出一个形状为 T x E 的张量(T 为总 token 数,E 为 MoE 模型中的专家数),并在 E 维度上执行 topK softmax,得到一个 T 乘 K 的张量。这实际上相当于要求路由器为每个 token T 选出概率最高的 K 个专家,其中 K 可以是一个或多个专家。K 是超参数,研究人员可以调节。
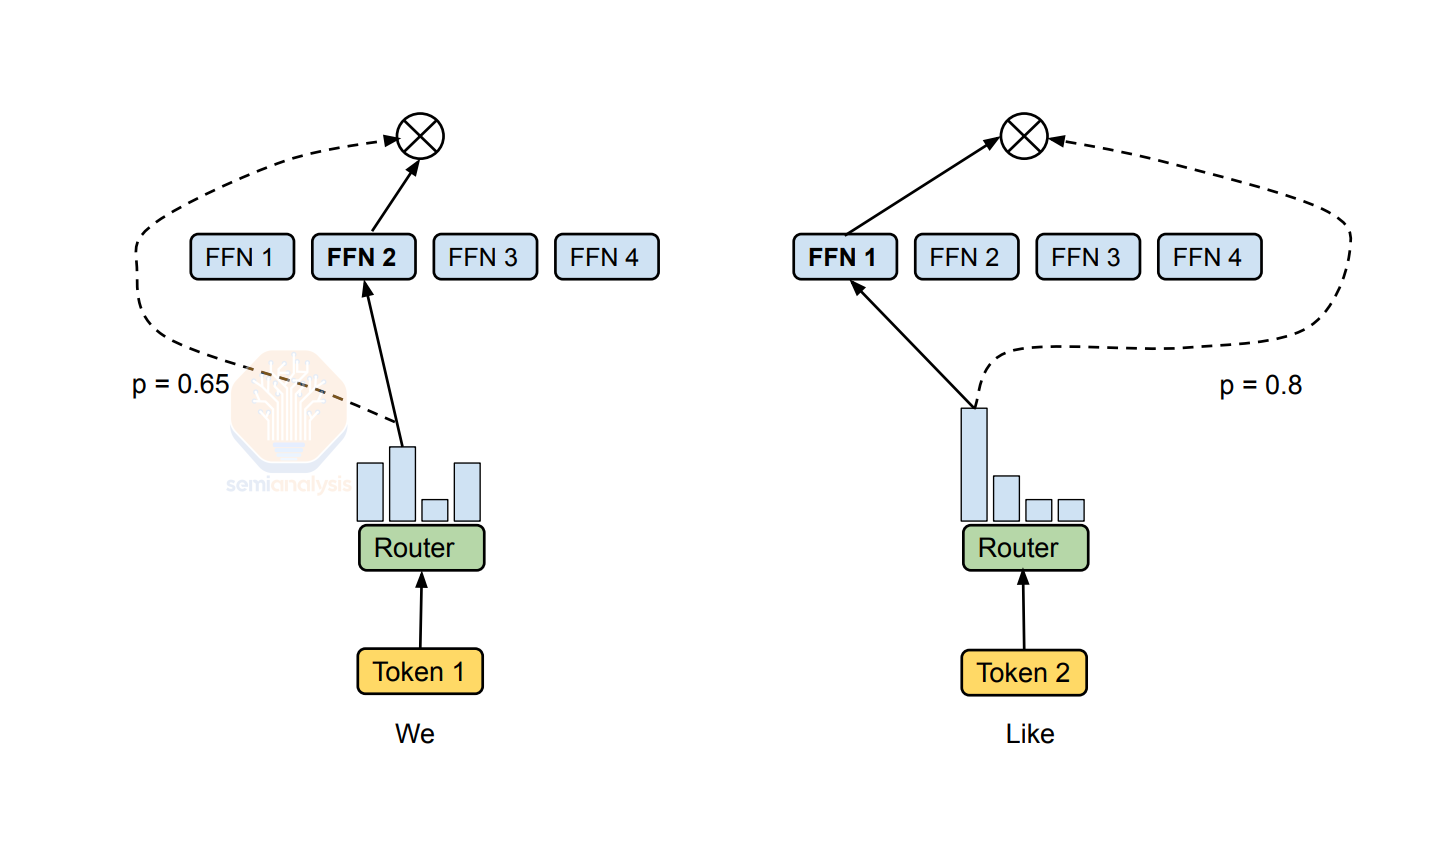
这种方法的优点是保证每个 token 都由 K 个专家处理,确保每个 token 的信息价值被相同数量的专家吸收。缺点是某些专家可能受到 token 不成比例的“欢迎”,而其他专家则训练不足,导致各专家的“智能”不平衡。这是一个已知问题,许多顶尖实验室已经通过辅助损失(或无损失)负载均衡开发出了修复方案。在使用 EP(专家并行)训练时,这可能导致训练 MFU 下降,因为模型分布在不同的 GPU 节点上,导致大量集合通信(NCCL)运行在横向扩展网络(InfiniBand 或 RoCE)上,而不是纵向扩展网络(NVLink)上。这正是 NVIDIA 设计 NVL72 的主要动机,它让纵向扩展网络超出了标准 8 路服务器的范围。
专家选择路由由 Google 于 2022 年提出,它把逻辑翻转过来:由专家选择前 N 个 token。对路由器产生的同一个 T x E 张量,专家选择路由在 T 维度上执行 topN softmax,得到一个 E 乘 N 的张量。这实际上意味着 E 个专家各自选出了概率最高的 N 个 token 进行路由。超参数 N 可由研究人员调节,但若要与 token 选择路由方法对比,则 N = K * T / E。
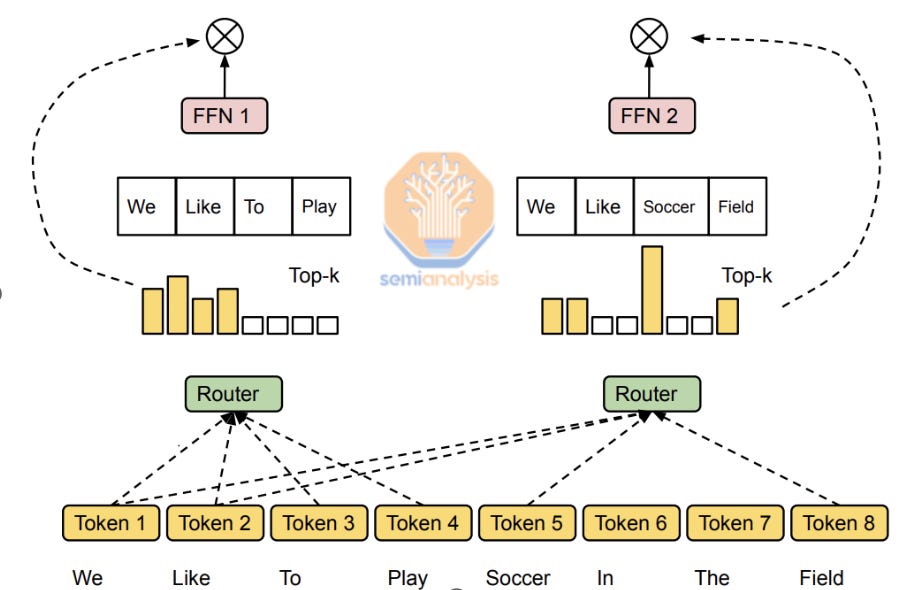
与 token 选择路由直接对比,专家选择路由能保证专家被均衡地激活,避免专家不均衡带来的性能下降。需要说明的是:两种情况下做出选择的都是路由器。在 token 选择中,路由器的输入是 token,由它挑选专家;在专家选择中,路由器的输入是专家,由它挑选 token。
这使专家训练的负载均衡,并提高了分布式硬件上的 MFU。超大规模云厂商的网络正是为这种并行方式专门打造的,我们在网络模型中对此有详尽介绍。
这种方法的缺点与 token 选择架构正好相反。专家选择路由可能导致某些“热门”token 被多个专家处理。虽然这不会产生 token 选择路由中存在的那种训练瓶颈,但由于大语言模型此时不再平等地关注所有 token,可能导致模型泛化能力下降。此外,大多数 EC 模型需要以 TC 训练收尾,才能得到有效的大语言模型。
推理对 EC 来说也是一个问题。推理分为两步:预填充和解码。在预填充阶段,用户提示词被编码并加载到 KV 缓存中,这一步受限于 FLOPS。在解码阶段,模型一次一个 token、一次一层地计算注意力并运行模型的前馈网络。
在这里,专家选择路由会遇到困难,因为每层最初专家只能从 1 个 token x 批大小中进行选择,导致每个专家分到的 token 集合比训练时小得多(例如一次训练的每次迭代有 8k 序列长度 x 16 批大小 = 128k 个 token)。像训练时那样看到整个序列会破坏现代自回归模型的因果性,因此即便是 EC 模型也要混用 EC 和 TC。
Meta 在训练中途从专家选择路由切换到 token 选择路由,这对 EC 模型来说并不罕见。然而,切换带来的性能下降使得最终模型明显比完全用 TC 训练的模型更差。
数据质量:自己造成的伤口
Llama 3 405B 使用 15T token 训练,我们认为 Llama 4 Behemoth 需要的 token 数量要多得多,大了 3 到 4 倍的量级。获得足够高质量的数据是一个主要瓶颈,西方超大规模云厂商无法通过抄其他模型输出的作业来走捷径。
在 Llama 4 Behemoth 之前,Meta 一直使用公开数据(如 Common Crawl),但在训练中途切换到了自己构建的内部网络爬虫。虽然这通常更优,但也适得其反。团队在清洗和去重新的数据流时遇到了困难,这些流程没有经过大规模的压力测试。
此外,与包括 OpenAI 和 Deepseek 在内的所有其他领先 AI 实验室不同,Meta 不使用 YouTube 数据。YouTube 的讲座文字稿和其他视频是极好的数据来源,没有这些数据,公司在打造多模态模型上可能会很吃力。
扩展实验
除上述技术问题之外,Llama 4 团队还难以把研究实验扩展为完整的训练运行。当时存在相互竞争的研究方向,又缺乏能决定哪个方向最有成效的领导者。某些模型架构选择没有经过恰当的消融实验,就被直接放进了模型。这导致扩展阶梯(scaling ladder)管理不善。
为说明扩展实验有多难,我们来看看 OpenAI 的 GPT 4.5 训练。OAI 内部的代码单体仓库对训练模型非常重要,因为在做训练消融时,他们需要一个已知未被污染的验证数据集来衡量困惑度。在扩展 GPT 4.5 训练实验时,他们看到模型泛化能力有了可喜的进展,却在训练中途意识到,单体仓库的部分内容是直接从公开数据中复制粘贴来的。模型并不是在泛化,而是在复述从训练数据集中记住的代码!大规模预训练需要极大的细致和准备才能有效执行。
尽管存在所有这些技术问题,并非一无所获。Meta 仍然能够把 logits 蒸馏到更小、更高效的预训练模型 Maverick 和 Scout 中,绕开了大模型一部分有缺陷的架构选择。对于较小的模型,蒸馏比强化学习高效得多。话虽如此,这些模型仍受限于其来源的局限:它们在同等规模下并不是最佳。
Meta GenAI 2.0 第二部分:弥合人才差距
随着基础设施改造正在推进、技术教训也已吸取,Meta 的 GenAI 2.0 战略现在转向超级智能的下一个要素:人才。
马克·扎克伯格(Mark Zuckerberg)清楚自己与领先 AI 实验室之间的人才差距,并亲自接管了招聘。他的目标是打造一支规模不大但人才密度极高的团队,随手开出数千万美元的签约奖金。目的是形成“飞轮效应”:顶级研究员加入这场冒险,为项目带来公信力和势头。从近期的高调招募来看,这已经奏效,包括:
- Nat Friedman,前 GitHub CEO
- Alex Wang,前 Scale AI CEO
- Daniel Gross,曾任 Ilya Sustkever 创办的初创公司 SSI 的 CEO 兼联合创始人。
招募说辞很有吸引力:无与伦比的人均算力、打造最佳开源模型家族的机会,以及超过 20 亿日活跃用户的触达。每位研究员 4 年通常 2 亿至 3 亿美元的报价也强化了这一说辞。因此,Meta 已从 OpenAI、Anthropic 和许多其他公司挖来了出色的人才。
并购 & Scale AI 等
据报道,扎克伯格曾向 Thinking Machines 和 SSI 都提出过收购要约,但被拒绝。虽然有人指出扎克伯格是“退而求其次”选了 Scale AI,但我们不认为是这样。正如我们所讨论的,Llama 4 的许多问题的核心都是数据问题,而收购 Scale 正是针对这一点的直接举措。
Alex 将带来 Scale 的许多顶尖工程师,尤其是专注于评测的 SEAL 实验室,而评测恰恰是 Meta 迫切需要的。SEAL 开发了推理模型评测的顶级基准之一 HLE(Humanity’s Last Exam)。随着 Nat Friedman 和 Daniel Gross 加入团队,Meta 获得的不仅是精英运营者,还有 AI 圈子里两位最高产、最受尊敬的投资人。Meta 高层有非常强的产品人才。
买得越多,省得越多:OBBB 版
扎克伯格选这个时间开启这轮大手笔支出再合适不过了。One Big Beautfiul Bill 中有一些专门针对超大规模云厂商的税收优惠,可能会极大地强化现在就大举建设的税收激励。由联邦政府出资的超级智能,就是现代的曼哈顿计划。