利用密码学安全环境,建立对专有模型基准测试的信任
设想一名学生即将参加一场关键考试。如果他不小心提前看到了试题,那么满分就受到了这一信息的影响,成绩也就毫无意义。要真正衡量他掌握了多少,在考试开始之前,他必须完全看不到试题。业界在评估先进 AI 模型时面临的正是这一难题。如果模型已经见过测试题,也就是所谓的基准污染(benchmark contamination),那么评估结果就只能在一定程度上被信任。
今天,我们推出全球首个针对专有前沿级 AI 模型的双盲评估。它把外部评估限制在一个密码学“盒子”里,模型之后无法利用这些评估内容在测试之前优化表现。我们正与 Singapore AI Safety Institute、OpenMined、AVERI 和 MLCommons 合作,在隐私保护环境中,用保密基准测试一个 Gemini Flash Lite 模型,以提高评估的完整性。
在 Google,我们在模型开发和部署的整个过程中,使用各种各样的评估来检验 AI 系统,但并不只依赖内部测试。为了发现潜在的盲点,我们与多元的外部合作伙伴共同工作,其中包括专业研究实验室、民间社会组织以及各国的 AI 安全与保障研究所(AISI),借助他们的独特专长对我们的模型进行压力测试。
随着 AI 模型能力不断增强,确保模型事先没有见过测试题或提示词至关重要,因为这会扭曲结果。政策制定者、研究人员和企业都需要相信,AI 基准测试能准确反映模型真实的能力和安全性;但如果模型能够提前“偷看”评估题目,就会人为抬高分数,损害这种信任。
虽然零日志协议和严格的合同保障长期以来一直让外部测试提示词保持保密,但引入技术和密码学层面的保障,标志着安全模型评估迈出了重要一步。
双盲评估如何运作
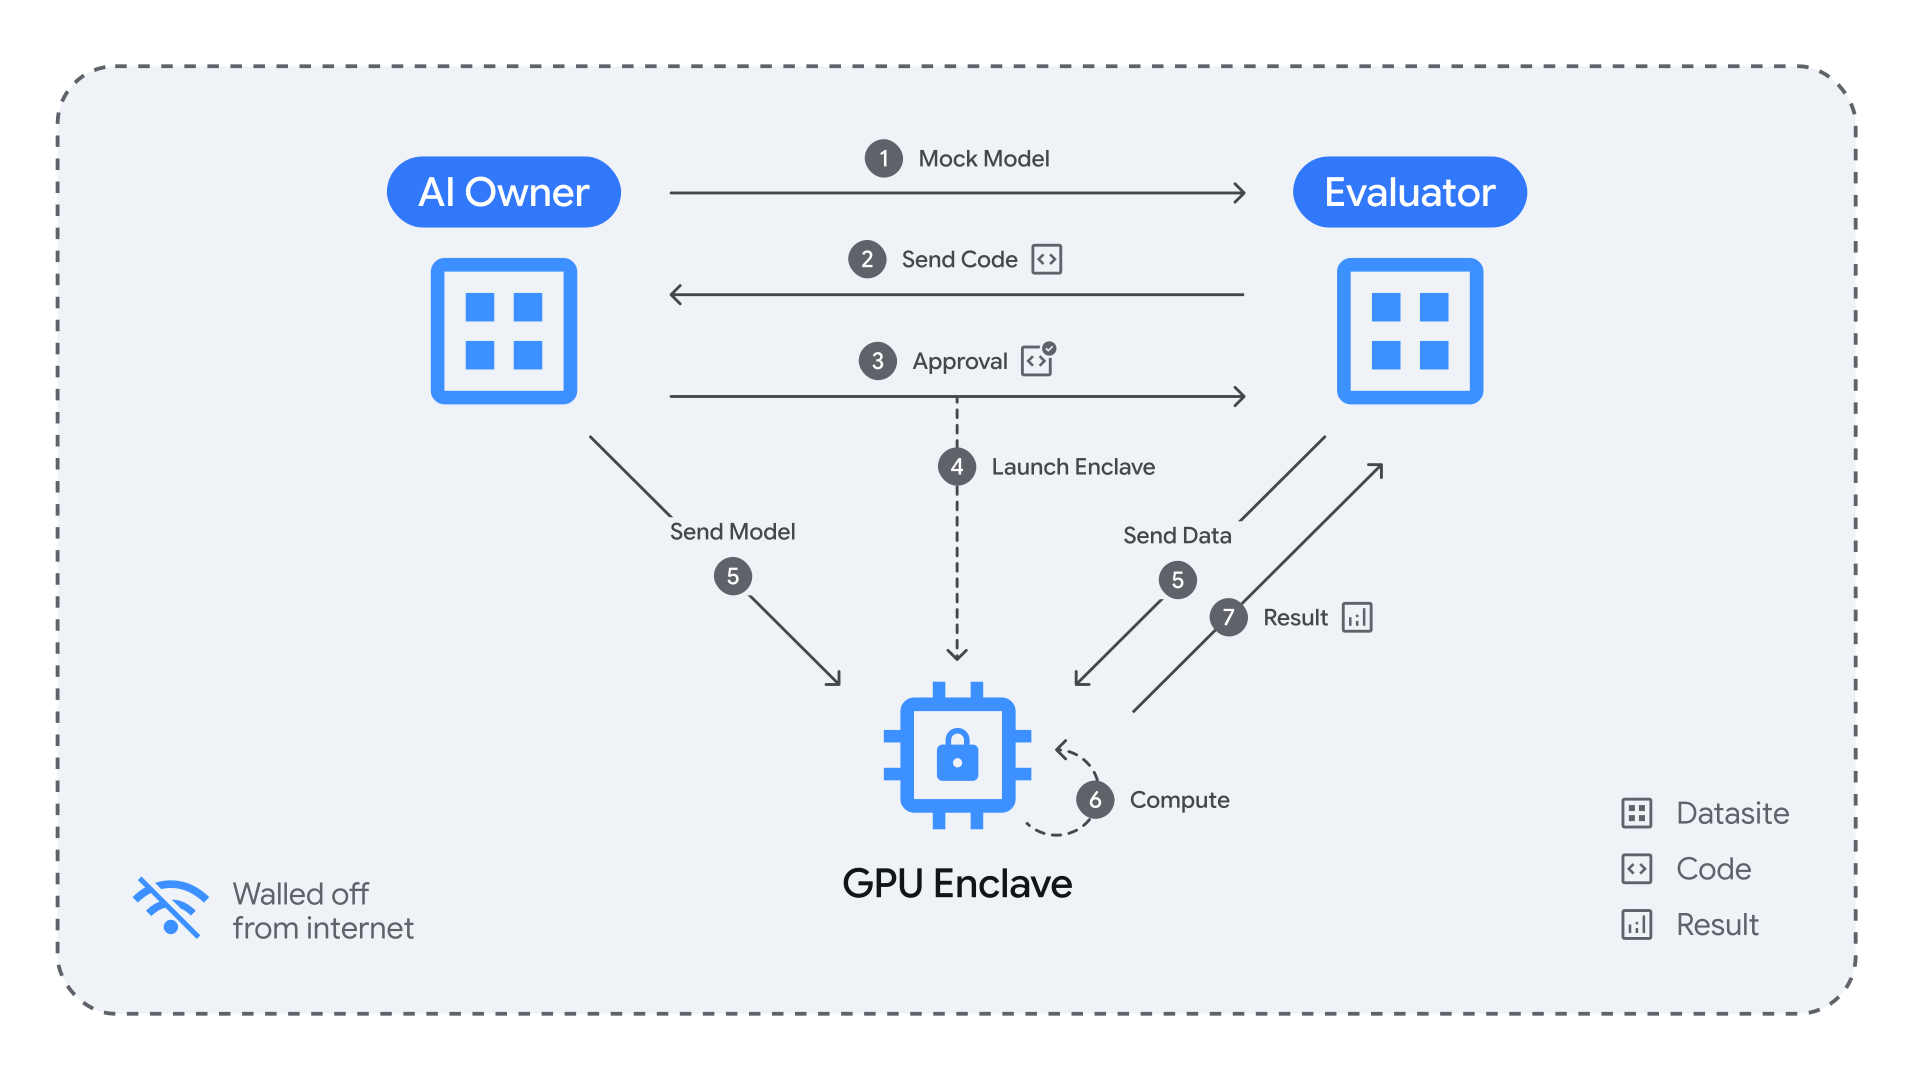
过去,高风险的外部评估需要做出取舍:要么由评估方交出测试提示词(模型提供方可能提前看到试题),要么由模型提供方交出模型权重(其知识产权面临风险)。
双盲评估消除了这种妥协。借助 Google Cloud 机密计算(Confidential Computing)产品组合中的 Confidential Space,我们可以通过密码学方式验证,外部评估数据和专有模型都只对各自的所有者保持私密。评估方看不到 Gemini 的模型权重,Google 也看不到评估方的测试提示词。
建立模型评估信任的新方法
这种密码学证据有助于防止基准污染,并保护敏感数据。随着模型能力增强,这对于高度敏感的评估尤为重要,例如网络安全评估或政府机构使用的评估。双盲评估让独立机构能够在不牺牲数据主权或安全的前提下,对先进模型进行严格测试。
我们希望这次试点能为模型监督开辟新的前沿,帮助整个行业构建更安全、更可靠、获得广泛信任的 AI 系统。要进一步了解我们的方法和发现,请阅读我们的技术报告。