随着 AI 智能体的能力越来越强,开发者开始让它们承担需要持续数小时甚至数天的复杂任务。然而,如何让智能体跨多个上下文窗口持续稳定地推进工作,仍是一个悬而未决的问题。
长时间运行的智能体面临的核心挑战是:它们只能以一个个离散的会话来工作,而每个新会话开始时,都不记得之前发生过什么。不妨设想一个由工程师轮班开发的软件项目,每位新接班的工程师都对上一班发生的事毫无记忆。由于上下文窗口有限,而大多数复杂项目又无法在单个窗口内完成,智能体需要一种办法来弥合不同编码会话之间的断层。
我们设计了一个双管齐下的方案,让 Claude Agent SDK 能够跨多个上下文窗口高效工作:一个是在首次运行时搭建环境的初始化智能体(initializer agent),另一个是编码智能体(coding agent),其任务是在每个会话中做出增量式进展,并为下一个会话留下清晰的产物。你可以在配套的 quickstart 中找到代码示例。
长时间运行智能体的问题
Claude Agent SDK 是一个功能强大的通用智能体运行框架(agent harness),既擅长编码,也擅长其他需要模型借助工具收集上下文、制定计划并执行的任务。它具备压缩(compaction)等上下文管理能力,使智能体能够在不耗尽上下文窗口的情况下处理任务。从理论上讲,有了这套机制,智能体应当能够在任意长的时间里持续做有用的工作。
然而,仅靠压缩是不够的。开箱即用的情况下,即便是 Opus 4.5 这样的前沿编码模型,在 Claude Agent SDK 上跨多个上下文窗口循环运行,如果只给它一个高层级的提示词,比如“构建一个 claude.ai 的克隆版”,也无法做出达到生产质量的 Web 应用。
Claude 的失败主要表现为两种模式。第一,智能体倾向于一次做太多事,本质上是想一步到位地做完整个应用。这往往导致模型在实现到一半时耗尽上下文,让下一个会话面对的是一个实现了一半且没有文档记录的功能。智能体随后不得不去猜测之前发生了什么,并花费大量时间让这个基础应用重新跑起来。即使有压缩机制,这种情况依然会发生,因为压缩并不总能把清晰无误的指令传递给下一个智能体。
第二种失败模式往往出现在项目的后期。在部分功能已经完成之后,后来的某个智能体实例环顾四周,看到已经取得了一些进展,便宣布任务完成。
这样就把问题拆成了两部分。首先,我们需要搭建一个初始环境,为给定提示词所要求的全部功能打下基础,让智能体能够逐步、逐个功能地推进工作。其次,我们应当提示每个智能体朝目标做出增量式进展,同时在会话结束时让环境保持整洁状态。我们所说的“整洁状态”,是指这样的代码:适合合并到主分支,没有重大缺陷,代码井然有序、文档齐全,总体而言,开发者可以轻松地着手开发新功能,而不必先清理一堆无关的烂摊子。
在内部实验中,我们用一个由两部分组成的方案解决了这些问题:
- 初始化智能体:第一个智能体会话使用专门设计的提示词,要求模型搭建初始环境,包括一个
init.sh脚本、一个记录各智能体已完成工作的 claude-progress.txt 文件,以及一次显示新增了哪些文件的初始 git 提交。 - 编码智能体:之后的每个会话都要求模型做出增量式进展,然后留下结构化的更新。1
这里的关键洞见在于,要找到一种办法,让智能体在全新的上下文窗口中开始工作时能够迅速了解工作状态,而这是通过 claude-progress.txt 文件配合 git 历史实现的。这些做法的灵感来自我们对高效软件工程师日常工作方式的了解。
环境管理
在更新后的 Claude 4 提示词指南中,我们分享了多上下文窗口工作流的一些最佳实践,其中包括一种“为第一个上下文窗口使用不同的提示词”的运行框架结构。这个“不同的提示词”要求初始化智能体搭建好环境,并提供后续编码智能体高效工作所需的全部上下文。下面,我们对这类环境的几个关键组成部分做更深入的介绍。
功能清单
为了解决智能体一步到位做完整个应用,或过早认为项目已经完成的问题,我们提示初始化智能体在用户最初提示词的基础上,扩展出一份全面的功能需求文件。以 claude.ai 克隆项目为例,这意味着超过 200 项功能,例如“用户可以打开新对话、输入查询、按下回车并看到 AI 的回复”。这些功能起初都被标记为“失败”,这样后续的编码智能体就能清楚地看到完整功能是什么样子。
{
    "category": "functional",
    "description": "New chat button creates a fresh conversation",
    "steps": [
      "Navigate to main interface",
      "Click the 'New Chat' button",
      "Verify a new conversation is created",
      "Check that chat area shows welcome state",
      "Verify conversation appears in sidebar"
    ],
    "passes": false
  }
我们提示编码智能体只能通过修改 passes 字段的状态来编辑这个文件,并使用措辞强硬的指令,例如“删除或编辑测试是不可接受的,因为这可能导致功能缺失或出现缺陷”。经过一番实验,我们最终选择使用 JSON 格式,因为与 Markdown 文件相比,模型不太容易不当地修改或覆盖 JSON 文件。
增量式进展
有了这一初始环境框架,下一轮迭代中的编码智能体每次只被要求处理一项功能。事实证明,这种增量式的方法对于解决智能体一次做太多事的倾向至关重要。
在增量式工作的前提下,模型在每次修改代码之后让环境保持整洁状态,依然至关重要。实验中我们发现,要引导出这种行为,最好的办法是要求模型用描述清晰的提交信息把进展提交到 git,并在进度文件中撰写进展摘要。这样,模型就可以用 git 回退错误的代码修改,恢复代码库中可以正常工作的状态。
这些做法还提高了效率,因为智能体不必再去猜测之前发生了什么,也不必花时间让基础应用重新跑起来。
测试
我们观察到的最后一个主要失败模式是:Claude 倾向于在没有经过恰当测试的情况下就把某项功能标记为完成。在没有明确提示的情况下,Claude 往往会修改代码,甚至用单元测试或针对开发服务器的 curl 命令做测试,但无法意识到该功能并不能端到端地正常工作。
在构建 Web 应用的场景中,一旦明确提示 Claude 使用浏览器自动化工具,并像真人用户那样完成所有测试,它在端到端验证功能方面大多表现良好。
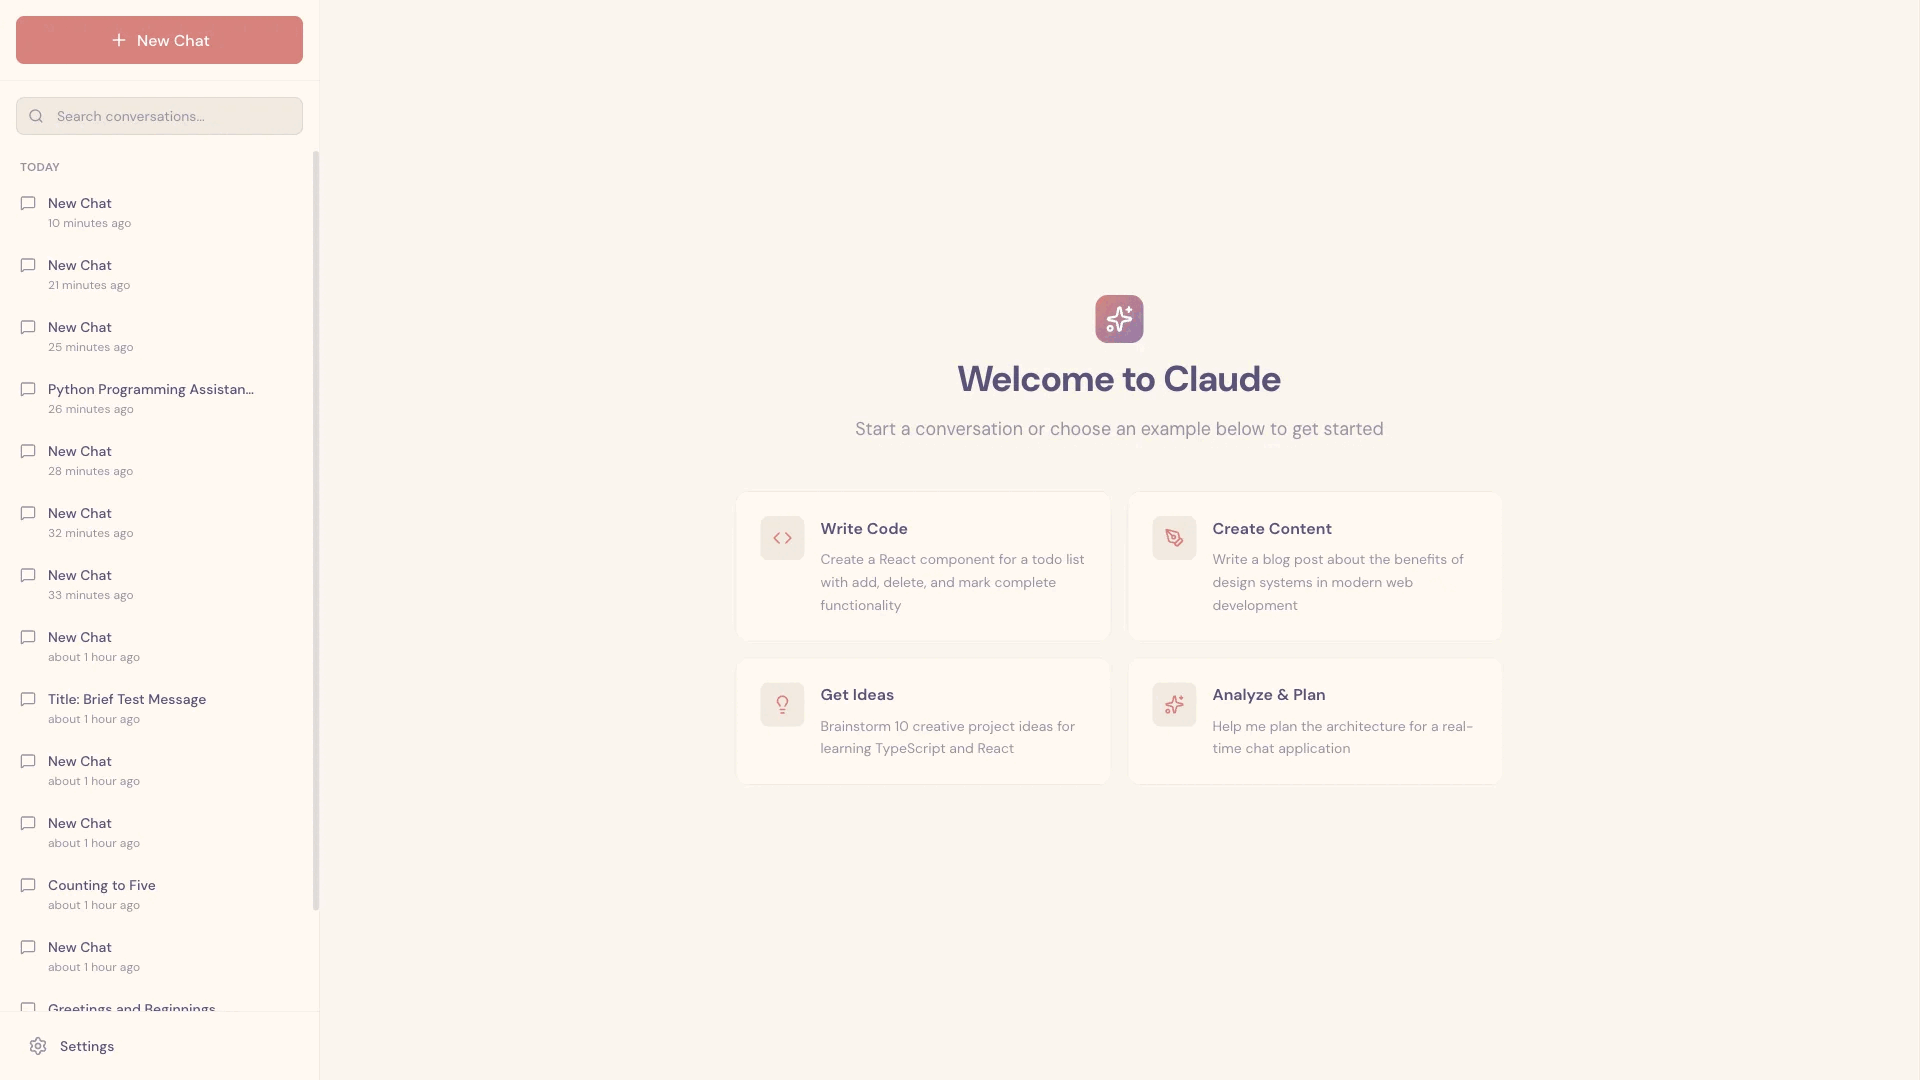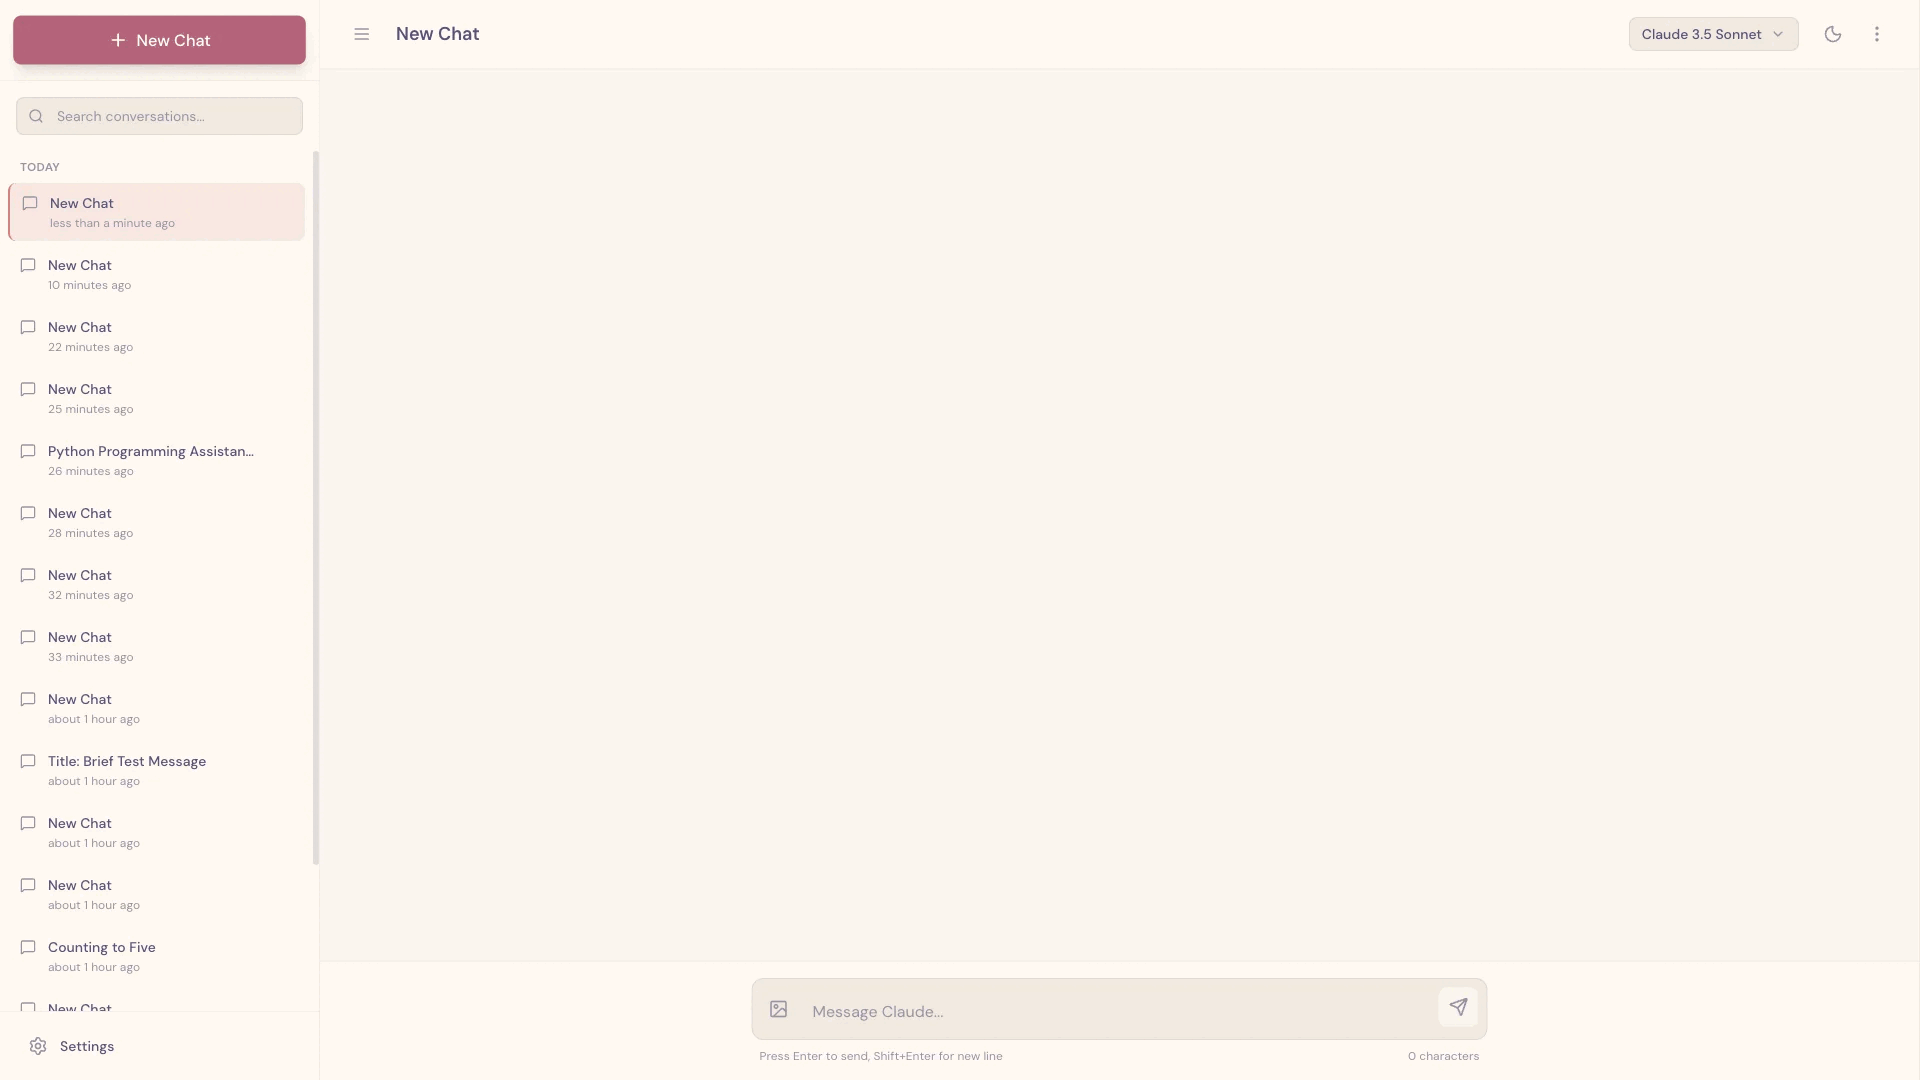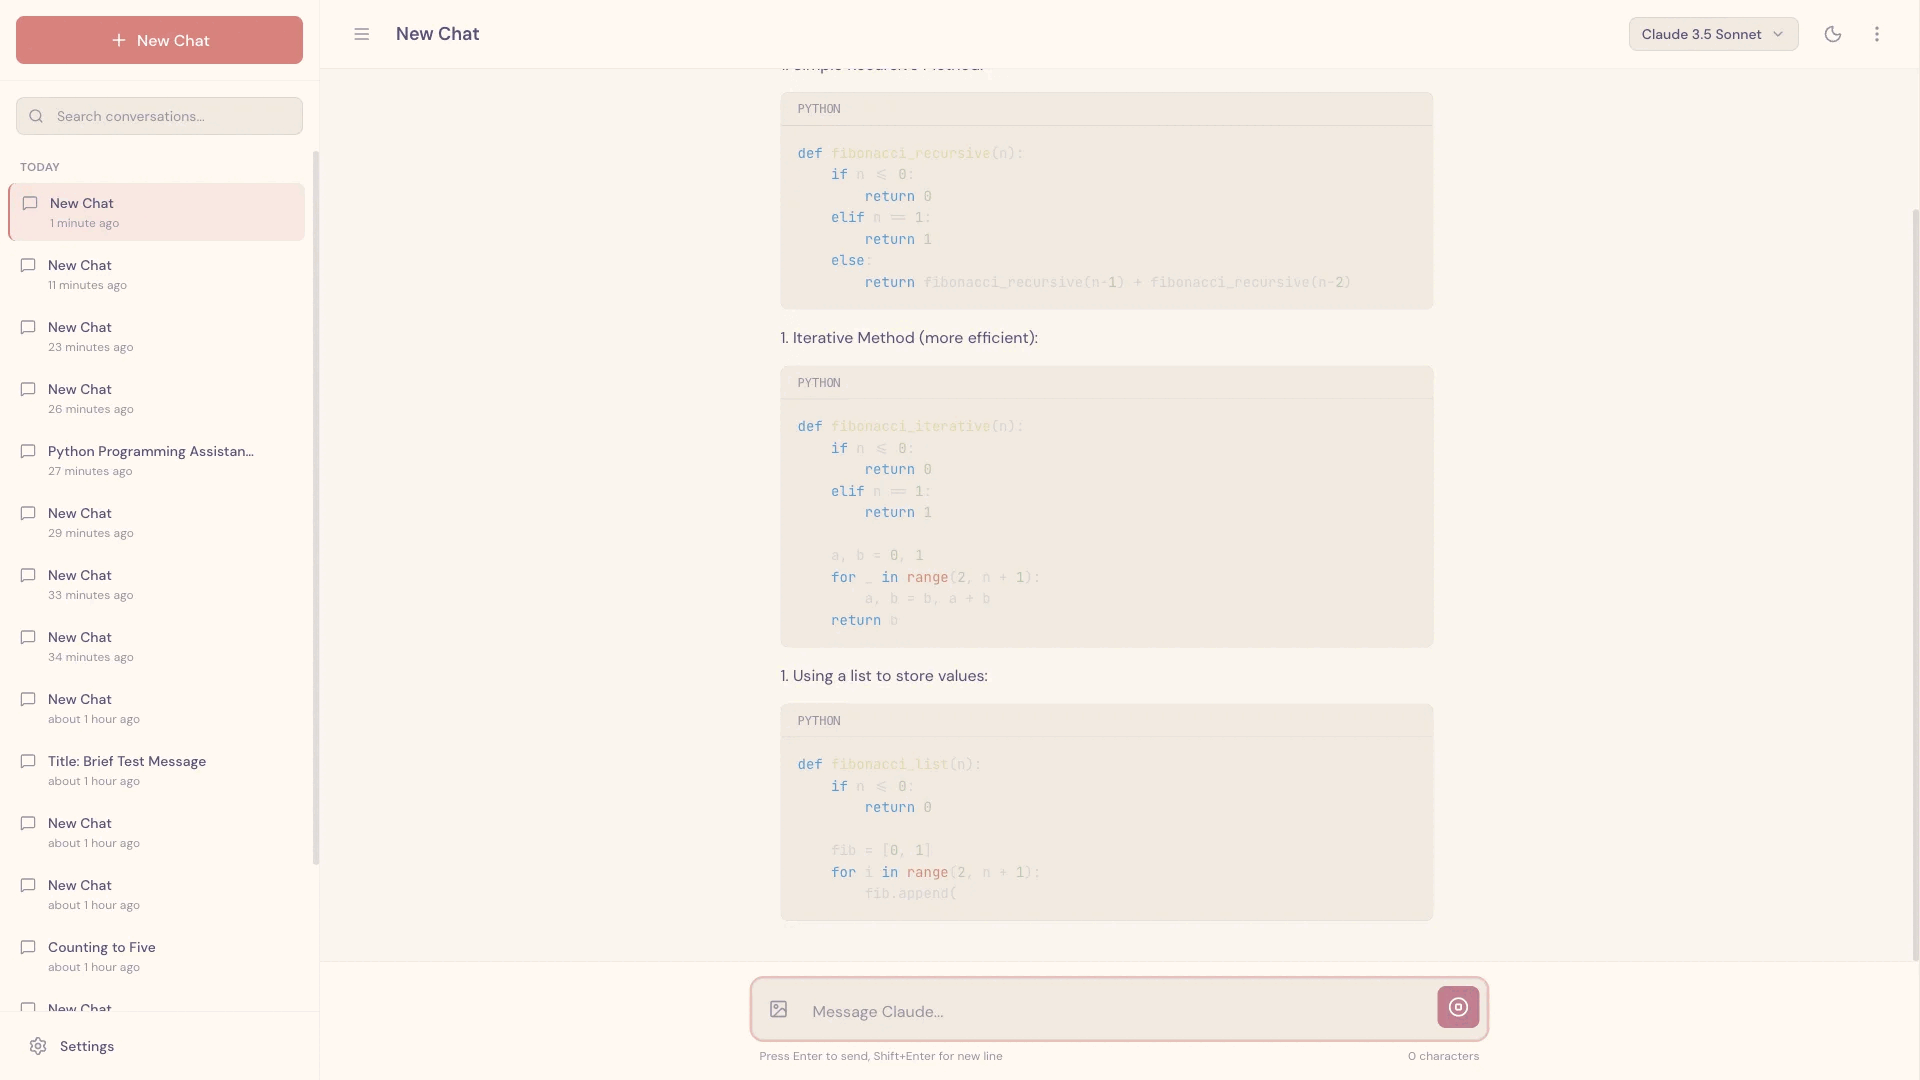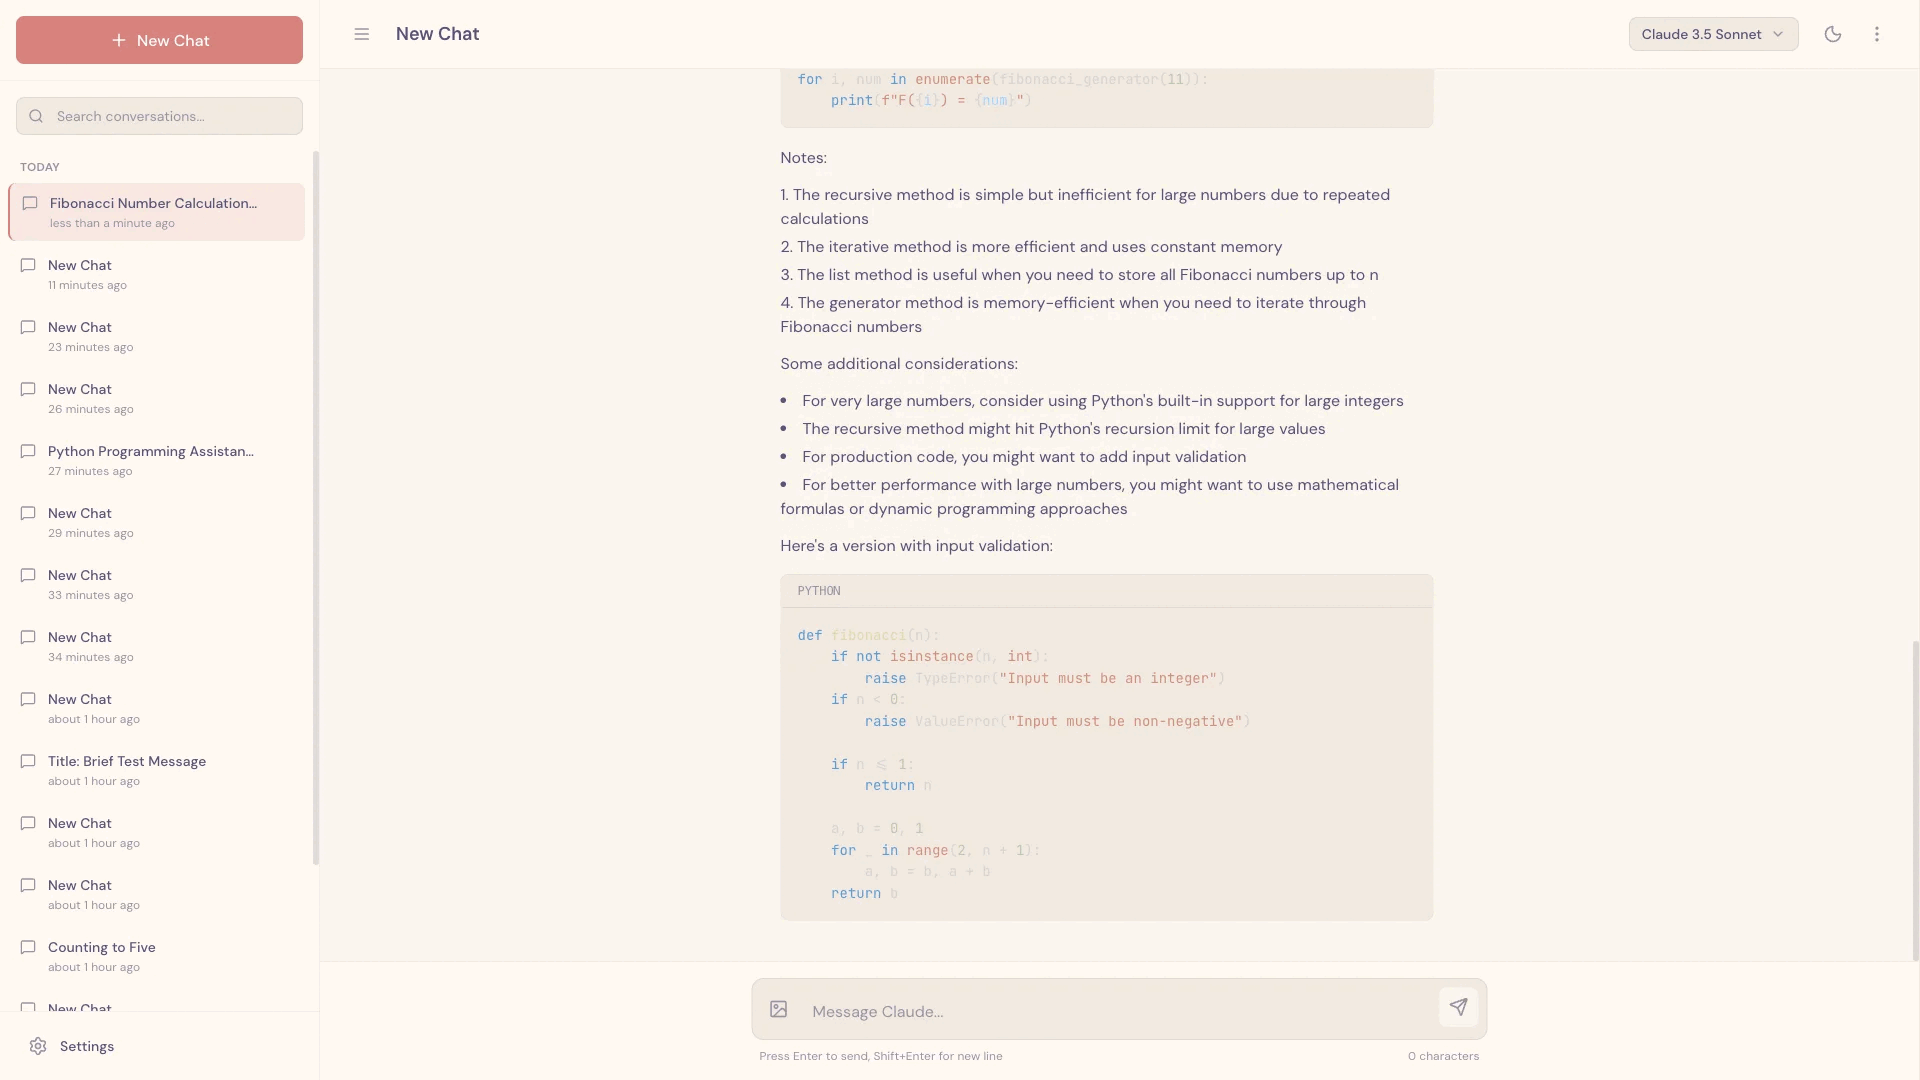
为 Claude 提供这类测试工具后,性能显著提升,因为智能体能够发现并修复仅凭代码本身难以察觉的缺陷。
仍有一些问题没有解决,例如 Claude 的视觉能力以及浏览器自动化工具存在局限,导致很难发现每一种缺陷。比如,Claude 无法通过 Puppeteer MCP 看到浏览器原生的警告弹窗,因此依赖这些弹窗的功能往往更容易出现缺陷。
快速进入状态
在上述一切就绪之后,每个编码智能体都会被提示依次执行一系列步骤来了解当前状况,其中有些步骤相当基础,但依然很有帮助:
- 运行
pwd查看你当前所在的目录。你只能编辑这个目录中的文件。 - 阅读 git 日志和进度文件,了解最近的工作内容。
- 阅读功能清单文件,选择尚未完成的最高优先级功能来开发。
这种做法让 Claude 在每个会话中节省了一些 token,因为它不必再摸索如何测试代码。另外,让初始化智能体编写一个能运行开发服务器的 init.sh 脚本,并在实现新功能之前先跑一遍基本的端到端测试,也很有帮助。
以 claude.ai 克隆项目为例,这意味着智能体总是先启动本地开发服务器,并使用 Puppeteer MCP 发起一次新对话、发送一条消息并接收回复。这样 Claude 就能迅速判断应用是否被遗留在了损坏状态,并立即修复已有的缺陷。如果智能体转而直接开始实现新功能,很可能会让问题更加恶化。
综上所述,一个典型的会话以如下的助手消息开场:
[Assistant] I'll start by getting my bearings and understanding the current state of the project.
[Tool Use] <bash - pwd>
[Tool Use] <read - claude-progress.txt>
[Tool Use] <read - feature_list.json>
[Assistant] Let me check the git log to see recent work.
[Tool Use] <bash - git log --oneline -20>
[Assistant] Now let me check if there's an init.sh script to restart the servers.
<Starts the development server>
[Assistant] Excellent! Now let me navigate to the application and verify that some fundamental features are still working.
<Tests basic functionality>
[Assistant] Based on my verification testing, I can see that the fundamental functionality is working well. The core chat features, theme switching, conversation loading, and error handling are all functioning correctly. Now let me review the tests.json file more comprehensively to understand what needs to be implemented next.
<Starts work on a new feature>
智能体的失败模式与解决方案
| 问题 | 初始化智能体的行为 | 编码智能体的行为 |
|---|---|---|
| Claude 过早宣布整个项目已经完成。 | 建立功能清单文件:根据输入的规格说明,创建一个结构化的 JSON 文件,列出端到端的功能描述。 | 在会话开始时读取功能清单文件,选择其中一项功能着手开发。 |
| Claude 留下的环境存在缺陷,或进展没有文档记录。 | 写入一个初始 git 仓库和进度记录文件。 | 会话开始时先阅读进度记录文件和 git 提交日志,并在开发服务器上运行基本测试,以发现未记录的缺陷。会话结束时撰写 git 提交并更新进度。 |
| Claude 过早地将功能标记为已完成。 | 建立功能清单文件。 | 对所有功能进行自我验证。只有经过仔细测试后,才能将功能标记为“通过”。 |
| Claude 需要花时间摸索如何运行应用。 | 编写一个能运行开发服务器的 init.sh 脚本。 |
会话开始时先阅读 init.sh。 |
总结长时间运行 AI 智能体的四种常见失败模式及其解决方案。
未来工作
这项研究展示了在长时间运行的智能体运行框架中,让模型能够跨多个上下文窗口做出增量式进展的一组可能的解决方案。不过,仍有一些问题悬而未决。
其中最突出的一点是,目前仍不清楚单个通用编码智能体是否在各种情境下表现最佳,还是采用多智能体架构能取得更好的效果。让测试智能体、质量保证智能体或代码清理智能体这样的专用智能体来处理软件开发生命周期中的各个子任务,也许能做得更好,这样的推测是合理的。
此外,这个演示是针对全栈 Web 应用开发优化的。未来的一个方向是把这些发现推广到其他领域。这些经验中的部分或全部,很可能同样适用于科学研究或金融建模等需要长时间运行的智能体任务。
致谢
作者:Justin Young。特别感谢 David Hershey、Prithvi Rajasakeran、Jeremy Hadfield、Naia Bouscal、Michael Tingley、Jesse Mu、Jake Eaton、Marius Buleandara、Maggie Vo、Pedram Navid、Nadine Yasser 和 Alex Notov 的贡献。
这项工作凝聚了 Anthropic 多个团队的共同努力,他们让 Claude 得以安全地完成长周期的自主软件工程,其中尤其要感谢代码强化学习(code RL)团队和 Claude Code 团队。有意参与的候选人欢迎通过 anthropic.com/careers 申请。
脚注
1. 之所以在此处把它们称为不同的智能体,只是因为它们的初始用户提示词不同。除此之外,系统提示词、工具集和整体的智能体运行框架完全相同。