今天,我们发布 Mistral Small 4。这是 Mistral Small 系列的下一个重大版本。Mistral Small 4 是 Mistral 首个把旗舰模型的能力统一到单一通用模型中的产品,这些旗舰包括负责推理的 Magistral、负责多模态的 Pixtral,以及负责智能体编码的 Devstral。有了 Small 4,用户不必再在快速的指令模型、强大的推理引擎和多模态助手之间做选择:一个模型就能同时提供这三种能力,推理强度可配置,效率同级最佳。
Mistral Small 4 以 Apache 2.0 许可证发布,延续我们对开放、易获取、可定制 AI 的承诺。
多模态、推理优化模型的新标准
Mistral Small 4 是一款混合模型,针对通用对话、编码、智能体任务和复杂推理进行了优化。其架构同时支持文本和图像输入,适用于各类应用。借 Mistral Small 4 发布之机,我们重申对开源模型的承诺,并很荣幸以创始成员身份加入 NVIDIA Nemotron Coalition,推动 AI 开发领域的协作与创新。
关键架构细节
- 混合专家(MoE):128 个专家,每个 token 激活 4 个,可实现高效的扩展与专业化。
- 总参数量 119B,每个 token 激活 6B 参数(含嵌入层和输出层为 8B)。
- 256k 上下文窗口,支持长篇交互和文档分析。
- 可配置的推理强度:可在快速、低延迟的响应与深度、推理密集的输出之间切换。
- 原生多模态:同时接受文本和图像输入,应用场景涵盖文档解析到视觉分析。
性能亮点
- 端到端完成时间缩短 40%(延迟优化配置)。
- 与 Mistral Small 3 相比,每秒处理的请求数提升至 3 倍(吞吐量优化配置)。
为什么选择 Mistral Small 4?
统一的能力
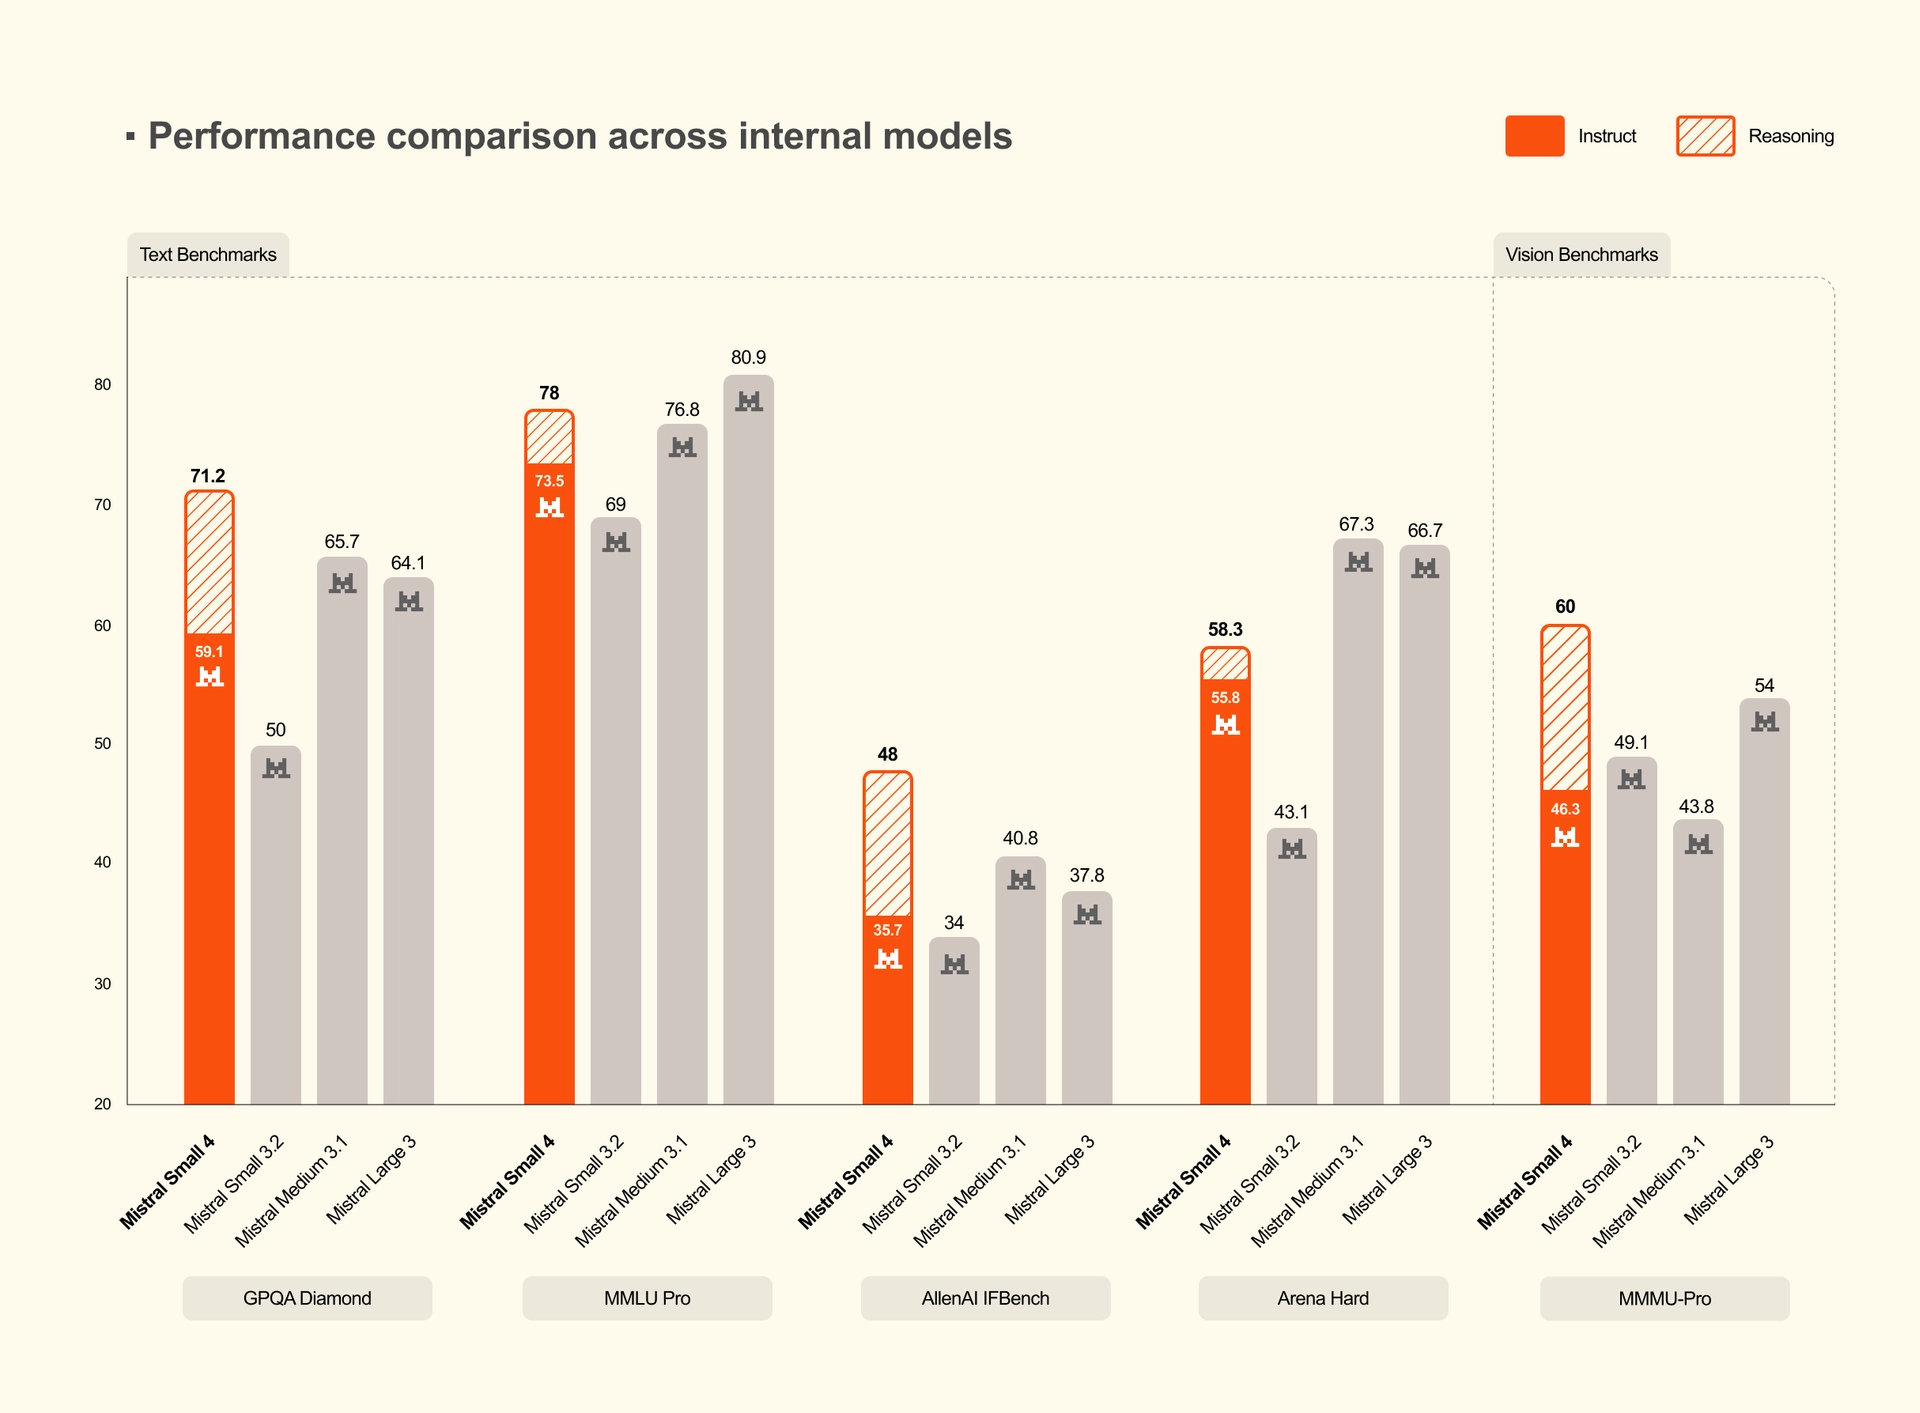
Mistral Small 4 把 Magistral(推理)、Devstral(编码智能体)和 Mistral Small(指令)的长处整合到一个模型中。无论你需要聊天助手、研究伙伴还是编码智能体,Small 4 都能适应任务,无需在专用模型之间来回切换。
按需推理
借助新的 reasoning_effort 参数,用户可以动态调整模型的行为:
reasoning_effort="none":快速、轻量的响应,适合日常任务,对话风格与 Mistral Small 3.2 相当。reasoning_effort="high":针对复杂问题的深度、逐步推理,详尽程度与此前的 Magistral 模型相当。
企业级效率
- 最低基础设施:4 块 NVIDIA HGX H100、2 块 NVIDIA HGX H200,或 1 台 NVIDIA DGX B200。
- 推荐配置:4 块 NVIDIA HGX H100、4 块 NVIDIA HGX H200,或 2 台 NVIDIA DGX B200,以获得最佳性能。
- Mistral Small 4 完全开源。你可以针对专门任务对其微调,也可以开箱即用于通用场景。得益于社区的协作,它现已支持 vLLM、llama.cpp、SGLang、Transformers 等。
- 交付先进的开源 AI 模型需要广泛的优化。通过与 NVIDIA 的紧密合作,我们针对开源的 vLLM 和 SGLang 都优化了推理,确保在各种部署场景下都能高效、高吞吐地提供服务。
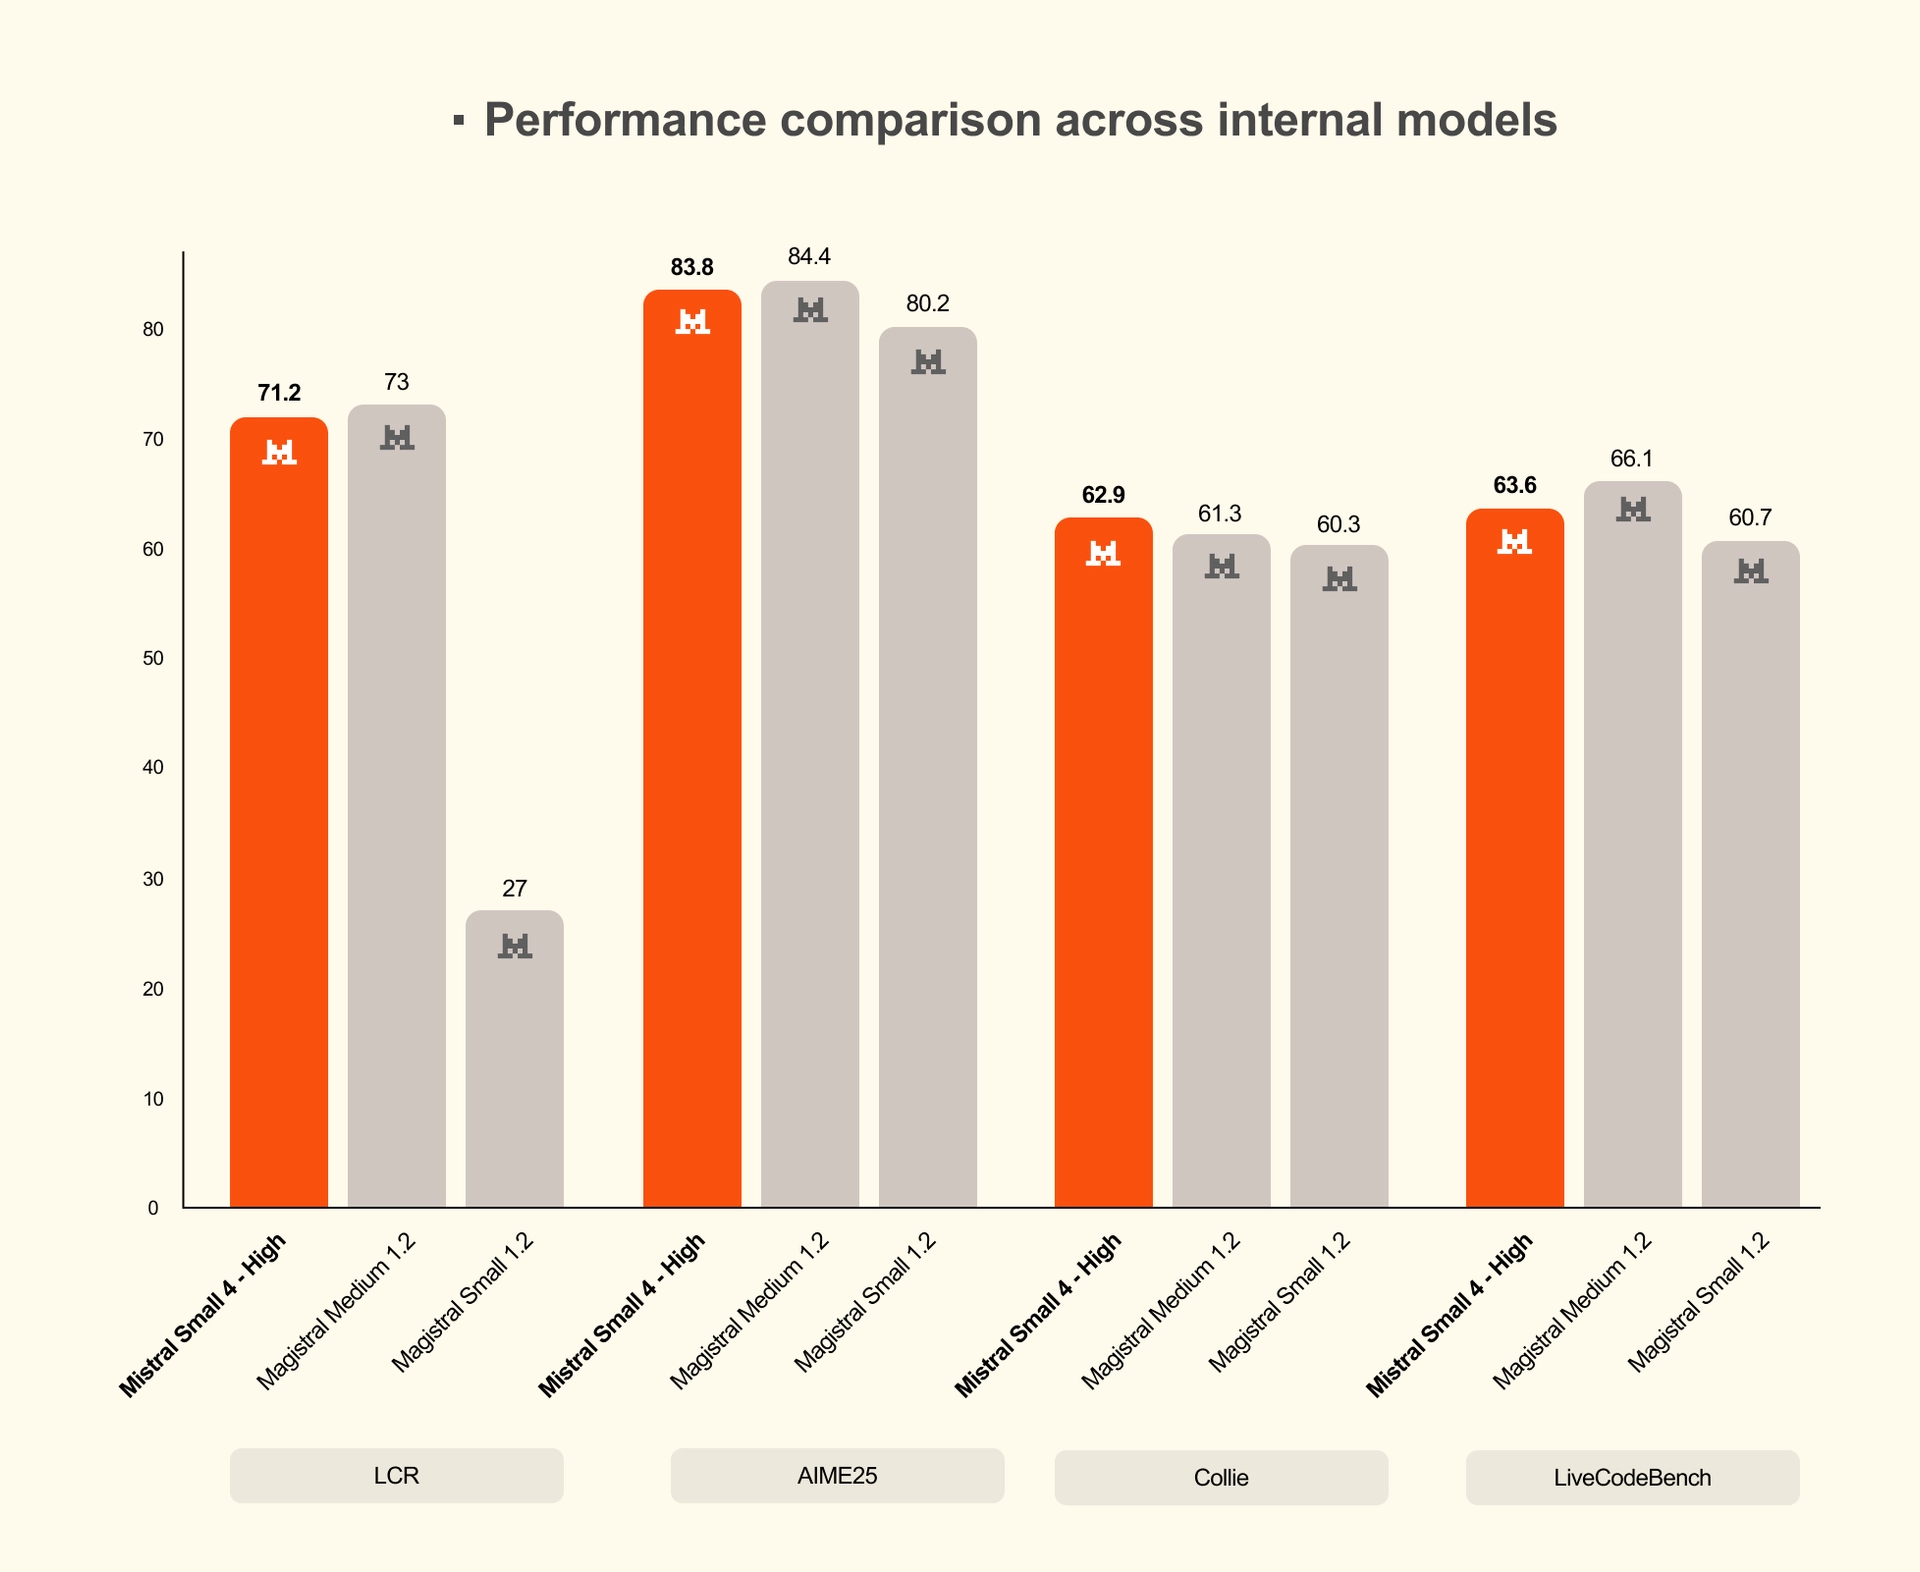
图:三项基准测试中的得分与输出长度对比。上图:准确率得分(越高越好)。下图:平均输出长度,单位为千字符(越短越好)。
开启推理的 Mistral Small 4 取得了有竞争力的成绩,在全部三项基准测试上持平或超过 GPT-OSS 120B,同时生成的输出明显更短。在 AA LCR 上,Mistral Small 4 仅用 1.6K 字符就拿到 0.72 分,而 Qwen 模型要多出 3.5 至 4 倍的输出(5.8 至 6.1K)才能达到相当的表现。在 LiveCodeBench 上,Mistral Small 4 的表现优于 GPT-OSS 120B,输出却少了 20%。这种效率差距在实践中很重要:输出更短,意味着延迟更低、推理成本更少、用户体验更好。
对企业采购方而言:
每个 token 的效率直接影响成本和可扩展性。当回答变长时仍能保持或提升表现的模型,可以减少人工干预,降低运营成本,并保证稳定的质量,即便是报告生成、客户支持或决策流程这类复杂且风险高的任务。混合推理模型在资源消耗不成比例增长的前提下实现准确率最大化,从而带来更高的价值,非常适合性能与成本效率都至关重要的大规模部署。
对技术团队和数据科学家而言:
每个 token 的表现是模型选型和优化的关键指标。扩展效率高的模型,让团队能够在不牺牲准确率、不推高计算成本的前提下,把方案部署到更长、更细致的任务上(例如详细分析、多步推理)。这意味着在质量与资源分配之间需要做的取舍更少,从而催生更具创新性、更可靠的 AI 应用。它还能简化微调和集成,因为模型的稳健性降低了持续调整或兜底系统的需求。
适用场景
Mistral Small 4 面向以下人群设计:
- 开发者:编码自动化、代码库探索和代码智能体工作流。
- 企业:通用聊天助手、文档理解和多模态分析。
- 研究人员:数学、研究和复杂推理任务。
其开源许可证和可定制的架构,使它非常适合微调和专业化。
可用性
- Mistral API 和 AI Studio
- Hugging Face 仓库
- 开发者可以在 build.nvidia.com 上免费基于 NVIDIA 加速计算对 Mistral Small 4 进行原型开发;用于生产部署时,Mistral Small 4 首日即以 NVIDIA NIM 形式提供,开箱即用地交付经过优化的容器化推理。也可以借助 NVIDIA NeMo 针对特定领域进行定制微调。
- 面向客户的技术文档可在我们的 AI Governance Hub 查阅
如需企业部署、定制微调或本地化方案,请联系我们的团队。
AI 的未来是开放的
通过统一指令、推理和多模态能力,Mistral Small 4 简化了 AI 集成,让用户用一个可灵活适配的工具应对更广泛的任务,把开源 AI 的益处带到真实世界的用例中。
Mistral Small 4
Apache 2.0
混合指令与推理的 MoE 模型;把 Instruct、Magistral 和 Devstral 统一为一个支持多模态输入的模型。
文本到文本
智能体
多模态
轻量
输入(/百万 token)
$0.15
输出(/百万 token)
$0.6