摘要
我们与斯坦福大学、威斯康星大学麦迪逊分校和 Bauplan 合作,测试 LLM 能否优化数据库查询执行计划。结果表明,由 LLM 引导的计划重写可以在不修改数据库引擎本身的前提下提升执行性能。
AI 近期的进步得益于底层系统基础设施的改进。但这种关系不必是单向的:AI 和 LLM 也可以用来优化大规模系统本身的功能组件。我们最近的论文展示了如何将 AI 用于数据库查询优化。
传统的查询优化依赖基于代价的估计器,它们使用统计模型和预定义的启发式规则来计算执行路径。执行类似“找出所有涉及太空旅行的科幻剧”这样的查询时,优化器必须决定执行策略:是先筛选科幻剧,再检查哪些涉及太空旅行,还是反过来?如果数据分布在多张表中(例如剧集表和类型表),应该先扫描哪张表,又该如何连接它们?优化器通过估计每个条件会匹配多少行来回答这些问题,然后选出估计代价最低的实际计划(即操作的顺序)。
然而,这些估计往往假设属性之间相互独立。以某流媒体服务的数据集为例,假设你想找出既是“科幻”又“涉及太空旅行”的剧集。如果 15% 的剧集是科幻,8% 涉及太空旅行,那么在独立性假设下,会估计 1.2% 的剧集同时满足两个条件(15% × 8%)。然而,太空旅行类的剧集绝大多数是科幻剧,所以实际的重叠比例接近 7%,比预测高出近 6 倍。
事实上,这些系统通常运行良好,但当启发式规则无法考虑模式(schema)或数据内部的语义相关性时就会吃力。正如 Lohman(2014)的一个例子所指出的,基数估计(cardinality estimation)是优化器低效的主要来源,因为行数估计的偏差会在代价模型中传播,并可能导致连接顺序、访问路径和物理算子的系统性糟糕选择。这种数量级的误差会产生次优的物理计划,需要大量工程投入才能手动修正。
查询优化是已经解决的问题吗?
这些估计误差持续存在,说明物理规划并不是一个已解决的问题,尤其是在函数依赖很常见的复杂 OLAP 工作负载中。
为此,我们提出了 DBPlanBench,这是一个暴露 Apache DataFusion 引擎查询执行过程的工具集(harness)。该系统向 LLM 暴露内部的物理算子图,包括连接策略和分区方案。这里的主要技术挑战在于原始物理计划本身信息密度过高:其中包含冗长的文件路径、分区元数据和类型编码,会迅速占满上下文窗口。
如果不经过细致的序列化,整个计划可能超过 200 万个字符,使 LLM 无法有效且高效地对输入进行推理。我们的工具集实现了一个序列化层,遍历引擎的物理算子图,把异构对象映射为统一的、节省 token 的 JSON 模式。
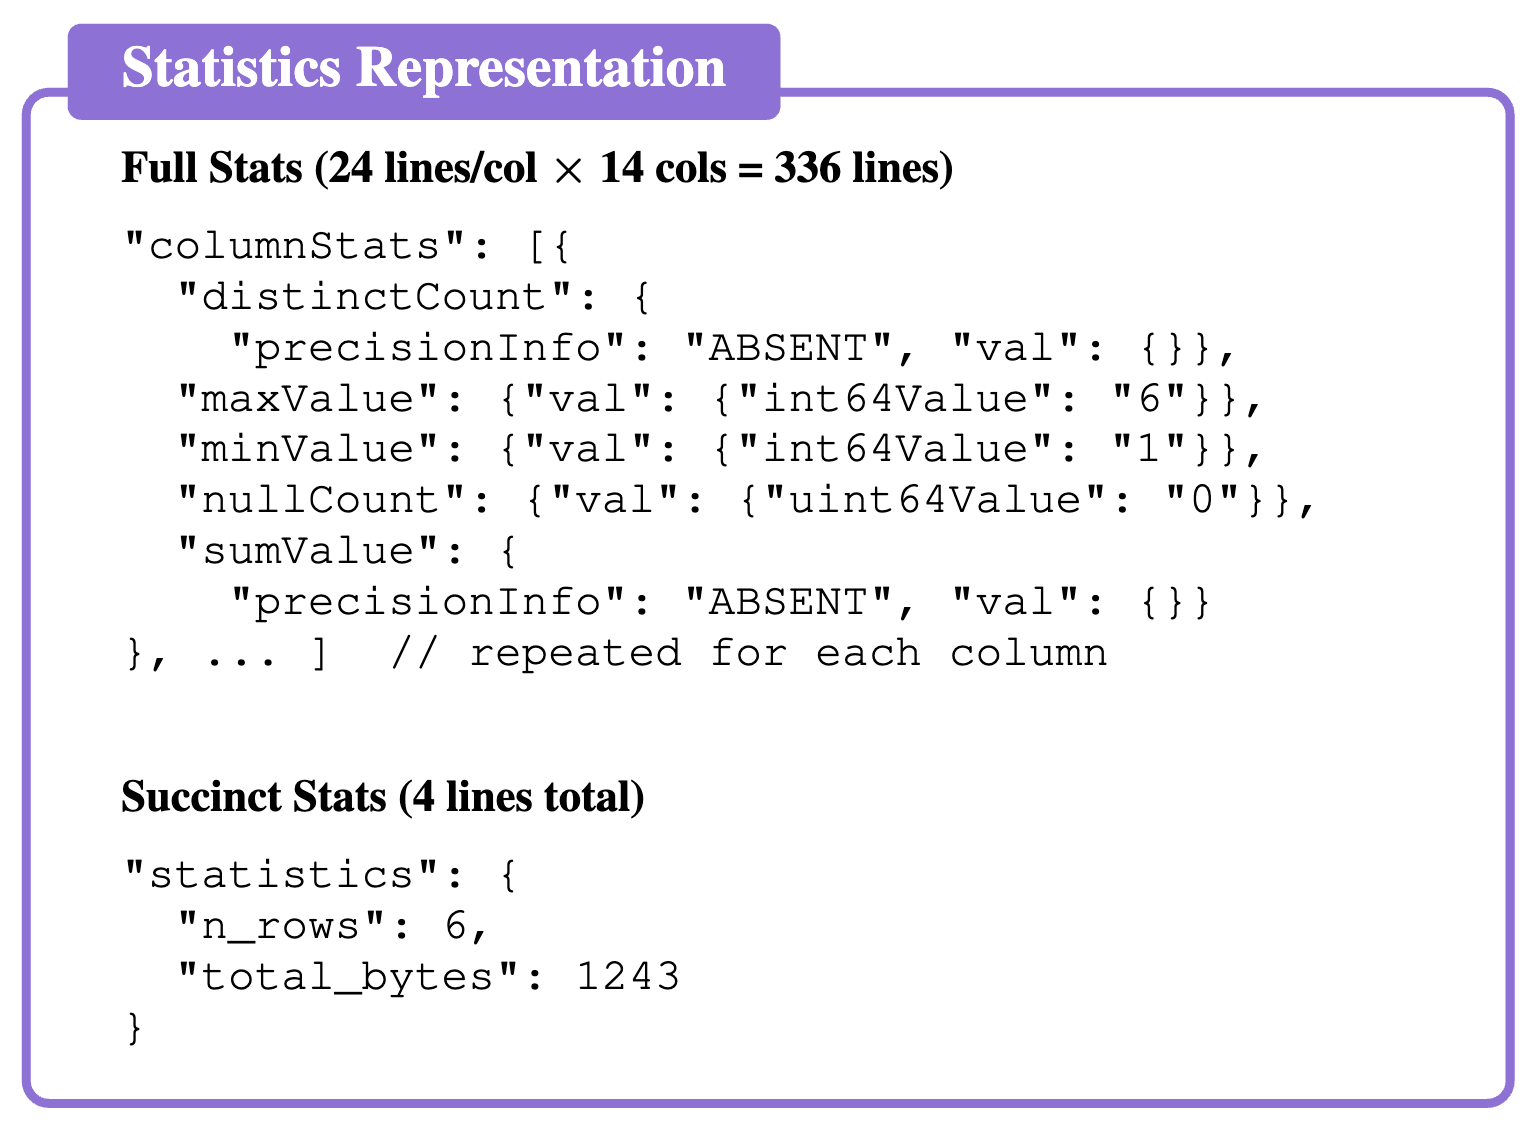
这种表示方式对文件级统计信息去重,并移除与执行无关的字段,使载荷比原生序列化小约 10 倍。
DBPlanBench 由此把优化任务从统计计算转变为语义推理问题:LLM 分析计划的拓扑结构,找出连接顺序中的逻辑缺陷。
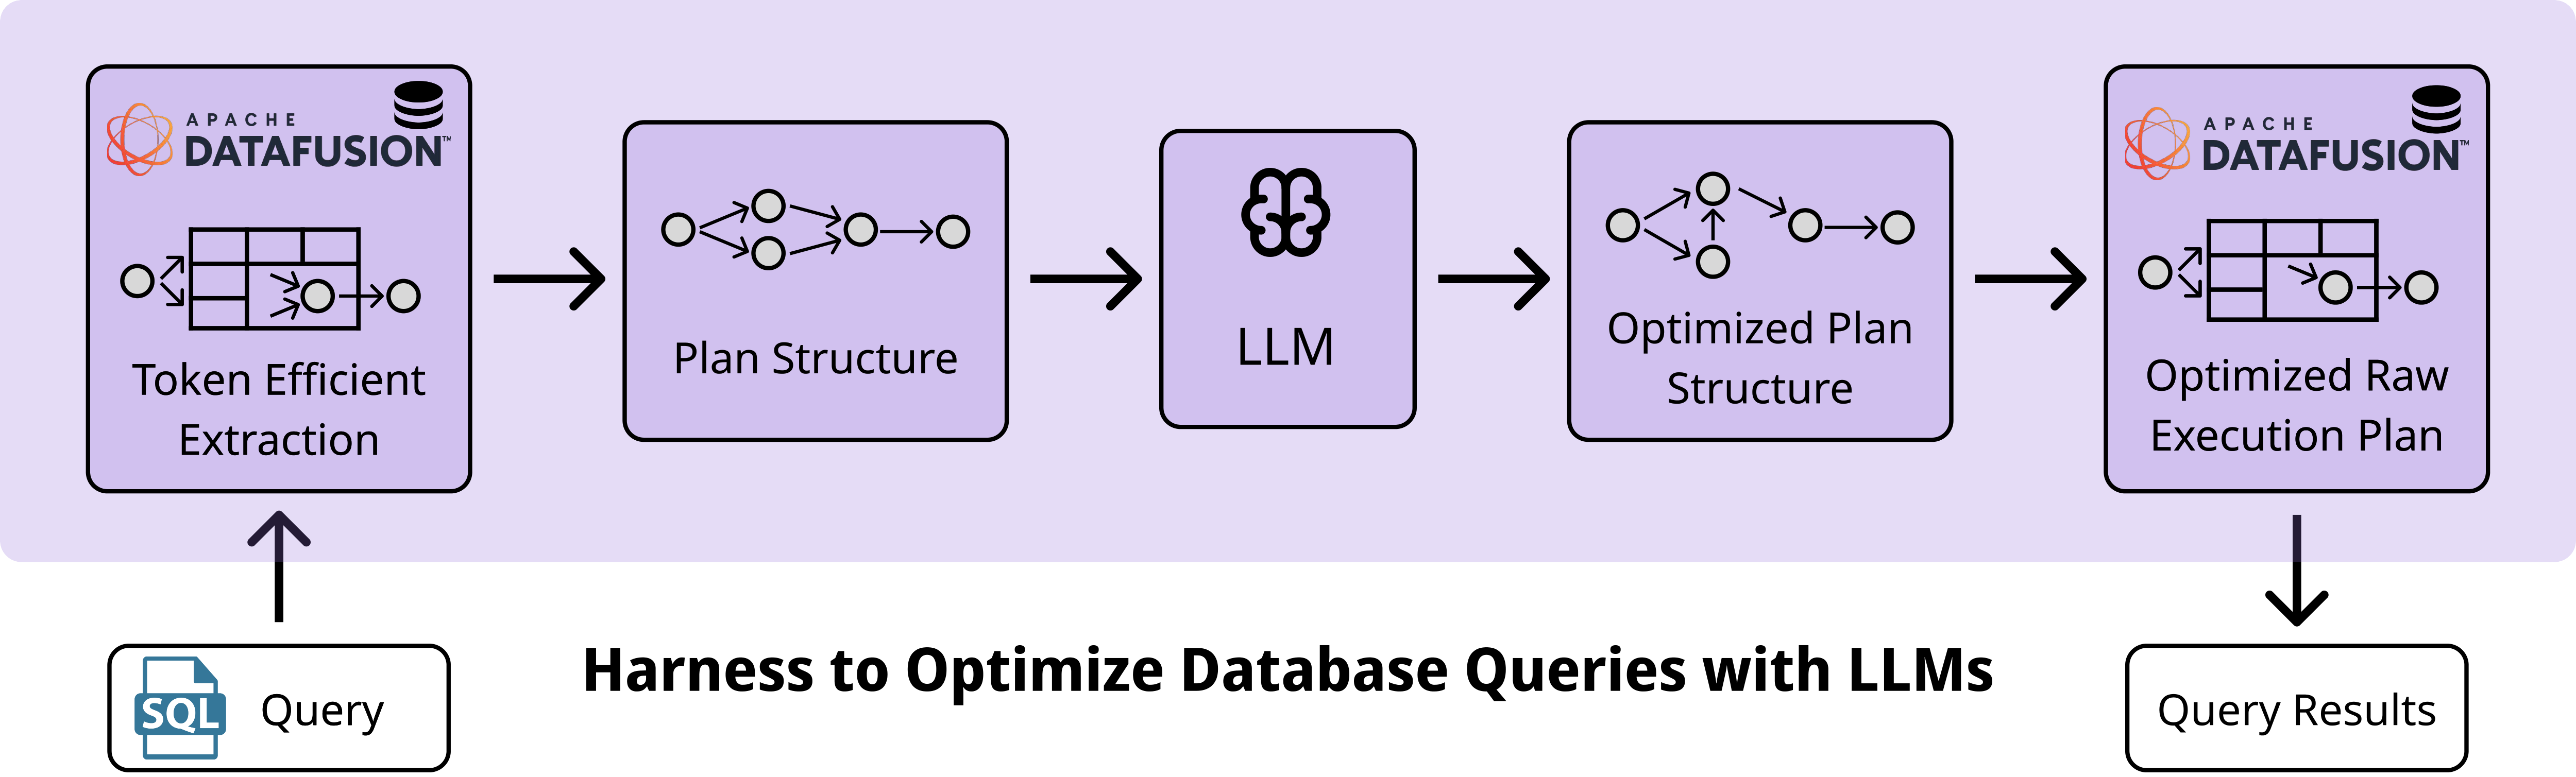
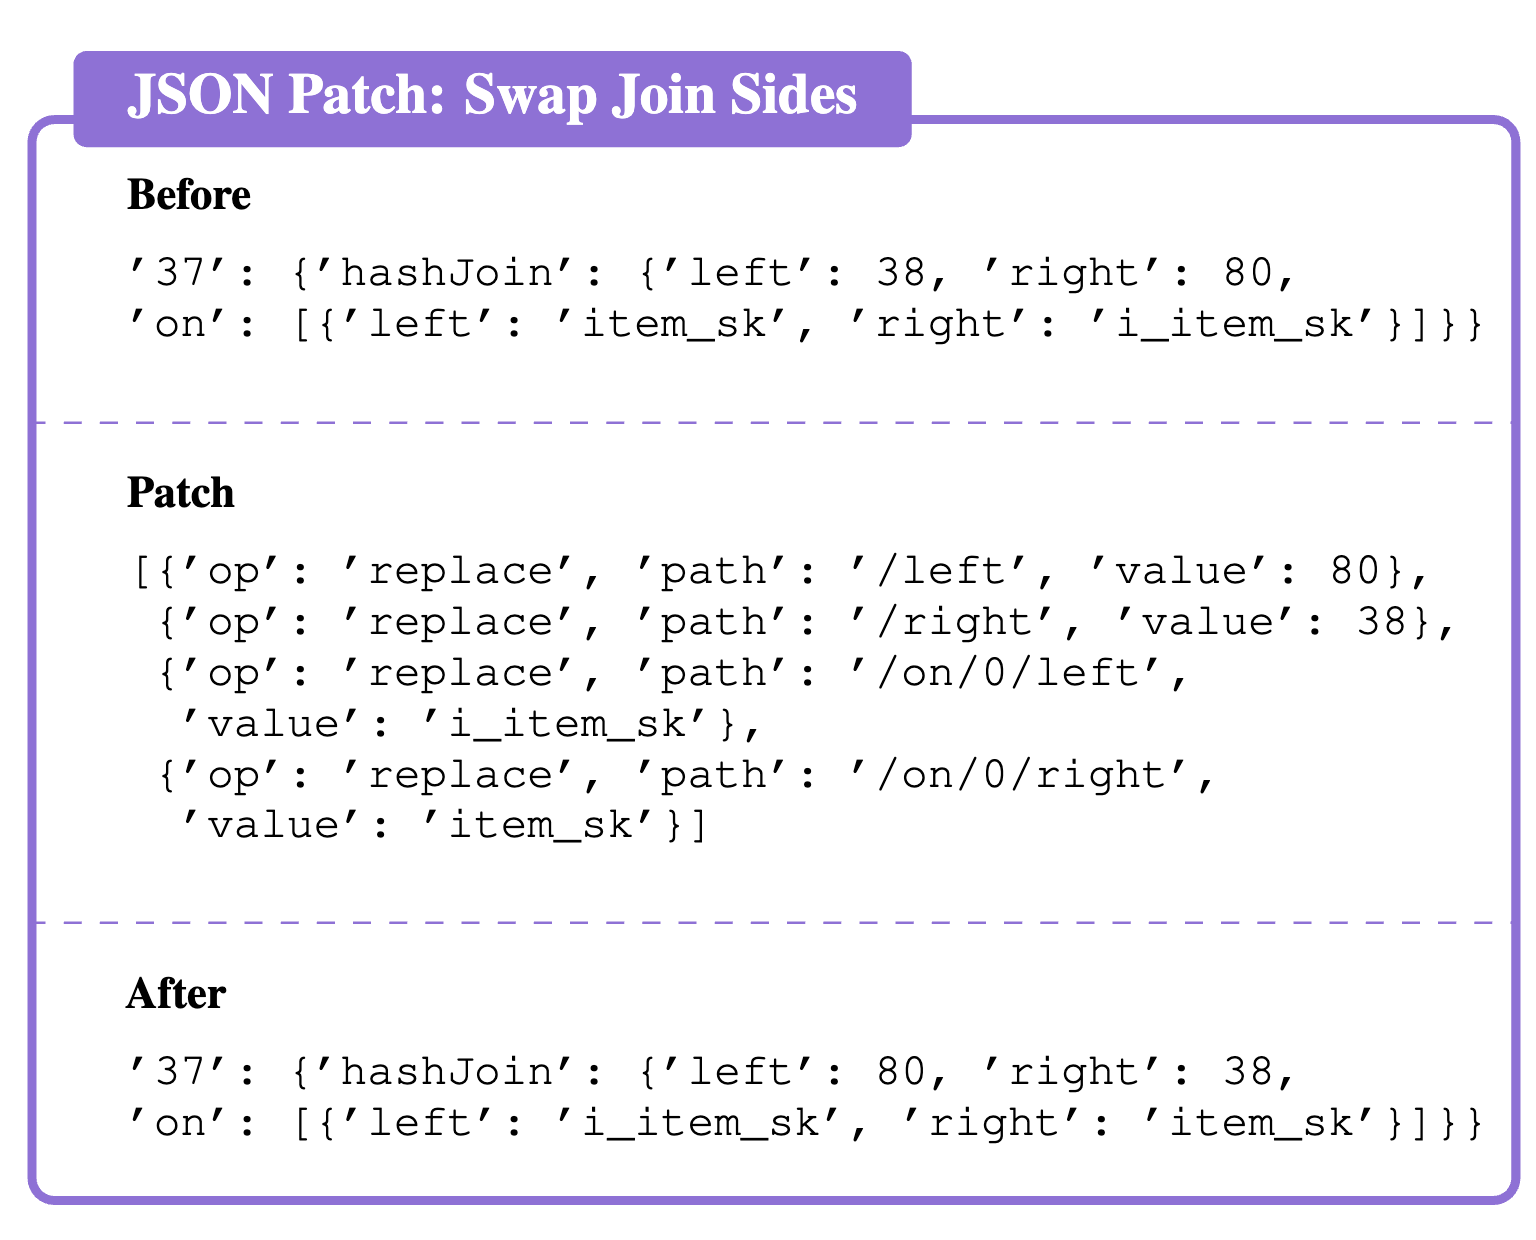
为了安全地实施这些修复,我们指示 LLM 不要从头重新生成整个物理计划,而是对 DataFusion 现有的物理计划做有针对性的编辑,从而降低语法错误或计划拓扑无效的风险。具体来说,LLM 生成 JSON Patch(RFC 6902)来描述局部编辑,例如交换连接的两侧或重新排列节点。这些补丁比完整计划小几个数量级,并直接应用于序列化后的图,确保执行 DAG 的结构完整性。
案例研究
统计估计失败的后果,在查询延迟和系统资源消耗上都是可度量的。在一个由 TPC-DS 衍生版本生成、涉及跨渠道销售的具体查询中,默认的 DataFusion 优化器认为较小的连接更便宜,于是优先连接较小的 item 表(3.6 万行),再连接较大的日期维度表(7.3 万行)。这一启发式规则没有考虑过滤条件 d_year=2001 在日期维度上的高选择性。经 LLM 优化的计划颠倒了这个顺序,先应用日期过滤,在后续连接之前把销售事实表从 1510 万行裁剪到 290 万行。
这一结构性优化使该查询获得 4.78 倍加速。更重要的是,资源占用大幅下降。优化后的计划把聚合哈希表的构建时间从 10.16 秒降到 0.41 秒,并把总的构建内存用量从 3.3 GB 削减到 411 MB。实验表明,在为 TPC-H 和 TPC-DS 生成的查询工作负载上,中位数加速比约为 1.1 倍到 1.2 倍;该方法在一些复杂的多表连接查询上也带来了大得多的收益,例如最高 4.78 倍的加速,另有若干查询在 1.5–1.7 倍之间。
进化式计划补丁
我们通过迭代改进来演化查询计划。系统使用 GPT-5 生成候选改进(以 JSON 补丁的形式),验证每一处改动,并保留能降低延迟的补丁。这些补丁应用之后,系统会以新的计划为起点,再次尝试生成新的候选。通过在多个步骤中累积成功的优化,这种进化式方法比单纯独立采样大量计划获得更好的加速。
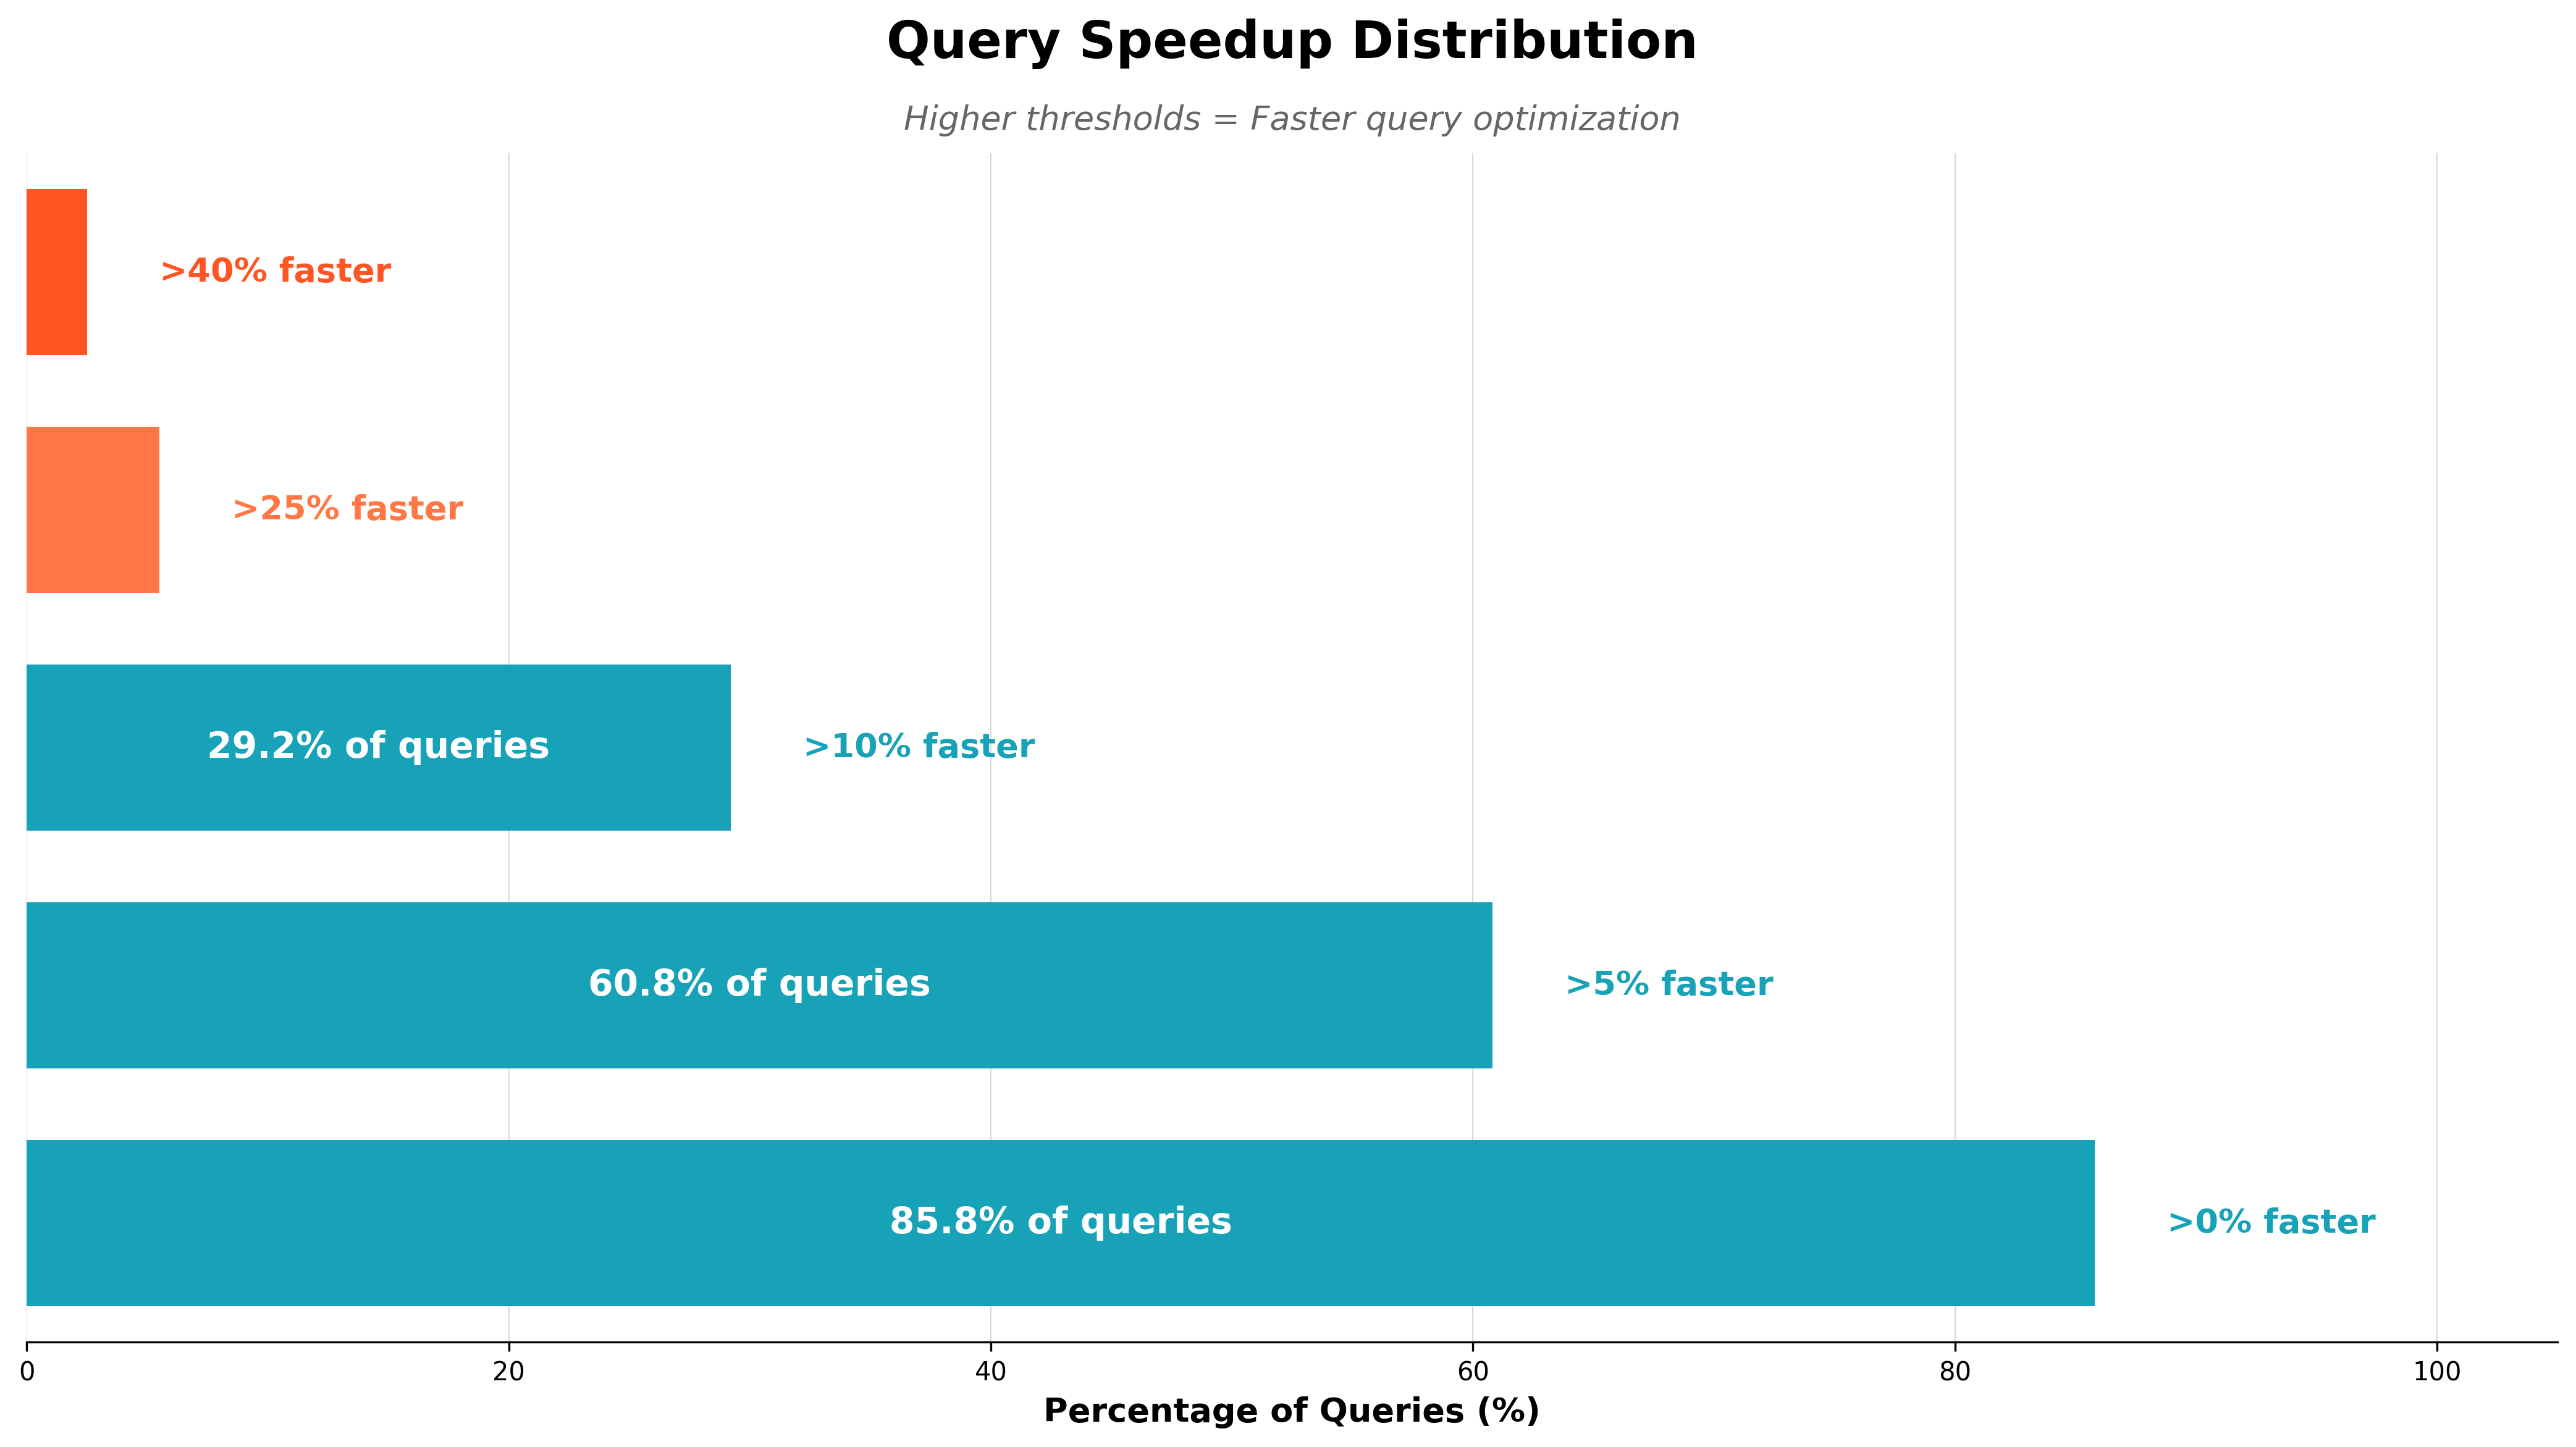
并非所有查询都能被有效优化,因为有些计划本身可能已经是最优的,但我们发现,在采样的数据集中,60.8% 的查询可以被优化 5% 以上。下图展示了我们某个衍生数据集上的改进:
跨规模因子迁移加速效果
我们使用的基准测试提供了规模因子(scale factor)参数,它在保持底层模式不变的情况下缩放表的基数。在实践中,这让我们可以构建一个较小的原型数据库(例如规模因子 3,即 SF3)和一个较大的、类似生产环境的数据库(例如 SF10),两者结构相同,只是大小不同。
由于在全量数据上探索大量候选计划代价高昂(每一步都要执行查询,还要为 LLM 生成的补丁付费并等待),我们先通过进化式搜索在 SF3 上找出好的优化计划。然后,对每个查询,用一个确定性的、基于规则的脚本把 SF3 上的最佳计划迁移到 SF10。该脚本通过规范化的模式/投影/谓词签名在不同规模之间匹配扫描算子,把 SF3 的优化计划改写成可运行的 SF10 计划,保留连接重排、连接两侧交换等结构性编辑,同时执行安全检查(例如没有悬空引用、DAG 拓扑有效)。
从经验上看,我们在 SF3 上选出的每个优化计划都能成功迁移到 SF10,所得加速与原始加速非常接近。这验证了一个实用的“小规模优化、大规模部署”工作流:在工作负载的紧凑副本上运行一次昂贵的搜索,再将得到的计划提升到更大的生产数据库上,几乎不需要额外的工程投入。
结论
DBPlanBench 证明,LLM 可以有效地充当语义基数估计器,纠正统计启发式规则遗漏的物理计划错误。通过将紧凑的计划序列化与进化式补丁搜索相结合,该系统显著缩短了执行时间并降低了内存压力,且无需修改核心数据库引擎。该工具集和代码已开源,供进一步研究。
参考文献
Lohman, G. Is query optimization a “solved” problem? ACM SIGMOD Blog, April 2014. URL: https://wp.sigmod.org/?p=1075. Accessed: 2026-01-26.