核心结论
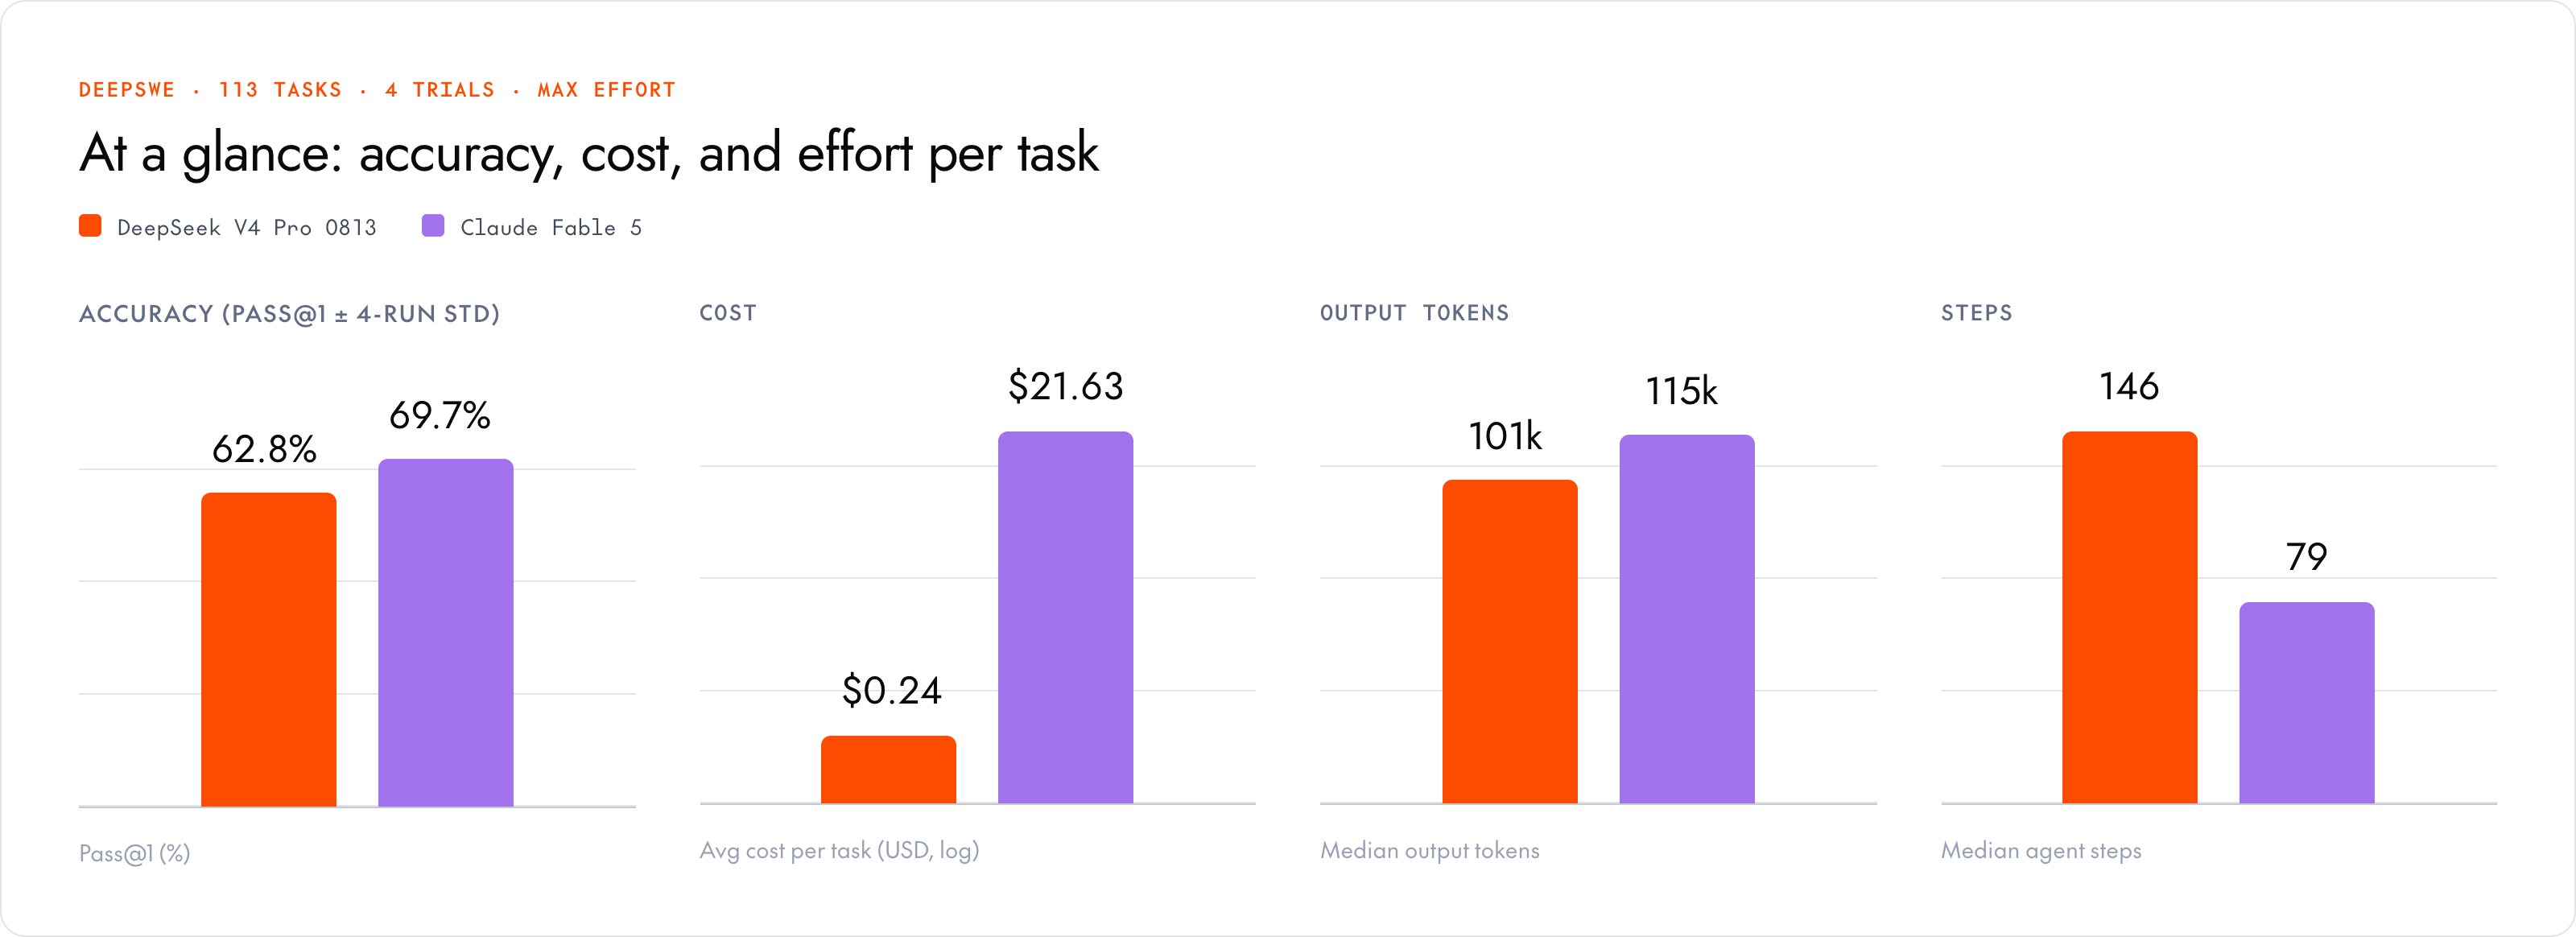
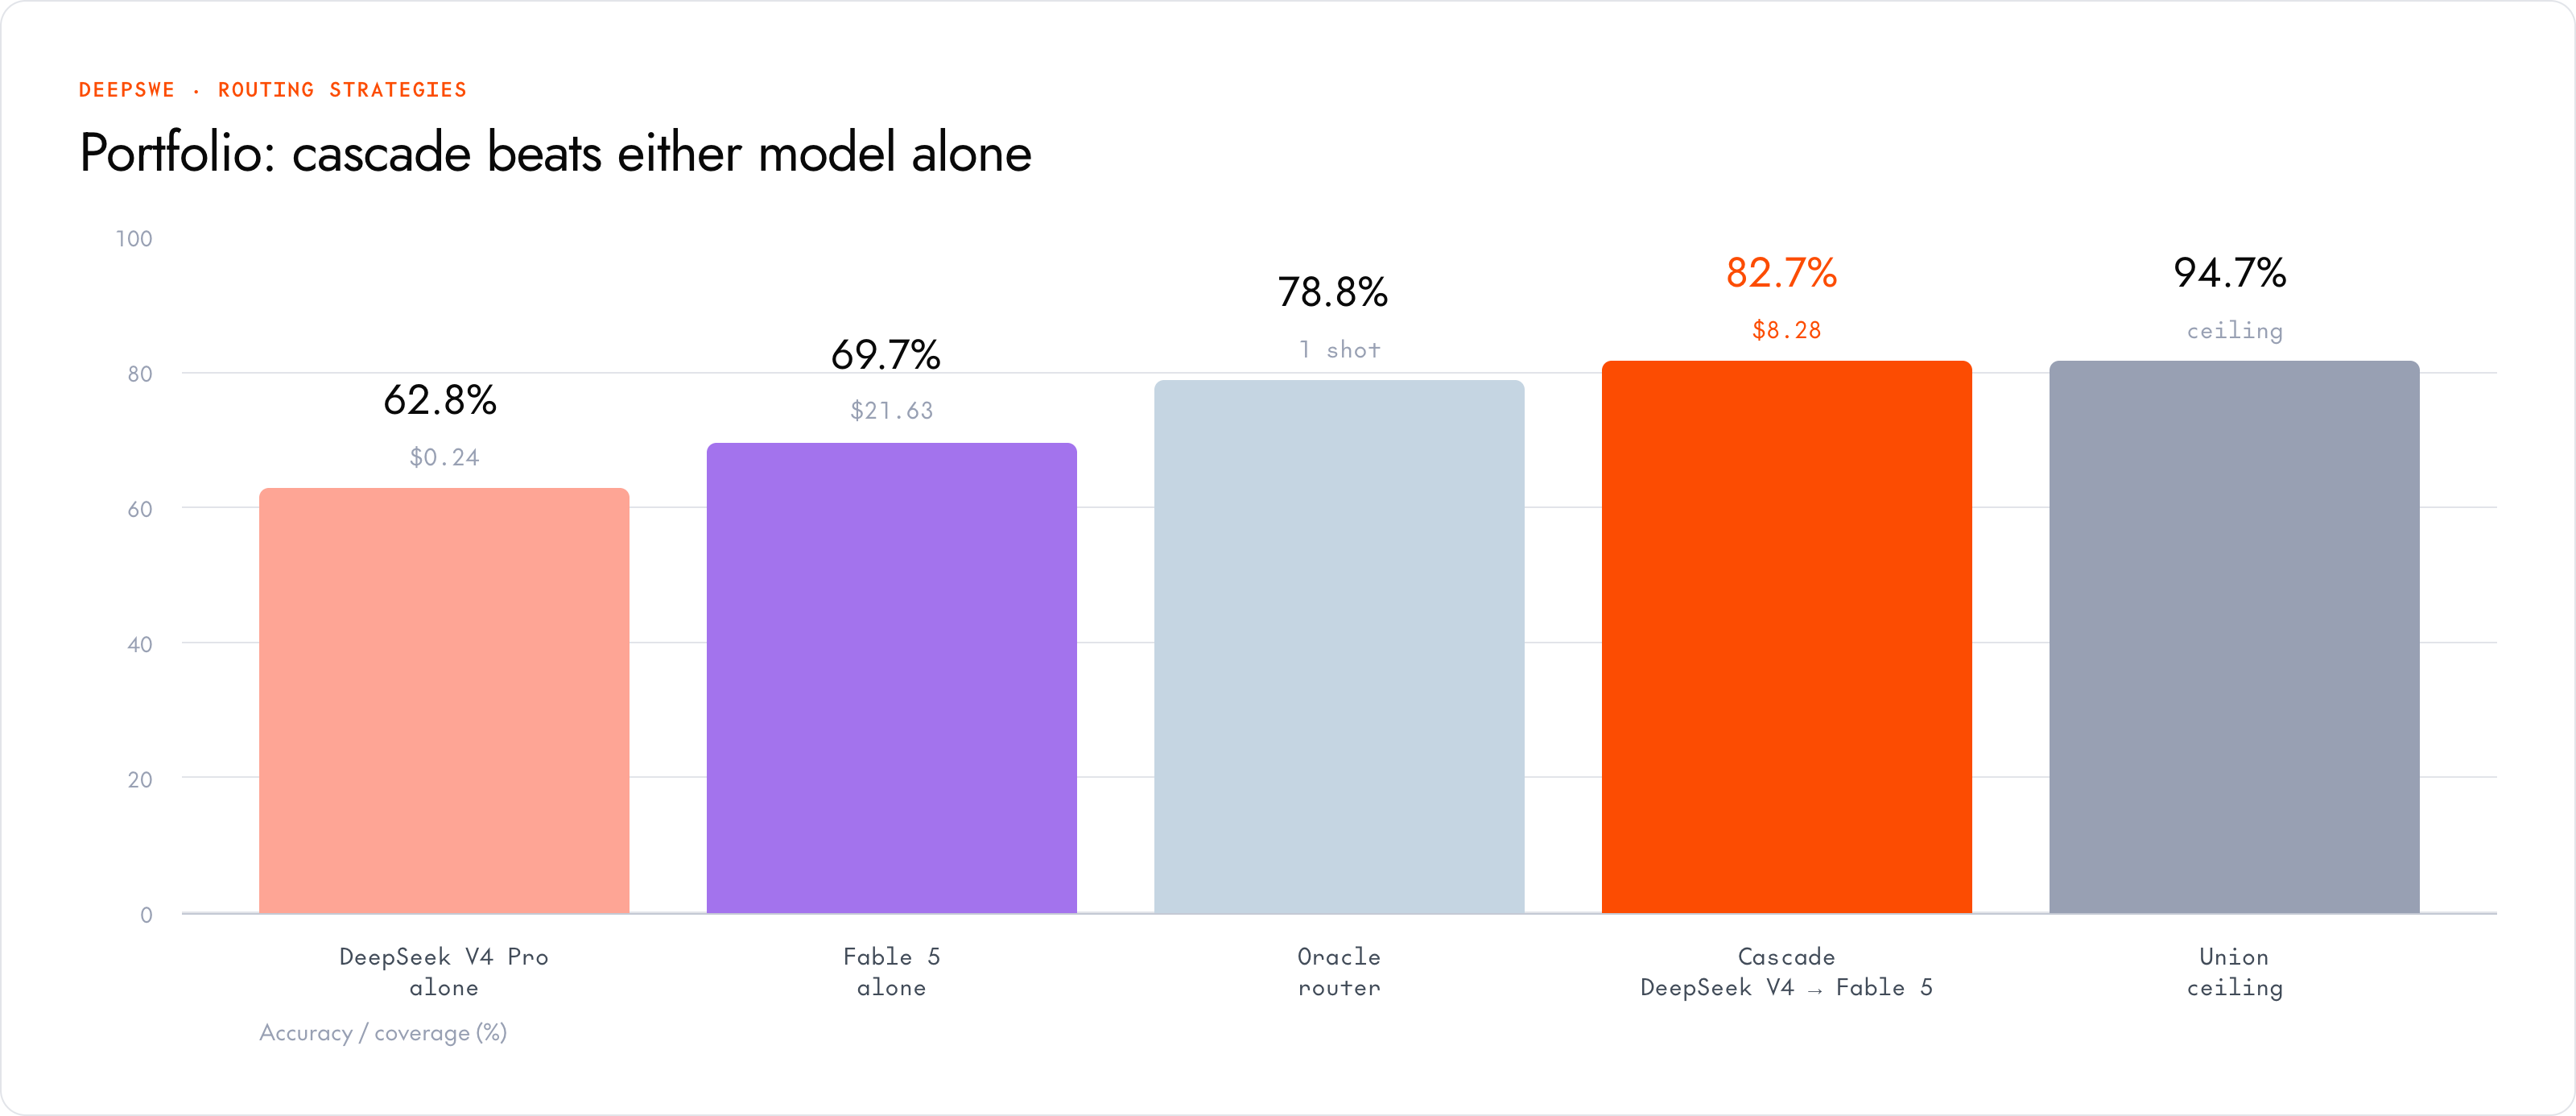
先运行 DeepSeek V4 Pro 0813,只有它失败时才升级到 Claude Fable 5。这种级联方式能解决 82.7% 的 DeepSWE 任务,每个任务成本 \$8.28。单独使用 Fable 能解决 69.7%,每个任务成本 \$21.63。准确率高出 13 个百分点,成本低 62%。
- Fable 赢在第一次尝试:pass@1 为 69.7%,对 62.8%,领先 7 个百分点。
- 此后每一次尝试都是 Pro 占优:pass@2 持平(78.5% 对 77.1%),pass@4 领先(88.5% 对 84.1%)。
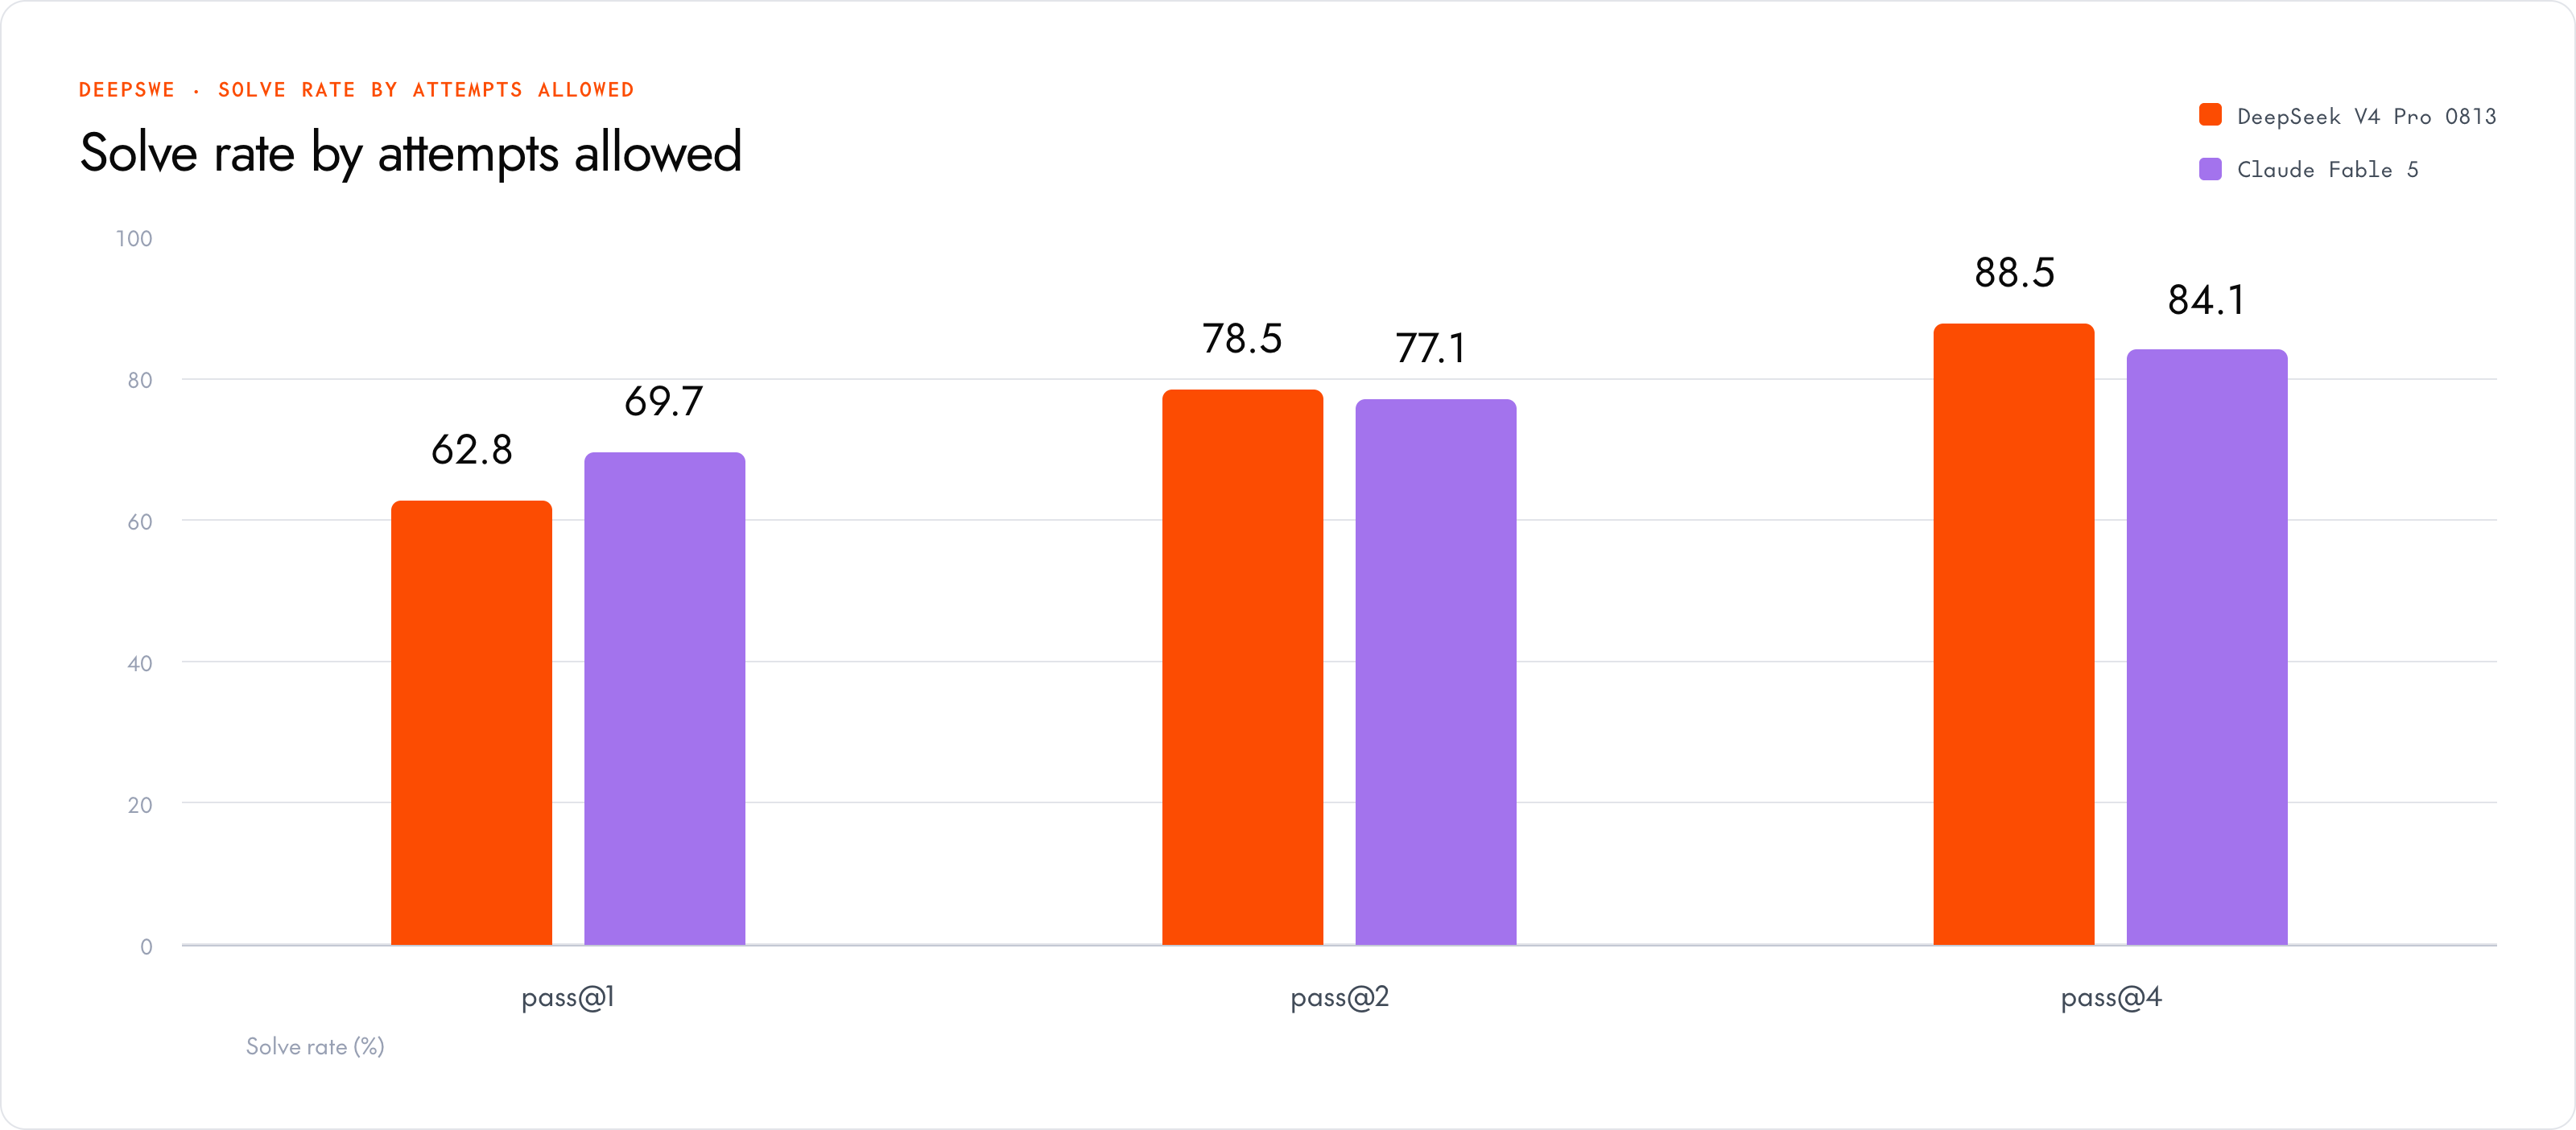
- 价格差距达 90 倍:每次 rollout \$0.24,对 \$21.63。每花 \$100,Pro 能解决 260 个任务,Fable 只能解决 3 个。
- 它们失败的任务各不相同。逐任务相关性为 0.39,是我们测过的差异最大的一对。两者合计覆盖 113 个任务中的 107 个。这种分歧正是路由有效的全部原因。
现已上线 · 美国托管
在 Together AI 上运行 DeepSeek-V4 Pro 0813
1.05M 上下文,支持函数调用和 JSON 模式,兼容 OpenAI 的 API,由美国基础设施提供服务。
查看该模型
在我们对 DeepSeek V4 Pro 0813 与 Claude Fable 5 在 DeepSWE 上的对比中(DeepSWE 是一个跨多种任务类型和编程语言测试模型软件工程能力的基准测试),这两个模型处在价目表的两端。Claude Fable 5 是 DeepSWE 榜单上单次 rollout 最贵的,DeepSeek V4 Pro 0813 则是最便宜的之一。Fable 在第一次尝试上准确率高 7 个百分点,每次 rollout 的成本却是对方的 90 倍,所以真正的问题不是哪个模型更好,而是这 90 倍的溢价究竟买到了什么,以及何时值得为之付费。
DeepSWE · 正面对比
DeepSeek V4 Pro 0813 与 Claude Fable 5 一览
| 模型 | Pass@1 | 平均成本 | 每 $100 解决数 | 输出 token | 步数 |
|---|---|---|---|---|---|
| claude-fable-5 [max] | 69.7% ± 2.3% | $21.63 | 3 | 115k | 79 |
| deepseek-v4-pro-0813 [max] | 62.8% ± 3.1% | $0.24 | 260 | 101k | 146 |
我们基于已公布的逐次试验记录,让 DeepSeek V4 Pro 0813(max)与 Claude Fable 5(max)在全部 113 个 DeepSWE 任务上各跑四次试验:共 904 次 rollout(每个模型 452 次)。Fable 是昂贵的工匠,Pro 是性价比的异类。这两者的分歧也超过了这组数据中任何其他配对,而这恰恰是它们最有意思的地方。下文所有数字均来自本次运行,因此可能与其他公开的 DeepSeek V4 Pro 0813 对 Claude Fable 5 的成绩单有所不同。
DeepSWE 成绩榜:pass@1 与 pass@k
单次尝试时 Fable 领先:pass@1 为 69.7%,Pro 为 62.8%(官方评分)。但这一领先很脆弱。两次尝试时 Pro 追平(78.5 对 77.1),四次尝试时 Pro 的 pass@4 为 88.5%,比 Fable 的 84.1% 高出四个多百分点。对于一个成本是对方 90 倍的模型来说,Fable 既没有掌握能力上限,也没能在重试下守住首次尝试的优势。成本更低的模型覆盖面更广,best-of-k 也更高。
成本对比:DeepSeek V4 Pro 0813 与 Claude Fable 5 的定价
每次 rollout \$0.24,DeepSeek V4 Pro 0813 比 Fable(\$21.63)便宜 90 倍:每 \$100 解决 260 个任务,而 Fable 只有 3 个。这是我们测过的所有配对中成本差距最大的,而 Fable 是榜单上最贵的单一配置。而且不同寻常的是,较低的价格并没有带来你预期中的速度代价:Fable 的 rollout 耗时中位数为 31 分钟,Pro 为 35 分钟,大致持平,因为 Fable 是榜单上最啰嗦的模型(输出 115k token),尽管它的步数更少(79 对 146)。Pro 步数多,Fable 每一步写得多。两者都没有明显更快。
失败模式:两者各是怎么出错的
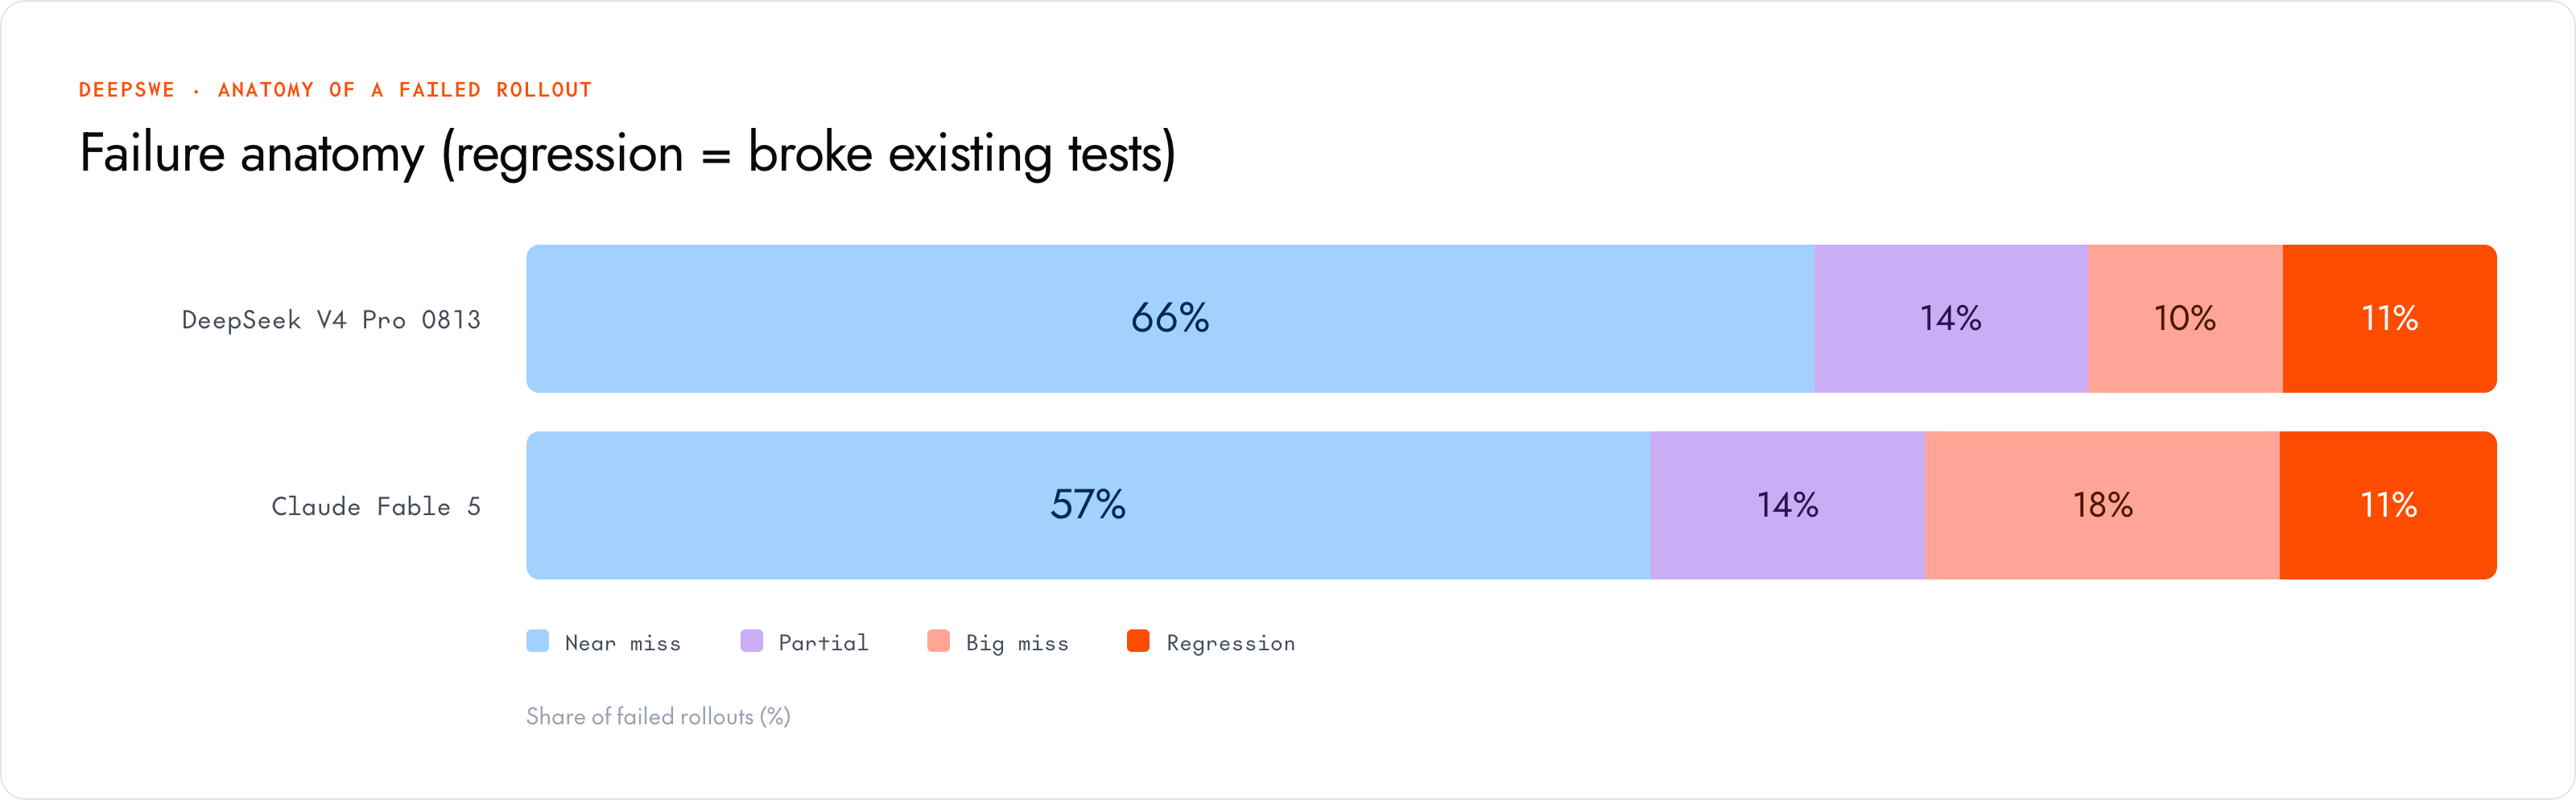
两者在避免破坏现有功能方面都很有章法:DeepSeek V4 Pro 0813 和 Fable 在各自的失败案例中,仅有 11% 会使现有测试套件出现回归,远低于 GPT 系列的 20%。差别出现在另一个方向:Fable 在此处的“大幅偏离”占比最高(18%,Pro 为 10%),也就是说 Fable 出错时更常错得离谱,解法与目标相去甚远,而不是只差一个边界情况。Pro 失败时更常是接近正确(“差一点”占 66%,Fable 为 57%)。因此,两者都可以不加繁重的回归把关就放心采纳,但 Fable 的失败调试起来代价更高。
按任务类型看各自的优势
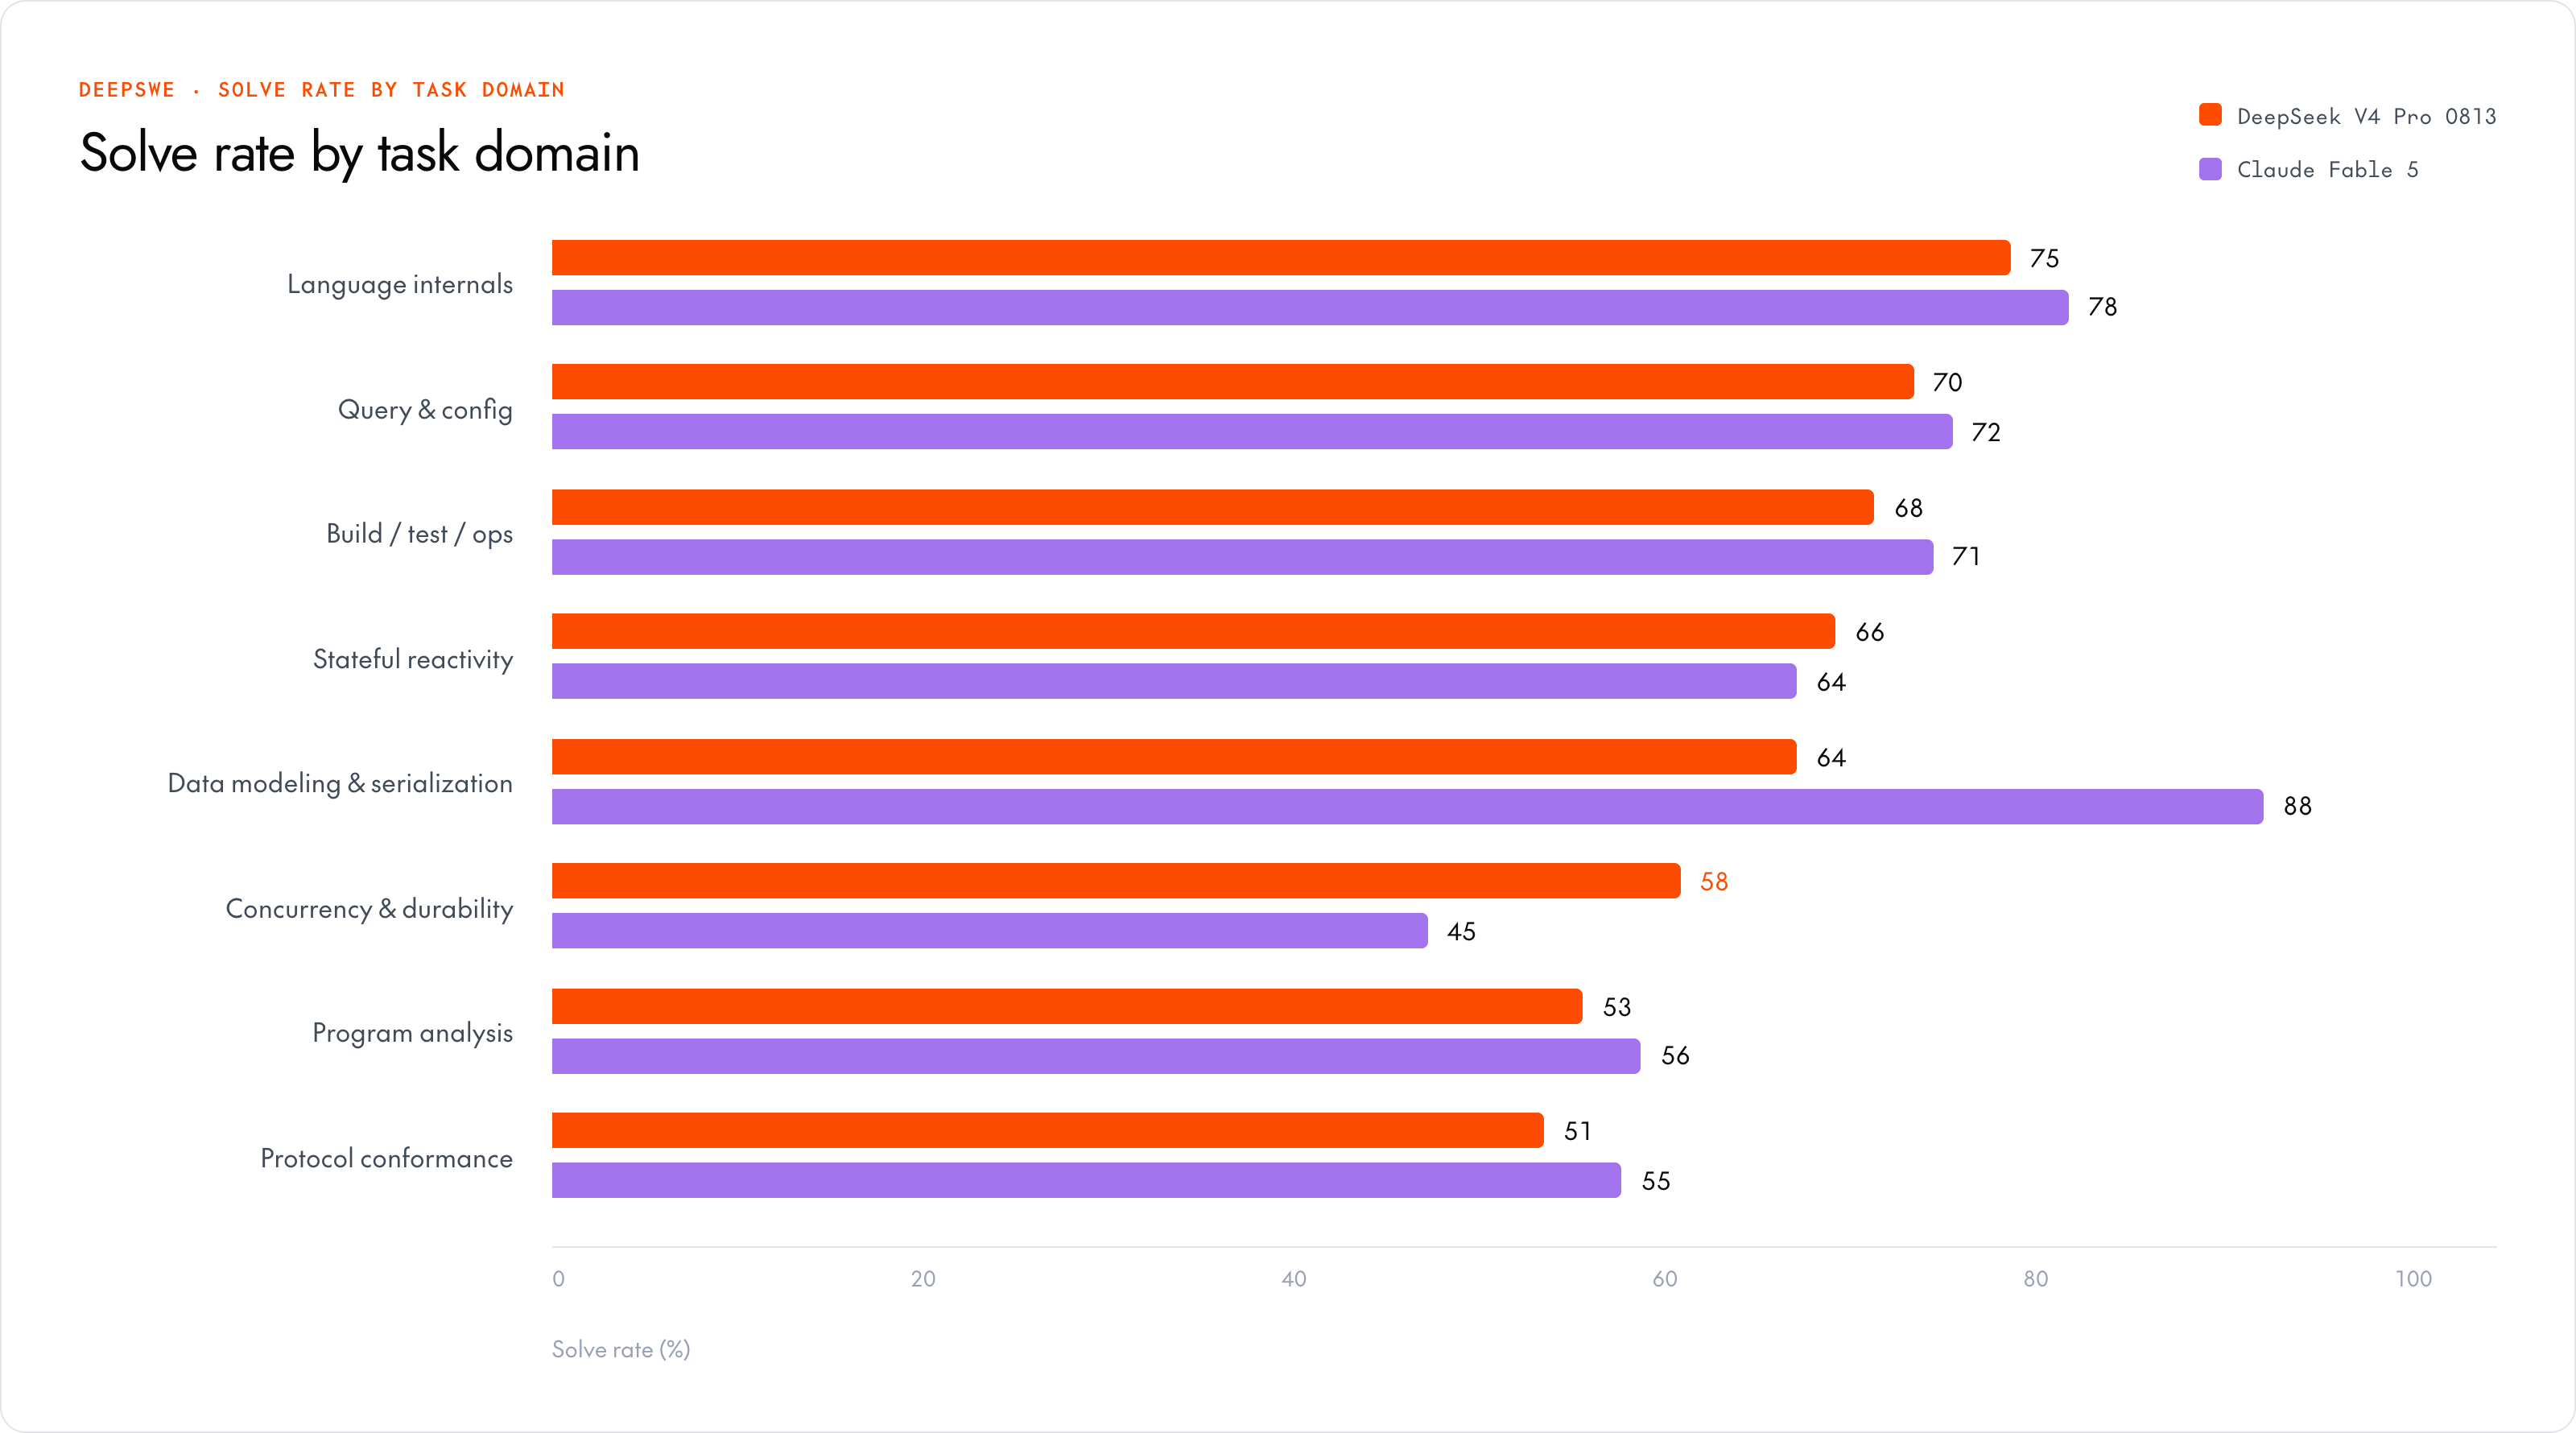
Fable 的工匠功夫体现在推理密集、契约精确的领域:8 个领域中它赢下 6 个,领先幅度最大的是数据建模与序列化,达到 88%(比 Pro 高 24 个百分点),以及语言内部机制(78)。但 DeepSeek V4 Pro 0813 拿下两个,而且都意义重大:有状态响应式(66 对 64),以及很说明问题的并发与持久性(58 对 45),在恰好是 Fable 最弱的领域领先 13 个百分点。Fable 在并发上的 45% 是它最薄弱的一格,也是这个成本更低的模型不只是更便宜、而是干脆就是更好的工程师的唯一领域。
按编程语言对比 DeepSeek V4 Pro 0813 与 Claude Fable 5
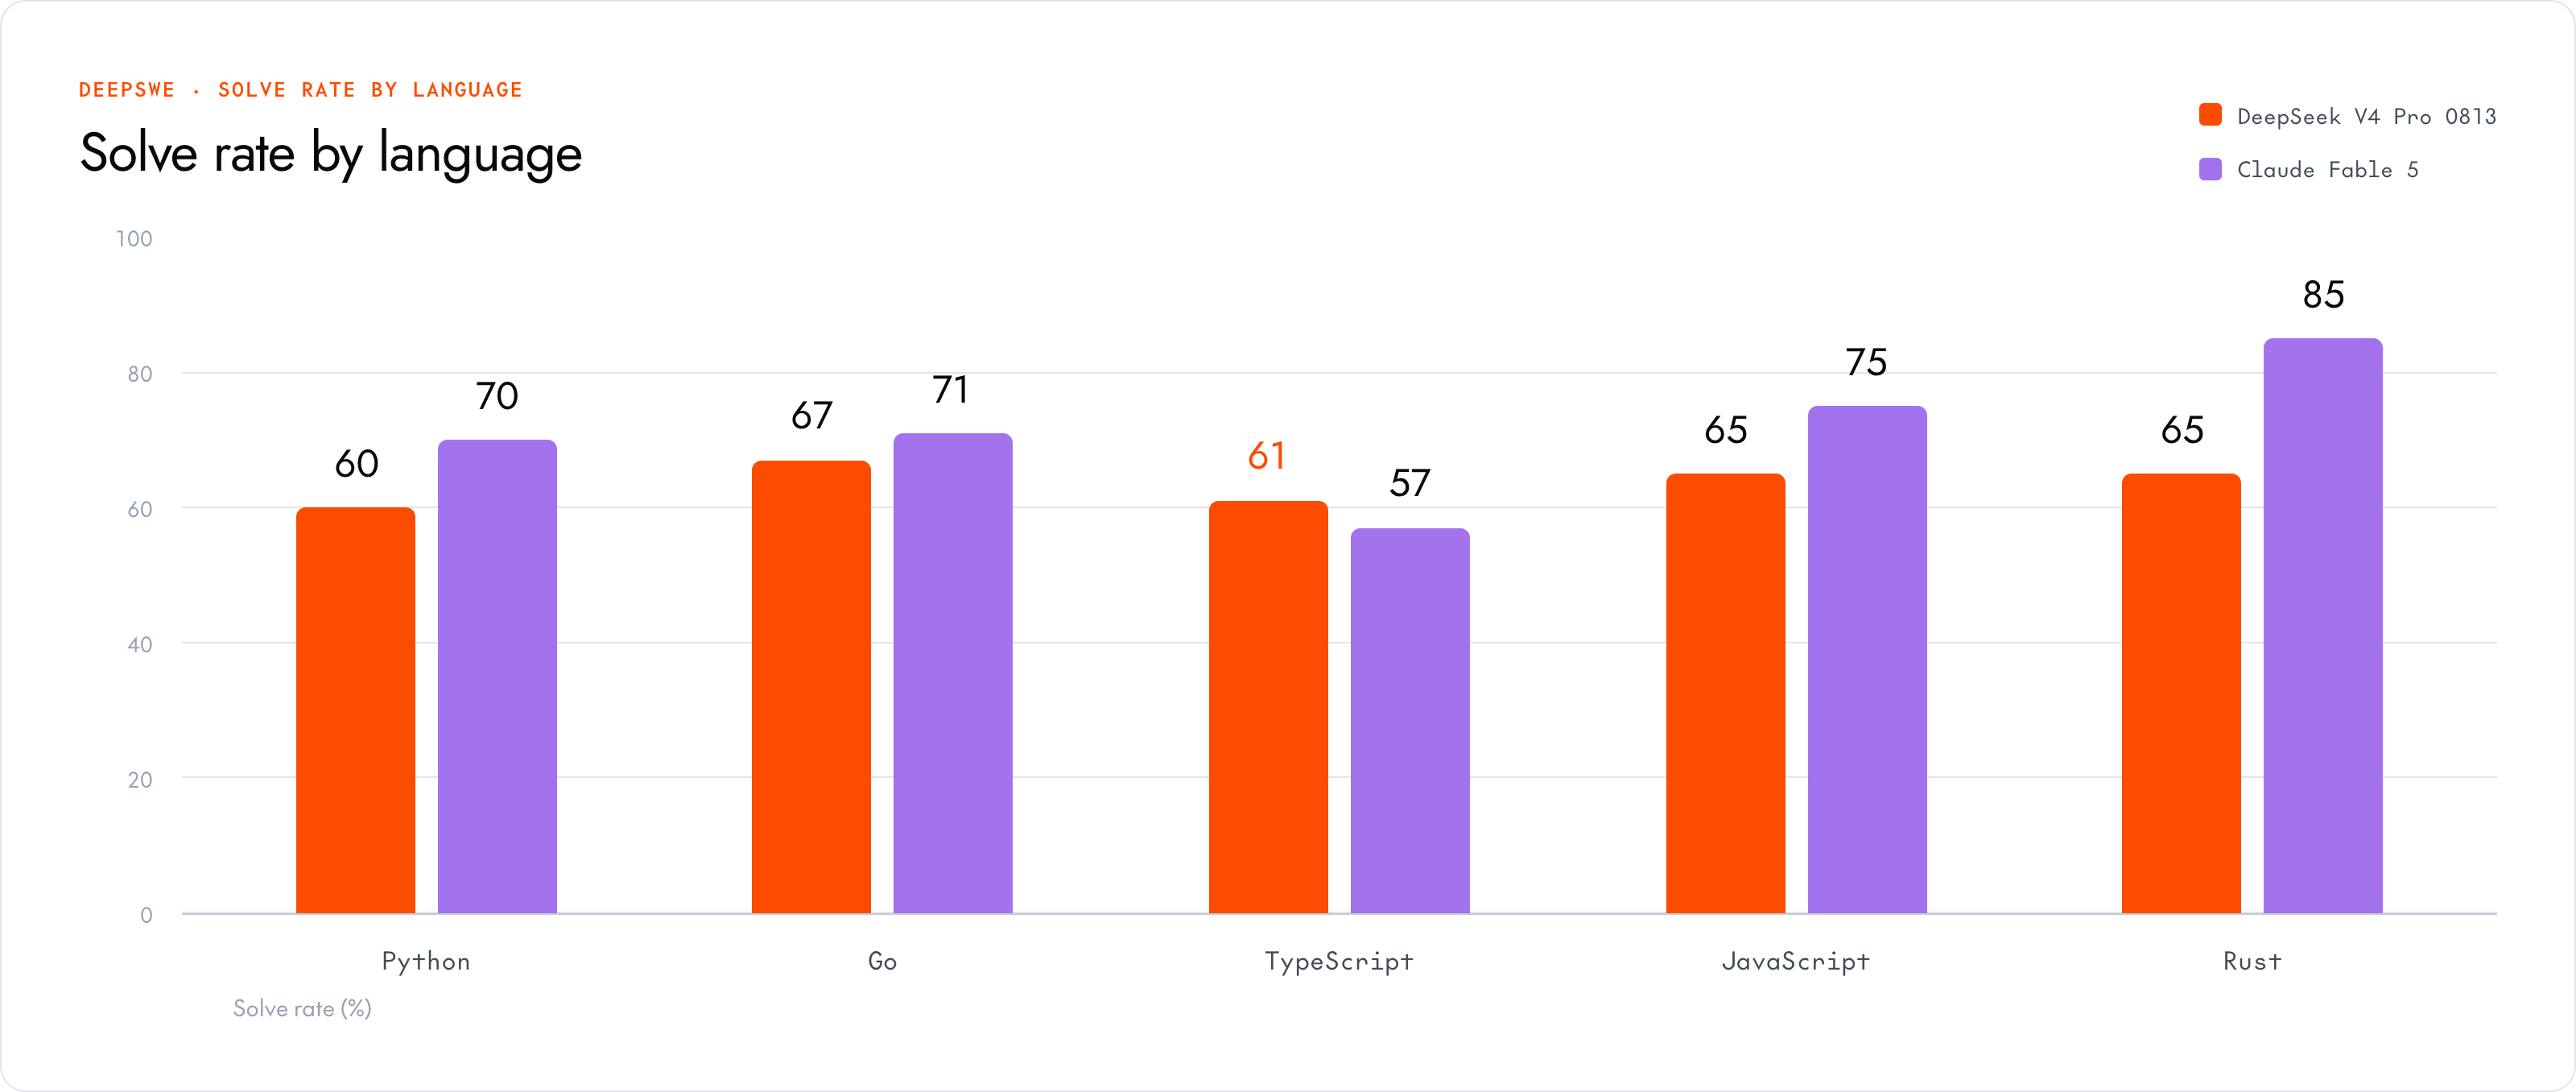
Fable 在五种语言中赢下四种,但能为它的价格提供依据的数字是 Rust:85% 对 Pro 的 65,领先 20 个百分点,是这组对比中最大的单项差距。Fable 显然是序列化与 Rust 方面的专家。在其他地方,两者比价格所暗示的要接近得多(Python 70 对 60,Go 71 对 67,JavaScript 75 对 65),而且 DeepSeek V4 Pro 0813 实际上拿下了 TypeScript(61 对 57)。除了 Rust 和序列化之外,很难为付出 90 倍的价格找到理由。
DeepSeek V4 Pro 0813 与 Claude Fable 5 有多大差异?
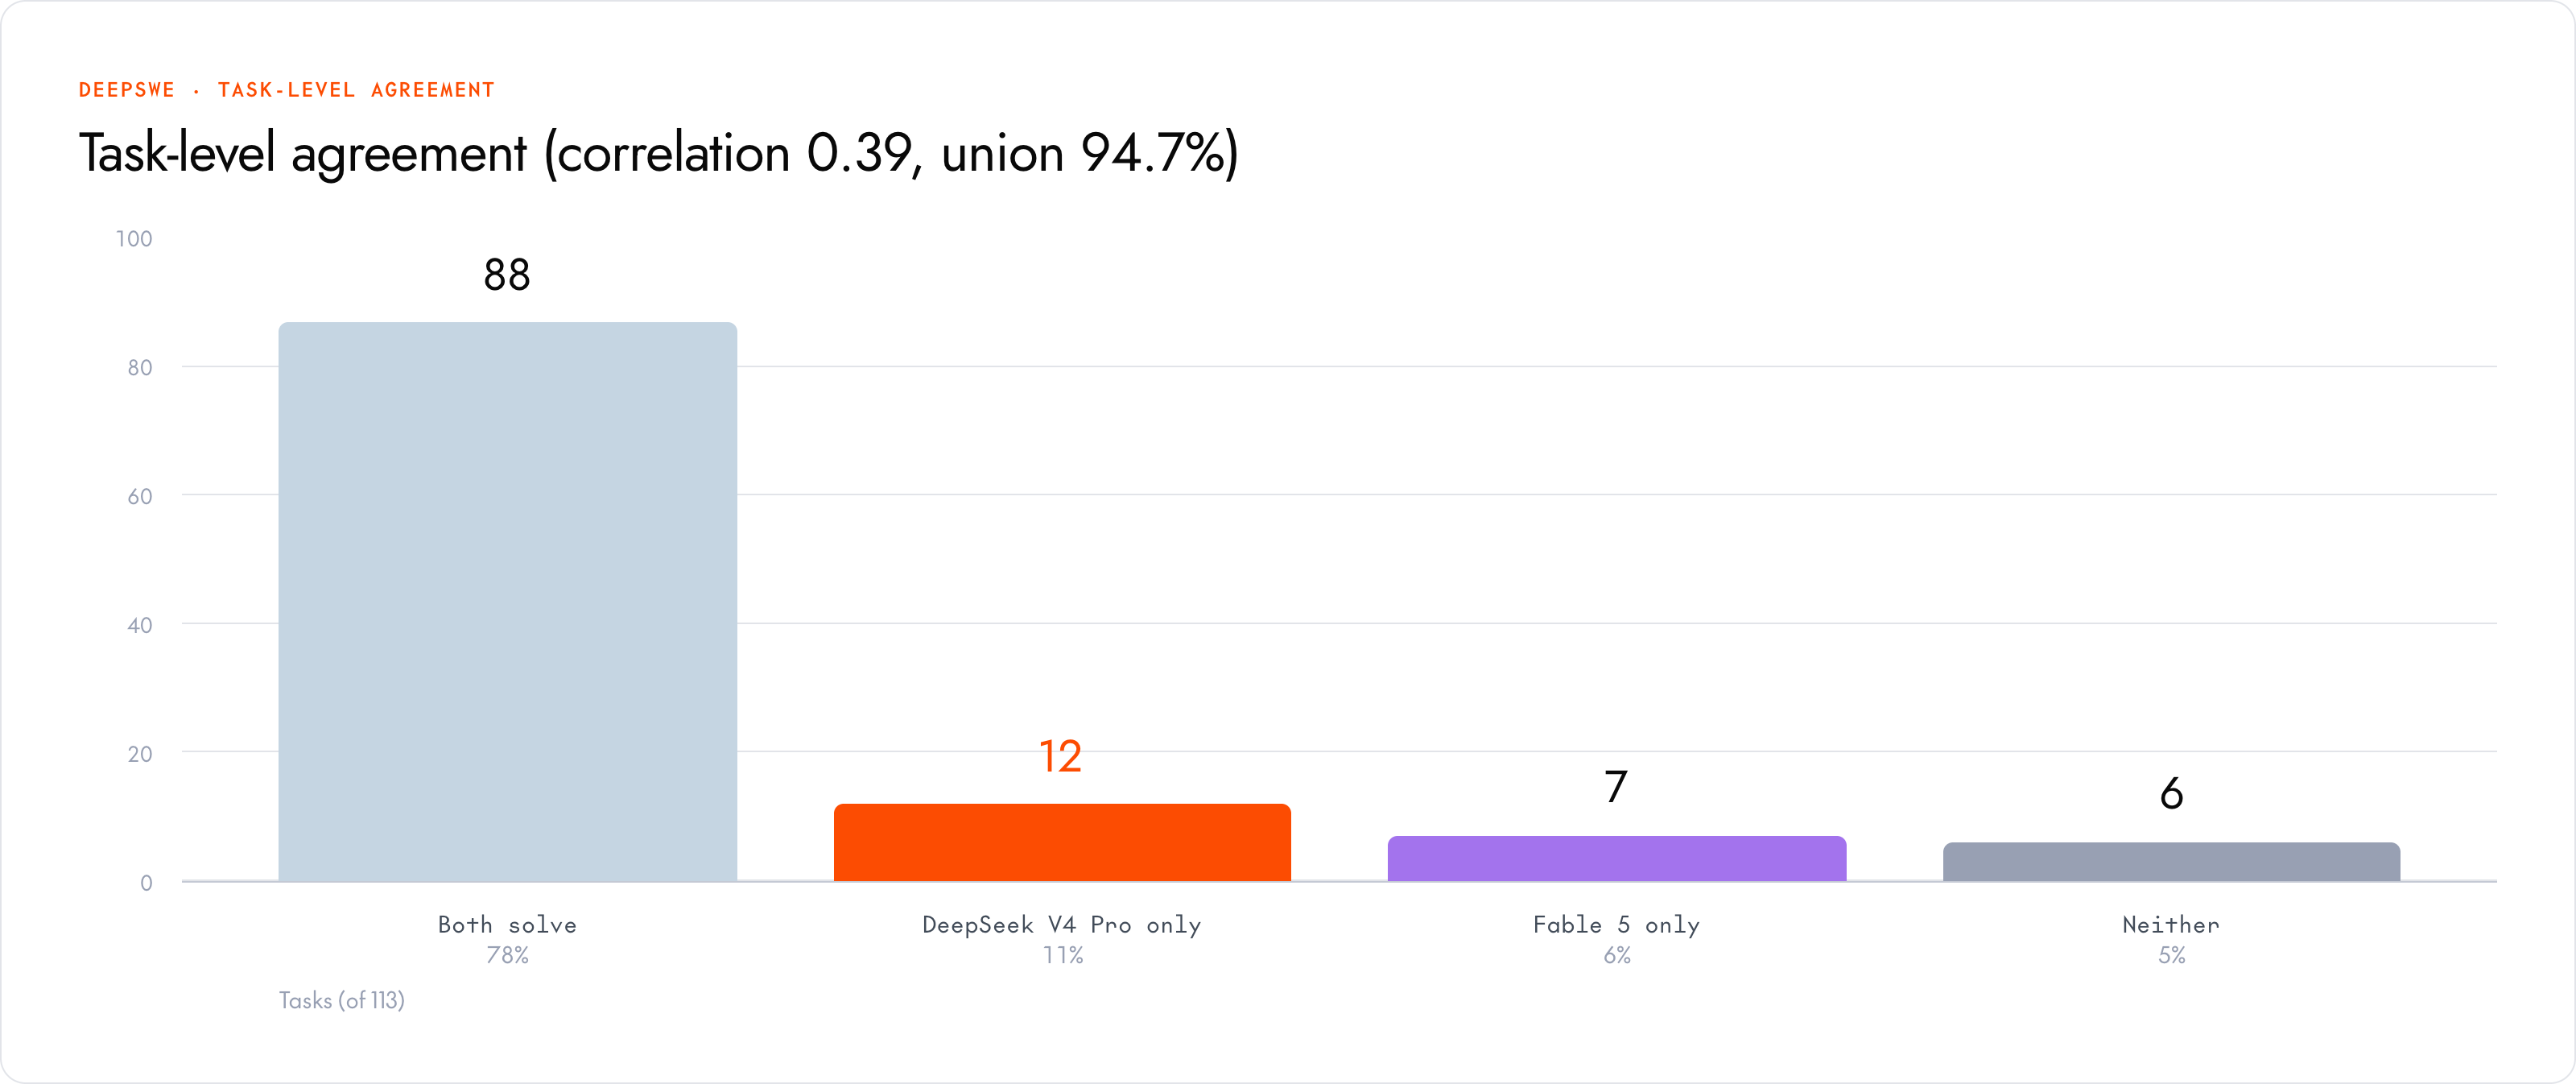
这正是它的亮点所在。逐任务相关性仅为 0.39,是所有 DeepSeek-Pro 配对中最低的,所以这两个模型确实存在真正的分歧。它们都能解决 88 个任务;只有 Pro 解决的有 12 个,只有 Fable 解决的有 7 个,两者都失败的只有 6 个。两者的并集覆盖 113 个中的 107 个(94.7%),而且分歧是双向的:DeepSeek V4 Pro 0813 四次全部解决了 awilix-async-container-initialization,而 Fable 从未做出;Fable 四次全部解决了四个 Pro 一次都没做出的任务(包括 koota-query-predicates 和 testem-bail-on-test-failure)。这是真正的互补,而不是冗余。
在两者之间做路由:组合策略
这种多样性加上价格,使级联方案很有吸引力。先运行 DeepSeek V4 Pro 0813,仅当你的测试套件拒绝其答案时再升级到 Fable:解决率 82.7%,每个任务成本 \$8.28。这比单独使用 Fable(69.7%)高出 13 个百分点,而每个任务的成本还不到 Fable 自身(\$21.63)的一半。低成本的第一阶段清掉了队列中的大部分任务,因此 Fable 的高价只需用在困难的剩余部分,而这些任务还额外得到了第二次独立尝试。该级联甚至胜过完美的单次预言机路由器(78.8%)。顺序不是可选项:Pro 优先的成本是 \$8.28,Fable 优先的成本是 \$21.71,而准确率相同。
这意味着什么
Fable 5 是这个榜单上最难被当作默认选项来论证的单一模型:rollout 成本远远最高,首次尝试的领先会被重试抹平,在四次尝试的上限上也没有优势。只在两件事上买它:Rust(85%)和重序列化的工作(88%),在这两处它的质量确实配得上这个价格。
DeepSeek V4 Pro 0813 则是相反的画像:首次尝试的准确率接近 Fable,上限更高,失败特征相当或更好,成本低 90 倍,只是在 Rust 和契约精确的领域上让步。而且由于这两者是我们测过的差异最大的一对,Fable 的最佳用法不是作为默认选项,而是作为低成本 Pro 第一阶段之后的选择性升级,只为真正需要 Rust 或序列化专家的少数任务付费。
现已上线 · 美国托管
在 Together AI 上运行 DeepSeek-V4 Pro 0813
1.05M 上下文,支持函数调用和 JSON 模式,兼容 OpenAI 的 API,由美国基础设施提供服务。
查看该模型
数据表:DeepSeek V4 Pro 0813 与 Claude Fable 5 的完整结果
DeepSWE · 完整结果
| 指标 | deepseek-v4-pro-0813 [max] | claude-fable-5 [max] |
|---|---|---|
| Pass@1(官方评分) | 62.8% | 69.7% |
| Pass@1(错误计为失败) | 62.8% | 67.3% |
| Pass@2 / pass@4 | 78.5 / 88.5% | 77.1 / 84.1% |
| 覆盖率 / 可靠性 | 88.5 / 71.0% | 84.1 / 82.0% |
| 稳固(4/4)/ 死角(0/4) | 35 / 13 | 56 / 18 |
| 每次 rollout 成本 / 总成本 | $0.24 / $109 | $21.63 / $9,346 |
| 每 $100 解决数 | 261 | 3 |
| 耗时中位数(分钟)/ 步数 | 35 / 146 | 31 / 79 |
| 峰值上下文中位数 / 输出 token | 232k / 101k | 202k / 115k |
| 失败构成(差一点 / 大幅偏离 / 回归) | 66% / 10% / 11% | 57% / 18% / 11% |
| 领先的领域数(共 8 个) | 2(有状态响应式、并发) | 6 |
| 领先的语言 | 1(TypeScript) | 4(Rust 大幅领先) |
| 逐任务相关性 / 并集 | 0.39 / 113 个中的 107 个(94.7%) | |
| 级联 Pro → Fable(准确率 / 成本) | 82.7% / $8.28(单独使用 Fable 为 69.7% / $21.63) | |
| 预言机单次路由器 | 78.8% | |
| 基础设施错误 | 0 | 16 |
常见问题
DeepSeek V4 Pro 0813 比 Claude Fable 5 更好吗?
这取决于指标。Claude Fable 5 在 DeepSWE 上的单次尝试质量更胜一筹(pass@1 为 69.7% 对 62.8%),四次全对的任务也更多(56 对 35)。DeepSeek V4 Pro 0813 在 pass@2 追平,并在 pass@4 胜出(88.5% 对 84.1%),而每次 rollout 的成本低 90 倍,因此对于高吞吐量或可容忍重试的智能体工作,它是性价比更高的选择。
DeepSeek V4 Pro 0813 比 Claude Fable 5 便宜多少?
在我们的运行中,DeepSeek V4 Pro 0813 每次 rollout 成本为 \$0.24,而 Claude Fable 5 在 max 强度下为 \$21.63,大约便宜 90 倍。按每个已解决任务衡量,Pro 每 \$100 解决 260 个,而 Fable 为 3 个,每美元完成的有效工作量约为 80 倍。
写代码方面,DeepSeek V4 Pro 0813 和 Claude Fable 5 哪个更好?
对于大多数编码工作,两者比价格所暗示的要接近。Claude Fable 5 在 Rust(85 对 65)、Python、Go 和 JavaScript 上领先,并在 8 个任务领域中赢下 6 个,领先最多的是数据建模与序列化。DeepSeek V4 Pro 0813 拿下 TypeScript(61 对 57)、有状态响应式,以及并发与持久性(58 对 45),后者正是 Fable 最弱的领域。
我应该在 DeepSeek V4 Pro 0813 和 Claude Fable 5 之间做路由吗?
如果你能验证结果,就应该。这两个模型的逐任务相关性是我们测过的所有组合中最低的(0.39),合计覆盖 113 个任务中的 107 个。先运行 DeepSeek V4 Pro 0813,在测试套件拒绝其输出时再升级到 Claude Fable 5,可以达到 82.7% 的解决率,每个任务成本 \$8.28,优于单独使用 Fable,也优于完美的单次预言机路由器。
DeepSWE 上的 pass@k 是什么?
pass@k 衡量的是对某个任务的 k 次尝试中,是否至少有一次通过隐藏测试套件。pass@1 奖励一次就做对;k 越大,越奖励那些经过多次尝试最终能够找到解法的模型。随着 k 增大,DeepSeek V4 Pro 0813 的优势也在扩大。