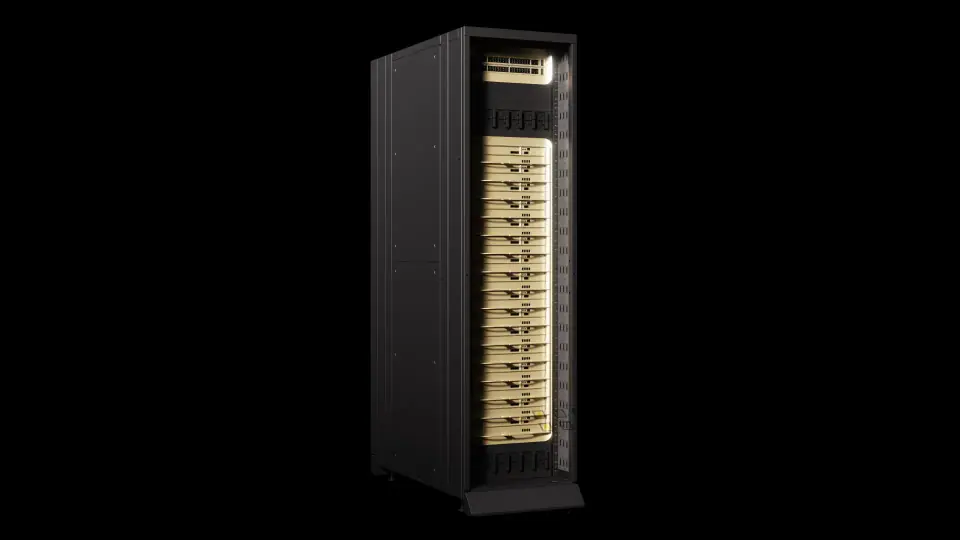
NVIDIA Groq 3 LPX 是面向 NVIDIA Vera Rubin 平台的交互式 AI 推理加速器。该平台的核心是 NVIDIA Vera Rubin NVL72,这是迄今打造的最通用的机器,能在最广泛的 AI 工作负载(从小模型到大模型,无论开源还是闭源)上同时提供高吞吐量和高交互性。Groq 3 LPX 与 Vera Rubin NVL72 搭配使用时,扩展了该平台应对最高交互性服务层级的能力,使 Vera Rubin 能更好地作为AI 工厂的一部分支撑各类用户体验。
在这篇文章中,我们报告 Groq 3 LPX 系统性能的首个第三方基准测试:Artificial Analysis 在 Groq 3 LPX 上,用 Gemma 4 31B 模型运行了其 100K 上下文基准测试,测得世界级的交互性:每秒 3,431 个输出 token。支撑这一性能的技术,加上 Groq 3 LPX 与 Vera Rubin NVL72 的搭配,使 Vera Rubin 平台能够以高交互性和长上下文,为由 2T+ 参数模型驱动的多智能体系统提供服务。
为什么高交互性下的长上下文很重要?
智能体会话的特点是多轮推理。每一轮结束时,智能体的输出都会被追加到不断增长的上下文中,并输入后续的每一轮。

如图 1 所示,在整个智能体会话中,上下文可以增长到数十万个 token,尤其是当会话超过数百轮时。这意味着在任务后期,智能体必须反复处理它迄今学到的所有内容。
没有长上下文,智能体就只能考虑此前相关上下文的一小部分。无论底层模型多快多聪明,上下文受限就意味着智能体能力受限。最强大的智能体不仅要快,还必须在会话不断增长的同时保持长上下文。
为什么在长上下文下以超快交互性提供模型服务很有挑战?
在为 100K 输入 token 管理 KV 缓存的同时,让模型为每位用户提供超过每秒 3,000 个 token 的服务,会带来独特的系统挑战。在推理系统中,张量并行(TP)等分而治之的技术可以带来数量级的加速,前提是系统能高效地管理所需的协调(集合操作)。但最高水平的交互性要求批大小非常小,此时固定的协调开销可能超过 TP 节省的时间。
TP 包含两部分:把一系列计算拆分到多个芯片上并行执行,然后合并结果。在高交互性推理所需的极小批大小下,要让 TP 有效,就需要紧密的协调。大量小张量必须在计算单元之间传输,每个张量都要在恰当的时间离开并到达恰当的位置。用于通信和合并结果的时间,很容易与分布式计算节省的时间相当,甚至更多。

在任何系统上,处理器间网络都必须协调这一系列传输。如图 2 所示,每次传输所需的总时间由两部分构成:
- 首比特延迟:用于确定某次传输应使用哪条具体的通信链路、同步发送端和接收端的链路端点,以及仲裁冲突(例如两个芯片想同时通过同一条链路发送数据)的时间。
- 传输时间:通过网络实际搬运数据所需的时间,取决于被传输的数据量与网络带宽之比。
TP 能带来的数量级加速,要求把首比特延迟压到绝对最低。要在整个前向传播过程中做到这一点,即对模型权重和长上下文 KV 缓存都采用并行,就需要一种同时兼顾低延迟和长上下文而设计的方案。
Groq 3 LPX 如何在长上下文下以超快交互性提供模型服务?
NVIDIA Groq 3 LPX 依靠由编译器调度的工作负载规划,在长上下文下以超快交互性提供模型服务。这包括其机架内的芯片间(C2C)网络,以及让计算与处理器间通信高度重叠的能力。
紧密调度的芯片间通信
Groq 3 LPX 采用确定性执行模型。这意味着编译器可以看到:
- 256 个 LP30 本地处理单元(LPU)中每个芯片内的各个计算单元
- 这些芯片合计 128 GB 的基于 SRAM 的内存
- 每个芯片 96 条 C2C 链路,每条速率为 112 Gbps
编译器可以利用这些信息,在工作负载开始之前就生成一份精确到时钟周期的调度,说明工作负载将如何运行。
这有许多优势。与高交互性最相关的是,它消除了对传输进行实时仲裁的需要,因为编译器可以在工作负载开始之前就规划好每份数据何时通过每条 C2C 链路传输,生成如图 3 所示的数据传输调度。

此外,这种工作负载开始前的调度,从根本上改变了数据传输的方式。许多系统即使传输很小的数据,每次传输也要经过好几个步骤:
- 一个芯片可能发出传输数据的请求
- 另一个芯片可能确认数据可供传输并找到它
- 数据可能必须与同时传输的其他数据争用资源
相比之下,编译器生成的调度意味着 LPU 可以在数据就绪的那个时钟周期发送数据,并在数据到达的那个时钟周期消费数据,如图 4 所示。

链路是成对 LPU 之间的点对点连接,每个 LPU 既是处理器也可充当路由器,这意味着必要时数据可以经由其他 LPU 路由到目标 LPU。
这种网络设计让 LPX 能把图 2 中的首比特延迟压到绝对最低。在大批量下,首比特延迟相比通过线路实际发送字节的时间微不足道;但在帕累托前沿的高交互性区域,尽量缩短固定的传输初始化时间就变得至关重要。
细粒度的计算与通信重叠
LPX 编译器除了能预先调度小批量推理所需的大量小型 C2C 传输外,还能以非常细的粒度让这些传输与计算重叠。
计算与通信重叠,对任何推理系统获得最佳性能都至关重要。LPX 可以更进一步:编译器以 320 字节向量为单位,在其计算单元和通信单元上调度工作负载。矩阵乘法可以表示为一系列点积,如图 5 所示,利用这一点,编译器可以安排各个 LPU 计算输出矩阵的 320 列,并在算完之后立即通过 C2C 链路发送出去。

这使 Groq 3 LPX 能在结果足以填满一个 320 字节向量时立即开始传输数据,而不必等待整个矩阵运算完成。这提高了计算与通信的重叠程度,对小张量尤其重要(图 6)。

这些技术共同作用,使长上下文推理中计算量最大的注意力运算获得数量级的加速。通过实现芯片间计算与通信的紧密协调调度,Groq 3 LPX 能利用张量并行分而治之的思路,即使在帕累托前沿中小批量、高交互性的区域也能带来加速。
Groq 3 LPX 在 Artificial Analysis 基准测试的 100K 上下文下取得领先的交互性
Artificial Analysis 拥有标准的基准测试套件,用于测试不同推理服务商在其各自模型上的服务速度,输入上下文长度分为 10K 和 100K 两种。Artificial Analysis 使用该套件,在其 100K 基准测试上测试了 Gemma 4,这是一个于 2026 年 4 月发布的 31B 参数稠密模型。NVIDIA 在自家数据中心搭建的一套 NVIDIA Groq 3 LPX 系统,以每秒 3,431 个输出 token 的速度生成答案(图 7)。

在 100K 输入上下文长度下,各样本的速度中位数为 3,431 token/秒。测试使用了“o200K_basetokens”分词器,所有模型和服务商都使用同一个分词器。
凭借对整个机架 SRAM 的低延迟访问,我们预计这一速度可以保持到数十万 token 的上下文。在智能体编程任务中,智能体可能轻松读取数百个文件,上下文超过 100K token,并在这样的上下文基础上生成 5,000 个推理和输出 token。这时,用户受益的不仅是上下文,还有从根本上改变其体验的速度。按这个速率,解码 5,000 个 token 约需 1.5 秒,而在每秒 100 个 token 的速度下需要 50 秒。这样的对比其实还算宽松,因为如今最流行的智能体工具的运行速度更接近每秒 60 个 token。

Artificial Analysis 还在 10K 上下文长度下对同一系统做了基准测试,以检验 LPX 在该长度下能否取得相近的性能;结果发现 Groq 3 LPX 的输出速度中位数为每秒 3,382 个 token。LPU 的确定性架构与高张量并行度相结合,使延迟和每秒输出 token 数随上下文长度的变化降到最小。

在 10K 输入上下文长度下,各样本的速度中位数为 3,382 token/秒。测试使用了同样的“o200K_basetokens”分词器。
Artificial Analysis 和 NVIDIA 的测试确认,这两项基准测试所用的 NVIDIA 配置,其输出没有任何精度或模型质量损失。详细了解 Artificial Analysis 的测试方法。
作为补充,我们运行了开源的 SPEED-Bench 基准测试,专门衡量编程场景,因为原始生成速度在智能体编程工作流中尤为重要。使用同一个 Gemma 4 模型,NVIDIA Groq 3 LPX 系统回答这些编程问题的速度中位数为每秒 4,767 个输出 token,P80 为每秒 5,520 个输出 token。这意味着该数据集上有 20% 的任务以超过每秒 5,500 个 token 的速度完成。

输出 token 速度的中位数为 4,767 token/秒;超过 20% 的问题,其解答的生成速度超过 5,500 token/秒。
NVIDIA Groq 3 LPX 如何与 Vera Rubin NVL72 一起加速长上下文智能体 AI 工作负载?
将 Groq 3 LPX 这种新的低延迟、确定性执行能力与 Vera Rubin NVL72 机架搭配,可以实现多种服务配置,包括:
- 标准的预填充-解码分离(prefill-decode disaggregation):Vera Rubin NVL72 负责预填充,并在每一轮交接一次 KV 缓存。Groq 3 LPX 利用这份 KV 缓存和存放在 SRAM 中的权重,完成整个解码步骤。
- 注意力-FFN 分离(Attention-FFN disaggregation):Vera Rubin NVL72 计算注意力并把 KV 缓存保存在 DRAM 中,Groq 3 LPX 则执行 FFN 层。机架之间只传送中间 token,每个全注意力层传送一次。
- 外部草稿模型推测解码(External-drafter speculative decoding):Groq 3 LPX 运行一个小型草稿模型,先于 Vera Rubin NVL72 上的大型目标模型生成草稿;目标模型负责验证并确认 token,并把被拒绝的位置返回,供下一个分块使用。每个机架保存各自模型的 KV 缓存,跨链路传输的只有草稿 token。
所有这些配置都让每个机架专注于自己最擅长执行的那部分工作负载。借助这套完全协同设计的方案,LPX 能把 Vera Rubin 平台推向高交互性和低延迟的新高度。图 11 展示了将 GPT-OSS 模型放大到 2 万亿参数后,在 Vera Rubin NVL72 和 Groq 3 LPX 上运行的预测结果。

*GPT-OSS 2T 是 GPT-OSS 120B 模型的放大版本。
了解更多
NVIDIA Groq 3 LPX 的速度如今已由第三方基准测试测得,证实它在对智能体工作负载至关重要的上下文长度下提供了领先的交互性。NVIDIA 还在一项开源的编程任务基准测试上测得了更极致的性能。
要了解 Groq 3 LPX 的更多信息,请参阅 Inside NVIDIA Groq 3 LPX: The Low-Latency Inference Accelerator for the NVIDIA Vera Rubin Platform。