基准测试表格没有抓住 DeepSeek-V4 的重点:真正重要的变化在于架构。V4 把百万 token 上下文变成了一个服务系统问题。
该模型通过一种混合注意力设计支持 1M token 的上下文窗口:在键值(KV)存储之前先压缩上下文,混合使用压缩与局部两条注意力路径,并改变了前缀复用的工作方式。这些选择降低了 KV 压力,但只有当推理引擎能够管理由此产生的缓存布局、恢复局部状态、有效地对请求做批处理,并选择与工作负载相匹配的端点配置时,这些节省才有意义。
本文聚焦于 V4 的 Compressed Sparse Attention(CSA)/ Heavily Compressed Attention(HCA)/ Sliding Window Attention(SWA)注意力设计对服务的影响,基于 Together 在 NVIDIA HGX B200 上的早期适配工作。V4 还包含其他架构和训练方面的改动,包括 Manifold-Constrained Hyper-Connections(mHC)残差连接和 Muon 优化器的选择,但这些不在本文的主要讨论范围之内。
V4 压缩了 KV cache 的 token 轴
自回归推理把先前的上下文存储在 KV cache 中。解码时,每生成一个新 token,都要读取并关注这些存储的状态。缓存随序列长度增长:
KV cache ∝ layers × tokens × kv_heads × head_dim × bytes
在长上下文下,KV cache 会从两方面冲击服务。它限制了并发度,因为每个活跃请求都要占用内存;它还降低了吞吐量,因为解码的每一步都必须读取已存储的上下文。V4 之所以重要,是因为它同时攻克了这个问题的两面:需要存储的缓存条目更少,需要在注意力中搬运的缓存条目也更少。
在 NVIDIA Blackwell 上,这种缓存压力直接对应服务的经济账。长上下文推理既要保留足够的 KV 以支撑并发,又要为解码保留内存带宽。V4 的 token 轴压缩让这一权衡变得更加有利:引擎有更多空间对请求做批处理、复用前缀,并把长上下文负载保持在高效的服务区间内。
近期的模型架构已经分别削减了上述乘积中的不同项。Group Query Attention(GQA)减少了 KV 头的数量。Multi-Head Latent Attention(MLA)把 KV 压缩为潜在表示。FP8、MXFP4 和 NVFP4 降低了每个元素的字节数。DeepSeek-V3.2 的稀疏注意力减少了解码时需要读取的 KV 量,但完整的缓存仍然必须常驻。
DeepSeek-V4 瞄准的是 token 轴。它在 KV 存储之前就压缩上下文。
这是关键的转变。
按照原始的 BF16 多头注意力计算,一个 70B 级别的模型每个 token 可能需要数 MB 的 KV cache。具体系数取决于层数、KV 头数、头维度和精度。在 1M token 下,单个请求的缓存就已经不切实际。V4 的 token 轴压缩,加上 MLA 式的头压缩和低精度 KV,把每个请求的缓存占用降低到足以让超长上下文显著更加实用。
在早期适配中,V4 的服务容量与其说取决于压缩后的 CSA / HCA 缓存,不如说更多取决于引擎如何处理 SWA 状态。完整 SWA 的实现,其每 token 的 KV 占用实际上比我们的 V3 路径更高——大约 3.8 KB 对 3.4 KB——因为引擎存储了完整的滑动窗口状态。
实际收益来自缓存策略。通过只保留最有可能被复用的 SWA 状态,我们只做了极少的改动,就把单个 NVIDIA HGX B200 节点上的 KV cache 总容量从大约 1.2M token 提升到了 3.7M token。这是最主要的服务经验:V4 的架构为长上下文效率创造了机会,但实际能获得的容量取决于推理引擎如何存储、重算和淘汰不同类型的缓存。
这一实际收益并不局限于完整的 1M token 请求。它还让 200K–500K token 的负载并发度更高、也更不脆弱,因为在内存压力迫使淘汰或限制批处理之前,引擎有更多的 KV 预算可用。早先的百万 token 上下文模型在内存、并发和成本方面仍留下了重大的服务挑战。当服务策略与缓存布局相匹配时,V4 让这一范围更接近真实的工作负载。

V4 需要多种 KV cache 布局
许多现有的服务路径假定的是接近单一的 KV cache 布局:每层每个 token 一个缓存对象,整个栈中形状相同。V4 则需要三种不同的缓存类型,并在各层之间混合使用。
Compressed Sparse Attention(CSA)以步幅 4 压缩上下文,但每个压缩条目是由稍宽一些的感受野构建而成的。在 V4 的配置中,每个条目概括一个 8 token 的邻域,因此相邻的压缩条目在边界处有重叠。当一个查询选中 128 个压缩条目时,它选中的是局部邻域的摘要,而不是孤立的 token 位置。这使 CSA 能以更细的粒度进入百万 token 前缀中被选中的区域,同时仍然降低了存储的缓存占用。
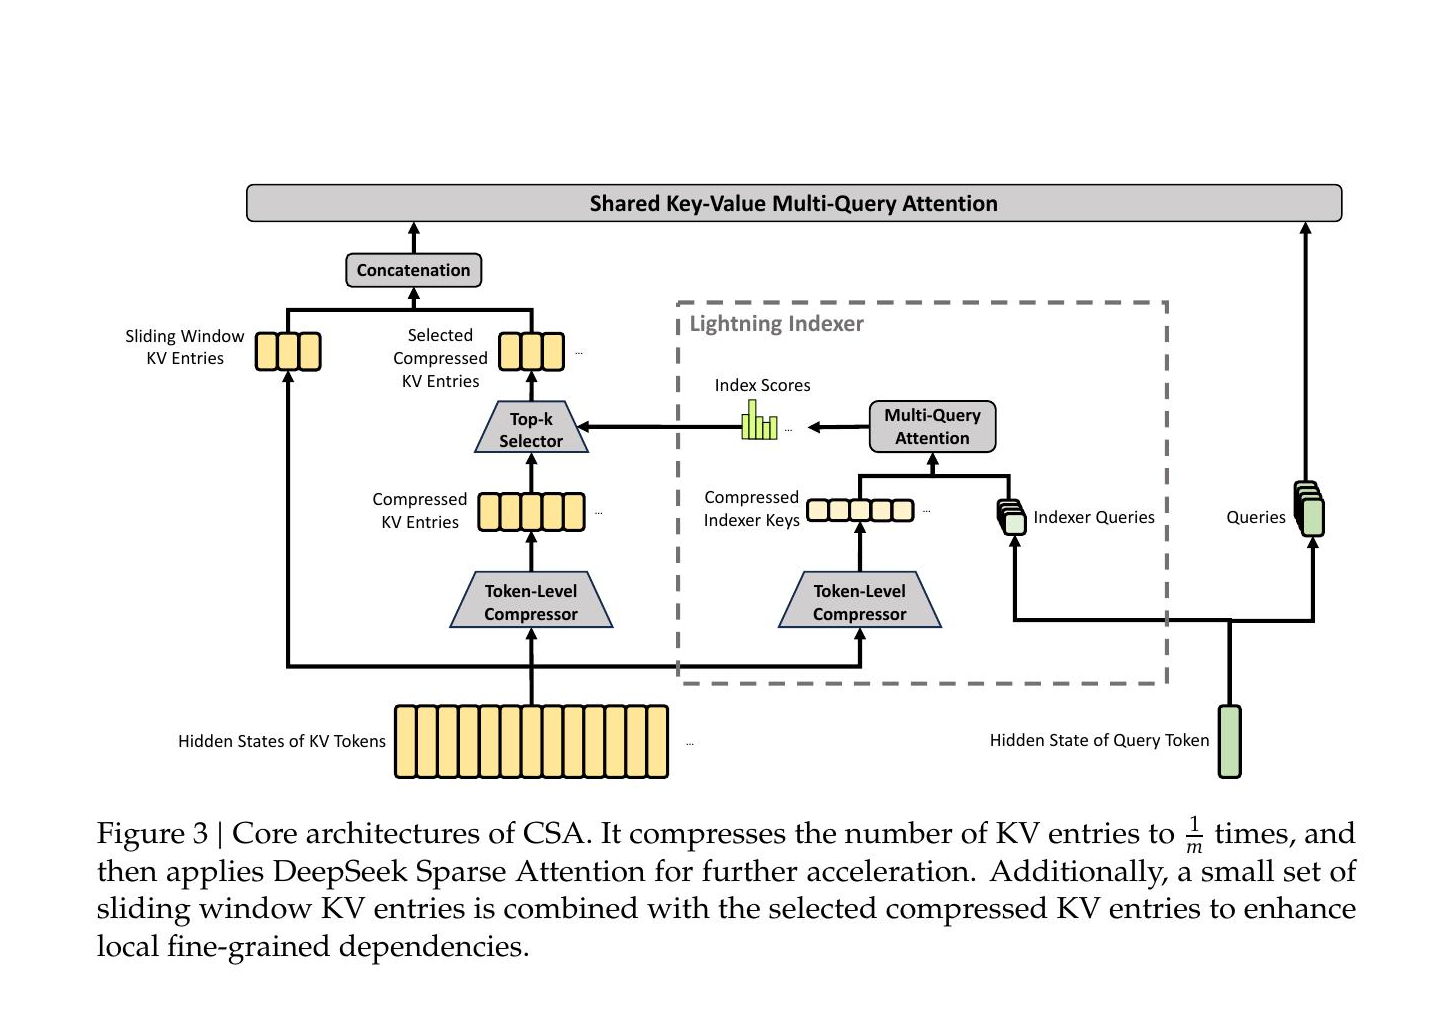
Heavily Compressed Attention(HCA)采用同样的压缩思路,但步幅为 128。在 1M token 的上下文长度下,这会把缓存从 1M 个 token 位置缩减到大约 8K 个压缩条目。这就是它与 CSA 的关键区别:压缩后的缓存足够小,模型可以对其做稠密注意力,而不必选择 top-k 子集。HCA 让模型对整个上下文做粗粒度的全局读取,而 CSA 则对选定区域做更细粒度的稀疏读取。
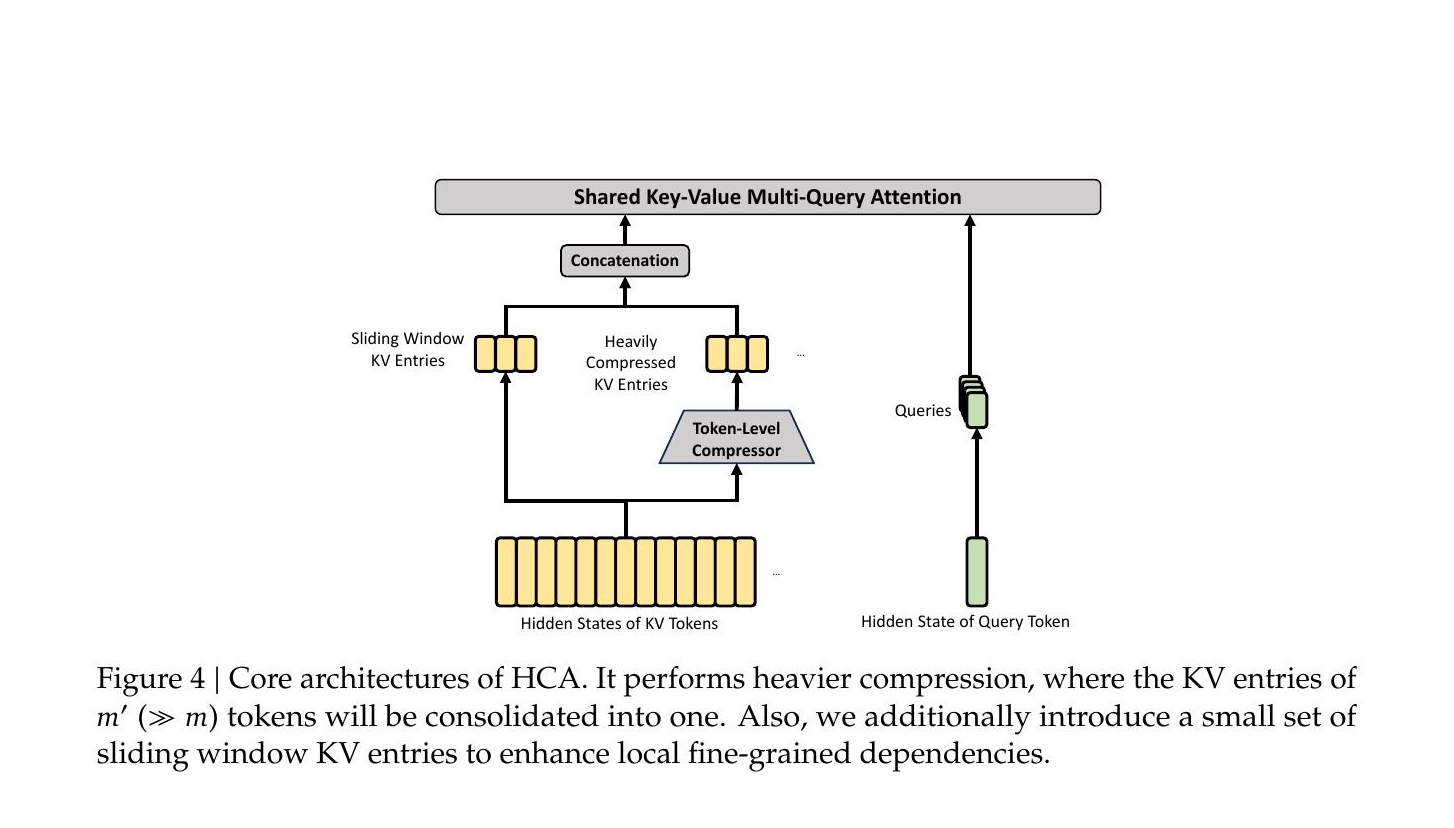
Sliding Window Attention(SWA)保留了局部路径。窗口很短,大约 128 个 token,使近期上下文保持精确。
在整个栈中,引擎需要管理 CSA 压缩状态、HCA 压缩状态、SWA 局部状态,以及 CSA 和 HCA 压缩器所使用的短的未压缩尾部状态。这些对象的大小、生命周期和读取模式各不相同。
新的注意力内核只是工作的一部分。更难的服务问题是内存管理:对请求做批处理、淘汰缓存页、复用前缀,并在模型的不同部分依赖不同类型存储状态的情况下,保持解码吞吐量稳定。

前缀缓存变成了一种存储策略
前缀缓存通常从一条简单的规则开始:前缀相同,KV 共享。到了 V4,问题变成了:缓存哪一种?
一个共享前缀包含 CSA 状态、HCA 状态、SWA 状态,以及 CSA 和 HCA 压缩器使用的未压缩尾部状态。CSA 和 HCA 足够紧凑,可以高效存储。SWA 是精确的局部状态,因此对长前缀来说存储成本更高,尤其是当缓存层级延伸到 GPU 内存之外时。
DeepSeek 的论文描述了三种 SWA 策略。
第一种是存储完整的 SWA cache。复用很简单,因为引擎可以直接恢复完整的前缀状态,但存储量和写入带宽会迅速增长。
第二种是存储周期性的 SWA 检查点。引擎每隔 K 个 token 保存一次状态,并在缓存命中时重算中间的间隔部分。
第三种是在命中时重算 SWA。引擎存储压缩后的 CSA / HCA 状态,并在前缀被复用时重建 SWA 路径。其成本以窗口大小乘以层数为上限。在 128 token 的窗口和 61 层的情况下,大约是 8K token 的重算量。相对于 1M token 的前缀,这样的权衡可能是合理的。
在我们当前的 V4 适配中,我们采用第一种策略:存储完整的 SWA cache。这使前缀复用保持简单,并在服务路径的其余部分仍在成熟的阶段避免引入重算的复杂性。代价是缓存占用更高,随着上下文长度和并发度的增加,缓存策略和淘汰行为也因此变得更加重要。
V4 把前缀缓存变成了跨缓存对象的策略决策:存储 CSA 和 HCA,决定如何处理 SWA,并按各自的成本分别淘汰每种类型。
V4 的性能取决于所处区间
V4 的收益首先出现在 KV cache 占主导的地方。
长上下文、以解码为主的工作负载,大部分时间都花在读取缓存上。V4 的压缩缓存布局减轻了这种压力。
短上下文、以预填充为主的工作负载则走另一条路径。CSA 的 top-k 选择、HCA 的压缩读取和 SWA 引入了一些成熟稠密注意力内核路径之外的操作。内核的成熟度很重要。精度格式同样重要:V4 的 MoE 权重使用 MXFP4,其性能特征与 NVIDIA Blackwell GPU 上的 NVFP4 不同。这使短上下文预填充对内核成熟度尤其敏感,而长上下文解码则更直接地受益于 KV cache 的缩减。
这就形成了区间的分化。长上下文负载很早就能从 V4 的缓存节省中获益。短上下文负载则更依赖内核适配和预填充优化。这对新架构来说很典型:第一个实现确立正确性;后续迭代再逐步缩小与硬件效率之间的差距。
Together 正在继续推进预填充和解码两条路径上的 V4 内核工作。
开发者应当在自己的实际区间内对 V4 做基准测试。1M 上下文的编码智能体和短上下文的聊天助手,考验的是服务栈的不同部分。
同样的权重,需要不同的服务配置
V4 拉大了不同工作负载形态之间的差距。
长上下文智能体最直接地受益于这一架构。它们在解码时要读取大量缓存,因此 V4 的压缩 KV 布局、更大的张量并行配置、批处理和前缀复用都很重要。这正是该模型的长上下文设计应当最先体现价值的区间。
基于共享代码仓库的编码智能体与之相关,但其服务问题更偏重前缀。相同的项目文件、仓库状态或任务脚手架可能在多个请求中重复出现,因此缓存分层和 SWA 重算策略成为首要选择。瓶颈同时包括长上下文和重复上下文的复用。
短聊天则处于光谱的另一端。这类负载从百万 token 缓存压缩中获益不多,反而会暴露预填充延迟、小批量开销和内核成熟度方面的问题。要把它们服务好,可能需要更小的张量并行组、最小的批处理等待,以及针对短上下文路径调优的内核。
强化学习展开关心的是另一种经济学单位:每条长轨迹的成本。它们可能与长上下文智能体共用服务机制,但优化目标是实验吞吐量,即每份训练预算能生成多少条长程展开,而不仅仅是单个请求的延迟。
同样的权重可以服务所有这些工作负载。每一种在不同的端点配置下表现最佳。Together 正在评估采用不同批处理、并行和缓存策略的端点配置方案。
迁移到 V4 之前该测什么
百万 token 服务对那些在长任务中不断累积状态的系统最为重要:编码智能体、研究智能体,以及其他更长周期的任务。对这些负载,成本模型往往从每 token 价格转向每条完成轨迹的成本。
在把流量迁移到 V4 之前,请对四件事做基准测试:上下文长度区间、前缀复用、缓存策略和端点配置。
对于长上下文智能体,请衡量缓存命中率、解码吞吐量和每个已完成任务的成本。首 token 延迟只反映了其中一部分情况。
对于短聊天,请在真实的上下文长度和批大小下比较延迟。V4 的长上下文收益可能不会首先体现在短聊天的延迟上。
对于共享前缀的负载,请测试 SWA 完整存储与命中时重算两种方案。前缀长度、缓存层级延迟和复用频率决定了答案。
对于强化学习展开,请按轨迹长度和每次实验的展开数量来计算成本,而不是只看 token 价格。
对于混合流量,需预期有所取舍。一个端点可以服务混合负载,但一旦工作负载形态明确,针对特定配置的端点通常表现更好。
质量仍然需要衡量。更长的上下文为有用的状态、检索噪声、压缩伪影和延迟都创造了更多空间。它还改变了压缩(compaction)策略:构建者对何时保留原始状态、何时做摘要、何时重置拥有更多控制权。
结论
DeepSeek-V4 的效率是一种系统属性。该架构通过沿 token 轴压缩来降低 KV 压力,但服务引擎必须管理由这一选择衍生出来的缓存类型、前缀策略、内核路径和端点配置。
这也正是全栈协同设计的价值所在。模型改变了缓存布局。推理引擎改变了内存管理和前缀策略。内核适配新的注意力和精度路径。NVIDIA 在 Blackwell 上以 MXFP4 为 V4 提供了 day 0 支持,同时也让开发者可以借助 NVFP4 优化性能。通过深入的协同设计,Together AI 和 NVIDIA 持续通过软件优化来提升硬件效率,例如 NVIDIA Dynamo。极致的协同设计在 DeepSeek V4 等领先的开源模型上实现了最低的每 token 成本,并在 NVIDIA Blackwell 上释放出更高的性能。
跑起来 V4 只是起点。要把它在架构上的节省转化为更低的延迟、更高的并发和更便宜的长上下文负载,还需要缓存策略方面的工作、内核方面的工作,以及针对具体工作负载的服务配置。下一步是测量:每 token 的 KV 占用、随上下文长度变化的吞吐量曲线、前缀缓存策略的影响,以及面向不同流量形态的端点配置。随着 V4 内核和缓存策略的成熟,我们会公布这些数据。
常见问题
DeepSeek-V4 的上下文窗口有多大?DeepSeek-V4 支持 1M token 的上下文窗口。它通过一种混合注意力设计实现这一点:在键值(KV)存储之前先压缩上下文,混合使用压缩与局部两条注意力路径,并改变前缀复用的工作方式。正是这一架构变化,使百万 token 上下文成为可行的服务负载。
DeepSeek-V4 中的 Compressed Sparse Attention(CSA)是什么?CSA 以步幅 4 压缩上下文,每个压缩条目概括一个 8 token 的邻域,因此相邻条目在边界处有重叠。查询会从这些压缩条目中选取大约 128 个,让模型获得一条细粒度的稀疏路径进入前缀中选定的区域,同时降低所存储的缓存占用。
什么是 Heavily Compressed Attention(HCA)?HCA 使用与 CSA 相同的压缩机制,但步幅为 128。在 1M token 的上下文下,这会把缓存从 1M 个位置缩减到大约 8K 个压缩条目,小到模型可以对其全部做稠密注意力。HCA 提供粗粒度的全局读取,而 CSA 则提供对选定区域的细粒度稀疏读取。
与早期模型相比,DeepSeek-V4 如何减小 KV cache 的大小?DeepSeek-V4 沿着 KV cache 的 token 轴进行压缩。早期技术削减的是缓存乘积中的不同项:Group Query Attention 减少 KV 头数,Multi-Head Latent Attention 压缩头维度,FP8/MXFP4/NVFP4 降低每个元素的字节数。DeepSeek-V3.2 减少了解码时需要读取的缓存量,但仍让完整缓存常驻。V4 则减少了所存储的 token 条目本身的数量。
为什么服务 DeepSeek-V4 需要多种 KV cache 布局?该模型使用三种注意力路径(CSA、HCA 和 Sliding Window Attention),并在各层之间混合使用。每一种产生的缓存对象在大小、生命周期和读取模式上各不相同。推理引擎必须针对每个请求同时管理这三种缓存,这使内存管理、淘汰和前缀复用比单缓存设计下更加困难。
前缀缓存如何与 DeepSeek-V4 配合工作?前缀缓存变成了按缓存类型分别做出的策略决策。CSA 和 HCA 状态足够紧凑,可以存储。SWA 状态是精确的局部状态,在长前缀下存储成本会变得很高。DeepSeek 的论文描述了三种选择:存储完整的 SWA、存储周期性检查点,或在缓存命中时重算 SWA。命中时重算的成本以窗口大小乘以层数为上限,相对于 1M token 的前缀,大约是 8K token 的重算量。
哪些工作负载从 DeepSeek-V4 中获益最多?长上下文、以解码为主的工作负载最先获益,包括在长任务中不断累积状态的编码智能体、研究智能体和强化学习展开。对这些负载,成本模型从每 token 价格转向每条完成轨迹的成本。短上下文聊天负载的收益较小,因为它们更多暴露的是预填充延迟和内核成熟度问题,而不是 KV cache 压力。
我应该把短聊天流量迁移到 DeepSeek-V4 吗?先做基准测试。V4 的收益体现在 KV cache 占主导的地方。短上下文、以预填充为主的工作负载走的是较新的内核路径(CSA top-k 选择、HCA 稠密读取、MXFP4 的 MoE 权重),这些路径仍在成熟之中。在切换之前,请在你真实的上下文长度和批大小下比较延迟。即使使用相同的权重,长上下文智能体和短聊天也可能需要不同的端点配置。
为什么 Together 选择 NVIDIA HGX B200 来服务 DeepSeek V4?
NVIDIA HGX B200 与 DeepSeek V4 中主导服务成本的两个部分相契合:长上下文解码期间的 KV cache 压力,以及预填充期间的 MoE 权重带宽。NVIDIA Blackwell 的推理性能使单个 HGX B200 节点能够为众多并发的长上下文请求常驻保存 V4 压缩后的 CSA / HCA / SWA 缓存布局,而其原生的 MXFP4 支持与 DeepSeek 为 V4 的 MoE 权重所发布的格式一致,因此我们可以端到端地运行模型的量化方案,无需重新转换格式。Together 的 HGX B200 实例同样继承了这条 MXFP4 路径和 KV 压缩带来的余量,这也是我们选它作为 V4 上线平台的原因。