前沿模型训练已将 GPU 和 AI 系统推向绝对极限,使成本、效率、功耗、每 TCO 性能和可靠性成为讨论高效训练的核心。Hopper 与 Blackwell 的比较,并不像 Nvidia 想让你相信的那样简单。
在本报告中,我们首先展示在 2,000 多块 H100 GPU 上运行基准测试的结果,分析模型浮点运算利用率(MFU)、总拥有成本(TCO)以及每训练 100 万 token 的成本等数据。我们还将讨论能耗,考察每训练一个 token 所消耗的电网焦耳(utility Joules)数,并与美国家庭的年均能耗做对比,从社会层面重新审视功耗效率。我们还将展示在把 GPU 集群从 128 块 H100 扩展到 2048 块 H100,以及在不同版本的 Nvidia 软件下,这一分析的结果。
在报告后半部分,我们还将分析 GB200 NVL72 在 Llama4 400B MoE 和 DeepSeek 670B MoE 上的基准测试结果,并将这些数据与我们早先在 H100 上的结果进行比较。我们将讨论,在计入可靠性问题之后,GB200 NVL72 在每美元性能上的优势是否依然成立。
可靠性不佳造成的停机时间和损失的工程师时间,是我们在每 TCO 性能计算中要计入的主要因素之一。目前,GB200 NVL72 上还没有完成任何大规模训练任务,因为软件仍在成熟,可靠性挑战也仍在解决之中。这意味着,Nvidia 的 H100 和 H200 以及 Google TPU,仍是当今唯一成功用于完成前沿规模训练的加速器。就现状而言,即使是前沿实验室和 CSP 中最先进的运营者,也还无法在 GB200 NVL72 上进行超大规模训练。
话虽如此,每一代新架构自然都需要时间,让生态系统的软件逐步爬坡以有效利用该架构。GB200 NVL72 的爬坡比前几代稍慢,但慢得不多,我们有信心在今年年底之前,GB200 NVL72 的软件会有大幅改进。再加上前沿模型架构在设计时就考虑了更大的 scale-up 规模,我们预计到年底,使用 GB200 NVL72 将带来显著的效率提升。
在可靠性方面,仍将存在重大挑战,Nvidia 必须与合作伙伴更紧密地合作,才能迅速解决,但我们认为生态系统会很快调集资源来应对这些可靠性挑战。
SemiAnalysis 正在招聘
我们正在寻找一名应届毕业的工程师加入工程团队。这是一个难得的机会,可以参与一个备受瞩目的特别项目,并得到众多行业领袖和 CEO 的支持。如果你热衷于性能工程和系统可靠性,并希望在硬件与软件的交汇处工作,这是一个产生全行业影响的难得机会。
你将从事的工作:
- 在多家厂商(AMD、NVIDIA、TPU、Trainium 等)的硬件上构建并运行大规模基准测试
- 设计可复现的 CI/CD 流水线,自动化基准测试工作流
- 确保行业合作伙伴所用系统的可靠性与可扩展性
我们期望的条件:
- 扎实的 Python 功底
- 具备站点可靠性工程(SRE)背景,或擅长系统级问题的解决
- 有 CI/CD 流水线和现代 DevOps 实践经验
- 对 GPU、TPU、Trainium、多云和性能基准测试充满好奇
申请链接:https://app.dover.com/apply/SemiAnalysis/2a9c8da5-6d59-4ac8-8302-3877345dbce1
基准测试与分析方法
在基准测试和分析中,我们依靠 Nvidia DGXC 基准测试团队全新的 DGX Cloud Benchmarking Scripts,在 NVIDIA 内部的 H100 EOS 集群上执行,该集群配置了 8×400 Gbit/s InfiniBand 网络。这些结果是官方参考数字,Neocloud 环境在 Neocloud 与客户之间约定服务水平协议(SLA)时,可以以此作为对比基准。
云厂商也可以向 NVIDIA 提交基准测试结果,如果能够达到这些 EOS 参考数字,就可以获得 NVIDIA Exemplar Cloud 认证。我们即将发布的 ClusterMAXv2 在评估服务质量时,将高度重视服务商的 Exemplar Cloud 资质,因为这一资质是一种背书,表明服务商能够在大规模 GPU 部署的众多工作负载上交付参考性能数字。
上述基准测试使用 NeMo Megatron-LM 进行,但考虑到许多 GPU 终端用户并不完全依赖 NeMo Megatron-LM,DGXC 基准测试团队计划把覆盖范围扩展到原生 Torch DTensor 框架,例如 TorchTitan。
我们要感谢 Nvidia DGCX 基准测试团队创建这些基准测试,并提供参考数字,助力 GPU 云行业的整体提升!
H100 与 GB200 NVL72 的资本支出、运营支出和总拥有成本分析
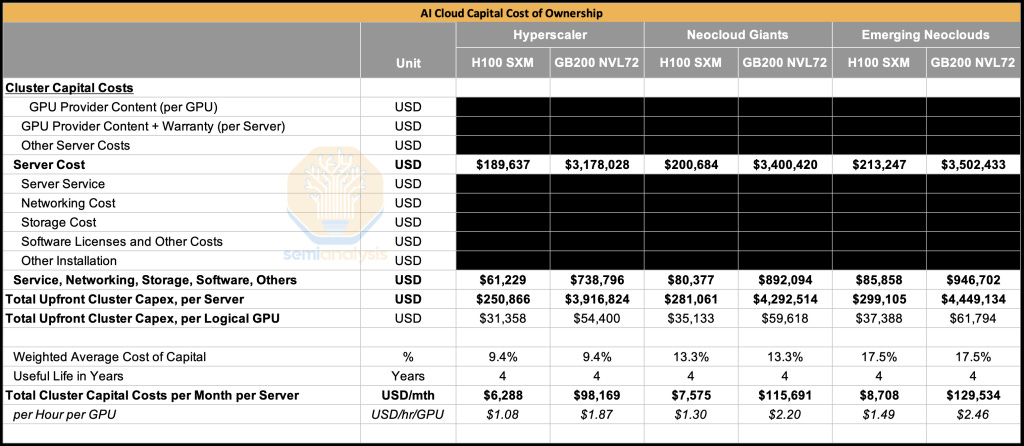
过去 18 个月里,H100 服务器的价格有所下降,目前约为每台 19 万美元。算上存储、网络和其他项目,典型超大规模云厂商每台服务器的前期资本总成本为 25 万美元。
再看 GB200 NVL72,仅机架级服务器一项,典型超大规模云厂商的采购价就是 310 万美元。算上网络、存储和其他项目,每个机架的全部成本约为 390 万美元。
比较从超大规模云厂商、Neocloud 巨头到新兴 Neocloud 这三类买家,GB200 NVL72 每块 GPU 的全部资本成本,约为 H100 每块 GPU 全部资本成本的 1.6 倍至 1.7 倍。
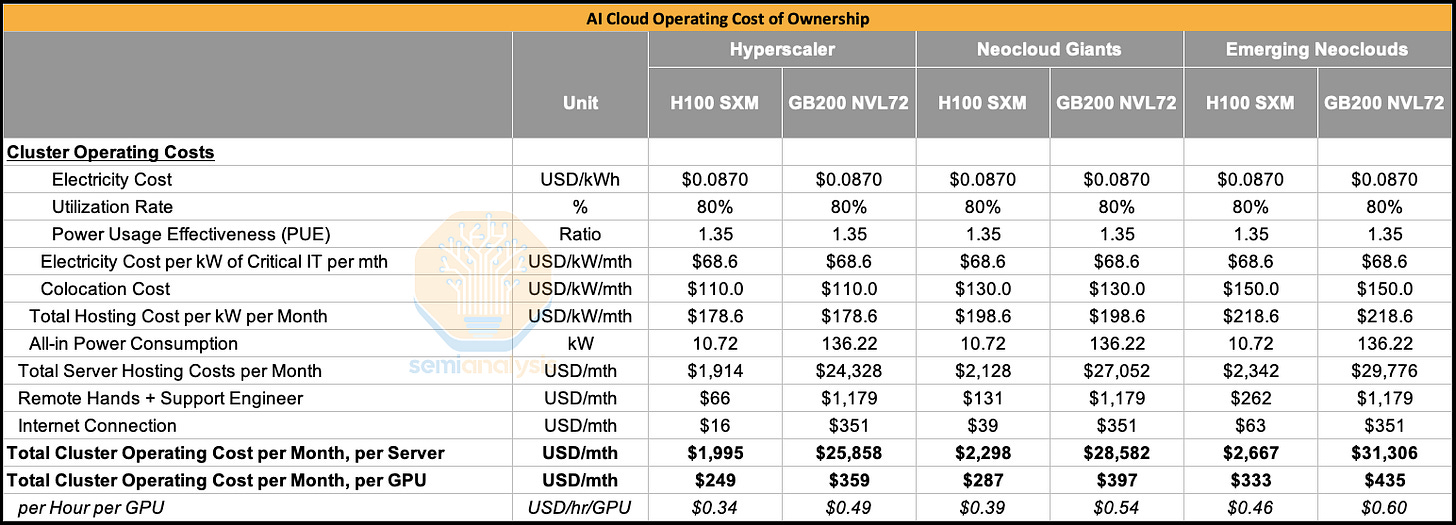
比较两套系统的运营拥有成本,我们发现 GB200 NVL72 每块 GPU 的运营支出(Opex)并不比 H100 高出太多。成本差异来自 GB200 NVL72 每块 GPU 的整体功耗高于 H100。这主要是因为 GB200 芯片每颗功耗 1200W,而 H100 为 700W。
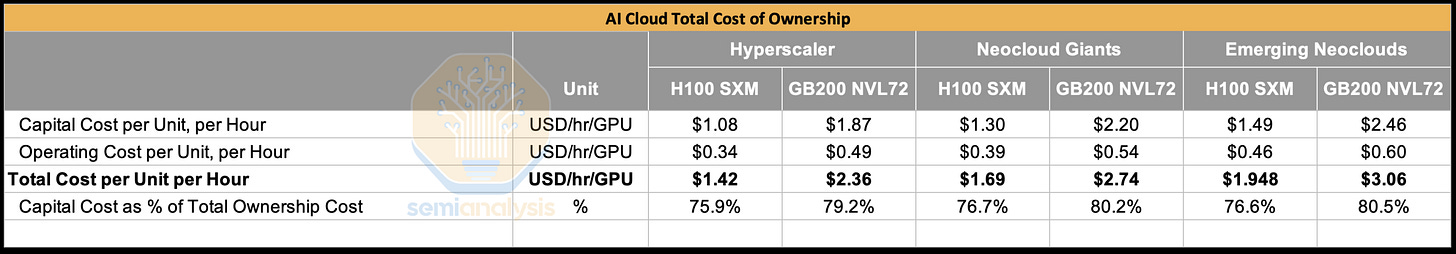
把资本支出和运营支出都计入,得出总拥有成本(TCO)后,我们看到 GB200 NVL72 的 TCO 比 H100 高出约 1.6 倍。这意味着,GB200 NVL72 至少要比 H100 快 1.6 倍,才能在每 TCO 性能上相对 H100 具备优势。
Nvidia 可以为 ML 社区做得更好的三件事
在深入基准测试和结果之前,我们先向 Nvidia 提出三条关键建议。
第一,我们建议 Nvidia 扩大基准测试工作,并进一步提高透明度。为了持续抬高整个 GPU 云行业的标准,Nvidia 需要对其超大规模云厂商合作伙伴和 Nvidia 云合作伙伴(NCP)都进行基准测试,并公开这些数据。这样,ML 社区里的任何人在签署价值数千万甚至数亿美元的合同之前,都可以把基准测试数据纳入决策过程。
举个例子,在我们首次发布的 ClusterMAX 评级体系中,我们指出 GCP 较早的 a3-mega H100,在 O(Llama 70B) 规模的训练中,MFU 比平均水平低 10%;在 O(8x7B) 规模的稀疏混合专家模型上,MFU 比平均水平低 15-20%。因此,终端用户向 GCP 支付的租用成本应比平均水平低 10-20%,才能获得与市场平均水平相同的每美元性能。有一套覆盖超大规模云厂商和 NCP 服务商、可公开获取的基准测试结果,将大大提高协商合理合同价格的便利性,并加快决策。这样就无需进行大量、昂贵且耗时的概念验证运行,双方都能节省大量时间和金钱。
我们对 Nvidia 的第二条建议是,把基准测试的重点扩展到 NeMo-MegatronLM 之外,因为许多用户更愿意使用搭配 FSDP2 和 DTensor 的原生 PyTorch,而不是 NeMo-MegatronLM。使用 NeMo-MegatronLM 的一个好处是,任何时候 NeMo-MegatronLM 中都有许多尚未进入原生 PyTorch 的性能特性。最新特性先在 NeMo-Megatron 中推出是合理的,但所有这些特性最迟应在一个月后上游合入原生 PyTorch。为此,应当把更多 Nvidia 工程师分配到 PyTorch 核心开发上,而不是让他们继续给 NeMo 添加更多特性。Nvidia 把基准测试重点扩展到包括使用 PyTorch 的运行,也与这一举措完美契合。
与其让工程师优化 NeMo,不如让他们去优化 TorchTitan。新的 NeMo AutoModel 库是朝着正确方向迈出的一步,因为除 Megatron-LM 外,它还支持原生 PyTorch FSDP2 后端;但明显缺失的是基于 DTensor 的原生 PyTorch 3D+ 并行,许多预训练特性也尚不具备,大部分特性都是面向微调的。
我们的第三条建议是,Nvidia 继续加快 GB200 NVL72 背板诊断和调试工具的开发。遗憾的是,即使经过大量的老化测试(burn-in)流程,NVLink 铜缆背板仍然不够可靠。GB200 NVL72 的运营者还抱怨说,用于诊断和调试背板相关错误的工具落后且不够理想,使这一问题雪上加霜。Nvidia 还可以在将 GB200 NVL72 机架交付给客户之前,坚持要求其 ODM/OEM 合作伙伴执行更严格的验收测试,以改善这种状况。
GPT-3 175B 每 GPU 每秒 token 数、训练性能与功耗。2024 年 1 月至 2024 年 12 月的成本改善
下表展示了我们在 128 块 H100 集群上、于不同时间点训练 GPT-3 175B 的基准测试结果。我们选择展示从 2024 年 1 月到 2024 年 12 月不同 NeMo-Megatron LM 版本下的结果,分别对应 H100 大规模部署开始后的第一年和第二年。
基准测试配置使用 128 块 H100,有 4 个数据副本。每个数据副本由 32 块 GPU 组成:每一层在 4 块 GPU 的 NVLink 域内做张量并行(即 TP=4),然后再做流水线并行。人们可能认为,最好使用 TP=8 以匹配 H100 整个 NVLink 域的 8 块 GPU,但对于 GPT-3 175B 模型,使用 TP=4 更好,因为这样的算术强度更高。
具体来说,GPT3 175B 的隐藏维度是 12,288,这意味着如果使用 TP=8,得到的 K 归约维度会很小,只有 1,536。相比之下,使用 TP=4 时,隐藏归约维度则为 3,072。
该基准测试的序列长度沿用原始 GPT-3 论文的设置,使用 2,048 的序列长度,以及 256 个样本的全局批大小。这意味着模型在每次优化器更新之前会看到 50 万(全局批大小 × 序列长度)个 token。
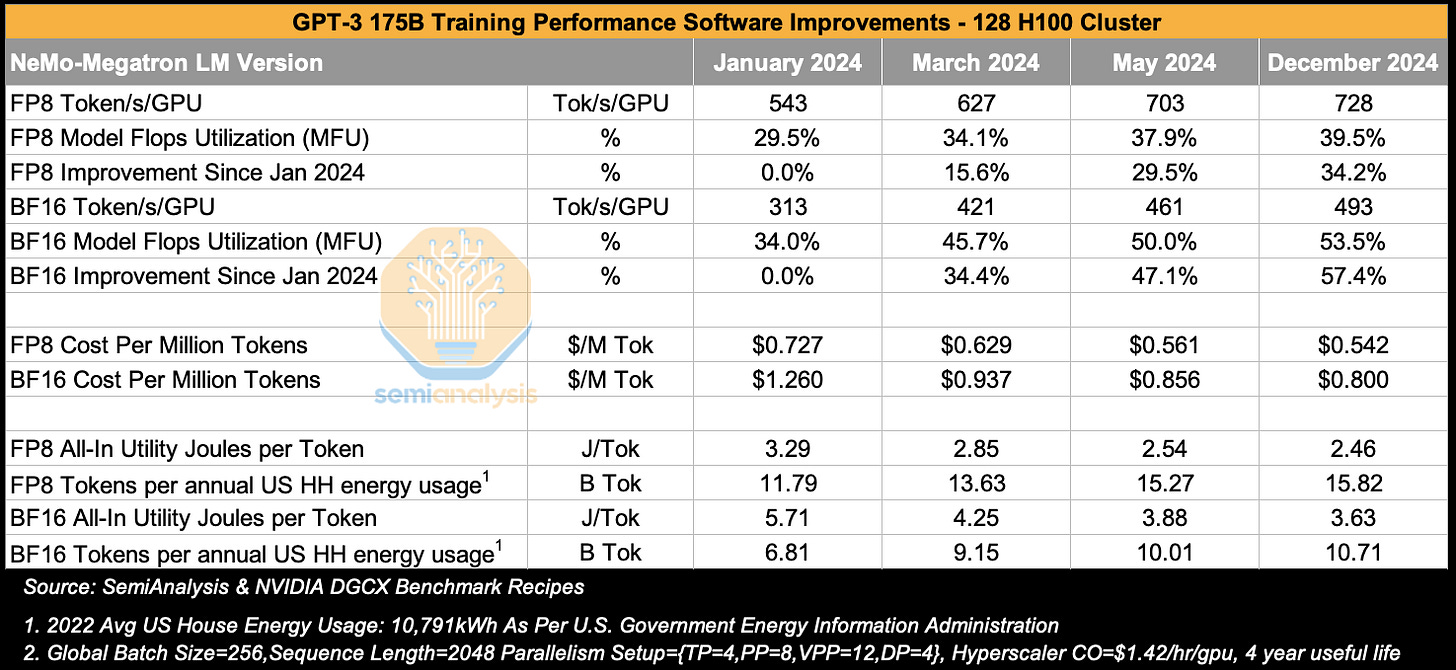
观察 BF16 模型浮点运算利用率(MFU),我们看到在 12 个月里 MFU 从 34% 大幅提升到 54%,仅靠 CUDA 软件栈的软件改进,训练吞吐量就提升了 57%。这一改进来自 NVIDIA CuDNN/CuBLAS 工程师编写了更优化的融合 wgmma kernel,NCCL 工程师编写了通信时占用更少 SM 的更优化集合通信算子,以及其他改进。归根结底,重要的是整个软件栈的优化。
FP8 MFU 呈现同样的趋势,在同一时期从 29.5% 提升到 39.5%,仅靠软件收益,吞吐量就提高了 34%。
再看成本,假设每块 GPU 每小时成本为 1.42 美元(不含任何租赁利润),我们看到 FP8 下训练 GPT-3 175B 的成本,从 2024 年 1 月的每训练 100 万 token 72 美分,降到 2024 年 12 月的每百万 token 仅 54.2 美分。这意味着,按原始训练 token 数 3000 亿计算,训练 GPT-3 175B 的成本从 2024 年 1 月的 21.8 万美元,降到 2024 年 12 月的仅 16.2 万美元。
最后,我们考察训练 GPT-3 的功耗。我们估算了 128 块 H100 集群的整体功耗,包括 GPU、CPU、网络、存储及其他组件。然后按典型托管数据中心的电能利用效率(PUE)上调,得出每个 token 的全部电网焦耳数。
这是一段不受欢迎的高中物理回忆:焦耳是能量单位,相当于 1 牛顿的力沿力的方向将物体移动 1 米所做的功。点亮一只 60W 的白炽灯泡一秒钟消耗 60 焦耳(瓦特(W)是每秒能耗的单位),一小时消耗 216kJ。表示能量单位的另一种方式是使用瓦时或千瓦时,即设备功率乘以其使用的小时数。2022 年美国家庭的年均能耗为 10,791kWh,约合 38,847,600,000 焦耳。将这 10,791 kWh 除以每年 8,760 小时,得到全年平均功率 1,232 W,略高于单块 GB200 GPU 所用的 1,200W!
我们看到,使用 2024 年 12 月版本的 NVIDIA 软件时,每训练一个 token,FP8 消耗 2.46 焦耳,BF16 消耗 3.63 焦耳。如果我们的能量预算相当于美国家庭的年均能耗,就可以训练 158 亿个 FP8 token。进一步延伸这一计算,在 GPT3 175B 上训练 3000 亿个 token,FP8 需要相当于 19 个美国家庭年能耗的能量,BF16 需要相当于 28 个家庭年能耗的能量。
GPT-3 总训练成本 16.2 万美元、19 个家庭的年能耗,听起来并不过分,但正是大量的实验和大量失败的训练任务累加起来,才造成了我们现在在美国看到的 AI 训练能耗激增。
弱扩展与强扩展
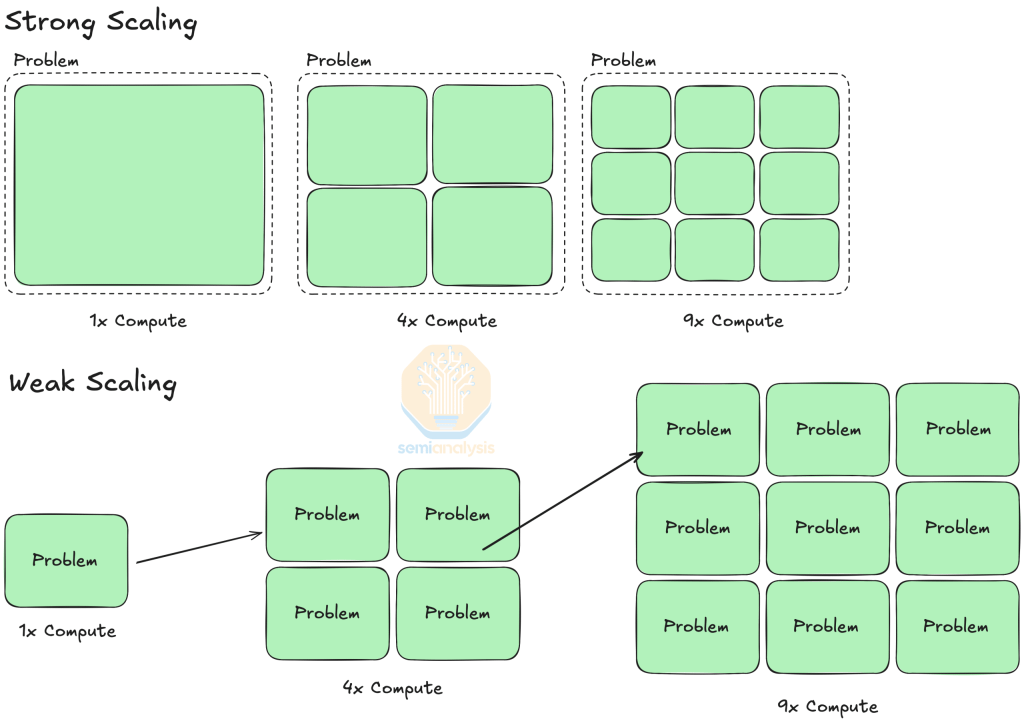
强扩展和弱扩展描述的是,针对不同的问题设置(例如不同的批大小),扩展计算资源所带来的性能提升。
强扩展是指在保持模型大小和全局批大小不变的情况下扩展计算资源。在这种情况下,可以用阿姆达尔定律(Amdahl’s Law)来量化强扩展的加速比,该定律描述了并行化计算步骤所能实现的加速。
另一方面,弱扩展是指扩展计算资源,在恒定时间内解决更大的问题。AI 训练本质上采用弱扩展,因为你可以通过增加训练任务所用的 GPU 数量,来扩大模型规模和全局批大小(取决于收敛情况)。
Llama3 405B 每 GPU 每秒 token 数、每百万 token 成本、每 token 焦耳数与 GPU 数量的关系(弱扩展)
在这项基准测试中,我们考察随着集群中 H100 GPU 数量的增加,Llama3 405B 的训练性能如何变化,这是弱扩展的一个例子。
下表显示,当我们把 GPU 集群规模从 576 块 H100 增加到 2,304 块 H100 时,各个规模下的 FP8 MFU 和 BF16 MFU 分别稳定在约 43% 和 54%。在 Llama 3 Herd of Models 论文公布的训练运行中,研究人员使用 16k 块 H100 训练 Llama 3 405B,采用类似的并行策略,预训练时BF16 MFU 达到 41%。请注意,上述预训练运行使用的序列长度为 8192,而在中期训练的上下文扩展阶段,每个样本的序列长度是 131,072,而不是 8,192。这种更长的序列长度需要跨 16 个节点做上下文并行,由于环形注意力(ring attention)所需的额外通信,MFU 降到了 38%。
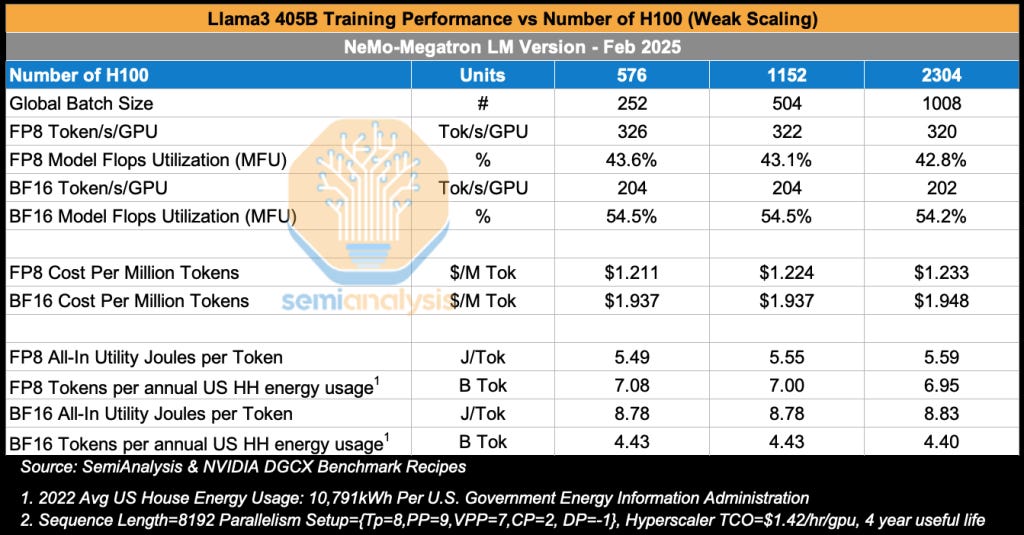
再看总训练成本,仅进行预训练运行,即在 15T token 上训练 Llama 3 405B,使用 2,304 块 H100 集群以 BF16 训练时,每百万 token 成本为 1.95 美元。仅预训练阶段就累计高达 2910 万美元,远高于 DeepSeek 等混合专家模型,后者每次训练运行仅需 500 万美元。
当然,我们再次强调,这一成本仅反映单次最终成功训练运行的成本,并不包括为达到最终阶段所需的大量实验的成本,也不包括雇用研究人员的成本等其他成本。
由于 Llama3 405B 的总参数量约为 GPT3 175B 的 2.3 倍,Llama 3 405B 的每 token 全部电网焦耳数也约为 GPT3 175B 的 2.3 倍,分别为每 token 8.8 焦耳和每 token 3.6 焦耳。
这意味着,使用与美国家庭一年消耗的相同能量,Meta 可以用 BF16 在 Llama3 405B 上训练 44 亿个 token。若使用 15T token 训练至收敛,Meta 需要的能量相当于 3,400 个美国家庭组成的整个社区一年的消耗量。
Llama3 70B 训练性能:每 GPU 每秒 token 数、每百万 token 成本、每 token 焦耳数与 GPU 数量的关系(弱扩展)
接下来,我们看不同集群规模下 Llama3 70B 的训练性能。当集群规模从 64 块 H100 增加到 2,048 块 H100 时,我们看到 FP8 的性能下降了 10%,从 64 块 GPU 时的 38.1% 降到 2,048 块 GPU 时的 35.5%。MFU 下降得如此之多(按百分比计算,鉴于 MFU 基数较低,这才是真正重要的),相当有意思,因为在扩展过程中,每个数据副本的批大小没有变化,并行策略也没有变化。所有运行仍然使用 TP=4、PP=2 和上下文并行=2,唯一真正的变化是增加了更多数据副本。有趣的是,对于 BF16,MFU 的下降要小得多,只有 1-2%,从 64 块 H100 时的 54.5% MFU 降到 2,408 块 GPU 时的 53.7%。
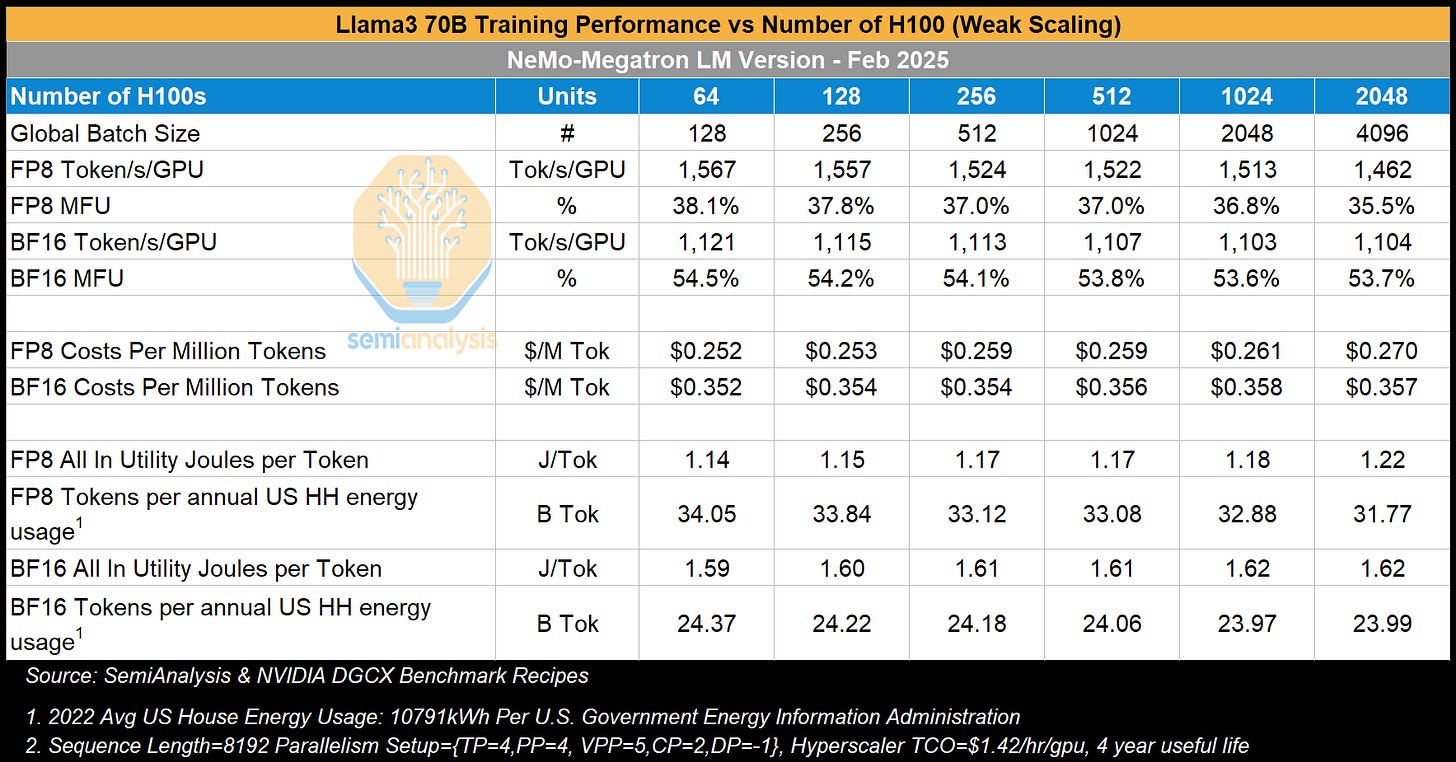
Llama3 405B 比 Llama3 70B 大 5.7 倍,与任何稠密模型一样,所需的 FLOPs 数量与参数量呈线性关系。因此,训练 Llama 3 405B 的成本应该是训练 Llama 3 70B 的 5.7 倍。实际上,在约 2k 块 H100 的规模下,按 BF16 每百万 token 成本计算,Llama3 405B 贵 5.4 倍。
在功耗方面,我们看到对于 FP8,在 2,408 块 H100 上训练比在 64 块 H100 上训练,每个 token 多消耗 10% 的能量。若用 64 块 H100 以 FP8 在 15T token 上把 Llama 3 70B 训练到收敛,所用能量仅相当于 440 个美国家庭的年能耗,而在 2,048 块 H100 的规模下,则需要相当于 472 个美国家庭年能耗的能量。
Llama3 8B 训练性能随时间的变化
Llama3 405B 和 Llama3 70B 这类较大的模型都同时使用张量并行、流水线并行和数据并行,而训练 Llama3 8B 只需在 NVLink 域内的每对 GPU 之间,沿 8,192 的序列长度做上下文并行,并用数据并行把工作分散到其他各对 GPU 上。在这项分析中,我们还考察训练性能随时间的变化,以衡量整个软件栈的软件改进对训练性能的影响。我们看到,从 2024 年 11 月到 2025 年 4 月,性能只有小幅提升,后一个日期距离 Hopper 开始大规模部署已整整过去 23 个月。
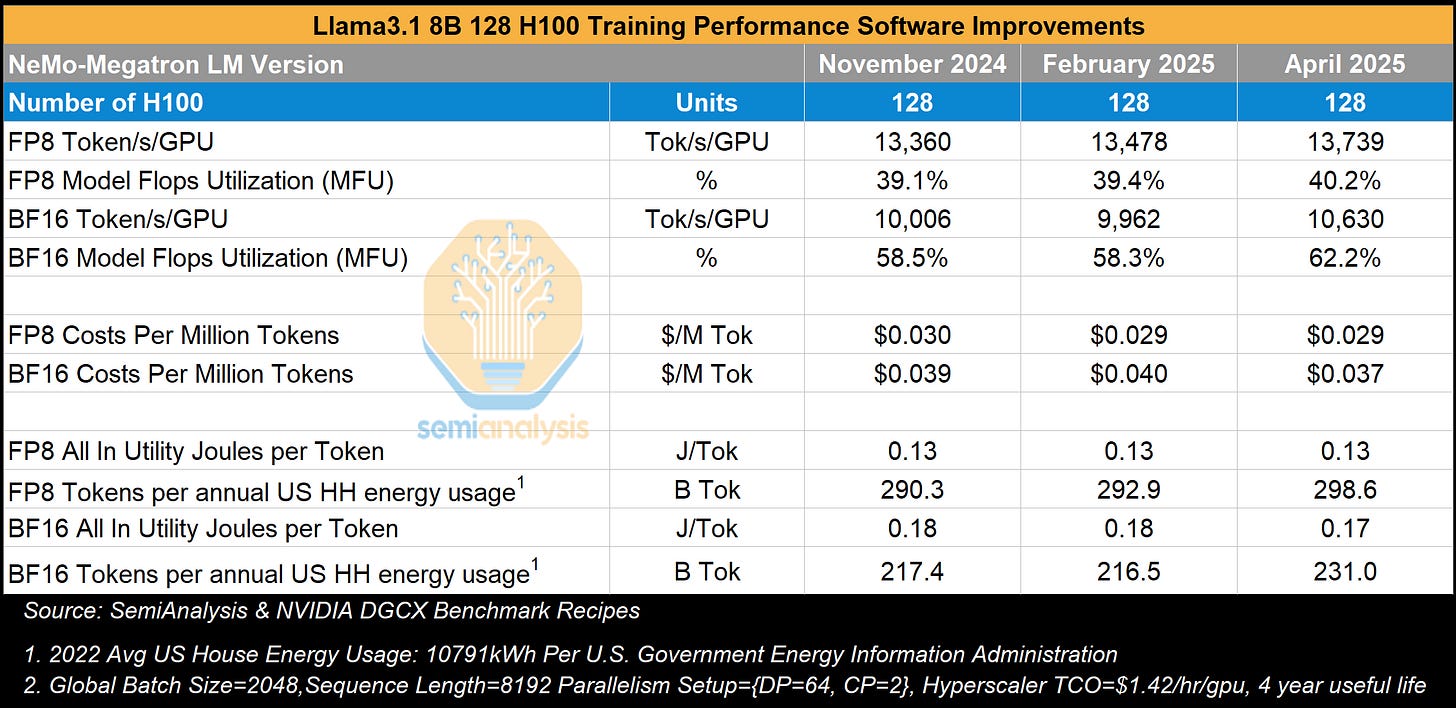
在下一部分,我们将深入探讨 GB200 NVL72 目前的训练性能,并与 H100 上的训练进行比较。我们将讨论训练 DeepSeek 670B MoE 和 Llama4 400B MoE 的基准测试,分析 GB200 相对于 H100 的每总拥有成本(TCO)性能。
我们还将聚焦前面提到的 GB200 NVL72 缺乏有效诊断和调试工具的问题,并讨论造成 GB200 NVL72 不可靠的诸多问题。要想在年底之前在 GB200 NVL72 上成功且经济高效地训练前沿模型,NVIDIA、CSP、Neocloud 以及前沿实验室的终端用户都必须解决这些挑战。