思考
摘要
Mistral 发布了 Voxtral TTS,这是一个 40 亿参数的文本转语音模型,在多语言语音生成方面达到业界领先水平,可用 9 种语言生成逼真且富有情感表现力的语音,延迟低,并且易于适配新声音。该模型在上下文理解、说话人建模和零样本跨语言声音适配方面表现出色,非常适合企业语音工作流和可扩展的 AI 智能体。它可通过 API 和 Mistral Studio 使用,提供高性价比的高质量语音生成,价格起步为每 1k 字符 $0.016。
今天,我们发布 Voxtral TTS,这是我们的首个文本转语音模型,在多语言语音生成方面具备业界领先的性能。该模型只有 4B 参数,体量轻巧,使由 Voxtral 驱动的智能体在大规模部署时自然、可靠且成本可控。
亮点。
- 支持 9 种常用语言和多种方言,语音逼真,富有情感表现力。
- 首段音频的延迟极低。
- 易于适配新声音。
- 可在 Mistral Studio 中试用。
- 企业级文本转语音,为关键的语音智能体工作流提供支撑。
▶ https://www.youtube.com/watch?v=SpLRS7Q3fIk
自然的语音生成取决于模型能否不只是朗读,而是准确地理解文本。上下文理解(比如中性、开心、讽刺等)决定了听者认为生成结果是准确的还是机械的。我们的模型在上下文理解和说话人建模上都表现出色:说话人建模即捕捉特定的人自然说话的方式。我们的声音适配超越了传统的朗读式语音,能够捕捉说话人的个性,包括其自然的停顿、节奏、语调和情感上的灵活变化。凭借紧凑的体量、低成本和低延迟以及易于适配的特性,Voxtral TTS 为希望自主掌控语音 AI 技术栈的企业提供了完全的控制权和定制能力。
音频是新的用户体验。创造只有在语音中才能实现的协作与理解的新型交互。现在就在 AI Studio 中使用我们的美式、英式和法式口音的 Mistral Voices 开始吧。
听一听,再判断:你能分辨出区别吗?
我们的团队会说几十种语言和多种方言,我们理解文化细微差异的重要性,并构建了一个反映我们自身的模型。语音生成通过类似真人的节奏、情感乃至幽默的运用来建立信任。因此,在声音仿真上,我们专注于真实感和情感表现力。
声音仿真
原始声音
Margaret
Model Behavior Architect
英语(美国)
▶ https://mistral.ai/audio/tts/emulation/margaret/Margaret_american.wav
仿真
提示
哇哦!我对夏天太期待了。这里会非常暖和,迫不及待想去 Lido 游泳,还要做樱桃派。
提供方 1
本音频由以下生成
提供方 2
本音频由以下生成
胜率(声音定制)
68.4%
31.6%
听者平均偏好
Voxtral TTS
ElevenLabs
业界领先的性能。
对于多语言文本转语音系统,词错误率和音频质量评分等自动化指标无法衡量语音的自然度。让语音听起来自然的因素极其微妙,需要深入理解文化差异和典型的说话模式。因此,由母语者进行的对比人工评测至关重要。
对语音智能体而言,延迟与质量始终处于拉扯之中。人工评测显示,Voxtral TTS 的自然度优于 ElevenLabs Flash v2.5,同时保持相近的首段音频时间(TTFA)。Voxtral 的质量也与 ElevenLabs v3 持平,并成功支持情感引导,让交互更加逼真。
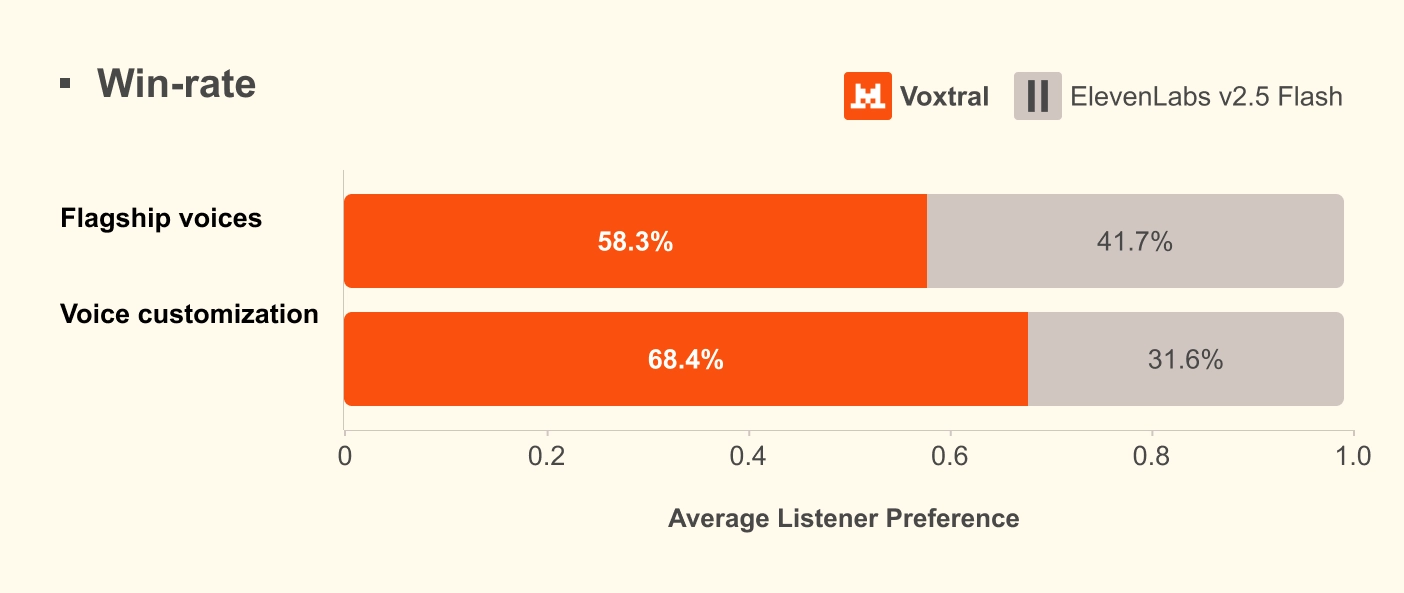
我们在零样本自定义声音场景下,对 Voxtral TTS 和 ElevenLabs v2.5 Flash 进行了对比人工评测。针对所支持的 9 种语言,每种语言选取两个以其母语方言说话的辨识度高的声音,由 3 名标注员对每一对进行并排偏好测试,维度包括自然度、口音贴合度以及与原始参考音频的声学相似度。在这一零样本多语言自定义声音场景中,Voxtral TTS 相对 v2.5 Flash 的质量差距进一步拉大,凸显了 Voxtral TTS 对任意声音的即时可定制性。
母语般的表达。
Voxtral TTS 在大规模语音数据集上训练,面向全球应用而构建。它在 9 种语言上达到业界领先的性能:英语、法语、德语、西班牙语、荷兰语、葡萄牙语、意大利语、印地语和阿拉伯语。
该模型经过训练,仅需短至 3 秒的参考音频就能适配自定义声音,不仅能捕捉声音本身,还能捕捉细微的口音、抑扬变化、语调,甚至与参考音频类似的不流利之处。我们在 API 中提供了一些预设声音选项,但也很容易扩展到你自己的内部声音库,按用例进行定制:适配语言和口音,保持中性或更富情感,随意或正式,更自然、更口语化,或更机械。
尽管并未专门针对此训练,该模型还展现出零样本跨语言声音适配的能力。例如,给定法语声音提示和英文文本,模型可以生成英语语音。生成的语音听起来自然,同时带有所给声音提示的口音(在这个例子中,生成的是带有自然法语口音的英语)。这使该模型适用于构建级联式语音到语音翻译系统。
级联式语音到语音翻译
点击一位说话人,运行级联式语音到语音翻译。
提示
开始之前,我需要核实几项信息。请问您能确认一下您的全名和出生日期吗?
生成的音频
Voxtral TTS
▶ https://mistral.ai/audio/tts/demo/paul/en.mp3
为低延迟流式输出而构建。
延迟对语音智能体应用至关重要。对于典型的 10 秒、500 字符的输入声音样本,Voxtral TTS 的模型延迟为 70ms,实时因子(RTF)约为 9.7 倍。该模型原生可生成最长两分钟的音频,我们的 API 则通过智能交错处理任意长度的生成。
Voxtral TTS 架构。
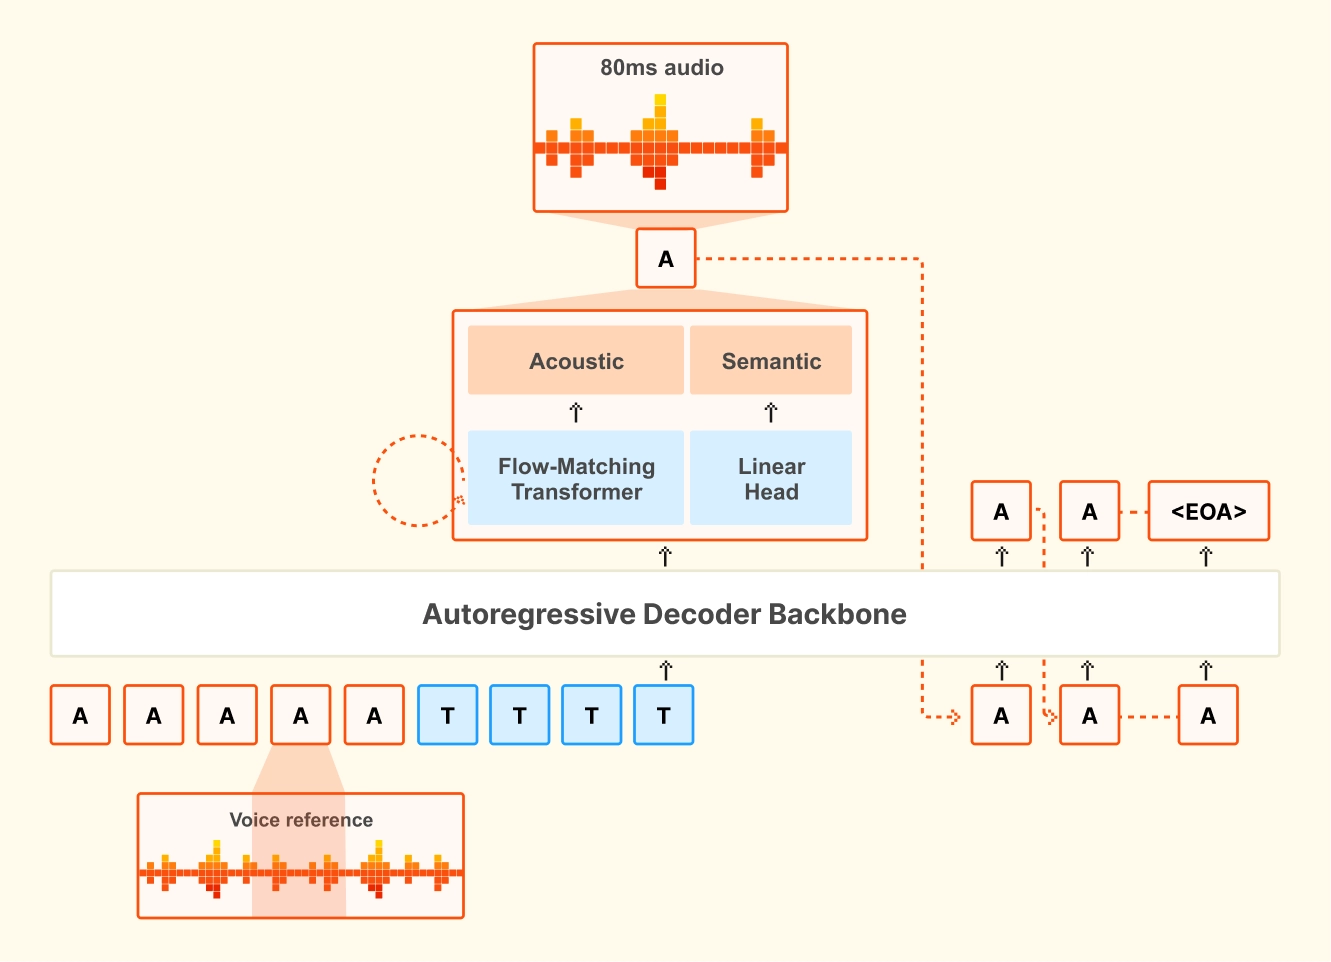
该模型是基于 Transformer 的自回归流匹配模型,构建于 Ministral 3B 之上。它由以下组件构成:
- 34 亿参数的 Transformer 解码器骨干网络
- 3.9 亿参数的流匹配声学 Transformer
- 3 亿参数的神经音频编解码器(对称的编码器—解码器)
模型接收一段声音提示(5 到 25 秒)和一段 9 种受支持语言之一的文本提示。对于每个音频帧,Transformer 骨干网络先预测一个语义词元,随后流匹配 Transformer 执行 16 次函数评估(NFE)来生成声学隐变量。
我们开发了自研编解码器,它以因果方式处理音频,使用语义 VQ(词表大小 8192)和声学 FSQ(36 维、21 级)隐变量,并以 12.5Hz 的帧率生成它们。
为企业语音工作流提供支撑。
Voxtral TTS 补全了音频智能的闭环,为企业语音管道提供了一个能通过人耳检验的输出层。它可与 Voxtral Transcribe 配合实现完整的语音到语音,也可集成到任何现有的语音转文本和 LLM 技术栈中,并支持跨语言。
工作流
客户支持
语音智能体可以用自然、符合品牌调性的语音,在各渠道间分流并解决问题。把 Voxtral TTS 接入现有的客服呼叫系统,即可实现自动语音应答,输出可融入现有工作流。
▶ https://mistral.ai/audio/tts/workflows/support.mp3
感谢您联系客服。我了解到您对 3 月 22 日那笔意外扣款有疑虑。让我调出您的账户详情。啊,是的,这似乎是您申请的订阅升级所产生的临时冻结。您希望我取消这笔冻结,还是调整您的套餐?您的来电对我们很重要,所以我会一直在线,直到问题解决。
Jane
▶ https://www.youtube.com/watch?v=SpLRS7Q3fIk
在 Mistral Studio 中试运行该模型。
直接在 Mistral Studio 试验场中体验 Voxtral TTS。选择一个 Mistral 声音,或录制你自己的声音。
▶ https://www.youtube.com/watch?v=DffzOI3g8Yk
开始使用 Voxtral TTS。
Voxtral TTS 现已通过 API 提供,价格为每 1k 字符 $0.016。
现在就在 Mistral Studio 或 Le Chat 中试用。
带有若干参考声音的模型已作为开放权重发布在 Hugging Face 上,采用 CC BY NC 4.0 许可证。
报名参加我们即将举行的网络研讨会,了解更多!
我们在招人!
我们正在构建 AI 的语音层,如果这正是你想解决的问题,欢迎与我们联系。
Voxtral TTS
CC BY-NC 4.0
使用参考声音生成语音。
声音
音频生成
$0.016
每 1k 字符
可用于
/v1/audio/speech