过去十年间,网页每年都在变得更重,增幅在 6% 到 9% 之间,原因是网页越来越依赖框架、交互越来越丰富、媒体内容越来越多。这一趋势没有任何改变的迹象。真正在变的,是这些页面被重新构建的频率,以及请求它们的客户端数量。这两者都因为智能体而急剧攀升。
共享字典能缩减从服务器到浏览器的资源传输量,让页面加载更快,线路上的冗余更少,对回访用户或网速较慢的访客尤其如此。每次部署之后,浏览器不必再重新下载整个 JavaScript 包,而是告诉服务器自己已经缓存了什么,服务器只需发送文件之间的差异。
今天,我们很高兴为你抢先展示我们对共享压缩字典的支持,介绍我们在早期测试中看到的结果,并公布你何时可以亲自试用测试版(提示:2026 年 4 月 30 日!)。
问题:发布越多 = 缓存越少
智能体爬虫、浏览器和其他工具会反复访问各个端点,获取完整页面,往往只是为了提取其中一小段信息。2026 年 3 月,智能体类访问者占 Cloudflare 网络总请求数的比例略低于 10%1,同比增长约 60%。
每一个发布的页面都比去年更重,而被机器读取的频率也前所未有地高。但智能体不只是在消费网络,它们也在帮忙构建网络。AI 辅助开发意味着团队发布得更快。提高部署、实验和迭代的频率,对产品迭代速度是好事,对缓存却是灾难。
当智能体推送一行修复时,打包工具会重新分块,文件名随之改变,全球每个用户都可能重新下载整个应用。这并不是因为代码有什么实质性的不同,而是因为浏览器/客户端无从得知具体变了什么。它看到的是一个新 URL,于是从零开始。传统压缩有助于减小每次下载的体积,却解决不了冗余问题。它不知道客户端其实已经缓存了该文件的 95%。因此每一次部署、面向每一个用户、每一个机器人,都在一遍又一遍地发送冗余字节。如果你每天发布十个小改动,实际上就等于主动放弃了缓存。在硬件正迅速成为瓶颈的网络环境中,这会浪费带宽和 CPU。
要应对更多请求访问更重、部署更频繁的页面,压缩必须变得更聪明。
什么是共享字典?
压缩字典是服务器和客户端之间共享的一份参考,作用就像一张小抄。服务器不再从头压缩响应,而是说“文件的这一部分你已经知道了,因为你之前缓存过”,只发送新增的内容。客户端持有同样的参考,并在解压时用它重建完整的响应。字典能引用文件中的内容越多,传输给客户端的压缩输出就越小。
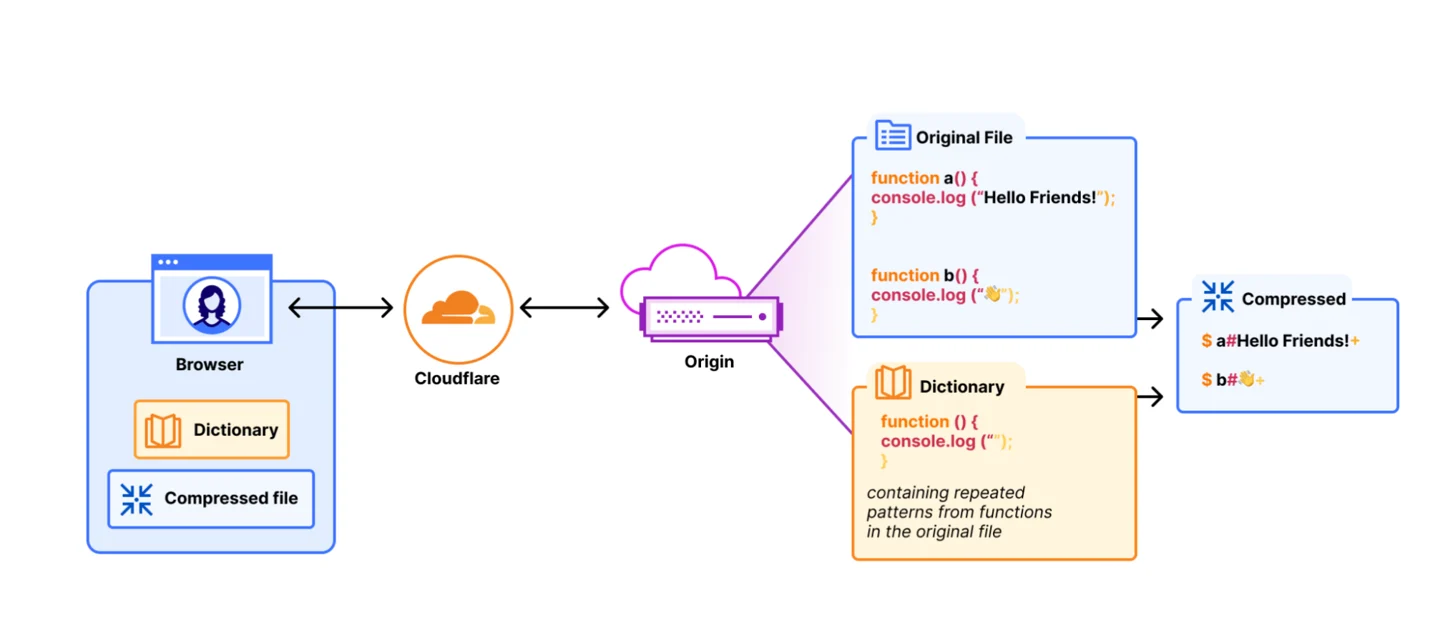
这种“对照已知内容进行压缩”的原则,正是现代压缩算法超越前代的关键。Brotli 自带一份内置字典,收录了 HTML 属性和常用短语等常见的网页模式;Zstandard 则专为自定义字典而设计:你可以喂给它具有代表性的内容样本,它会针对你所提供的内容类型生成一份优化字典。Gzip 两者皆无,只能在压缩过程中实时地发现模式来构建字典。这些“传统压缩”算法如今在 Cloudflare 上已经可用。
共享字典把这一原则又推进了一步:资源先前缓存的版本本身就成为字典。还记得那个部署难题吗——团队发布了一行修复,所有用户却要重新下载完整的包?有了共享字典,浏览器已经缓存了旧版本,服务器对照它进行压缩,只发送差异。一个 500KB 的包,只改动一行,在线路上就只剩几 KB。假设每天有 10 万用户、每天部署 10 次,这就是 500GB 传输量与几百 MB 之间的差别。
增量压缩
增量压缩(delta compression)能把浏览器已有的版本变成字典。协议的流程是:服务器首次提供某个资源时,会附带一个 Use-As-Dictionary 响应头,告诉浏览器基本上要把这个文件留着,因为以后会用到。浏览器下一次请求该资源时,会回传一个 Available-Dictionary 头,告诉服务器“这是我手上有的”。服务器随后对照旧版本压缩新版本,只发送差异。无需单独的字典文件。
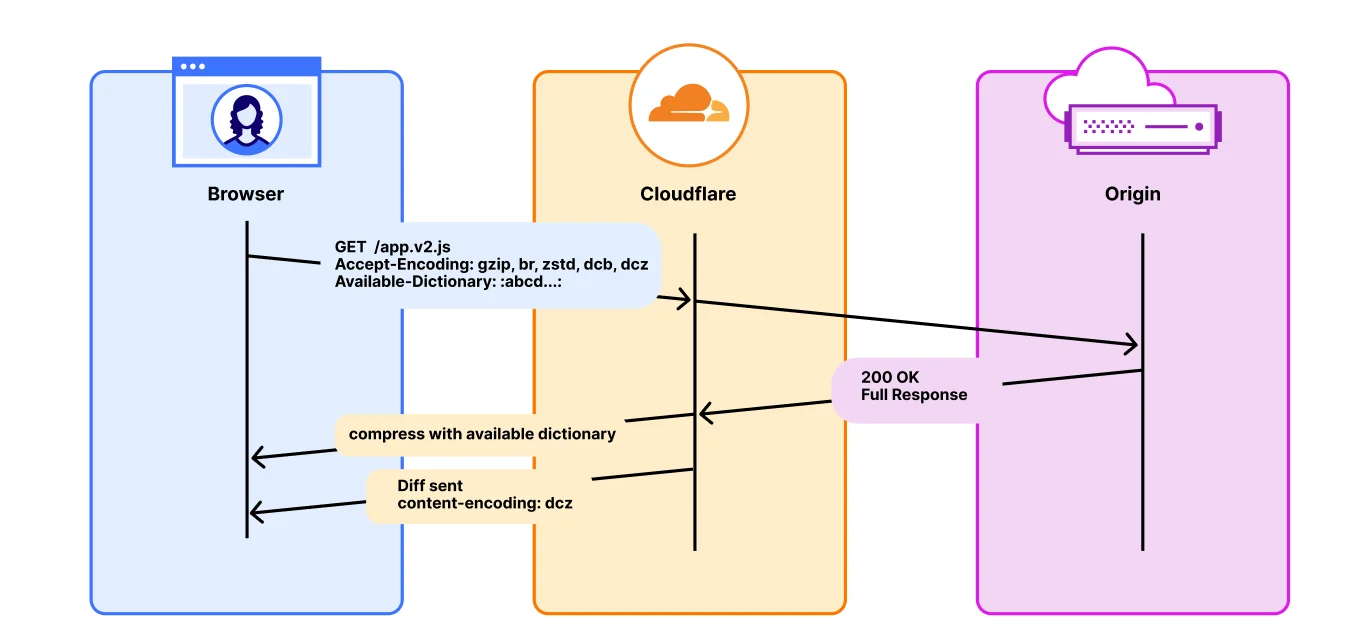
这对真实应用来说回报最大:带版本号的 JS 包、CSS 文件、框架更新,以及任何在版本之间增量变化的内容。浏览器已经缓存了 app.bundle.v1.js,开发者做了更新并部署了 app.bundle.v2.js。增量压缩只发送这两个版本之间的差异。此后的每个版本同样只是差异。第三版对照第二版压缩,第 47 版对照第 46 版压缩。节省的效果不会重置,而是贯穿整个发布历史持续存在。
社区中也在积极讨论针对非静态内容的自定义字典和动态字典。那是未来的工作,但意义重大。我们把它留到另一篇文章再谈。
那为什么等了这么久?
如果共享字典这么强大,为什么没有人早就普遍使用呢?
因为上一次尝试时,那套实现经受不住开放网络的考验。
2008 年,Google 在 Chrome 中推出了面向 HTTP 的共享字典压缩(SDCH)。它的效果很好,一些早期采用者报告页面加载时间改善了两位数百分比。但 SDCH 积累问题的速度,快过任何人修复的速度。
其中最令人印象深刻的是一类压缩旁路攻击(CRIME、BREACH)。研究人员表明,如果攻击者能在被压缩的敏感内容(如会话 cookie、令牌等)旁边注入内容,压缩输出的大小就可能泄露机密信息。攻击者可以一次猜一个字节,观察资源大小是否缩小,如此反复,直到提取出整个机密。
但安全并不是唯一的问题,甚至不是采用率没有起来的主因。SDCH 暴露出一些架构层面的问题,例如违反了同源策略(讽刺的是,这在一定程度上正是它性能出色的原因)。它的跨源字典模型无法与 CORS 调和,而且对于与 Cache API 等机制的交互,规范也有所欠缺。过了一段时间,人们逐渐明白采用的时机还不成熟,于是在 2017 年,Chrome(当时唯一支持它的浏览器)撤下了它。
让网络社区接过这根接力棒花了十年,但这是值得的。
现代标准 RFC 9842:Compression Dictionary Transport 弥补了让 SDCH 难以为继的关键设计缺陷。例如,它强制要求所公布的字典只能用于同源的响应,从而杜绝了许多使压缩旁路攻击成为可能的条件。
Chrome 和 Edge 已经推出支持,Firefox 也正在跟进。该标准正朝着广泛采用的方向推进,但完整的跨浏览器支持仍在追赶中。
RFC 缓解了安全问题,但字典传输的实现一直很复杂。源站可能需要生成字典,用正确的响应头提供它们,检查每个请求是否匹配 Available-Dictionary,即时对响应做增量压缩,并在客户端没有字典时优雅地回退。缓存也变得复杂。响应会同时随编码和字典哈希而变化,因此每个字典版本都会产生一个独立的缓存变体。在部署过程中,你会同时遇到持有旧字典的客户端、持有新字典的客户端,以及没有字典的客户端。你的缓存要为每种情况分别存储一份副本。命中率下降,存储量攀升,而字典本身还必须在常规 HTTP 缓存规则下保持新鲜。
这种复杂性是一个协调问题,恰恰属于应该放在边缘处理的那类事情。CDN 本来就位于每个请求的前面,本来就在管理压缩,也本来就在处理缓存变体(敬请关注,相关公告博文即将发布)。
Cloudflare 如何构建共享字典支持
共享字典压缩涉及从浏览器到源站之间技术栈的每一层。我们看到客户的兴趣很强:一些人已经构建了自己的实现,例如 RFC 作者 Patrick Meenan 的 dictionary-worker,它借助编译为 WASM 的 Zstandard,在 Cloudflare Worker 内运行完整的字典生命周期(仅作为一个例子)。我们希望让所有人都能用上它,并尽可能降低实现难度。因此,我们将分三个阶段在整个平台上推出,先从底层管道做起。
第一阶段:透传支持目前正在积极开发中。Cloudflare 会转发共享字典所需的标头和编码,例如 Use-As-Dictionary、Available-Dictionary,以及 dcb 和 dcz 内容编码,不会剥离、修改或重新压缩它们。缓存键也进行了扩展,会根据 Available-Dictionary 和 Accept-Encoding 区分变体,从而让字典压缩后的响应得到正确缓存。这一阶段服务于在源站自行管理字典的客户。
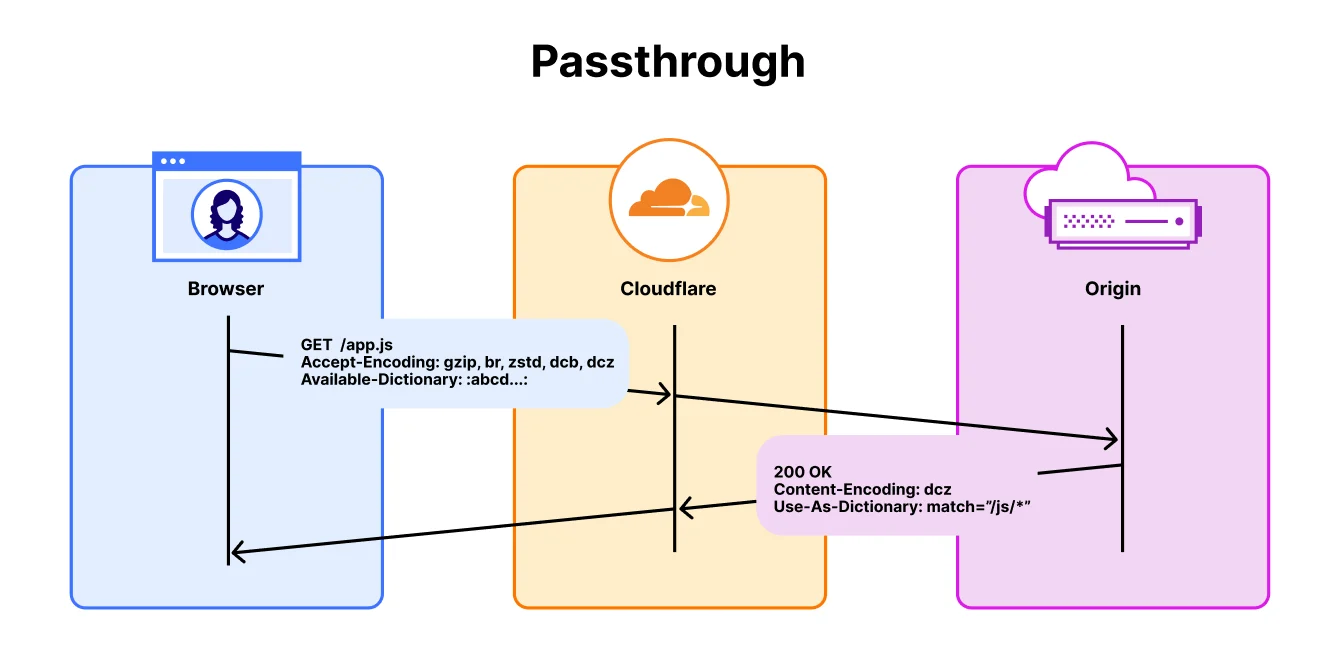
我们计划在 2026 年 4 月 30 日前推出第一阶段的公开测试版。要使用它,你需要使用已启用该功能的 Cloudflare 区域,源站需要以正确的标头提供字典压缩后的响应(Use-As-Dictionary、Content-Encoding: dcb 或 dcz、对 Accept-Encoding、Available-Dictionary 的 Vary),并且访客需要使用支持字典传输的浏览器。目前这意味着 Chrome 130+ 和 Edge 130+,Firefox 的支持正在推进中。
该功能上线时间以及更多使用文档,请持续关注我们的更新日志。
我们已经开始在内部测试透传。在一次受控测试中,我们依次部署了两个 js 包。它们几乎完全相同,只是两个版本之间有一些局部改动,代表同一个 Web 应用的连续两次部署。我们对位于加利福尼亚州圣何塞的 PoP 发起了 200 次测试,源站位于爱荷华州康瑟尔布拉夫斯,提供字典、JS 包以及经字典压缩的包(注意,dcz 压缩包是预先计算好的)。对每个请求,我们都通过 curl 记录了 TTFB 和总下载时间。
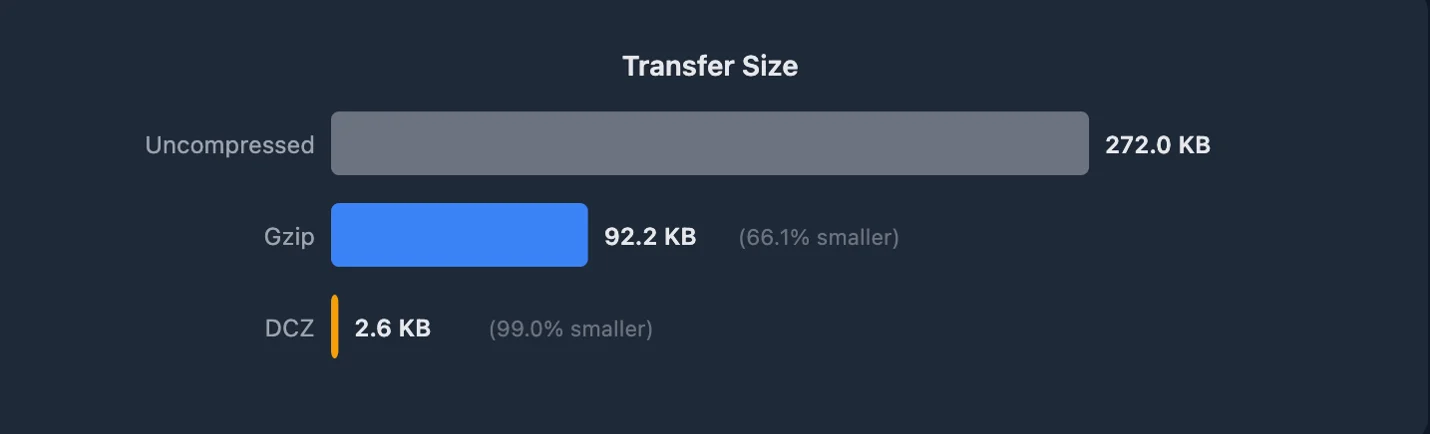
未压缩时,该资源大小为 272KB。Gzip 将其降到 92.2KB,减少了可观的 66%。使用基于 DCZ 的共享字典压缩,并以上一个版本作为字典后,同一资源降到了 2.6KB。相比未压缩的资源减少了 99%,比 gzip 还要小 97%。
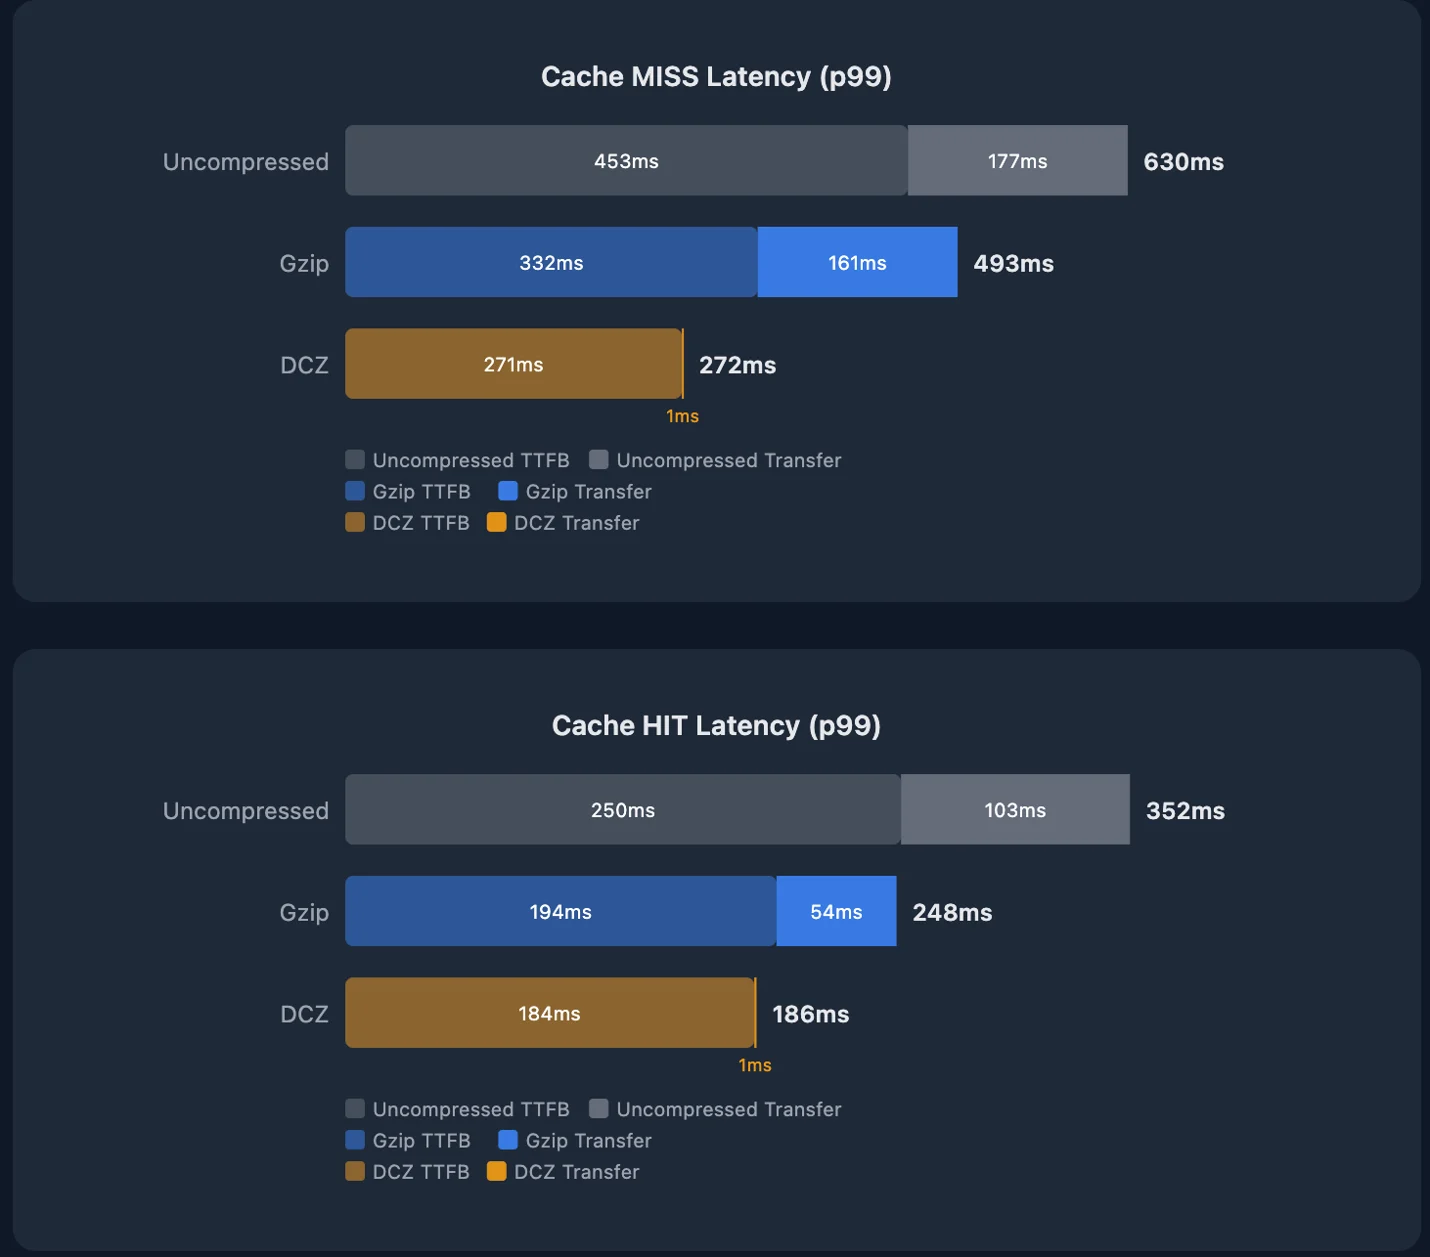
在同一次实验室测试中,我们从客户端测量了两个时间节点:首字节时间(TTFB)和完整下载完成时间。两者的时间差异十分明显。在缓存未命中的 P99 情况下,DCZ 的 TTFB 比 gzip 快约 60 ms。缓存命中时,TTFB 差距缩小到可以忽略的 10ms。
真正关键的是下载完成时间。图中的“Transfer”表示 curl 接收响应所花的总时间减去 TTFB。缓存未命中时,DCZ 响应的这一时间为 1ms,而 gzip 为 161ms(快 99.4%,响应体基本上与标头同时到达)。缓存命中时,为 1ms 对 54ms(快 98%)。两个版本之间的局部改动已经被字典涵盖,这正是关键所在:对于大致相同的应用的连续部署,共享字典几乎消除了所有冗余传输。
这是模拟极小 JS 包差异的初步实验室结果,实际结果会因字典与资源之间的实际差异而异。
第二阶段:从这一步开始,由 Cloudflare 替你完成工作。你不必再在源站处理字典标头、压缩和回退逻辑,而是在这一阶段通过规则告诉 Cloudflare 应将哪些资源用作字典,其余由我们代为管理。我们会注入 Use-As-Dictionary 标头、存储字典字节、针对旧版本对新版本做增量压缩,并为每个客户端提供合适的变体。你的源站只需提供正常的响应。所有与字典相关的复杂性都从你的基础设施转移到我们这边。
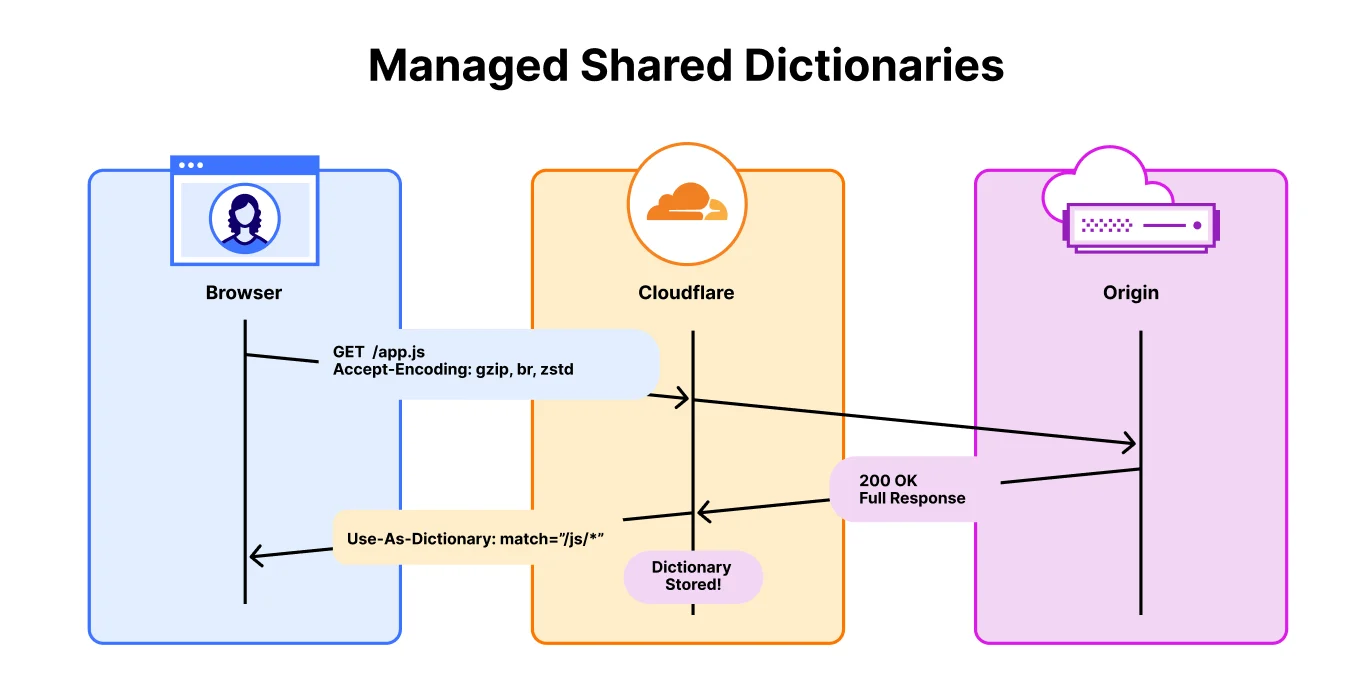
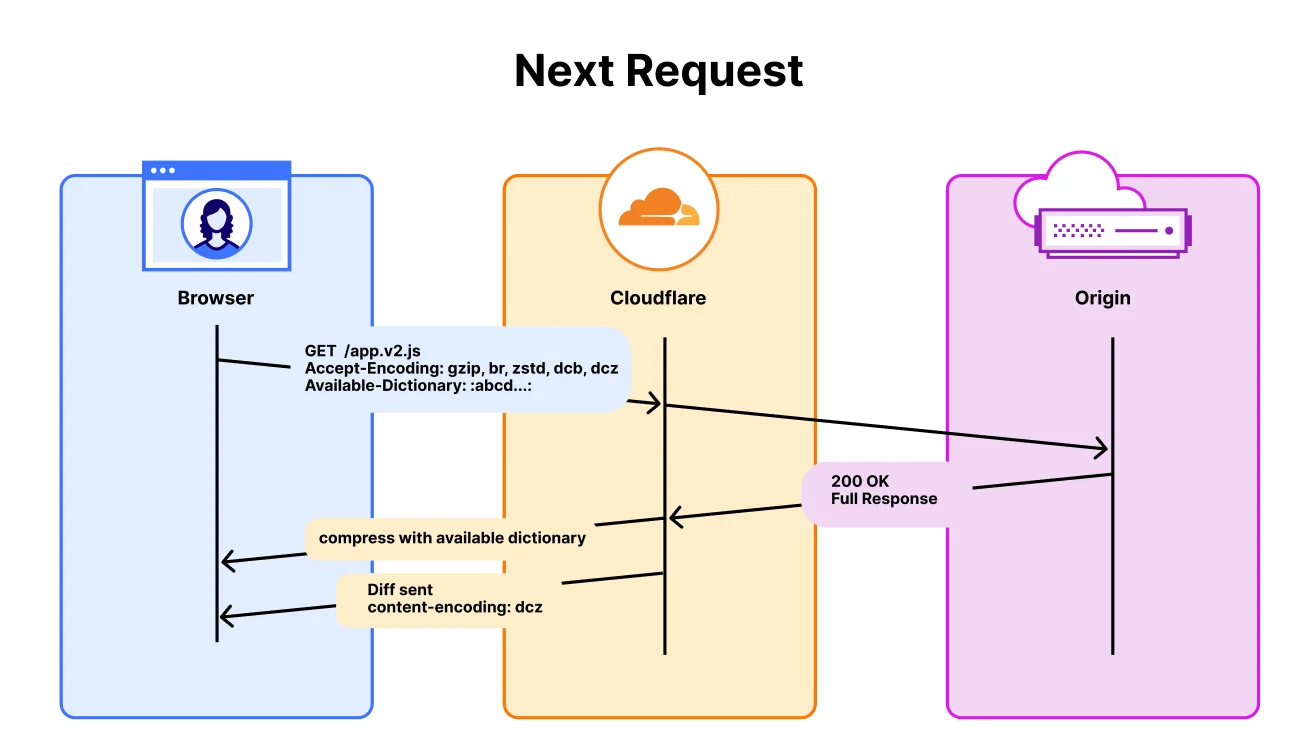
为了演示这一点,我们构建了一个在线演示,展示它在实践中的样子。在这里体验:Can I Compress (with Dictionaries)?
该演示每分钟部署一个约 94KB 的新 JavaScript 包,用来模拟典型的生产环境单页应用包。大部分代码在各次部署之间保持不变,每次只有一小块配置发生变化,这也反映了真实部署中大部分包是未变的框架和库代码的情形。第一个版本加载时,Cloudflare 的边缘节点会将其存为字典。下一次部署到来时,浏览器会发送它已有版本的哈希值,边缘节点则针对该版本对新包做增量压缩。结果是:94KB 被压缩到大约 450 字节。相比 gzip 减少了 99.5%,因为线路上传输的只有真正的差异部分。
演示站点包含逐步演练,你可以通过 curl、浏览器或你偏好的智能体自行验证压缩比。
第三阶段:字典由系统代网站自动生成。客户无需再指定哪些资源用作字典,而是由 Cloudflare 自动识别。我们的网络已经能看到流经其中的每一种资源的每一个版本,涵盖数百万个站点、数十亿次请求以及每一次新的部署。其思路是:当网络观察到某个 URL 模式下的连续响应大部分内容相同时,就有了强烈的信号,表明该资源适合做增量压缩。在安全的前提下,系统会将上一个版本存为字典,并针对它压缩后续版本。无需客户配置,也无需维护。
这个想法很简单,但确实很难。安全地生成不会泄露私有数据的字典,并识别出字典能带来最大收益的流量,都是真正的工程难题。不过 Cloudflare 具备合适的条件:我们能看到整个网络的流量模式,已经在管理字典所需存放的缓存层,而且我们向客户端提供的 RUM 信标可以提供一个验证闭环,在我们正式投入使用之前确认字典确实能改善压缩效果。流量可见性、边缘存储和合成测试三者结合,使自动生成成为可能,不过仍有许多环节有待摸索。
第三阶段带来的性能和带宽收益,是我们的核心动力所在。正是它让所有使用 Cloudflare 的用户都能用上共享字典,包括数以百万计原本没有工程资源去手动实现自定义字典的区域。
更大的图景
在 Web 的大部分历史中,压缩都是无状态的。每个响应的压缩都像是客户端从未见过任何东西一样。共享字典改变了这一点:它让压缩拥有了记忆。
这一点在今天比五年前更重要。智能体编码工具正在缩短两次部署之间的间隔,同时也带来越来越多消耗这些部署的流量。虽然如今 AI 工具可能产生大规模的 diff,但智能体正在获得更多上下文,改动代码也越来越精准。再加上更频繁的发布和更多自动化客户端,意味着每个请求中都有更多冗余字节。增量压缩从两方面同时受益:既减少了每次传输的字节数,也减少了需要发生的传输次数。
共享字典花了几十年才完成标准化。Cloudflare 正在帮助构建基础设施,让它对所有访问你站点的客户端都能奏效,无论是人还是非人。第一阶段的测试将于 4 月 30 日开启,期待你来试用。
_____
1Bots = 占所有 HTTP 请求的 ~31.3%。AI = 约占所有 Bot 流量的 29-30%(2026 年 3 月)。