摘要
GPT-5.6 Sol 在单次尝试质量上略胜 Kimi K3,但 Kimi 在 k > 1 的 pass@k 上胜出,每完成一项任务的成本还低 64%。两个模型成功和失败的方式各不相同,因此在二者之间做路由是这个基准测试上最强的策略。
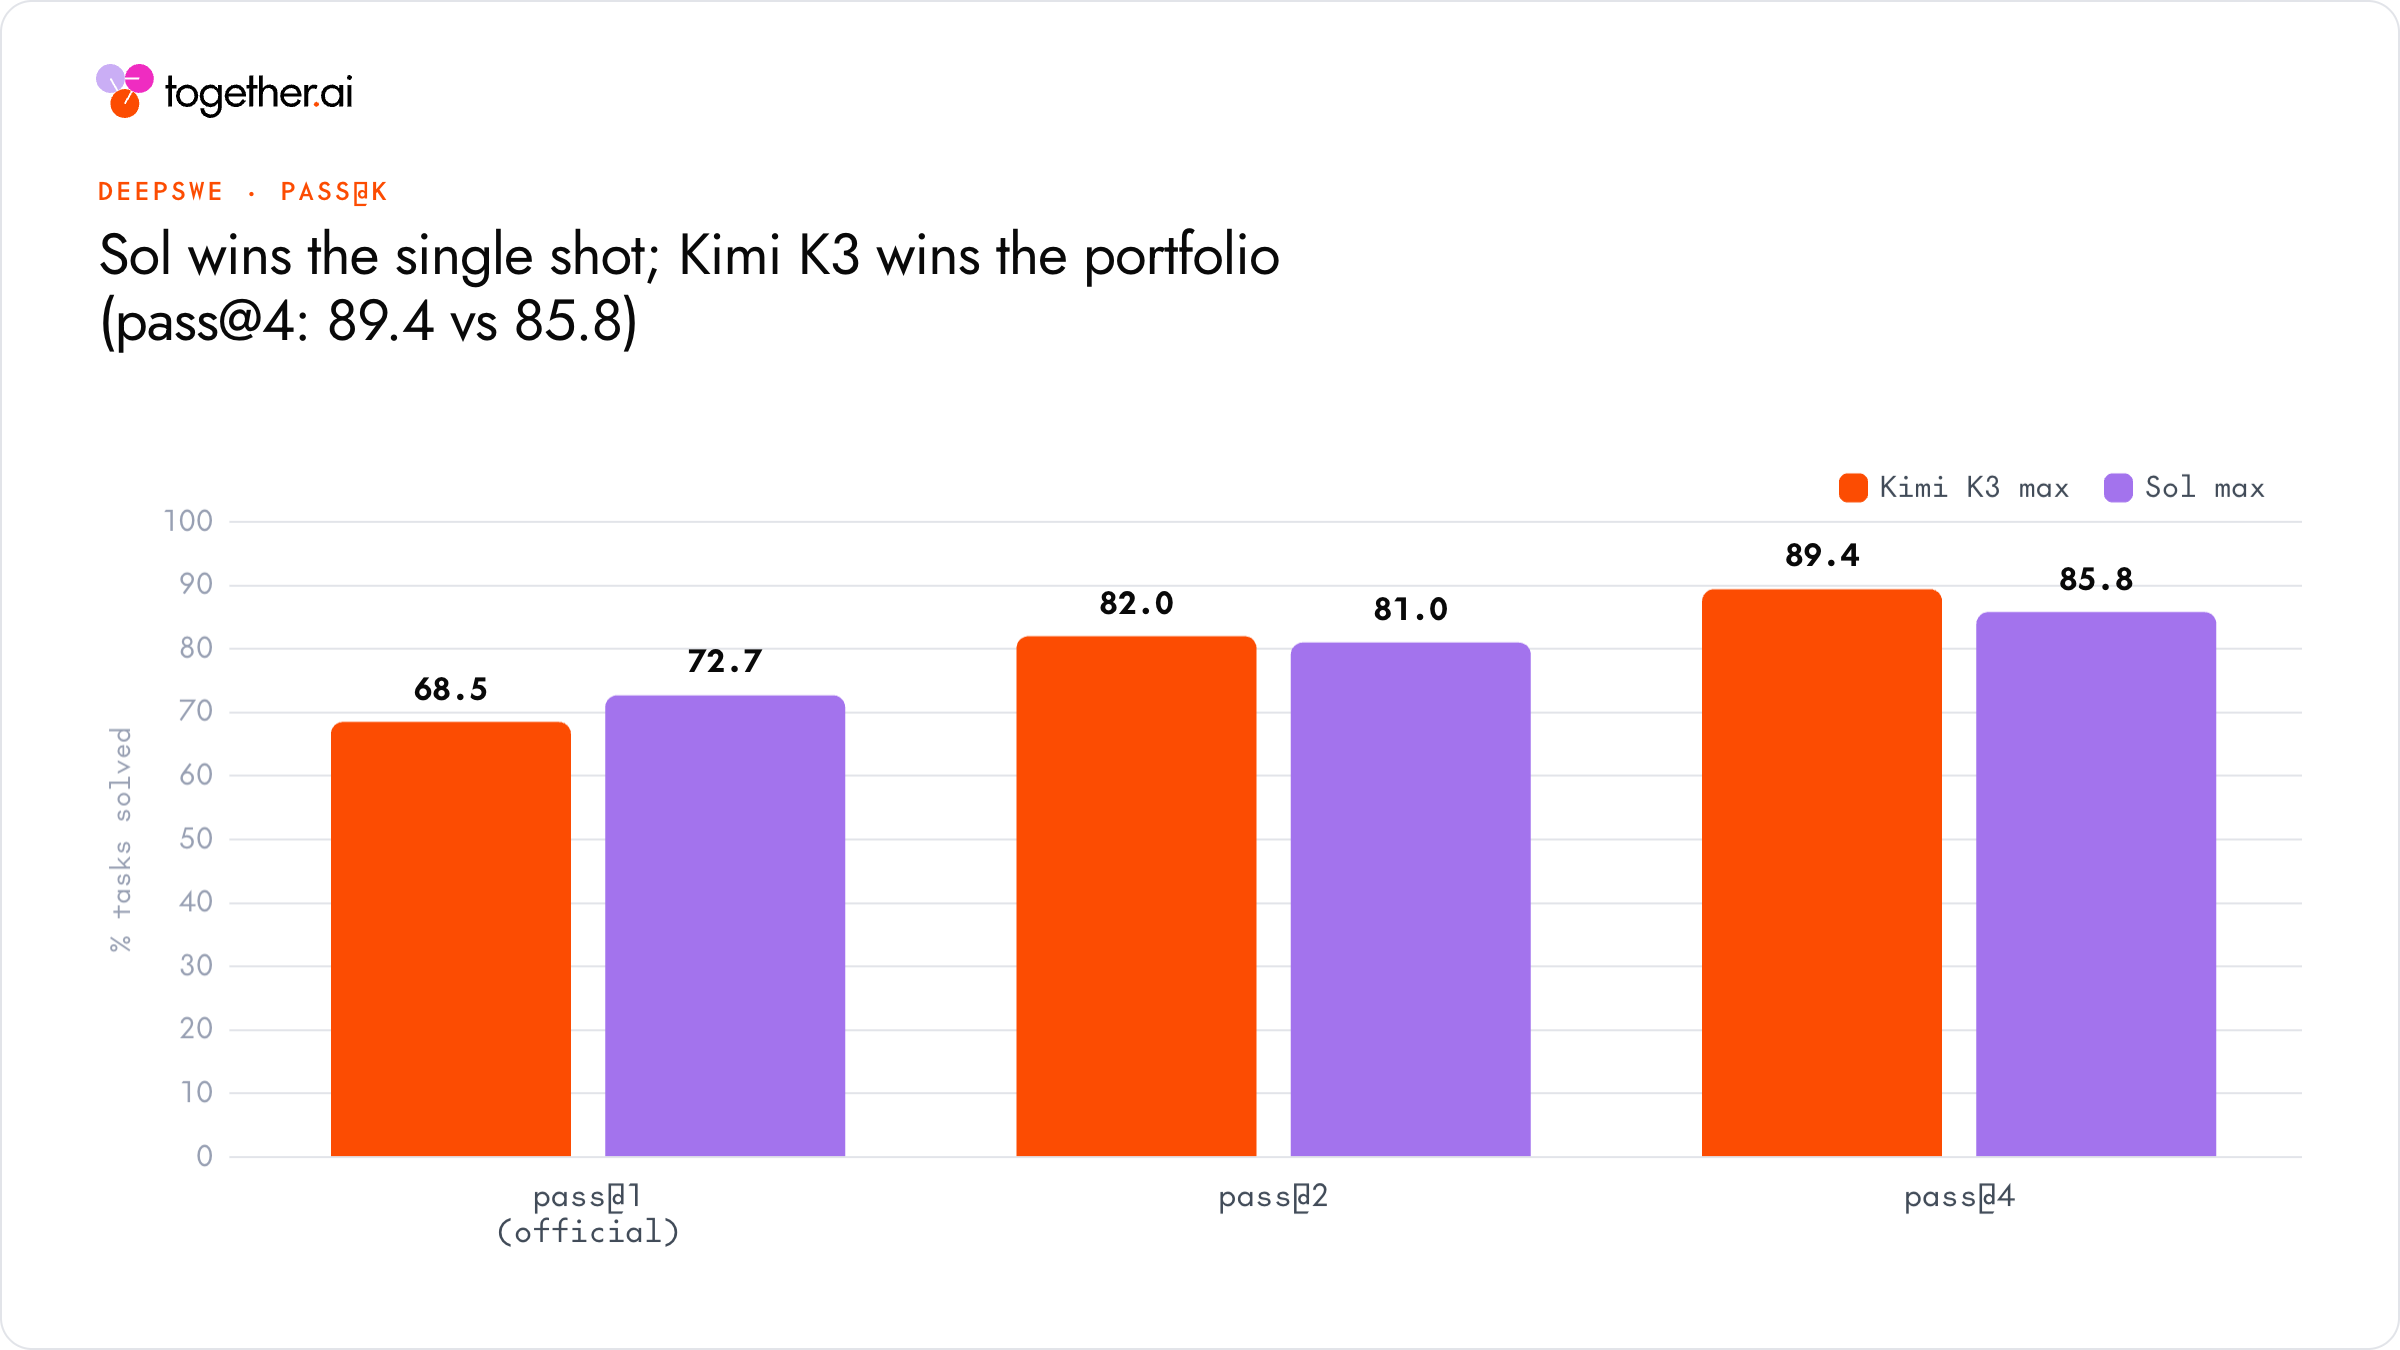
- Kimi K3 与 GPT-5.6 Sol 在 DeepSWE pass@1 上相差不大:Sol 以 72.7% 对 68.5% 领先,差距 4.2 个百分点。
- 给模型更多尝试机会,Kimi K3 就会反超。它赢下了 pass@2(82.0 对 81.0)和 pass@4(89.4% 对 85.8%)。
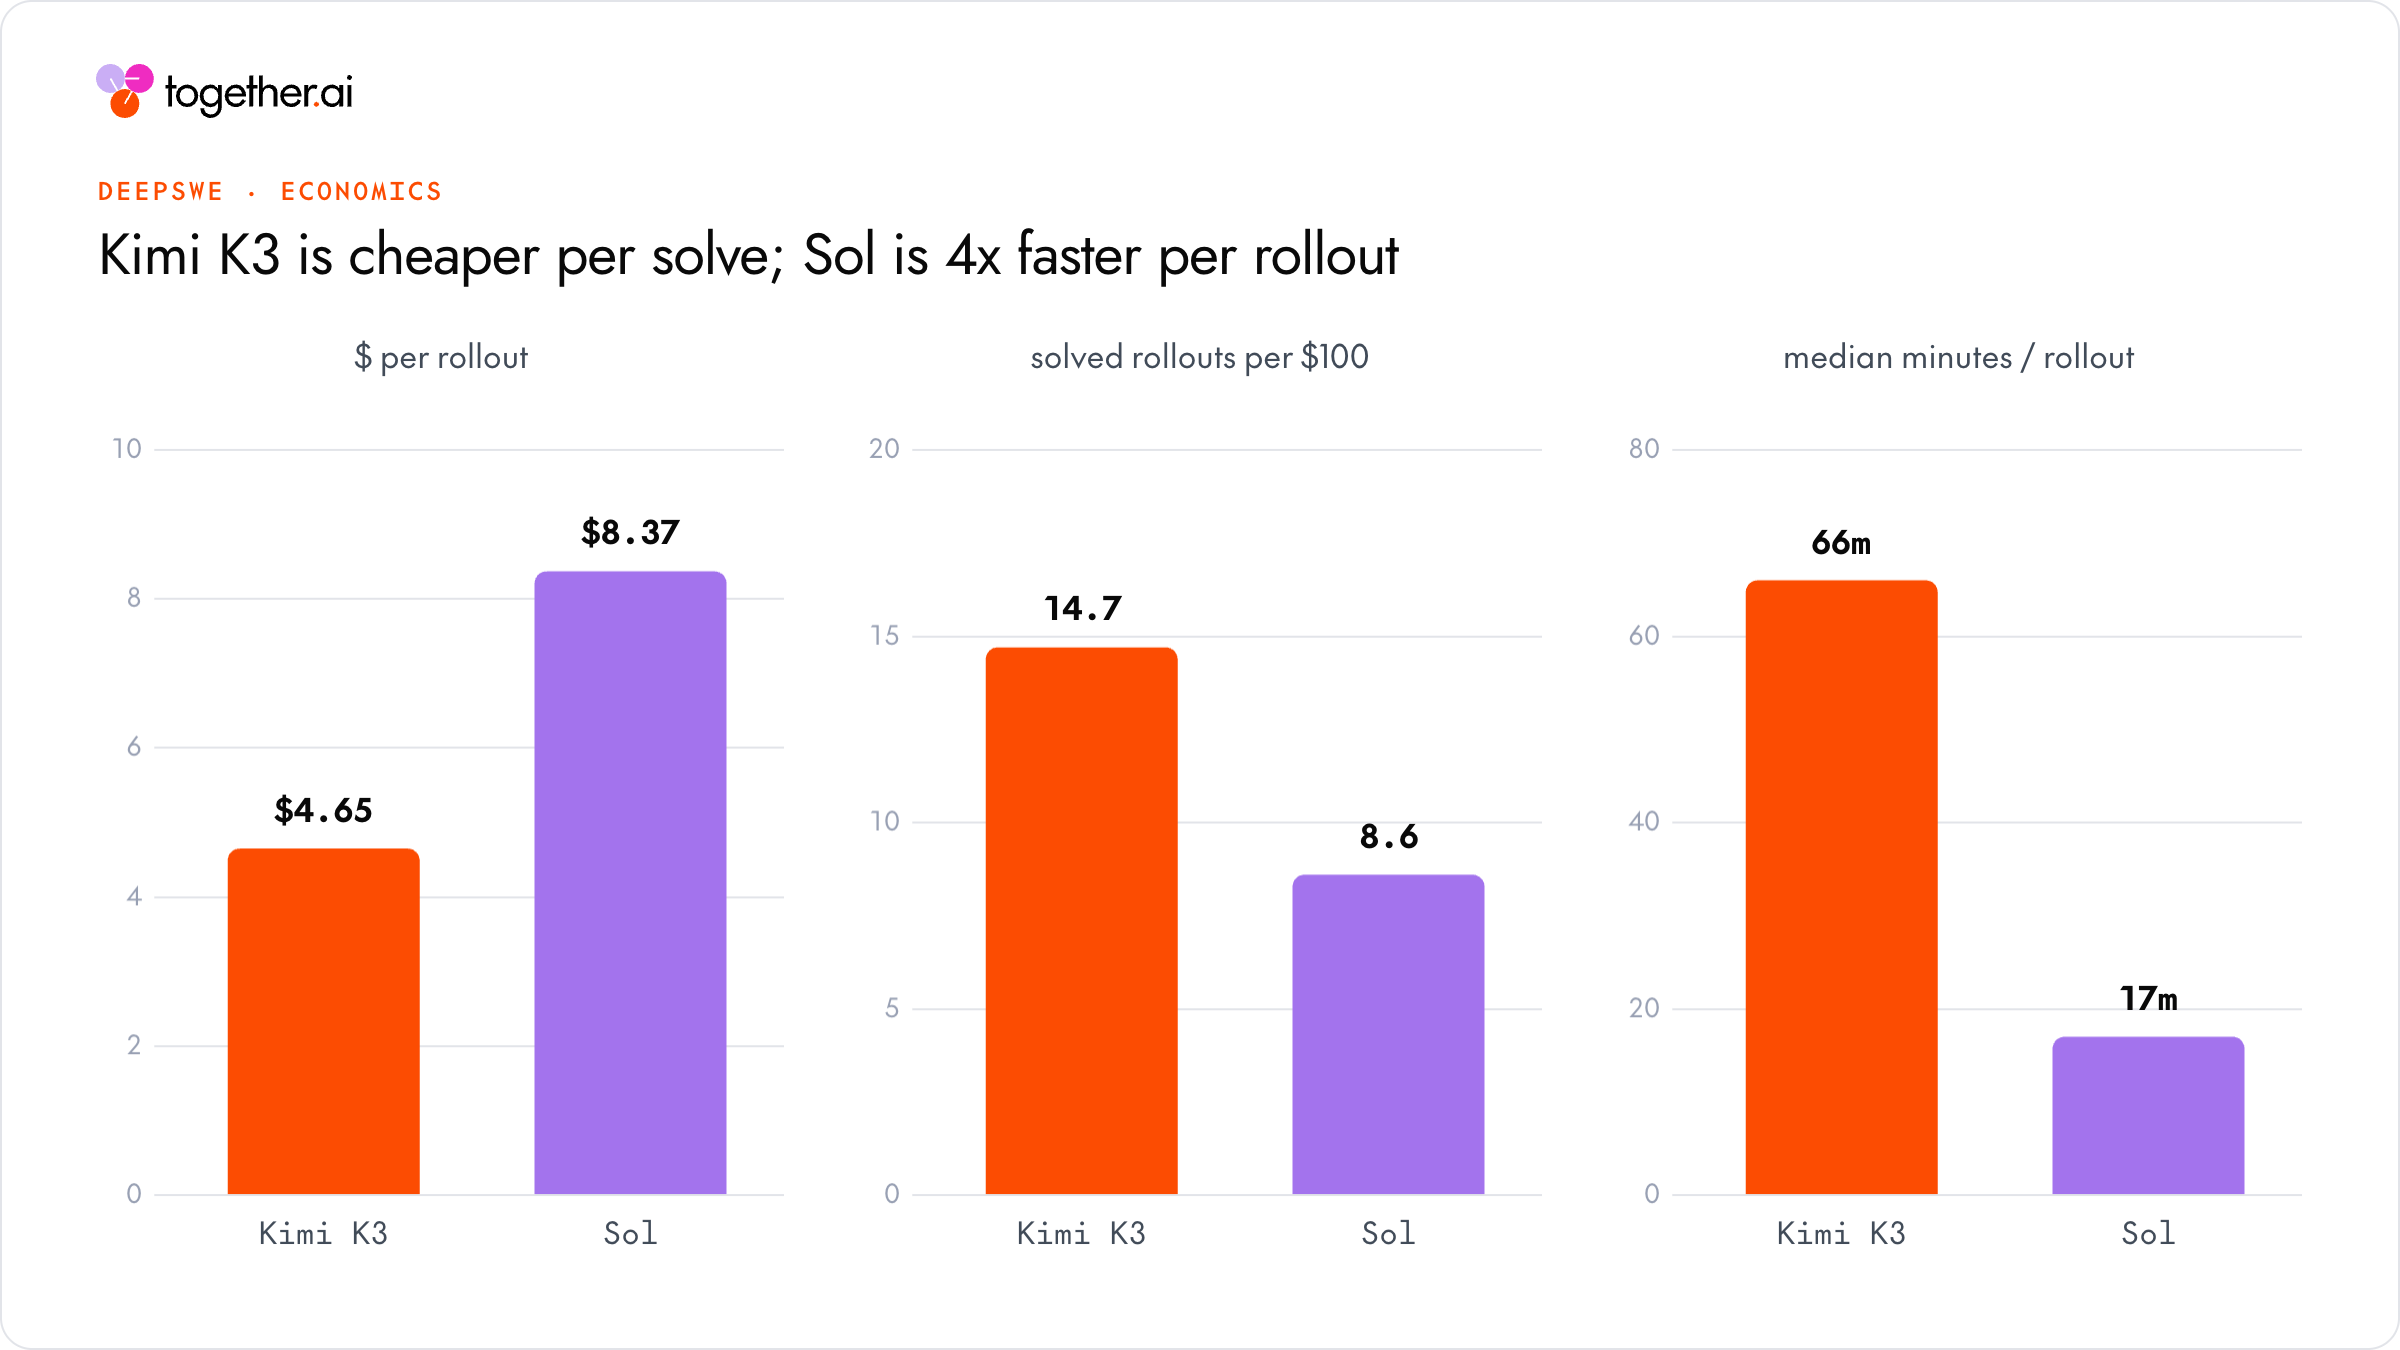
- Kimi K3 便宜得多:每次 rollout 成本为 \$4.65,而 Sol 为 \$8.37,每美元解决的任务数是 Sol 的 2.8 倍。
- GPT-5.6 Sol 是更可靠的模型:它在 4 次尝试全部成功的任务更多(61 对 45)。
- 两个模型的表现存在分歧(在哪些任务做对、做错上,相关系数为 0.46),失败方式也不同,因此“先用 Kimi、失败再升级到 Sol”的级联方案可覆盖 113 个任务中的 108 个,达到约 85.6%。
现已上线
在 Together AI 上运行 Kimi K3
完整 1M 上下文,自动前缀缓存,兼容 OpenAI 的 API,由美国基础设施提供服务。
打开 Playground
DeepSWE · 正面对比
Kimi K3 与 GPT-5.6 Sol 一览
| 指标 | Kimi K3 | GPT-5.6 Sol |
|---|---|---|
| DeepSWE pass@1 | 68.5% | 72.7% |
| DeepSWE pass@2 | 82.0% | 81.0% |
| DeepSWE pass@4 | 89.4% | 85.8% |
| 覆盖率(至少解决一次) | 89.4% | 85.8% |
| 可靠性(4/4 通过率) | 76.6% | 84.5% |
| 四次全部解决的任务数 | 45 | 61 |
| 每次 rollout 成本 | $4.65 | $8.37 |
| 每 $100 解决的任务数 | 14.7 | 5.3 |
| rollout 耗时中位数 | 66 分钟 | 17 分钟 |
| 开放权重 | 是 | 否 |
在我们对 Kimi K3 与 GPT-5.6 Sol 的 DeepSWE 对比中(DeepSWE 是一个跨多种任务类型和编程语言、考察模型软件工程能力的基准测试),关键并不在于谁坐上榜首。两周前,GPT-5.6 Sol 以 DeepSWE 官方评分下的 72.7% 摘得 pass@1 桂冠,这是该基准测试上有记录以来最强的单次尝试成绩和最高的可靠性。而开放权重的新晋选手 Kimi K3 则在另一条轴线上给出回应:pass@4 达到 89.4%,优于榜单上的所有旗舰模型(包括 Sol),而每次 rollout 成本仅 \$4.65,Sol 为 \$8.37。我们分析了 deepswe.datacurve.ai 上公布的逐次试验记录中全部 904 次已评分的 rollout(113 个任务,每个任务四次试验,双方均使用最高推理强度)。
DeepSWE 排行榜:pass@1 与 pass@k
只给一次尝试时,Sol 明显领先:在 DeepSWE 官方评分下为 72.7% 对 68.5%。但差距缩小得很快。两次尝试时 Kimi K3 已经领先,82.0 对 81.0。四次尝试时,Kimi 的 89.4% 比 Sol 的 85.8% 高出 3.6 个百分点,是榜单上所有旗舰级配置中最好的 pass@4。
成本对比:Kimi K3 与 GPT-5.6 Sol 定价
- Kimi K3:每次 rollout \$4.65。GPT-5.6 Sol:\$8.37。
- 按每个已解决任务计算,Kimi 每 \$100 可解决 14.7 个任务,Sol 为 5.3 个,每美元完成的工作量约为 Sol 的 2.8 倍。
- 代价是速度和步数:Sol 的 rollout 耗时中位数为 17 分钟,而 Kimi 为 66 分钟(截至 7 月 25 日使用 Moonshot 的 Kimi K3 API),Sol 使用的步数大约少 40%。随着推理服务商对 Kimi K3 的优化,端到端延迟应会改善,不过多出来的步数是模型自身的行为特征。
按编程语言对比 Kimi K3 与 GPT-5.6 Sol
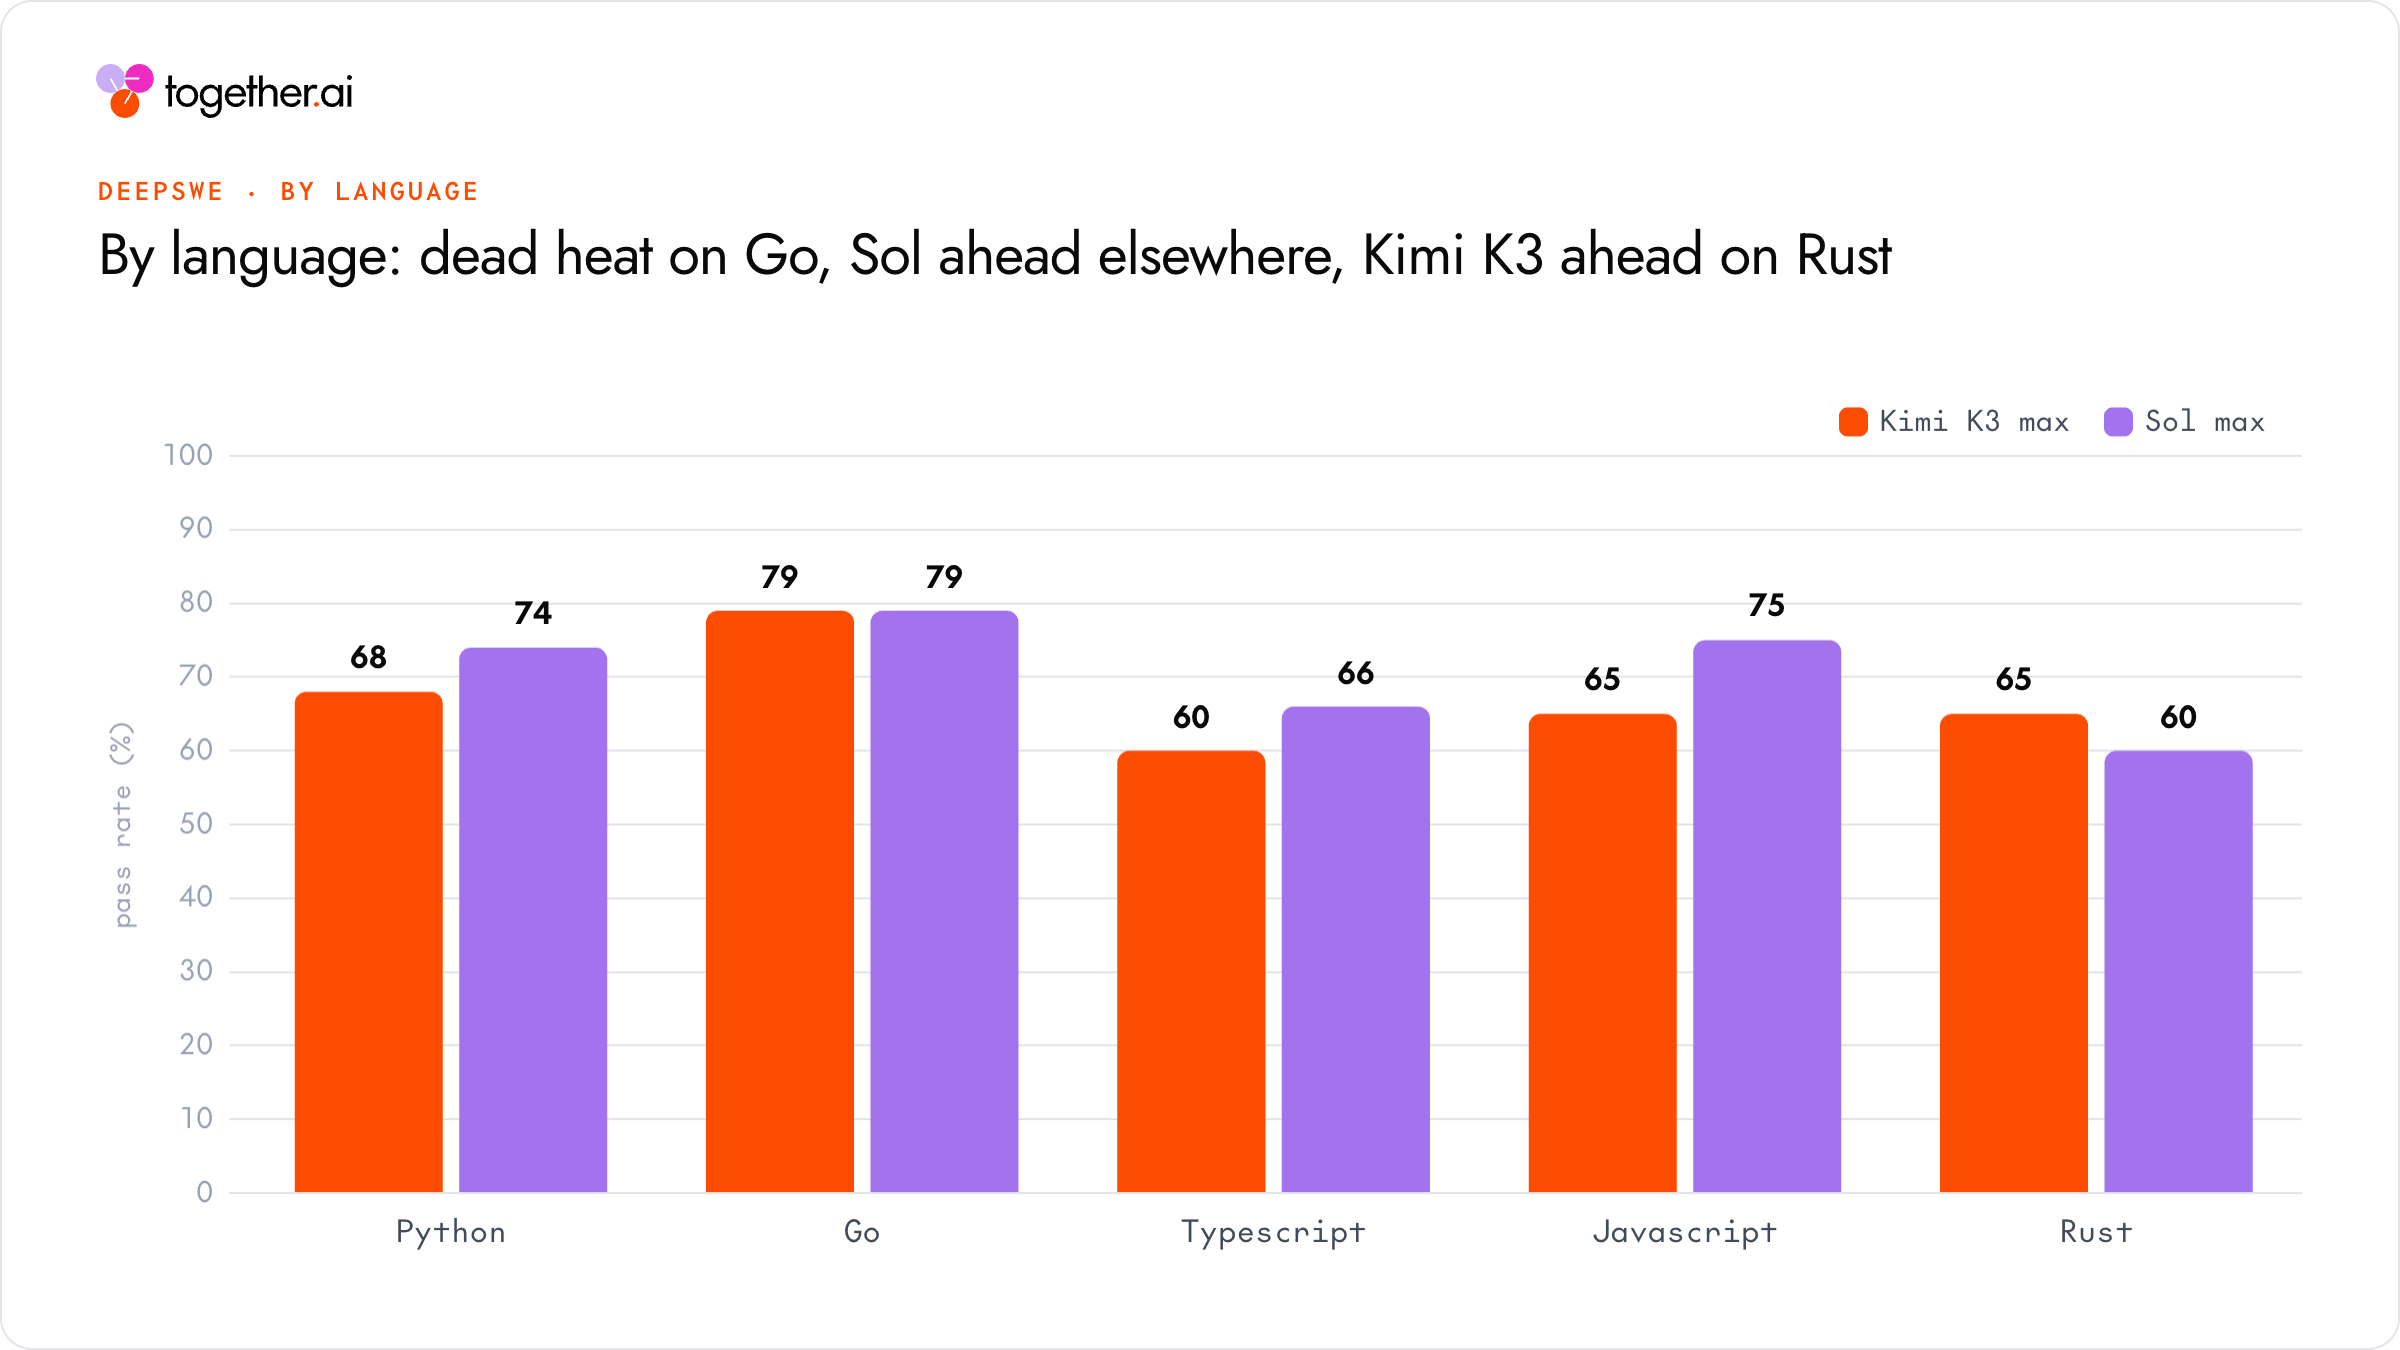
两者在 Go 上持平(各 79)。Sol 在 Python(74 对 68)、TypeScript(66 对 60)和 JavaScript(75 对 65)上领先。Kimi K3 在 Rust 上胜出(65 对 60)。
覆盖率与可靠性:平面上的两个对角
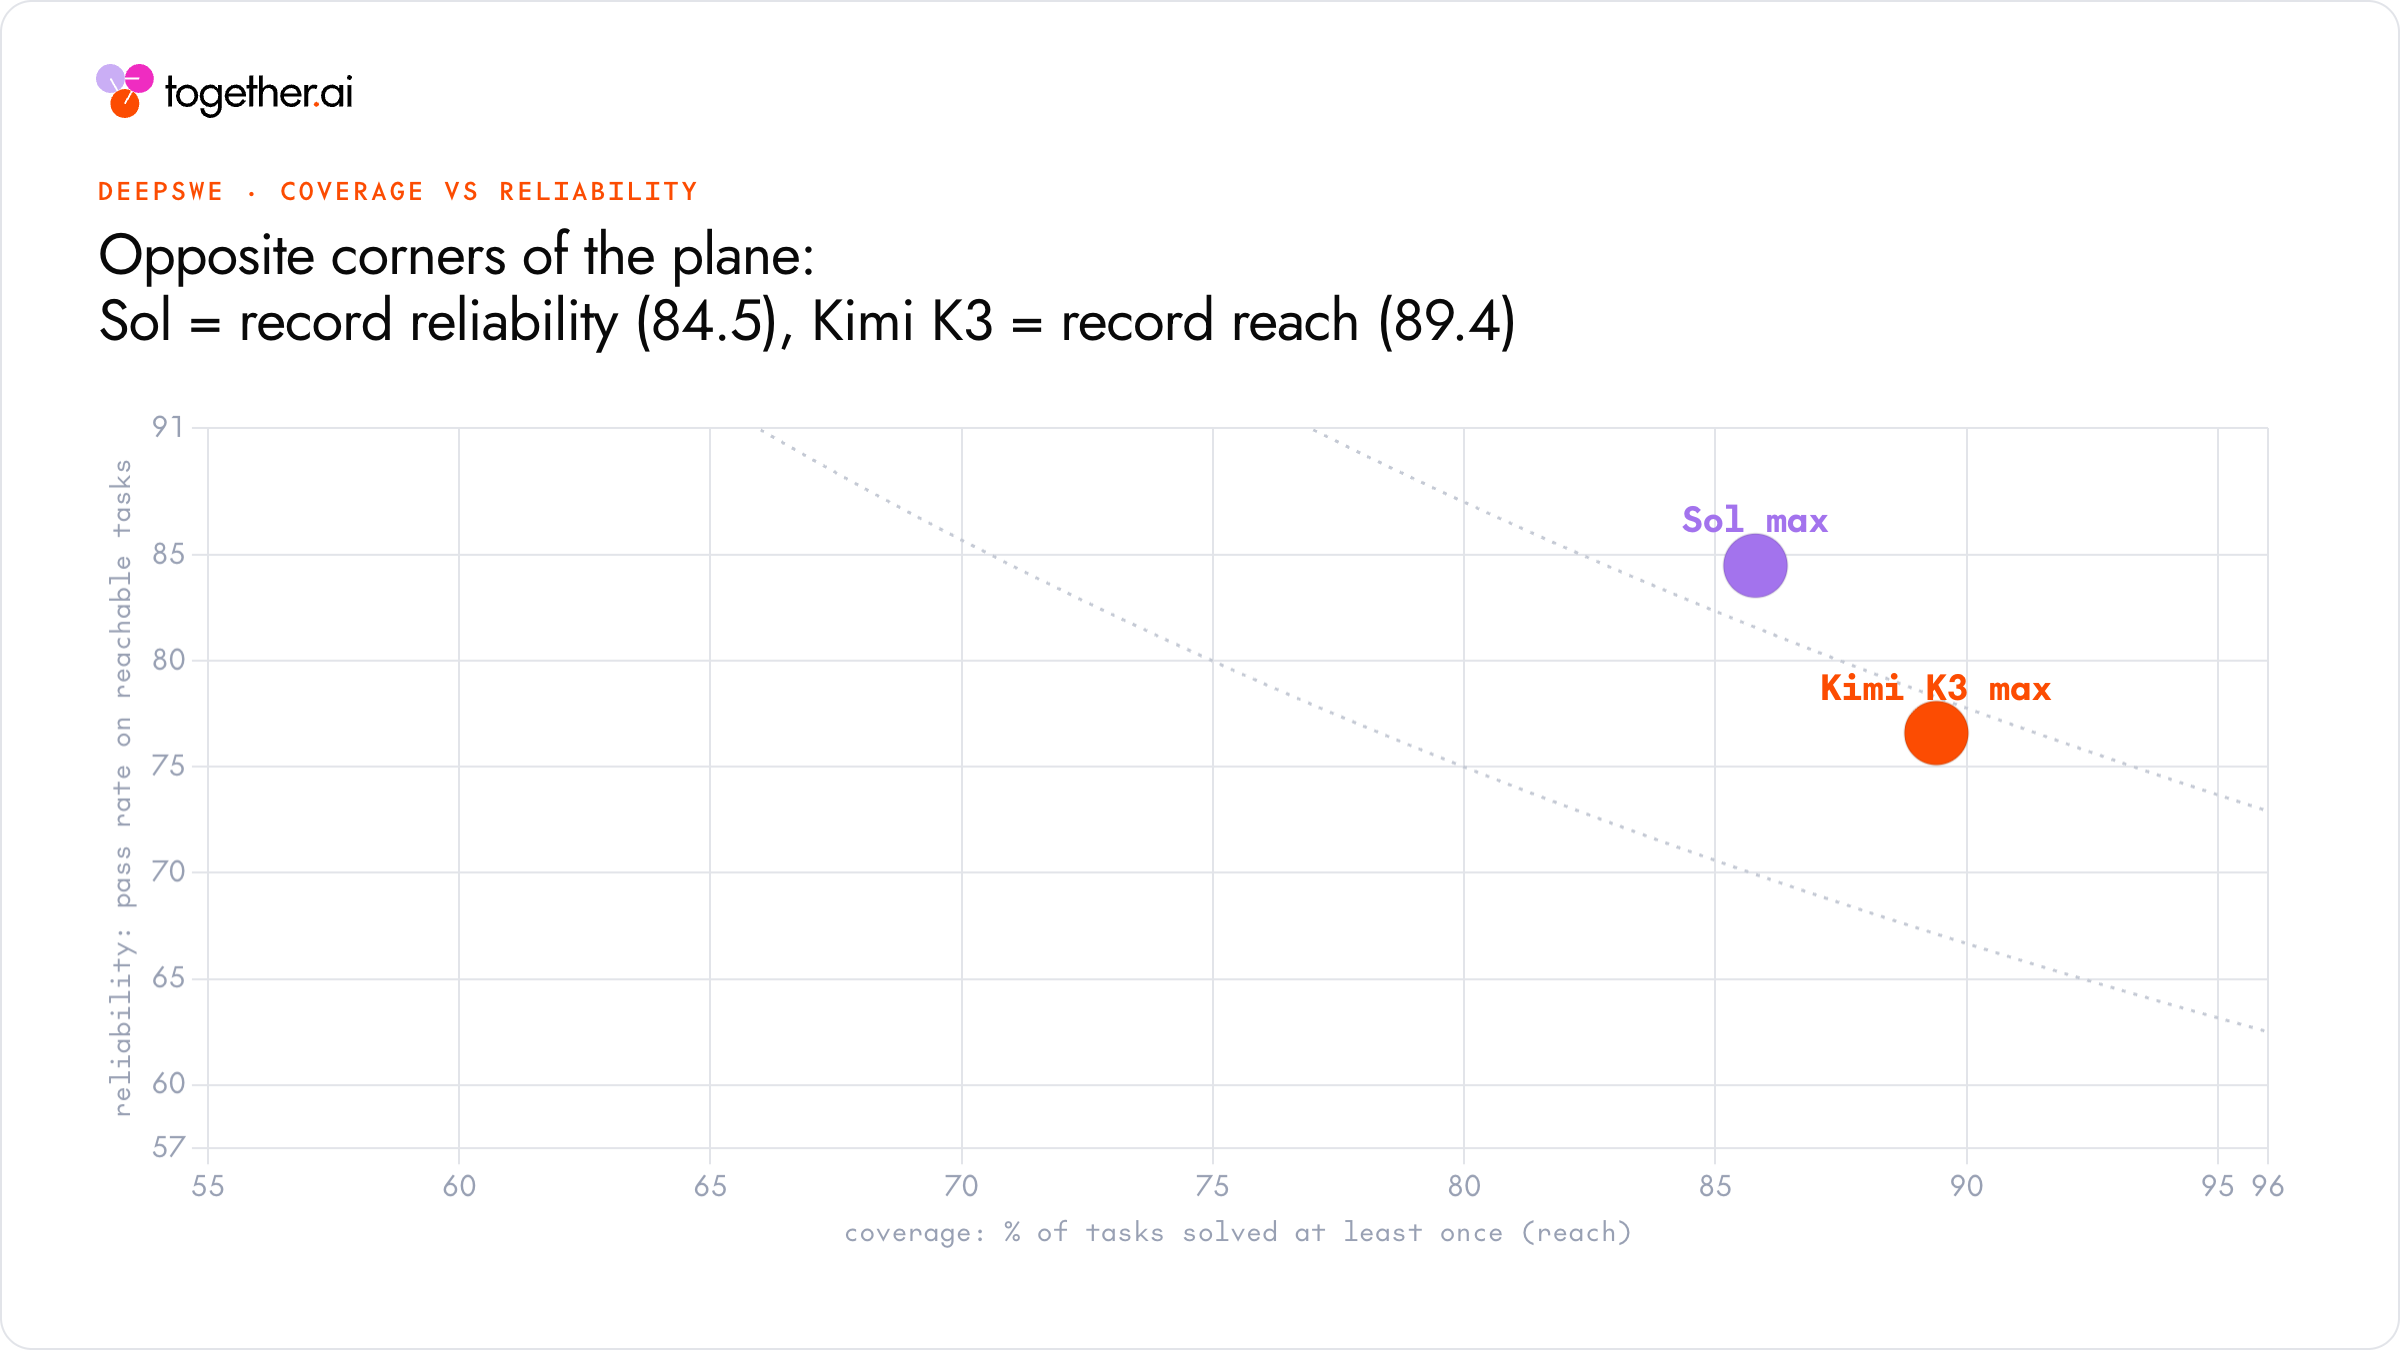
把 pass@1 和 pass@4 分解为覆盖率(四次尝试中至少解决一次的任务)和可靠性(四次全部解决的任务),两个模型恰好位于相反的角落。Sol 的可靠性为 84.5%,有 61 个任务四次全部解决,但覆盖的任务只占基准测试的 85.8%,并不算高。Kimi K3 的覆盖率达到 89.4%,比任何旗舰模型都广,但可靠性只有 76.6%,稳稳拿下的任务有 45 个。Sol 更稳定、更具确定性;Kimi K3 则撒下的网更大。
Kimi K3 与 GPT-5.6 Sol 有多大差异?
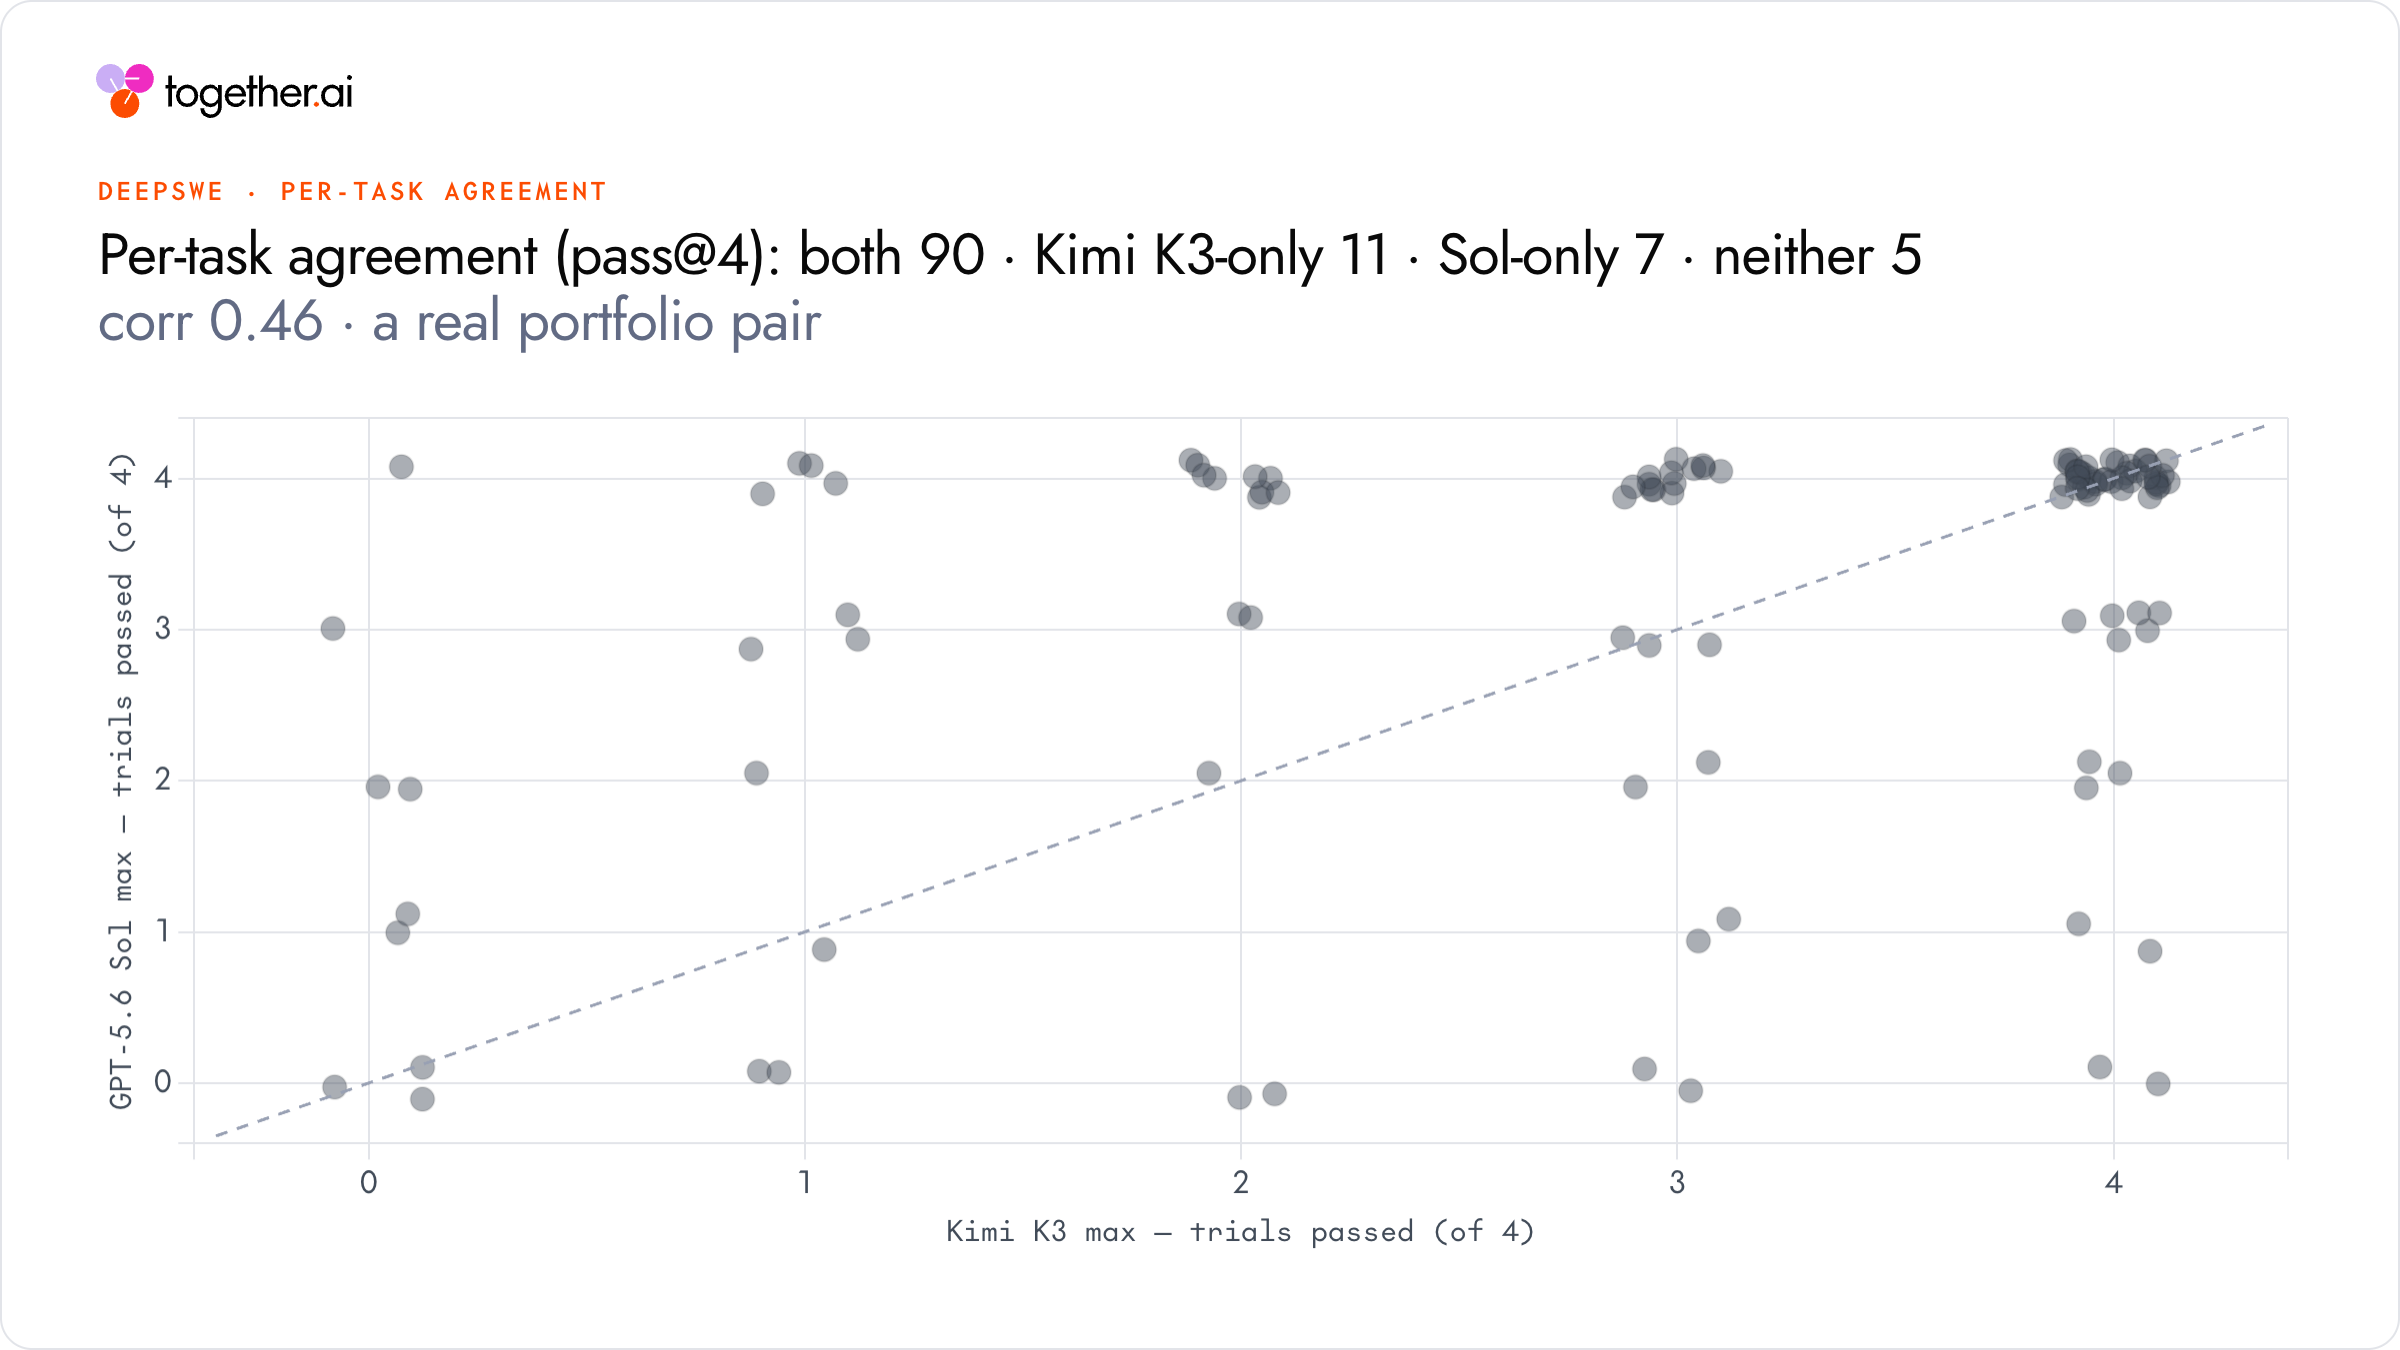
Kimi K3 与 Fable 基本上是一个回音室(相关系数 0.72),而 Kimi K3 与 Sol 则出现分歧:逐任务相关系数为 0.46,两个方向上都存在“四次全对对四次全错”的极端情形。两个模型成功和失败的方式确实不同。这恰恰让它们成为路由和级联的理想搭档:合在一起可以覆盖 113 个任务中的 108 个(95.6%),是该基准测试上最好的双模型组合。
在二者之间做路由,上限能有多高?
由于两个模型在 113 个任务中有 18 个意见不一致,路由可以把这种分歧转化为“免费”的准确率。能捕获多少,取决于你是否有验证器(比如你的测试套件)来发现错误答案并触发升级。
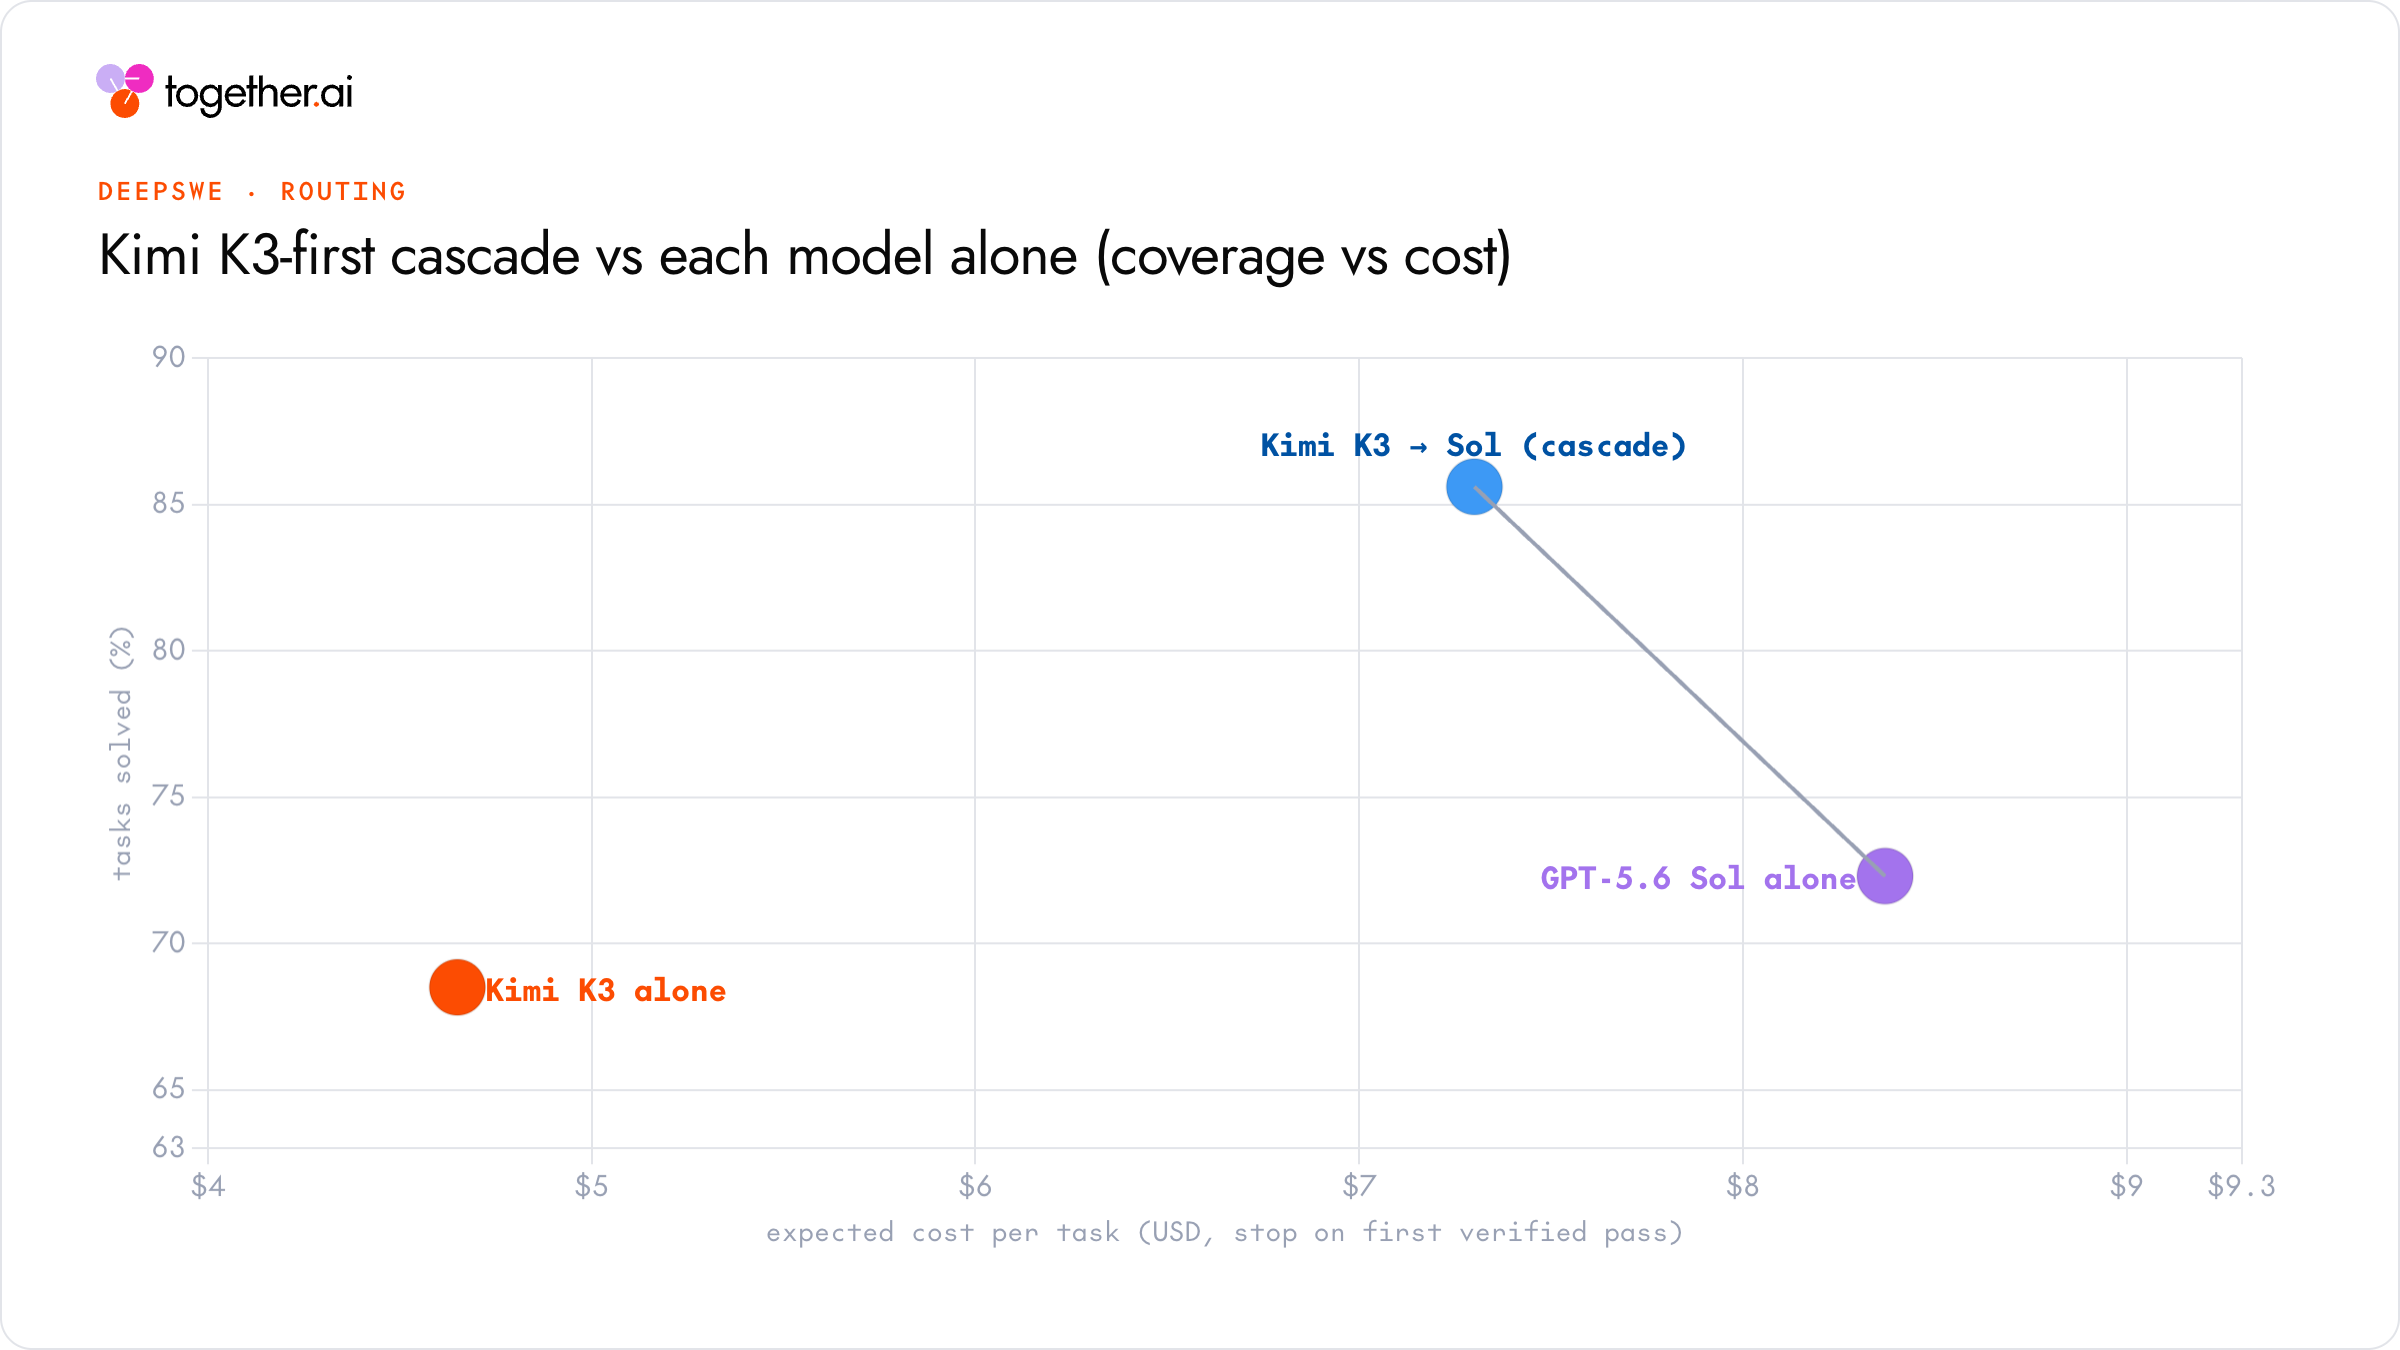
实际可达的结果约为 85.6%:先运行 Kimi K3,只有在测试套件拒绝其结果时才升级到 Sol。这比任何单个模型都好,甚至超过完美的一次性路由器(83.4%),因为级联让难题获得两次相互独立的尝试,而不是只押注一个模型。每解决一个任务的成本也低于单用 Sol,因为在调用 Sol 之前,Kimi K3 已经清掉了大约 70% 的队列。真正起作用的是验证器:没有验证器的话,现实中的路由器只能落在 70% 多,而 83.4% 是上限。
DeepSWE · 路由策略
路由策略:准确率与单任务成本
| 路由策略 | 准确率 | 单任务成本 |
|---|---|---|
| 最佳单一模型,不做路由(Sol) | 72.7% | $8.37 |
| 现实的学习型路由器(一次性) | 72–83% | ~$6 |
| 完美的预言机路由器(一次性,选对模型) | 83.4% | ~$6.07 |
| 级联:Kimi 失败后转 Sol | 85.6% | $7.30 |
| 两个模型各跑一次,任取其一 | 85.6% | $13.02 |
这对模型的硬性上限是 95.6%。113 个任务中有 5 个,在两个模型合计八次尝试中全部失败。要超过 95.6%,需要的是第三个模型,而不是更好的路由器。
各自擅长什么:按任务类型
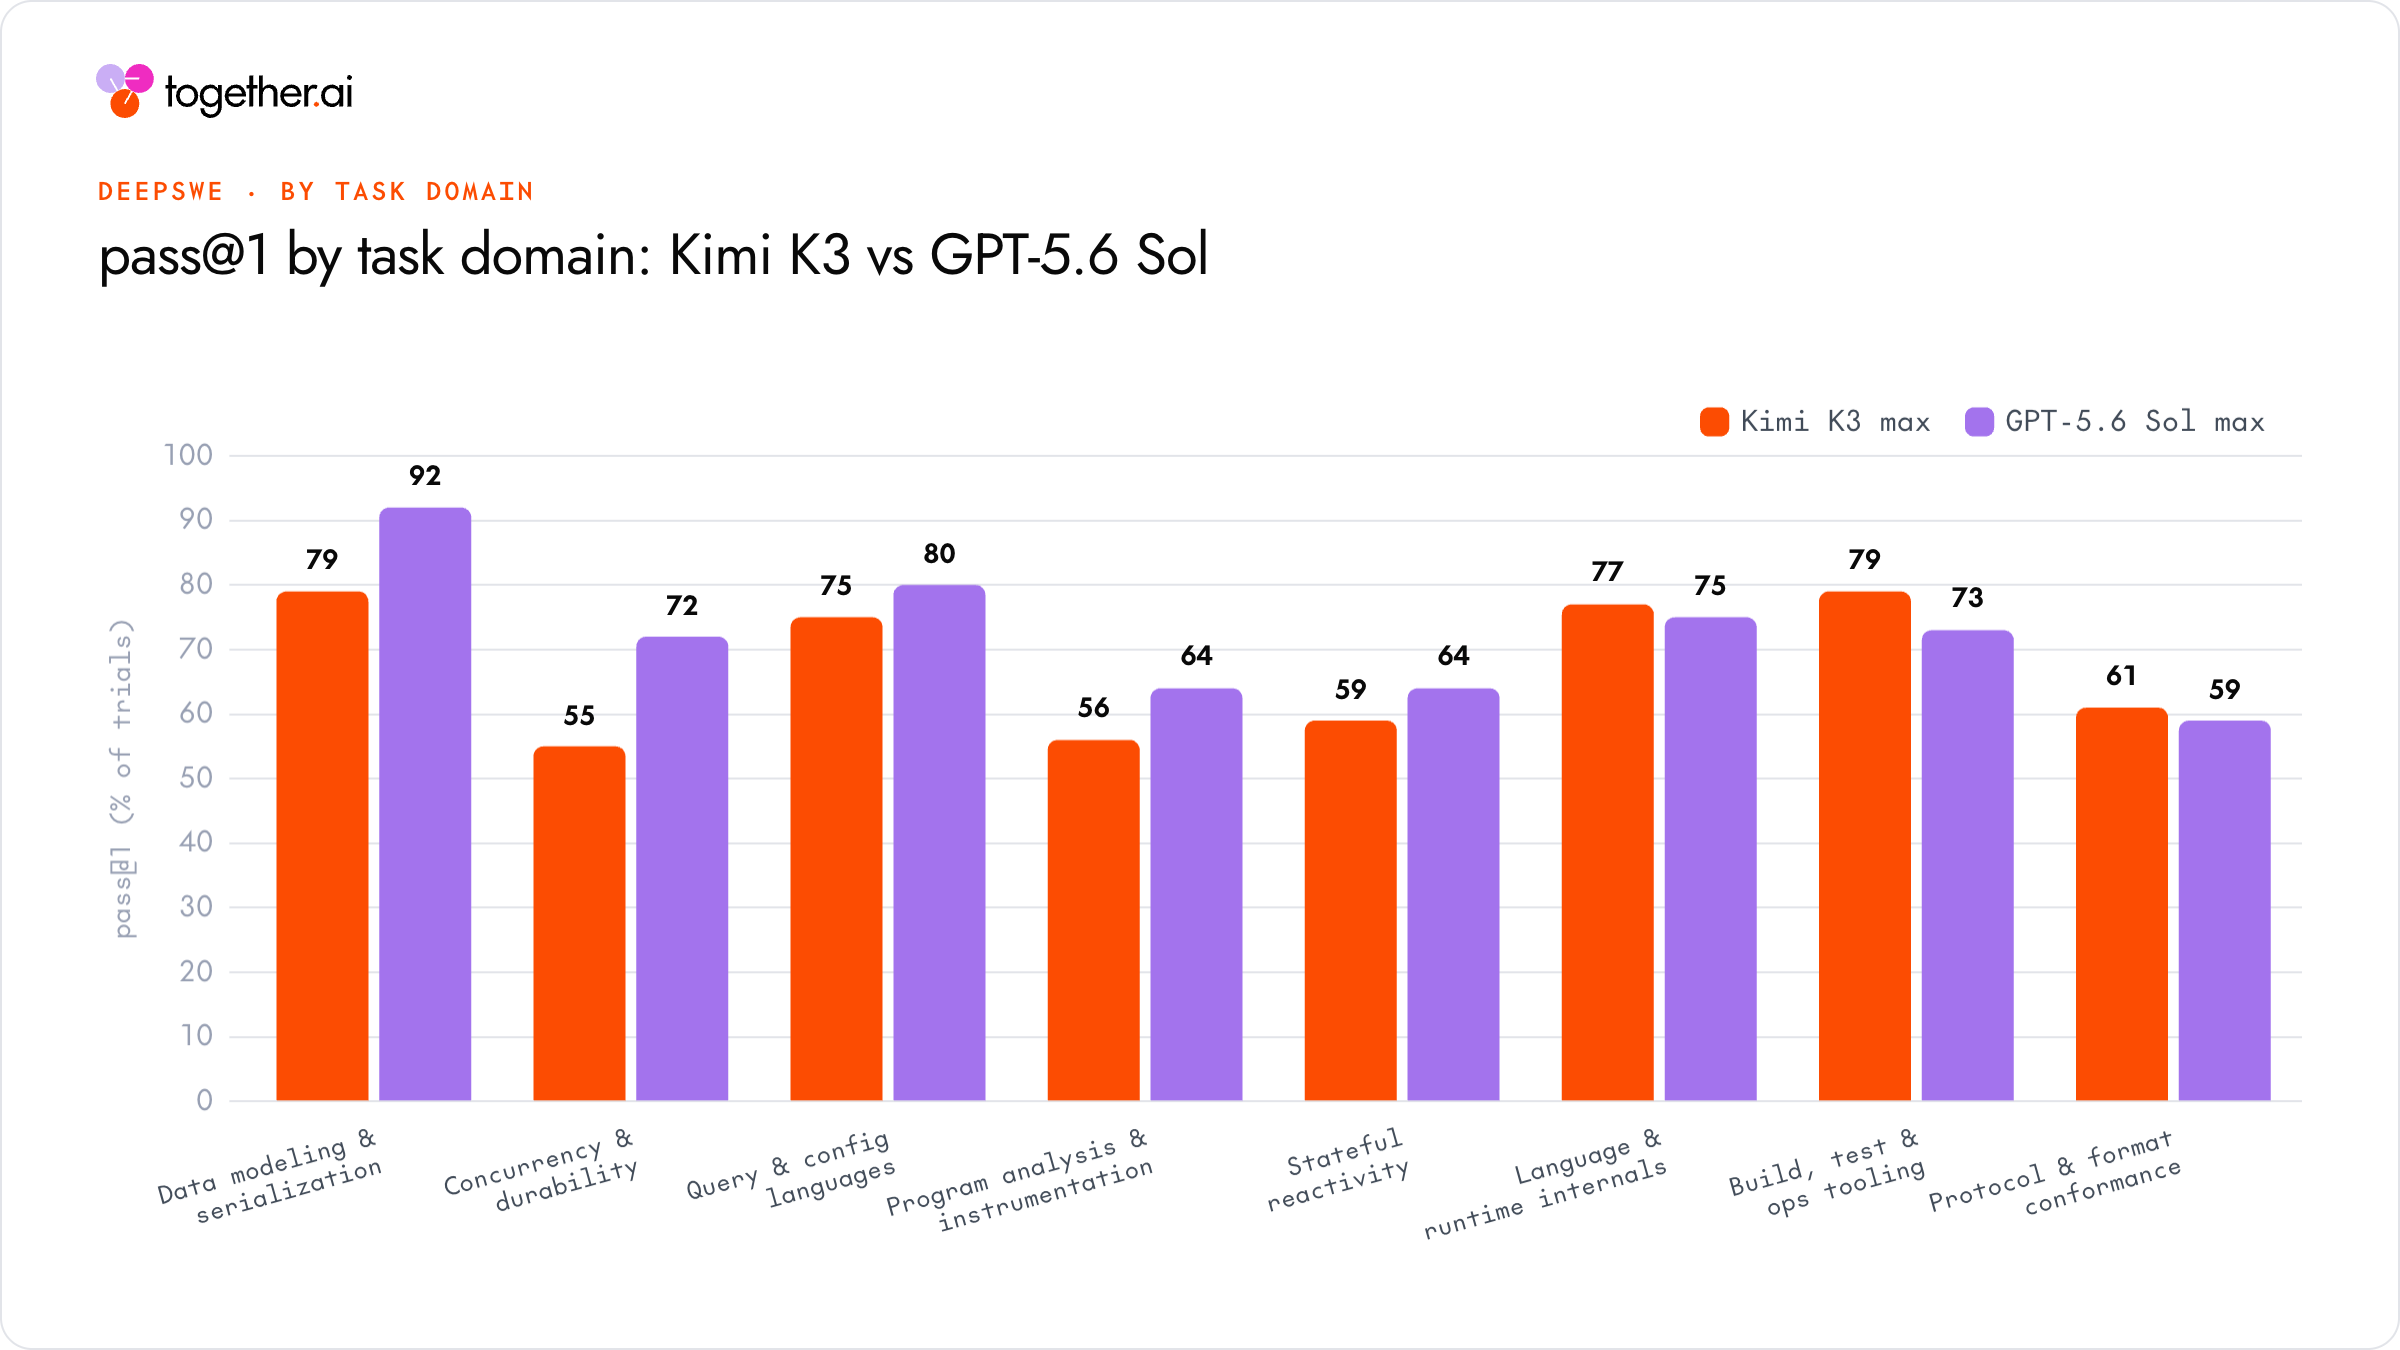
要路由得好,就要按编码需求的实际性质对任务分类。在 8 个领域中,Sol 领先 5 个,Kimi K3 领先其余领域。序列化(92 对 79)、并发(72 对 55)和程序分析(64 对 56)应交给 Sol。运维工具(79 对 73)和运行时内部机制(77 对 75)应交给 Kimi K3。一致性(conformance)为 61 对 59,基本是抛硬币。这里的任务类型由 LLM 根据各基准测试提示词分类得出。
失败模式
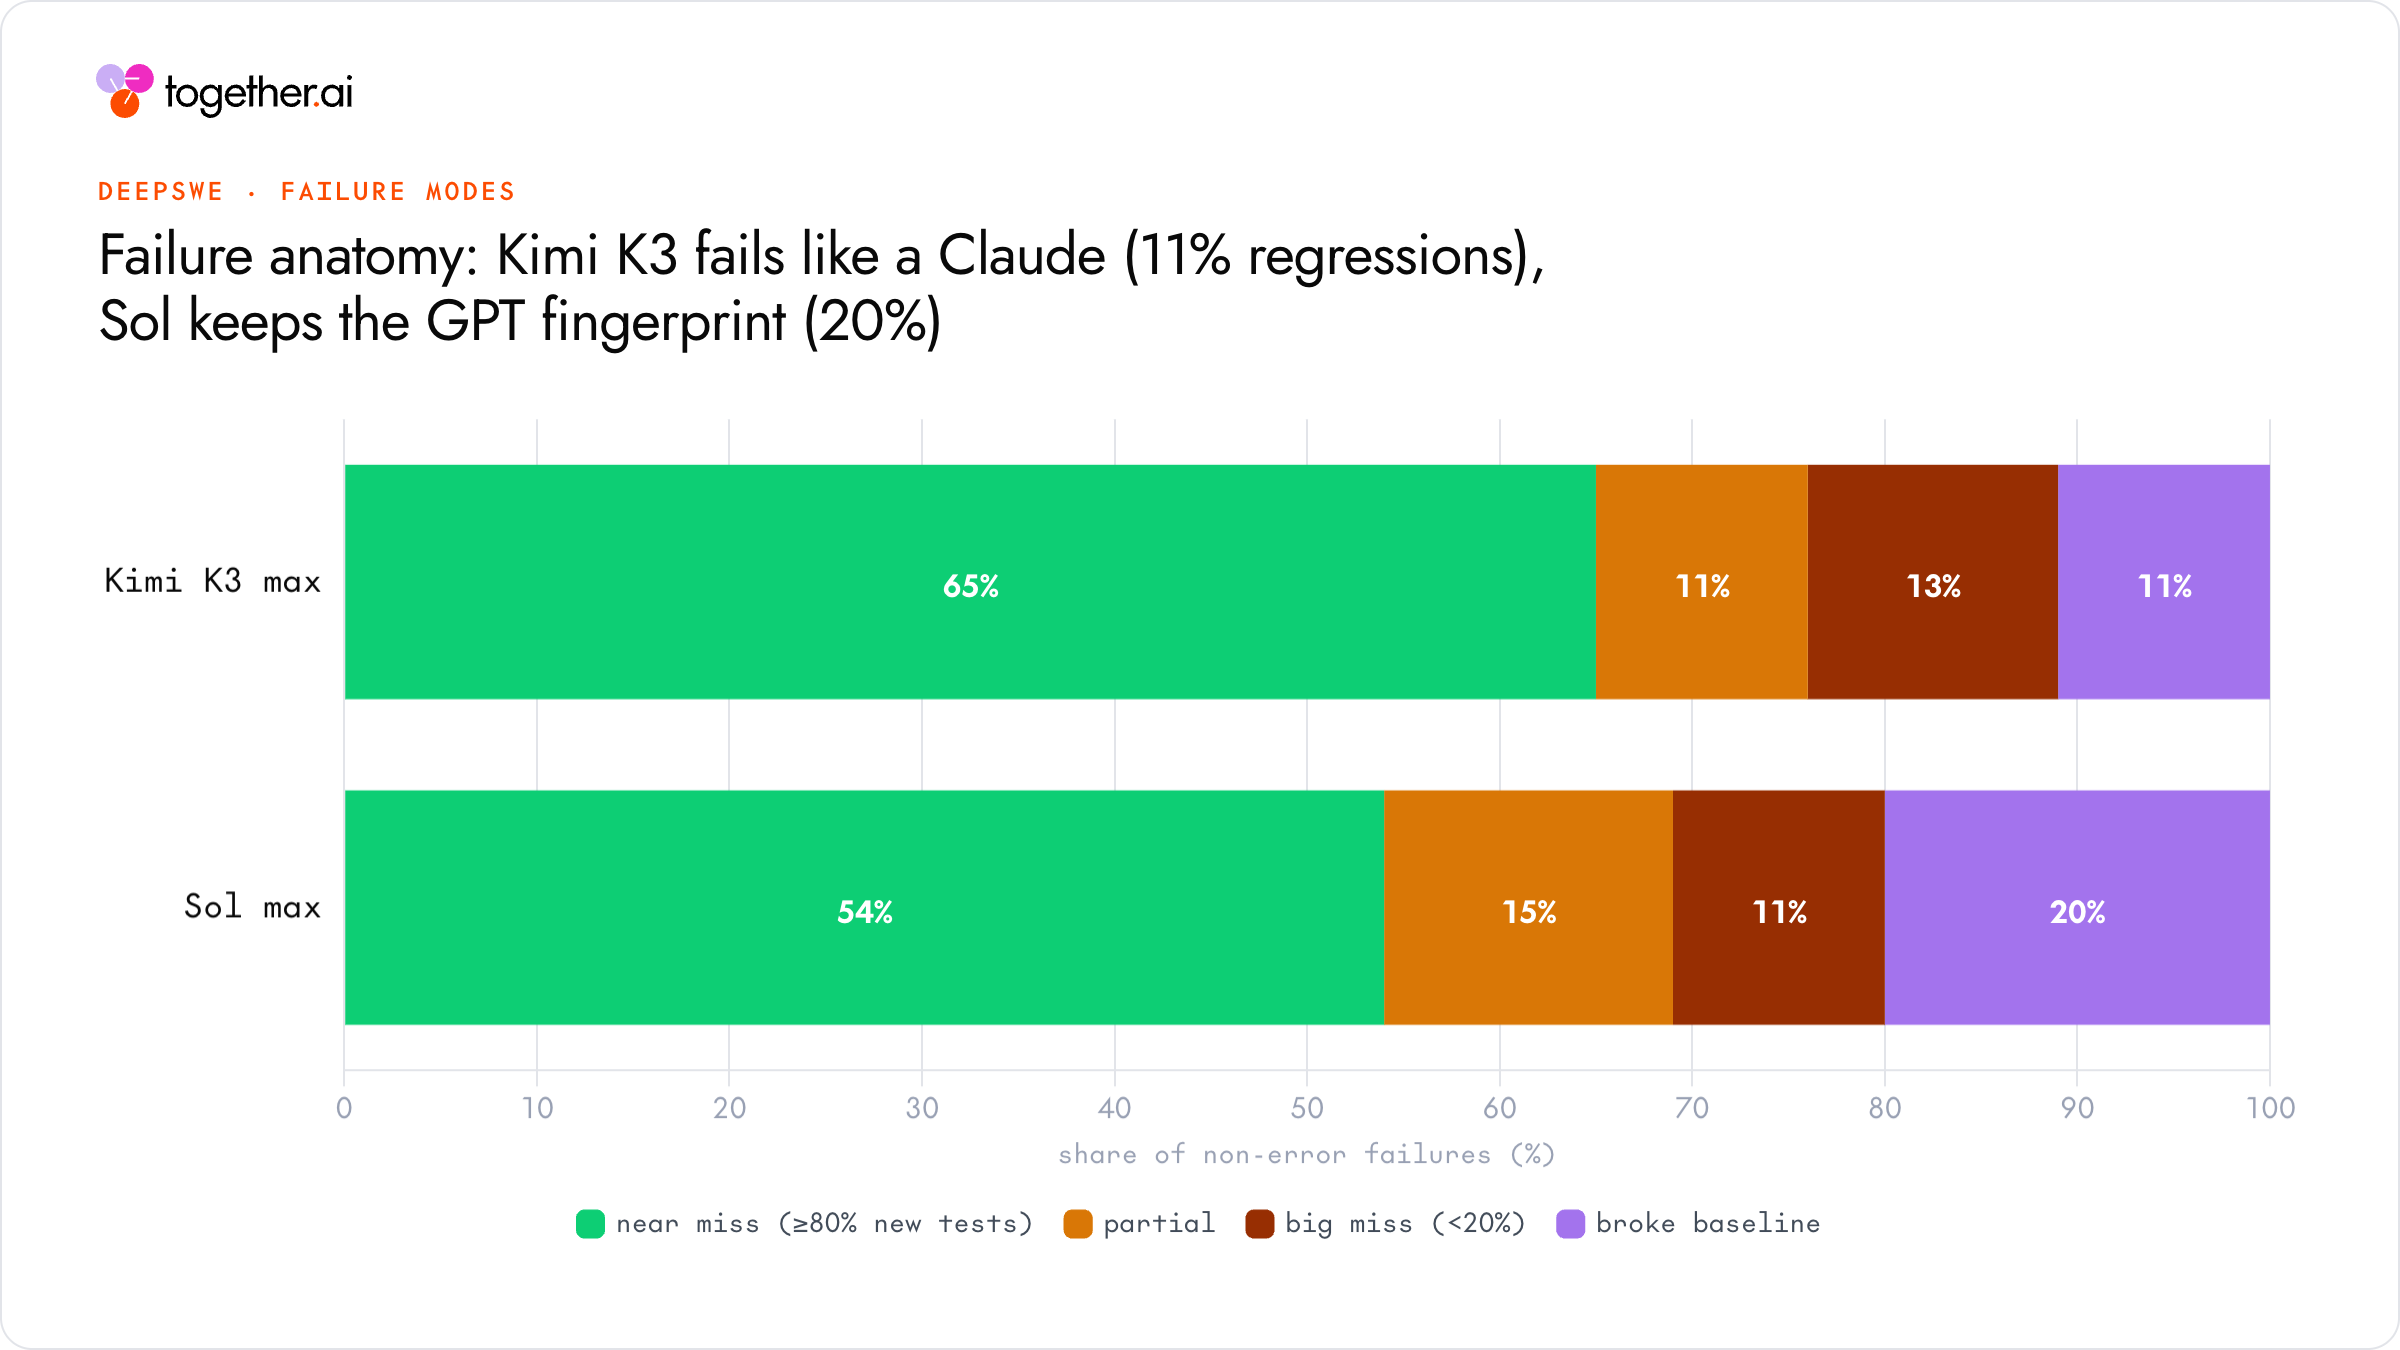
两者的失败方式非常不同:Kimi K3 往往接近成功,但没能通过全部测试;而 Sol 更多是破坏了基线测试。Sol 的失败案例中有 20% 破坏了仓库原有的测试,这其实与其他 GPT 模型相当一致。Kimi K3 则是 11% 的失败破坏了基础测试,但有 65% 属于“差一点”,即新增测试通过率超过 80%,只是仍有一些失败!
在 Together AI 上运行 Kimi K3
Kimi K3 以开放权重模型的形式发布,这使得上文所述的 pass@4 覆盖面、低成本和路由方案都可以按你自己的条件使用。权重可用后,Together AI 的推理栈就是为在生产规模上服务 Kimi K3 这类开放模型而构建的,因此你可以运行“Kimi 优先”的级联方案,追求更宽的 pass@k 覆盖面,而无需支付前沿模型的 token 价格。
请参阅 Together AI 推理定价,根据你的工作负载估算成本。
Kimi K3 与 GPT-5.6 Sol 常见问题
Kimi K3 比 GPT-5.6 Sol 更好吗?
取决于看哪项指标。GPT-5.6 Sol 在 DeepSWE 上单次尝试质量更高(pass@1 72.7% 对 68.5%),四次全部解决的任务也更多。Kimi K3 赢下 pass@2 和 pass@4,成本也低得多,因此对于大批量或能容忍重试的智能体工作,它是性价比更高的选择。对大多数团队来说,最佳答案是在二者之间做路由。
Kimi K3 比 GPT-5.6 Sol 便宜多少?
在我们的测试中,Kimi K3 每次 rollout 成本为 \$4.65,GPT-5.6 Sol 为 \$8.37,略高于一半的价格。按每个已解决任务计算,Kimi K3 每 \$100 解决 14.7 个任务,Sol 为 5.3 个,每美元完成的工作量约为 Sol 的 2.8 倍。
应该在 Kimi K3 和 GPT-5.6 Sol 之间做路由吗?
如果你能验证结果,就应该。两个模型存在分歧(相关系数 0.46),失败方式也不同,因此先跑 Kimi,在测试套件拒绝输出时再升级到 Sol,可达到约 85.6%,优于任何单个模型,甚至超过完美的一次性路由器。二者合计可覆盖 113 个任务中的 108 个。
写代码方面,Kimi K3 和 GPT-5.6 Sol 哪个更好?
在编码方面两者很接近。它们在 Go 上持平;Sol 在 Python、TypeScript 和 JavaScript 上领先;Kimi 在 Rust 上胜出。在任何单次尝试中 Sol 更稳定,而 Kimi 在多次尝试中撒下的网更大。
DeepSWE 上的 pass@k 是什么?
pass@k 衡量的是对某个任务的 k 次尝试中,是否至少有一次通过隐藏的测试套件。pass@1 奖励一次就做对;k 越大,越奖励那些经过多次尝试最终能得出解的模型。随着 k 增大,Kimi K3 的优势也在扩大。