核心结论
虽然 GPT-5.6 Luna 在每项质量指标上都是更强的工程师,但 DeepSeek-V4 Flash 0731 足够便宜,以至于先用 DeepSeek 的级联方案在准确率和成本上都胜过单独使用 Luna。
- GPT-5.6 Luna 在 DeepSWE pass@1 上明显领先,67.2% 对 53.3%,相差 14 个百分点,并且在每个相同的尝试次数下都保持领先。
- DeepSeek-V4 Flash 是 DeepSWE 榜单上最便宜的模型:每次 rollout \$0.10,而 Luna 为 \$0.61,每 \$100 可解决 532 个任务,Luna 为 110 个。
- DeepSeek-V4 Flash 失败得更干净:失败案例中有 9% 破坏了仓库现有的测试套件,Luna 则为 15%。
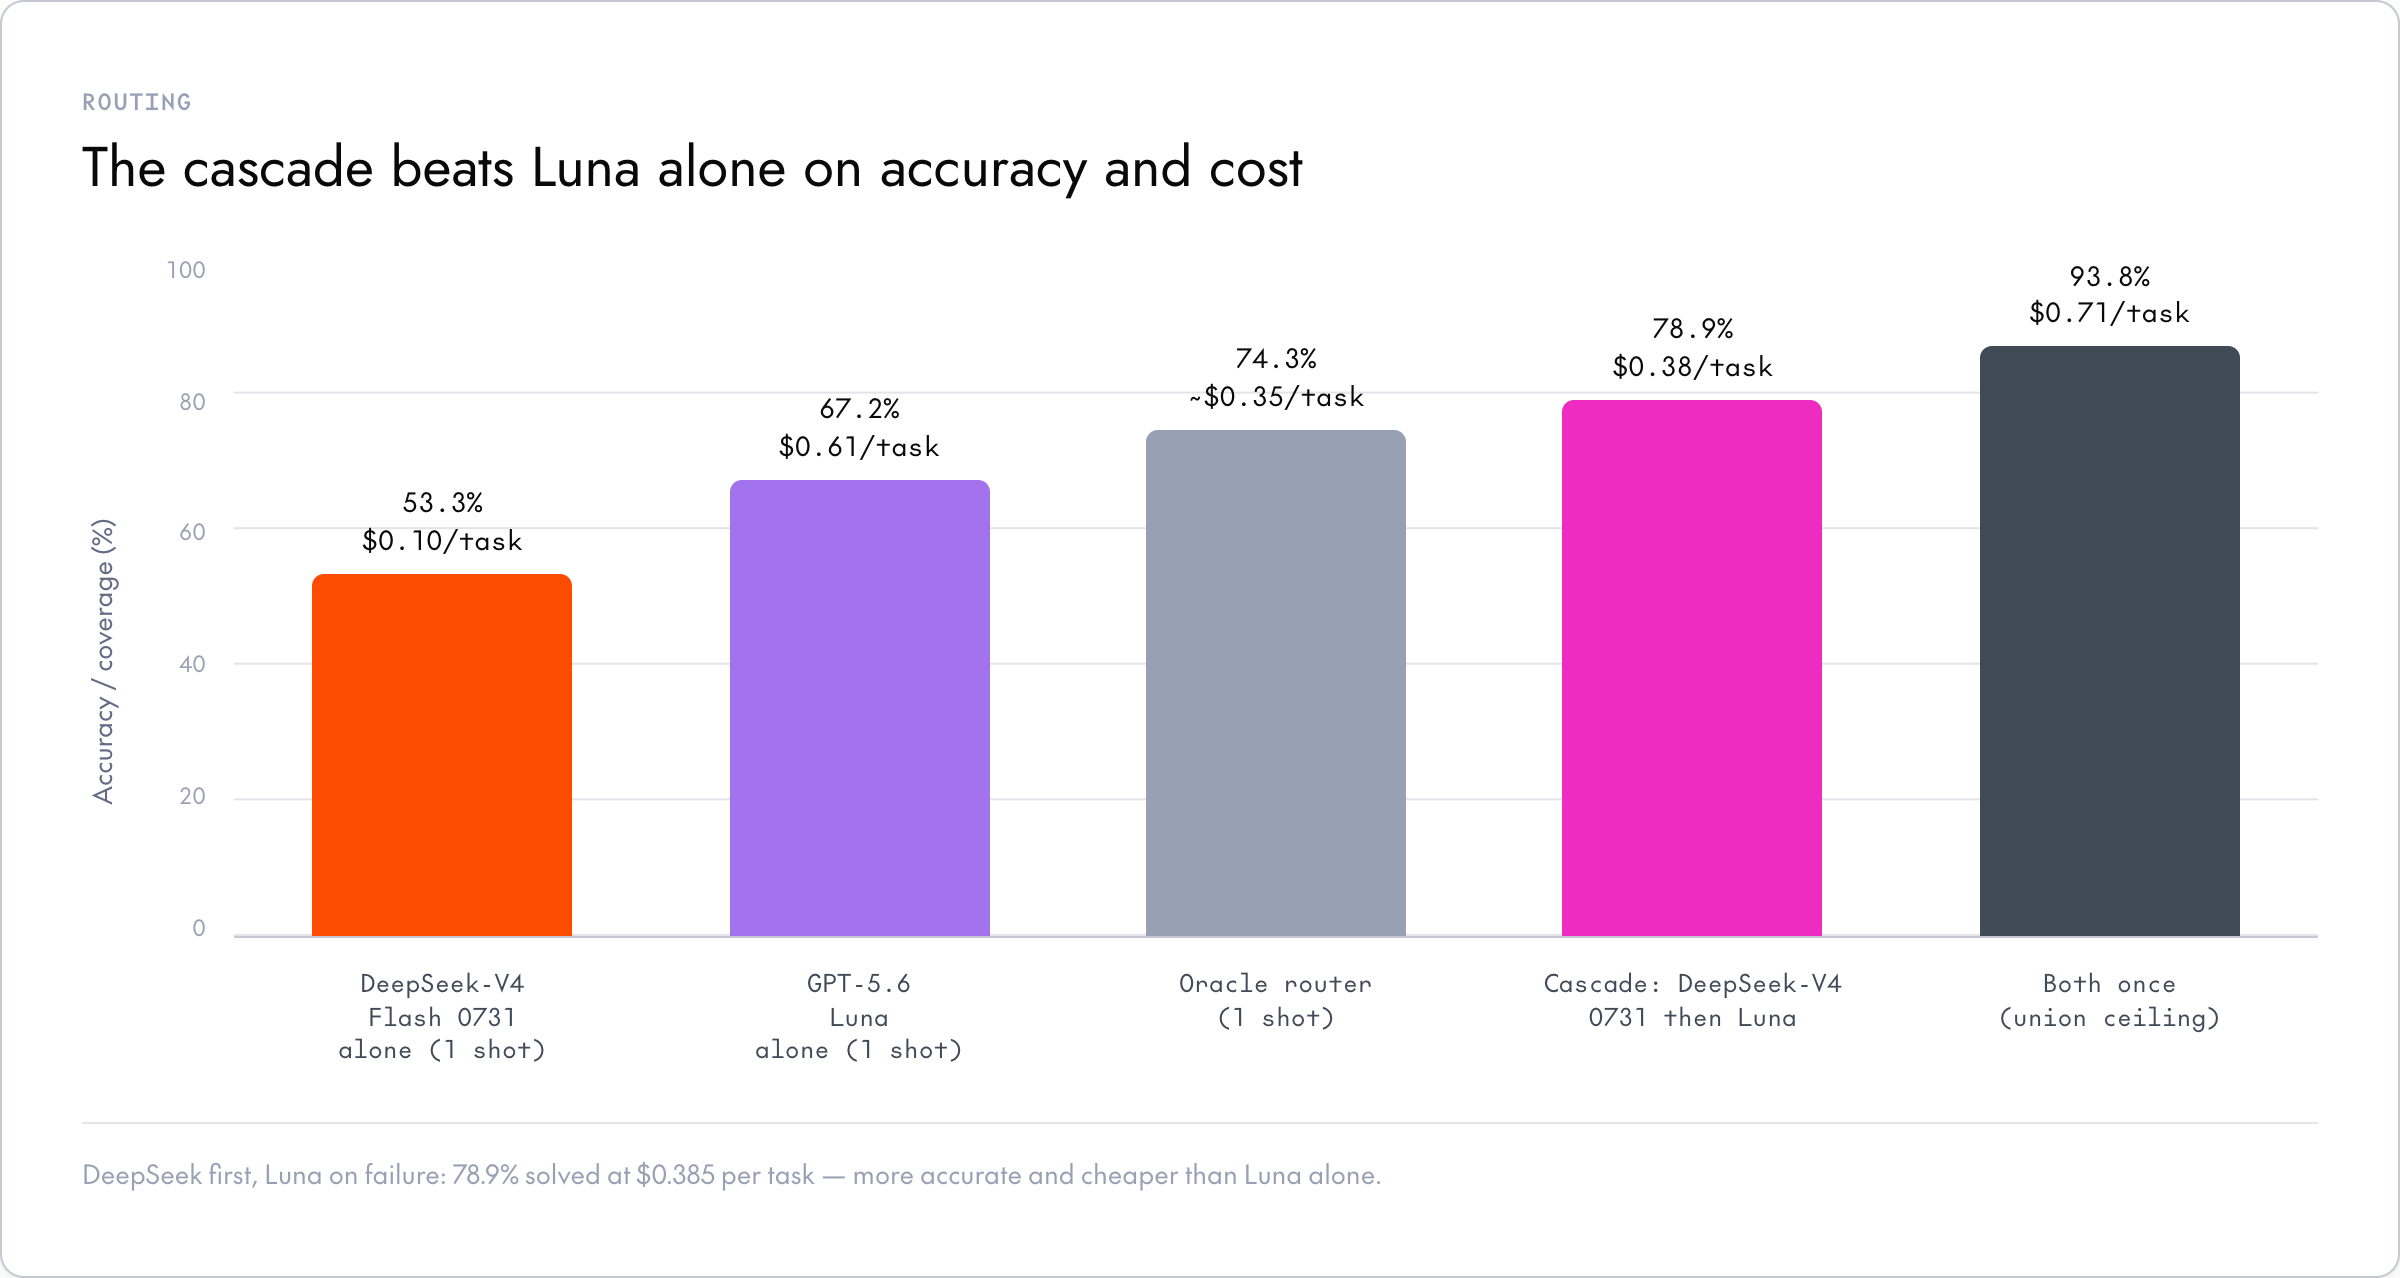
- 先运行 DeepSeek-V4 Flash,仅在失败时升级到 Luna,可以解决 78.9% 的任务,每个任务成本 \$0.385:比单独使用 Luna 更准确,且便宜 37%。
现已上线 · 开放权重
在 Together AI 上运行 DeepSeek-V4 Flash
DeepSWE 榜单上最便宜的模型,每个任务约一角钱。无需前沿模型的 token 价格,即可在生产规模上提供这个廉价的第一阶段。
打开 Playground
DeepSeek-V4 Flash 0731 是整个 DeepSWE 榜单上最便宜的模型:每个任务约一角钱!GPT-5.6 Luna 是一款扎实的上层旗舰模型,每个任务 \$0.61,约为 DeepSeek 价格的六倍。所以问题不在于谁赢得榜单(显然是 Luna),而在于六倍的价差能换来什么、又让你付出什么,以及两者合用是否胜过任何单独一个。
我们让 DeepSeek-V4 Flash 0731(max)与 GPT-5.6 Luna(max)在全部 113 个 DeepSWE 任务上对决:这些任务是来自活跃开源仓库的真实、长周期功能需求,每个任务跑四次,由隐藏的测试套件判定通过与否。根据公布的逐次试验记录,总共有 900 次 rollout(DeepSeek 一侧 452 次,Luna 一侧 448 次)。下文所有数字均来自这次运行,因此可能与其他公开的评分卡有所不同。
一览
DeepSWE · 正面对比
DeepSeek-V4 Flash 与 GPT-5.6 Luna 一览
| 模型 | Pass@1 | 平均成本 | 输出 token | 步数 |
|---|---|---|---|---|
| gpt-5.6-luna [max] | 67% ± 4% | $0.61 | 73k | 102 |
| deepseek-v4-flash [max] | 53% ± 4% | $0.10 | 108k | 153 |
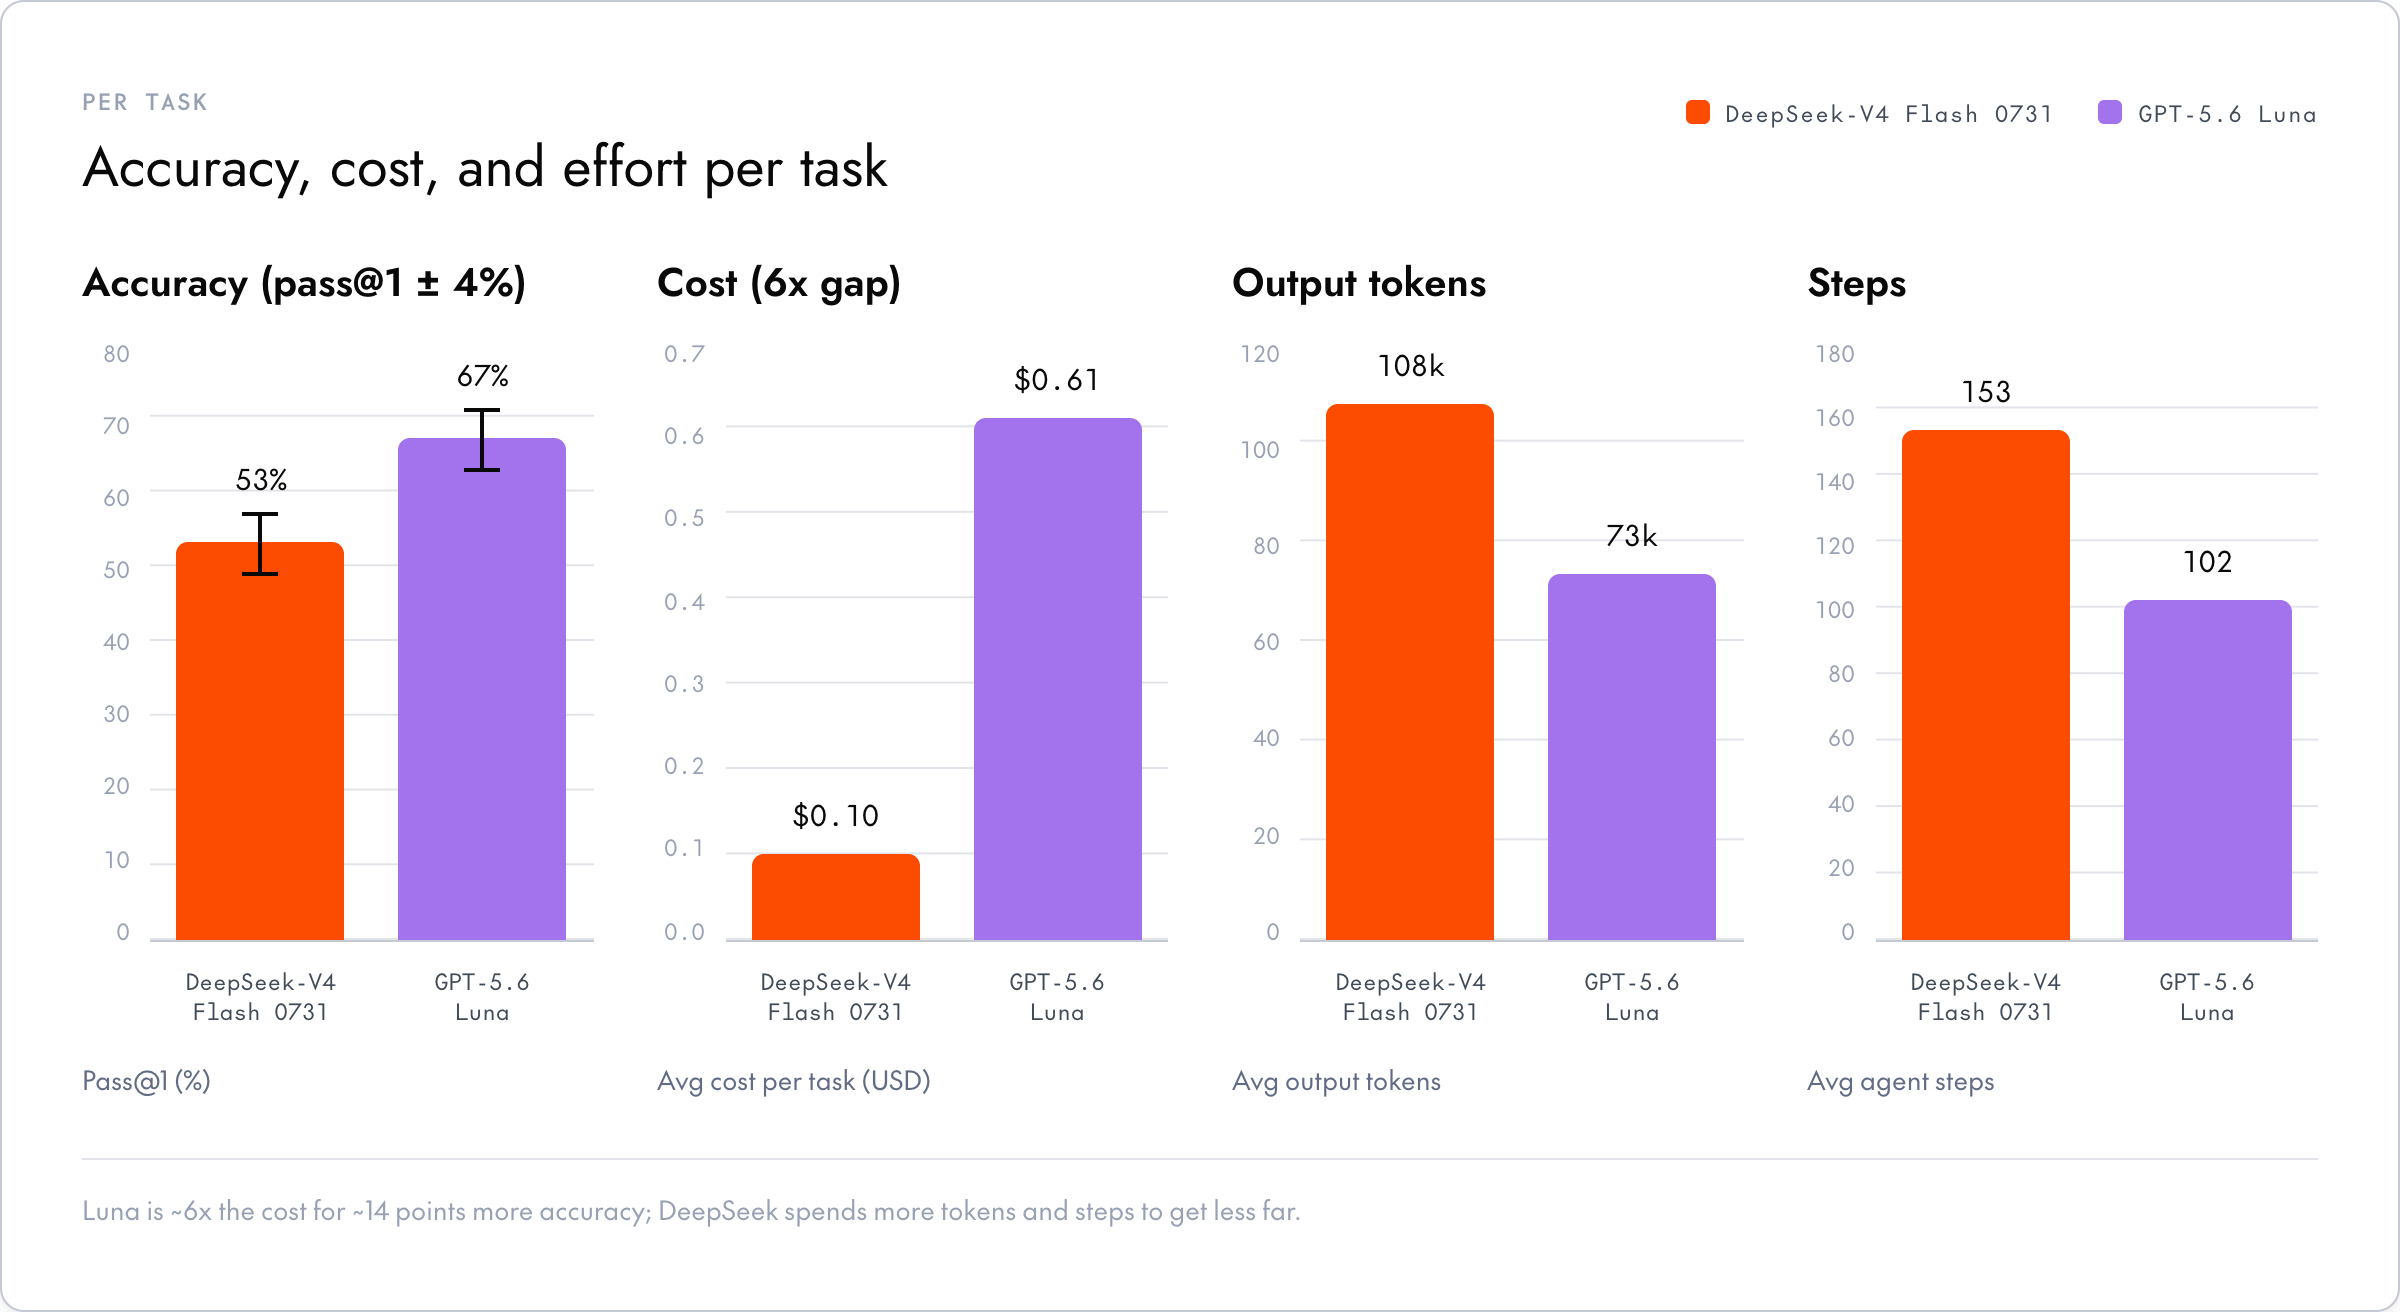
Luna 的成本约为 6 倍,换来约 14 个百分点的准确率提升;DeepSeek 使用更多输出 token 和步数,却走得不如 Luna 远,但在 \$0.10 的价格下,它是这组测试中最便宜的一次运行,且领先幅度很大。
DeepSWE 排行榜:pass@1 与 pass@k
Luna 在单次尝试上明显获胜:按 DeepSWE 官方评分,pass@1 为 67.2%,DeepSeek 为 53.3%,领先 14 个百分点,相对而言准确率高出约 26%。在相同尝试次数下,Luna 在每个 k 值上都保持领先(两次尝试为 81.6 对 70.1,四次尝试为 90.3 对 80.5)。就原始解题能力而言,这并不是一场势均力敌的较量。
但 DeepSWE 恰恰是那种可以并行发起多次尝试的工作负载,在这种情况下,经济账会改写整个局面。DeepSeek 的 pass@2(70.1%)已经略高于 Luna 的单次尝试(67.2%),而两次 DeepSeek 尝试约花费 \$0.20,Luna 则是 \$0.61。如果有验证器能挑出成功的那次运行,这个便宜的模型只需三分之一的价格,就能达到旗舰模型一次成功的质量,这还没有用到下文的任何路由技巧。
成本对比:DeepSeek-V4 Flash 与 GPT-5.6 Luna 的定价
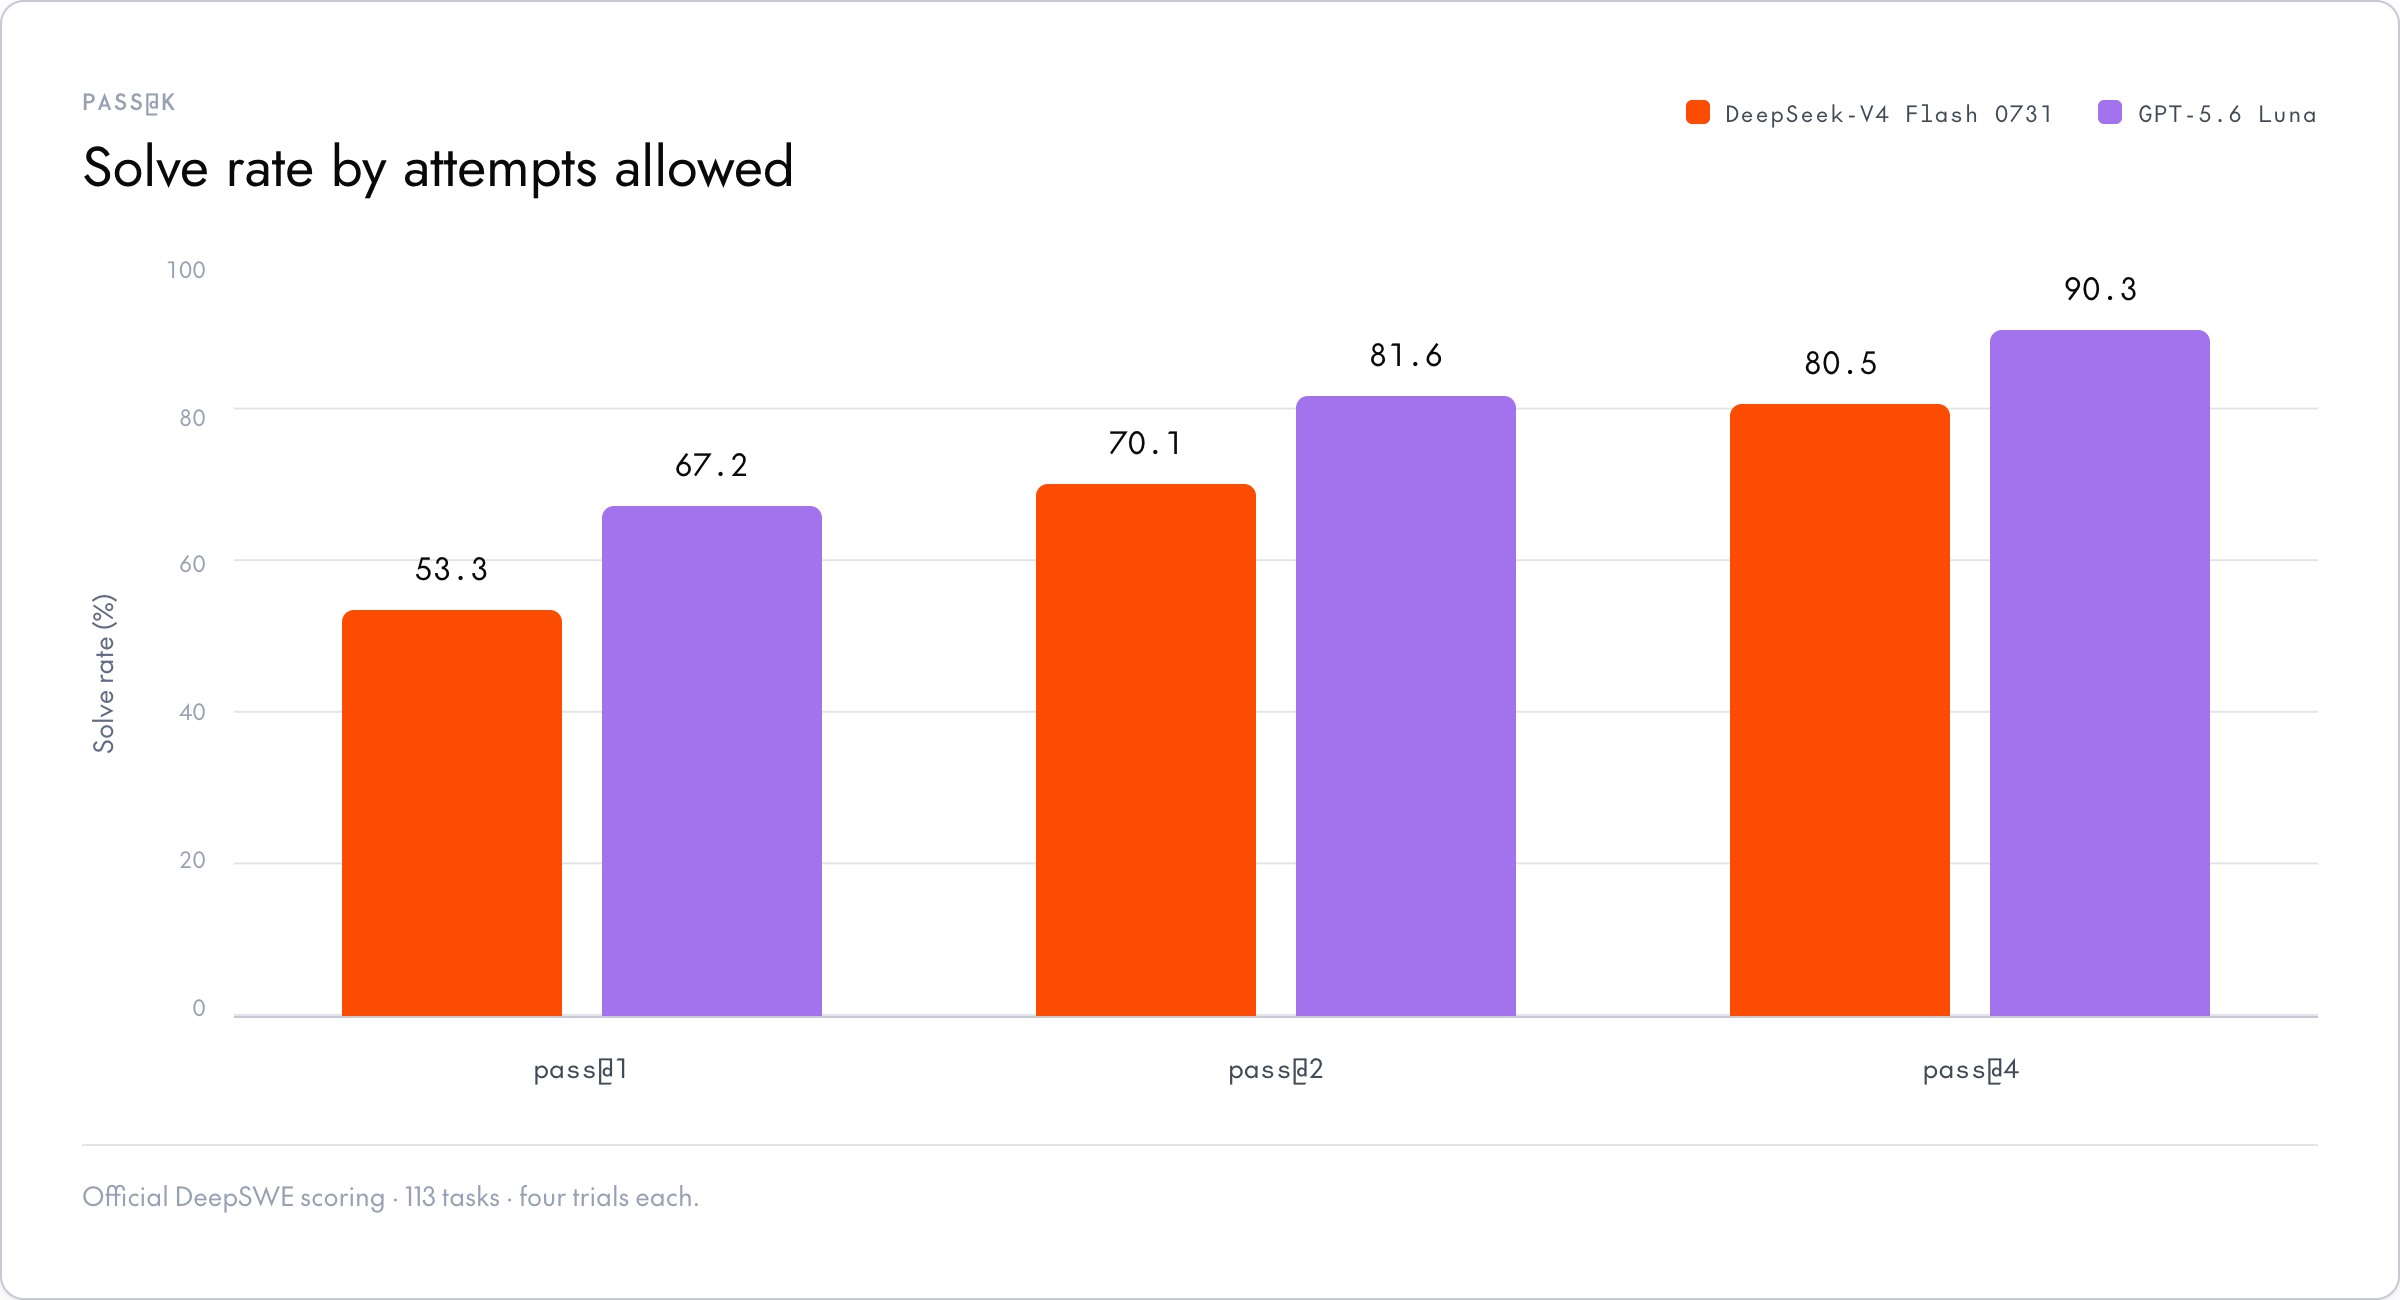
- 按每个任务 \$0.61 计算,Luna 每 \$100 解决 110 个任务,DeepSeek 为 532 个:便宜的模型在性价比上有 4.8 倍的优势。每次 rollout 的成本差距约为 6 倍。
- 便宜的模型换不来的一样东西是速度,这也是它与常见“flash”模型故事不同的转折:在这里 DeepSeek 反而是两者中较慢的,中位数需要 23 分钟和 148 步,而 Luna 为 16 分钟和 92 步。它是靠硬磨(输出也更多,中位数为 104k token,Luna 为 70k)。DeepSeek 的优势在于钱,而不是时间。
- 这一挂钟时间上的差距,部分源于该模型还很新;随着推理引擎针对它进行调优,预计这个差距会缩小。
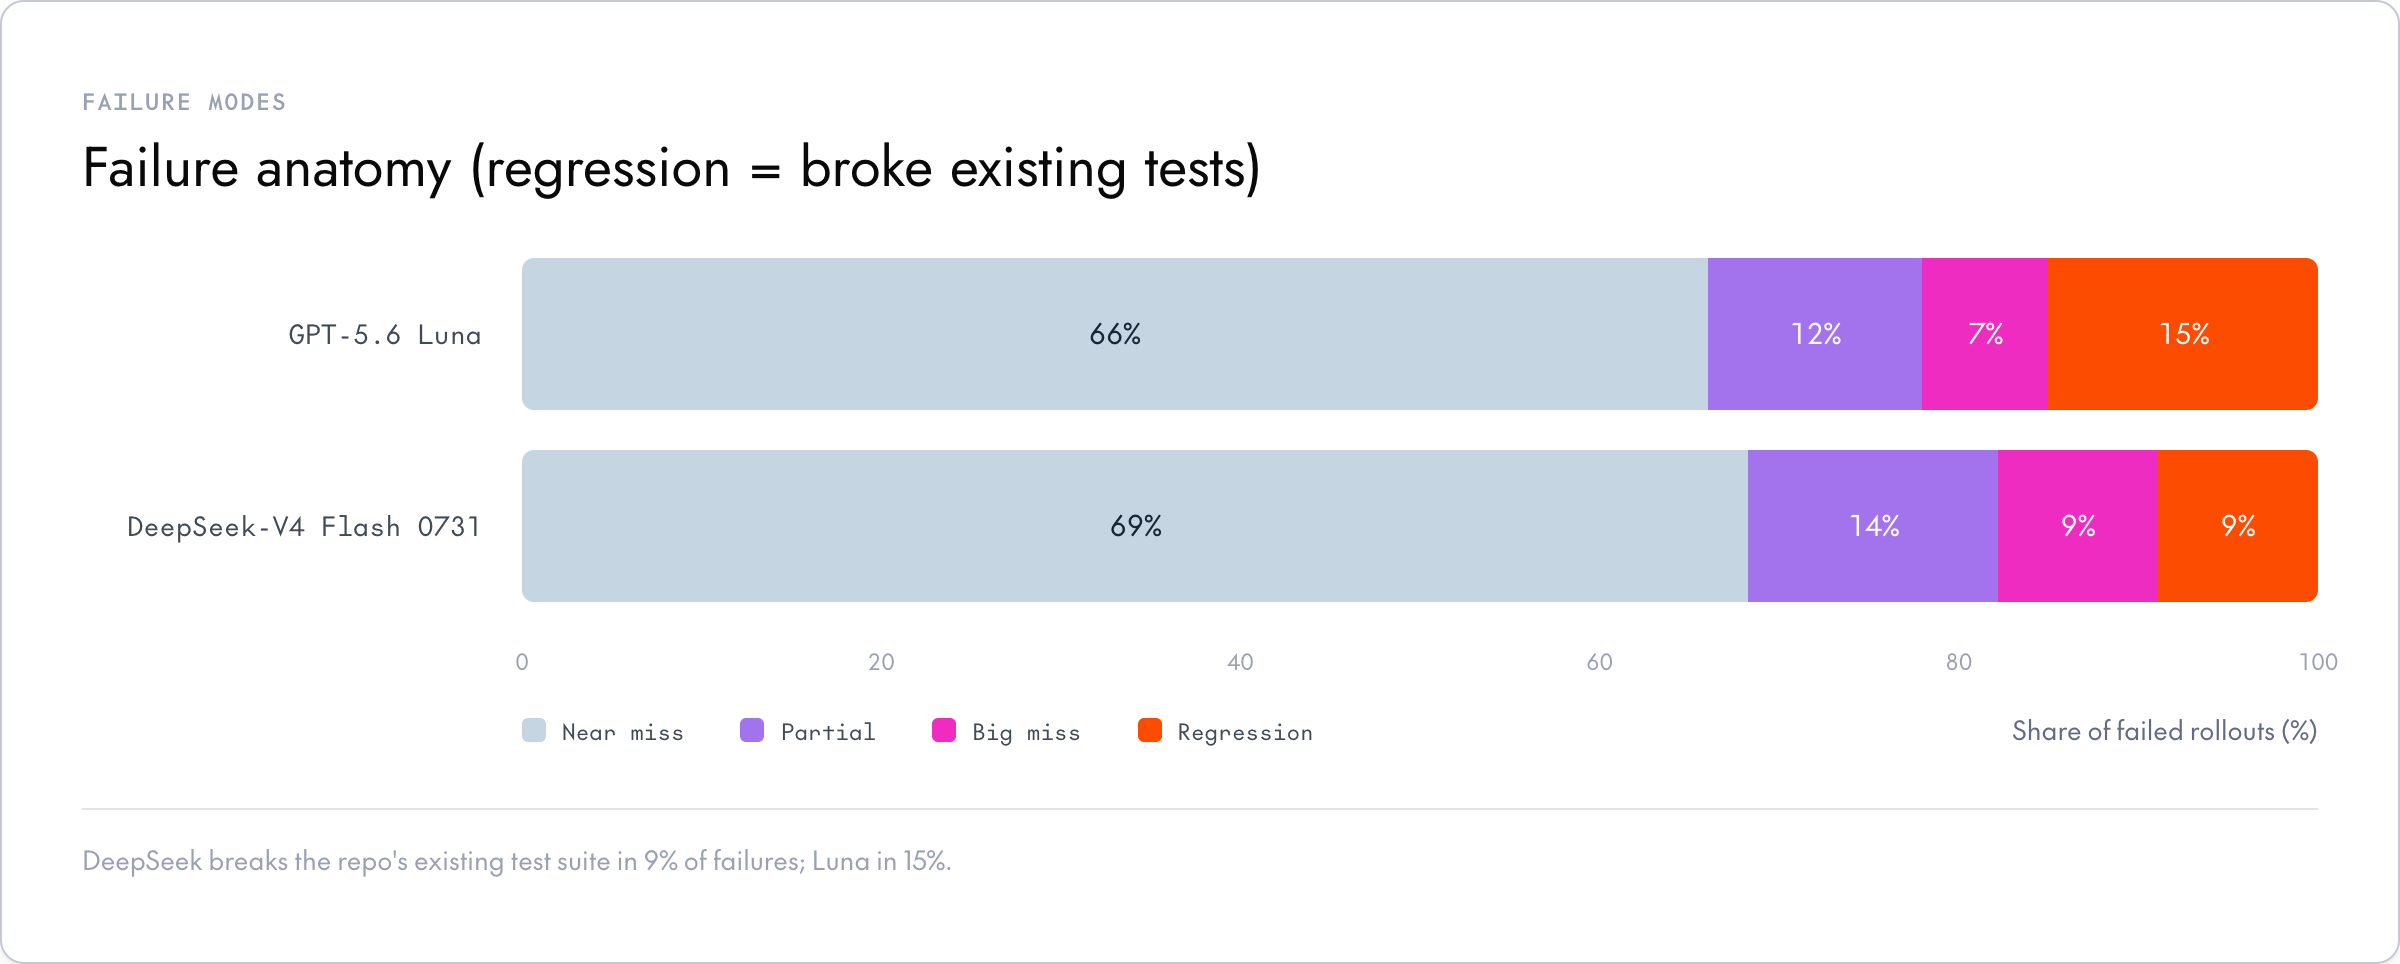
失败模式:DeepSeek 比旗舰模型失败得更体面
这个便宜的模型还悄悄赢下了另一点:规范性。DeepSeek 失败时,只有 9% 的失败案例破坏了仓库现有的测试套件,Luna 则是 15%:这是 GPT 系列典型的回归特征,我们在 Sol 和其他 OpenAI 系模型上看到的同样是 15% 到 20%。两者的失败大多是差一点就成功(DeepSeek 69%,Luna 66%),但更贵的模型更容易破坏原本能正常运行的代码。如果你部署 Luna,应当用完整的回归测试来把关;DeepSeek 对这道防护的需求较小。
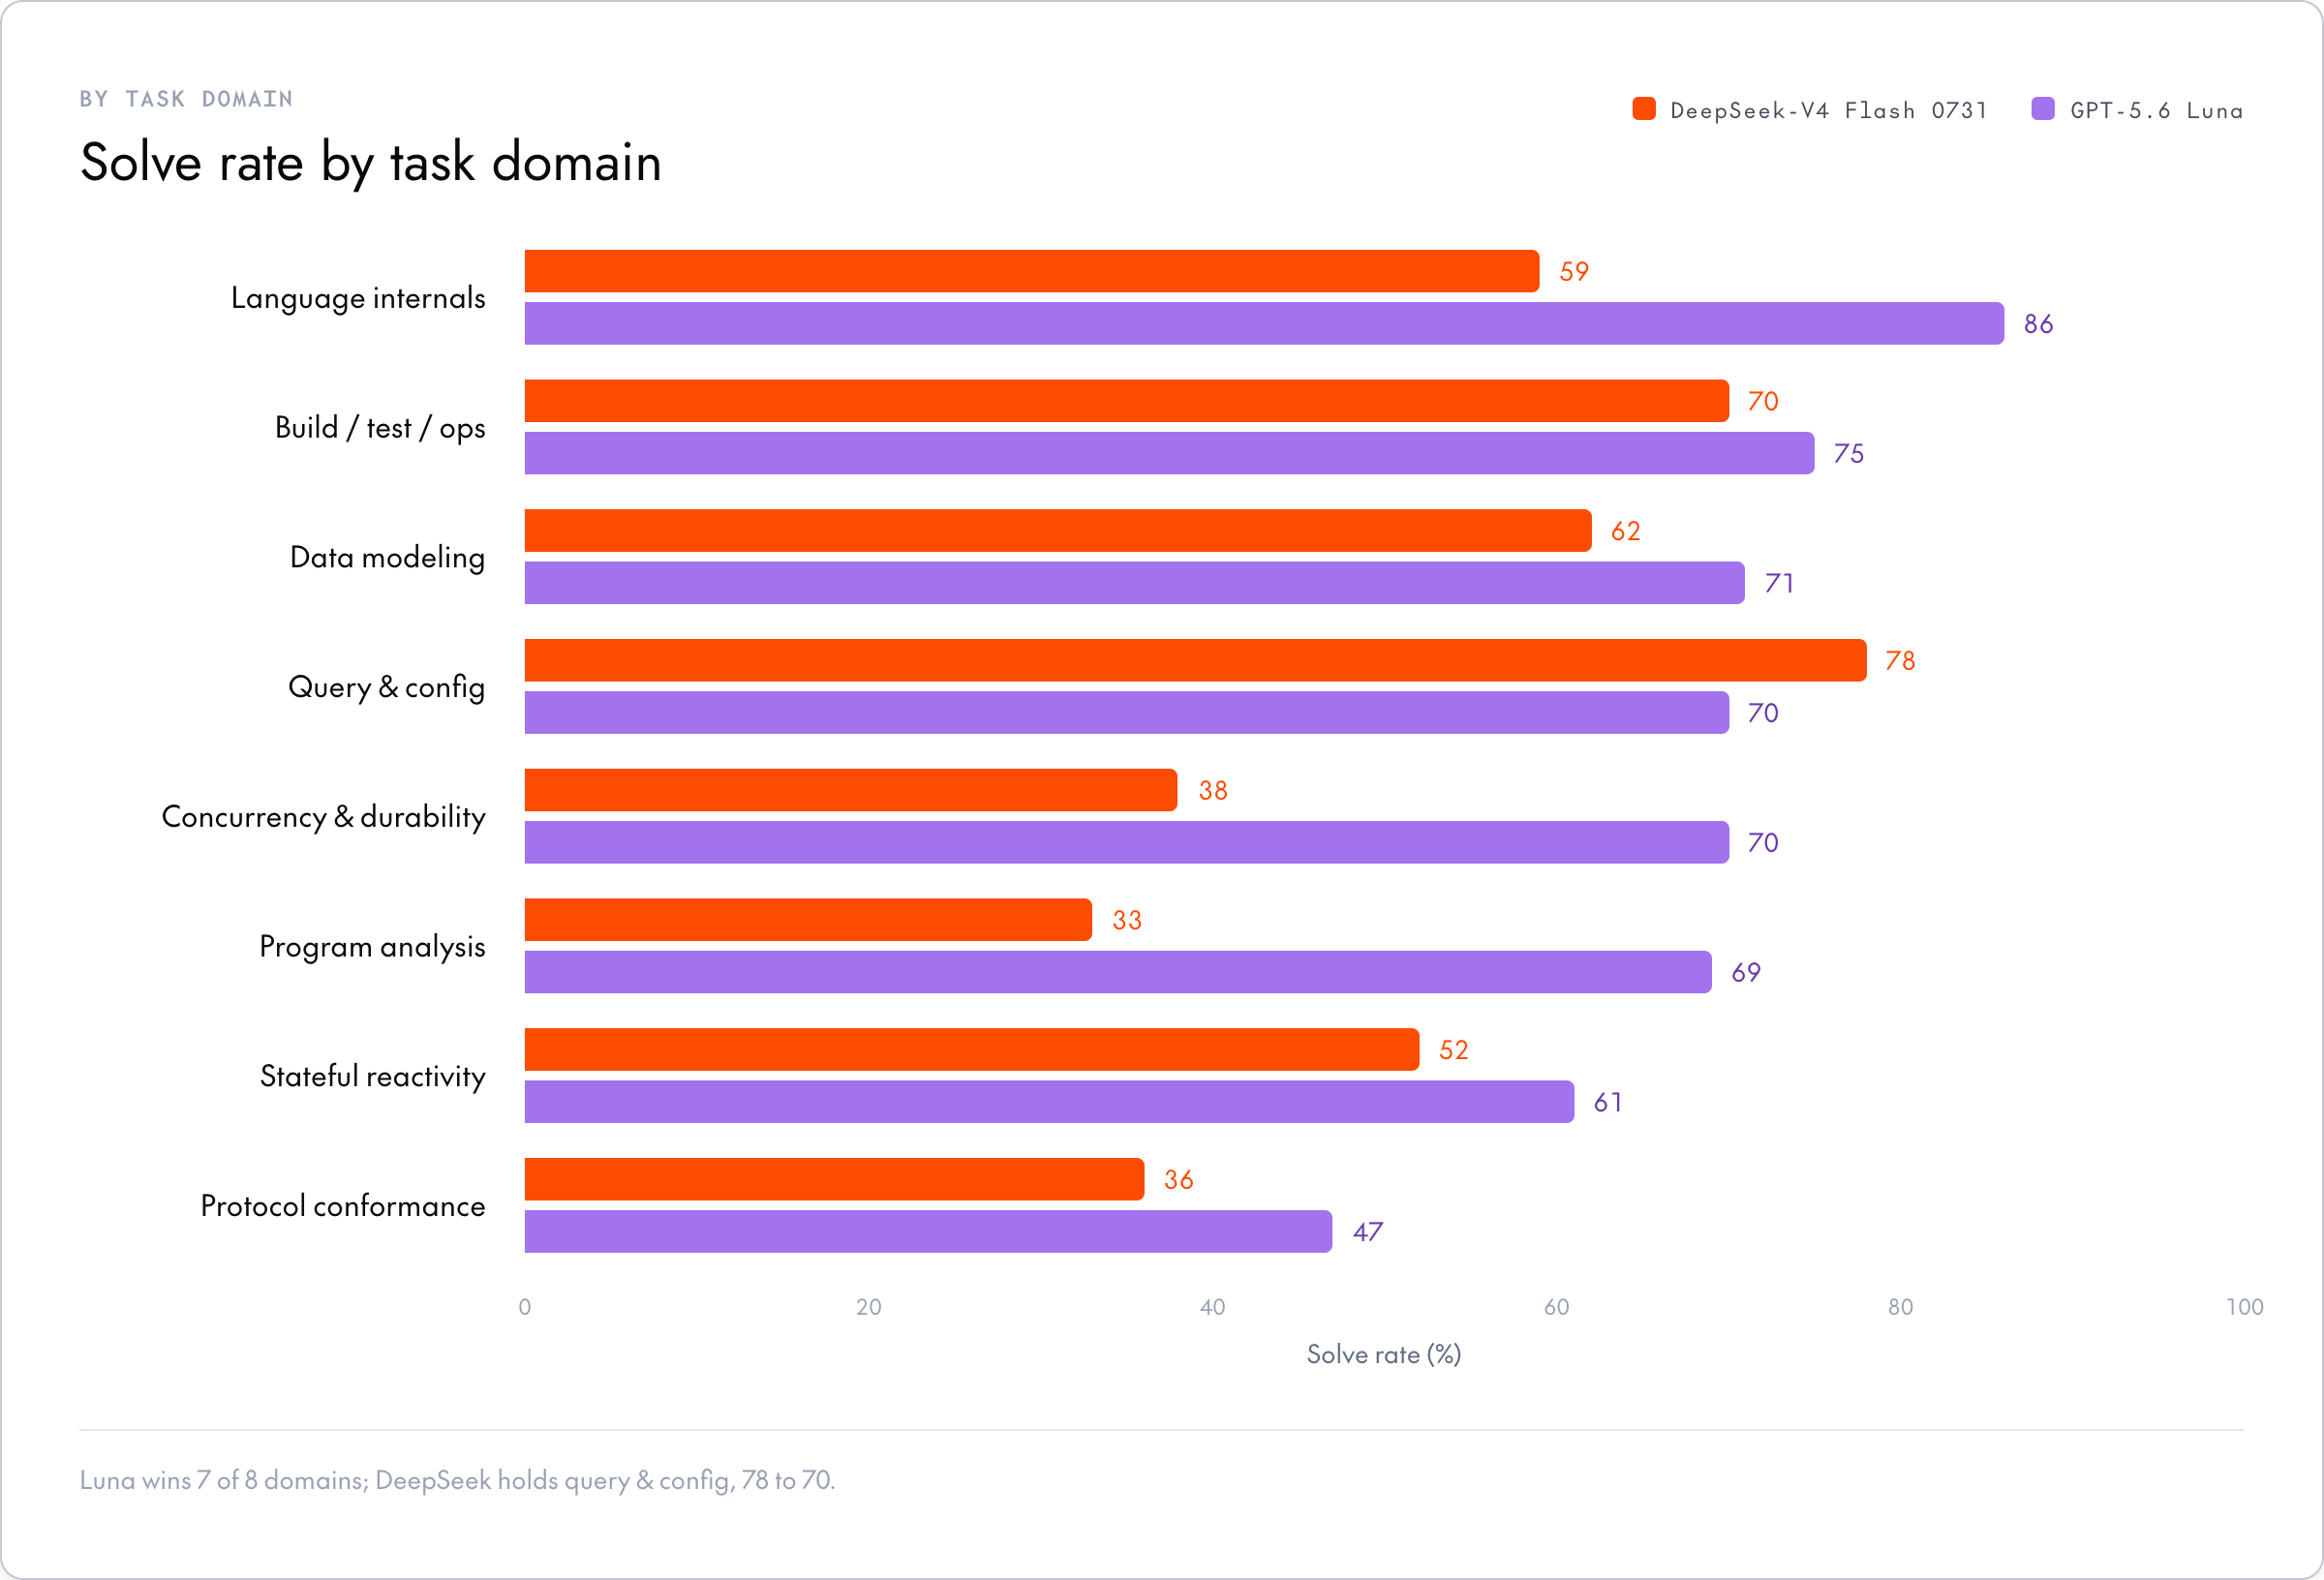
按任务领域对比 DeepSeek-V4 Flash 与 GPT-5.6 Luna
按代码的实际性质对 113 个任务分类,Luna 赢下 8 个领域中的 7 个。它最大的优势恰恰在需要大量推理的工作上:程序分析(69 对 33)、并发与持久性(70 对 38)、语言与运行时内部机制(86 对 59),每项大约相差 30 个百分点。这正是模型能力真正显现的地方,而 DeepSeek 在这里大幅落后。
DeepSeek 恰好守住了一个领域,而且很有代表性:查询与配置语言,78 对 70。涉及 SQL 构建器、窗口函数、keyset 分页、配置解析器等。结构化、符合模式、遵循约定的工作,正是这个便宜模型真正有竞争力、甚至领先的地方。凡是任务要求在整个系统范围内维持一个严苛不变量的地方,Luna 的能力就拉开了差距。
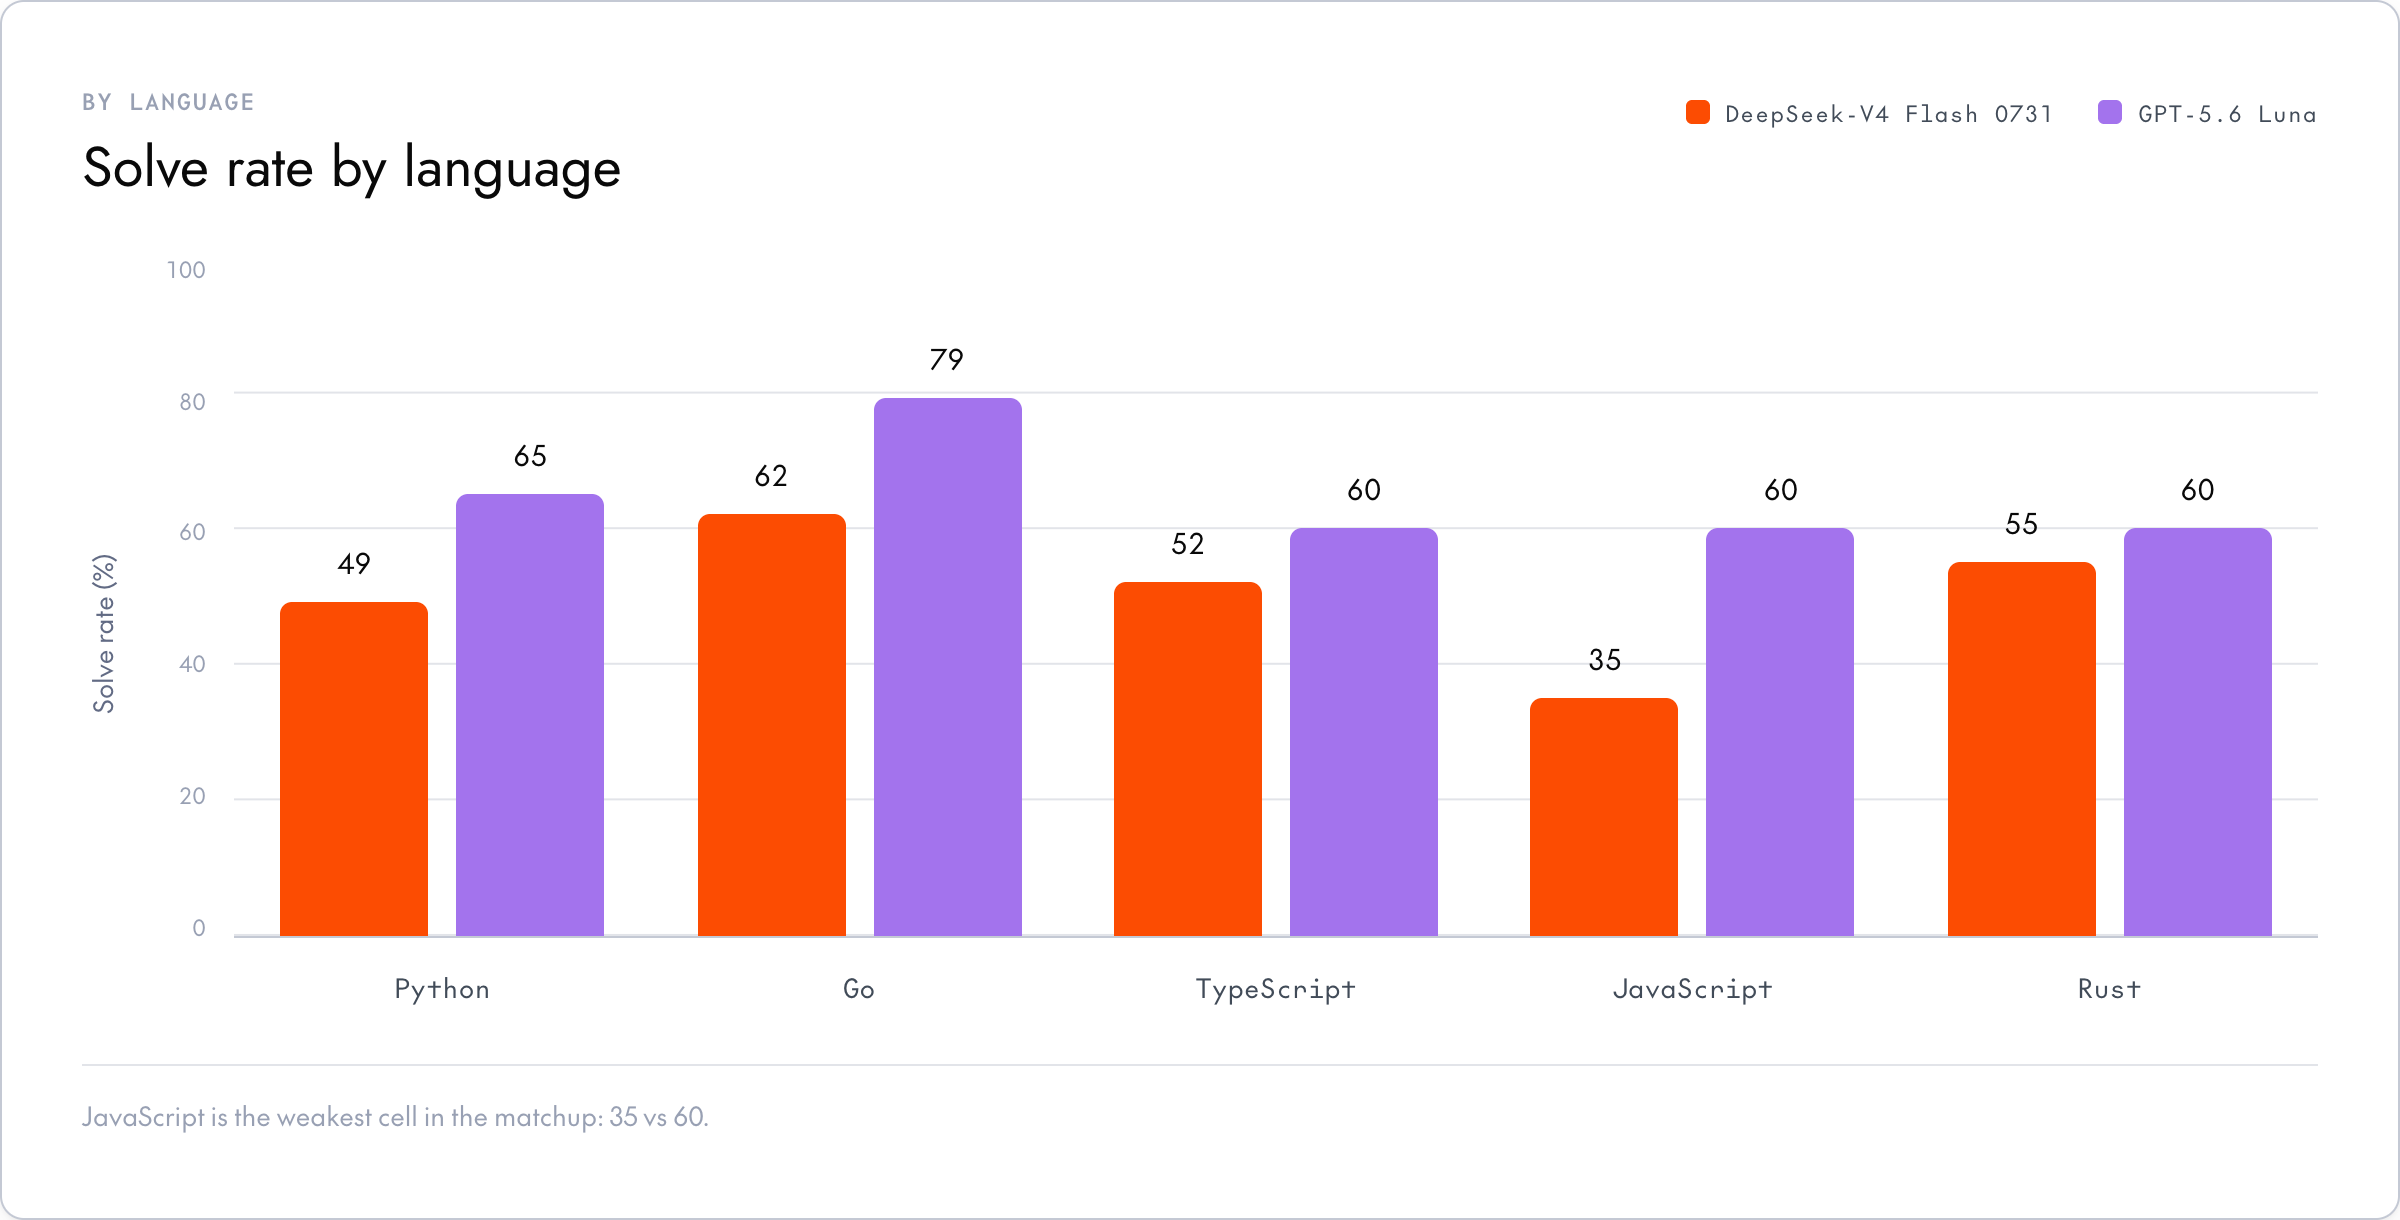
按编程语言对比 DeepSeek-V4 Flash 与 GPT-5.6 Luna
Luna 五种语言全胜,但差距大小提示了使用 DeepSeek 时该在哪里多加小心。它在 Rust(55 对 60)和 Go(62 对 79)上还算体面,但它的 JavaScript 表现崩塌:35 对 Luna 的 60,是整个对比中最弱的单项,落后 25 个百分点。DeepSeek 的 Python 也偏弱(49 对 65)。如果你的技术栈以 JS 为主,这个便宜的模型就是虚假的节省;如果是配置、查询或 Rust,DeepSeek 能缩小大部分差距。
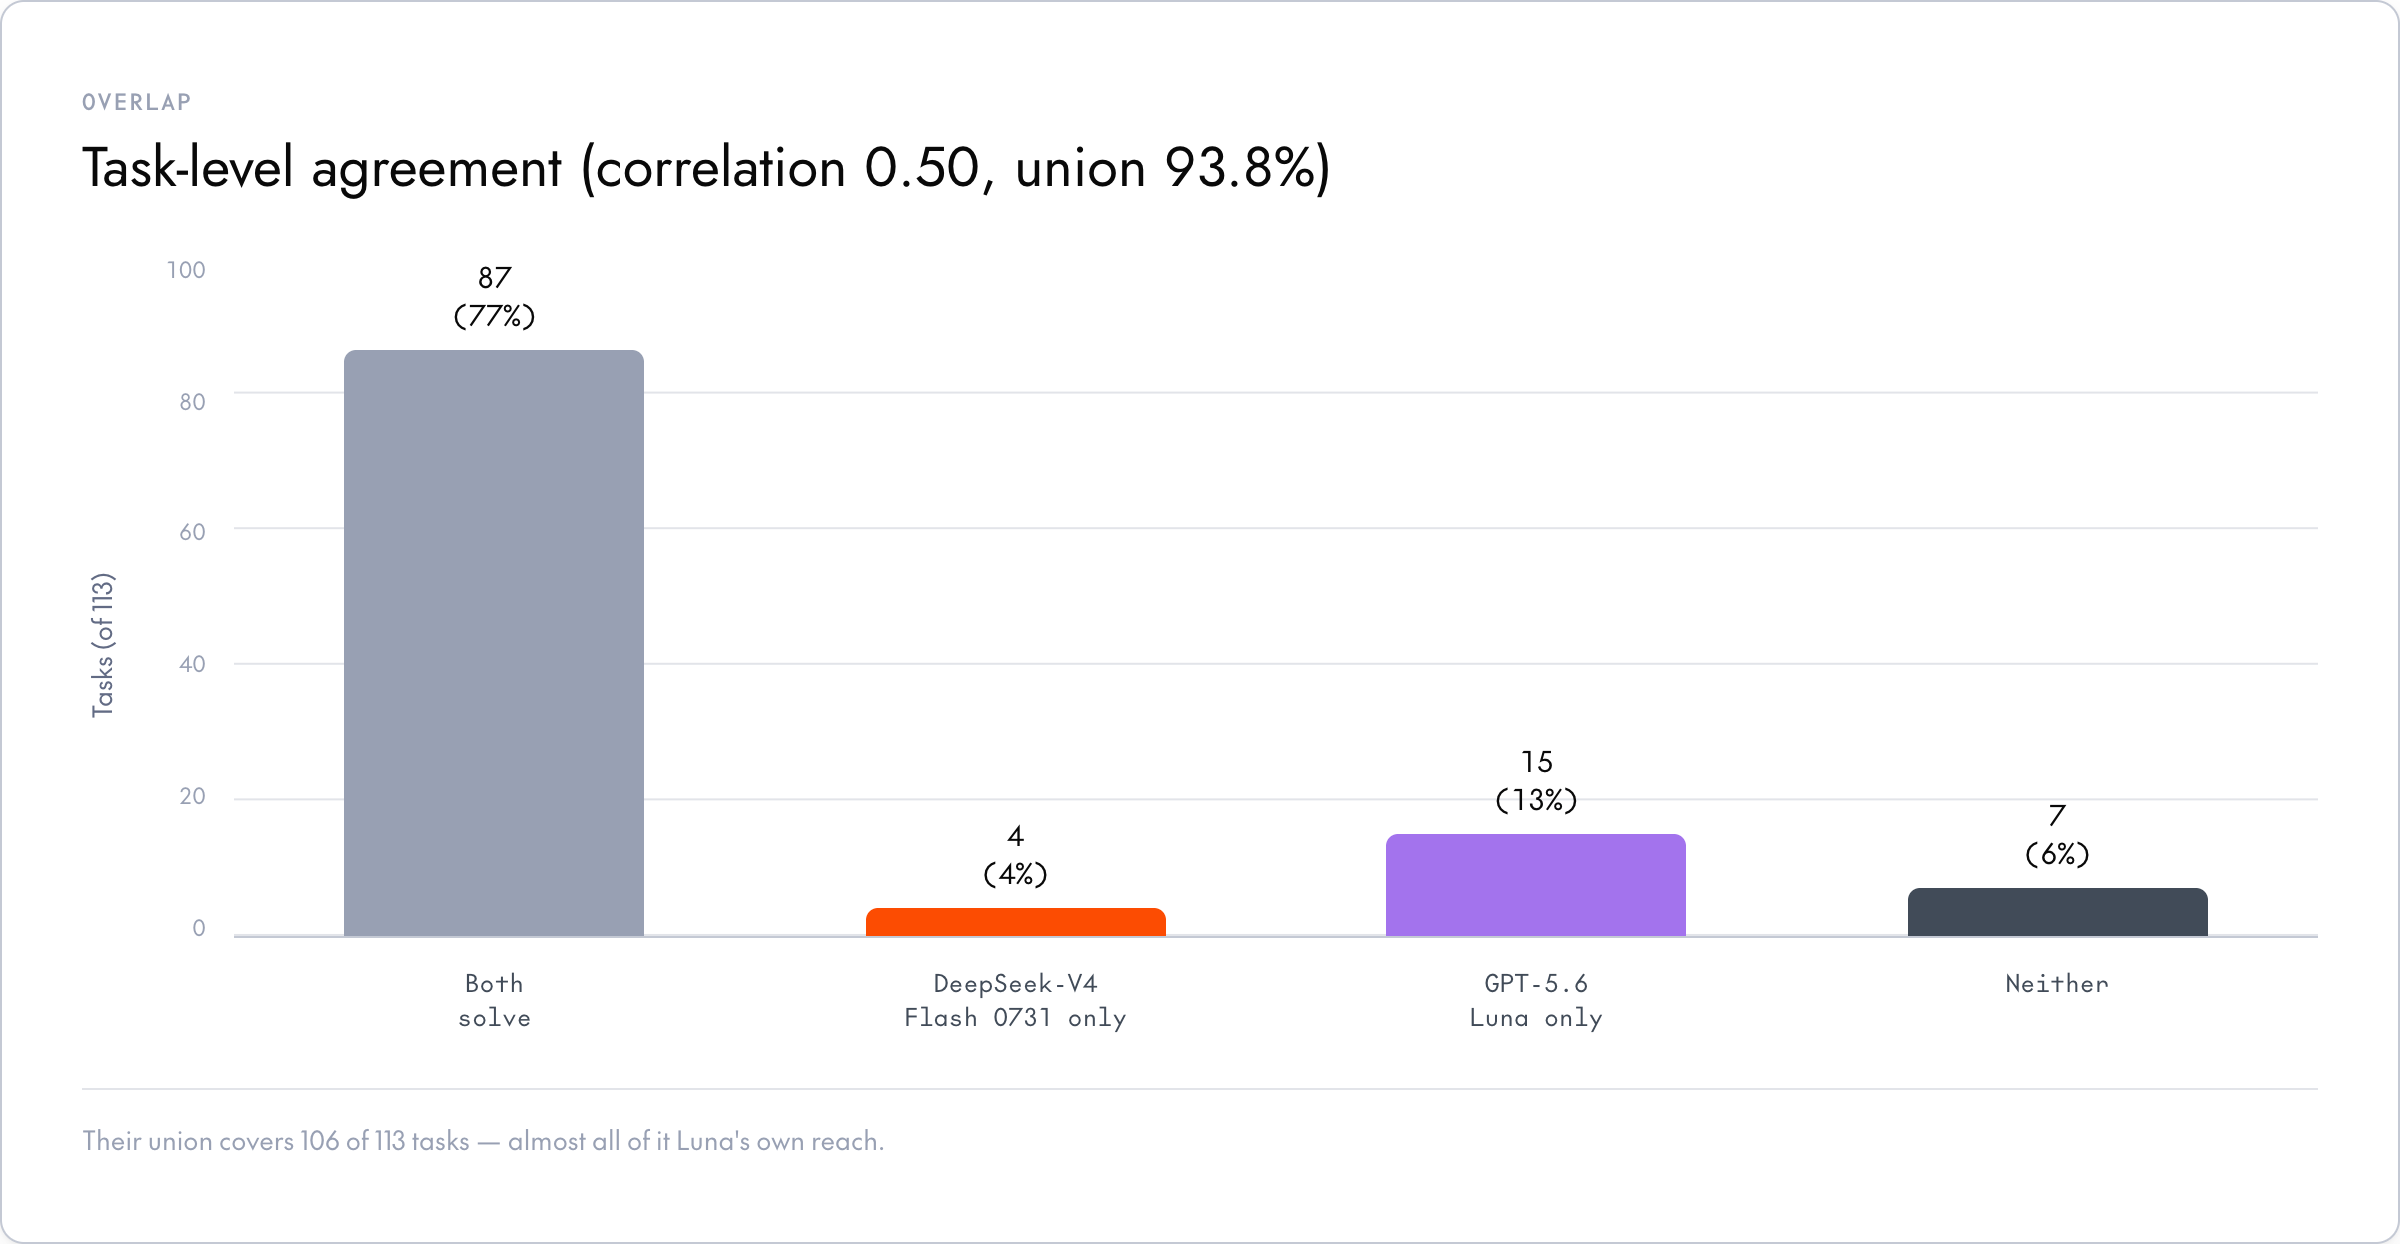
DeepSeek-V4 Flash 与 GPT-5.6 Luna 有多相似?
比低价档的那几对模型差异更小。逐任务相关系数为 0.50,而多样性是一边倒的:两者共同解决 87 个任务,Luna 独自解决 15 个,DeepSeek 独自解决的只有 4 个。关键在于,不存在 DeepSeek 四次全中而 Luna 完全失手的任务(有利于 DeepSeek 的四中零角落为零),而 Luna 有四个任务四次全中、DeepSeek 却从未做对(go-critic-doc-link-checker、langchain-request-coalescing、meriyah-explicit-resource-declarations、superjson-error-stack-serialization)。两者的并集覆盖 113 个任务中的 106 个(93.8%),但其中几乎全是 Luna 自己能覆盖的部分。作为单纯的多样性搭配,DeepSeek 贡献很少。
组合策略:为什么级联依然有效
所以这样的搭配本该毫无意义。但事实并非如此,原因在于价格。先运行 DeepSeek,只有当测试套件拒绝答案时才升级到 Luna:以每个任务 \$0.385 解决 78.9%。请仔细体会这一点。它比单独使用 Luna(67.2%)更准确,提高了 11.7 个百分点,也比单独使用 Luna(\$0.61)更便宜,每个任务成本约为 Luna 的 63%。
近乎免费的第一阶段就是全部诀窍:DeepSeek 以每个一角钱的价格清掉队列中大约 53% 的任务,因此 Luna 的费用只会落在困难的剩余部分上,而到达 Luna 的任务还会获得一次额外的独立尝试。这种级联甚至胜过完美的一次性预言机路由器(74.3%),因为两次出手胜过一次完美的选择。无论哪个模型打头阵,准确率都相同,但 DeepSeek 优先便宜得多(\$0.385 对 \$0.64),所以始终应让便宜的模型打头阵。
这一组合的上限是 93.8%;两者都从未解决的 7 个任务(包括 gql-incremental-graphql-delivery 和 bandit-structured-nosec-directives)需要的是一个更强的第三个模型,而不是更好的路由器。
这意味着什么
就其本身而言,DeepSeek-V4 Flash 0731 是一款中游水平的模型:有一个真正擅长的领域(查询与配置),失败特征干净,JavaScript 上有灾难性的短板,价格则无可匹敌。GPT-5.6 Luna 在每项质量指标上都是更好的工程师:pass@1 高 14 个百分点,赢下 8 个领域中的 7 个、全部 5 种语言,而且更快。你为此要付约 6 倍的价格,外加需要加以防护的 GPT 系列回归习惯。在每个任务 \$0.61 的价格下,这款旗舰模型其实相当便宜,在你看重质量时,它是顺理成章的默认选择。但 DeepSeek 最犀利的用法并不是替代 Luna,而是充当 Luna 的前端。一个只花一角钱、就能清掉一半工作的第一阶段,让你用低于旗舰自身的价格买到超过旗舰的准确率。当便宜的模型便宜到这种程度,级联就不再是一种妥协,而成了榜单上最好的一行。
现已上线 · 开放权重
在 Together AI 上运行 DeepSeek-V4 Flash
DeepSWE 榜单上最便宜的模型,每个任务约一角钱。无需前沿模型的 token 价格,即可在生产规模上提供这个廉价的第一阶段。
打开 Playground
附录:数据表
DeepSWE · 附录
DeepSeek-V4 Flash 与 GPT-5.6 Luna:完整数据表
| 指标 | DeepSeek-V4 Flash 0731 (max) | GPT-5.6 Luna (max) |
|---|---|---|
| pass@1(官方评分) | 53.3% | 67.2% |
| pass@1(错误计为失败) | 53.3% | 67.2% |
| pass@2 / pass@4 | 70.1 / 80.5% | 81.6 / 90.3% |
| 覆盖率 / 可靠性 | 80.5 / 66.2% | 90.3 / 74.8% |
| 稳定通过(4/4)/ 全部失败(0/4) | 23 / 22 | 43 / 11 |
| 每次 rollout 成本 / 总计 | $0.10 / $45 | $0.61 / $273 |
| 每 $100 解决数 | 532 | 110 |
| 中位数分钟数 / 步数 | 23 / 148 | 16 / 92 |
| 中位数峰值上下文 / 输出 token | 202k / 104k | 202k / 70k |
| 失败构成 | 69% 差一点,9% 回归 | 66% 差一点,15% 回归 |
| 赢下的领域数(共 8 个) | 1(查询 & 配置) | 7 |
| 赢下的语言 | 无 | 全部 5 种 |
| 逐任务相关系数 / 并集 | 0.50 / 113 个中的 106 个(93.8%) | |
| 级联 DeepSeek > Luna(准确率 / 成本) | 78.9% / $0.385 | 对比单独使用 Luna 67.2% / $0.61 |
| 预言机一次性路由器 | 74.3% | |
| 排行榜名次(共 52 种配置) | 第 30 名 | 第 13 名 |
| 基础设施错误 | 0 | 0 |
常见问题
GPT-5.6 Luna 比 DeepSeek-V4 Flash 更好吗?
就质量而言,是的。GPT-5.6 Luna 在 DeepSWE pass@1 上以 67.2% 对 53.3% 获胜,在每个相同尝试次数下都领先,赢下 8 个任务领域中的 7 个以及全部 5 种语言,而且速度更快。DeepSeek-V4 Flash 的优势在价格上,每次 rollout 大约便宜 6 倍,并且在失败时失败得更干净。
DeepSeek-V4 Flash 比 GPT-5.6 Luna 便宜多少?
在我们的运行中,DeepSeek-V4 Flash 每次 rollout 的成本约为 \$0.10,而 GPT-5.6 Luna 为 \$0.61,大约是六分之一的价格。按每个已解决任务衡量,DeepSeek 每 \$100 可解决 532 个任务,Luna 为 110 个,每美元完成的工作量约为 4.8 倍。
应该把 DeepSeek-V4 Flash 和 GPT-5.6 Luna 搭配使用吗?
应该,采用级联方式。先运行 DeepSeek,只有当测试套件拒绝其答案时才升级到 Luna,在我们的运行中以每个任务 \$0.385 解决了 78.9% 的任务:比单独使用 Luna(67.2%)更准确,也比单独使用 Luna(\$0.61)更便宜。始终让便宜的模型打头阵;两种顺序的准确率相同,但 DeepSeek 优先成本更低。
做编码任务,DeepSeek-V4 Flash 和 GPT-5.6 Luna 哪个更好?
在我们的分项统计中,Luna 赢下每一种语言,但差距各不相同。DeepSeek 在 Rust 上表现尚可,在查询和配置类工作上也有竞争力,甚至处于领先。它的 JavaScript 是整个对比中最弱的一项(35 对 60),因此以 JS 为主的技术栈不应只依赖这个便宜的模型。
DeepSWE 上的 pass@k 是什么?
pass@k 衡量的是对某个任务的 k 次尝试中,是否至少有一次通过隐藏的测试套件。pass@1 奖励一次就做对;更大的 k 则奖励那些经过多次尝试最终能得出解法的模型。DeepSeek 的 pass@2(70.1%)已经略高于 Luna 的 pass@1(67.2%),这正是并行尝试和级联方案在经济上成立的原因。