摘要
借助 Together AI 平台上的 Dedicated Model Inference,你可以让部署根据推理引擎真正能理解的指标自动扩缩容,例如在途请求数、TTFT、GPU 利用率和词元吞吐量。你可以设定副本数上下限,选择指标和目标值,再调整两个时间窗口,分别控制扩容的积极程度和缩容的耐心程度。理解并选对指标很重要,因为它决定了部署在流量陡峰下的表现,并直接影响用户感受到的延迟。下文会介绍如何选择自动扩缩容所依据的指标,并展示一个实验:同一份负载在三种不同的自动扩缩容策略下重放。
过度配置和配置不足,代价都很高
使用专用推理(dedicated inference)时,你按副本分钟付费,因此容量规划就是在两种失败模式之间取得平衡:
- 过度配置:你为 GPU 付费,让它们以 15% 的利用率空转,只为在峰值流量到来时(如果到来的话)能扛住。这几乎不可行,在当前 GPU 紧缺的环境下尤其如此。
- 配置不足:一旦流量超出副本能够批处理的范围,p95 就会急剧恶化。LLM 服务的性能退化是非线性的:达到并发上限的副本不会只是“慢一点”,而是开始排队,TTFT 可能从 200ms 飙升到 15s。
“直接自动扩缩容不就行了”是最显而易见的答案,对无状态 Web 服务来说通常也确实管用。但 LLM 服务是另一种情形,它打破了传统自动扩缩容依赖的两个假设:
- CPU 式指标会误报负载。GPU 利用率读数为 60% 时,引擎的请求队列可能已经在积压,因为利用率衡量的是算术强度,而不是压力。依据错误的信号来扩缩部署,意味着系统响应的是一个并不描述真实问题的数字。
- 冷启动可能需要数分钟。新副本需要被调度到 GPU 节点上,拉取数十 GB 的权重,加载进显存,再完成预热。这意味着你无法靠扩容来应对尖峰,因为等尖峰到来时再扩容已经太迟了。因此,好的自动扩缩容器的工作,是根据先行信号提前行动。
鉴于这些细微之处以及每位客户的需求各不相同,我们的平台提供了一套面向推理原生的指标目录,让你自行选择部署如何扩缩。这篇文章帮助你做出好的选择!
工作原理
每个部署都带有一份自动扩缩容策略:副本数上下限、一个或多个带目标值的扩缩容指标,以及时间窗口。
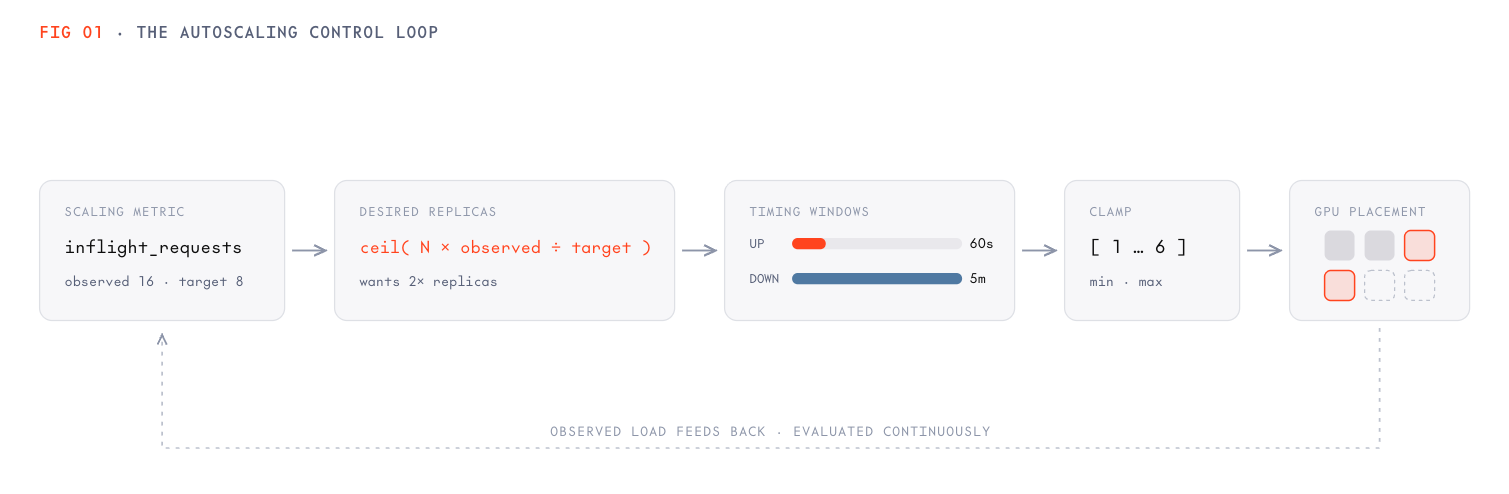
控制回路如下:观测到的指标 → 期望副本数(ceil(N × observed/target))→ 时间窗口进行平滑 → 限制在上下限之内 → GPU 调度。观测到的负载会反馈回来,回路持续评估,流量分配自动跟随容量变化。
核心回路是成比例的:如果你把目标设为每副本 8 个在途请求,而实际观测到 16 个,系统就会想要两倍的副本(前提是两倍副本仍在最小值和最大值范围内)。时间窗口可以起到去抖动的作用,避免副本数来回震荡:
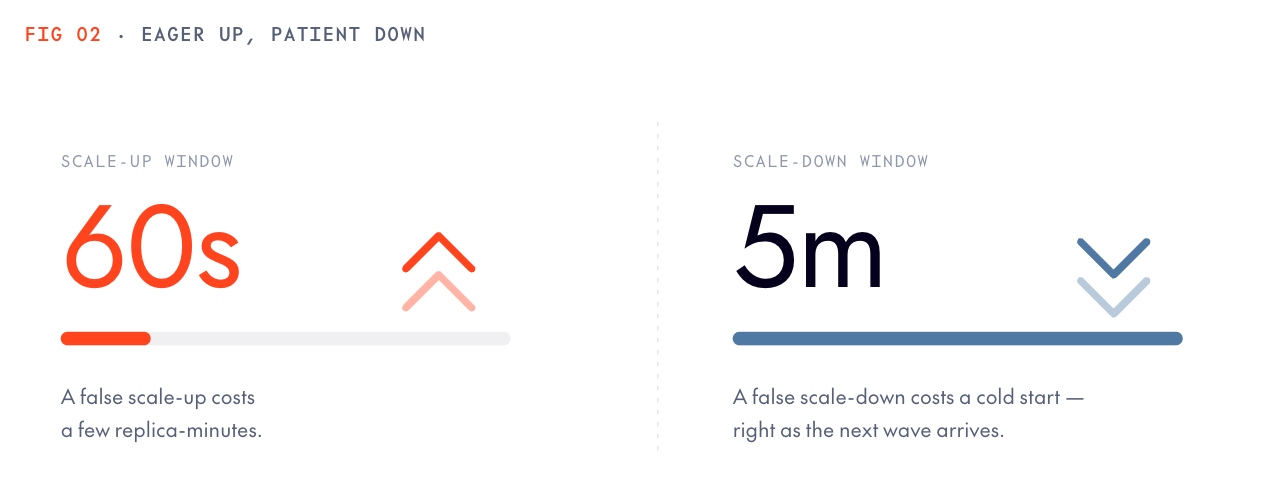
scale_up_window:压力需要持续多久才会增加副本。把它设短一些;误扩容的代价只是几个副本分钟,而漏扩容的代价是用户侧延迟上升。scale_down_window(默认 5m):系统需要保持平稳多久才会移除副本。把它设得比你的流量自然节奏更长;误缩容的代价可能是在下一个高峰到来时恰好遇上冷启动。
这种“扩容积极、缩容耐心”的非对称权衡,是调优中非常重要的一环,需要你对自身流量分布有直观的理解。扩容窗口的失误损失的是金钱,而缩容窗口的失误损失的是延迟以及金钱(因为你随后又得立刻扩回去,再付一次冷启动的代价)。
设置只需一次 PATCH:
tg beta endpoints update ""$DEPLOYMENT_ID" \
  --min-replicas 1 --max-replicas 6 \
  --scale-up-window 60s --scale-down-window 300s \
  --scaling-metric ttft --scaling-target 500 --scaling-percentile p95
有几项设置需要留意:
min_replicas == max_replicas:得到固定规模的部署,自动扩缩容实际上被关闭。- 两者都设为
min_replicas = max_replicas = 0→ 部署会停止(状态为STOPPED,停止计费)。这可以用来暂停你的开发端点。 - 给定一个范围即开启扩缩容;如果你设置了上下限但没有指定指标,平台会应用默认值:目标为 8 的
inflight_requests。
底层机制:可用于自动扩缩容的指标
共有八个指标可用于自动扩缩容。选哪一个,取决于你想保护部署免受什么问题的影响。
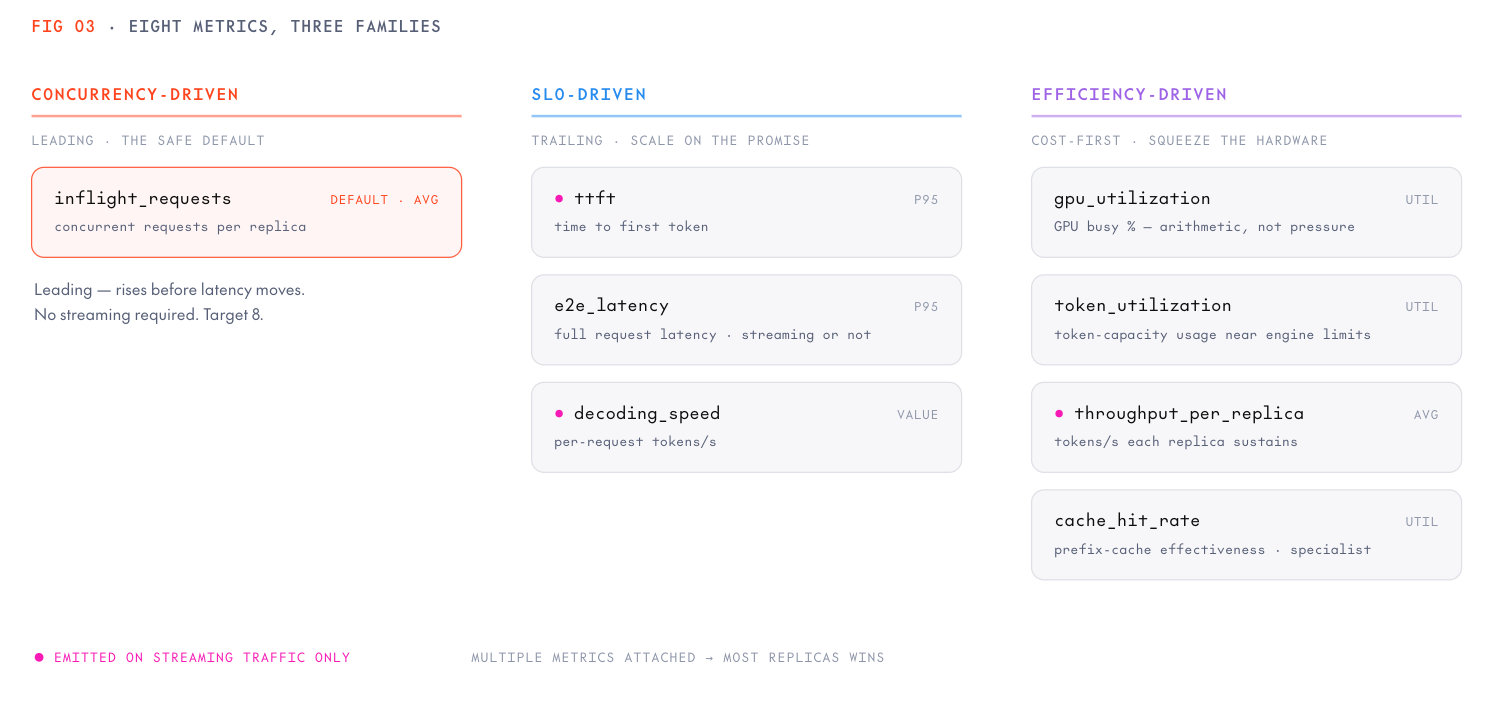
自动扩缩容指标包括并发驱动型(先行指标,安全的默认选择)、SLO 驱动型(滞后指标,按承诺扩缩)和效率驱动型(成本优先)。如果你附加了多个指标,则使用列表中的第一个。
选择合适指标,可以从三个角度来考虑:
- 并发驱动型(
inflight_requests)是安全的默认选择。在途请求数是先行指标:当需求超过服务能力时它就会上升,而此时延迟还没有明显恶化。该指标不需要流式传输,也不需要选择百分位,并且与引擎批处理请求的方式直接对应。该指标的目标值设为 8,表示“我希望每个副本同时处理大约八个并发请求”。对于批处理效果好的短提示词聊天负载,可以调高它;对于预填充耗时更长的编码智能体长上下文流量,则应调低。 - SLO 驱动型指标(
ttft、e2e_latency):如果你对用户的承诺是“一秒内出首个词元”,那么按ttft的 p95 来扩缩,正好瞄准这一点。延迟是滞后信号,这意味着等 p95 突破设定阈值时,用户已经能感觉到了,因此通常应将延迟指标与min_replicas中留出的充足余量搭配使用。 - 另一点要注意,按词元计的指标需要流式流量。
ttft、decoding_speed和throughput_per_replica只会在流式路径上产生。如果你的客户端不使用流式传输,这些指标就没有数据,你也不应基于它们构建自动扩缩容策略。(e2e_latency是个例外,因为它在流式和非流式负载下都会被测量。) - 效率驱动型(
gpu_utilization、token_utilization):把硬件潜力榨到极致。这类指标以成本为优化目标:让副本保持忙碌,只有当整个集群真正饱和时才增加容量。使用这些指标时,你需要明白“利用率”对你的工作负载究竟意味着什么。GPU 可能很忙,但负载的延迟表现并不健康,而且接近 100% 的利用率目标也不会给突发到达留出余量。如果你按利用率扩缩,就应该密切关注 Grafana 上的 p95 图表。
在选择扩缩容指标时,不妨把下面这张表记在心里:
| 指标 | 衡量对象 | 类型 | 适用场景 | TTFT p95 @ c16 |
|---|---|---|---|---|
| inflight_requests | 每副本的并发请求数 | AVERAGE_VALUE | 默认。稳健、先行、与引擎无关 | 368 ms |
| ttft | 首个词元时间 | VALUE • 百分位(默认 p95) | 你对响应速度有延迟 SLO | 323 ms |
| e2e_latency | 完整请求延迟 | VALUE • 百分位 | 对总完成时间有 SLO | |
| gpu_utilization | GPU 忙碌百分比 | UTILIZATION (0–100) | 成本优先、能容忍延迟波动的负载 | |
| token_utilization | 词元容量使用率 | UTILIZATION | 接近引擎上限的批处理/吞吐量型负载 | |
| throughput_per_replica | 每个副本持续的词元/秒 | AVERAGE_VALUE | 持续生成型流水线 | |
| decoding_speed | 单请求词元/秒 | VALUE | 保障每位用户的生成速度 | |
| cache_hit_rate | 前缀缓存的有效性 | UTILIZATION | 专项:重度依赖缓存的服务模式 |
空闲关停与冷启动
不存在“缩容到零并自动唤醒”。min_replicas: 0 只能与 max_replicas: 0 一起使用,后者是显式停止部署的方式。唤醒需要显式操作,向已停止的部署发送请求只会返回错误,而不会触发启动。这意味着,你应围绕自动停止加显式重启窗口来规划开发和预发布端点。
tg beta endpoints update dep_abc123 --min-replicas 0 --max-replicas 0 # explicit stop
使用这一自动停止功能时,理解冷启动预算很重要。你可以把冷启动看作由以下阶段组成:GPU 调度 → 权重下载 → 引擎加载 → 预热,部署的事件流会为其中每个阶段打上时间戳(pod.startup_phase_changed):
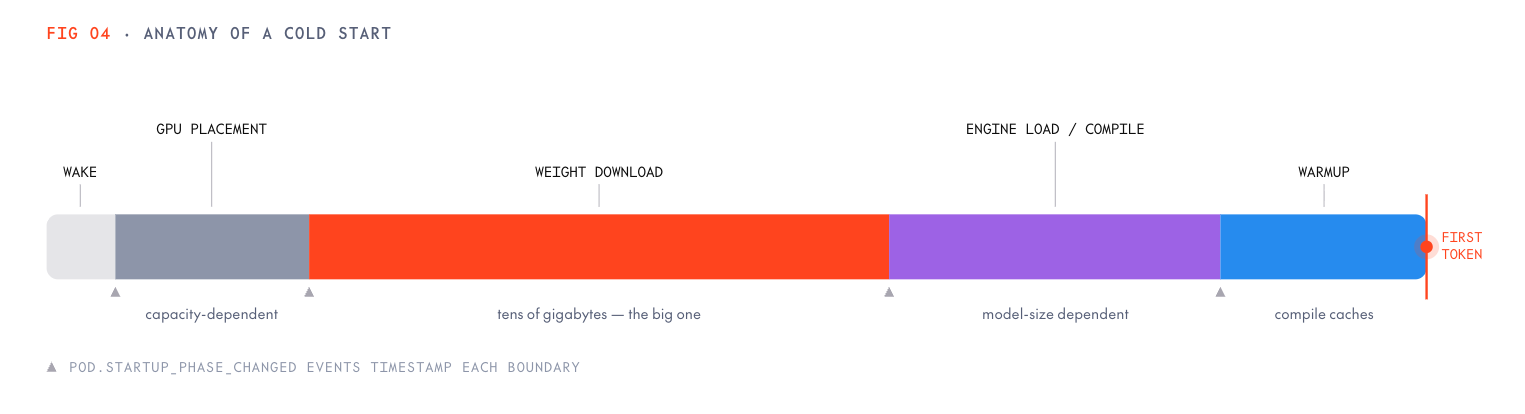
更大的模型,其权重下载、引擎加载和预热时间可能会相应更长。为了让你对这些数字有更直观的感受,下面给出我们在预热完毕的集群上用 1×H100 副本多次运行得到的结果:
| 场景 | 实测 |
|---|---|
| 基础目录模型(Qwen3.5-9B),创建 → 副本 READY | 86s(PullingImage 约 30s → Starting 约 30s → 就绪) |
| 自定义微调模型,全新的 18GB 权重,创建 → READY | 145s |
| 副本 READY → 经路由服务首个词元 | +26–40s |
| 从 1 个扩容到 2 个副本 | 约 2.5 min |
| 从 STOPPED 重启(权重已在平台侧) | 约 1–2 min |
请注意,这些窗口以分钟计,这意味着只有当两次使用之间的间隔相对于重启耗时足够长,并且空闲期过后的第一位用户愿意接受显式启动(或“报错后重试”的流程)时,自动停止才划算。这种权衡对开发和预发布端点来说没问题,但对于有 p95 SLO 或存在无人值守调用方的端点,通常应保持 min_replicas: 1。
边缘情况
尖峰到来的速度比冷启动还快,实际会发生什么?
请求会在现有副本上排队(inflight_requests 和引擎队列深度会上升),延迟随之恶化,先是 TTFT 上升,随后在新副本启动期间出现错误/超时风险。这意味着,如果你的流量能在 90 秒内飙升 10 倍,而冷启动需要 4 分钟,那么唯一的防线就是 min_replicas 余量,或者采用目标值更高、能保留冗余容量的策略。这更多是容量形态的问题,而不是调优问题,最好在上线日之前就解决。
自动扩缩容会和发布(rollout)打架吗?
不会。发布进行期间,平台会锁定两个部署的自动扩缩容上下限;否则发布过程中的副本数会被某次缩容决策在中途撤销。发布完成或中止后,你配置的上下限会自动恢复。
扩缩容如何与流量拆分相互作用?
这一点处理得很顺畅:流量拆分的权重是按就绪副本计算的(容量 = 权重 × 就绪副本数),因此自动扩容的部署会按比例自动承接更多流量,无需任何路由变更。自动扩缩容和路由依据的是同一幅容量图景。
为什么我的副本数看起来像锯齿?
这是缩容窗口短于流量自然节奏的典型症状。突发流量加上 1 分钟的缩容窗口,就会在每个波谷缩容、在每个波峰冷启动。要解决这个问题,你应该调大 scale_down_window,直到锯齿被抹平。这样你只需多付出几个副本分钟,就能避免反复的冷启动。
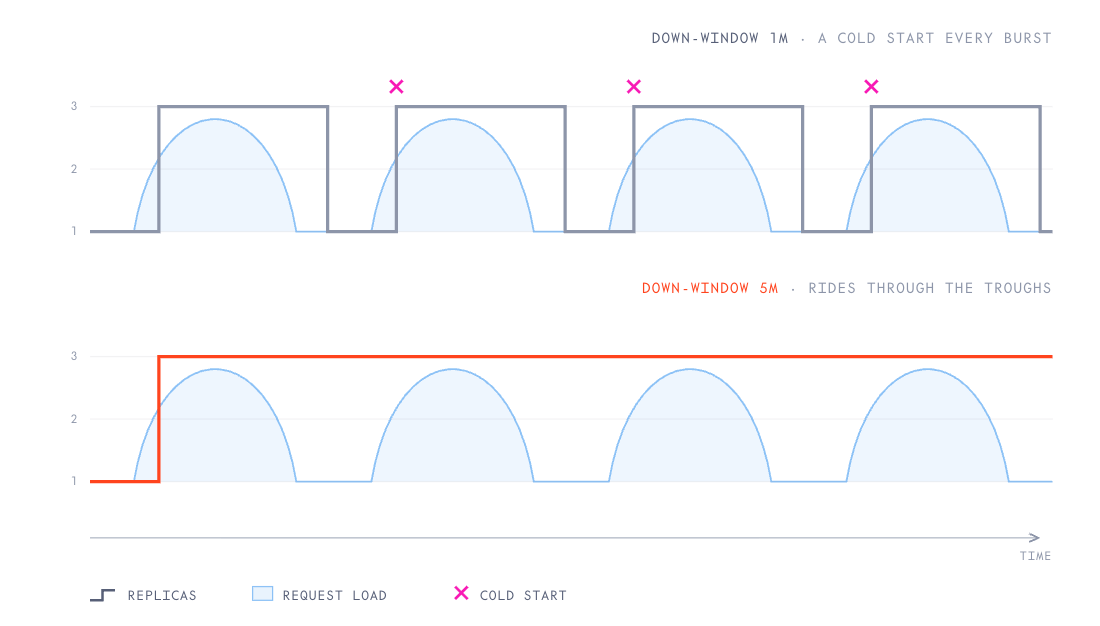
用不同策略对同一负载进行自动扩缩容
我们在一个 Qwen3.5-9B 部署上进行了这项实验(每个副本 1×H100,上下限为 1–3),每轮之前都重置为恰好 1 个副本,然后把同一份脚本化负载重放三次:一条在约 12 到 48 RPS 之间变化的正弦波,叠加两次 80 rps 的尖峰。实验在三种不同的自动扩缩容策略下重复进行:
inflight_requests目标 8ttftp95 目标 300 msgpu_utilization目标 75%

| 策略 | 是否扩缩? | 副本分钟 | 请求数(错误数) | 发生了什么 |
|---|---|---|---|---|
| inflight_requests (8) | 1→2→3 | 26 | 40.6k (536) | 对每一波负载都做出反应;其额外容量明显降低了窗口中段的 p95 |
| ttft p95 (300ms) | 从未 | 18 | 46.4k (6) | 引擎的 TTFT 始终低于目标;未观察到扩缩容 |
| gpu_utilization (75%) | 从未 | 18 | 46.5k (2) | 利用率从未越过 75%;未观察到扩缩容 |
从上述运行中可以得到三点经验:
- 只有并发信号触发了扩容。在这份负载下,客户端 p95 达到 3–5 秒,显然已经饱和,但
ttft策略从未扩容,因为引擎侧的首个词元时间一直很低:引擎的连续批处理把队列压力吸收进了总延迟,而不是首个词元延迟。而gpu_utilization也从未扩容,因为短而突发的请求让 GPU 始终没有达到 75% 的门槛。这两种策略读到的信号看起来都很健康,而系统其实已经饱和。inflight_requests作为直接反映队列压力的信号,是唯一发现问题的指标,这正是它成为默认值的原因。 - 容量带来的帮助正如预期。在 inflight 策略维持 2 个副本的那段时间里(约第 6–11 分钟),在完全相同的负载下,它的 p95 明显低于单副本的各策略,中间的图表清楚显示了这一差距。
- 选择策略之前,先摸清单个副本的饱和点。一个副本能在 3–5s 的 p95 下支撑 12–48 rps 而不崩溃,但如果你的 SLO 是 500 ms,这就行不通。
亲自试试吧!
先从默认值开始,再依据证据调优:
- 设置真实的上下限(
min= 基础负载所需,max= 预算所能承受),并采用默认的inflight_requests目标 8。 - 在 metrics API 中观察一周的流量:副本数、队列压力、p95。
- 然后再调优:有延迟 SLO → 增加
ttft策略(如果你使用流式传输);有成本压力 → 尝试利用率指标,并如实监控 p95;出现锯齿 → 调大缩容窗口。