我们正在为 transformers 添加高效运行 GGUF 模型的支持,这样你就可以通过熟悉的 transformers API,使用大小适合笔记本内存的检查点。从 Hub 上挑一个 GGUF,用 from_pretrained 加载,就可以在自己的机器上开始生成。
在笔记本电脑上运行 AI 模型已经容易了很多,llama.cpp 功不可没。它的推理引擎为 Ollama、LM Studio 和 Jan 等本地 AI 工具提供动力。与 MLX 等项目一起,它让本地推理成为日常使用中切实可行的选择。
最近有一个例子,可以看出本地 AI 给人的感受:
GGUF 由 llama.cpp 团队开发,是广泛使用的本地推理格式。该团队还在 Hub 上的 ggml-org 下分享量化检查点。Unsloth、LM Studio Community 和 bartowski 等发布者也提供了多种量化级别的开箱即用 GGUF 检查点,用户可以选择适合自己机器的版本。GGUF 模型已被下载数百万次。
我们也希望让用 transformers 在本地运行这些模型变得更容易。兼容性只有在模型运行起来体验良好时才有价值。为了让性能接近 llama.cpp,我们通过 kernels 库复用其底层的 ggml 内核,并降低 generate 中的开销。我们最初的重点是 Apple Silicon 上的本地推理,从 Qwen3.5 架构开始。
什么是 GGUF 文件格式?
GGUF 把模型权重和元数据(包括分词器信息和可选的聊天模板)打包在一个文件中。它支持不同的量化级别,让你以牺牲一些精度为代价换取更小的内存占用。Q4_K_M 等变体混合了不同的张量精度,大部分权重使用 4 比特,同时让敏感张量保持更高精度。
下面是量化如何改变 Unsloth 的 Qwen3.5-4B 的文件大小:
| GGUF 变体 | 文件大小 | 取舍 |
|---|---|---|
BF16 |
8.42 GB | 未量化的参考版本 |
Q6_K |
3.53 GB | 精度高于更小的变体 |
Q5_K_M |
3.14 GB | 大小与精度之间的折中 |
Q4_K_M |
2.74 GB | 本地推理切实可行的起点 |
我们建议从 Q4_K_M 开始,如果有更多内存,再尝试 Q5_K_M 或 Q6_K。更激进的量化可以让更大的模型装得下,但质量上的取舍取决于模型和任务。请在你真正希望模型完成的工作上进行评估。Hub 的 GGUF 文档介绍了可用的量化类型。
用 transformers 加载 GGUF
开始之前,你需要:
- 一台 Apple Silicon Mac。
- 已发布的 ggml-quantization 内核构建所支持的 PyTorch 版本,通常是最新的两个 PyTorch 版本。
- 最新版本的 transformers(在下一个版本发布前暂用 main 分支)以及兼容版本的
kernels。
pip install -U "git+https://github.com/huggingface/transformers.git" kernels
要加载 GGUF 模型,把它在 Hub 上的 model_id 和文件名作为 gguf_file 传给 from_pretrained。
无需额外配置:当权重在 Metal 上保持打包状态时,transformers 会自动加载兼容的 ggml/Metal 层内核,并使用 ggml-org/ggml-attn 作为注意力实现。如果无法获取该内核,模型会带着警告回退到 "sdpa",你也可以通过显式传入 attn_implementation="sdpa" 来强制使用 "sdpa"。更多加载选项请参阅 GGUF 文档。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "unsloth/Qwen3.5-4B-GGUF"
filename = "Qwen3.5-4B-Q4_K_M.gguf"

tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    gguf_file=filename
)
这是唯一与 GGUF 相关的步骤。之后的一切都是标准的 transformers API:
messages = [{"role": "user", "content": "Explain why the sky is blue in a few sentences."}]
inputs = tokenizer.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_dict=True,
    return_tensors="pt",
).to(model.device)

with torch.inference_mode():
    outputs = model.generate(**inputs, max_new_tokens=256)

print(tokenizer.decode(outputs[0], skip_special_tokens=True))
如果没有兼容的量化内核,加载器会回退为将模型反量化,并占用更多内存。
用你喜欢的界面来服务 GGUF
你也可以把同一个检查点用于 transformers serve,它提供与 OpenAI 兼容的 API:
pip install -U "transformers[serving] @ git+https://github.com/huggingface/transformers.git" kernels

transformers serve "unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf"
model 参数使用 <model_id>:<filename>.gguf:冒号之前是 Hub 仓库(unsloth/Qwen3.5-4B-GGUF),之后是要加载的文件(Qwen3.5-4B-Q4_K_M.gguf)。这样可以从可能包含多个量化版本的仓库中选定某一个。
对于聊天模板支持思考的模型,添加 --reasoning off 可跳过思考,添加 --reasoning on 可启用思考。默认值 --reasoning auto 遵循聊天模板的默认设置。详情请参阅推理选项。
你可以通过添加一个与 OpenAI 兼容的自定义提供方并使用下面的设置,来连接 Jan 或 Pi 等客户端:
| 设置 | 值 |
|---|---|
| Base URL | http://localhost:8000/v1 |
| Model ID | unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf |
transformers 在你的 Mac 上运行模型,而客户端提供对话界面。其他支持该 API 的客户端也可以使用同一个端点。
与 llama.cpp 的基准测试对比
我们衡量本地推理性能的参照是 llama.cpp。下面的比较聚焦于三个 GGUF 检查点:一个小型稠密模型、一个较大的稠密模型和一个混合专家(mixture-of-experts)模型。
llama.cpp 一列的数据来自 llama-bench 工具(构建 5f55650a7,版本 b10200,使用 ggml 0.18.0 的 Metal 后端),以 llama-bench -m <file> -p 0 -n 128 -r 3 方式运行,报告 tg128:即 128 个解码词元的 token 生成速率,三次重复取平均,不含提示词处理。transformers 一列是 generate 从 12 个词元的提示词生成同样的 128 个词元,取三次预热运行中的最佳值,并包含预填充(prefill)。
测试环境:MacBook Pro M2 Max,32 GB 统一内存,macOS 26.6,PyTorch 2.12.1,kernels 0.17.0,接通电源。
基准测试脚本
import time
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id, filename = "unsloth/Qwen3.5-4B-GGUF", "Qwen3.5-4B-Q4_K_M.gguf"

model = AutoModelForCausalLM.from_pretrained(model_id, gguf_file=filename)
tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
inputs = tokenizer("The capital of France is Paris. The capital of Germany is", return_tensors="pt")
inputs = inputs.to(model.device)


with torch.inference_mode():
    model.generate(**inputs, max_new_tokens=8, min_new_tokens=8, do_sample=False)  # warm up
    torch.mps.synchronize()
    for _ in range(3):
        time.sleep(90)  # let the machine cool: back-to-back runs decay by 10% or more
        start = time.perf_counter()
        model.generate(**inputs, max_new_tokens=128, min_new_tokens=128, do_sample=False)
        torch.mps.synchronize()
        print(f"{128 / (time.perf_counter() - start):.1f} tok/s")
另一列的脚本:
llama-bench -hf unsloth/Qwen3.5-4B-GGUF:Q4_K_M -p 0 -n 128 -r 3
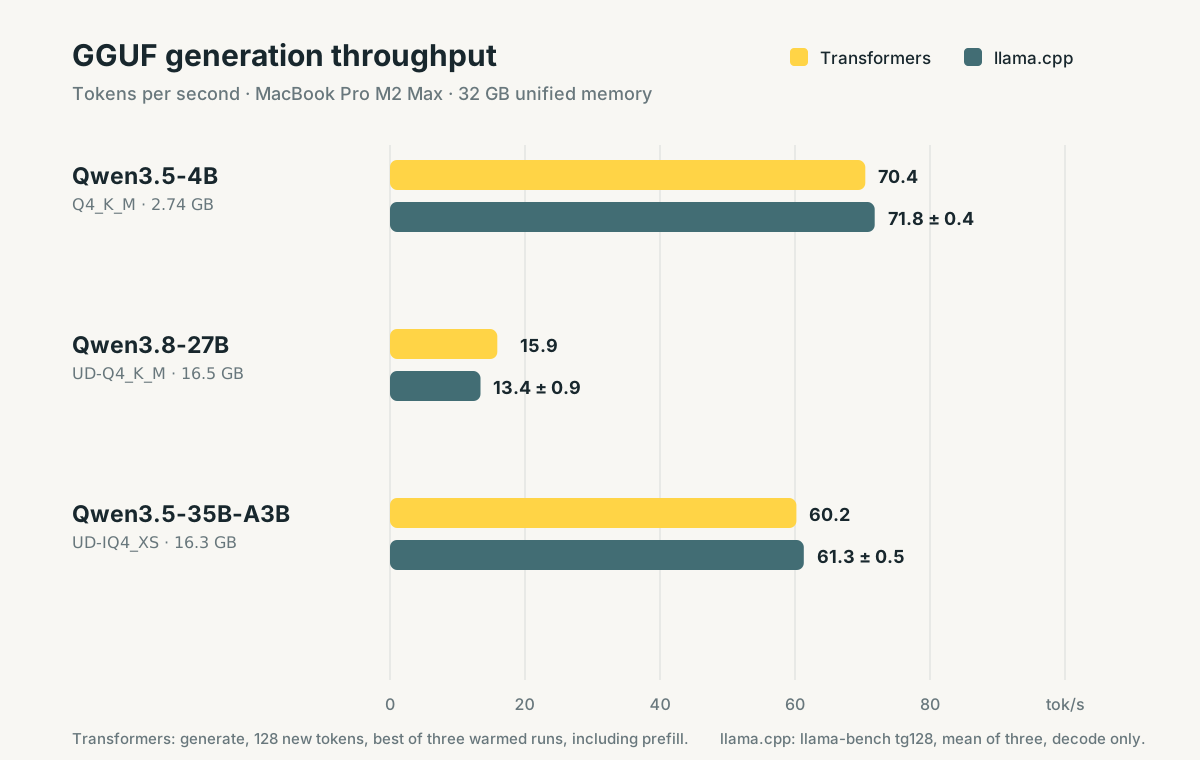
在这三个检查点上,Transformers 都与 llama.cpp 相当接近。图表使用的是上述同样的测量数据;这并不意味着基准测试条件完全相同,因为 Transformers 的测量包含预填充,而 llama-bench 报告的是仅解码的吞吐量。
transformers 与 llama.cpp
当 GGML 和 llama.cpp 加入 Hugging Face 时,我们阐述过它们互补的角色:llama.cpp 为本地推理提供基础,而 transformers 为模型定义提供基础。对 GGUF 的支持让这两者更加靠近。
如果你的首要目标是高效的本地推理,llama.cpp 仍然是我们推荐的引擎。它专用的运行时、内存管理和广泛的硬件支持都是围绕这一目标构建的。这次集成为开发者提供了一种便捷的方式,可以在 transformers 中使用同样的 GGUF 检查点:
- 在 Python 和 PyTorch 中试验 GGUF。使用钩子检查中间激活,修改模型的前向传播,或用熟悉的 PyTorch 工具原型化自定义层。
- 评估 GGUF 模型。使用你现有的 transformers 评估工作流来衡量量化检查点的质量。
- 验证 GGUF 转换。对我们开发者来说,在 transformers 中同时加载原始检查点及其 GGUF 转换版本,可以更容易地检查权重是否被正确转换(需考虑量化误差)。
- 尝试新的解码思路。配合
generate使用自定义的 logits 处理器和停止条件,或者用 Python 编写你自己的生成循环。 - 从 GGUF 检查点出发进行微调。将权重反量化,然后沿用标准的 transformers 训练工作流继续。
对于最后这种情况,请使用 GgufConfig(dequantize=True):
import torch
from transformers import AutoModelForCausalLM, GgufConfig

model = AutoModelForCausalLM.from_pretrained(
    "unsloth/Qwen3.5-4B-GGUF",
    gguf_file="Qwen3.5-4B-Q4_K_M.gguf",
    quantization_config=GgufConfig(dequantize=True),
    dtype=torch.bfloat16,
)
超越 GGUF:为更多模型提供 ggml 内核
更大的机会在于,把 ggml 的性能带给 llama.cpp 不支持的模型。
transformers 已经提供了这些架构的 PyTorch 实现。有了可在 PyTorch 中使用的 ggml 内核和量化方案,我们就可以着手加速这些架构所支持的算子,而不必先在 llama.cpp 中实现整个模型。这对新架构、研究模型以及可能永远得不到专门的 llama.cpp 实现的自定义变体尤其有用。
这一机会不止于 GGUF 格式本身。内核作用于张量,并不要求整个模型来自 GGUF 文件。同样的构建模块可以集成到其他 transformers 模型和加载工作流中。这也为其他模态打开了一条路:计算机视觉模型、音频模型和多模态模型可以复用兼容的注意力、归一化和矩阵乘法内核,而无需先在 llama.cpp 中有完整的实现。每种架构仍然需要集成和验证;这里最初的 GGUF 示例涵盖的是文本生成。
用 Python 和 PyTorch 实现快速的本地推理
我们还想展示,在把模型和生成循环保留在 Python 中的前提下,能走多远。有了合适的内核和高效的生成循环,Python 和 PyTorch 也能提供出色的本地推理性能。内核负责繁重的计算,而生成循环通过避免不必要的同步,让 GPU 保持忙碌。
我们的重点是在不依赖 torch.compile 的情况下让 eager 执行变快。对于交互式使用,我们希望启动迅速、词元持续稳定地输出,没有编译停顿,也不会在输入形状变化时重新编译。这项工作的两个主要部分是内核和 generate 本身。
复用 ggml 的 Metal 内核
内核是在 GPU 上执行某项操作的小程序。PyTorch 提供通用实现;而专用内核可以做更少的工作、合并多个操作,或者直接以存储格式读取量化权重。
借助 kernels 库,我们可以在 Hub 上分发与 ggml 的 Metal 内核兼容的构建版本,并在 transformers 中直接调用。这样一来,ggml 的成果就被带入了 PyTorch 模型,而无需用一个独立的推理运行时取代该模型。
| 内核 | 作用 |
|---|---|
ggml-quantization |
读取打包的量化权重来完成矩阵运算,包括 MoE 模型中被选中的专家。它避免了在每次解码操作前把整个权重矩阵展开。 |
ggml-norm |
融合归一化操作,包括 Qwen3.5 和 Qwen3.8 使用的零中心化 RMSNorm。 |
ggml-attn |
为提示词处理和词元解码提供 ggml 的 Metal flash attention。 |
ggml-gated-delta-net |
加速 Qwen3.5 和 Qwen3.8 混合架构线性注意力层中使用的门控 delta 网络(gated delta network)。 |
topk |
为 MoE 模型中的每个词元选择专家,将 softmax 与 top-k 路由合并在一起。这是我们自己的 Metal 实现。 |
前四个软件包基于 ggml 的内核构建;top-k 内核则针对 MoE 路由中另一个独立的瓶颈。它们共同减少了生成每个词元所需的 GPU 工作量。
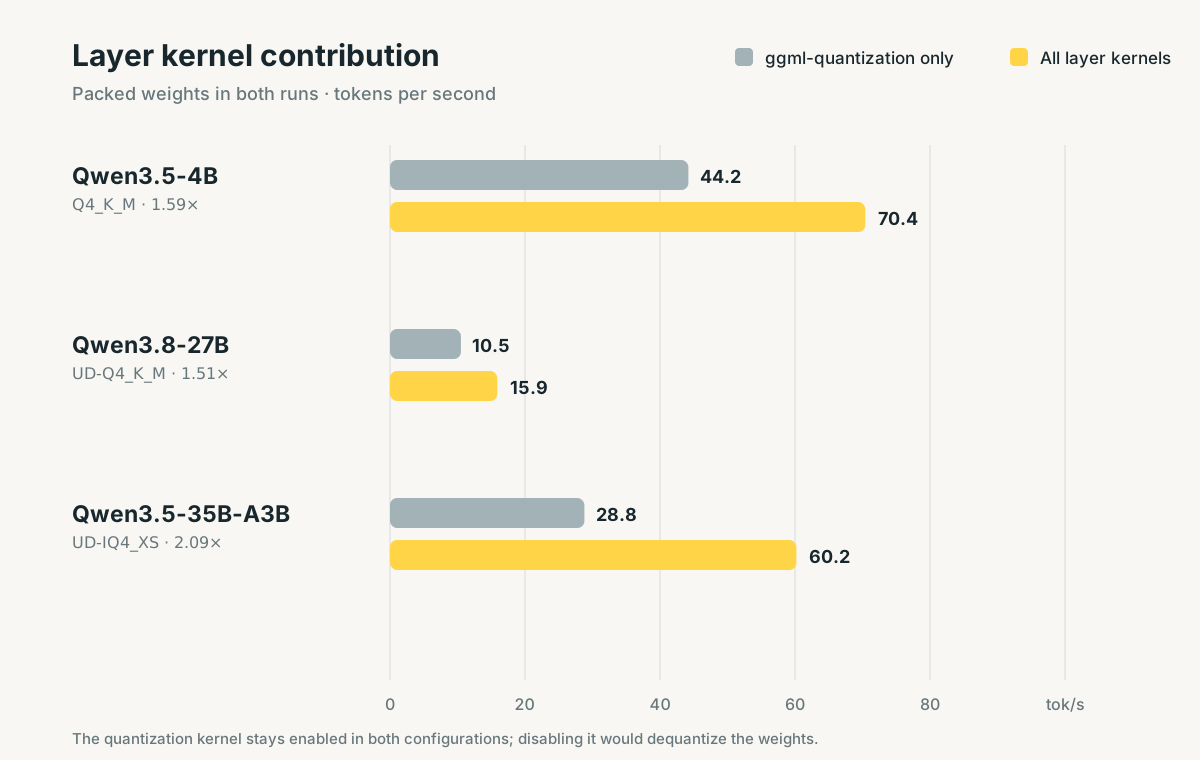
为了展示各层内核的贡献,我们对同样的打包 GGUF 检查点分别在启用和不启用这些内核的情况下进行了对比。两种配置中量化内核都保持启用:若将其关闭,权重的表示方式也会随之改变,测得的将是另一种权衡。
让 CPU 与 GPU 协同工作
只有 GPU 有活可干,更快的内核才有意义。生成过程中,由 CPU 调度 GPU 操作,并控制产生下一个词元的循环。从 GPU 读回结果可能迫使 CPU 等待,直到排队的操作全部完成。即使每个词元只重复一次很短的等待,也会明显拉低吞吐量。
我们在 generate 中做了两项改动来解决这个问题,它们能让所有 transformers 模型都获得提升(不仅限于运行 GGUF 文件时):
- 尽早丢弃不必要的注意力掩码(#48814)。当受支持的仅解码器输入没有填充时,可以在生成开始时去掉其全为 1 的填充掩码。下游的注意力代码就不必再反复检查该掩码以判断能否跳过。因果注意力依然得到保留。
- 推迟停止条件检查(#47975)。在受支持的路径上,
generate以异步方式复制停止判定,并在下一步再使用它。这样 GPU 运行时,CPU 可以继续调度任务。流式输出的词元采用同样的做法,超出停止条件多走的那一步会从结果中移除。
这些改动改进了模型外围的生成循环,因此其作用并不局限于 GGUF。它们与内核方面的工作相辅相成:内核降低单个操作的开销,而更少的同步点则让 CPU 调度与 GPU 执行得以重叠。
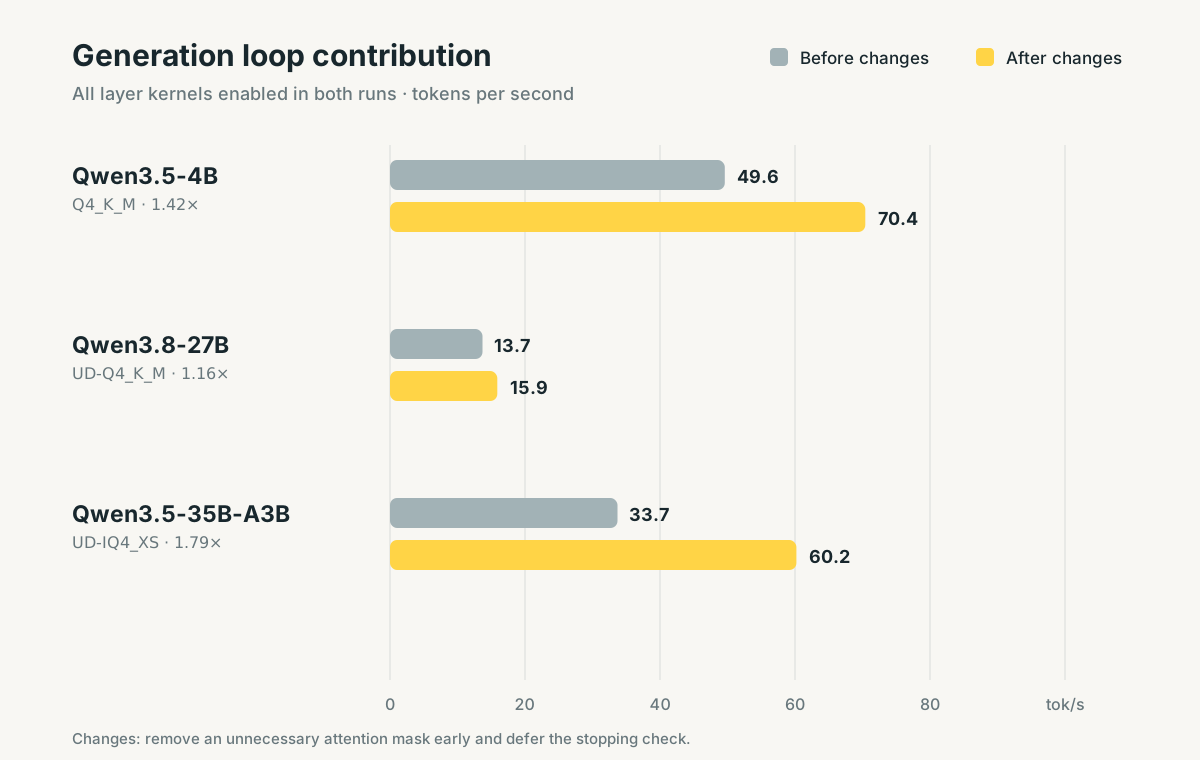
这些测量中所有层内核均保持启用;柱状图单独体现的是生成循环改动的效果。
当前的局限与后续计划
最初的目标是在 Apple Silicon 上进行单路交互式对话。有几点边界需要留意:
- 打包推理路径目前仅支持 MPS。通过反量化导入 GGUF 仍然是另一种可选方式;支持该文件格式并不意味着每种设备上都有打包内核可用。
- 填充和批处理仍有待完善。未填充的输入可以受益于上文所述的掩码优化。带填充的批次无法走同样的捷径,性能可能较低。我们希望把这项工作扩展到 MPS 上的
generate_batch。 - 架构覆盖范围有限。打包加载器目前覆盖 Qwen3.5 的稠密与 MoE 架构,包括兼容的 Qwen3.8 检查点。增加对其他架构的支持相对简单,我们会逐步扩大覆盖范围。
如果你有想在 transformers 中使用的 GGUF 模型,请提交一个 issue,附上检查点和你的使用场景。这将帮助我们优先支持大家在本地运行的模型。
致谢
感谢 Arthur Zucker 发起这项工作并审阅我的所有 PR,感谢 Cyril Vallez 提交 generate 相关的 PR。感谢 Sayak Paul、llama.cpp 团队和 Bertrand Chevalier 在内核集成方面提供的帮助。同时感谢 Aritra Roy Gosthipaty 和 Pedro Cuenca 审阅这篇博客文章,感谢 Lysandre Debut 统筹整个项目。