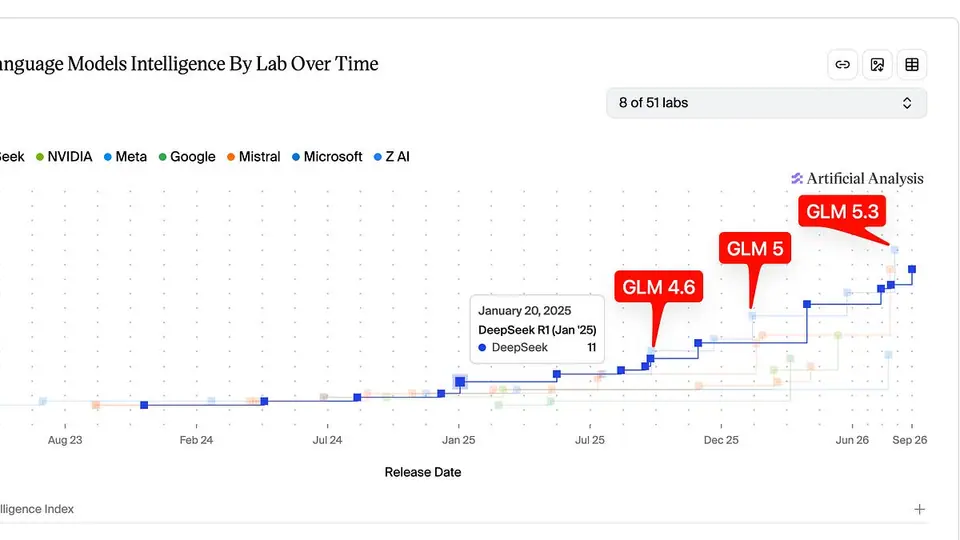
这期我们来晚了,但总比不发好。最近一直在忙着敲定第二届 AIE NYC,它将在一个月后举行。涨价之前赶紧订票——下周我们会公布来自 Bridgewater、Ramp、Coatue、Mastercard、Vanguard、Coinbase、Blackrock、Fidelity、Point72、Capital One、JPMC、Wells Fargo、Bloomberg、A24(没错,就是那家电影公司)Labs、Two Sigma、Apollo Global 等机构的演讲嘉宾!
DeepSeek 推进研究议程的方式,堪称迷人。在 v2、v3、v4 这几个主要版本之间,他们都会发布聚焦于某一项架构改进的中间论文,命中率基本是 100%,从 Math(尤其是 GRPO)、Coder、到 R1,更不用说近期关于流形约束超连接(Manifold Constrained Hyperconnections)和压缩稀疏注意力(Compressed Sparse Attention)的工作。在 2025 年上半年因 R1 论文受到巨大关注之后,DeepSeek 开始低调行事,过去大约一年里,甘愿让 GLM、Kimi 这样的同行在开源模型领域领跑。
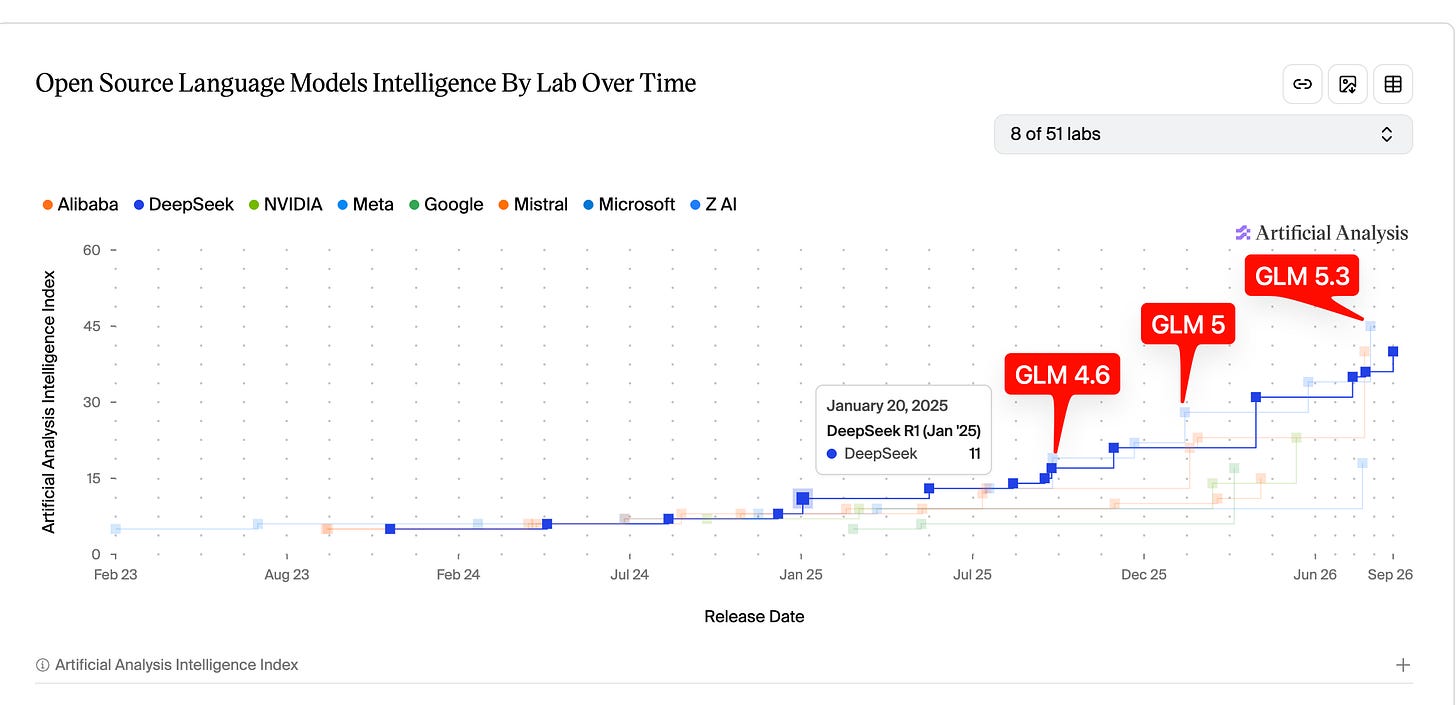
有一阵子形势看起来不太妙,但真正的鲸鱼粉从未动摇。如今 DeepSeek 传递出一个相当矛盾的信号:他们采用了全新的架构,下线了 V4 Pro,把宝全押在这个新模型上,却只把它命名为 v4.1 Flash。这似乎是在考验你能不能看穿表面的标题,读懂真正的进步。
没错,v4.1 Flash 在某些基准测试上确实落后于其他开源模型。但那是因为我们目前还没有能够简明刻画 v4.1 以及 DeepSeek 整体研究议程所追求目标的基准测试——那就是我们见过的、被公开阐述的最具创意、最高效的上下文利用方式。
如果你只看模型版本号和基准测试的标题,那你恰恰就是 DeepSeek 想要忽悠的那种浅薄之人。要理解 DeepSeek 这次的巨大进步,最好的办法是看 Sebastian 的这张梗图:
▶ Sebastian Raschka (@rasbt): I know, sorry, but it's hard to resist
模型名称没变,但按任何人的标准来看,这都远不止 0.1 的小升级,他们甚至还顺带加入了视觉能力,没有让你再等一个单独的模型。想要更直观的呈现,你可以看看从《Attention is All You Need》里最初的编码器-解码器架构开始,随时间叠加起来的所有模型创新:
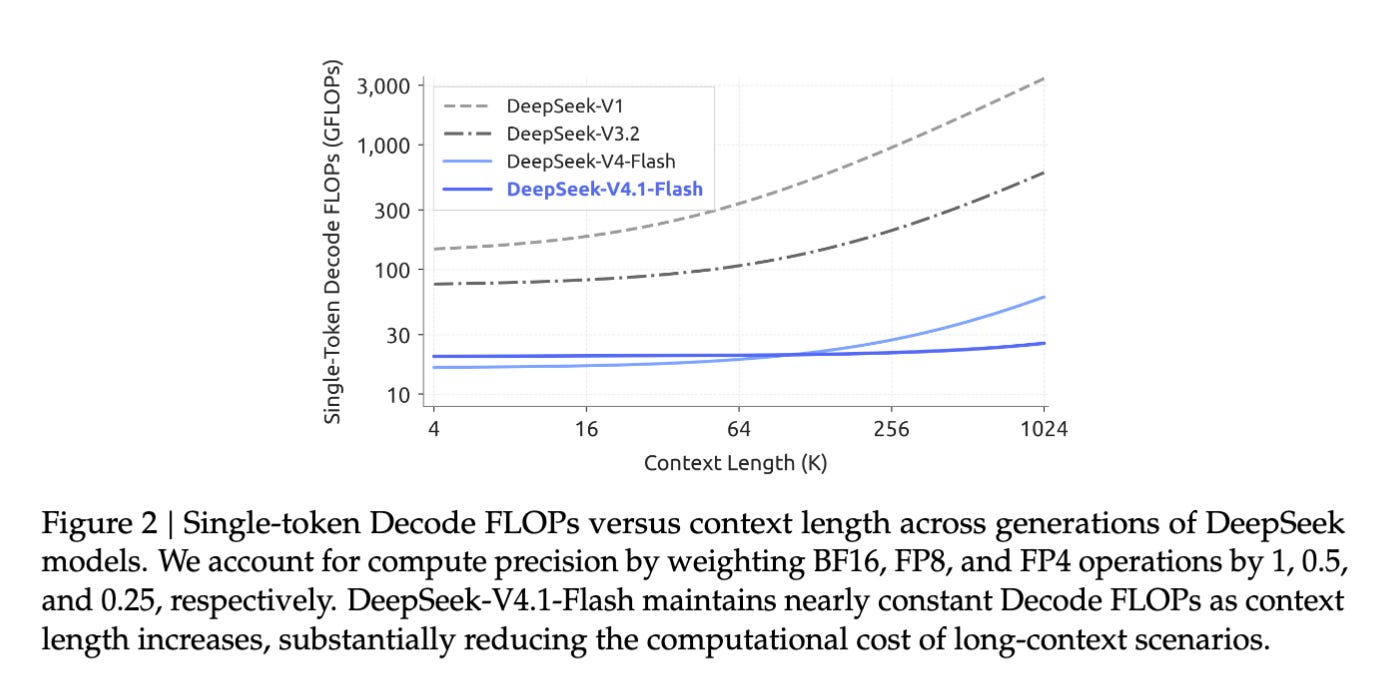
如果你读过我们的 V4 Pro 解读和 Engram,就应该了解截至 2026 年 4 月 DeepSeek 的基本架构;但我们特别钟爱的是这里引入的预填充(prefill)/解码(decode)分离:预填充(输入 token)用 8B,解码(输出 token)用 16B,沿用 MoE 既有的记法,就有了我们这串字母汤般的“DeepSeek v4.1-Flash:763B-P8B-D16B”。这意味着 1% 到 2% 的稀疏度;而如果你读过 DeepSeek v4.1 Flash 技术报告,再加上滑动窗口注意力有界重放(Sliding-Window Attention Bounded Replay)等新改动,KV 缓存占用最多可降至 V4 Flash 的 1/8……这让它在长时间运行的智能体场景中更好、更快、更便宜:
我们很高兴 DeepSeek 重新开始发表 SOTA 研究。最后一个亮点是他们对后训练的看法,他们在很大程度上似乎同意唐杰教授的观点:
AI News,时间范围 2026 年 9 月 9 日至 9 月 10 日。我们查看了 12 个 subreddit、544 个 Twitter 账号,没有再查看 Discord。AINews 网站支持搜索所有往期内容。再提醒一下,AINews 现在是 Latent Space 的一个栏目。你可以选择订阅或退订不同频率的邮件!
AI Twitter 速递
DeepSeek 发布 V4.1-Flash,这是一款新的开放权重旗舰模型,主打极致的推理效率和低成本。
- 独立基准测试账号 Artificial Analysis 报告称,DeepSeek V4.1 Flash 在价格便宜得多的情况下超过了 DeepSeek V4 Pro 0813,在 Artificial Analysis 智能指数上得分 40,略低于 GLM-5.3-Flash,高于最新的 V4 Pro;定价为每百万输入 token 0.30 美元、每百万输出 token 1.20 美元,缓存输入每百万 0.006 美元,另有 50% 的错峰折扣。他们还将其描述为一个总参数量 763B、输入侧激活 8B、输出侧激活 16B 参数的模型,1M token 上下文,支持文本+图像输入,采用 MIT 许可证,并可通过 DeepSeek 官方在美国地区使用 API @ArtificialAnlys、@ArtificialAnlys、@ArtificialAnlys
- Vals 称其为 Vals Index 上全新的开放权重第一名,领先于 Kimi K3,而每次测试仅需 0.30 美元,是开放权重前十名中最便宜的模型;他们还指出,评测使用了 1M 上下文、384 的最大输出 token 数、temperature 为 1、默认 top-p/top-k 以及高推理强度 @ValsAI、@ValsAI、@ValsAI
- Baseten 提供了首日支持,并将产品定位概括为比 DeepSeek v4 Pro 0813 更聪明、更快、更高效,具备文本和视觉能力、仅限美国、ZDR(零数据留存)以及 1M 上下文 @baseten
- Ollama 开始向 Max 和 Team 账号推送,随后扩展到 Pro 套餐订阅用户 @ollama、@ollama、@ollama
架构与论文层面的技术细节
讨论最多的技术创新是一种因果编码器-解码器设计,旨在降低激活计算量和 KV/缓存成本。
- Artificial Analysis 表示,该模型采用全新的因果编码器-解码器(Encoder–Decoder)架构,输入/预填充阶段激活 8B 参数,输出/解码阶段激活 16B 参数 @ArtificialAnlys
- Sebastian Raschka 将 V4.1 称为“大改版”,并表示他们“应该把它叫作 DeepSeek V5”,明确指出编码器-解码器的设置是与 DeepSeek 前几代模型最关键的决裂 @rasbt
- 多位技术读者对这一设计的异常混合风格有所反应:有人称之为“研究上非常保守、有时甚至陈旧的想法,与工程上可能处于前沿的效率和硬件设计,二者非常有趣的混合” @_xjdr
- Stochastic Chasm 给出了一份简明的架构解读,将其设计理念与 HySparse、NSA 以及 DeepSeek 自家 V4 中的 CSA/HCA 相比较,总结为局部滑动窗口分支加稀疏检索分支,并认为这种稀疏/局部混合正在成为更普遍的模式 @stochasticchasm
- 同一账号指出,多模态方面的改动并不激进,称 DeepSeek 基本上是“让主干网络去处理大部分工作,再给它视觉 token”,采用 3x3 像素反混洗(pixel unshuffle),而不是更常见的 2x2 @stochasticchasm
- 他们随后指出“在视觉编码器上与 K3 有很大差异”,暗示其视觉前端与近期的中国同行存在实质性分歧 @stochasticchasm
- TeortaxesTex 观察到 DeepSeek 一贯的做法:在前 N 层做一些不寻常的处理——此前是稠密层或哈希路由,现在是仅 SWA——并推测这可能反映出他们在早期层上反复遇到训练困难 @teortaxesTex
- 之后,同一账号又提出,这套结构“只剩 40 层,真正算得上解码器层的可能只有 20 层”,凸显出 DeepSeek 在解码关键路径上对有效深度的压缩可能有多激进 @teortaxesTex
- TeortaxesTex 的另一段帖子片段则暗示,DeepSeek 在做多种压缩频率,“这全都是 CSA2”,这是在回应围绕内存压缩的架构讨论 @teortaxesTex
- Nrehiew 的技术笔记强调,KV 缓存压缩是该设计的核心,称其是“死磕 KV 缓存压缩如何造就超高效前沿模型”的一个案例 @nrehiew_
- 在后续帖子中,nrehiew 强调了报告中的基础设施细节:用于减少长尾卡顿的调度策略、来自先前检查点的路由器重放、通过数据集级别的截断来处理较短补全带来的离策略效应、丢弃方案、有界的离策略比率与损失掩码,以及在更新到新检查点时持久化的 KV 和路由器;他们还提到最后阶段采用了对 40 多个教师模型做全词表 OPD @nrehiew_
- Nrehiew 总结道,这套设计看起来比 V4 中较早的 HSA + CSA 组合更简洁,称其“显然是为推理而设计的”,并引用了在基准测试得分档位下惊人的约 890 字节/token 的 KV 大小 @nrehiew_
- Stochastic Chasm 推断其对 KV 缓存采用了 QAT(量化感知训练),称这可以解释为什么该模型在 FP4 KV 缓存下比同行表现更好 @stochasticchasm
基准测试结果与数据
独立评测一致认为,V4.1-Flash 在成本调整后的智能水平、长上下文和自动化方面异常强劲,但有一个重要的缺点,即输出冗长。
- Artificial Analysis 的头条结论:AA 指数 40,高于 V4 Pro,低于 GLM-5.3-Flash @ArtificialAnlys,Scaling01 也独立印证了这一点 @scaling01
- Artificial Analysis 报告称其 AutomationBench-AA 得分 69%,与 GPT-6 Astra(69%)持平,高于 Grok 4.6(67%),比 V4 Flash 0731 提升了 15 个百分点,比 V4 Pro 0813(57%)高 12 个百分点,比 GLM-5.3(62%)高 7 个百分点 @ArtificialAnlys
- 据报道,在 GDPval-AA v2 上它提升了 164 Elo,从 1468 升至 1632,超过了 得分 1584 的 Kimi K3 @ArtificialAnlys
- 在 AA-LCR v1.1 上得分 84%,与同为 84% 的 GPT-5.6 Sol 和 Gemini 3.8 Flash 持平 @ArtificialAnlys
- Artificial Analysis 还表示,V4.1 Flash 是已测模型中最啰嗦的之一,平均每个智能指数任务消耗 89k token——比 GLM-5.3(71k)多 25%,比 GLM-5.3-Flash(69k)多 29%,比 V4 Pro 0813(55k)多 62%,甚至高于 Fable 5.1(78k)和 Claude Opus 5(73k) @ArtificialAnlys
- 即便如此冗长,AA 估算每个智能指数任务也只需 0.27 美元,约为 GLM-5.3(2.01 美元)和 Kimi K3(2.00 美元)的七分之一,比 V4 Pro 0813(0.67 美元)便宜约 2.5 倍 @ArtificialAnlys
- Vals 的结果进一步印证了成本优势:每次测试 0.30 美元,位居其榜单开放权重第一 @ValsAI
- 另一条反应帖更激进地总结了 DeepSWE 类的说法,称 V4.1 Flash 在 DeepSWE 上以低 94% 的 API 成本,提供了比 GPT-5.6 Sol 和 Opus 5 更好的性能,但这一说法属于二手转述,并非本数据集中的一手基准测试帖子 @kimmonismus
本地运行与推理工程方面的反应
很大一部分讨论围绕着一个意外:借助卸载(offload)和 SSD 流式加载,V4.1-Flash 竟能轻松地在近乎普通的本地硬件上运行。
- Fraser Price 报告称,在 4 张 Max-Q 显卡、仅 64GB 系统内存的条件下,以全精度运行 DeepSeek 4.1 Flash + DSpark,可达 200 TPS,其做法是把 200GB 的 Engram/哈希表卸载到 NVMe;他说这样就没有必要把整个结构放进内存,并承诺会给出 vLLM 配方 @fraserpricee
- 他随后将其提升到在 4 张 RTX Pro 上达到 300+ TPS,依然是全精度,系统内存峰值低于 32GB,使用了定制的 vLLM 分支和 SSD 支持 @fraserpricee
- Antirez 展示了 DwarfStar 在 128GB 的 M5 Max 上运行 V4.1 Flash,称 SSD 流式加载让速度出乎意料地快;他推测原因既有近期 SSD 流式加载方面的改动,也可能是 DS4.1“更多地复用了相同的专家” @antirez
- TeortaxesTex 感叹“能主要靠 SSD 运行前沿模型,简直不可思议” @teortaxesTex
- Elie Bakouch 发了一张反应梗图,明确针对的是推理工程师眼中的 V4.1 Flash 架构,反映出这次发布在系统工程师群体中引起了多么强烈的共鸣 @eliebakouch
- vLLM 的新版本还包括将 DeepSeek-V4 共享专家融合进 MegaMoE,以及 Mooncake Store 可以卸载解码 KV,这些背景说明了为什么在开源基础设施中部署这一类模型正迅速变得更容易 @vllm_project、@vllm_project
事实与观点
事实及有明确出处的说法
- V4.1 Flash 发布后,Ollama 和 Baseten 很快提供了支持 @ollama、@baseten
- 独立基准测试报告了 AA 指数 40、AutomationBench-AA 69%、AA-LCR 84%、GDPval-AA v2 1632 Elo、1M 上下文、MIT 许可证以及低廉的 API 定价 @ArtificialAnlys
- Vals 报告称其在自家指数上位列开放权重模型第一,每次测试 0.30 美元,其评测框架设置下最大输出为 384 token @ValsAI、@ValsAI
- 本地部署报告称,在 4 卡配置上达到了 200 TPS,随后提升到 300+ TPS,另外还有在 M5 Max 上以 SSD 流式加载成功运行的案例 @fraserpricee、@fraserpricee、@antirez
解读与观点
- Raschka 所说的“他们应该把它叫作 V5”,是对架构变化有多大的一种看法 @rasbt
- TeortaxesTex 推测 DeepSeek“反复在把前几层训练好上吃了苦头”,这属于推断,并非 DeepSeek 确认的说法 @teortaxesTex
- Nrehiew 认为这份报告比之前的 HSA/CSA 设计“更简洁”,并且由于 OpenAI/Anthropic 使用定制芯片,他们很可能不会这么做,这属于有依据的观点 @nrehiew_
- “DeepSeek 发布的是内部研究产物,而不是产品”这种批评属于外部评判,并非事实性的发布说明 @teortaxesTex
- “数据就是一切”或“研究已经结束”之类的断言,本身也被批评为反应过度 @shikibmehri
不同的观点与反应
支持/赞赏
- 来自基准测试者和研究人员的强烈正面反应,强调的是性价比的跃升:Vals 的“全新开放权重第一名”、Artificial Analysis 经成本调整的头条结论,以及“有趣的发布/一股清新之风”之类的普遍赞誉 @ValsAI、@ArtificialAnlys、@dejavucoder
- Raschka 称其“超酷,令人耳目一新” @rasbt
- XJDR 尽管在审美上有所保留,但欣赏其中的工程思路 @_xjdr
- Nrehiew 称之为“又一份精彩的技术报告” @nrehiew_
- Stochastic Chasm 最后表示这篇论文“信息密度很高”,但欣赏其中的多智能体训练思路和稀疏设计理念 @stochasticchasm、@stochasticchasm
中立/分析
- 一些观察者主要是在剖析这一设计,而不是为之喝彩:稀疏/局部混合、前几层的怪异之处、多模态词元化、KV 量化、同地部署的异步 RL 等 @stochasticchasm、@stochasticchasm、@nrehiew_
- Gordic Aleksa 把这篇论文当作一个更宏观的预训练数据分类法中的证据,将 DeepSeek 归入有机数据阵营,并指出令人意外的是,从其发表的内容来看,他们似乎连合成数据的改写都没有使用 @gordic_aleksa
批评/怀疑
- TeortaxesTex 多次反驳外界的印象,认为 DeepSeek 往往表现为内部评测成绩高,而外部鲁棒性较弱、容易失灵、技能存在奇怪的缺口,因为它“发布的是内部研究产物,而不是产品” @teortaxesTex
- 同一账号称某些评测结果“非常奇怪”,尤其是 AutomationBench 排第一以及 CritPt 上的退步,并请 DeepSeek 团队“好好琢磨一下” @teortaxesTex
- 他们还认为,V4 GA 极大地受益于工具/技能框架(harness)的接入,而 V4.1 似乎对框架脚手架的依赖更小,在“最简框架”下表现更好 @teortaxesTex
- 在实际使用中,他们报告称,除非项目的模块化非常清晰,否则多智能体“DSH 智能体团队”可能会拉低质量,至少在一个例子中,单独运行的 V4.1 优于团队模式,因为子智能体产出了垃圾内容,或在不必要的调研上浪费了 token @teortaxesTex、@teortaxesTex
- Jared Z 的更宽泛的产品-市场批评——用户现在非常在意 token 成本,日常使用的编码模型应该既便宜又聪明——与 V4.1 Flash 的定位相吻合,尽管他说的并不是专门针对这个模型 @imjaredz
背景
这在技术和战略上为何重要
- 这次发布正值一个更大的转变:从“更大的稠密对话模型”转向系统优化的、稀疏的、长上下文的、面向智能体的模型,这类模型确实可以便宜地、在本地提供服务。
- V4.1 Flash 的定位异常激进:开放权重、MIT 许可证、1M 上下文、多模态输入、很低的激活参数量、极致的缓存折扣,并且已证明可在严重依赖 SSD/卸载的、近乎消费级的配置上运行 @ArtificialAnlys、@fraserpricee、@antirez
- 基准测试的规律显示出一种有意义的取舍:输出非常啰嗦,但得益于极其便宜的 token 定价,每个任务的总成本依然异常之低 @ArtificialAnlys
- 这一架构也反映了业界更广泛的趋势,即拆分预填充和解码的成本结构,使长上下文和智能体工作负载更加实用,而无需为每个 token 支付前沿稠密模型的成本。
- 这次发布强化了一种观点:开放模型日益具备竞争力,不仅在于能拿到原始权重,更在于可部署性(servability)——即能否融入卸载流水线、量化 KV 栈、本地部署和开源推理服务器。
- 它也让人们对 2026 年模型进步中什么最重要的争论更加尖锐:是架构、RL/推理协同设计、数据质量,还是系统工程。Shikib Mehri 明确反驳了 DeepSeek 的论文意味着“研究已经结束”的说法,他认为可着力的范围已经从架构扩展到了数据工厂和奖励设计研究 @shikibmehri
- 最后,DeepSeek 在身份认同上依然是一家两极分化的实验室:它因发布不同寻常的研究产物和详尽的报告而受到钦佩,但一些从业者也认为它不如以产品为中心的竞争对手那样打磨精细,评测上有奇怪的缺口,在真实工作流中比在内部的头条数字中更明显地暴露出脆弱的行为 @teortaxesTex、@teortaxesTex
OpenAI 在语音、智能体与企业市场上的发力
- OpenAI 将 GPT-Live-1 推向 API,并迅速围绕它培育起一个生态:这款新模型被定位为全双工语音接口,可以边说边听,并把工具调用或推理委托给后端模型。核心发布来自 @OpenAIDevs,另有细节说明开发者可以控制语气、节奏、表现力、回复长度和语言 见此处。OpenAI 自己的基准测试帖子称其相比 GPT-Realtime-2.1 有所提升,包括与 GPT-6 Astra 搭配时在 Tau3 上首次尝试任务完成率达 83.6%,Artificial Analysis Conversational Dynamics 上达 97.3%,以及在 Full Duplex Bench v1 上响应起始延迟为 0.798 秒 详情。
- 周边工具链正朝着托管式智能体基础设施成熟:OpenAI 还宣布了公开测试版的 Agents API(搭载 Codex harness),以及通过托管云智能体提供的、用于代码执行、文件和产物的 OpenAI 托管沙箱 发布。这与业界把模型、运行时和沙箱合并到同一界面的更大趋势相吻合。来自 LiveKit、HeyGen、Telnyx、Speak 和 Cognition 的 Devin Voice 的集成公告表明,GPT-Live-1 成为生产级语音智能体默认底座的速度,可能比此前的实时(realtime)技术栈更快。
- 企业数据访问正在成为一等产品原语:OpenAI 在产品侧宣布的 ChatGPT Work 中的 Data agent,承诺可基于已连接的公司数据源生成仪表盘、回答和执行操作 @ChatGPT,而 Box 则把自己的集成称为“AI 的文件系统”,将受治理的企业上下文带入 ChatGPT。结合 Google 面向智能体的文档推动以及 Cursor 新的持久化工作区,趋势是走向有状态的、感知组织的智能体环境,而不是无状态的模型端点。
Cognition、Cursor 与向持久化编码智能体的转变
- Cognition 度过了格外强劲的一天:它发布了 SWE-2,称其为“我们迄今最接近前沿的模型”,声称在主流编码评测上与之持平,而成本最多低 70%,并明确表示将 RL 扩展到了数万亿参数的规模 发布。ybenpan 补充的背景强调,团队在内部自研了算法、基础设施和数据,而 silasalberti 则强调了一个实用的 RL 发现:一个简单的线性长度惩罚在不同强度档位下保持了训练期间帕累托曲线的形状。
- Devin 技术栈正变得更加多模态,也与开发者工作流结合得更紧密:除了 SWE-2,Cognition 还推出了由 GPT-Live 和 SWE-2 驱动的 Devin Voice 推文,并宣布 Dioxus Labs 加入 Cognition,负责 Devin 的虚拟机、计算机使用和测试方面的工作,同时继续支持 Dioxus 及相关的 Rust 开源项目 Cognition。这是编码智能体厂商收购基础设施和系统人才,而不仅仅是模型研究员的一个具体例子。
- Cursor 新的“Projects”功能从 IDE 一侧指向了同一个目的地:Cursor 推出了带协调者智能体的持久化线程、跨智能体共享的记忆/产物,以及在用户设备和智能体计算机之间的同步。实际上,这是在从“每个任务一个对话”转向长期存在的软件项目底座,子智能体在其中随时间积累状态。结合 Claude Code 新的窗格弹出以及托管智能体会话查看器/自动模式来看,市场正在趋同于这样一种认识:编码智能体需要持久的上下文、可检视的会话和明确的编排控制,而不只是更好的补全。
智能体研究:框架、时间跨度、并行检索与自我进化
- 几篇论文都在推动同一个主题:框架(harness)如今已成为核心优化对象。omarsar0 广泛传播的一篇 Salesforce 论文摘要显示,用更强专家的完整轨迹去训练较弱的模型,在框架进化之后可能使性能下降 4 到 30 个点,因为微调后的模型采用了不相容的规划风格。论文提出的解决办法是只改写较弱模型自身 rollout 中失败的那一轮,从而保持模型与框架的契合。与此同时,Sumanth_077 对字节跳动 HarnessDev 的解读描述了能够构建并迭代改进自身可运行框架的智能体,其泛化效果参差不齐:只有 34/64 项改动在方向上迁移到了留出任务。
- 长时间跨度和长上下文的智能体训练也得到了更有章法的处理:dair_ai 总结了 Qwen 关于 Elastic Horizon 的工作,这是一个闭环控制器,通过跟踪成功轨迹长度的第 90 百分位来调整最大交互时间跨度,在提升成功率的同时最多节省 25% 的轨迹 token。另外,omarsar0 重点介绍了 PARSER,它用并行的冻结子智能体 + 经 RL 训练的主导智能体,在迭代的分发-汇总轮次中取代了顺序读取分块;据报道,收益包括在 896K 上下文下提升 12 个点,以及最高延迟降低 11 倍。
- 技能与工具使用的数据生成也在走向形式化:dair_ai 谈 SkillAdam,把技能的自我进化表述为一个离散优化问题,借用类似 Adam 的一阶/二阶矩思想来稳定更新方向和编辑幅度。与此同时,Google Research 的 ToolGrad 会先于提示生成真实的工具使用链,据报道数据集构建的通过率接近 100%,并带来下游工具使用能力的提升。综合来看,这一批工作表明该领域正从“更用力地给模型写提示”转向对脚手架、轨迹预算、技能文档和工具轨迹的闭环优化。
安全、滥用、可监控性与模型治理
- Anthropic 的威胁情报报告主导了安全方面的讨论:该公司发布了迄今最详细的滥用报告,涵盖利用 Claude 进行网络攻击、影响力行动、监控、生物和武器相关的企图,并表示已瓦解报告中描述的每一项行动 发布推文。大量讨论集中在报告提到的涉及竞争实验室的提取/路由模式以及与国家相关的滥用上,pradeepXkapoor、logangraham 和前 Meta 威胁瓦解负责人 David Agranovich 都有高互动量的反应,后者认为即便部分表述值得商榷,Anthropic 仍应为这种程度的透明度获得肯定。
- 第二条线索聚焦于推理可监控性和“neuralese”风险:Redwood Research 为可能削弱或消除思维链可见性的架构提出了透明度规范,Ryan Greenblatt 则主张,公司在部署大幅降低对 CoT 依赖的架构之前,应先公布证据和政策。Neel Nanda 的相关评论将 GPT-6 Astra 解读为无 CoT 推理方面一次可能令人担忧的跃升,或许意味着超出常规规模扩展的架构变化。
- 前沿实验室的员工和校友之间,在风险文化问题上也出现了明显分歧:Chris Hayduk 强调 AI 在人道主义方面的积极一面,而 balesni 和 jkcarlsmith 则公开支持灭绝风险超过 10%的观点。在治理方面,Thom Wolf 宣布 Hugging Face 成立新的 Open Alignment 团队,Richard Ngo 则发表了一篇尖锐的批评,针对 Paul 加入 OpenAI 董事会一事,以及他所认为的安全社区被 AGI 公司俘获的现象。
互动量最高的推文
- Anthropic 威胁情报报告:@AnthropicAI 发布了一份详细说明,介绍 Claude 在网络、影响力、生物、监控和武器等领域遭到的复杂滥用。
- OpenAI 因 Astra 算力原因暂停 200 美元 Pro 新用户注册:@thsottiaux 表示现有用户不受影响,API 和其他套餐仍可使用。
- GPT-Live-1 API 发布:@OpenAIDevs 将新的全双工语音模型推向 API。
- ChatGPT Work 的 Data agent:@ChatGPT 宣布推出连接数据的企业智能体,可生成仪表盘、回答和执行操作。
- SWE-2 发布:@cognition 推出新的编码模型,声称评测表现接近前沿,而成本显著更低。
- Cursor Projects:@cursor_ai 推出了带协调者智能体、共享记忆和同步产物的持久化项目线程。
AI Reddit 速递
/r/LocalLlama + /r/localLLM 速递
1. DeepSeek V4.1 Flash 的发布与架构
- DeepSeek V4.1 Flash:更强、更快、更易用(热度:317):DeepSeek 发布了 V4.1 Flash,这是一个
552B参数的 MoE,原生支持多模态视觉,并采用全新的因果编码器-解码器(Causal-Encoder-Decoder)非对称架构:输入侧激活8B参数,输出侧激活16B,声称能力高于 V4 Pro,而推理成本更低(来源、权重、技术报告)。DeepSeek 声称,相比上一代,KV 缓存/存储在 HBM 上减少了4×,在 SSD 上减少了8×,相比其第一代模型则减少了437×;API 用户可以切换到deepseek-flash,而已弃用的deepseek-v4-flash、deepseek-v4-flash-vision-exp以及最终的deepseek-v4-pro将路由到 V4.1 Flash,并采用新的峰/谷定价。技术讨论的焦点是前沿 LLM 中异常地重新出现编码器-解码器式架构,评论者质疑编码器对长提示和多模态切分到底起什么作用。另一些人指出,尽管是稀疏激活,552B的总参数量仍使本地推理不切实际,即便是多台 DGX Spark/Strix 一类的配置也不行,因此较小的 V4/Qwen 衍生编码模型仍然是本地智能体工作流更现实的选择。- 几位评论者聚焦于所宣称的编码器-解码器/非对称架构,质疑 DeepSeek 是如何在现代 GPT 式 LLM 中使用编码器的:例如提示是否在解码器自注意力之前被嵌入或压缩,以及这如何扩展到按句子、段落或模态切分的长输入。一种解读认为,这种非对称设计可能意味着,与标准的纯解码器 Transformer 相比,其生成路径在结构上有所不同。
- 围绕该模型所报告的
552B参数规模,大家讨论了本地推理的可行性,评论者认为即便是多台 DGX Spark/Strix 级别系统这样的高端本地配置也不现实。建议的实用工作流是:用更大的 DeepSeek V4 级模型做规划,再用较小的/蒸馏模型,如 Q38-27B、Q38-35B-Distill 或 Ornith35B,在本地智能体编码流水线中执行。 - 帖子中凸显的一个技术上值得注意的说法是,
437×相比第一代的 KV 缓存缩减,评论者认为这对长上下文推理成本和内存扩展意义重大。如果属实,这种程度的缩减将实质性地影响长上下文服务的吞吐量和部署经济性,尤其是与传统纯解码器注意力缓存相比。
- Deepseek V4.1 Flash 是 748B,不是 552B(热度:575):楼主检查了 Hugging Face 上的
safetensors,认为 DeepSeek V4.1 Flash 的主干加 engram 约为748.5B参数,而不是284B、305B、485B或522B,其中主干为551.566B,engram 为196.929B;若再算上可选的 DSpark/MTP(14.225B)和视觉编码器(0.485B),则存储的模型约为763.21B参数 /511.76 GB。造成困惑的原因被归结为统计/元数据错误:例如,一份 NVIDIA 论坛的估算低估了主干,Hugging Face 的485B很可能把 FP4 打包权重按字节而不是每字节两个参数来计数,与 GLM-5.3-Flash-NVFP4 类似,而 vLLM 的配方在后来修正参数细节之前,前后不一致地列出了522B。主干绝大部分是 MoE 的 FFN 专家:543.582BFP4 参数,注意力/共享/嵌入/其他组件中只有约7.984B,这意味着 128–256 GB 的内存/显存不足以完整地在本地使用。一位评论者指出,“Flash”这个命名可能与延迟有关,称其预填充阶段只使用大约9B激活参数。另一个技术问题是:用于 engram/ngram 式查找表的 SSD 卸载,应该优先考虑顺序吞吐量还是随机 4K 读取 IOPS,但所提供的评论中没有给出实质性回答。- 评论者讨论说,DeepSeek V4.1 Flash 报告的总大小可能大得多,是因为包含了
n-gram/查找表式的组件,但有人认为不应该像计算激活神经网络参数那样计算它们,因为它们可以存放在外部 SSD 上,而不必像模型权重那样加载到显存/内存中。 - 有人提出一个技术性说法:“Flash”变体之所以快,是因为它在预填充期间只使用大约
9B的参数,这意味着实际的激活计算路径远小于748B这个头条数字,也许能解释这种强调延迟的品牌定位。 - 对于本地部署,一位评论者估计
256GB的系统内存加64–96GB的显存就足够了,n-gram数据则放在任何一块 PCIe Gen 3 及以上的 NVMe SSD 上。讨论中还提出,SSD 性能应优先考虑顺序吞吐量还是4K随机读取,因为驻留在磁盘上的查找表可能对访问模式敏感。
- 评论者讨论说,DeepSeek V4.1 Flash 报告的总大小可能大得多,是因为包含了
- Deepseek 已“软下线”Deepseek V4 Pro(热度:1598):这张图片是一条推文截图,称 DeepSeek 实际上在“软下线”DeepSeek V4 Pro:在 V4.1 Pro 发布之前,V4 Pro 的流量将被自动路由到 DS V4.1 Flash,并按更便宜的 Flash 价格计费。给出的理由是,V4.1 Flash 在性能、成本、速度和总使用时长上都优于旧的 V4 Pro,这意味着尽管 V4 Pro 体量更大,更小更便宜的 Flash 变体已成为首选的生产模型。评论者推测,V4 Pro 的 GA 版本可能存在奖励作弊(reward hacking)和扩展效果不佳的问题,其中一人指出它“尽管体量接近 Flash 模型的 6 倍,表现却没有实质性的提升”。还有人争论,DeepSeek 和 Google 是否因为各自独立的训练运行、架构差异或数据配比问题,而看到了类似的“小模型胜过大模型”的现象;另一位评论者则抱怨 Flash 在创意写作上较弱,反映出整体上向编码优化模型倾斜的趋势。
- 几位评论者认为,DeepSeek V4 Pro GA 的表现与其体量不相称,其中一人声称它表现出“高度的奖励作弊”,尽管比 Flash 模型大近
6×,却没有实质性更好。技术上的担忧在于,Pro 更大的参数/计算开销并没有转化为基准测试或真实世界能力的提升,因此如果推理成本高昂,下线就是合理的。 - 有一个帖子比较了 DeepSeek 和 Google 的情况:较小的“Flash”变体表现优于或持平较大的模型,这表明它们可能并非简单地从一次大型训练中蒸馏而来。评论者推测,这种差距可能来自独立的架构选择、训练流水线的差异或数据配比效应,而不仅仅是规模,由此引出了一个问题:为什么较小的模型在某些任务上泛化得更好。
- 一些用户区分了 API 下线和模型消失:DeepSeek 停止提供 V4 Pro 服务,但据报道权重仍然可获取,这不同于 OpenAI/Anthropic 完全封闭式的下线。另一种技术假设是,DeepSeek 可能是在释放推理容量,或正向中国推理芯片迁移,因此优先考虑更便宜的 Flash 级服务,即使 Pro 保留了更多对规划/通用任务有用的世界知识。
- 几位评论者认为,DeepSeek V4 Pro GA 的表现与其体量不相称,其中一人声称它表现出“高度的奖励作弊”,尽管比 Flash 模型大近
- DeepSeek-V4.1-Flash 让人惊喜……(热度:537):这张图片是一张反应梗图,但它突出了一个技术性说法:DeepSeek-V4.1-Flash 将全局 KV 缓存降低到只有
890 bytes/token,远低于先前的版本,而 DeepSeek-V4.1-Flash-Base 显示为一个552B参数的主干,仅有8B/16B激活参数。该帖认为这证明,未来的中等规模模型可以将 MoE 或稠密主干、10–15B“Engram”组件以及 Flash 式 KV 缓存优化结合起来,以提升长上下文的内存效率。评论者推测,极小的 KV 缓存设计可能会让 M5 Ultra 512GB 或多台 Spark 配置这类大内存本地推理硬件更有吸引力,而 Qwen 等其他模型家族也可能采用类似的 KV 缩减。还有一位评论者纠正了对 Engram 规模的直觉,认为它们大约占参数的1/3–1/2,例如30B的稠密主干大约会搭配10–15B的 Engram。- 评论者聚焦于内存压力和硬件可行性,指出亮眼的“AA 分数”可能让 M5 Ultra
512GB这类超大内存的本地推理配置以及多台 Spark 配置更具吸引力。有用户质疑,在使用多个子智能体时,即便是512GB的统一内存是否足以“从容地”运行 DeepSeek-V4.1-Flash,这意味着除了原始模型权重之外,KV 缓存和并发开销可能才是主导因素。 - 一个技术帖讨论了架构上的参数分配:engram 估计约占总参数的
1/3到1/2,因此30B的稠密主干意味着还要额外增加10B–15B的 engram 组件,总计约40B–45B参数。另一位评论者预期 Qwen 会采用“极小 KV”设计,这可以通过直接降低上下文内存需求,减少对 KV 缓存量化之争的依赖。
- 评论者聚焦于内存压力和硬件可行性,指出亮眼的“AA 分数”可能让 M5 Ultra