想结识小米和其他顶尖中国前沿实验室?来 AIE Shanghai 吧!
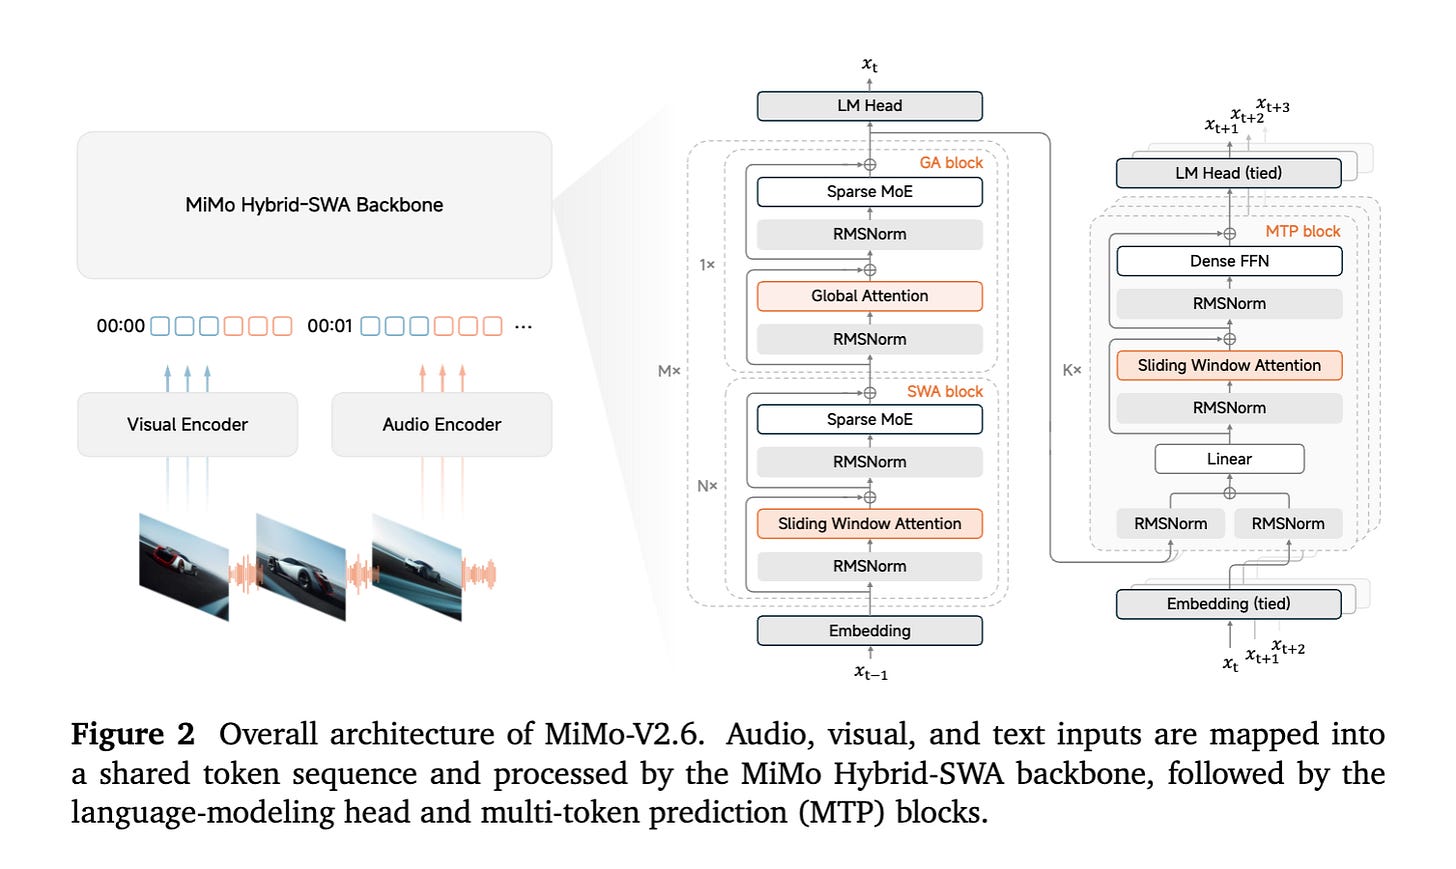
这对这家被称为“中国苹果”、如今转型为前沿实验室的手机厂商来说尚属首次:“MiMo-V2.6 系列包含两款原生全模态模型:MiMo-V2.6-Pro 是我们迄今能力最强的模型,而 MiMo-V2.6-Flash 则在智能、效率和成本之间取得了最佳平衡。我们还将推出 MiMo-V2.6-Pro-UltraSpeed,在质量不变的前提下输出速度最高提升 20 倍,面向需要极致生成速度的用户。”
小米传统上并不被视为中国六小虎之一,因此这对你所熟悉和喜爱的既有格局来说相当出人意料。而且……它还是原生全模态的!
几天前,前 DeepSeek 明星工程师、现就职于小米的罗福莉(Fuli Luo)开始实时公开他们最终的 RL 训练运行,内部指标的透明度高得异乎寻常,由此成为新闻。
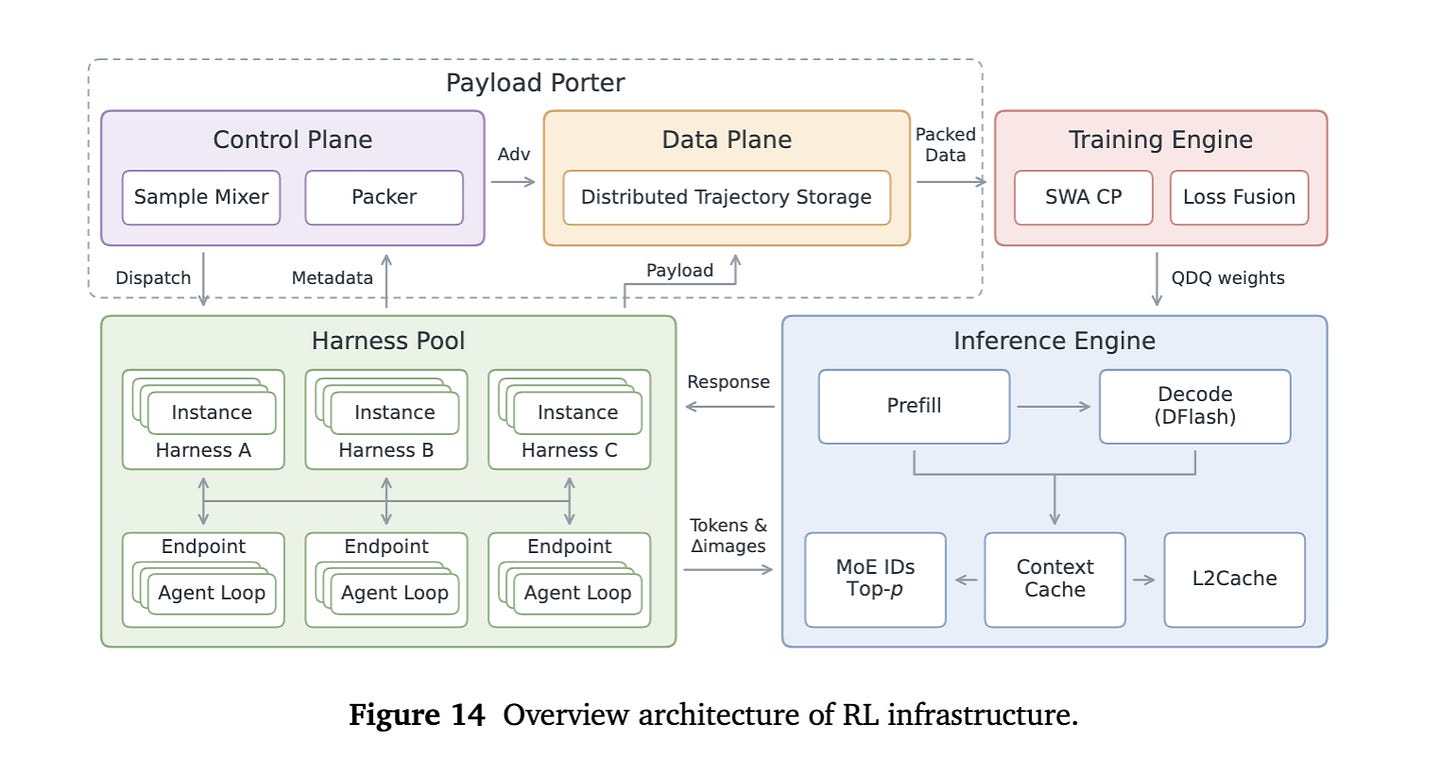
正如他们在技术报告中所述,他们沿三个维度扩展了 RL 算力:
- 更大的批量和更高的吞吐量:在完全异步的架构上使用大批量,每次更新 1,568 个样本,训练上下文最长达 1M,每步 35 亿到 37 亿 token。
- 更多任务和更丰富的环境:一套横跨编码、通用智能体、视觉和网络安全的多任务训练集,混合了多种 harness,使某一能力上的提升能够促进其他能力。
- 更多的评分器算力:在每个分组内进行相对比较,为长程 RL 任务提供更精确、更多样的奖励信号,闭合一个自我改进的循环,并引导模型走向更短的路径、让每个任务消耗更少的 token。
所有这些工具,包括环境在内,都将开源。——即环境代码和训练配方,但完整的 7k+ 任务数据集尚未发布。
- 编码 / 软件工程:代码配方、数据集加载器和奖励
- 网络安全 / 漏洞复现:ARVO 环境和训练配方
- 通用 / 知识工作:通用环境、工具和训练配方
- 视觉 / Web 开发:Web 开发环境与评分
- 音乐生成:数据准备与音乐评分器
- 可组合的 mini-harness:智能体配置
- 共享环境适配器:mimoagent 环境
AI News 涵盖 2026 年 9 月 19 日至 9 月 21 日。我们查看了 12 个 subreddit、544 个 Twitter 账号,没有再查看其他 Discord。AINews 网站支持搜索所有往期内容。再次提醒,AINews 现已成为 Latent Space 的一个栏目。你可以选择订阅或退订不同频率的邮件!
AI Twitter 回顾
开源模型、竞争与中国差距
- 开源模型仍是政策和市场层面的核心话题:Nathan Lambert 分享了一场关于开源模型表现、采用情况以及中美竞争的国会简报,随后又发布了一份公开摘要。更广泛的论点也在别处再度浮现:@Yuchenj_UW 声称自 Opus 4.8 以来前沿编码能力已陷入平台期,而开源模型正以低 10–50 倍的成本不断缩小差距;@ClementDelangue 同样认为,对许多真实场景而言 API 是大材小用,专用模型将抢占份额。反方观点:@teortaxesTex 认为前沿实际上已经分化出新的更高层级,内部模型和顶级闭源模型依然遥遥领先。
- 中国实验室的发布节奏如今已难以忽视:@Thom_Wolf 整理了一份异常密集的约 10 周开源发布清单,包括 Kimi K3、Qwen3.8-Max、DeepSeek V4-Pro、GLM-5.3、Hy4 Preview、Atria Dawn 等。@Polymarket 转述的一则出自 Bloomberg 的消息进一步印证了这一点:创业公司越来越多地基于开放权重构建定制模型,以降低成本并减少对 OpenAI/Anthropic 的依赖。多条推文的潜台词是:开放权重的能力已不再局限于中等规模的模型;多个团队正在推出前沿规模的 MoE,并给出了可信的性价比说法。
小米 MiMo-V2.6 与作为新扩展杠杆的 RL
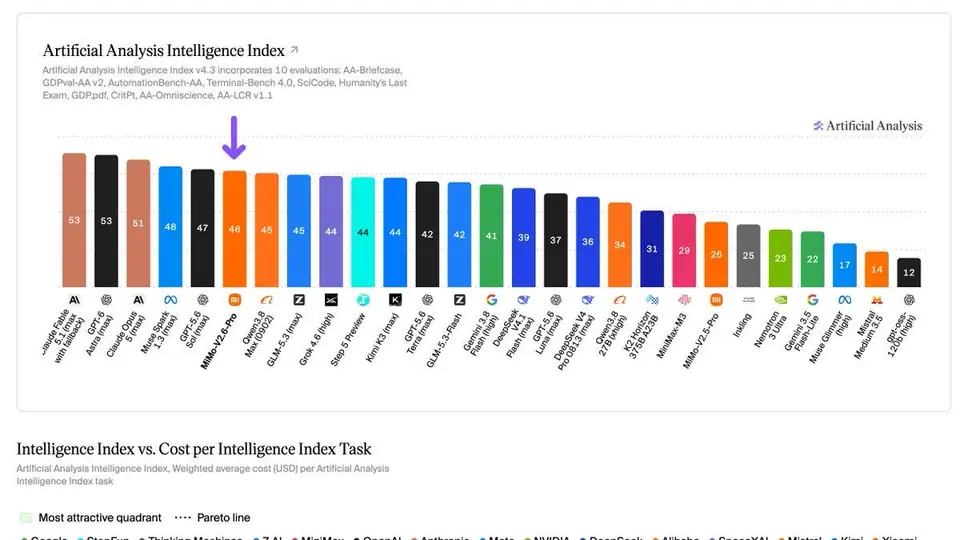
- MiMo-V2.6 是本期最大的开源模型发布:@XiaomiMiMo 发布了 MiMo-V2.6 Pro 和 Flash,称其为开源的全模态模型,并附带权重、技术报告、RL 环境和训练代码。Artificial Analysis 表示,MiMo-V2.6-Pro 以 Intelligence Index 46 分首次亮相即成为榜上顶级的开放权重模型,拥有 1.02T 总参数 / 42B 激活参数,成本效率出色,输入 $0.435/M、输出 $0.87/M token。@victormustar 指出这些模型采用 MIT 许可证。
- 技术上引人注目的不只是模型本身,还有 RL 技术栈:@eliebakouch 重点介绍了小米的环境/数据工厂论文,该论文利用“智能体在环”从开源仓库生成 RL 任务,以保证稳健性并防止作弊。后续评论提到了第二篇论文以及异常高的透明度:@xeophon 指出小米想要发布约 7K 个 RL 环境,@eliebakouch 则强调团队在最终 RL 运行结束后不到一周就发布了模型和技术报告。@bertgodel 和 @Thom_Wolf 反复提出的一种解读是:高质量的开放 RL 环境如今在战略上的重要性,可能就像上一个周期里的预训练语料一样。
- RL 的成本/吞吐量细节之所以受到关注,是因为它们压缩了时间线:@zephyr_z9 引用了该成果背后 RL 运行的 130 小时、75B token 和 $2.6M;@tianjun_zhang 表示 MiMo 系列在 JAX + TPU 上扩展 RL,扩展“主要只是改配置,而不是重写代码”。如果这些数字站得住脚,就意味着后训练/RL 正在成为获得接近前沿提升的一条远比许多人设想更便宜的路径。
决策模型、Jev 与专用推理的回归
- Jev 是占主导地位的产品/主题讨论:多条帖子趋向同一种看法:这“不过”是分类/路由,只是有了现代模型的智能,延迟和成本也好得多。@karpathy 称其为帕累托前沿上“不思考、单 token、低延迟、可接受智能”的一个点。@willdepue 将其描述为具备近前沿智能的零样本分类器,而 @ClementDelangue 则认为,这股热度表明存在大量潜在需求,需要的是专用模型,而非越来越大的通用模型。
- 围绕 Jev 的生态迅速扩张:@sarah_edo 构建了一个 Chrome 扩展,每次按键都用 Jev 来选择并填写相关的 WebMCP 工具。LangChain 在 LangSmith 中加入了 Jev-as-a-judge;@hwchase17 和 @Hacubu 通过 LangSmith Gateway 推出了开源决策模型 SemIf。@omarsar0 报告称,用 Jev 为约 2.3K 篇论文重新打标签,耗时 83 秒、花费 $0.14,产生了 579 处高置信度改动,并对存在分歧的部分做了人工验证。
- 更持久的启示在于架构层面:DSPyOSS 认为,向前沿智能体发问就像管理人,而手写决策模型程序则类似于写汇编;两个极端都有用,但过度使用都会很脆弱。多条帖子强调了这类模型最适合的位置:路由、审批关卡、轨迹评分、工具选择、离散的文档决策,以及在更大的智能体循环内部做低成本监督,而不是作为独立的“智能体”。
推理、工具与系统优化
- 分词器和后训练基础设施都迎来了实质性升级:Hugging Face 的 tokenizers v1 RC 声称分词速度最高提升 30 倍,多线程扩展性改善、内存占用更低、软件包体积小得多;@art_zucker 称其为新的 SOTA 分词库。另外,Halo 作为后训练框架发布,声称吞吐量比原版 TRL 最高提升 2.8 倍,同时保持模型为原生 Hugging Face 格式。
- 推理侧工程仍是重要的杠杆:@RisingSayak 展示了 KV 缓存如何被引入 QwenImage 2.1,将固定上下文与变化的图像位置分离,带来 2.55 倍加速;该帖引用的数据是在预热后的 A100 上 DiT 耗时由 50.57s 降至 19.86s,内存开销适中。vLLM 发布了在 GB300 NVL72 上服务 Qwen3.8-2.4T 的调优配置,给出的帕累托前沿从高吞吐下的每 GPU 总计 5K tok/s,到低延迟下的每用户 180 output tok/s。在视频工作负载方面,vLLM 还集成了 PyNvVideoCodec/NVDEC,消除了 CPU 解码瓶颈,并报告在 8×H100 上吞吐量提升 2 倍以上。
- 压缩/量化仍在快速推进:@ZhihuFrontier 总结了腾讯混元的工程做法:通过平均约 2.38 bits/weight 的混合精度量化,将 Hy4 Preview(770B)压缩进 214 GiB,其中包括在打过补丁的 llama.cpp 中使用自定义 CUDA kernel。在边缘/本地方面,@vikhyatk 发布了 Parakeet Redux,把 NVIDIA 的语音模型从 1.2GB 压缩到 178MB,在 CPU 上可达 113 倍实时速度,在 25 种语言的 FLEURS 上超过基础模型,英语上的 WER 差距保持在 0.3 以内。
智能体、安全与人在回路控制
- 计算机操控系统正日益走向生产化,但安全如今成为核心:Patrick Wardle 报告了 Muse 中一个严重的本地劫持漏洞,认为广泛的操作系统访问权限使这类助手成为高价值的攻击面。与之相对,DeepLearningAI 重点介绍了 Meta 针对类 Muse 智能体的设计理念:假定提示注入一定会发生,让真实凭据远离模型,在容器中隔离工具,并使用独立的出站调用守门人。
- 商业智能体也正被推向更深的工作流:Cognition 推出了 Devin Cloud in Terminal 和 devin ssh,让模型的虚拟机可直接从 CLI 访问,并允许在 Devin 与用户的机器之间交接。GitHub Copilot 预告了桌面应用中的可编辑 diff,而 @pierceboggan 展示了一个集成 Sentry 的画布,用于从崩溃报告一路走到修复。
- 一个反复出现的系统层面观点:推理和智能体基础设施正转向测试时算力:@sarahookr 预测算力将从边际 FLOPs 收益递减的预训练,转向测试时算力,这需要“非常不同的基础设施”。这一主题也出现在关于本地服务持久化缓存的讨论中,例如 @TheZachMueller 谈到 SGLang 的多级 hiCache(GPU/RAM/磁盘),可在模型切换和重启之间保留 KV 缓存。
热门推文(按互动量)
- Grok 4.7 发布:SpaceXAI 宣布了 Grok 4.7,称其在价格和速度不变的情况下相比 4.6 有显著提升。后续评测结果好坏参半:Artificial Analysis 报告其在 Coding Agent Index 上得分 56,在 DeepSWE/Terminal-Bench/SWE-Atlas-QnA 上有所提升,而 Vals 看到它在 Vals Index 上排名 第 24,比 Grok 4.6 下降 5 分,尽管在法律/医疗方面有提升。
- OpenAI 的自动化模型训练工作流:@wallstengine 一则被广泛转发的摘要称,OpenAI 已在很大程度上自动化了实验性模型训练的部分环节,包括编写 GPU kernel 和代码优化,内部智能体相互协作,把一些实验从数年压缩到约一周。
- OpenAI 数学顾问组与“解决公开难题”的说法:OpenAI 宣布成立一个由数学家组成的独立顾问组,指导对 AI 在数学领域进展的评估与沟通。随后,关注点转向了更强的说法——经 @AndrewCurran_ 等人放大——即 OpenAI 的一个内部模型已解决数学领域 100 多个长期悬而未决的问题。这是本期内容中影响最重大、但最缺乏独立评估的事项之一。
- 开源有价值的数据资产:@ClementDelangue 重点提到 Eidon AI 开源了 1,274 小时的第一人称机器人数据(13,451 条录制),这是一家创业公司在关停后仍为社区保留影响力的罕见案例。
AI Reddit 回顾
/r/LocalLlama + /r/localLLM 回顾
1. Qwen-Image 2.1 与小型开源图像模型
- Qwen-Image-2.1 发布了!(热度:2485):Qwen-Image-2.1 以开放权重发布,是一款统一的 7B 图像生成/编辑模型,定位为 Qwen-Image 系列中更快、成本更低的成员(博客、GitHub、Hugging Face)。主要技术新增包括:原生 RGBA/透明图像生成与编辑,最多支持 10 张参考图,多图推理加速,以及针对物体移除、属性更改、保留产品/人像的编辑、全景图、信息图、字体排印和虚拟试穿等任务的局部编辑控制。评论主要强调原生透明管线和局部编辑界面;有一个示例用彩色圆圈同时指定三个区域,分别完成移除、头发换色和服装替换,这表明人们对更可控的多区域编辑工作流很感兴趣。
- 据报道,Qwen-Image-2.1 新增了原生透明图像生成以及透明图像编辑支持,这在技术上值得注意,因为 alpha 通道工作流通常是作为后处理或蒙版来处理,而不是由图像模型直接完成。链接的示例展示了透明输出能力:https://preview.redd.it/59fu834idoqh1.png?width=767&format=png&auto=webp&s=5fb81b135b35dac70f9d38a9995d7c1a7a2877dd
- 该模型似乎支持通过视觉标注进行多区域局部编辑,即可以在提示词中引用被圈出的区域并同时编辑它们。一个示例要求:“移除蓝色圆圈中的金属手表,把红色圆圈中的头发改成黑色,并把绿色圆圈中的区域替换成灰色短袖亚麻睡衣”,在一次编辑中同时完成了物体移除、属性修改和区域替换:https://preview.redd.it/cvh09tyvdoqh1.jpeg?width=1242&format=pjpg&auto=webp&s=32077f7420def5bec85160e2e982d6aef5efce54
- 几位评论者强调了模型大小:Qwen-Image-2.1 被描述为
7B参数,明显小于此前的 Qwen 图像模型,评论者称后者超过20B。这一体积缩减被认为对本地推理的可行性很重要,有用户特别从 16GB 显存 GPU(如 RTX 5060 Ti 16GB)的角度表达了兴趣。
- 关于 Qwen-image-2.1 许可证的澄清(热度:948):这张图片是 Qwen Developers 在 X 上的一则帖子的截图(并非梗图),澄清了 Qwen-Image-2.1 的输出不被视为受许可的“Materials”,因此用户保留对所生成图像/内容的权利。这一点之所以重要,是因为据称模型许可证对 Materials 的使用仍含有非商业限制,这使得即便生成的输出归用户所有,是否允许商业图像生成也仍不明确。评论者欢迎这一澄清,其中一位用户称 Qwen-Image-2.1“轻松击败目前所有 Flux 模型”。另一位提到可以通过 ComfyUI int8 在
16 GB RTX 5060 Ti上本地运行,显存峰值约15.2 GB,但提醒说 Hugging Face 上的 LICENSE 文件可能尚未反映澄清后的本意。- 一位评论者报告称,在 16 GB RTX 5060 Ti 上通过 ComfyUI 以
int8量化本地运行 Qwen-Image-2.1,显存峰值约15.2 GB。他们认为该模型适合本地测试,但指出围绕生成输出的许可不确定性是其更广泛使用或用于客户项目的主要障碍。 - 几位评论者指出了法律与实现之间的不一致:Hugging Face README 似乎已经做了澄清,但实际的 LICENSE 文件中仍含有第
2(b)条的措辞,禁止对 Materials 的商业“使用”。有位用户给model-business@notice.qwencloud.com发了邮件,询问许可证文本是否会更新,因为推文/README 的本意可能不足以用于客户或商业工作。 - 争论的关键技术/法律区分在于:“不允许商业使用”是否仅适用于提供服务、再分发或将模型/Materials 变现,还是同时也限制模型生成的输出。评论者认为,在权威的许可证文件更新之前,下游用户拿它与宽松的 Apache-2.0/MIT 式模型许可证相比较,尽管有了澄清,仍可能有理由避开商业工作流。
- 一位评论者报告称,在 16 GB RTX 5060 Ti 上通过 ComfyUI 以