Voice Arena 与 Hugging Face 合作,推出针对印地语和印度英语的开放 ASR 评估
基准测试决定了人们会去构建什么。在 Open ASR Leaderboard 上得分高的模型会被采用并持续迭代,而排行榜没有衡量的能力往往得不到改进。排行榜近期的大量工作都用于让评估指标更值得信赖:
这一切让单一数字(WER)更难被刷分。但它终究只是一个数字。大量研究表明,ASR 的错误率在使用者之间并非均匀分布。Racial disparities in automated speech recognition 发现,商用系统对黑人说话者的表现大约是白人说话者的两倍差,Quantifying Bias in Automatic Speech Recognition 还发现了性别、年龄和口音上的进一步差异。这些在排行榜上都看不到,而这并不是排行榜在刻意隐藏。它所用的测试集记录了说了什么,却几乎没有记录是谁说的。
为了弥补这一缺口,我们向 Open ASR Leaderboard 引入两个评估集:Monsoon en-IN 和 Monsoon hi-IN。印地语有超过五亿人使用,是多语言标签页上的第一种印度语系语言,而该标签页目前只涵盖欧洲语言。每个评估集都以公开划分和私有划分的形式发布:公开划分可供自行打分,私有划分则被保留,以限制针对基准的专门优化。这四个划分的说话者互不重叠,共包含 4,888 位说话者,每人记录了 12 项说话者属性。
数据收集的设计
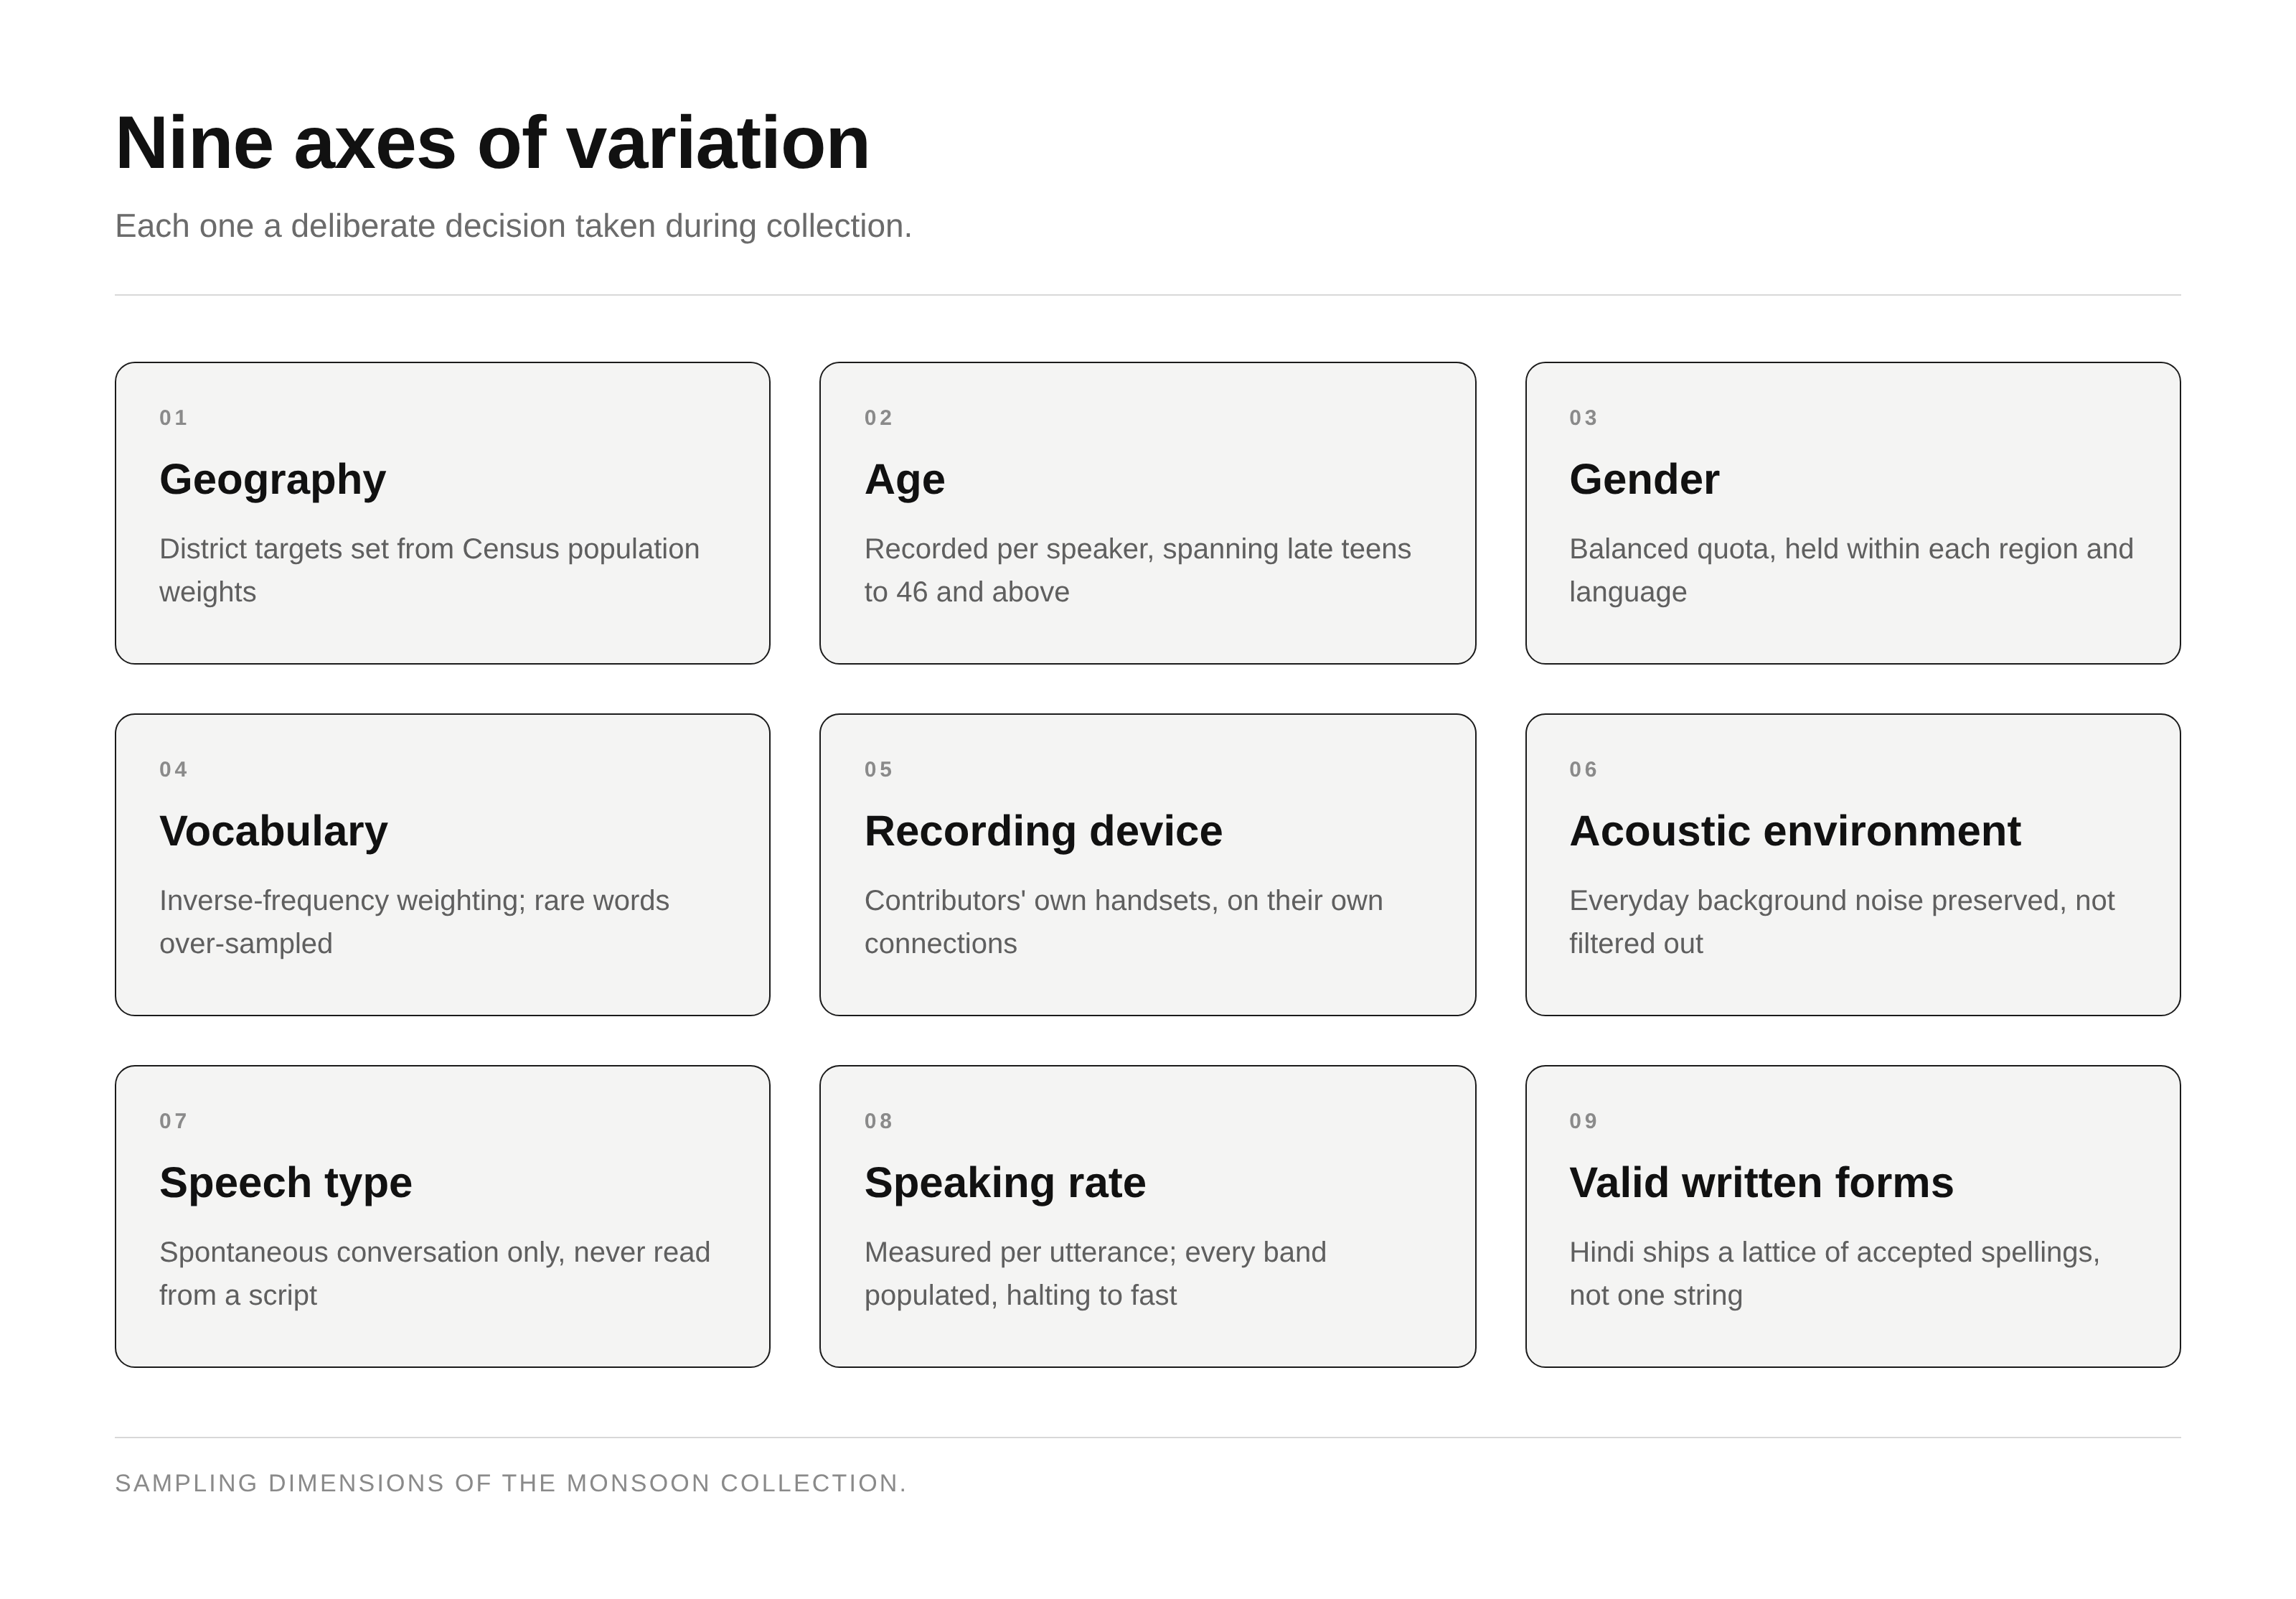
测试集只能暴露它在其上有所变化的那些失效模式。大多数基准是用手头容易获得的音频拼凑而成的。Monsoon 的构建则沿九个维度展开变化:地域、年龄、性别、词汇、设备、声学环境、语音类型、语速,以及同一段音频存在多种有效转写。每一个维度都是汇总 WER 可能在平均意义上正确、却对某个特定人群出错的原因。
收集方法正是由此而来。
- 地域来自在数百个地区招募参与者,而不是在较少的地点录制更长的会话。
- 设备与声学条件来自参与者使用自己的手机和网络,在室内外录音,而不是在安静房间里使用统一提供的硬件。
- 词汇、语音类型和语速来自提示话题:日常话题会促使参与者表达观点、争论、叙述和回忆,而命名实体、数字和未经排练的措辞正是出现在这些场景里。
- 年龄和性别按说话者记录并经过核实。
- 多种有效转写是参考文本的属性,而非音频的属性,后文有专门一节讨论。
数据集构成
四个划分,两种语言,通过同一条流水线收集。
| 数据集 | 语言 | 时长 | 说话者 | 片段长度(均值 / 中位数) | 男/女 | 地区 | 邦/中央直辖区 | 设备 | 风格 | 转写 |
|---|---|---|---|---|---|---|---|---|---|---|
| Monsoon en-IN 公开 | 印度英语 | 5.62 小时 | 1,444 | 9.6s / 10.4s | 50/50 | 428 | 24/6 | 556 | 对话式、自发 | 已归一化,含不流利语段 |
| Monsoon en-IN 私有 | 印度英语 | 5.58 小时 | 1,405 | 9.6s / 10.4s | 45/55 | 420 | 24/6 | 560 | 对话式、自发 | 已归一化,含不流利语段 |
| Monsoon hi-IN 公开 | 印地语 | 1.33 小时 | 468 | 6.4s / 5.0s | 54/46 | 202 | 11/3 | 315 | 对话式、自发 | 格(lattice,接受的正字法变体) |
| Monsoon hi-IN 私有 | 印地语 | 4.47 小时 | 1,571 | 6.6s / 5.3s | 55/45 | 295 | 12/3 | 582 | 对话式、自发 | 格(lattice,接受的正字法变体) |
数据来自无脚本的双声道自发对话,片段从单一声道中切分,因此每个片段只含一位说话者。除表中列出的字段外,每个片段还记录了职业、学历、婚姻状况、收入档次、手机品牌、当前所在城市以及在当前地区居住的年数。
公开印度英语划分中的五个片段,以及各自携带的元数据:
29 岁女性,特里普拉邦西特里普拉。学生,samsung SM-G781B。
32 岁女性,中央邦萨特纳。无业,samsung SM-E146B。
22 岁男性,比哈尔邦罗赫塔斯。学生,motorola moto g54 5G。
27 岁女性,特伦甘纳邦瓦朗加尔。无业,vivo V2247。
57 岁男性,本地治里。私企职员,Xiaomi M2006C3LI。
英语评估集使用标准字符串作为参考文本,排行榜的归一化器能消除其中大部分拼写差异。印地语的拼写变体则多得多,没有任何归一化器能解决,因为这些变体并不是两种书写惯例之间的固定映射。因此,印地语评估集附带了一个格(lattice):对转写文本的每一段,给出一份被接受为正确的拼写列表。
说话者覆盖
以小时计,Monsoon 不大;以说话者数量计,它很大。这是刻意的设计,也是其大部分价值所在。
上述字段之外的说话者集中度与多样性。
| Monsoon hi-IN 公开 | Monsoon hi-IN 私有 | Monsoon en-IN 公开 | Monsoon en-IN 私有 | |
|---|---|---|---|---|
| 每位说话者的片段数(均值) | 1.61 | 1.56 | 1.46 | 1.48 |
| 只有一个片段的说话者 | 261 | 994 | 956 | 924 |
| 每位说话者的音频时长(中位数) | 8.34 s | 8.28 s | 12.36 s | 12.39 s |
| 前 10 位说话者占比 | 6.8% | 3.1% | 2.8% | 2.9% |
| 当前所在城市 | 289 | 814 | 641 | 584 |
| 设备制造商 | 18 | 25 | 23 | 20 |
由此得出三个特性,每一个讲的都是方差,而不是数据量。
- 没有哪个声音左右得分:贡献最多的十位说话者,占总时长的比例在 2.8% 到 6.8% 之间,且超过一半的说话者只出现一次。Monsoon 上的结果是对数百个不同声音求平均,而不是对少数几位长时间录音的说话者求平均。时长相当的测试集通常是反过来构建的。
- 没有哪个地区或手机型号左右得分:印度英语公开集涵盖 30 个邦和中央直辖区的 428 个原籍地区;印地语评估集因为是印地语带的语言,分布更集中,但仍然分别覆盖 202 个和 295 个地区。录音来自 315 到 582 种不同的设备型号,在任何子集中,单一型号占比都不超过 2.1%。在统一硬件上采集的语料库会过拟合到某一种麦克风响应,而这一个不会。
- 这里的印度英语不是单一口音:这是全国各地所说的英语,而非某一个地区的英语。六个区域全部都有代表:在公开集中,35% 的片段由南部说话者贡献,东部 18%,中部 18%,北部 16%,西部 11%。由这种分布带来的口音差异记录在元数据中,而不是凭空断言。
元数据字段
Monsoon 每个片段提供 18 列,其中 12 列是元数据,而大多数公开 ASR 测试集只提供标识符、转写文本和时长。人口统计字段完整或接近完整,贡献者已同意这种用途。
| 类别 | 字段 |
|---|---|
| 片段 | id, audio, audio_length_s, language |
| 参考文本 | lattice(印地语)或 text(印度英语) |
| 说话者 | speaker_id, gender, date_of_birth |
| 背景 | occupation, educational_background, marital_status, income |
| 地域 | native_district, native_state, current_city, years_spent_in_current_district |
| 录音 | device_manufacturer, device_model |
两种语言的地理分布形态不同,而这种形态本身就带有信息。印地语评估集集中在印地语带,其中北方邦占说话者的约 40%,这正是按人口抽样的印地语语料库应有的样子。印度英语评估集则平坦得多:没有哪个邦超过 13%,并且有三分之一的说话者来自人数最多的八个邦之外。公开和私有两半在这两方面都非常接近。
印度各邦的边界是沿语言界线划定的,因此地区和邦承载着真实的口音信号,这也是这些字段被公开发布而没有被汇总抹去的原因。这类分析已在印度 ASR 上大规模报道过:地区级错误率从约 4% 到 44% 不等,欠代表的地区远落后于印地语带和大都市,此外还按音频质量、语速、语句时长、性别、年龄和设备做了拆分。不过那些实验是在一个封闭基准上进行的。Monsoon 使这一类分析在公开排行榜的测试集上成为可能。
数据收集与质量控制
要实现广泛的地域覆盖,就需要在数百个地区招募,而不是从较少的说话者那里录更长的会话。而这种规模的分散招募会带来较小规模的收集所不会遇到的失效模式:贡献者钻任务的空子、把回放的音频冒充现场说话提交,以及标注时心不在焉。每一种问题都有明确的检查来应对。
- 招募与录制:贡献者通过 Voice Arena 社区招募。这是一个全球性的数字平台,触达范围延伸到语音语料库很少覆盖的农村和半城市化地区。随后,两人一组通过点对点界面,围绕指定的日常话题录制双人对话,采用双声道。贡献者使用自己的手机和自己的网络,其中许多是低端设备,带宽也不稳定,因此发布的音频中保留了这类条件,而没有将其过滤掉。潜在贡献者在获得录音权限之前要先完成语言水平筛选,并获得报酬,同时提供知情同意,涵盖用于训练和分发。我们还按语言设置了单个说话人的时长上限,该上限根据各语言使用者的人口规模和地理分布校准,以避免少数高产贡献者主导某一语言或地区;这些数据集中,超过一半的说话人恰好只贡献了一个片段。
- 话题引导:大规模采集自发语音本身就有难度,因为没有结构化引导时,贡献者往往只给出简短、零散的回应。因此,每段对话都以一个开放式的叙述提示和逐步揭示的追问作为起点,涵盖旅行、医疗、农业、教育和数字服务等领域,在不预设脚本的前提下引导对话走向较长的描述。候选话题由大语言模型生成,再由母语语言学家审阅并做本地化处理。
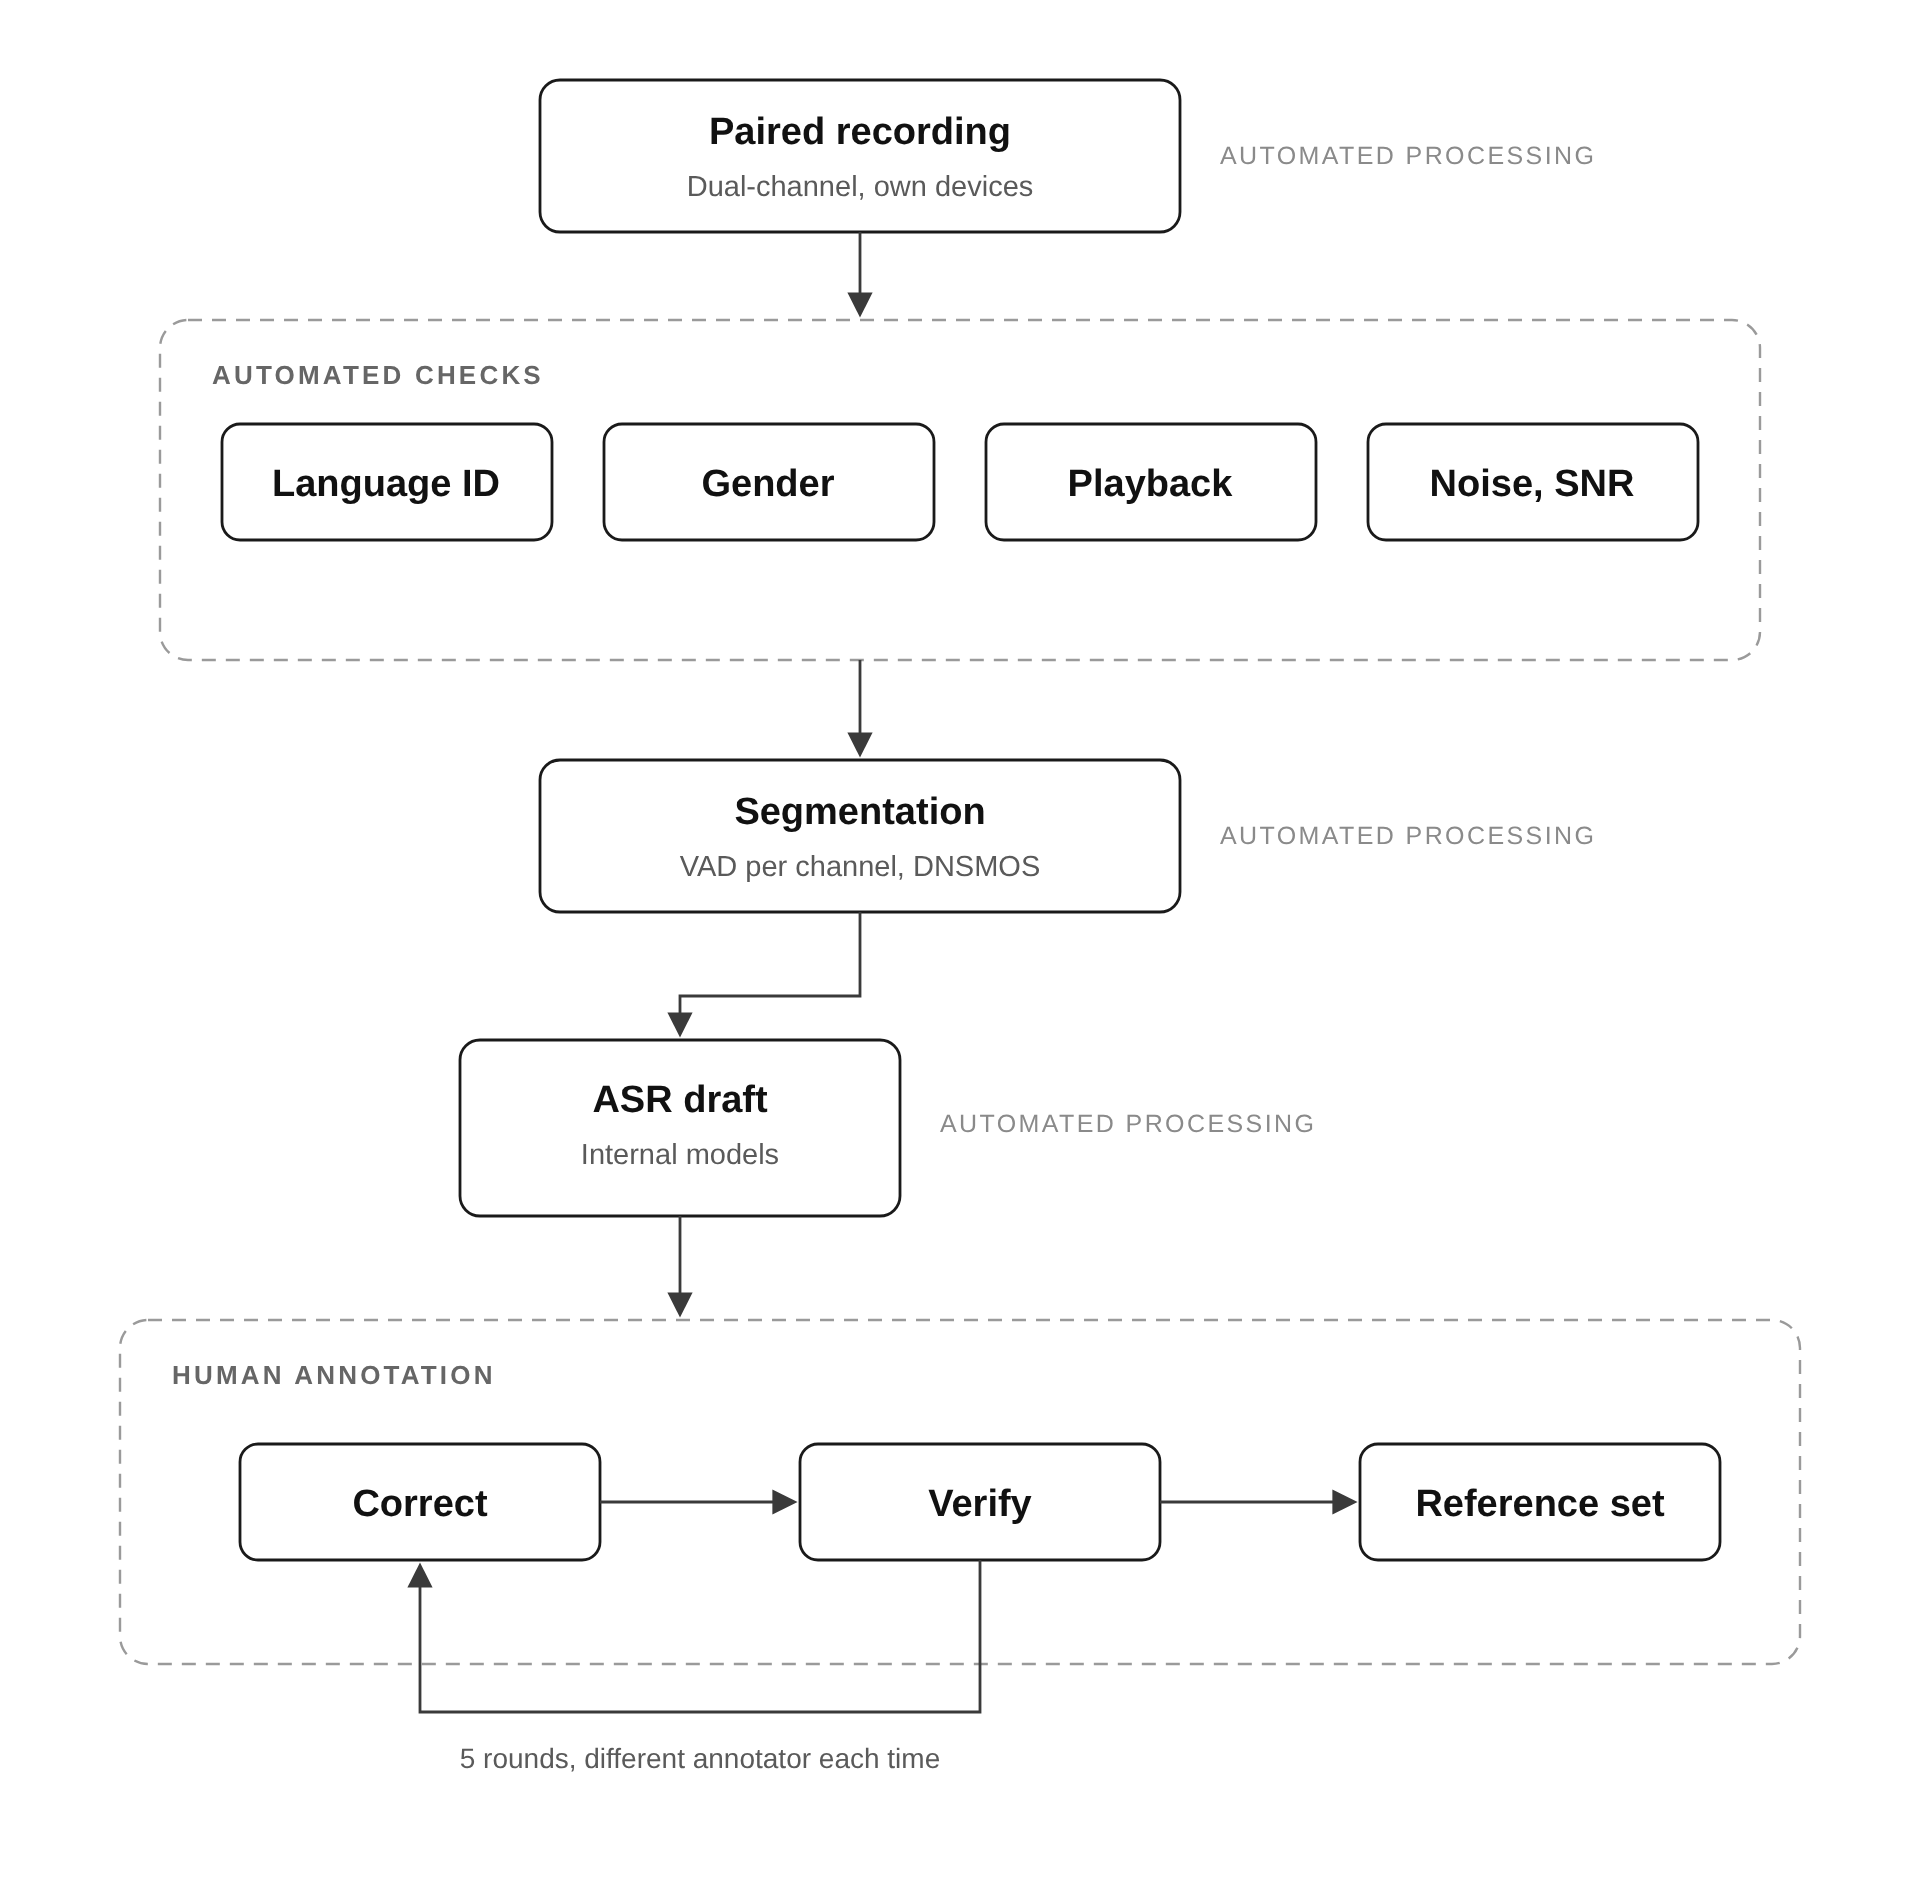
- 质量控制:每条录音在转写之前都要通过一组关卡检查。我们使用在 30 多种语言的人工标注数据上训练的语种识别模型,核验所说语言与指定语言是否一致。说话人性别则用专门的分类器与自报标签比对确认,该分类器只是用来佐证自报信息,而不是取代它。另一个模型用来区分真实的自发对话与预先录制或回放的音频。信噪比估计会剔除劣化到无法听清的录音,同时有意保留自然的环境背景噪声,以保持真实场景语音的声学真实感。通过这些检查的录音,再用语音活动检测进行切分:在连续静音达到两秒处切分,或在十五秒的软上限之后、于下一个检测到的静音处结束。切分按声道独立进行,因此每个片段都是单说话人、单声道。随后片段还要通过 DNSMOS P.808 检查。
- 转写:参考转写文本出自人工。初稿由在领域内数据上训练的内部 ASR 模型生成,这些模型都没有出现在任何公开排行榜上,因此在这些数据集上接受评测的系统,都没有参与它们所对照的参考文本的生成。此后的每个环节都由母语语言学家按五级流程完成,该流程建立在严格的分工之上:每一轮修正之后,都由另一位标注员进行独立核验,因此没有语言学家会审核自己的产出。第一位语言学家对照声学信号逐个片段修正初稿;第二位重新核验,并标出仍存在的分歧。后续各级由新的标注员迭代这一循环,逐步解决含糊的语音实现、语码转换边界、命名实体,以及不同拼写变体之间的正字法一致性问题。数字一律写成文字,使转写文本与实际所说内容直接对应。到最后一级仍被标记的片段,会退回重新转写后才能入库。整个过程中,系统会自动监控标注员的行为,对包含目标文字之外字符、不自然的字符或单词重复,以及编辑次数异常偏低或偏高的提交进行标记。
地区差异
下面是一个例子,在公开的印度英语子集上运行,用来说明这些元数据能够支持哪类评估。这并不是这些数据集要交付的结论,而是用来说明:一旦每个音频片段都带有说话人信息,哪些问题就变得可以回答。
排行榜上的八个模型在这个数据集上的 WER 介于 4.81 和 4.99 之间,从最好到最差只差 0.18 个点,落在五小时数据所能分辨的范围之内。按整个语料库排名,它们就是同一个模型。
按地区对说话人分组,结果就不一样了。每位说话人的出生地所在区被归并到其所属的区域委员会(zonal council),这是印度内政部对各邦的分组方式,由此得到五个采样充分的区域。openai/whisper-large-v3-turbo 在这些区域间相差 0.46 个点。mistralai/Voxtral-Mini-3B-2507 在整个语料库上仅落后它 0.14 个点,区域间的差距却达到 1.68:中部地区为 4.38,东部地区为 6.06。两个在排行榜上无法区分的系统,其准确率对说话人所在地区的依赖程度却相差近四倍。
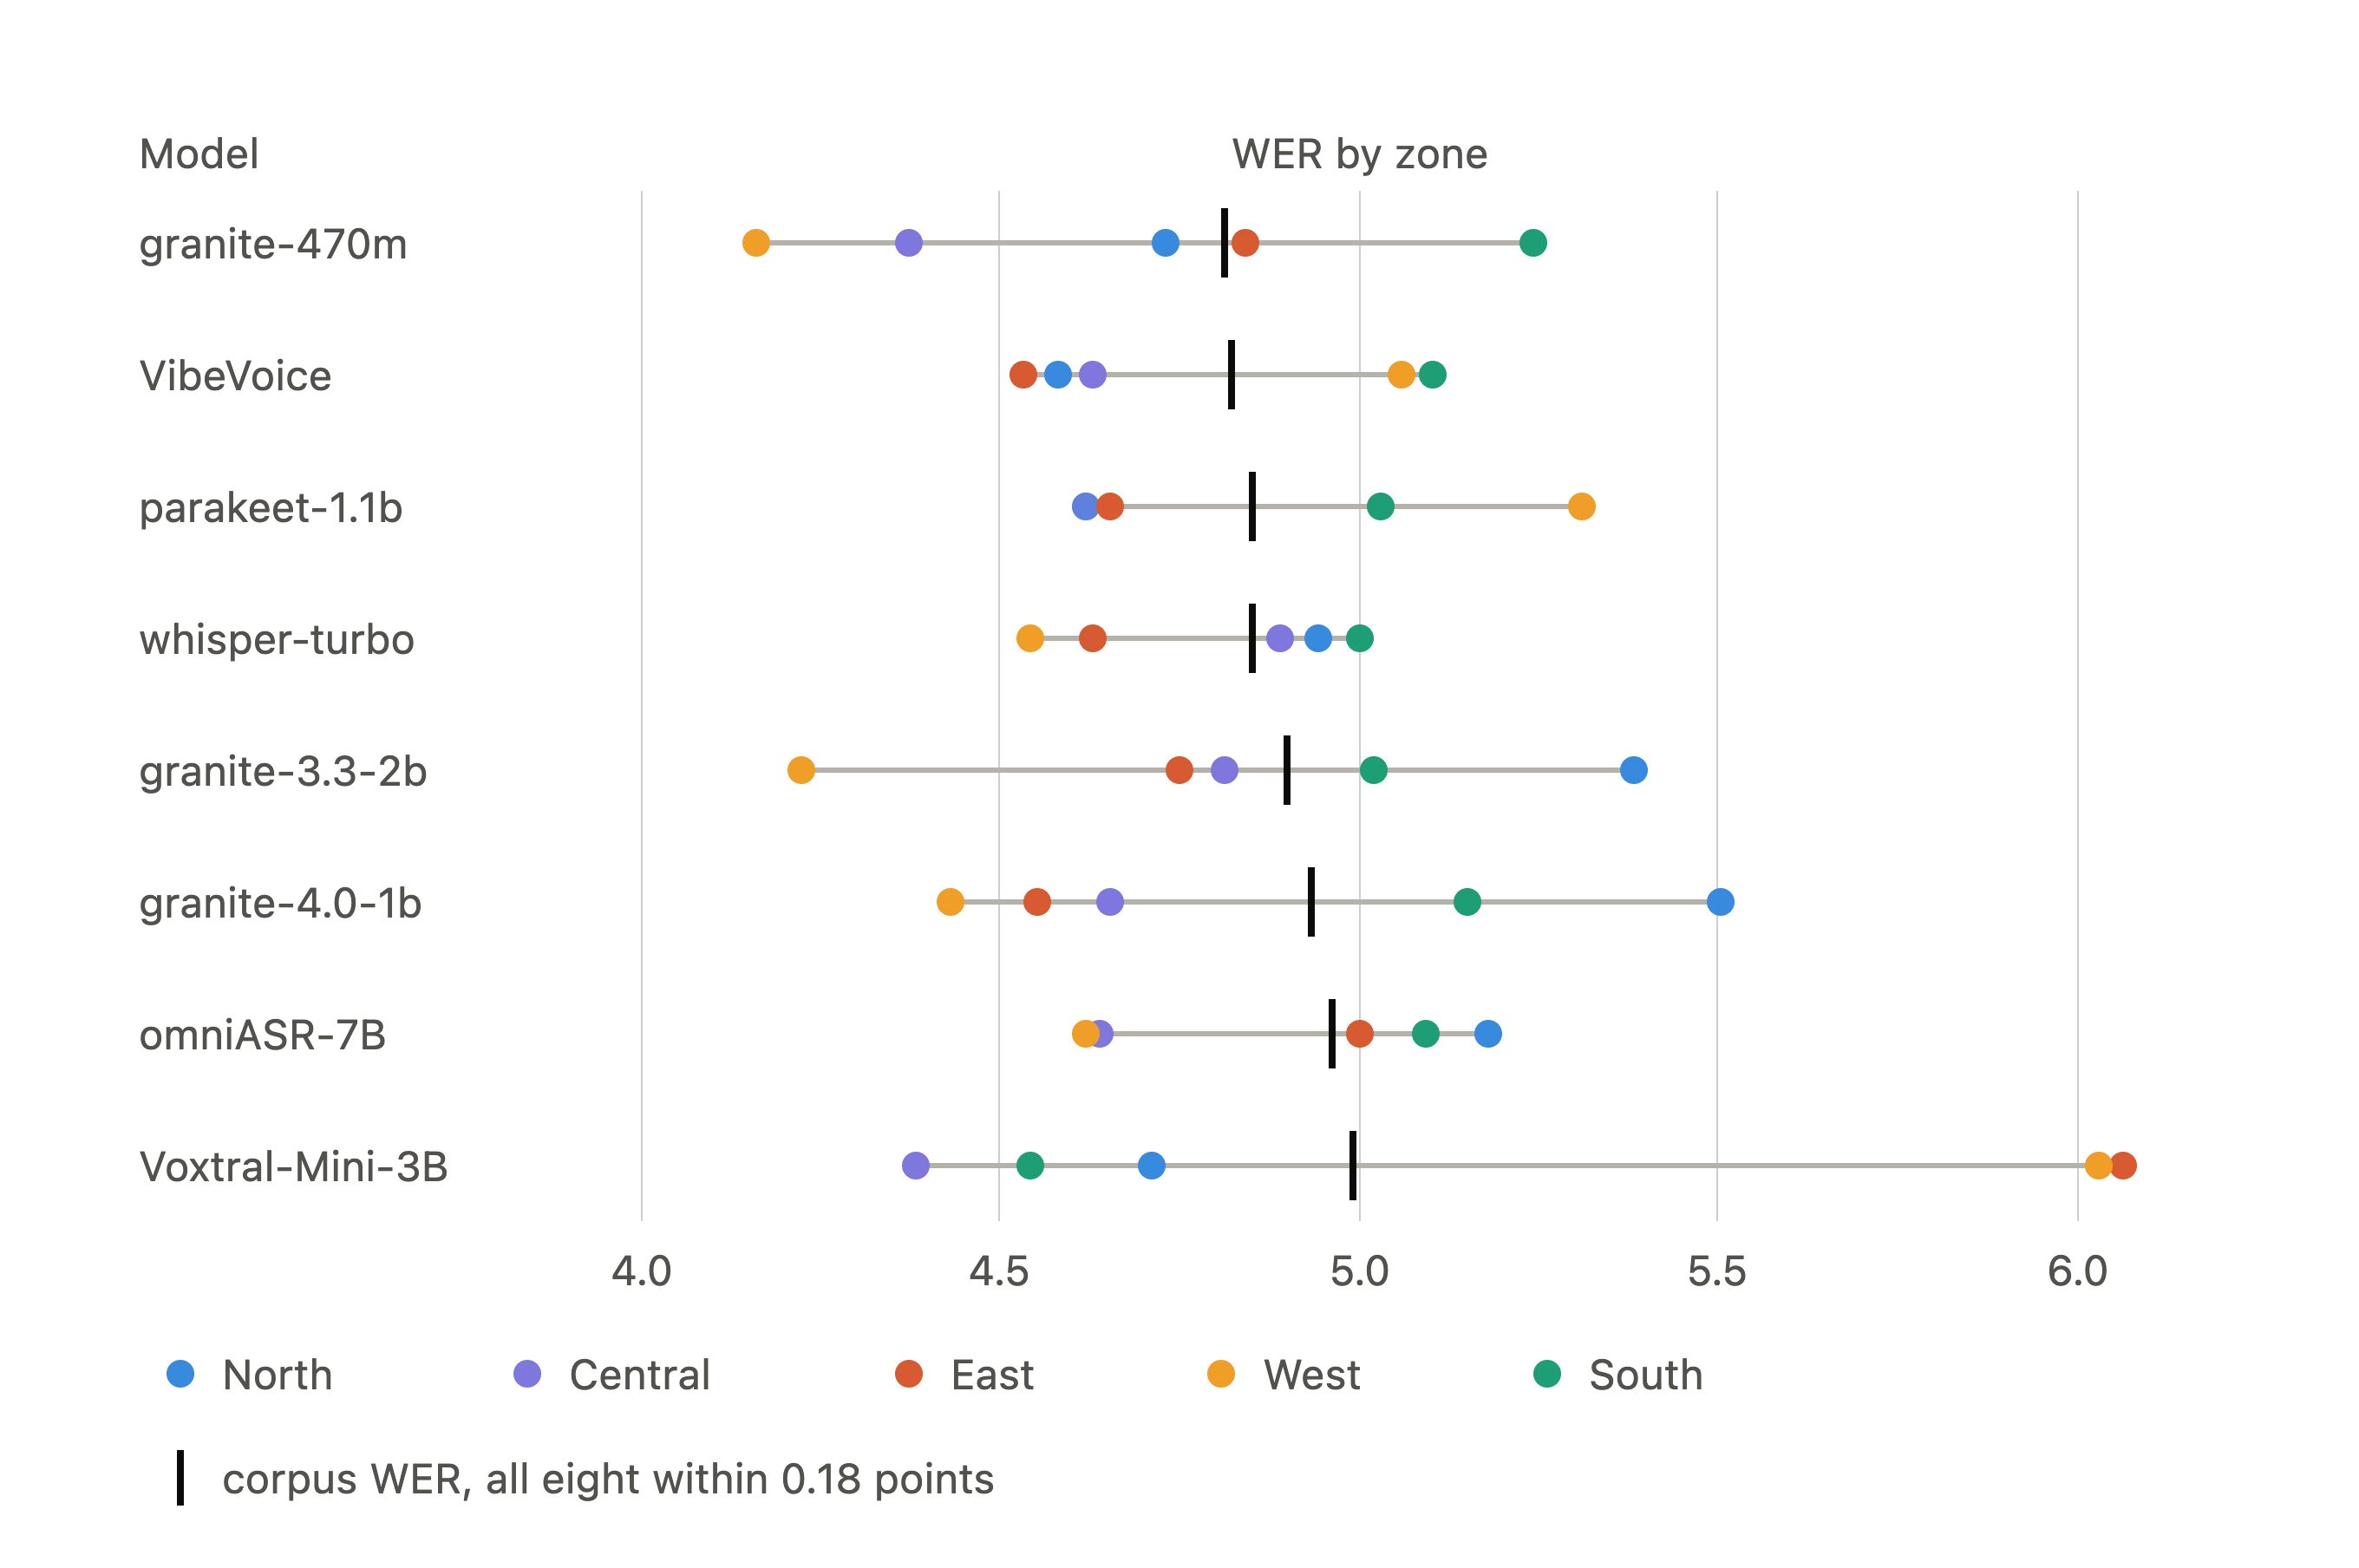
哪个区域最难,同样并不固定。ibm-granite/granite-speech-3.3-2b 在北部表现最差,microsoft/VibeVoice-ASR-HF 在南部最差,mistralai/Voxtral-Mini-3B-2507 则在东部最差。如果某一个地区本来就更难转写,那么所有模型对各区域的排序应当一致。事实并非如此,这说明问题出在模型,而不是音频。
地区只是记录的十二项属性之一,上述区域也只是 428 个地区的粗略归并。同样的拆分还可以按年龄、教育程度、职业和手机型号进行,发布的文件中包含复现所需的全部信息。而对于只记录了说话内容的测试集,这些信息一概无从获得。
印地语的正字法变体
英语的正字法变体是有边界的。英式与美式拼写、标点、大小写、数字与单词写法:归一化器可以把其中大部分映射到单一形式,排行榜的归一化器也是这样做的。印地语则不同,它没有这样的边界。日常口语中语码混用十分普遍,源自英语的词在天城文中没有固定的拼写,复合词写成连写还是分写则取决于个人偏好。同一个短语可能有十种甚至更多种有效的书写形式,而任何固定的映射都无法将它们归并,因为并不存在一个可以作为映射目标的规范形式。
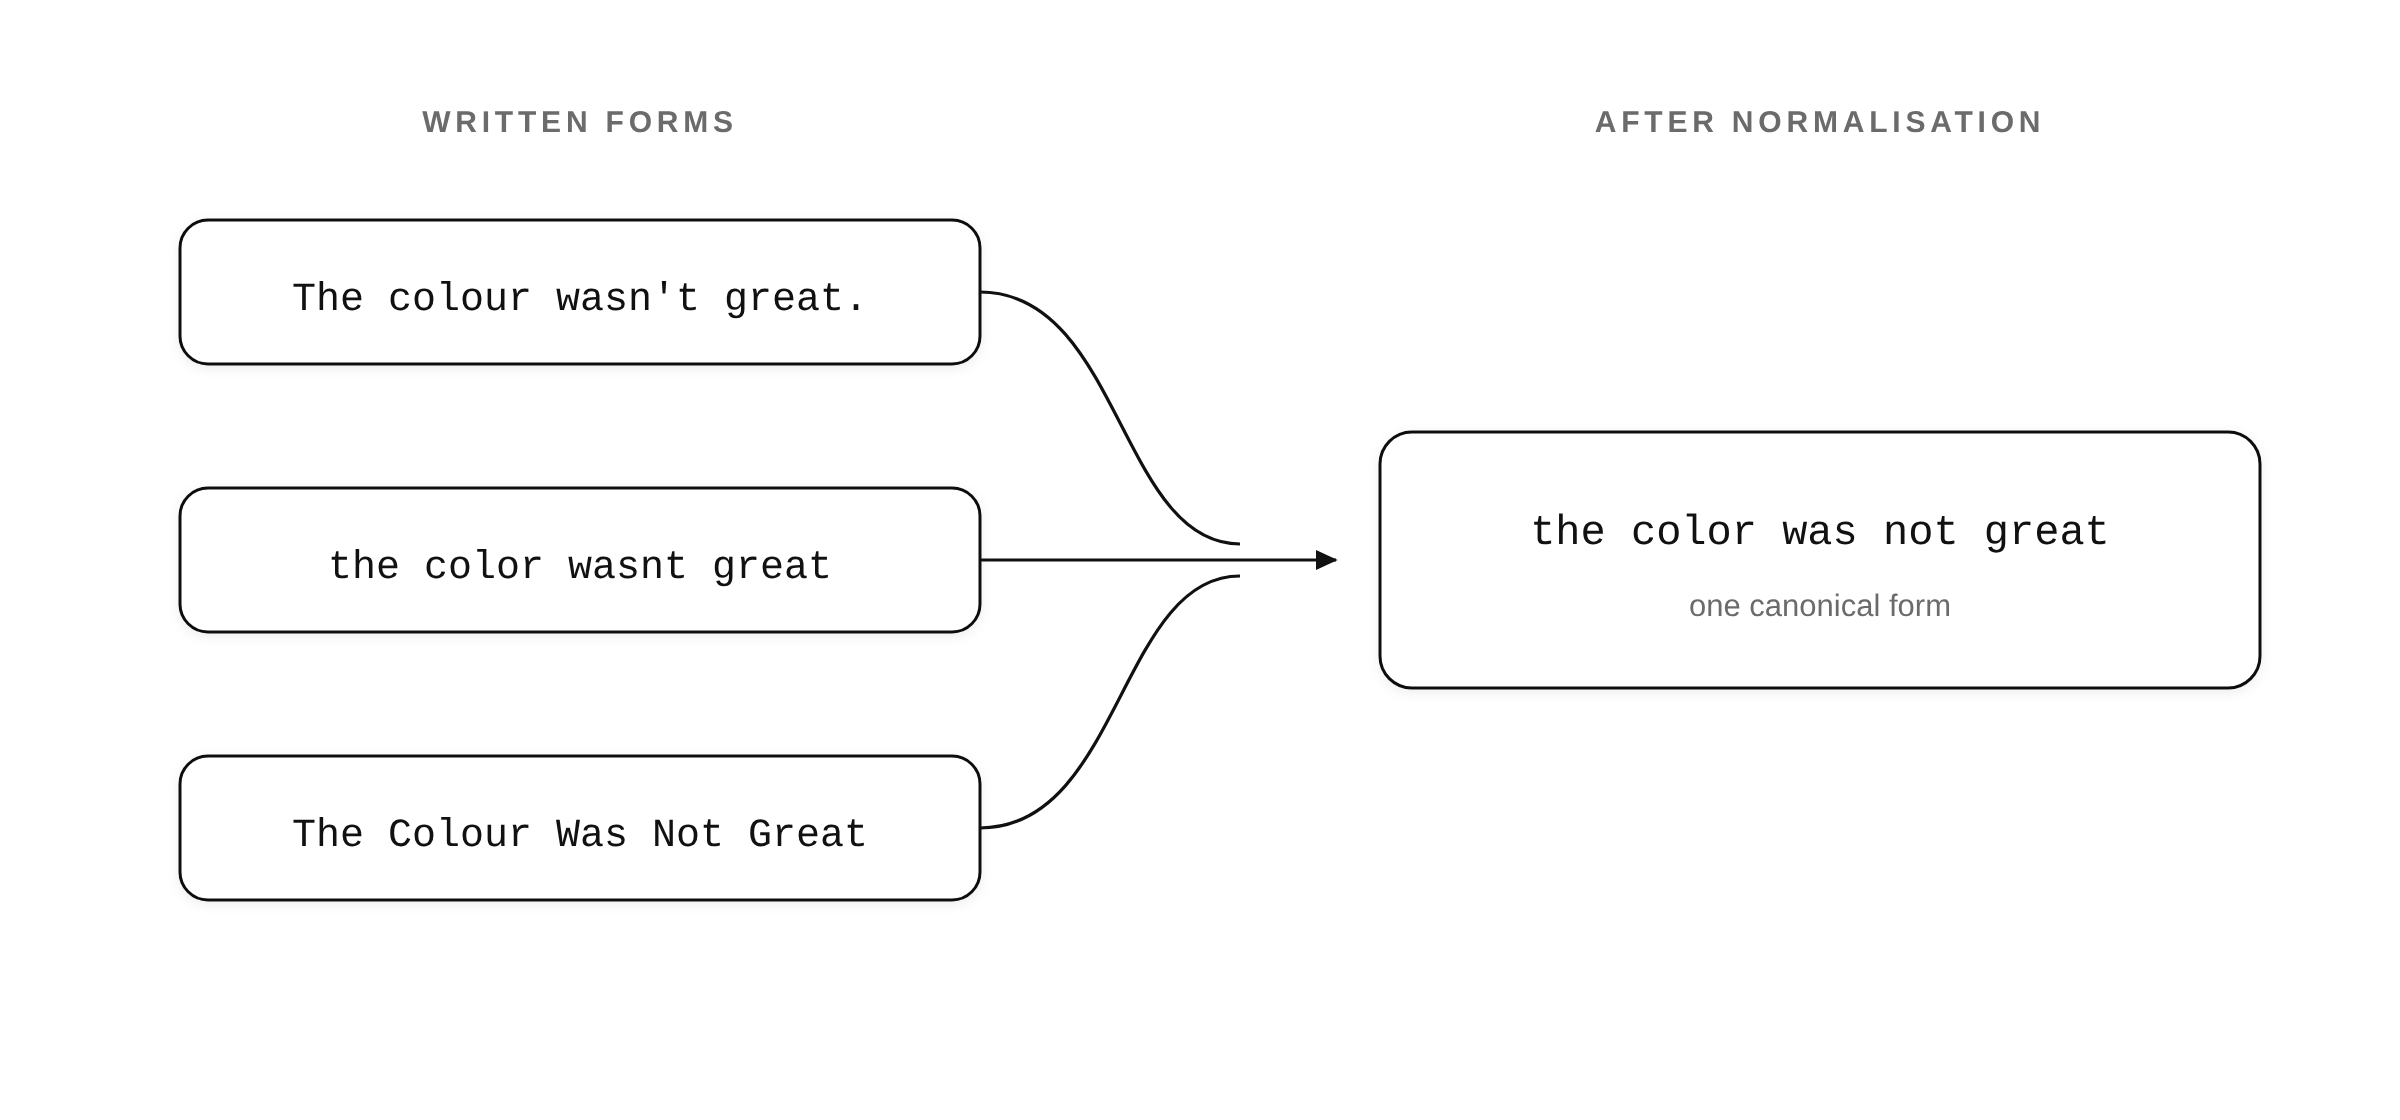
只用单一参考文本打分时,WER 会奖励恰好产出标注员所选拼写的系统。两个对音频识别效果同样好的系统,仅凭正字法就可能相差好几个点。
因此,印地语数据集附带了一个词格(lattice):对于转写文本的每一个片段,给出被接受为正确的所有书写形式的集合。构建词格是人工活儿。候选变体取自对同一段音频的多个 ASR 转写结果,并借助语言模型扩展,再由母语语言学家判断哪些对该句话有效,并剔除其余的,只有与实际所说内容一致的形式才会被收录。
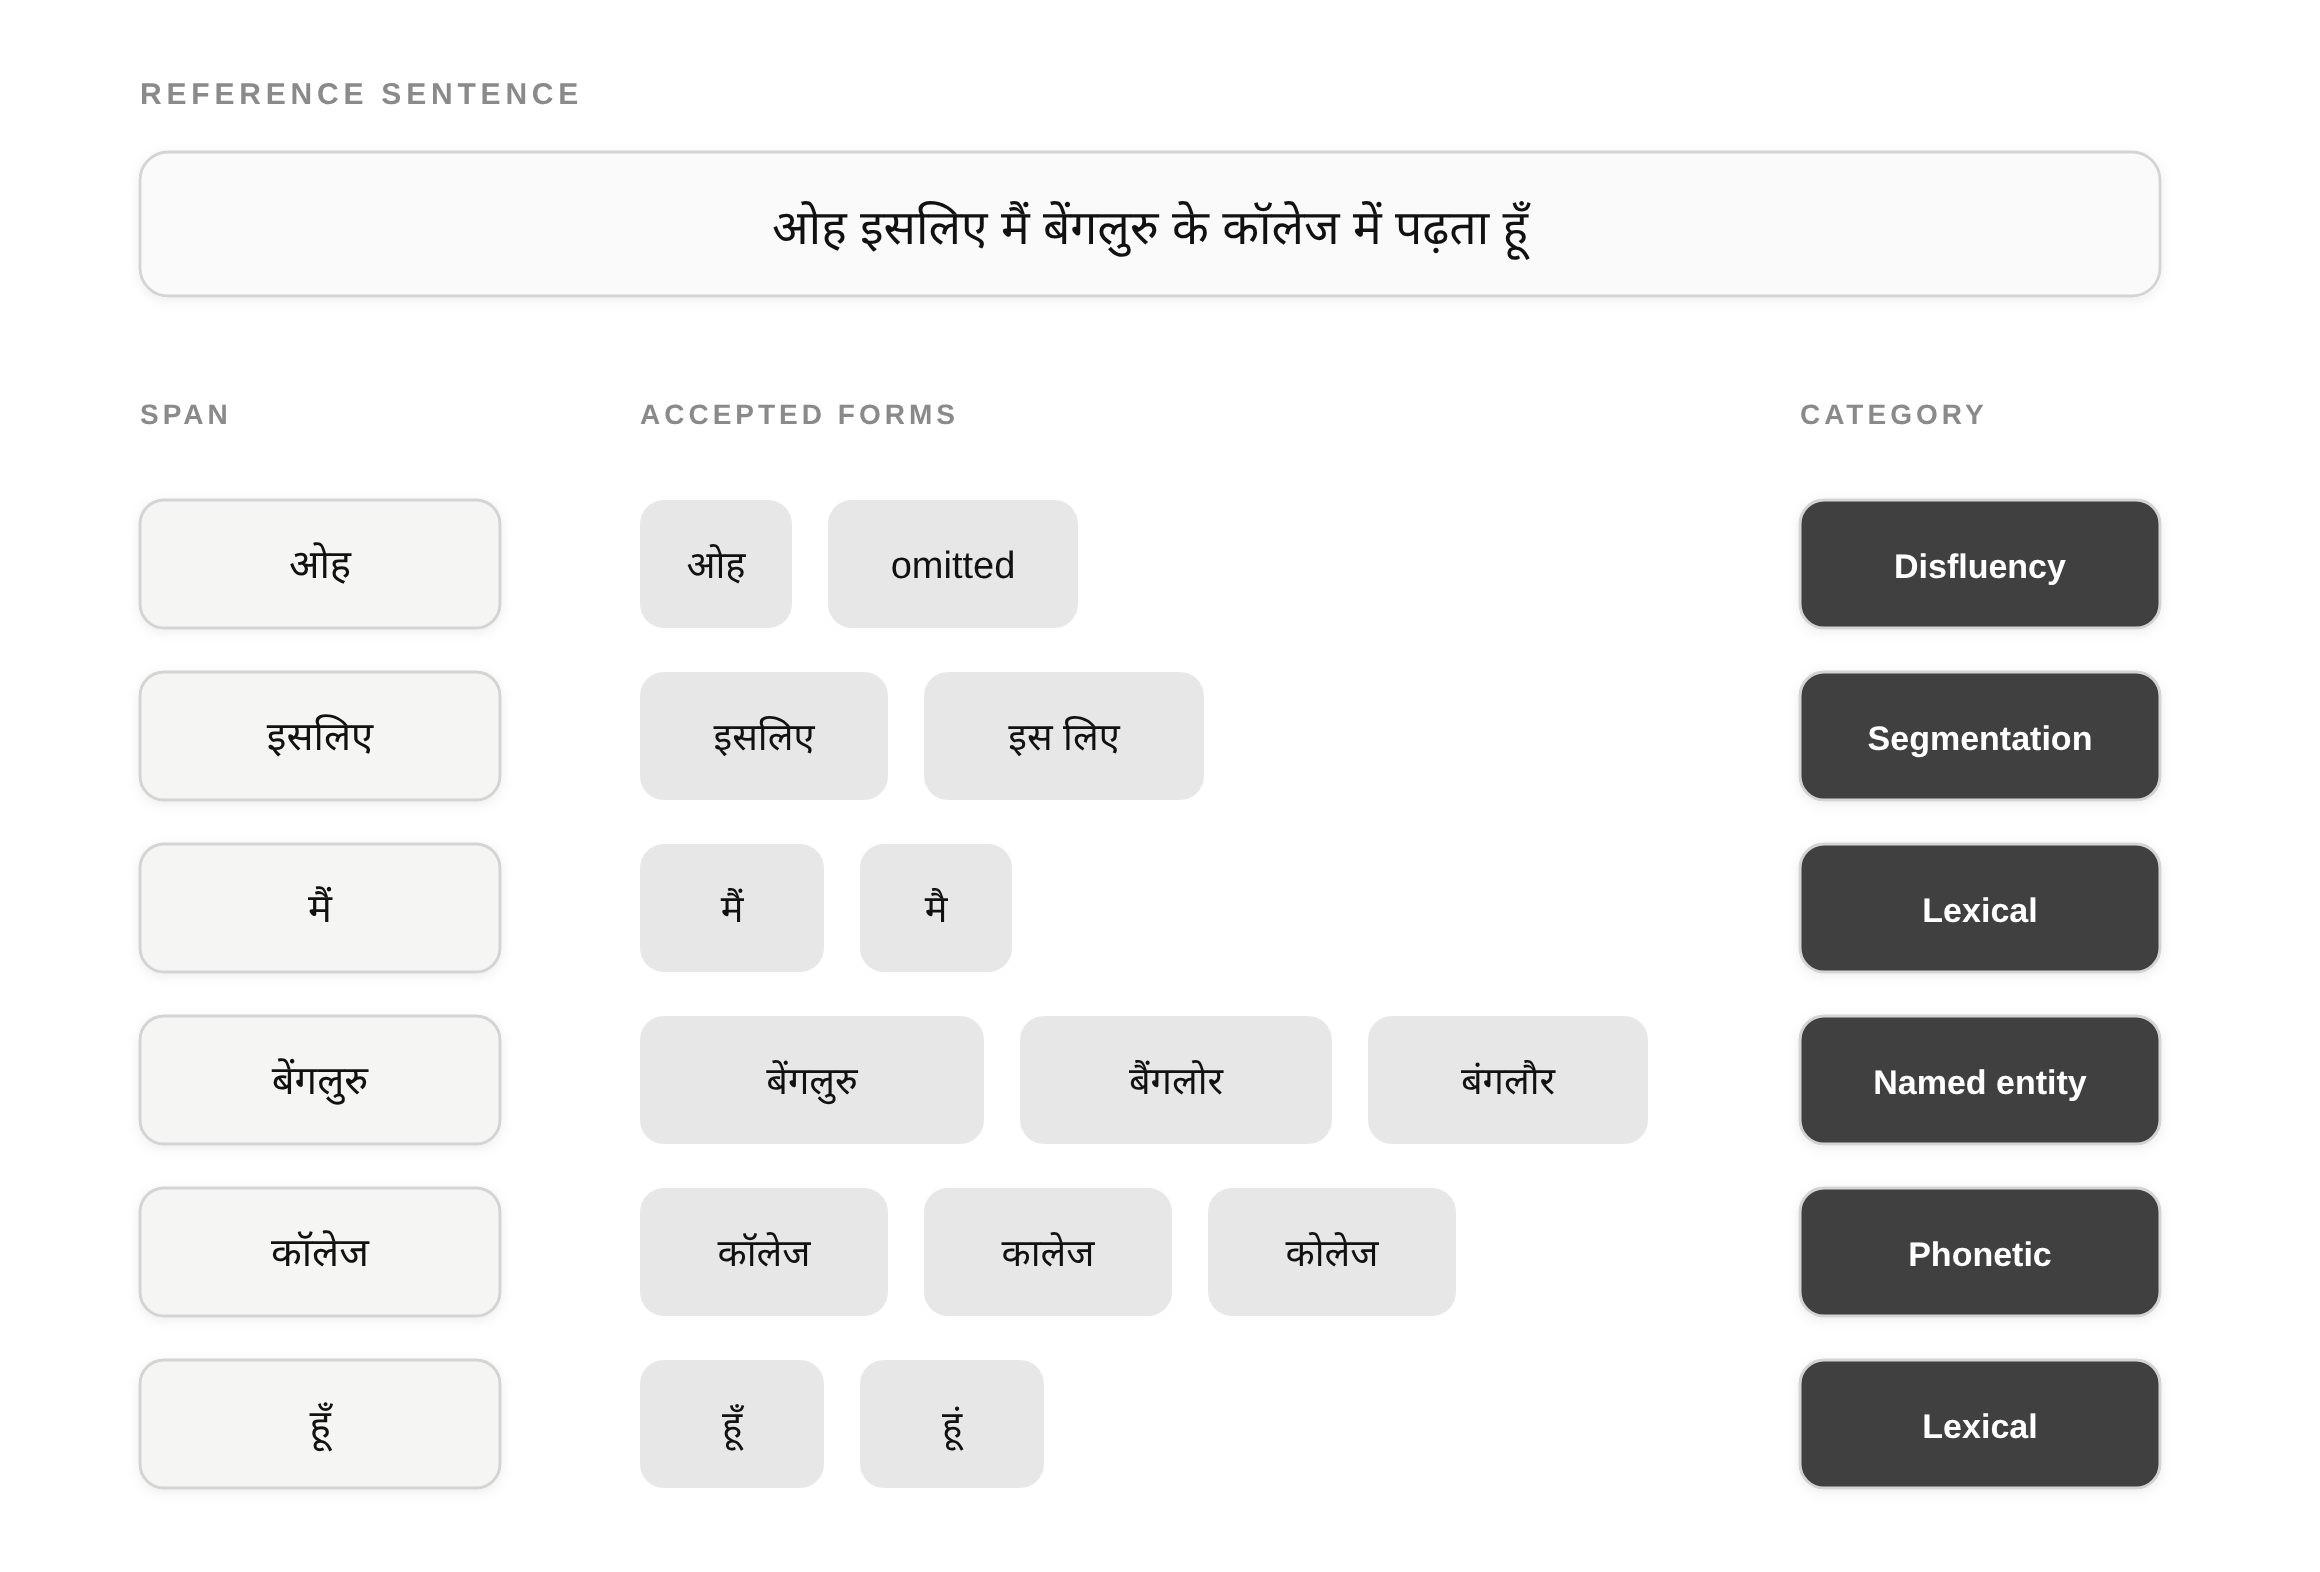
因此,对于印地语,我们报告由 AI4Bharat 提出的正字法感知词错误率(Orthographically-Informed Word Error Rate,OIWER),而不是 WER。假设文本会在每个片段与被接受的形式集合对齐,因此任何被收录的形式都算作正确,只有真正的识别错误才会被计入。
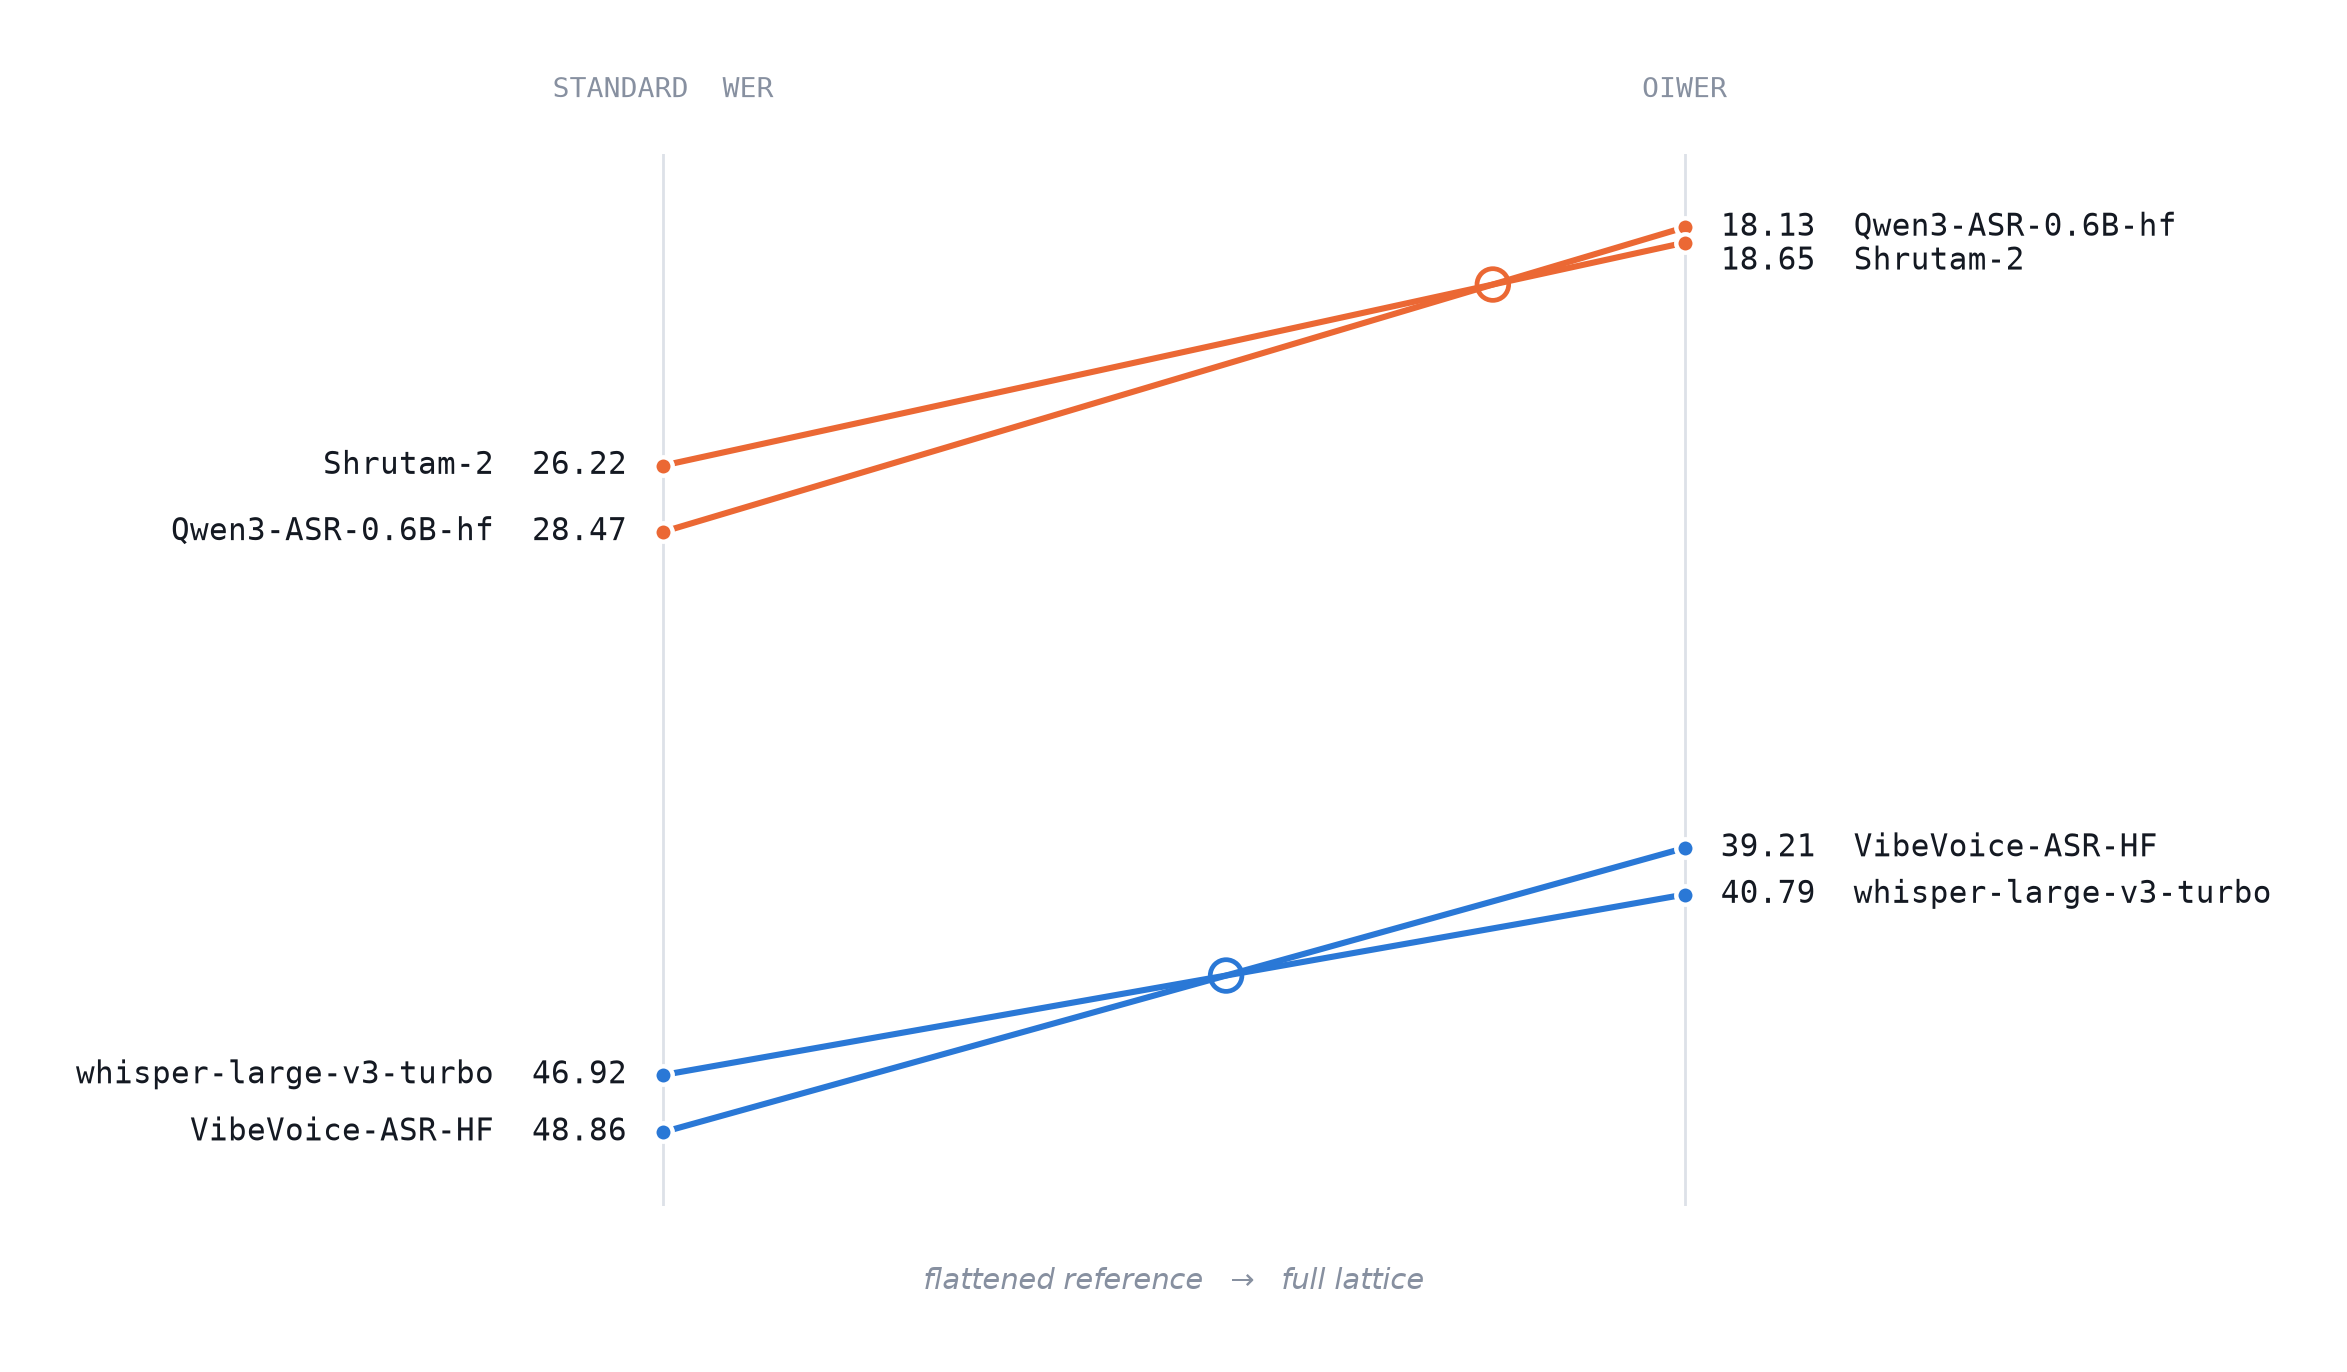
为了量化这一影响,我们对同样的假设文本打了两次分。把每个词格压平为每个片段的第一个变体,就得到一条类似传统基准测试所提供的单字符串参考文本;其实任何一个被收录的变体都同样适用,换一种选择就会得到不同的参考文本。对照压平后的参考文本打分,所有系统的错误率都上升了,而且上升幅度并不一致,排名也随之改变。下图展示了在两种参考文本下排名发生颠倒的两对系统:在单一参考文本下,系统会因为重现了标注员的正字法而部分地获得奖励,而词格只评价识别本身。
我们还开源了自己的实现 voi-oiwer,因此这些数据集上的每一项结果都可以直接复现。
如何参与评测
对于私有子集,请把你的模型提交到 Open ASR 排行榜,Hugging Face 团队会负责运行评测。与以往一样,向排行榜添加模型的流程在 Open ASR Leaderboard GitHub 上进行:
- 提交一个 pull request,会出现一份模型检查清单。与以往一样,你需要报告自己在公开数据集上的结果。
- 我们会在公开数据集上核验这些结果,并在私有数据集上计算指标。
- 确认我们得到的结果。
印度英语以 Voice Arena Monsoon 的形式加入主排行榜,位于默认列集中,而不是作为可选开关,因此它会计入每个模型的总体平均 WER。私有子集与 Appen 和 DataoceanAI 的数据一起,汇入聚合的 Private (conversational) 列。公开和私有的印地语数据出现在多语言标签页中,只有支持所有所选语言的模型才会被排名,这使该列成为同口径的比较。此外,也可以从“Language dataset breakdown”下拉菜单中选择“Hindi”。
接下来
印地语是一个尖锐的例子,反映的是一个普遍问题。任何有不止一种写法、且使用者是基准测试尚未采样的人群的语言,都会同时带有这里描述的两种缺陷。这些数据集并不能修复它们,它们增加的是一种发现问题的方式:在一个业界本来就在关注的排行榜上,提供一个测试集,其中足够多地记录了每位说话人和每条参考文本的信息,使两个系统之间的差异能够追溯到是谁在说话、以及他们如何书写,而不是消失在一个数字里。
这四个数据集是 Monsoon 的一部分,Monsoon 是 Voice Arena 面向全球南方的更广泛的数据集计划。