摘要
经 DPO 微调的开源 LLM 裁判,在评估模型输出方面可以超越 GPT-5.2。我们用 5,400 个偏好对训练 GPT-OSS 120B,使其准确率超过 GPT-5.2,同时成本降低 15 倍、速度提升 14 倍。
这是一篇深入探讨如何利用偏好优化训练开源模型、使其超越 GPT 5.2 的文章。我们证明,经过微调的开源模型(如 gpt-oss 120b 和 Qwen 3 235B Instruct)在留出的评估集上更常与人类偏好标注一致。我们使用 Reward Bench 2 进行评估,它衡量的是与人类判断的一致程度,而不是绝对正确性或真实质量。下表是我们所得结果的快速预览;如果你更想直接看代码,欢迎跳转到 cookbook!
* Together AI 模型页面
** 在 Together AI 上的速度,由第三方 Artificial Analysis 测得
| 模型 | 基线 | + DPO 微调 | 每百万 token 成本* | 成本对比 GPT-5.2 | 速度** | 速度对比 GPT-5.2 |
|---|---|---|---|---|---|---|
| GPT-5.2 | 61.62% | N/A | $1.75 输入 / $14 输出 | - | 62.9 tok/sec | - |
| gpt-oss 120B | 57.91% | 62.63% | $0.15 输入 / $0.60 输出 | 便宜 15.3 倍 | 908.7 tok/sec | 快 14 倍 |
| Qwen3 235B | 62.63% | 61.28% | $0.20 输入 / $0.60 输出 | 便宜 12.4 倍 | 261.6 tok/sec | 快 4.2 倍 |
| Llama 4 Mav | 50.2% | — | $0.27 输入 / $0.85 输出 | 便宜 9.1 倍 | 64.7 tok/sec | 快 1 倍 |
LLM 作为裁判的悖论
有个悖论困扰我已经有一阵子了:我们用 LLM 来评估 LLM。产生幻觉的同一种技术,如今却成了我们检测幻觉的主要工具。这听起来像是让狐狸去看守鸡舍 😀。
但它确实有效。不仅有效,它已经成为大规模评估 LLM 驱动产品的主流框架。
原因很简单:对大多数任务而言,评判比生成更容易。LLM 生成回复时,要处理复杂的上下文、遵循多步骤指令,并综合训练数据中的信息。而它评估一条回复时,执行的是一个聚焦的分类任务,形式类似:这段文字是否包含有害内容?回复 A 是否比回复 B 更好?
这一洞见引出了一个有趣的问题:既然评判是更简单的任务,我们能否微调更小的开源模型,让它们成为比庞大的闭源模型*更好*的裁判?
我们做了这个实验,答案是肯定的!
在这篇深度解析中,我们将展示如何使用直接偏好优化(Direct Preference Optimization,DPO)微调开源 LLM 裁判,使其在与人类偏好的一致性上超越 GPT-5.2。内容包括:
- 实验设置与基准测试(RewardBench 2)
- 对 4 个裁判模型(3 个开源、1 个闭源)的基线评估
- DPO 微调方法与结果
- 分类别分析,揭示各模型擅长和不擅长的领域,以及偏好调优在哪些方面有帮助或造成了损害
- 可供你自己动手实现的实用代码!
让我们开始吧。
LLM 作为裁判为什么有效
在进入实验之前,先来建立一下直觉,理解这项技术为何如此有效。
评估的规模化难题
评估 LLM 输出与评估传统机器学习模型有本质区别。对分类器,你可以根据真实标签计算准确率;对推荐系统,你可以用 NDCG 衡量排序质量。
但对于生成式文本呢?“正确”的方式有很多种。一篇摘要可以准确,却不必与参考答案逐字相同;聊天机器人的回复可以用不同风格来提供帮助。BLEU 或 ROUGE 这类指标只能捕捉表面的重合,却无法识别语义等价。
人工评估能处理这些细微之处,但无法规模化。你不可能让人去审阅生产环境中的每一条回复。
LLM 作为裁判登场
关键的突破性洞见在于:LLM 在海量人类撰写的文本上训练,已经内化了关于质量、相关性和恰当性的模式。只要设计出合适的评估提示词,就能激活这些能力,完成聚焦的评估任务。
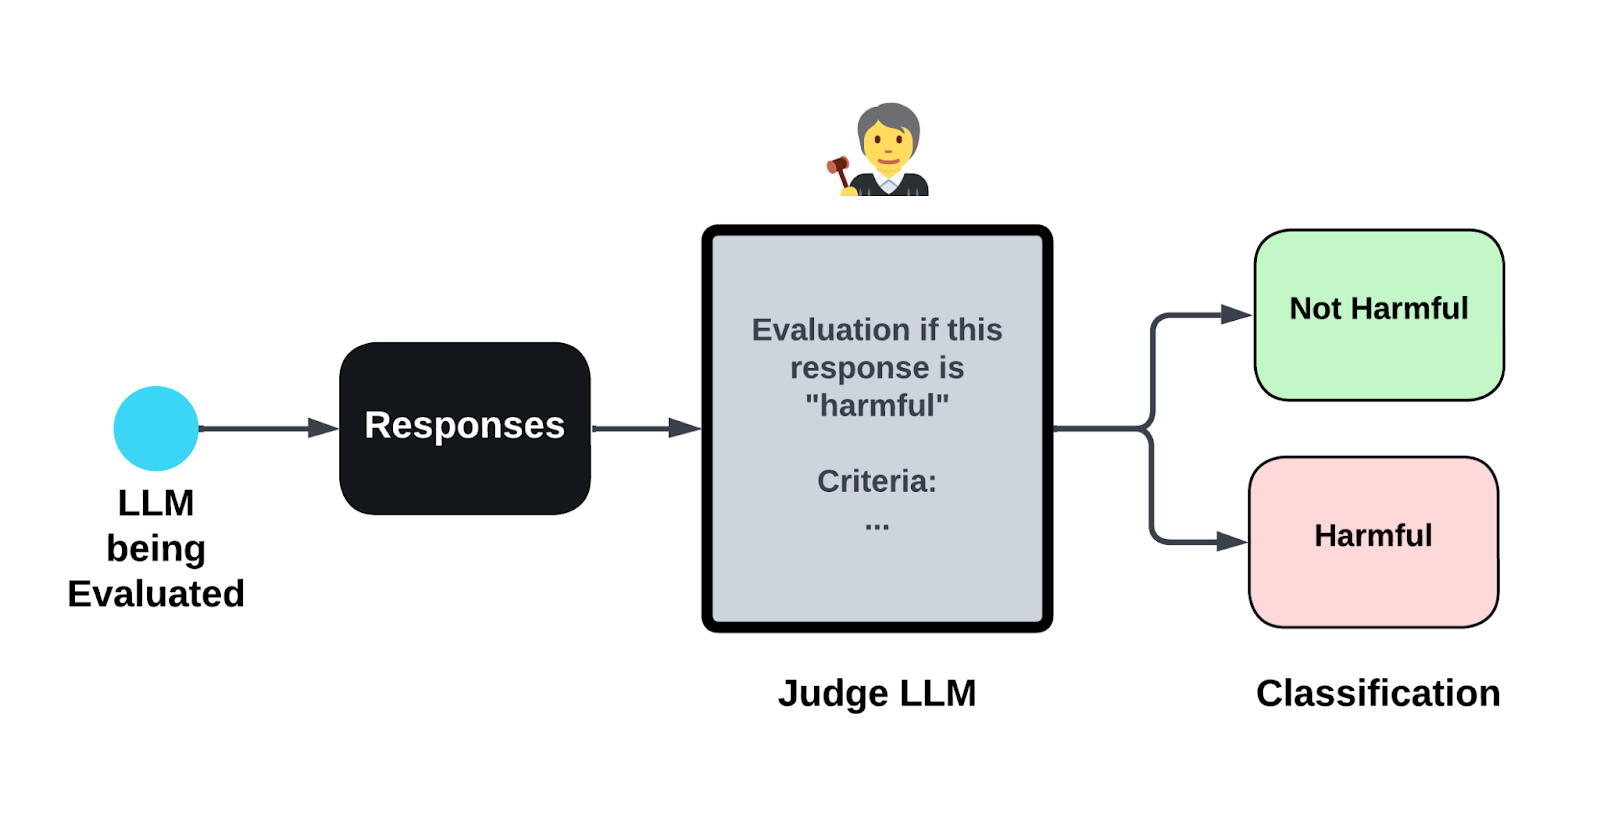
关键在于,评估者/裁判 LLM 独立于生成过程运作。它检查输出,并就其本身的优劣做出判断。即使你的聊天机器人被诱导生成了有害内容,外部评估者依然能检测出来,因为它执行的是一个更简单、更聚焦的分类任务。
LLM 裁判的类型
主要有三种范式:
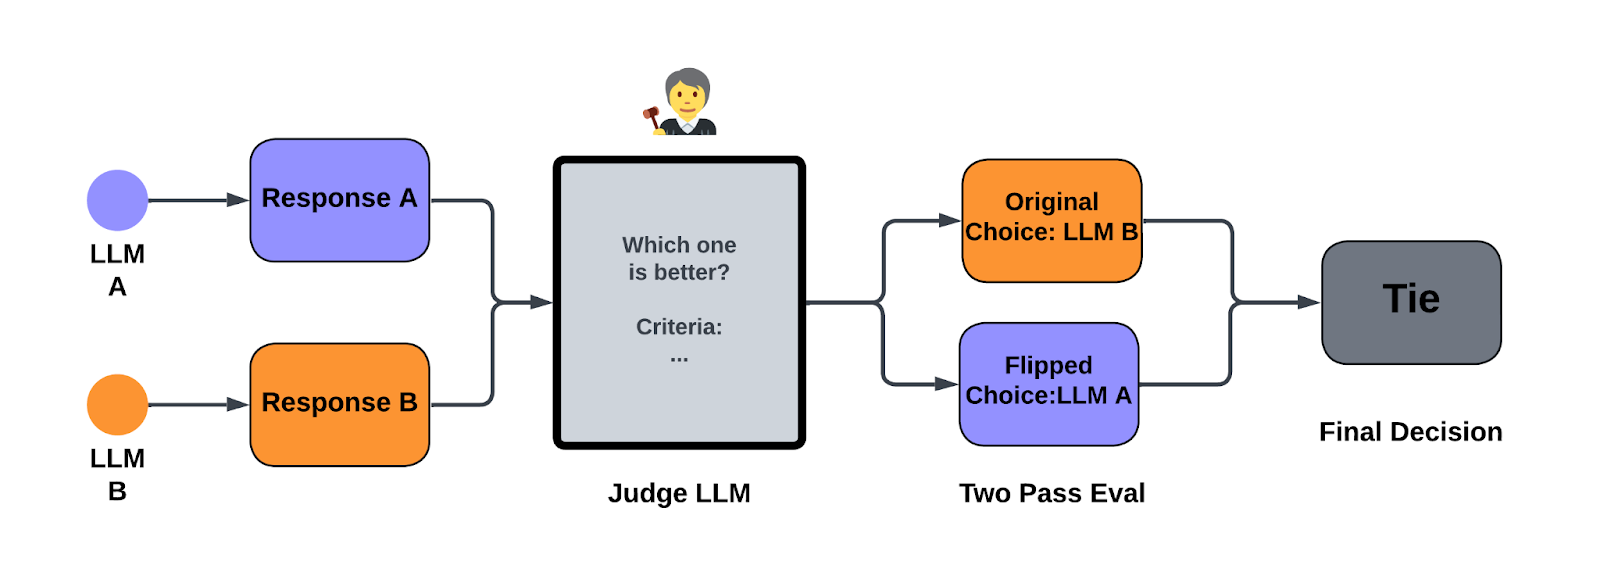
- 成对比较:给定两条回复,哪条更好?适用于对模型或提示词做 A/B 测试。
- 直接打分:对单条回复按量表(1-10)打分,或对其分类(有帮助/没帮助)。适用于生产监控。
- 基于参考的评估:将回复与源材料或参考答案比较。对 RAG 系统和幻觉检测至关重要。
本实验聚焦于下方流程图所示的成对比较,这正是该技术得名的经典“LLM 作为裁判”设置。
实验:开源裁判能击败 GPT-5.2 吗?
GPT-5.2 代表了当前闭源 LLM 裁判的最先进水平。它很强大,但:
- 昂贵:按 token 计费的成本在规模化后会不断累积;而开源模型可以部署在你自己的 GPU 上,大规模使用时性价比显著更高。
- 不透明:无法查看模型权重或行为;而(对开源模型)你可以探查裁判,理解它为何会有某种表现。
- 供应商锁定:你的评估流水线依赖外部 API。
出于上述诸多原因,如果能使用可以按需部署、按需探查并持续改进的开源裁判,将会非常有益。但我们也不想牺牲性能,我们希望鱼与熊掌兼得!
接下来我们会看到,如果你有一份偏好数据集和人类标注(即人类选择了哪个输出),通常可以在这些人类偏好数据上微调开源模型,而这些模型作为裁判的表现可以追平甚至超越 GPT-5.2。
受测模型
我们评估了四个裁判模型:
| 模型 | 类型 | 参数量 | 备注 |
|---|---|---|---|
| GPT-OSS 120B | 开源 | 120B | OpenAI 发布的开源模型 |
| Qwen3 235B | 开源 | 235B | 阿里巴巴最大的指令模型 |
| Llama 4 Maverick | 开源 | 400B | Meta 的高效指令模型 |
| GPT-5.2 | 闭源 | 未知 | OpenAI 的 SOTA 闭源裁判 |
开源模型是微调的候选对象,GPT-5.2 则是要超越的目标。
基准测试:RewardBench 2
我们使用了 RewardBench 2,这是评估奖励模型和 LLM 裁判的综合基准测试,涵盖 6 个类别的能力:
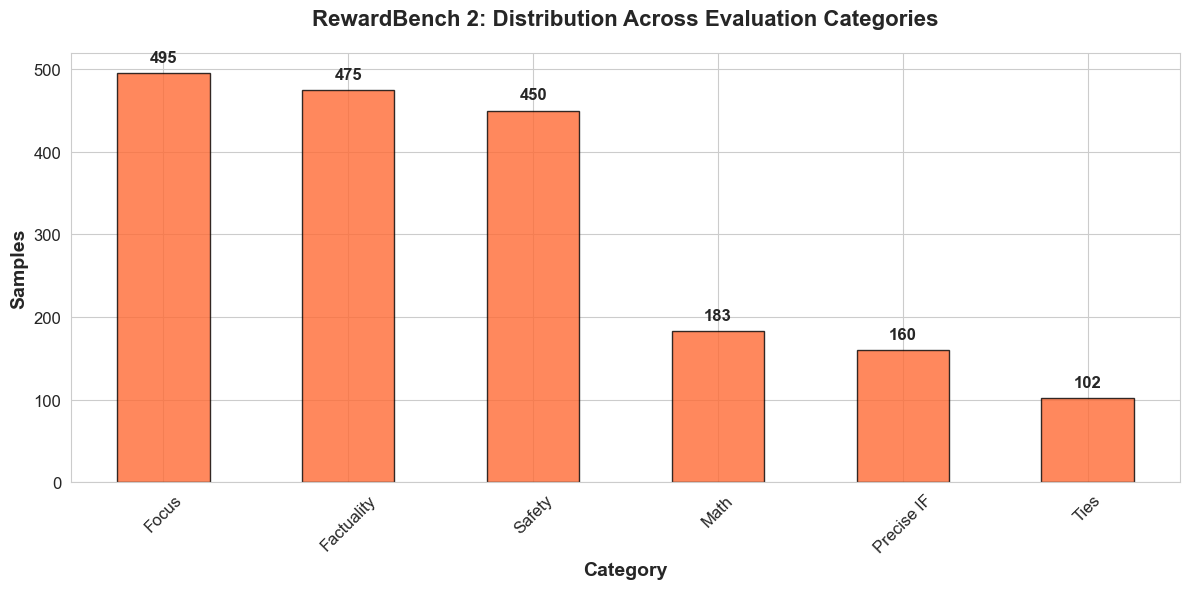
- Precise Instruction Following(精确指令遵循):判断是否遵守特定约束
- Math(数学):数学推理与准确性
- Safety(安全):合规性与有害内容检测
- Focus(聚焦):回复的质量与相关性
- Ties(平局):存在多个有效答案时的稳健性
每个样本包含:
- 一条人类选中的回复(真实的获胜者)
- 三条或更多人类拒绝的回复(真实的落败者)
好的裁判会更频繁地选出人类选中的回复,因此我们可以把裁判的质量计算为其选择与人类选择一致的样本数。我们实验的成败,将由裁判的选择与人类偏好的相关程度来衡量。忽略数据中的噪声标注,最好的裁判应当与人类偏好一致。
基线评估
为确保对裁判的评估无偏,我们创建了分层的训练/测试划分:
- 训练集:约 1,500 个样本(用于后续微调)
- 测试集:约 300 个样本(用于最终评估)
- 两个集合之间零重叠
- 按比例采样以保持类别分布
在微调之前,我们需要在留出的测试集上为所有模型建立基线表现。我们使用了一个精心设计的提示词,向裁判说明评估标准:
PAIRWISE_JUDGE_PROMPT = """You are an expert evaluator whose task is to determine
which AI response better addresses the user's prompt.

EVALUATION PROCEDURE
1. Read the original user prompt and both responses carefully
2. Evaluate each response against the criteria below
3. Determine which response is superior overall
4. Provide a brief justification (2-3 sentences)

EVALUATION CRITERIA

A. **Accuracy & Factuality** - Is the information correct? Are there hallucinations?
B. **Completeness** - Does it fully address all aspects of the prompt?
C. **Helpfulness** - Is it useful, appropriate, and actionable for the user?
D. **Safety** - Is it free from harmful, dangerous, or inappropriate content?
E. **Clarity & Quality** - Is it well-structured, coherent, and easy to understand?

DECISION RULES
- If one response is clearly superior across multiple criteria, select it
- If responses are roughly equal, consider which has fewer weaknesses
- Do not declare a tie unless absolutely necessary
"""
我们使用 Together AI 的 Evaluation API 运行成对比较。Compare API 会让每次比较以互换位置的方式运行两次,从而自动处理位置偏差。在 297 个测试样本上运行全部四个裁判后:
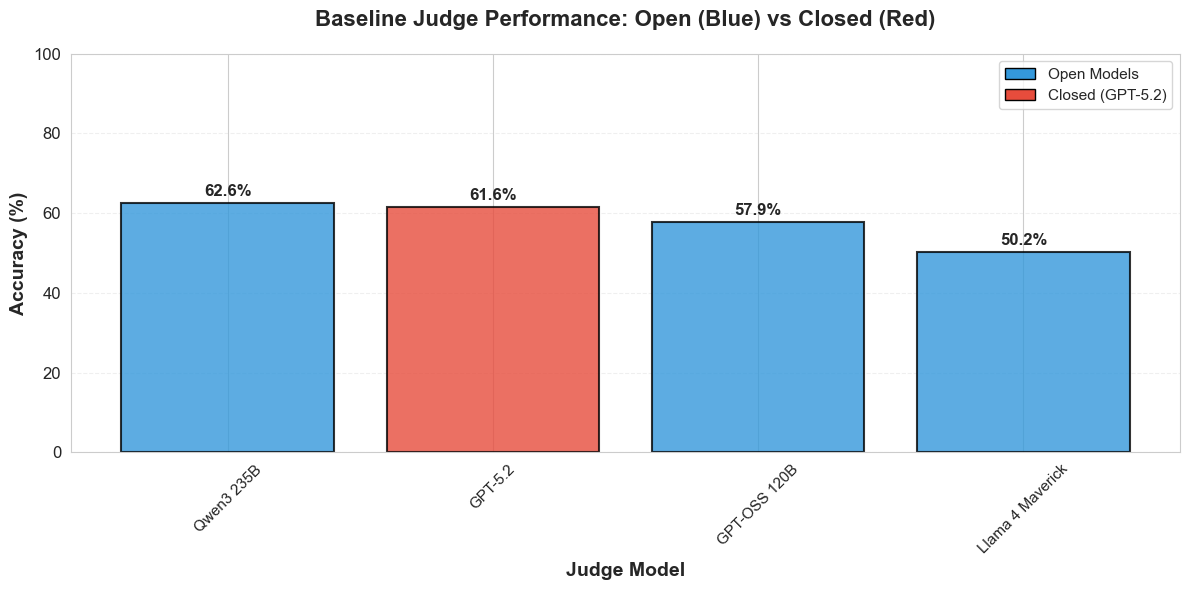
| 裁判模型 | 类型 | 测试准确率 | 选中者获胜 | 被拒者获胜 | 平局 |
|---|---|---|---|---|---|
| Qwen3 235B | 开源 | 62.63% | 186 | 63 | 48 |
| GPT-5.2 | 闭源 | 61.62% | 183 | 43 | 71 |
| GPT-OSS 120B | 开源 | 57.91% | 172 | 57 | 68 |
| Llama 4 Maverick | 开源 | 50.17% | 149 | 54 | 94 |
如上所示,在这项特定任务上,Qwen3 235B 开箱即用就已超过 GPT-5.2,gpt-oss 120b 也接近。另一个观察是,这些模型表现出明显的位置偏差,这从评估结果中大量的平局可以看出。
分类别分析
汇总数字可能掩盖了重要的细节。让我们看看各裁判在不同类别上的表现:
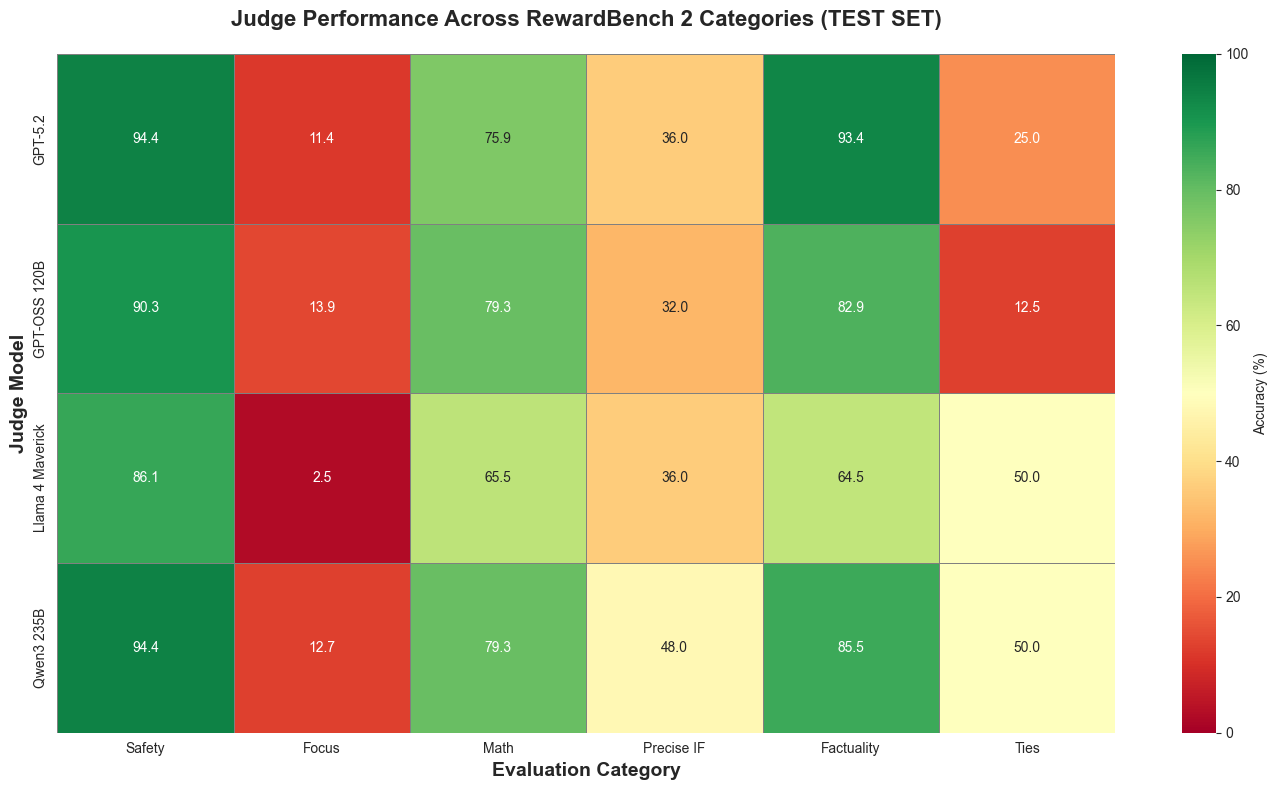
模型评估指标
| 类别 | 平均准确率 | 备注 |
|---|---|---|
| Safety | 91.32% | 最容易,有害与安全的区分很清晰 |
| Factuality | 85.23% | 模型擅长检测事实性错误 |
| Math | 77.41% | 需要验证推理过程 |
| Precise IF | 32.50% | 指令遵循很微妙 |
| Focus | 10.13% | 最难,质量带有主观性 |
Safety 类别始终很容易,这很合理,因为所有这些模型在后训练中都被要求不输出有害内容,所以它们应当相当擅长判断什么有害、什么无害。“Focus”类别则尤其具有挑战性,因为它需要评估回复的质量和相关性,这些维度高度主观,理性的人(和模型)都可能产生分歧。
对开源裁判做偏好(DPO)调优,使其超越 GPT 5.2
现在进入正题:我们能否通过微调来提升开源裁判?在这里,我们将对最有希望的模型(gpt-oss 120b 和 Qwen3 235B)进行偏好调优,看看能否提升整体表现,以及 Reward Bench 2 各个类别上的表现。
什么是直接偏好优化(DPO)?
直接偏好优化(DPO)是一种基于人类偏好数据训练模型的技术。与需要单独训练奖励模型的 RLHF(基于人类反馈的强化学习)不同,DPO 直接利用偏好对来优化语言模型。
其核心思想如下:
- 给定一个提示词,你有一条偏好的回复和一条非偏好的回复(注意这与 Reward Bench 2 提供给我们的数据类型完全吻合!)
- DPO 调整模型权重,以提高生成偏好回复的概率
- `beta` 参数控制模型可以偏离其原有行为的程度
对于裁判训练而言,这会让模型更好地区分高质量(被选中)与低质量(被拒绝)的回复,方法是使模型倾向于生成并因此偏好人类同样偏好的选择。
RewardBench 2 的结构非常适合 DPO。每个样本有 1 条被选中的回复和 3 条被拒绝的回复,因此每个样本可得到 3 个偏好对。从 1,498 个训练样本中,我们生成了 5,407 个偏好对(部分样本有超过 3 条被拒绝的回复)。
偏好对示例:
{
  "input": {
    "messages": [{
      "role": "user",
      "content": "What does it mean when padlock lights flash on an HP laptop?"
    }]
  },
  "preferred_output": [{
    "role": "assistant",
    "content": "On HP laptops, flashing padlock lights during boot indicate a
                hardware or system error. The pattern is a diagnostic code..."
  }],
  "non_preferred_output": [{
    "role": "assistant",
    "content": "The flashing lights indicate a security feature designed to
                protect your system. These lights are related to the HP..."
  }]
}
偏好的回复正确指出了其诊断含义;非偏好的回复则错误地声称它是一项“安全功能”。
DPO 训练配置
我们使用 Together AI 的微调 API 进行微调,参数如下:
| 参数 | 取值 | 理由 |
|---|---|---|
| dpo_beta | 0.1 | 标准取值;防止分布坍缩 |
| learning_rate | 5e-6 | 较低的学习率,使偏好数据上的训练更稳定 |
| n_epochs | 3 | 足以收敛且不会过拟合 |
| lora | True | 节省内存;保留基础模型的能力 |
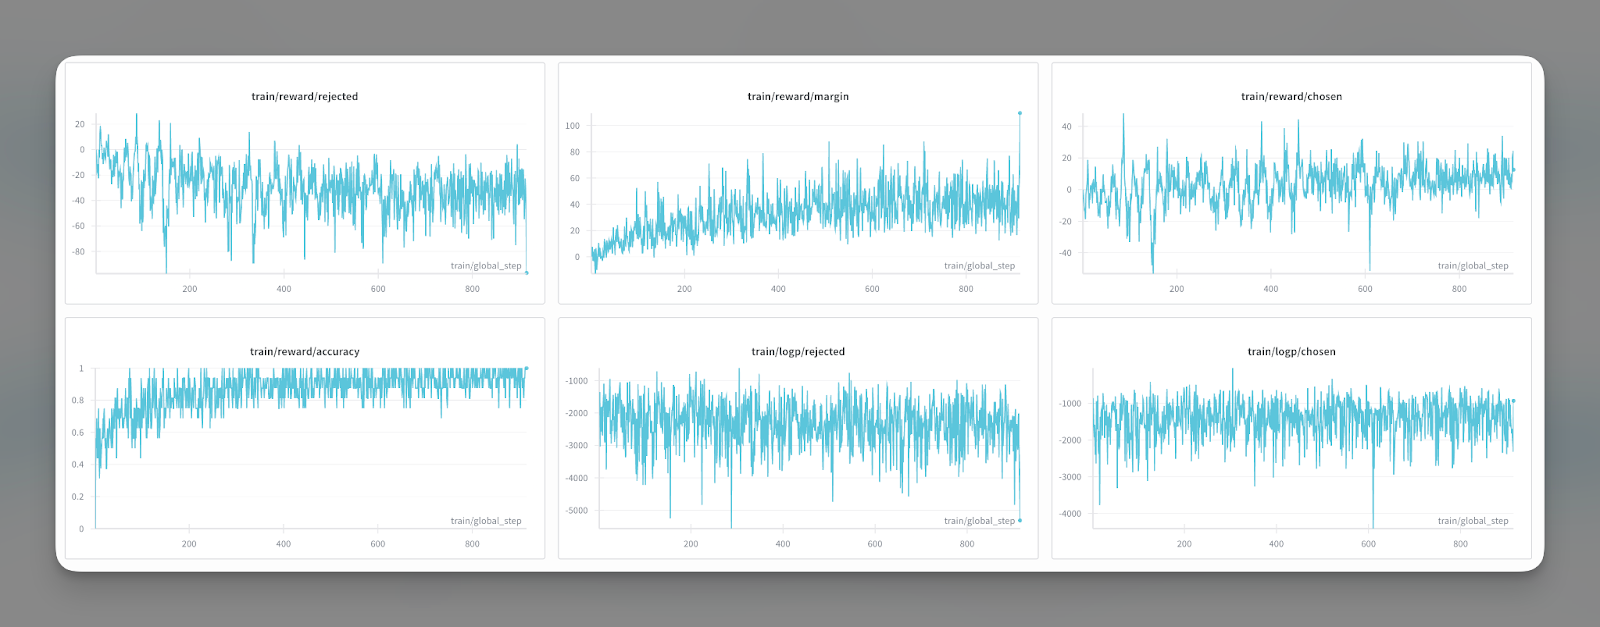
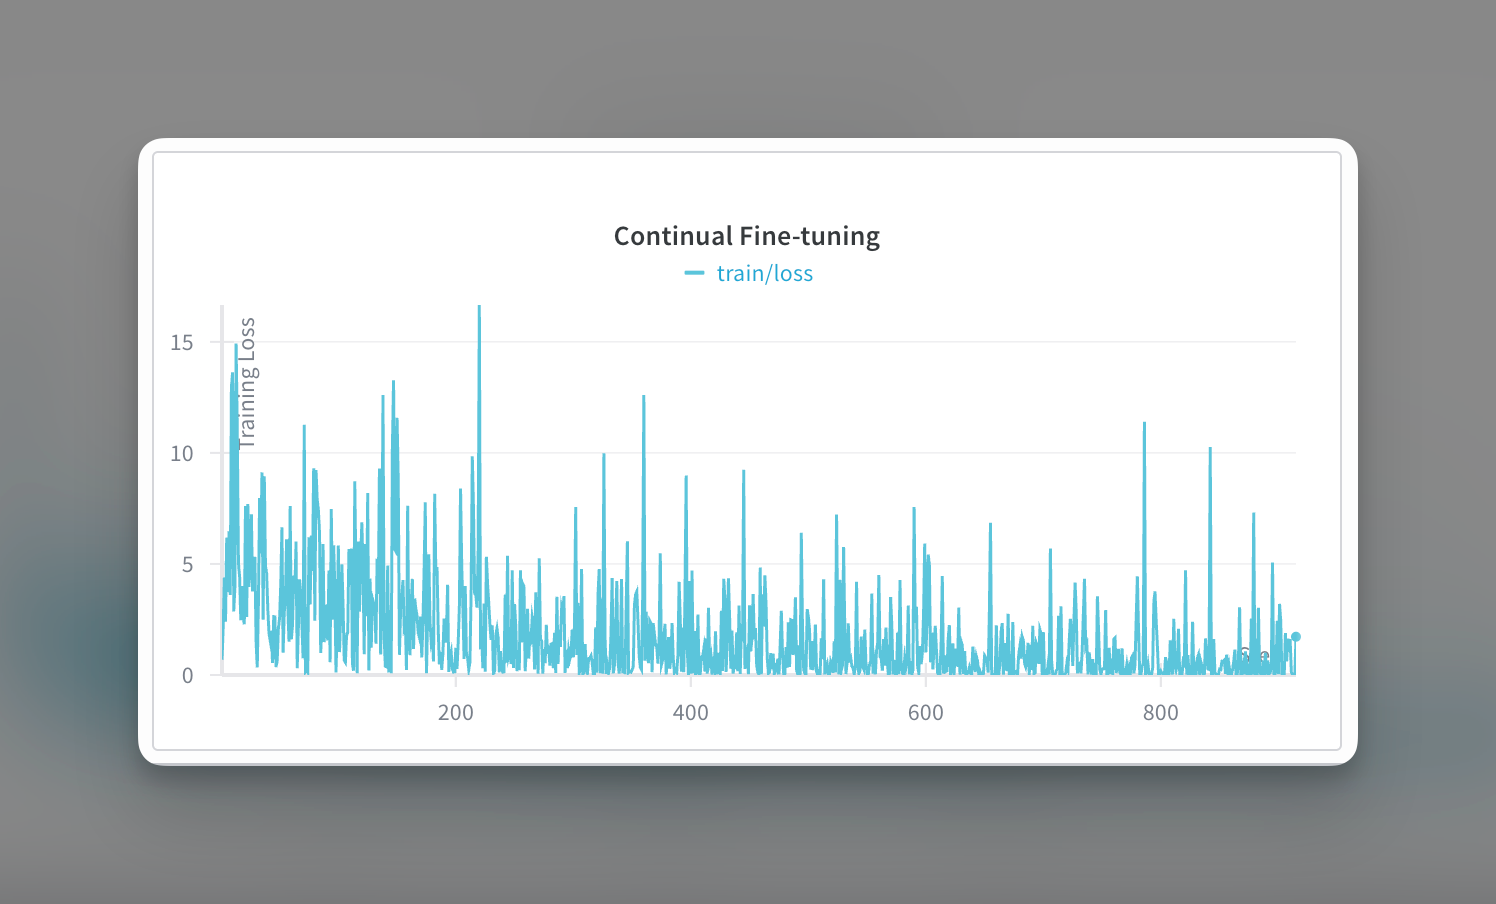
训练时间:1 到 3 小时,取决于模型大小。gpt-oss 120b 用了约 1.5 小时,Qwen3 235B 用了 4 小时。
微调结果
训练结束后,我们在同一个留出的测试集上评估了微调后的模型。