生物分子结构预测如今经常在蛋白质组规模上运行,目标是让整个工作清单高效地走完整条流水线。
NVIDIA BioNeMo Inference Runtime(BioIR)可在保留熟悉的 PyTorch 工作流的同时,帮助加速受支持的生物分子结构预测模型在 NVIDIA GPU 上的运行。它使用优化过的内核,并在适用时借助 CUDA Graphs 加速模型执行。对于大批量相互独立的输入,Ray 可以在单个节点内的每块 GPU 上运行一个完整的模型副本,以提升整体吞吐量。
BioIR 也已用于真实的蛋白质组规模工作,包括 AlphaFold Database(AFDB)近期的扩展:它加速了 4,777 个蛋白质组中蛋白质复合物结构的生成,共约 3,100 万个候选复合物,其中 181 万个作为高置信度预测结果发布。
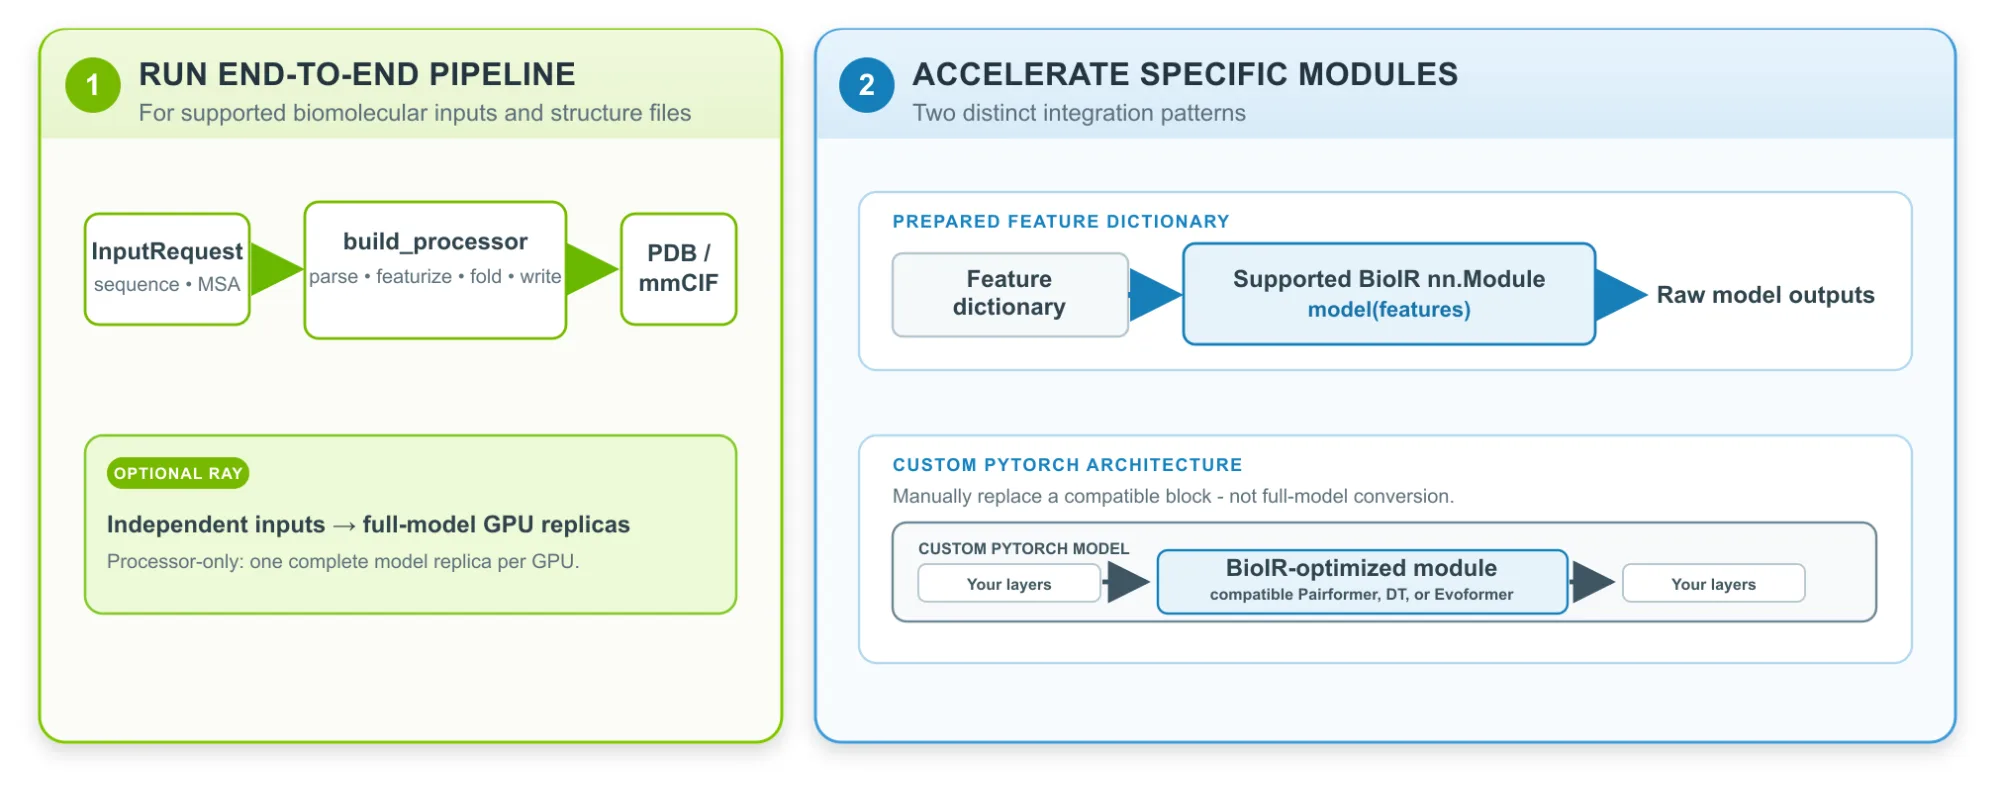
你可以通过两种方式使用它(见下方图 1):
- 端到端处理器让一个 InputRequest 依次经过解析、分词、特征生成、GPU 推理,以及 PDB 或 mmCIF 写出。
- 直接集成 PyTorch 时,你可以构建受支持的模型(torch.nn.Module),或在自定义代码中复用选定的模块。
本教程将带你走一遍 BioIR 的端到端处理器,从输入准备到 GPU 推理,再到 PDB 或 mmCIF 输出,并展示如何跟踪每小时处理的结构数和资源效率。
前置条件
- Python 3.12 或更高版本
- 兼容的 NVIDIA GPU 和驱动,以及 BioIR wheel 包或受支持的开发环境
- 一个已就位的模型检查点(下面的示例使用 Boltz-2)和所需的化学元数据
- 每条蛋白质链都需要一个 A3M MSA。对于含有多条不同蛋白质链的输入,配对或非配对的 MSA 均可接受
- 要利用 Ray 扩展吞吐量,请在同一节点上使用多块可见 GPU,且独立记录的数量要多于副本数
该 wheel 包含预编译的 CUBIN,因此运行时使用不需要 nvcc、CUDA 源码、CMake 或 CUDA toolkit。
步骤 1. 选择受支持的结构预测工作流
下面我们演示 BioIR 中 Boltz2 的端到端工作流。请使用 model_source="boltz-2"。蛋白质链需要 MSA;对于含有多条不同蛋白质链的输入,配对或非配对的 MSA 均可接受。由于 BioIR 不运行 HHsearch 或 HMMsearch,你可以自行提供模板(可选)。端到端处理器支持配体结构预测,但不支持配体亲和力预测。
from bionemo_ir.data.schemas import InputRequest, MSARecord, Polymer

request = InputRequest(
    input_id="demo",
	polymers=[
    	Polymer(
            polymer_type="protein",
            chain_id=["A"],
            sequence="GSHMSL...",
            msas=[MSARecord(path="msa.a3m", format="a3m")],
            paired_msas=[],
            templates=None,
    	)
	],
)

rows = [{"record": request, "__record_id": request["input_id"]}]
请将被截断的序列和 MSA 路径替换为有效值。进行 Ray 测试时,请用真实工作清单构建行数据,记录数要多于副本数;不要把同一行重复多次,并以此作为扩展有效的证据。
步骤 2. 用串行处理器验证一次预测
对于端到端处理器工作流,BioIR 有两种执行器后端:串行和 Ray。串行后端针对一个输入依次运行各阶段,完成整个工作流后再处理下一个输入。这有助于在步骤 3 使用 Ray 后端并发处理独立输入之前,先检查你的环境配置。
import json

from bionemo_ir.pipeline.processor.engine_proc import (
    EngineProcessorConfig,
    build_processor,
)
from bionemo_ir.pipeline.stages.configs import (
    FeatureGeneratorStageConfig,
	WriterStageConfig,
)

serial_config = EngineProcessorConfig(
    model_source="boltz-2",
	executor_backend=None,  # None mean the serial processor
	runtime_args={
        "recycling_steps": 3,
        "num_sampling_steps": 50,
        "diffusion_samples": 1,
	},
    feature_generator_stage=FeatureGeneratorStageConfig(
        init_context={"random_seed": 42},
	),
    writer_stage=WriterStageConfig(
        output_path="output/serial",
        format="cif",
	),
    engine_kwargs={"profile_inference": True},
)

serial_processor = build_processor(serial_config)
serial_outputs = serial_processor(rows)

for row in serial_outputs:
	scores = json.loads(row["scores"])
    print(row["output_path"])
    print(row["model_inference_time"])
    print(scores.get("confidence_score"))
model_inference_time 是 BioIR 经 CUDA 同步的折叠模型前向计算耗时的测量值,不包括解析、分词、特征生成、后处理和写出。请通过特征生成器的 init_context 设置随机种子。scores 字段必须先解码,因为它是一个 JSON 字符串。
步骤 3. 用 Ray 副本扩展独立输入的处理
按如下方式可选用 Ray 后端,采用默认的副本布局:
from bionemo_ir.pipeline.processor.engine_proc import EngineProcessorConfig

ray_config = EngineProcessorConfig.create_default_replica_mode_config(
    model_source="boltz-2",
    output_dir="output/ray",
    output_format="cif",
)
此配置会在当前节点的每块可见 GPU 上各放置一个完整的模型副本,并根据 torch.cuda.device_count() 确定 CPU 阶段的规模。下面是显式控制四块 GPU 的另一种配置:
import ray

from bionemo_ir.pipeline.processor.engine_proc import (
	EngineProcessorConfig,
	build_processor,
)
from bionemo_ir.pipeline.stages.configs import (
	EngineStageConfig,
    FeatureGeneratorStageConfig,
	ParallelismMode,
	ParserStageConfig,
	TokenizerStageConfig,
	WriterStageConfig,
)

ray_config = EngineProcessorConfig(
    model_source="boltz-2",
    executor_backend="ray",  # selects the ray backend
    parser_stage=ParserStageConfig(compute=4),
    tokenizer_stage=TokenizerStageConfig(compute=4, num_cpus=2),
    feature_generator_stage=FeatureGeneratorStageConfig(
    	compute=8,
    	num_cpus=4,
        init_context={"random_seed": 42},
	),
    engine_stage=EngineStageConfig(
        parallelism_mode=ParallelismMode.REPLICA,
    	compute=4,
    	num_gpus=1.0,
    	num_cpus=4,
	),
    writer_stage=WriterStageConfig(
    	compute=4,
        output_path="output/ray",
        format="cif",
	),
)

ray_processor = build_processor(ray_config)
dataset = ray.data.from_items(rows)
ray_outputs = list(ray_processor(dataset).materialize().iter_rows())
容量规则是 engine_stage.compute × engine_stage.num_gpus ≤ visible GPUs。这个四副本的示例是单节点配置,假定有四块可见 GPU。本教程不涉及多节点部署。在这里,Ray 会创建四个引擎 actor,并为每个预留一块 GPU,每个 actor 都加载完整的模型。build_processor 会在需要时初始化 Ray。实际吞吐量取决于输入分布、阶段均衡、存储、调度和故障情况,因此请实际测量。
步骤 4. 平衡五个处理器阶段
在 Ray 端到端处理器中,五个处理器阶段按如下依赖顺序消费输入:解析器 → 分词器 → 特征生成器 → 折叠引擎 → 写出器。请用对应的 *StageConfig 配置每个阶段;步骤 3 的示例展示了相关字段。enabled 字段不是公开的跳过控制项。每个阶段都提供 compute;相关阶段还提供 num_cpus、memory 和 batch_size。Ray 引擎另外增加了 max_concurrent_batches、accelerator_type 和 num_gpus。
调优 Ray 流水线时,请从 EngineProcessorConfig.create_default_replica_mode_config(...) 入手。增大某个阶段的 compute 可增加 worker;使用 num_cpus、memory,对于引擎 actor 还有 num_gpus,来设置资源预留。如果引擎在等待输入,就增加解析器、分词器或特征生成的 worker。当 GPU 或对象存储内存导致失败时,降低并发度或把大输入分开处理。
Ray 旨在让 CPU 阶段与推理重叠,但这是否能改善目标工作负载,取决于在特定硬件配置下,针对给定输入,解析、特征生成和输出写出这几个阶段的运行耗时。请参阅 ScaleFold 中的图 4,了解 OpenFold 预处理时间的多样性。
步骤 5. 区分单副本加速与流水线扩展
BioIR 在三个不同的层面提供优化:
- 内核选择:受支持的算子会根据模型配置、GPU、数据类型和张量形状,选择兼容的 BioIR 自定义实现、cuEquivariance 实现或 PyTorch 回退实现。
- 模块优化:在受支持的情况下,独立的 optimize() 机制可为兼容的模块启用 CUDA Graph 捕获。
- 流水线扩展:Ray 执行器把完整的模型副本放置在各块 GPU 上,并在它们之间分发独立输入。
这几个层面针对的瓶颈各不相同。内核和模块优化缩短单个副本内的模型前向耗时。Ray 则通过让 CPU 阶段与 GPU 折叠重叠,并为独立输入在不同 GPU 上运行完整模型副本,来提升工作清单的吞吐量。Ray 不会把单次模型前向传播拆分到多块 GPU 上。上方的图 1 区分了处理器路径和直接集成路径;Ray 扩展只适用于处理器路径。
我们使用 BioNeMo Inference Runtime 做的早期基准测试,估算出以下模型前向加速效果:
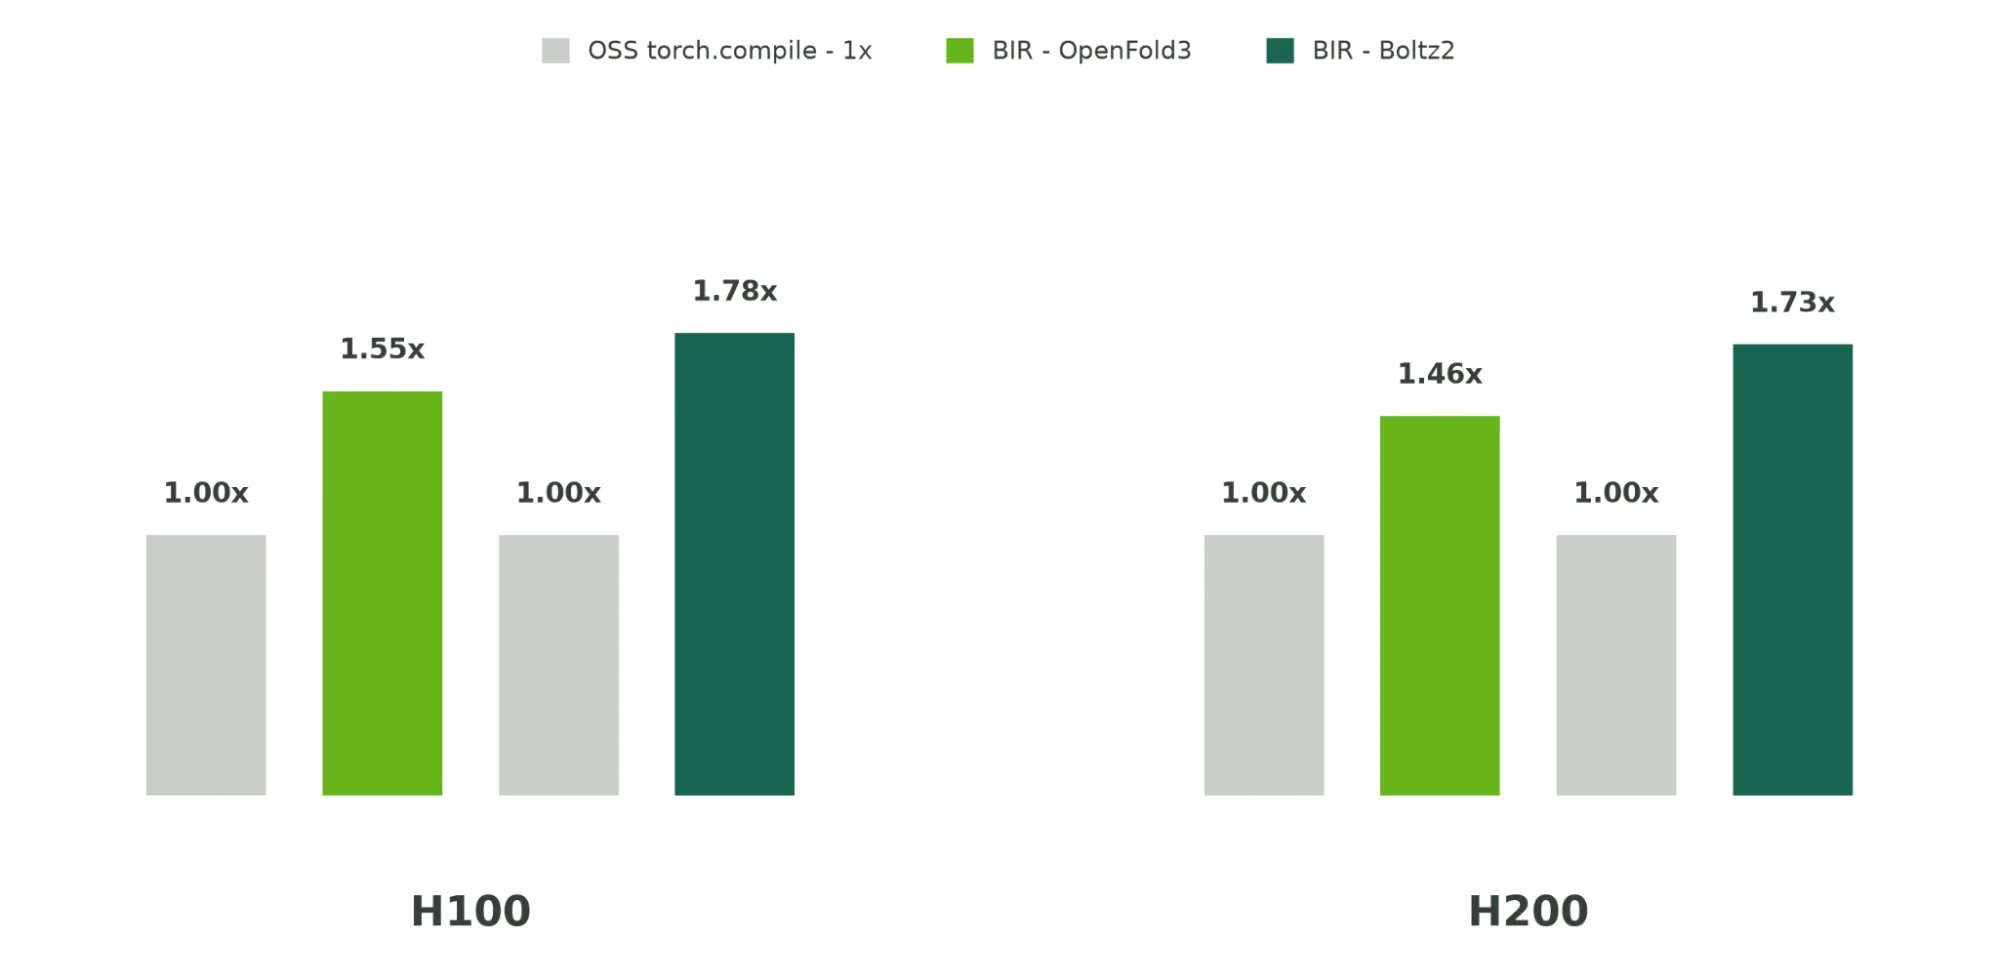
加速比的测量方式为:对 17 个长度在 29 至 1,734 个残基之间的输入,进行 1 次预热运行(结果丢弃)和 1 次测量调用。OpenFold3 和 Boltz2 的开源基线使用 torch.compile,并搭配 dynamic=None、fullgraph=False、recompile_limit=128、accumulated_recompile_limit=256、fail_on_recompile_limit_hit=True。Boltz2 开源基线使用 cuEq;OpenFold3 开源基线使用 use_cuequivariance=True 和 use_deepspeed=True。
这些结果量化的是单个模型副本内的加速效果,并未衡量解析、特征生成、输出写出、Ray 调度、多 GPU 吞吐量或完整工作清单的总耗时。下方的图 3 说明了为什么模型前向测量与端到端测量必须分开。
要确定增加 GPU 能为真实部署带来什么,请在单个节点上用同一份有代表性的工作清单,分别用一个、两个和四个 Ray 副本进行测量。步骤 6 定义了所需的指标和对比方法。
步骤 6. 基准测试折叠阶段效率与端到端交付:AFDB 案例研究
为了让这些测量更具体,我们对 1,000 个人类二聚体目标(合计序列长度低于 2,800 个残基)运行了对照基准测试,它们代表一大批相互独立的生物分子结构预测任务,类似 AlphaFold Database 中最近新增的数据集。
这个有代表性的折叠阶段基准测试,在 8 块 H100 GPU 上对比了经 BioIR 加速的 Boltz-2 与经 torch 编译的开源 Boltz-2 实现。两种实现使用相同的目标、已就位的 MSA、推理方案和 GPU 配置;吞吐量指标及其他结果仅针对此配置,不应推广到所有 BioIR 支持的模型、数据集或硬件。
该工作流对每个目标使用三次 recycle、200 个采样步数和五个扩散样本。BioIR 完成了全部 1,000 个目标,每分配一个 GPU 小时可成功折叠 5.85 万个残基,而公开实现为 2.02 万个,按残基归一化的吞吐量提升了 2.90 倍;开源实现则在 29 个目标上出现显存不足。
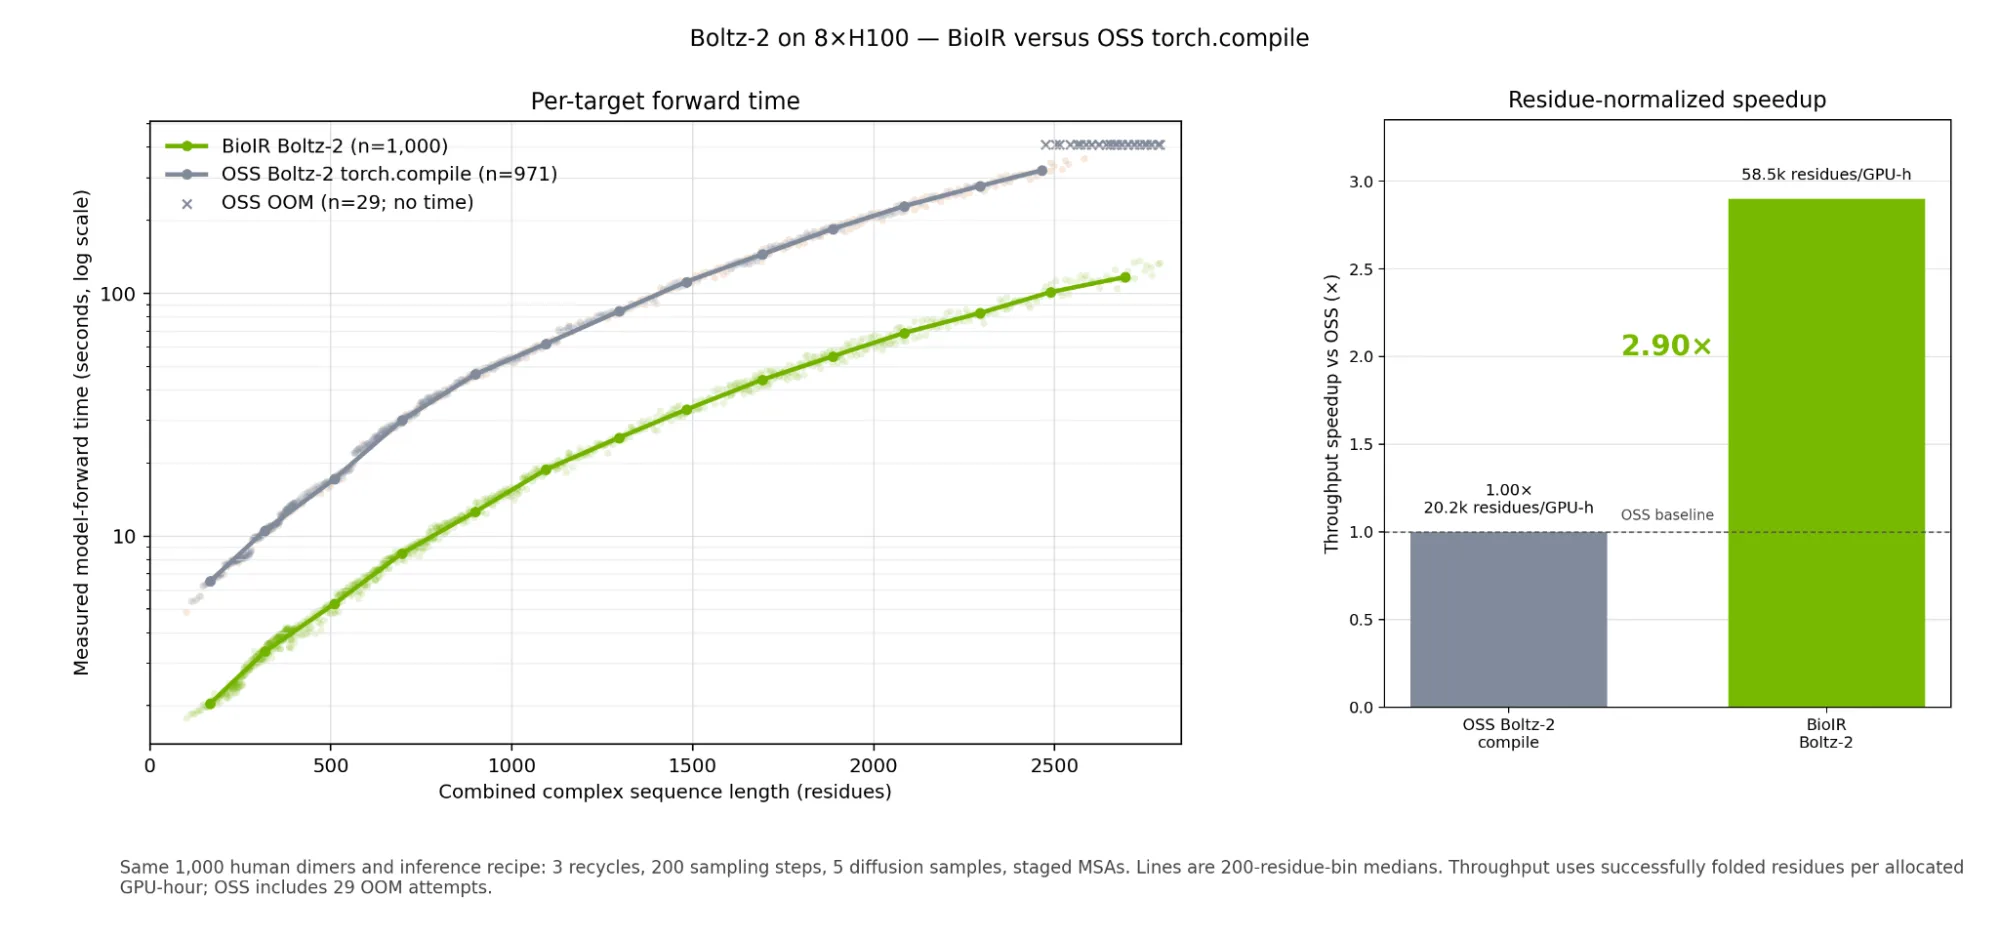
上方图 3 的左侧面板对比了 BioIR 与经 torch 编译的开源实现的模型前向时间,直接显示出 BioIR 带来的更低模型前向时间。图 3 的右侧面板对比了 BioIR 与开源实现的吞吐量,其中吞吐量是预测结构中的残基总数除以所分配的 GPU 小时数。图 3 右侧面板展示了 BioIR 中内核级、模块级和流水线级优化所带来的加速。图 3 左侧面板展示了内核级和模块级实现所带来的加速。
与 Boltz2 的加速类似,BIR 同样能加快 OpenFold2、OpenFold3 等其他生物分子共折叠模型的推理。BIR 的早期版本曾为 NVIDIA 内部版本的 OpenFold2-MM 提供加速模块,使其得以对 AFDB 中 3,100 万个蛋白质复合物结构进行大规模蛋白质结构预测。
我们按额定功率等效值,把图 3 中 1000 个目标的匹配基准测试线性外推到一百万个可比目标,对应一个配备 8 x H100 80GB HBM3 的节点(见下方图 4)。
按 8 GPU 的 TDP(热设计功耗)等效值估算,BioIR 约需 11 MWh,而公开实现需要 35 MWh;按整节点最大功率等效值估算,则分别为 21 MWh 和 64 MWh。这些只是针对 IT 设备、仅含折叠环节的估算值,并非实测能耗,也不包含电能使用效率(PUE)等数据中心开销。
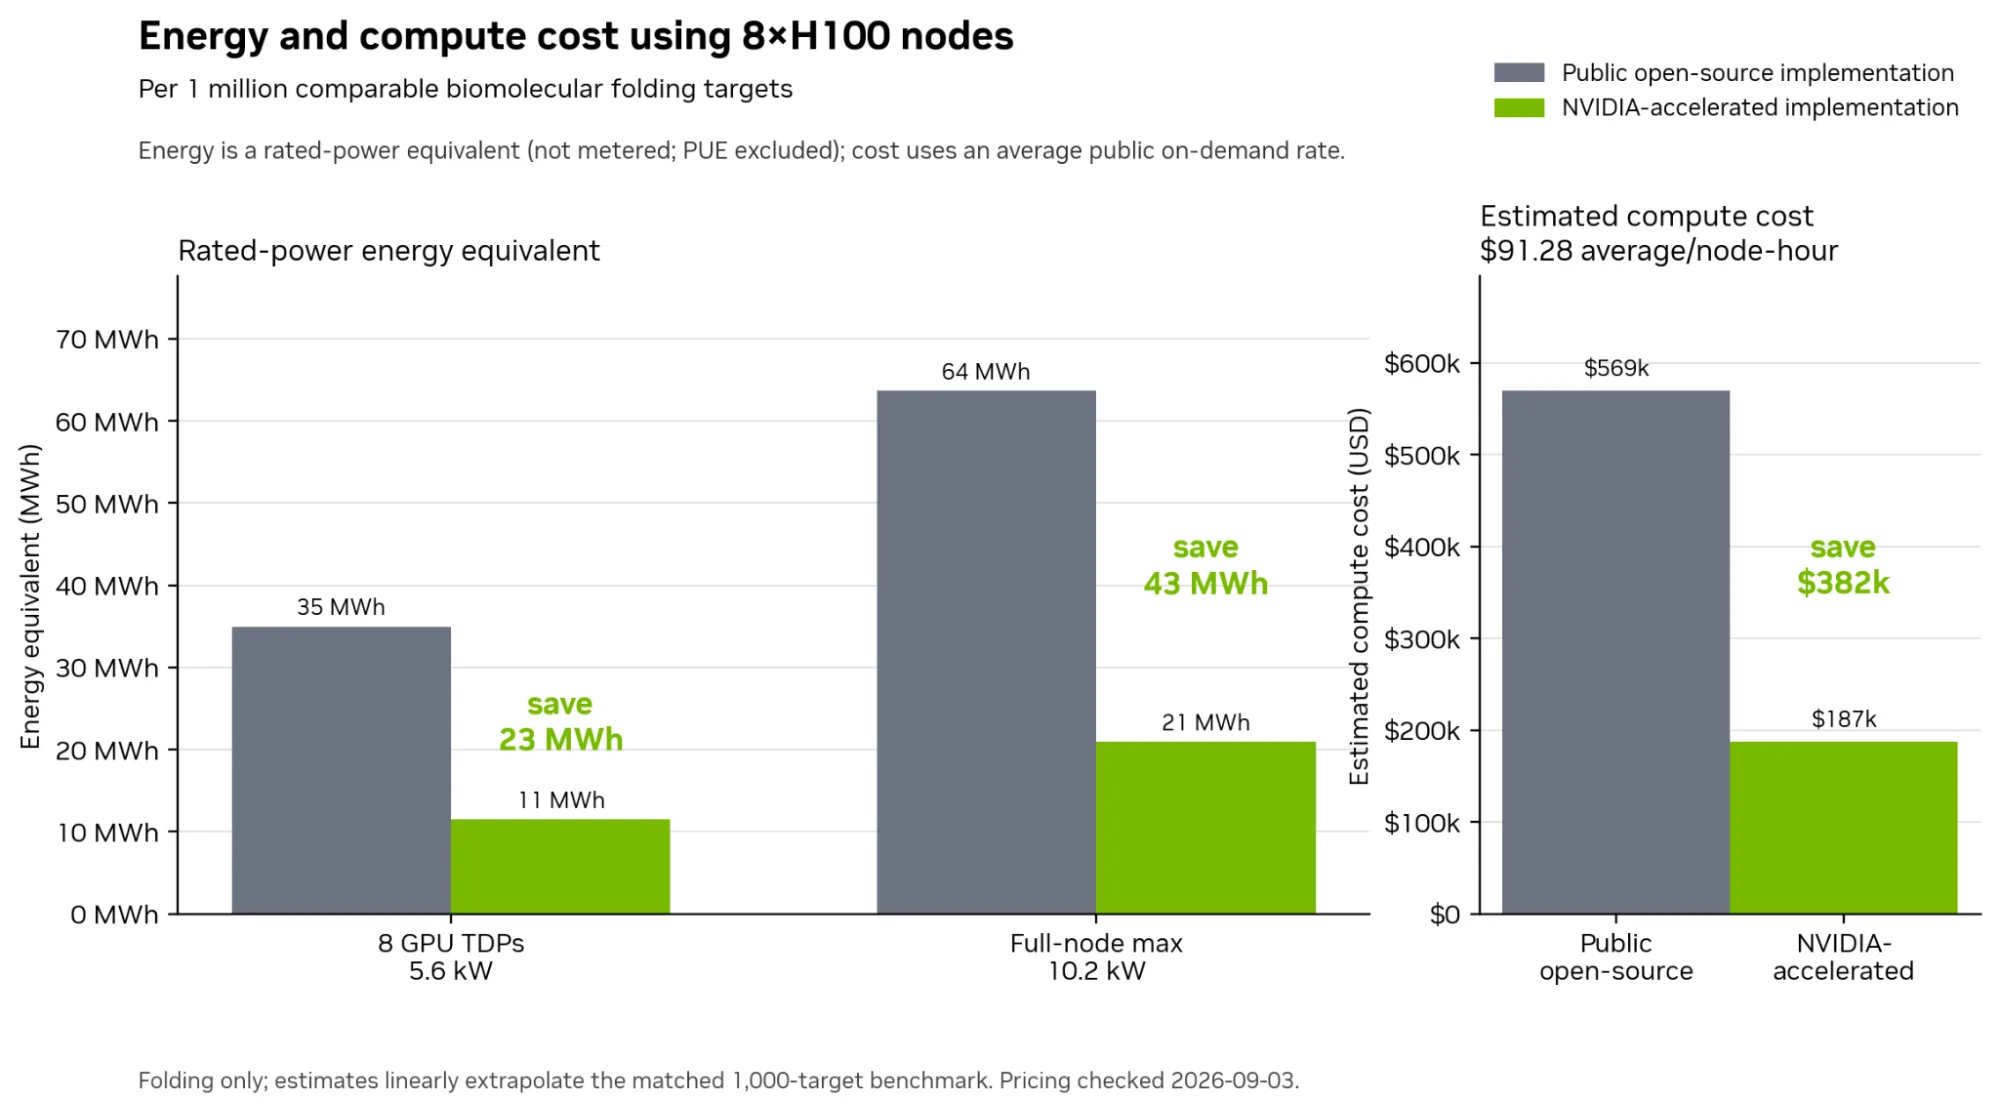
这一对照比较在每种实现上使用相同的输入和 MSA 来衡量折叠吞吐量,不包括 MSA 生成、预处理所占用的 CPU、存储、数据传输、重试和工程开销。请把端到端流水线性能指标与模型前向指标分开报告,包括每小时完成的结构数、GPU 和 CPU 利用率、GPU 显存峰值、完成率、失败次数和重试次数。
故障排查
- 只有一块 GPU 在工作:确认 Ray、
REPLICA、多于一个副本、多块可见 GPU,以及足够多的相互独立的记录。 - 构造 processor 时抛出 `ValueError`:检查
compute * num_gpus是否超过了可见 GPU 的数量。 - 蛋白质输入失败:检查所需的未配对 A3M 文件,以及 worker 可见的路径。
- GPU 处于等待状态:在增加副本之前,先检查 CPU 阶段、CPU 预留、排队情况和 Ray 对象存储容量。
- 推理之后各行在等待:检查写入器的并发度和目标端的吞吐量。
- Ray 无法放置 actor:检查 CPU、GPU、内存和
accelerator_type标签。 - 一条记录导致整个作业停止:默认的快速失败策略会抛出
FoldingPredictionError。仅当确实希望在行级别继续运行时才设置should_continue_on_error=True,然后再inspect __inference_error__。
快速上手
了解 BioNeMo Inference Runtime(BioIR),并将其大规模集成到你的结构预测工作流中:http://github.com/NVIDIA-BioNeMo/BioNeMo-Inference-Runtime
若想通过智能体编排进一步加速药物发现工作流,请查看 NVIDIA BioNeMo Agent Toolkit(BAT)。