从 8 月到 9 月初,三个基础设施缺陷间歇性地降低了 Claude 的响应质量。这些问题现已解决,我们想说明事情的来龙去脉。
8 月初,一些用户开始反映 Claude 的回答质量下降。这些最初的反馈很难与用户反馈中的正常波动区分开来。到 8 月下旬,此类反馈越来越频繁、持续时间也越来越长,我们因此展开调查,并由此发现了三个相互独立的基础设施缺陷。
明确地说:我们从不会因为需求量、时段或服务器负载而降低模型质量。用户反映的问题完全是由基础设施缺陷造成的。
我们明白,用户期待 Claude 的质量始终如一,我们对确保基础设施变更不影响模型输出也设定了极高的标准。在这几次事件中,我们没有达到这一标准。下面的事后分析将说明:究竟出了什么问题,为什么发现和解决问题所花的时间比我们期望的更长,以及我们将做出哪些改变来避免类似事件再次发生。
我们通常不会分享基础设施方面如此详细的技术细节,但这些问题的范围和复杂程度,值得我们做一次更全面的说明。
我们如何大规模提供 Claude 服务
我们通过自家的第一方 API、Amazon Bedrock 以及 Google Cloud 的 Vertex AI,为数百万用户提供 Claude 服务。我们把 Claude 部署在多种硬件平台上,即 AWS Trainium、NVIDIA GPU 和 Google TPU。这种做法提供了服务全球用户所需的容量和地理分布。
每种硬件平台的特性各不相同,需要进行专门的优化。尽管存在这些差异,我们对模型实现仍有严格的等效标准。我们的目标是,无论请求由哪个平台处理,用户得到的回答质量都应一致。这种复杂性意味着,任何基础设施变更都需要在所有平台和配置上经过仔细验证。
事件时间线
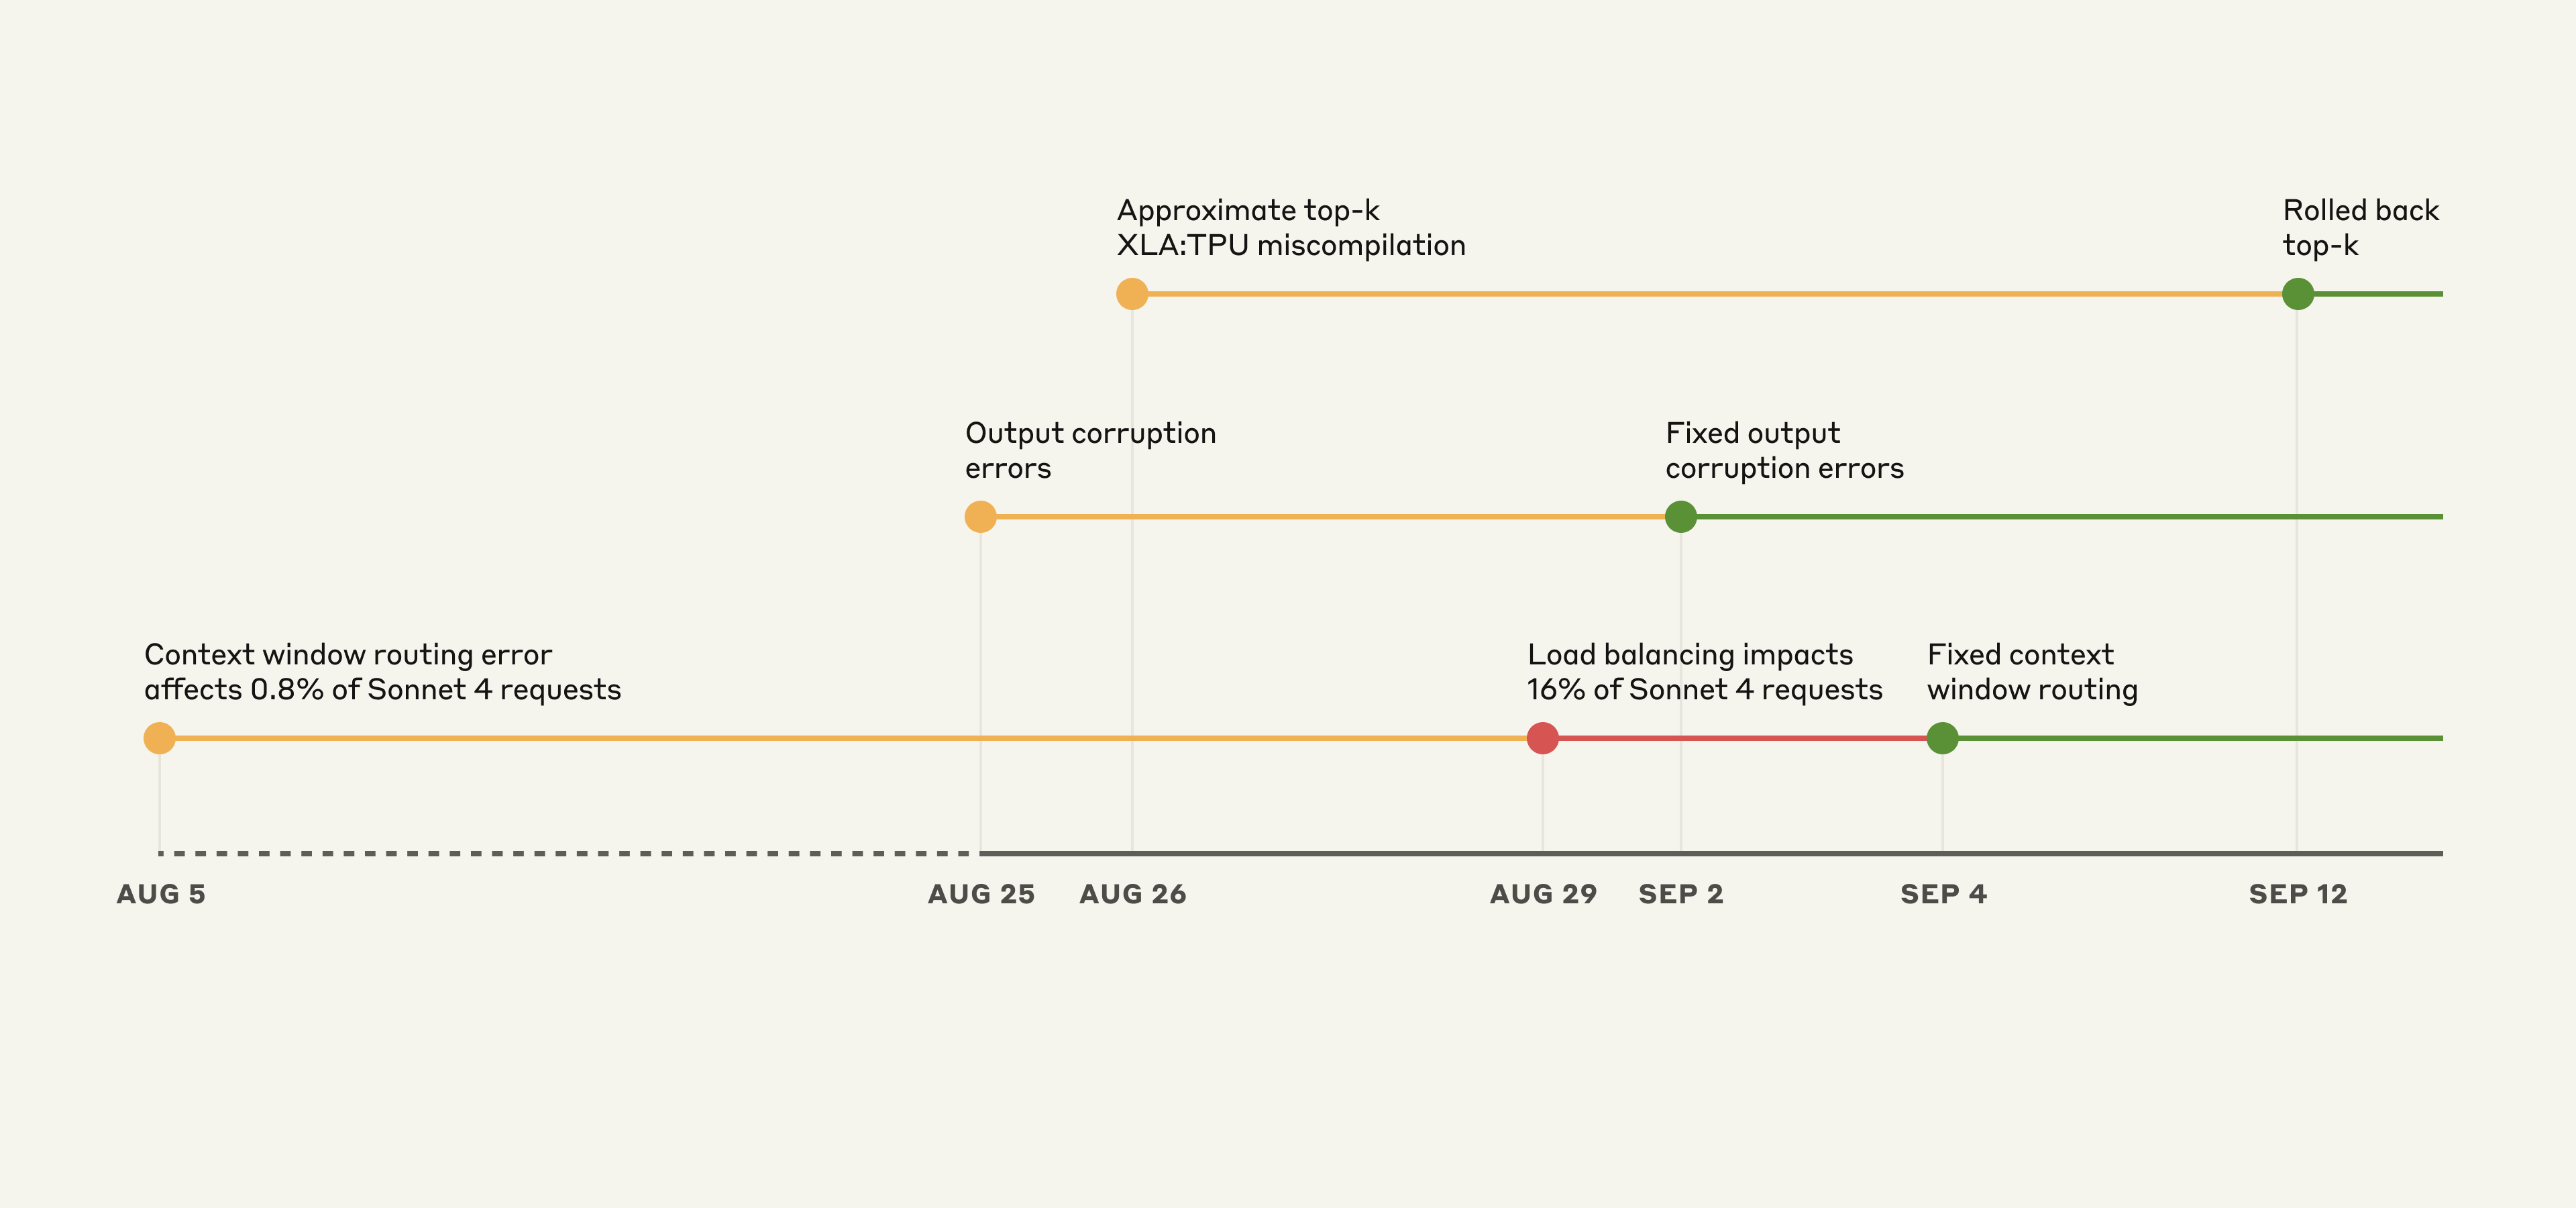 *Claude API 上事件时间线示意图。黄色:问题被发现;红色:质量下降加剧;绿色:修复已部署。*
这些缺陷相互叠加,使诊断格外困难。第一个缺陷于 8 月 5 日引入,影响了约 0.8% 发往 Sonnet 4 的请求。另外两个缺陷则来自 8 月 25 日和 26 日的部署。
尽管最初影响有限,但 8 月 29 日的一次负载均衡变更使受影响的流量开始增加。这导致更多用户遇到问题,而另一些用户仍然表现正常,由此产生了令人困惑且相互矛盾的反馈。
三个相互叠加的问题
下面我们逐一说明导致质量下降的三个缺陷、它们出现的时间以及我们的解决方式:
1. 上下文窗口路由错误
8 月 5 日,一些 Sonnet 4 请求被错误地路由到了为即将推出的 100 万 token 上下文窗口配置的服务器。这个缺陷最初影响了 0.8% 的请求。8 月 29 日,一次例行的负载均衡变更意外增加了被路由到 100 万上下文服务器的短上下文请求数量。在 8 月 31 日受影响最严重的一小时内,16% 的 Sonnet 4 请求受到了影响。
在此期间发出请求的 Claude Code 用户中,约 30% 至少有一条消息被路由到了错误类型的服务器,导致回答质量下降。在 Amazon Bedrock 上,从 8 月 12 日起,被错误路由的流量在高峰时占全部 Sonnet 4 请求的 0.18%。在 Google Cloud 的 Vertex AI 上,8 月 27 日至 9 月 16 日期间,错误路由影响的请求不到 0.0004%。
不过,一些用户受到的影响更为严重,因为我们的路由具有“粘性”。这意味着,一旦某个请求被错误的服务器处理,后续的跟进请求很可能继续由同一台错误的服务器处理。
解决方式:我们修复了路由逻辑,确保短上下文和长上下文请求被分配到正确的服务器池。修复于 9 月 4 日部署。第一方平台和 Google Cloud 的 Vertex AI 在 9 月 16 日前完成了发布,AWS Bedrock 则在 9 月 18 日前完成。
2. 输出损坏
8 月 25 日,我们向 Claude API 的 TPU 服务器部署了一项错误的配置,导致 token 生成过程中出现错误。一项运行时性能优化引发的问题,偶尔会给那些在当前上下文中本应极少出现的 token 分配很高的概率,例如在回答英文提示时输出泰文或中文字符,或在代码中产生明显的语法错误。例如,一小部分用英文提问的用户,可能在回答中间看到了“สวัสดี”。
这一损坏影响了 8 月 25 日至 28 日对 Opus 4.1 和 Opus 4 的请求,以及 8 月 25 日至 9 月 2 日对 Sonnet 4 的请求。第三方平台未受此问题影响。
解决方式:我们定位了问题,并于 9 月 2 日回滚了该变更。我们还在部署流程中加入了针对意外字符输出的检测测试。
3. 近似 top-k 的 XLA:TPU 误编译
8 月 25 日,我们部署了一段代码,用来改进 Claude 在文本生成过程中选择 token 的方式。这一变更无意中触发了 XLA:TPU[1] 编译器中一个潜伏的缺陷,该缺陷已被确认会影响对 Claude Haiku 3.5 的请求。
我们还认为,它可能影响了 Claude API 上一部分 Sonnet 4 和 Opus 3 的请求。第三方平台未受此问题影响。
解决方式:我们最先发现该缺陷影响了 Haiku 3.5,并于 9 月 4 日将其回滚。后来我们注意到用户反映的 Opus 3 问题与该缺陷相符,并于 9 月 12 日对其进行了回滚。经过大量调查,我们未能在 Sonnet 4 上复现这个缺陷,但出于谨慎,仍决定一并回滚。
与此同时,我们(a)正与 XLA:TPU 团队合作修复这个编译器缺陷,并且(b)已上线修复,改用精度更高的精确 top-k。详情请参阅下面的深入分析。
深入剖析 XLA 编译器缺陷
为了说明这些问题的复杂性,下面介绍 XLA 编译器缺陷是如何表现出来的,以及它为何特别难以诊断。
Claude 生成文本时,会计算每个可能的下一个词的概率,然后从这个概率分布中随机抽样。我们使用“top-p 采样”来避免无意义的输出,即只考虑累积概率达到某个阈值(通常是 0.99 或 0.999)的那些词。在 TPU 上,我们的模型运行在多块芯片上,概率计算发生在不同的位置。要对这些概率排序,就需要在芯片之间协调数据,这相当复杂。[2]
2024 年 12 月,我们发现 TPU 实现在 temperature 为零时,偶尔会丢掉概率最高的 token。我们部署了一个临时解决方案来处理这种情况。
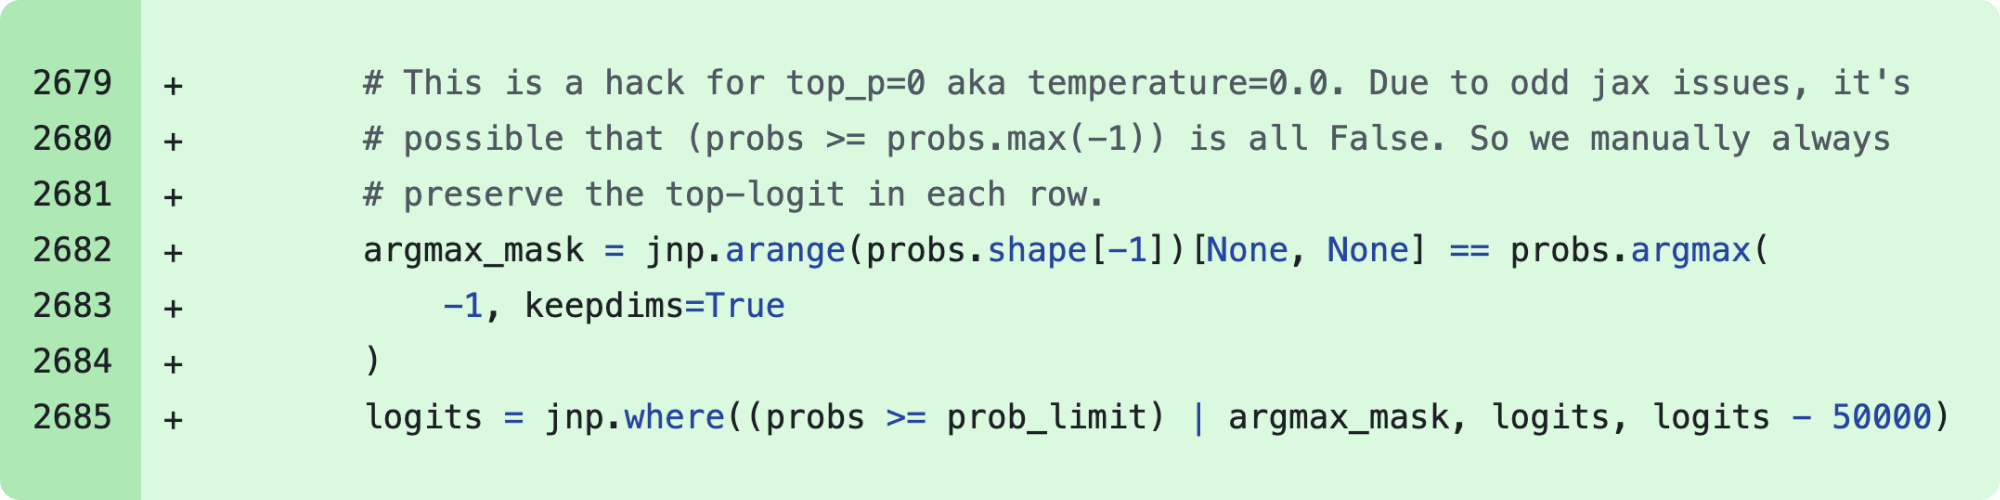
根本原因涉及混合精度运算。我们的模型以 bf16(16 位浮点数)计算下一个 token 的概率。然而,向量处理器原生支持 fp32,因此 TPU 编译器(XLA)可以通过把部分运算转换为 fp32(32 位)来优化运行时间。这一优化过程由 xla_allow_excess_precision 标志控制,该标志默认为 true。
这就造成了不一致:本应对概率最高的 token 达成一致的各项运算,实际运行在不同的精度级别上。精度不匹配意味着它们对哪个 token 的概率最高没有达成共识,结果概率最高的 token 有时会从候选中完全消失。
8 月 26 日,我们部署了对采样代码的重写,以修复精度问题,并改进对达到 top-p 阈值的临界概率的处理。但在修复这些问题的过程中,我们暴露出了一个更棘手的问题。
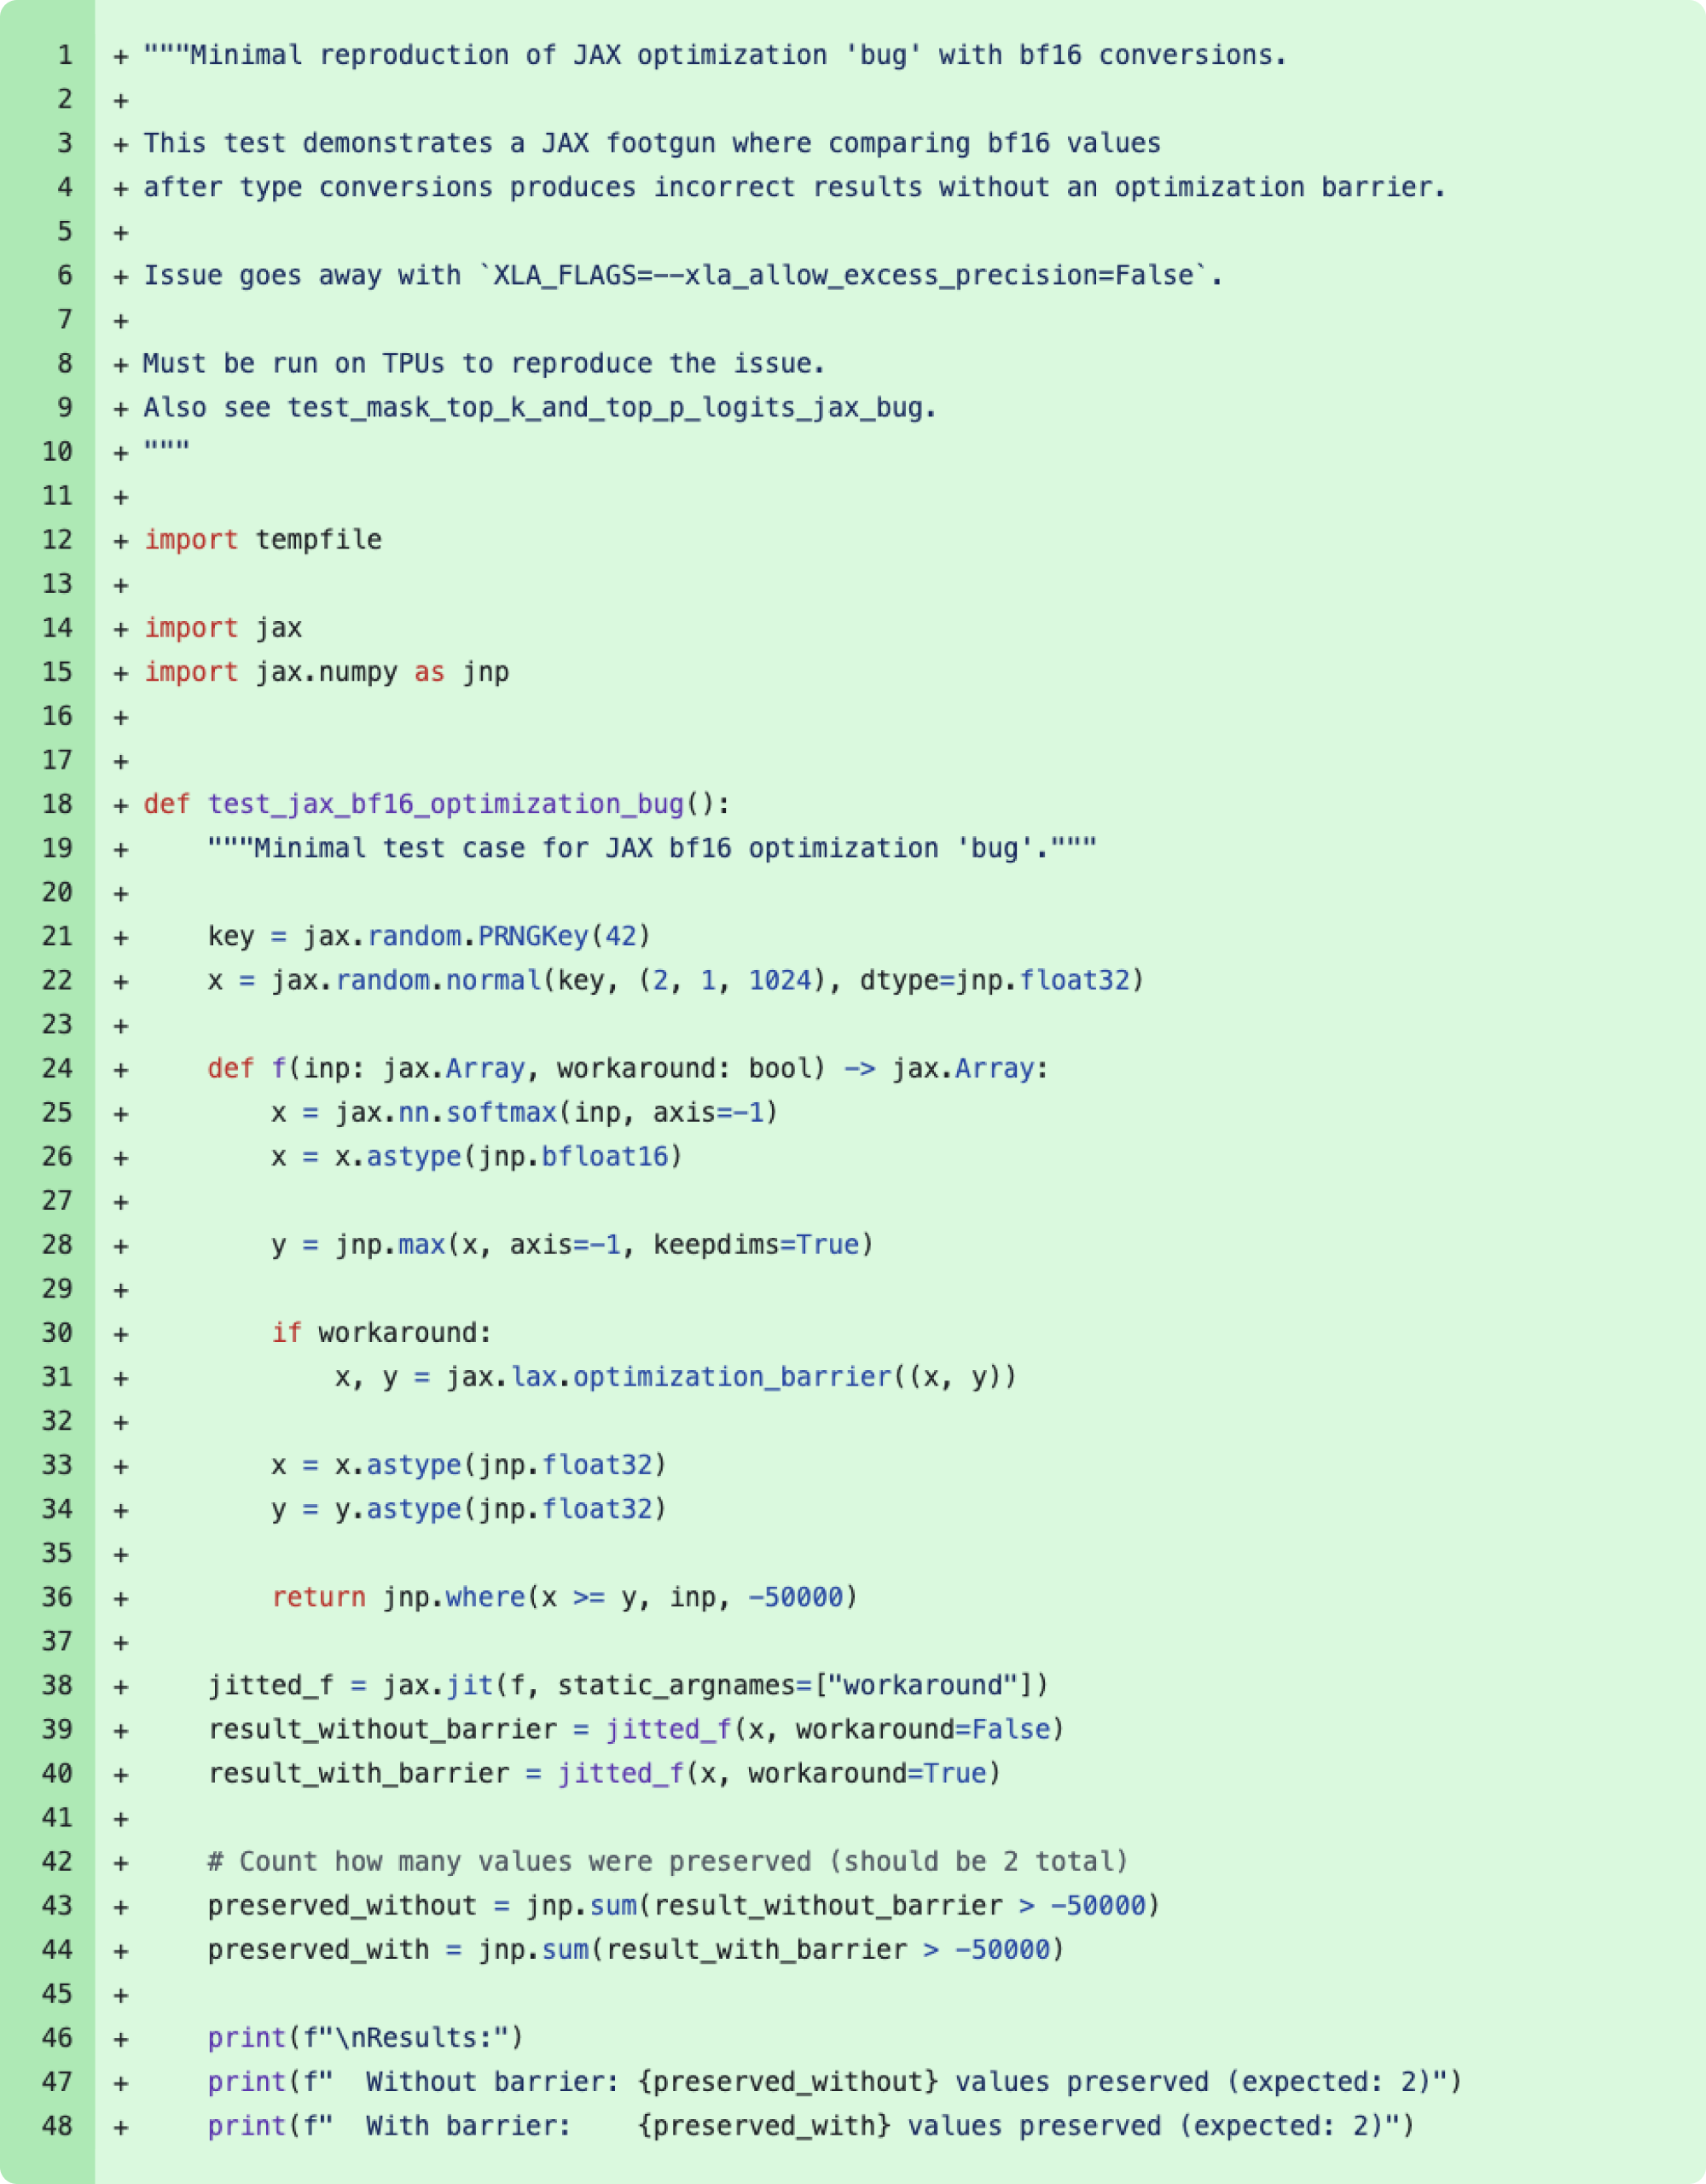
xla_allow_excess_precision 标志的预期行为。我们的修复移除了 12 月的临时解决方案,因为我们认为已经解决了根本原因。这却暴露出近似 top-k 运算中更深层的缺陷,这是一项能快速找出概率最高 token 的性能优化。[3]这种近似有时会返回完全错误的结果,但只在特定的批大小和模型配置下才会发生。12 月的临时解决方案无意中掩盖了这个问题。
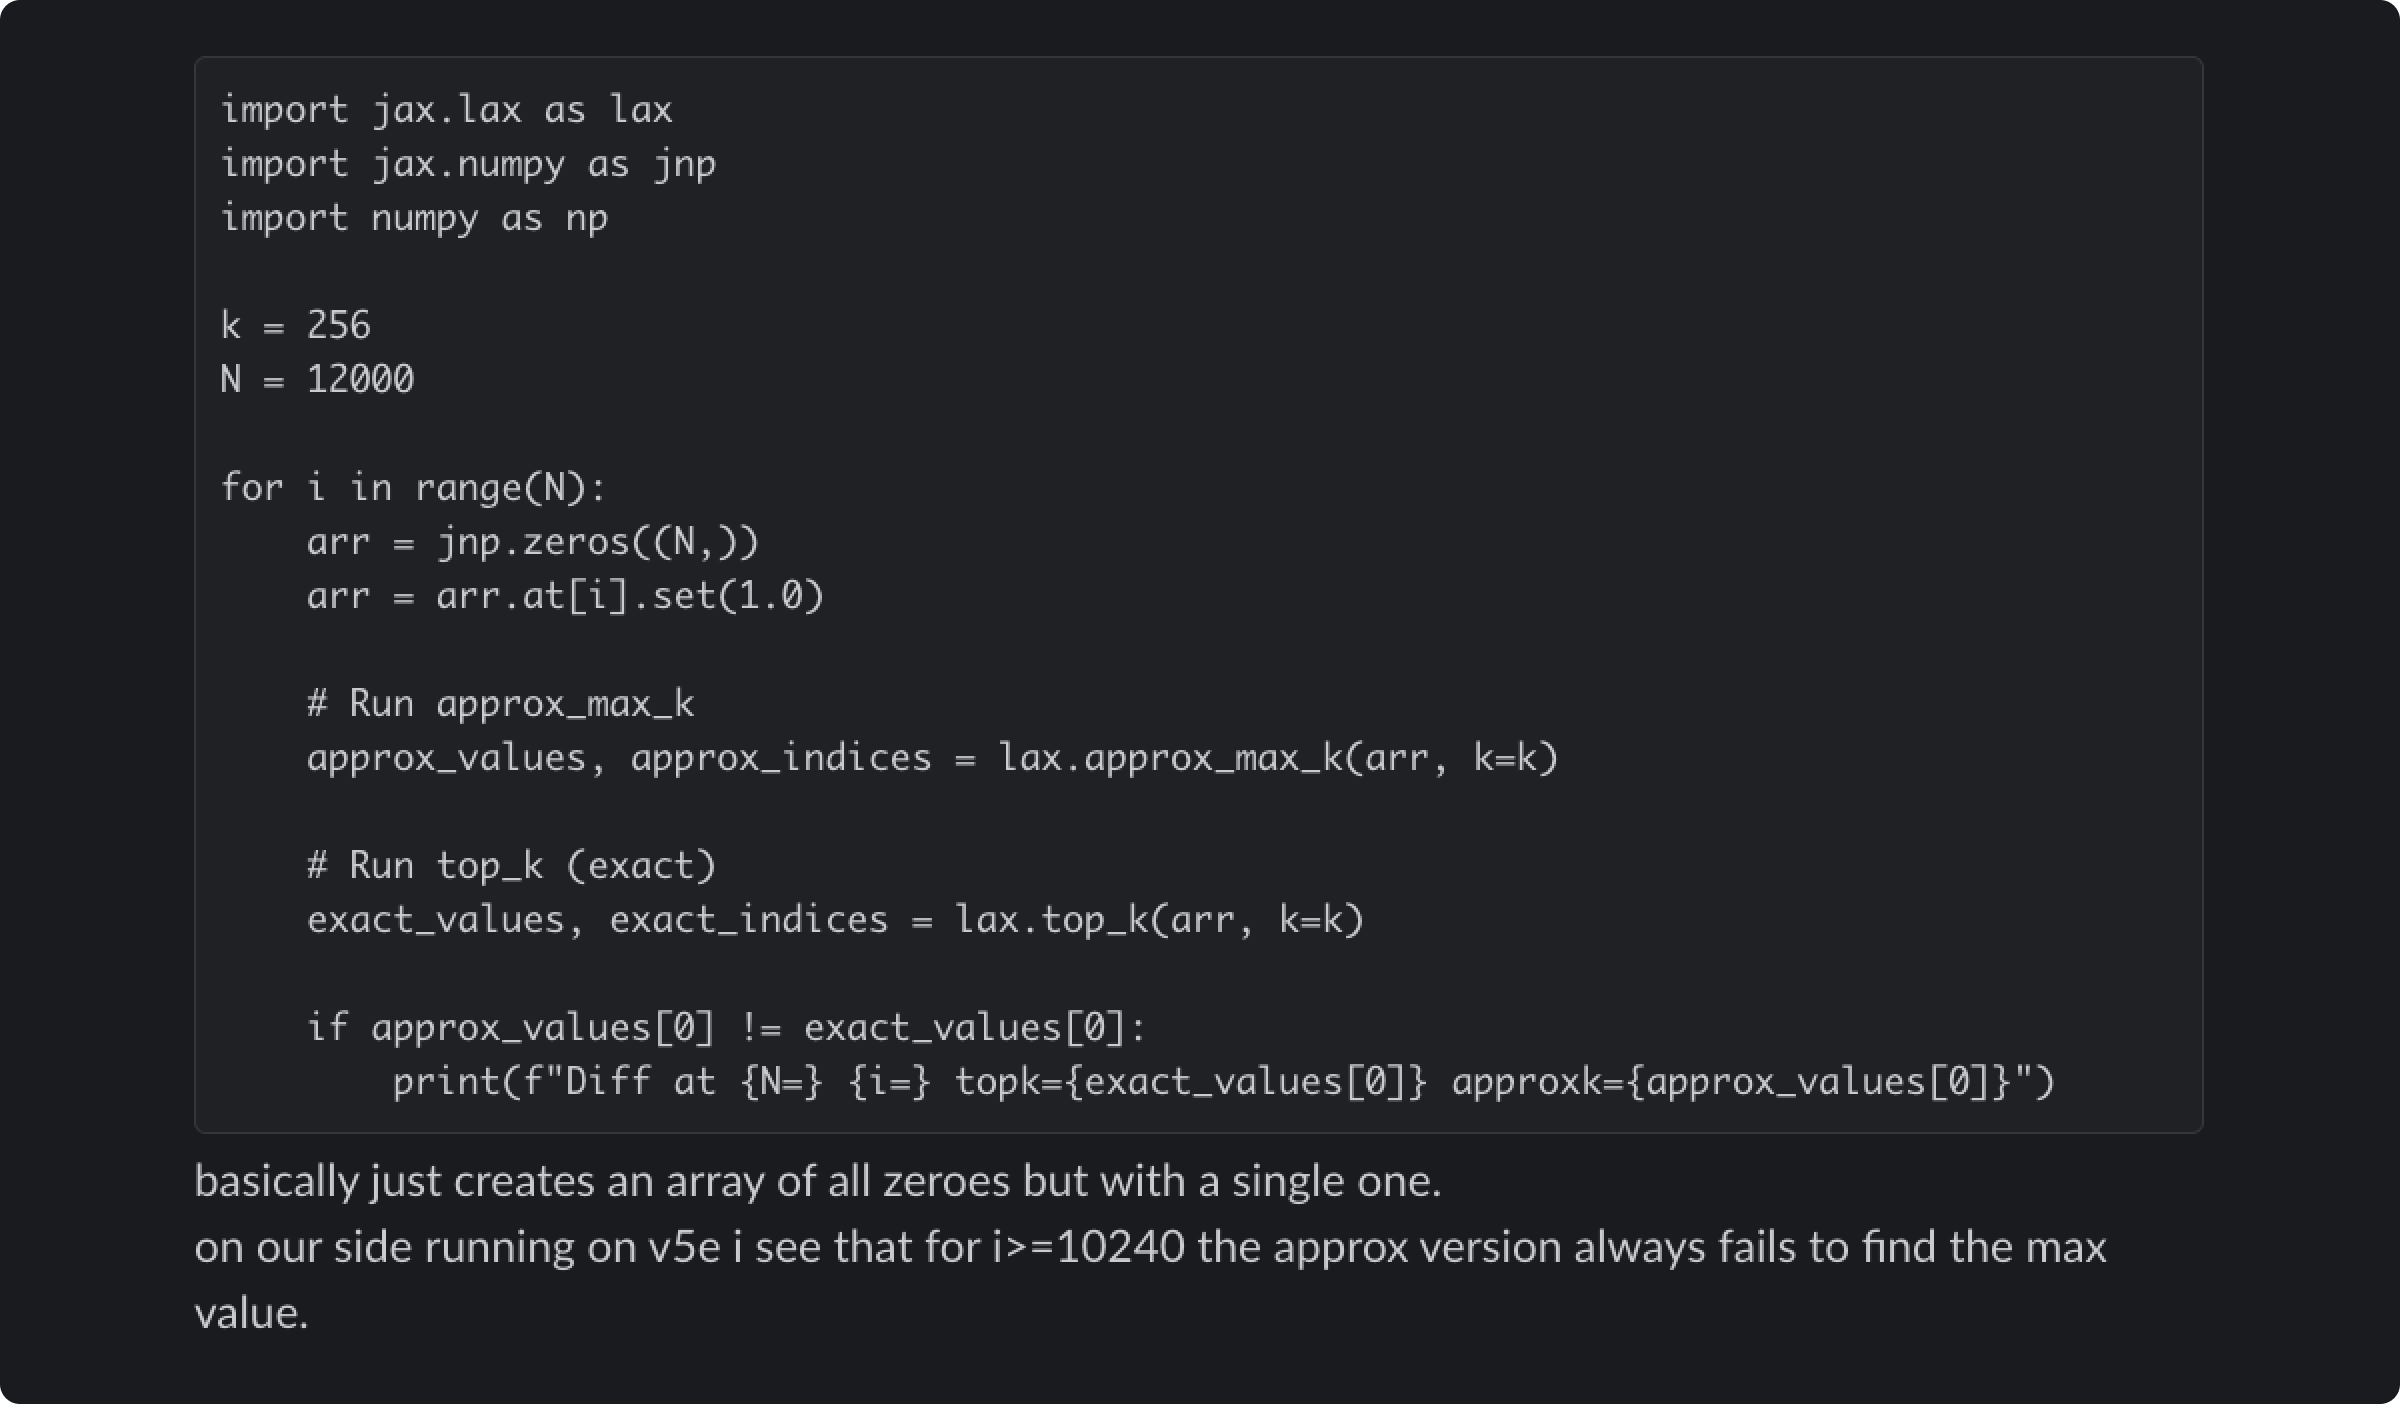
这个缺陷的行为极不稳定,令人沮丧。它会随着不相关的因素而变化,例如它之前或之后运行了哪些运算,以及是否启用了调试工具。同一个提示词,可能这次请求完全正常,下一次就出错。
在调查过程中,我们还发现精确 top-k 运算已不再有过去那种高得难以承受的性能代价。我们把近似 top-k 换成了精确 top-k,并将另外一些运算统一到 fp32 精度。[4]模型质量没有商量的余地,因此我们接受了轻微的效率损失。
为什么难以发现
我们的验证流程通常依靠基准测试,辅以安全评估和性能指标。工程团队会进行抽查,并先部署到小规模的“金丝雀”组。
这些问题暴露出一些关键的漏洞,我们本该更早发现。我们运行的评估根本没有捕捉到用户所反映的质量下降,部分原因在于 Claude 往往能从个别错误中很好地恢复。我们自身的隐私保护措施也给调查反馈增加了难度。我们内部的隐私和安全控制,限制了工程师访问用户与 Claude 交互内容的方式和时机,尤其是当这些交互没有作为反馈提交给我们时。这保护了用户隐私,但也使工程师无法查看识别或复现缺陷所需的问题交互。
每个缺陷在不同平台上表现出不同的症状,出现的比例也各不相同。这造成了一堆令人困惑的反馈,无法指向任何单一原因,看上去就像是随机且不一致的质量下降。
更根本的是,我们过于依赖噪声较大的评估。虽然我们知道网上的反馈在增多,但缺乏一种清晰的方法把这些反馈与我们最近的每次变更对应起来。8 月 29 日负面反馈激增时,我们没有立刻把它和一次原本很常规的负载均衡变更联系起来。
我们将做出的改变
在持续改进基础设施的同时,我们也在改进评估和预防上述这类缺陷的方式,覆盖我们提供 Claude 服务的所有平台。我们将做出以下改变:
- 更灵敏的评估:为了帮助找出任何问题的根本原因,我们开发了能更可靠地区分正常实现与故障实现的评估。我们会继续改进这些评估,以便更密切地关注模型质量。
- 在更多环节进行质量评估:虽然我们会定期对系统运行评估,但今后将在真正的生产系统上持续运行评估,以便捕捉上下文窗口负载均衡错误这类问题。
- 更快的调试工具:我们将开发基础设施和工具,在不牺牲用户隐私的前提下,更好地调试来自社区的反馈。此外,这里开发的一些定制工具将用于缩短今后类似事件(如果发生的话)的修复时间。
评估和监控很重要。但这些事件表明,当 Claude 的回答达不到平时的水准时,我们还需要来自用户的持续信号。关于观察到的具体变化的报告、遇到的异常行为的示例,以及不同使用场景下的共同模式,都帮助我们定位了这些问题。
用户继续直接向我们提交反馈仍然特别有帮助。你可以在 Claude Code 中使用 /bug 命令,或者在 Claude 应用中点击“踩”按钮。开发者和研究人员常常会想出新颖有趣的方法来评估模型质量,作为我们内部测试的补充。如果你愿意分享自己的方法,请联系 feedback@anthropic.com。
我们依然感谢社区做出的这些贡献。
致谢
作者 Sam McAllister,感谢 Stuart Ritchie、Jonathan Gray、Kashyap Murali、Brennan Saeta、Oliver Rausch、Alex Palcuie 以及许多其他人。
[1] XLA:TPU 是一个优化编译器,负责把 XLA 高层优化语言(通常用 JAX 编写)翻译成 TPU 机器指令。
[2] 我们的模型太大,单块芯片放不下,因此被划分到几十块或更多芯片上,这使得我们的排序运算成为分布式排序。TPU(与 GPU 和 Trainium 一样)的性能特征也与 CPU 不同,需要使用向量化运算而非串行算法的不同实现技术。
[3] 我们之前一直使用这种近似运算,因为它能带来显著的性能提升。这种近似的原理是接受概率最低的那些 token 可能存在的误差,这本不应影响质量,除非该缺陷导致它丢掉了概率最高的 token。
[4] 请注意,现在正确的 top-k 实现可能会使接近 top-p 阈值的 token 是否被纳入出现细微差异,在极少数情况下,用户可能需要重新调整所选的 top-p 值。