过去一个月,我们一直在调查部分用户反映 Claude 的回答变差的问题。我们已将这些反馈追溯到影响 Claude Code、Claude Agent SDK 和 Claude Cowork 的三项独立变更。API 未受影响。
截至 4 月 20 日(v2.1.116),这三个问题均已解决。
本文将说明我们的发现、已做的修复,以及我们将如何改进,以大幅降低类似问题再次发生的可能性。
我们非常重视有关质量下降的反馈。我们从不会故意降低模型的表现,并且我们当即确认了 API 和推理层未受影响。
经过调查,我们确认了三个不同的问题:
- 3 月 4 日,我们把 Claude Code 的默认推理强度从
high调整为medium,以缓解部分用户在high模式下遇到的超长延迟(长到足以让界面看起来像卡死)。这是一个错误的取舍。用户告诉我们,他们更希望默认使用更高的智能水平,在处理简单任务时再自行选择较低强度,因此我们于 4 月 7 日撤销了这项变更。该问题影响了 Sonnet 4.6 和 Opus 4.6。 - 3 月 26 日,我们发布了一项变更:对闲置超过一小时的会话,清除 Claude 较早的思考内容,以降低用户恢复这些会话时的延迟。一个 bug 导致这一清除在该会话的后续每一轮都会重复发生,而不是只发生一次,这让 Claude 显得健忘且重复啰嗦。我们于 4 月 10 日修复了该问题。受影响的是 Sonnet 4.6 和 Opus 4.6。
- 4 月 16 日,我们在系统提示词中加入了一条减少冗长输出的指令。它与其他提示词改动叠加,损害了编码质量,并于 4 月 20 日被撤销。受影响的是 Sonnet 4.6、Opus 4.6 和 Opus 4.7。
由于每项变更影响的流量范围不同、上线时间也不同,叠加起来的整体效果就表现为范围广泛、时好时坏的质量下降。我们在 3 月初就开始调查这些反馈,但起初很难将其与用户反馈中的正常波动区分开来,而且无论是内部使用还是评测(evals),一开始都没有复现出所发现的问题。
这不是用户应当从 Claude Code 获得的体验。自 4 月 23 日起,我们将重置所有订阅用户的使用额度。
Claude Code 默认推理强度的变更
2 月,我们在 Claude Code 中发布 Opus 4.6 时,把默认推理强度设为 high。
不久之后,我们收到用户反馈:高强度模式下的 Claude Opus 4.6 偶尔会思考过久,导致界面看起来卡死,让这些用户遭遇了不成比例的延迟和 token 消耗。
一般来说,模型思考得越久,输出越好。推理强度就是 Claude Code 让用户在这一取舍上做选择的方式:更多思考,还是更低延迟、更少触及使用额度上限。在为模型校准各档强度时,我们会考虑这一取舍,在测试时计算量(test-time-compute)曲线上选取若干点,为用户提供最合适的选项范围。在产品层,我们再决定把曲线上的哪个点设为默认值,这个值会作为 effort 参数发送给 Messages API;其他选项则通过 /effort 提供。
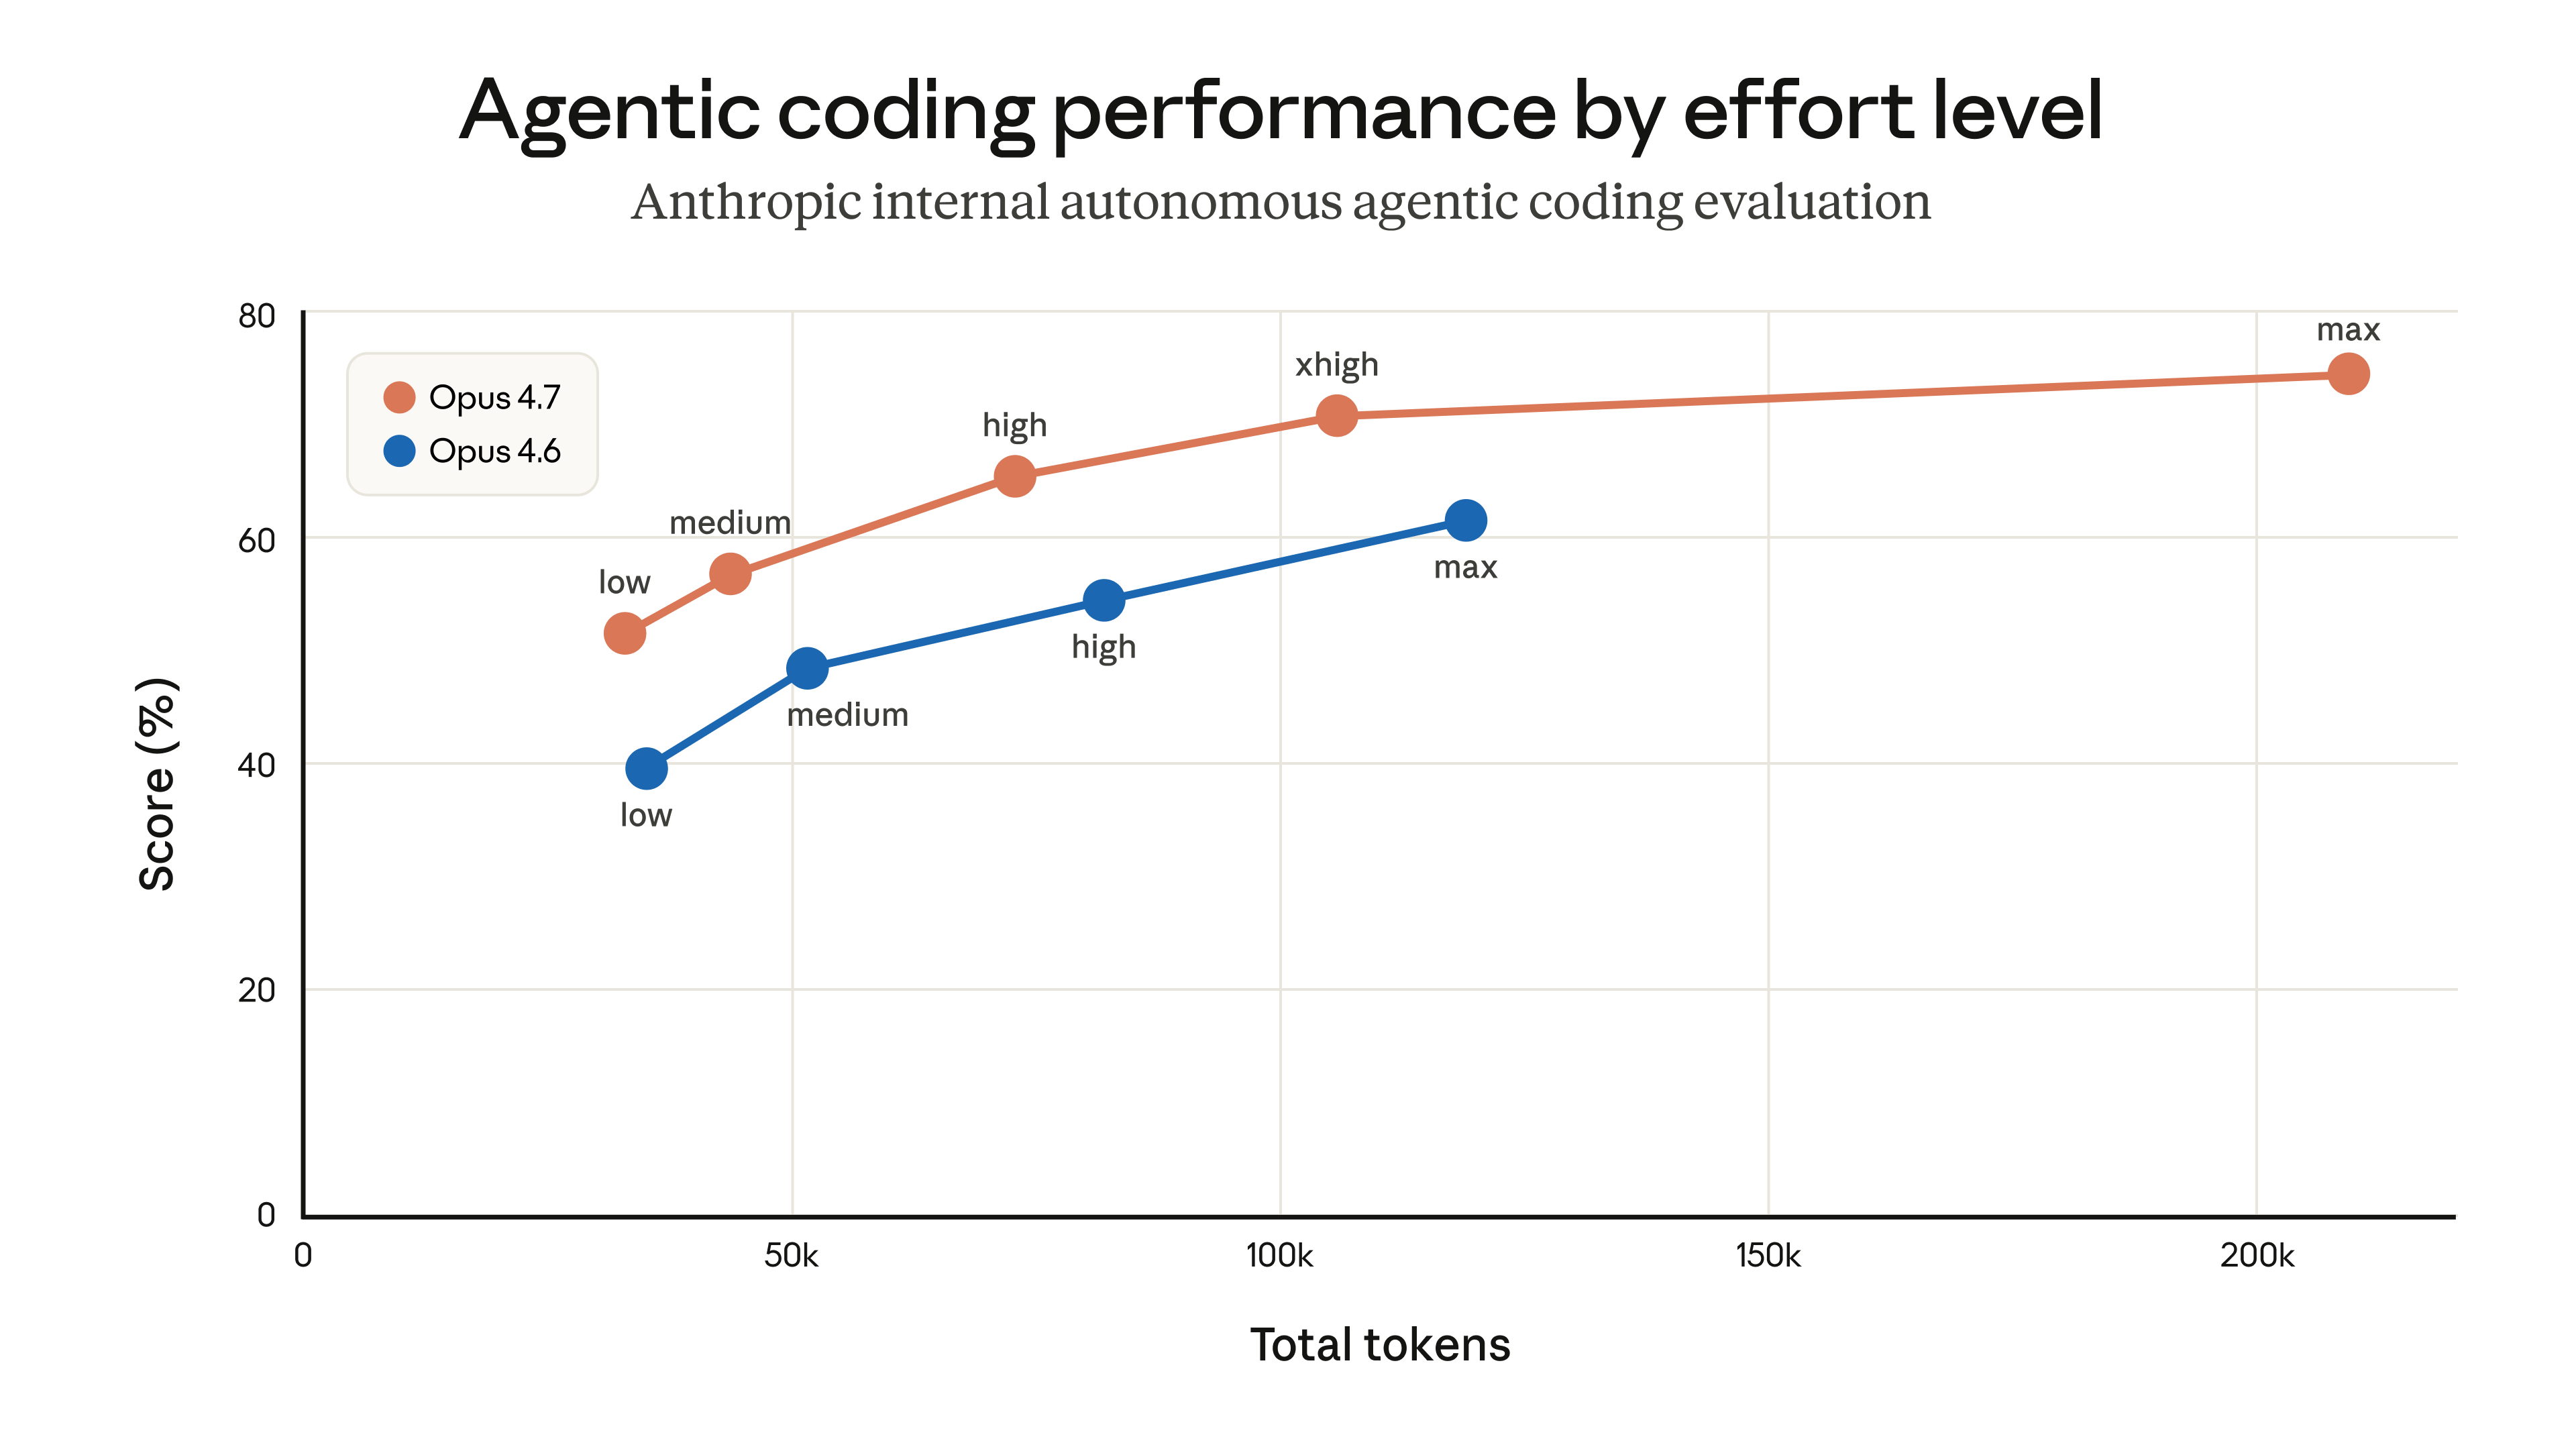
在我们的内部评测和测试中,对大多数任务而言,中等强度的智能水平略低,但延迟显著降低。它也不存在思考偶尔出现极长尾延迟的问题,还能让用户的使用额度发挥最大价值。因此,我们上线了把中等强度设为默认值的变更,并通过产品内对话框说明了理由。
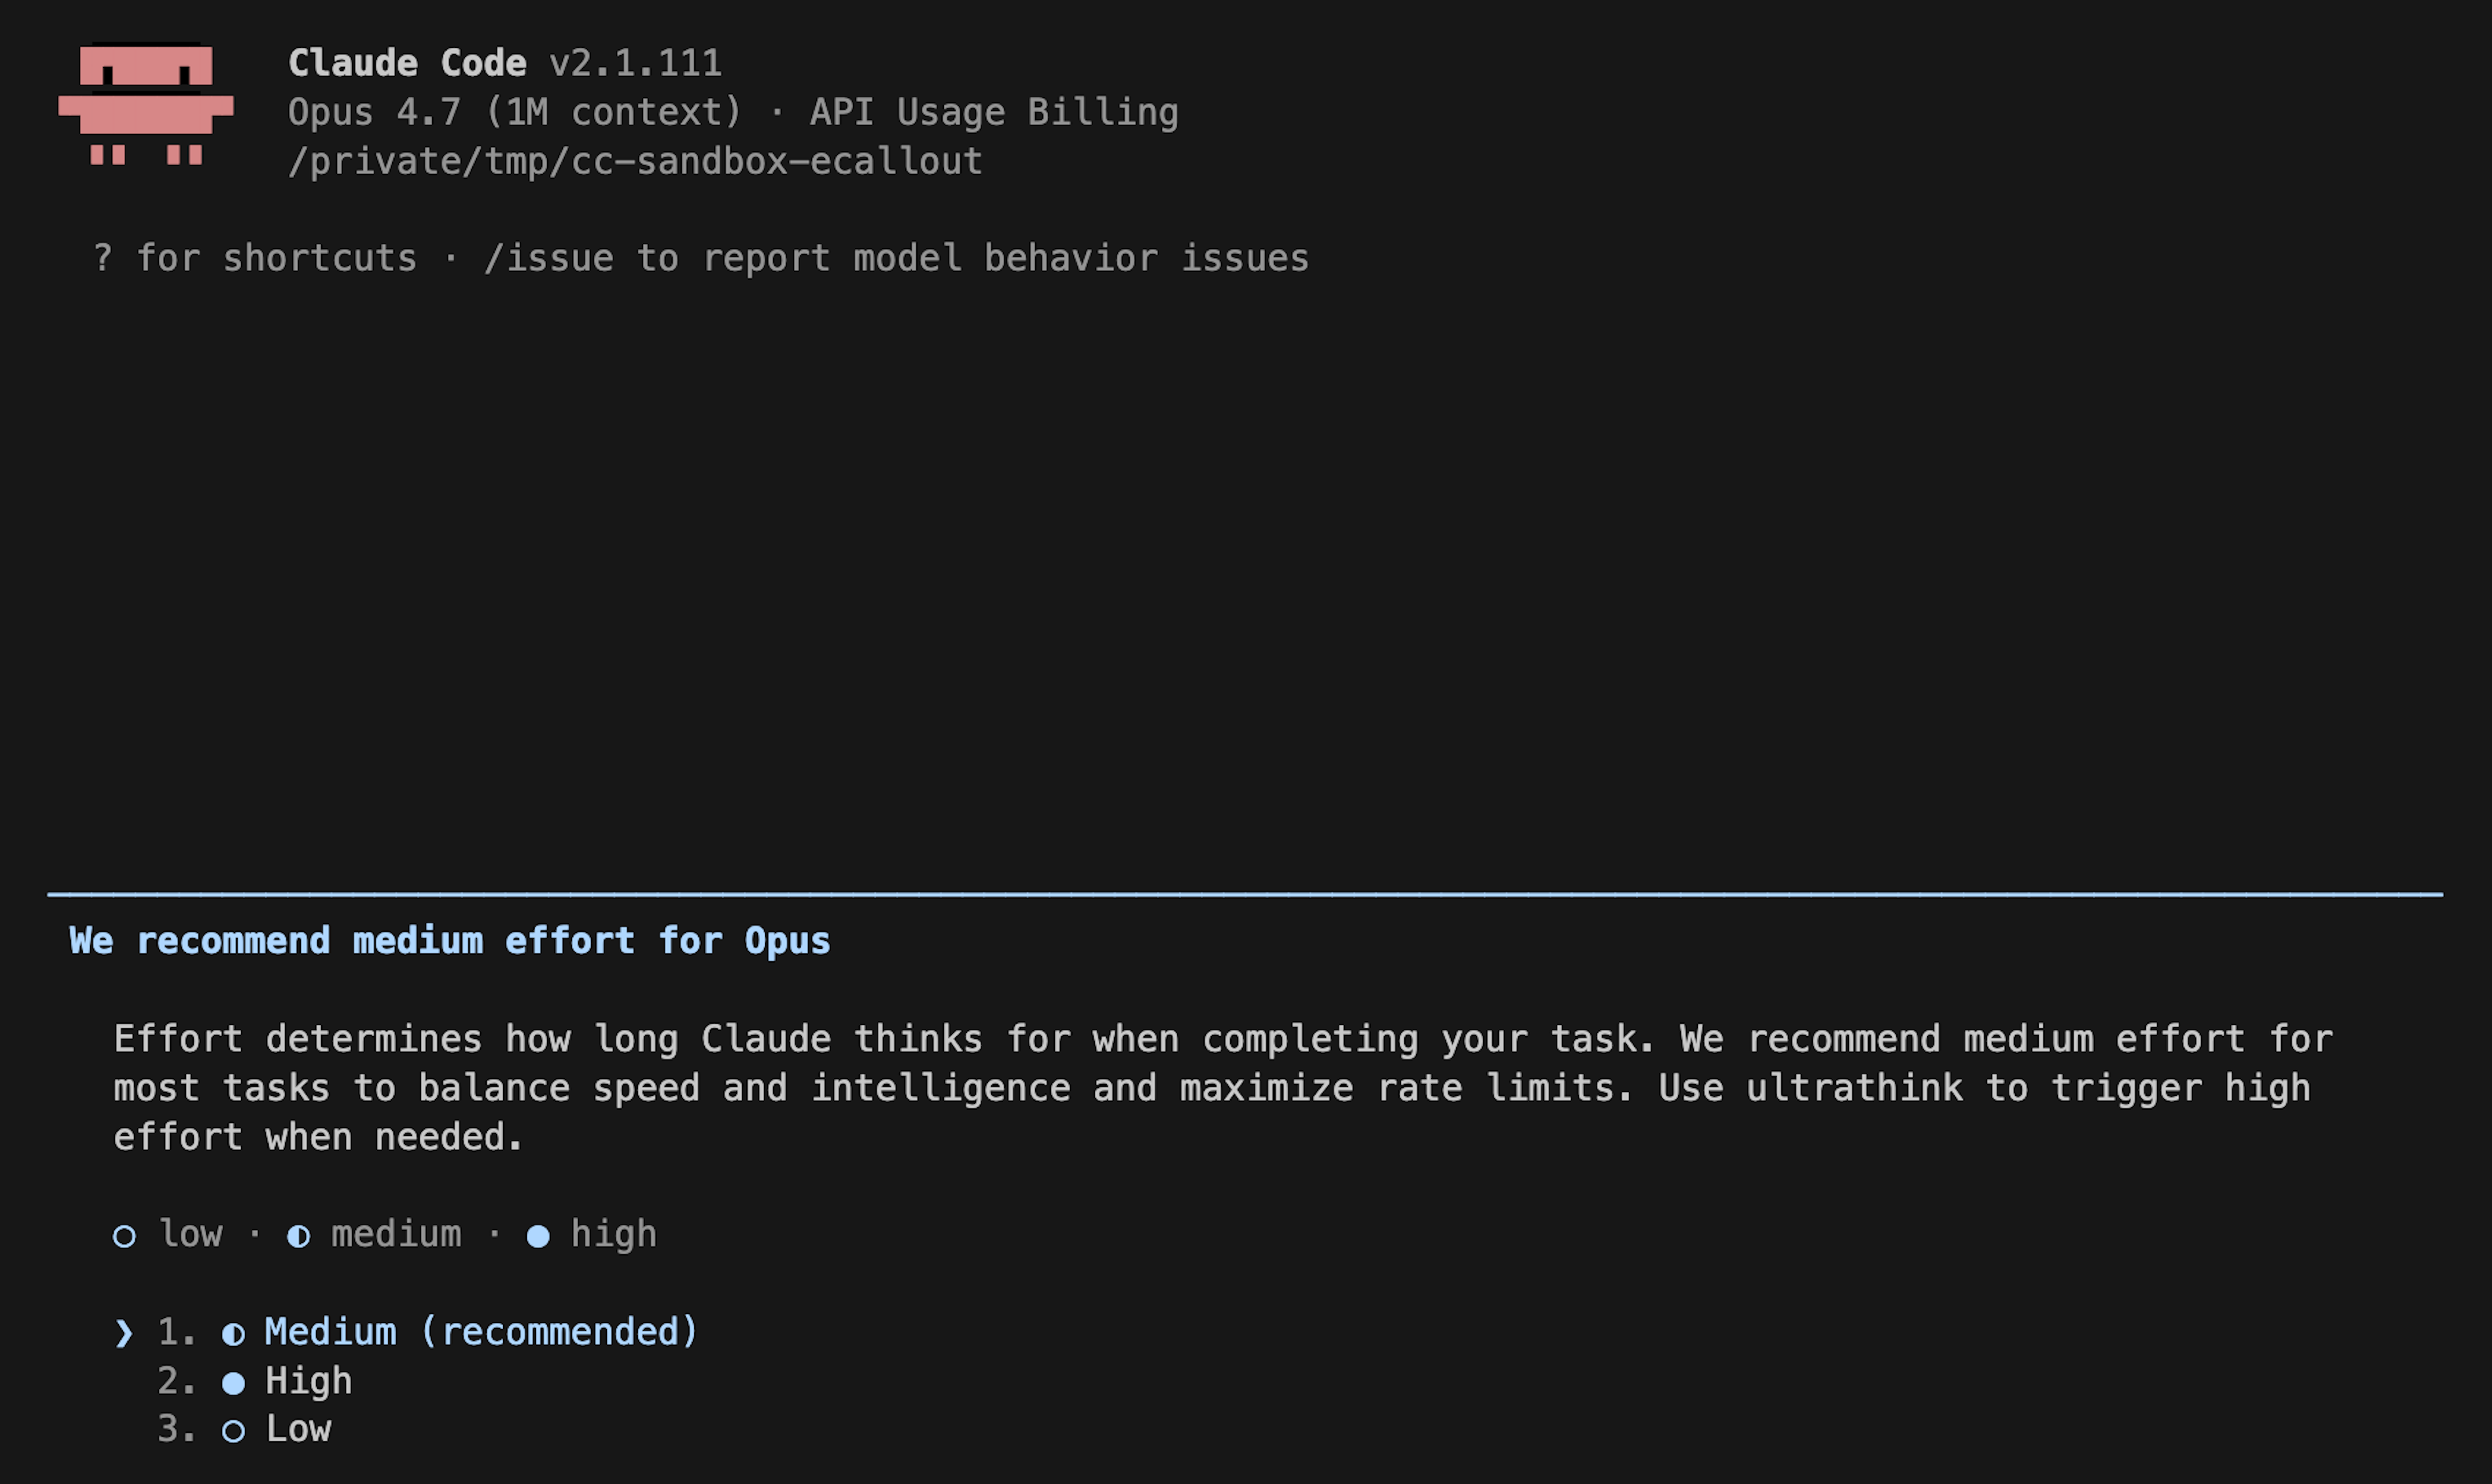
上线后不久,用户开始反映 Claude Code 感觉变笨了。我们发布了多轮设计迭代,让当前的强度设置更清晰,提醒大家可以修改默认值(启动时的提示、内嵌的强度选择器,以及恢复 ultrathink),但大多数用户仍然保持了中等强度的默认设置。
在听取更多客户的反馈后,我们于 4 月 7 日撤销了这一决定。现在,所有用户在使用 Opus 4.7 时默认采用 xhigh 强度,使用其他所有模型时默认采用 high 强度。
一项缓存优化意外丢弃了此前的推理内容
Claude 在推理完成某项任务时,这些推理内容通常会保留在对话历史中,这样在之后的每一轮,Claude 都能看到自己为什么做出那些编辑和工具调用。
3 月 26 日,我们发布了一项本意是提升这一功能效率的改进。我们使用提示词缓存(prompt caching),让用户连续发起的 API 调用更便宜、更快。Claude 在发出 API 请求时把输入 token 写入缓存,经过一段时间的闲置后,该提示词会被逐出缓存,为其他提示词腾出空间。缓存利用率是我们精心管理的事项(详见我们的做法)。
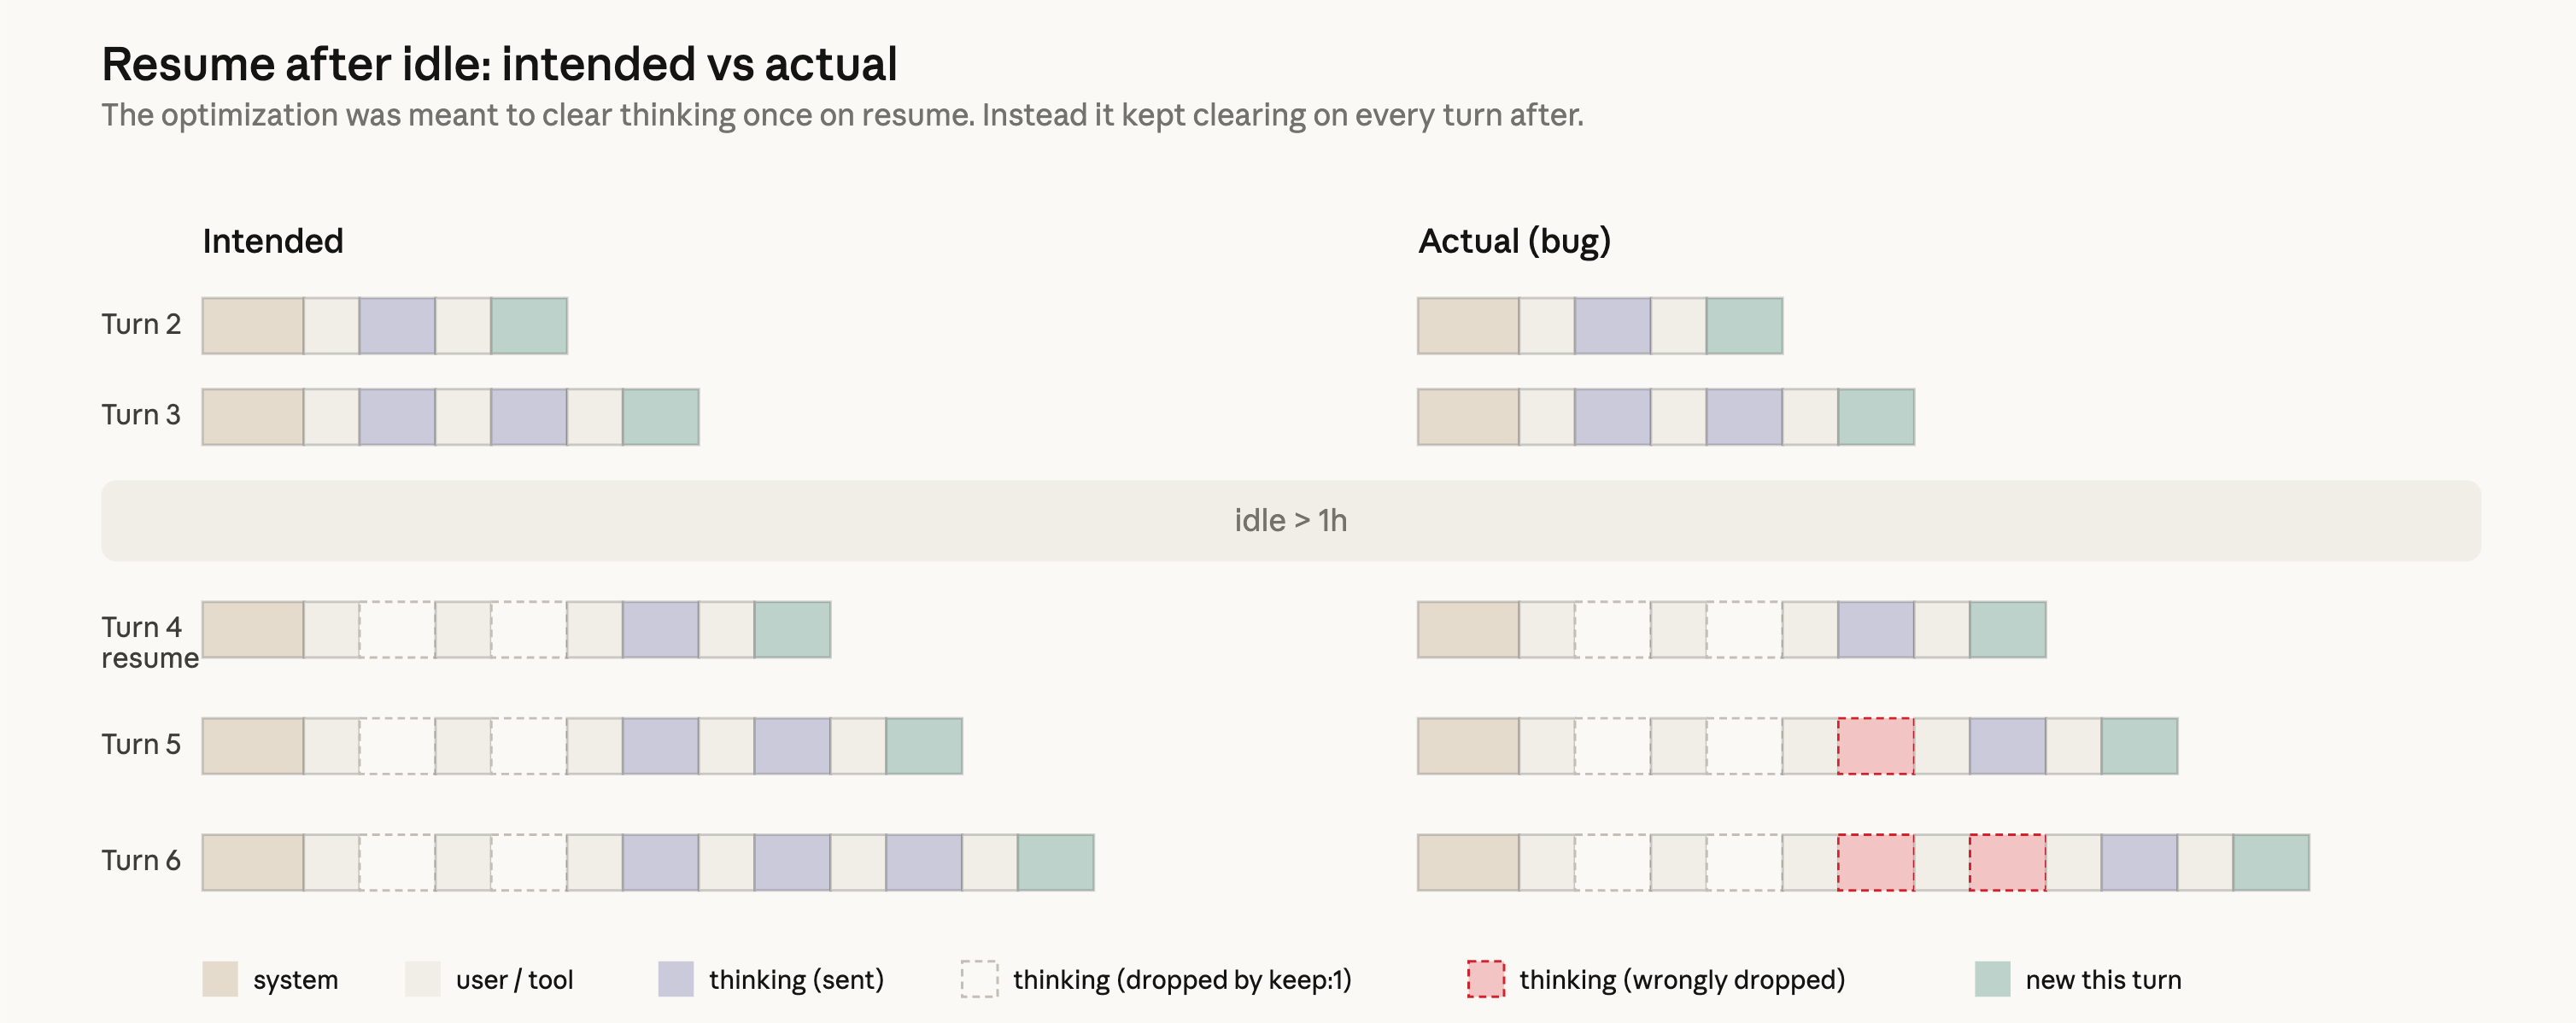
这一设计本应很简单:如果一个会话闲置超过一小时,我们可以通过清除旧的思考片段,降低用户恢复该会话的成本。既然这次请求本来就会未命中缓存,我们就可以从请求中裁剪掉不必要的消息,减少发送给 API 的未缓存 token 数量。随后再恢复发送完整的推理历史。为此,我们使用了 clear_thinking_20251015 API 请求头,并配合 keep:1。
这一实现存在 bug。它本应只清除一次思考历史,却在该会话余下的每一轮都执行了清除。会话一旦越过闲置阈值,此后该进程中的每个请求都会告诉 API 只保留最近的一段推理,丢弃在此之前的所有内容。影响层层累积:如果你在 Claude 正处于工具调用过程中时发送了后续消息,就会在这个有问题的标志下开启新的一轮,于是连当前这一轮的推理也被丢掉了。Claude 会继续执行,却越来越不记得自己为什么要这么做。这就表现为用户反映的健忘、重复和奇怪的工具选择。
由于这会不断从后续请求中丢弃思考块,这些请求也因此未命中缓存。我们认为,这正是导致另一类反馈(使用额度消耗得比预期更快)的原因。
两项互不相关的实验使我们起初难以复现该问题:一项是仅限内部的、与消息排队有关的服务端实验;另一项是思考内容展示方式上的正交变更,它在大多数 CLI 会话中抑制了这个 bug,因此即使测试外部构建版本,我们也没能发现它。
这个 bug 出现在 Claude Code 的上下文管理、Anthropic API 和扩展思考(extended thinking)三者的交汇处。引入它的改动通过了多轮人工与自动化的代码审查,以及单元测试、端到端测试、自动化验证和内部试用(dogfooding)。再加上它只在边缘情况(过期会话)下才会出现,且难以复现,我们花了一周多时间才找到并确认根因。
作为调查的一部分,我们使用 Opus 4.7 对有问题的拉取请求回测了 Code Review。在提供了收集完整上下文所需的代码仓库后,Opus 4.7 发现了这个 bug,而 Opus 4.6 没有。为避免此类情况再次发生,我们现在正在为代码审查加入对更多仓库作为上下文的支持。
我们于 4 月 10 日在 v2.1.101 中修复了这个 bug。
一项为减少冗长输出而改动的系统提示词
我们最新的模型 Claude Opus 4.7 相比其前代有一个明显的行为特点:正如我们在发布时所写,它往往相当冗长。这让它在难题上更聪明,但也会产生更多输出 token。
在发布 Opus 4.7 的几周前,我们就开始为它调优 Claude Code。每个模型的行为都略有不同,我们在每次发布前都会花时间针对它优化整套工具链(harness)和产品。
我们有多种手段来减少冗长输出:模型训练、提示词,以及改进产品中的思考体验(thinking UX)。最终这些手段我们都用上了,但系统提示词中新增的一条指令,对 Claude Code 的智能表现造成了超出预期的影响:
“长度限制:工具调用之间的文本保持在 25 个词以内。除非任务需要更多细节,最终回复保持在 100 个词以内。”
经过数周的内部测试,且我们运行的那组评测中没有出现退化,我们对这一改动有了信心,于 4 月 16 日将其与 Opus 4.7 一同发布。
作为这次调查的一部分,我们使用更广泛的评测集运行了更多消融实验(ablation,即逐行移除系统提示词以了解每一行的影响)。其中一项评测显示,Opus 4.6 和 4.7 都出现了 3% 的下降。我们立即在 4 月 20 日的版本中撤销了该提示词。
未来的改进
为避免这些问题,我们将在若干方面改变做法:确保更大比例的内部员工使用与公开版本完全一致的 Claude Code 构建(而非我们用来测试新功能的版本);同时改进我们内部使用的 Code Review 工具,并将改进后的版本提供给客户。
我们还将加强对系统提示词变更的管控。对 Claude Code 的每一次系统提示词变更,我们都会运行覆盖面广的分模型评测套件,继续通过消融实验了解每一行的影响,并且已经构建了新工具,让提示词变更更易于审查和审计。此外,我们还在 CLAUDE.md 中加入了指引,确保针对特定模型的改动只作用于它所针对的那个模型。对于任何可能以牺牲智能为代价的变更,我们都会增加观察期(soak period)、采用更广泛的评测套件并进行灰度发布,以便更早发现问题。
我们最近在 X 上创建了 @ClaudeDevs,以便有空间深入解释产品决策及其背后的考量。我们也会在 GitHub 上以集中的讨论串同步发布相同的更新。
最后,我们要感谢用户:那些使用 /feedback 命令向我们反馈问题的人(或在网上发布具体、可复现示例的人),最终帮助我们找到并修复了这些问题。今天,我们将重置所有订阅用户的使用额度。
我们由衷感谢你们的反馈与耐心。