随着企业 AI 的采用规模不断扩大,开发者越来越不得不拼凑碎片化的流水线,为文本、视觉和代码分别使用不同的模型,由此带来更高的复杂度、更高的成本和更慢的迭代。
MiniMax M3 可在包括 NVIDIA Blackwell 在内的 NVIDIA 加速基础设施上使用,它改变了这一局面,让单一的多模态系统就能胜任长上下文推理、智能体工作流和创意任务。
这个 428B 参数的 MoE 模型支持最长 1M 词元的上下文和原生多模态输入。开发者可以构建长视频理解、长时间编码会话(8 小时以上)和高质量设计工作流等应用,全部基于同一个统一模型,并在 NVIDIA 平台上获得可用于生产的部署路径。
表 1. MiniMax M3(一个 VLM MoE 模型)规格
| 名称 | MiniMax M3 |
|---|---|
| 输入模态 | 视频、图像、文本 |
| 总参数量 | 428B |
| 视觉编码器参数量 | 600M |
| 激活参数量 | 22B |
| 上下文长度 | 1M |
| 专家 | 共 128 个,每个词元激活 4 个专家 |
| 精度格式 | BF16、MXFP8 |
MiniMax M3 的核心架构创新是 MiniMax Sparse Attention(MSA),它用一个预过滤阶段取代标准的二次方复杂度注意力:先找出相关的上下文块,只对这些块做注意力计算。在算子层面,每个 KV 缓存块只需通过连续内存访问读取一次,比现有的稀疏注意力实现快 4 倍以上。这使得在 1M 词元上下文下,每个词元的计算量仅为 M2 的 1/20,预填充快 9 倍,解码快 15 倍,而且无需压缩键值,也不牺牲精度。该模型还从第 0 步起就在约 100 万亿个交错词元上原生训练文本、图像和视频,而不是在后训练阶段再添加多模态能力。
▶ https://developer.download.nvidia.com/video/devblog/MiniMax3.mp4
视频 1. NVIDIA API 目录中的 MiniMax M3,开发者可以在这里测试提示词、调整参数并探索推理控制,然后再用该模型进行构建
NVIDIA Blackwell 性能洞察
MiniMax M3 是为新一类多模态、长上下文推理而构建的,而 NVIDIA Blackwell 提供了高效服务它所需的规模和低延迟性能。在 MiniMax M3 上,NVIDIA Blackwell Ultra 的吞吐量最高可达上一代 NVIDIA Hopper 的 10 倍(见图 1),交互性提高一倍,并提升了 AI 工厂的吞吐量。
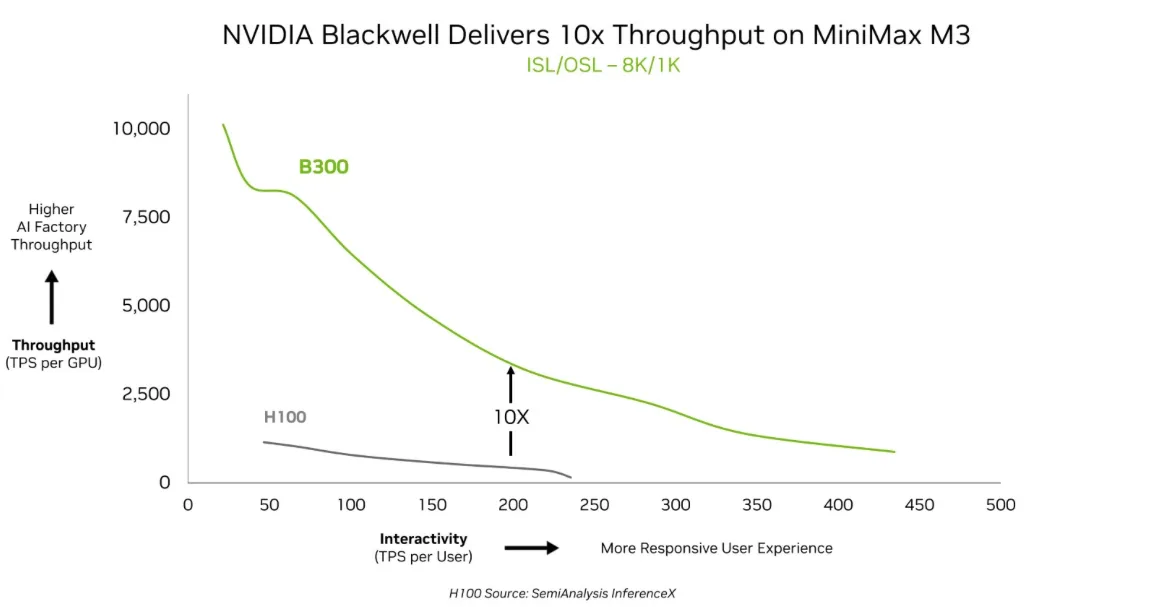
这些提升来自软硬件极致协同设计的结合。借助推测解码、MTP 以及不损失精度的 NVFP4 加速,随着整个技术栈在 NVIDIA Dynamo 和 NVIDIA CUDA 内核上持续优化,Blackwell 有望把 MiniMax M3 的性能进一步推高。
开源推理
开发者可以将加速计算与自己选择的开源推理引擎搭配使用,例如 NVIDIA TensorRT LLM(仅限文本)、SGLang 或 vLLM。
使用 NVIDIA TensorRT LLM 部署
这些优化已在 NVIDIA TensorRT LLM GitHub 仓库中提供。按照快速入门指南即可搭建高性能服务器,指南涵盖从 Hugging Face 下载模型检查点、开箱即用的 Docker 容器,以及低延迟和最大吞吐量两种服务方式的配置选项。NVIDIA 还通过 Transformers 库在开发者体验方面进行了协作。
使用 SGLang 部署
使用 SGLang 服务框架部署模型的用户可以参考以下说明。更多信息和配置选项请参阅 SGLang 文档。
# 8 GPUs node case
$ python -m sglang.launch_server \
    --model-path MiniMaxAI/MiniMax-M3 \
    --dtype bfloat16 \
    --tp-size 8 \
    --ep-size 8 \
    --trust-remote-code \
    --mem-fraction-static 0.8 \
    --enable-multimodal \
    --quantization mxfp8 \
    --attention-backend flashinfer \
    --mm-attention-backend flashinfer_cudnn \
    --moe-runner-backend deep_gemm \
    --chunked-prefill-size 8192 \
    --reasoning-parser minimax-m3 \
    --tool-call-parser minimax-m3-nom
--tr
使用 vLLM 部署
使用 vLLM 服务框架部署模型时,请参考以下说明。更多信息请参阅 vLLM Recipe。
vllm serve MiniMaxAI/MiniMax-M3 \
  --tensor-parallel-size 8 \
  --enable-expert-parallel \
  --block-size 128 \
  --mm-encoder-attn-backend FLASHINFER \
  --mm-processor-cache-type shm \
  --tool-call-parser minimax_m3 \
  --enable-auto-tool-choice \
  --reasoning-parser minimax_m3 \
  --trust-remote-code
借助 NVIDIA Dynamo 扩展
Dynamo 是一个开源的分布式推理服务平台,供开发者为大规模应用部署 MiniMax M3 等前沿模型。通过 Dynamo 搭配 TensorRT LLM 部署 MiniMax M3,可以在不牺牲吞吐量、不增加 GPU 预算的前提下,提升长输入序列的性能。
Dynamo 与所有主流推理引擎和框架集成,包括 PyTorch、SGLang、TensorRT LLM 和 vLLM,并提供感知 LLM 的路由、弹性自动扩缩容和低延迟数据传输。开发者可以按照部署指南,用 Dynamo 运行 MiniMax M3。
使用 NVIDIA NeMo Framework 进行定制
MiniMax M3 可以通过开源的 NVIDIA NeMo Framework 进行定制和微调。用户可以:
- 使用 NVIDIA NeMo AutoModel 对 Hugging Face 检查点开箱即用地进行微调(SFT 和 LoRA 均支持),无需任何转换,并借助完整的 N 维并行获得高吞吐量加速。具体而言,序列长度最长 128k 时可使用上下文并行。
- 使用 NVIDIA NeMo RL 在 Minimax M3 之上进行强化学习,可参考以下示例精度曲线。
这些库为开发者提供了一套轻量工具,便于在最新的前沿模型上快速实验。
立即开始
开发者可以通过 build.nvidia.com 上的 GPU 加速 API,或从 Hugging Face 下载权重,来原型验证和评估 MiniMax M3。