思考
摘要
Shieldstral 是一个 3B 参数的开放权重多模态安全分类器,它把内容审核表述为一个随策略自适应的问答任务,表现优于体量最高达其 7 倍的模型。与传统护栏模型不同,它在推理时接受自然语言写成的策略,无需重新训练即可统一文本与图像的安全评估。该模型以 Apache 2.0 协议发布,在多种基准测试中给出经过校准的安全分数,并且能在单张 16GB 的 NVIDIA GPU 上高效运行。
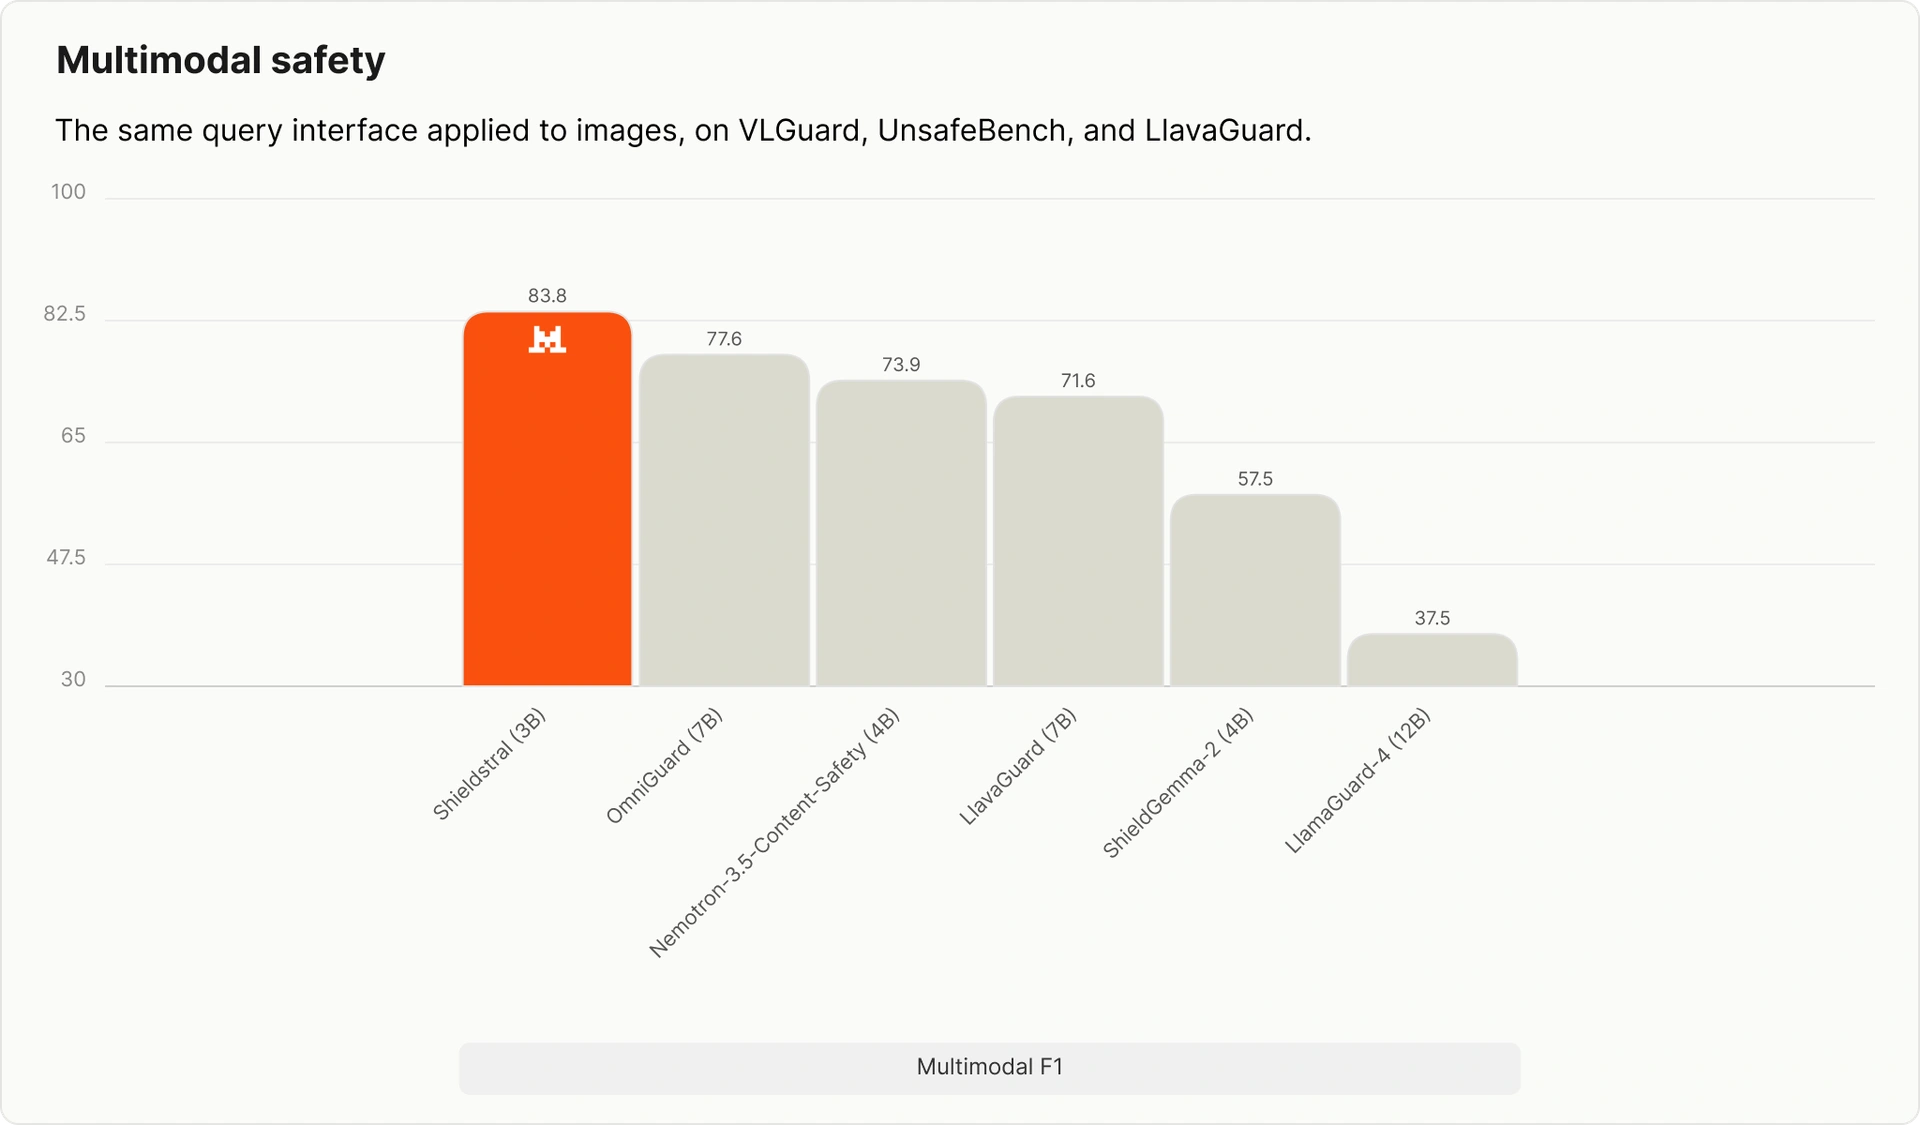
一个 3B 参数、开放权重、可随策略自适应的多模态安全分类器:在文本安全上与体量最高达其 7 倍的模型相当,在多模态审核上刷新了业界最佳水平。
“这段内容是否在宣扬针对受保护群体的暴力?这张图片适合展示给未成年人吗?助手是否拒绝了该请求?”
每一个上线模型的产品都需要回答类似的问题,但正确答案取决于产品、受众和当下的情境。同样的内容,对网络安全研究工具来说可能没有问题,放在心理健康平台上却可能有害。大多数护栏模型把一套固定的危害类别体系固化在权重里,因此想把它们迁移到新的部署场景,就得重新训练。而且由于不同应用和领域对安全的定义各不相同,根本不存在一套唯一“正确”的类别可供建模。
Shieldstral 采取了不同的做法:你在推理时用自然语言把策略写成一个问题,模型返回一个经过校准的安全分数。无需重新训练,文本和图像共用一个接口,只凭单个 token 就能给出判定。请参阅我们的技术报告。
作为 Open Secure AI Alliance(开放安全 AI 联盟)与 NVIDIA 及其他机构共同的创始成员,我们今天以 Apache 2.0 协议开放权重发布 Shieldstral,可在此处下载。
把审核变成一个问题
Shieldstral 把内容审核表述为一个二元问答任务。每个请求包含三部分:
<Instruct>:评估情境、严格程度,以及(可选的)对何谓不安全内容的定义。<Query>:一个单一的是/否问题,例如“这段内容是否宣扬肉体暴力?”<Document>:待判定的内容,可以是提示词、回复、提示词与回复的组合,或带有可选文字的图像。
推理时,模型只读取 yes 和 no 两个 logit,并通过 softmax 归一化得到一个连续的安全分数。这个简单的表述承担了很多工作:它把提示词分类、回复审核、拒答检测和毒性检测统一成同一个问题;它让策略完全存在于提示词之中,因此同一个检查点就能在部署时适应新的策略。
亮点
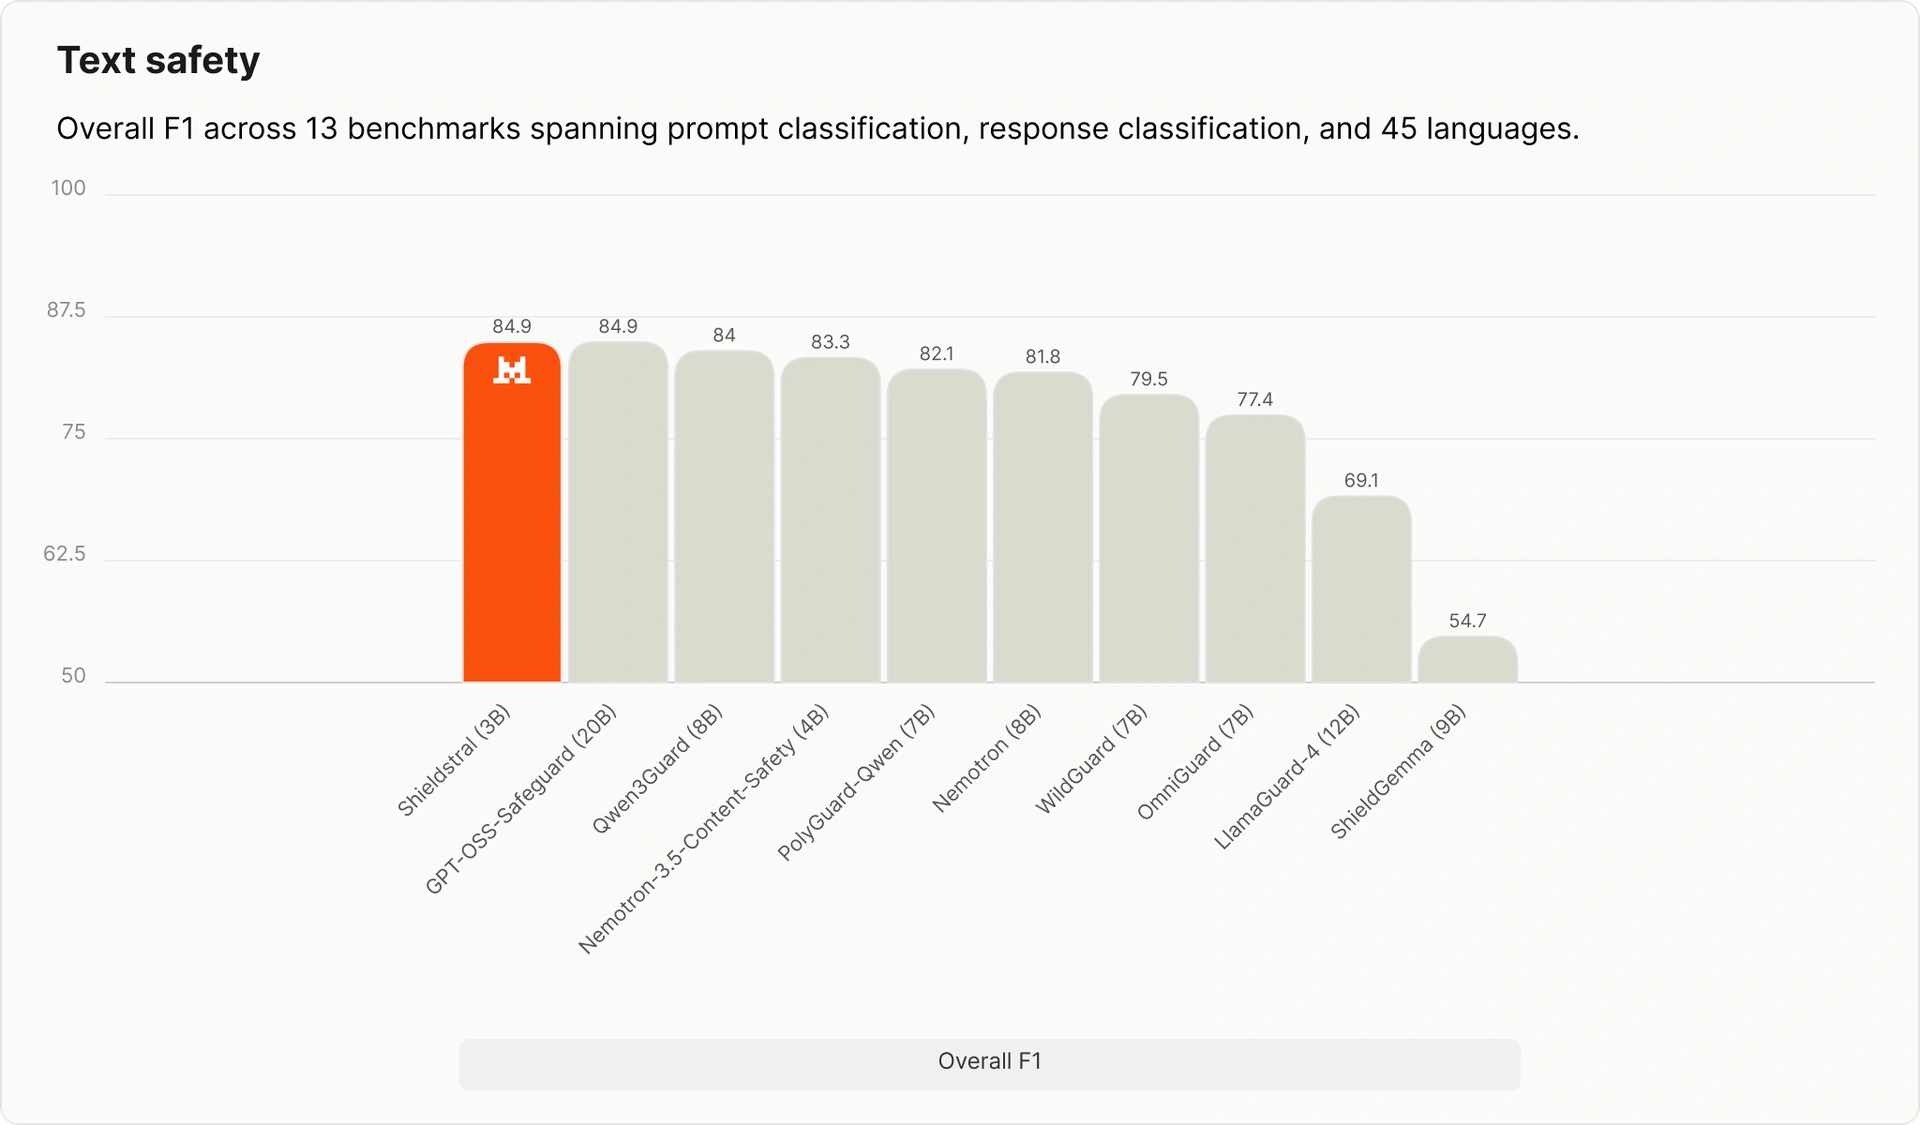
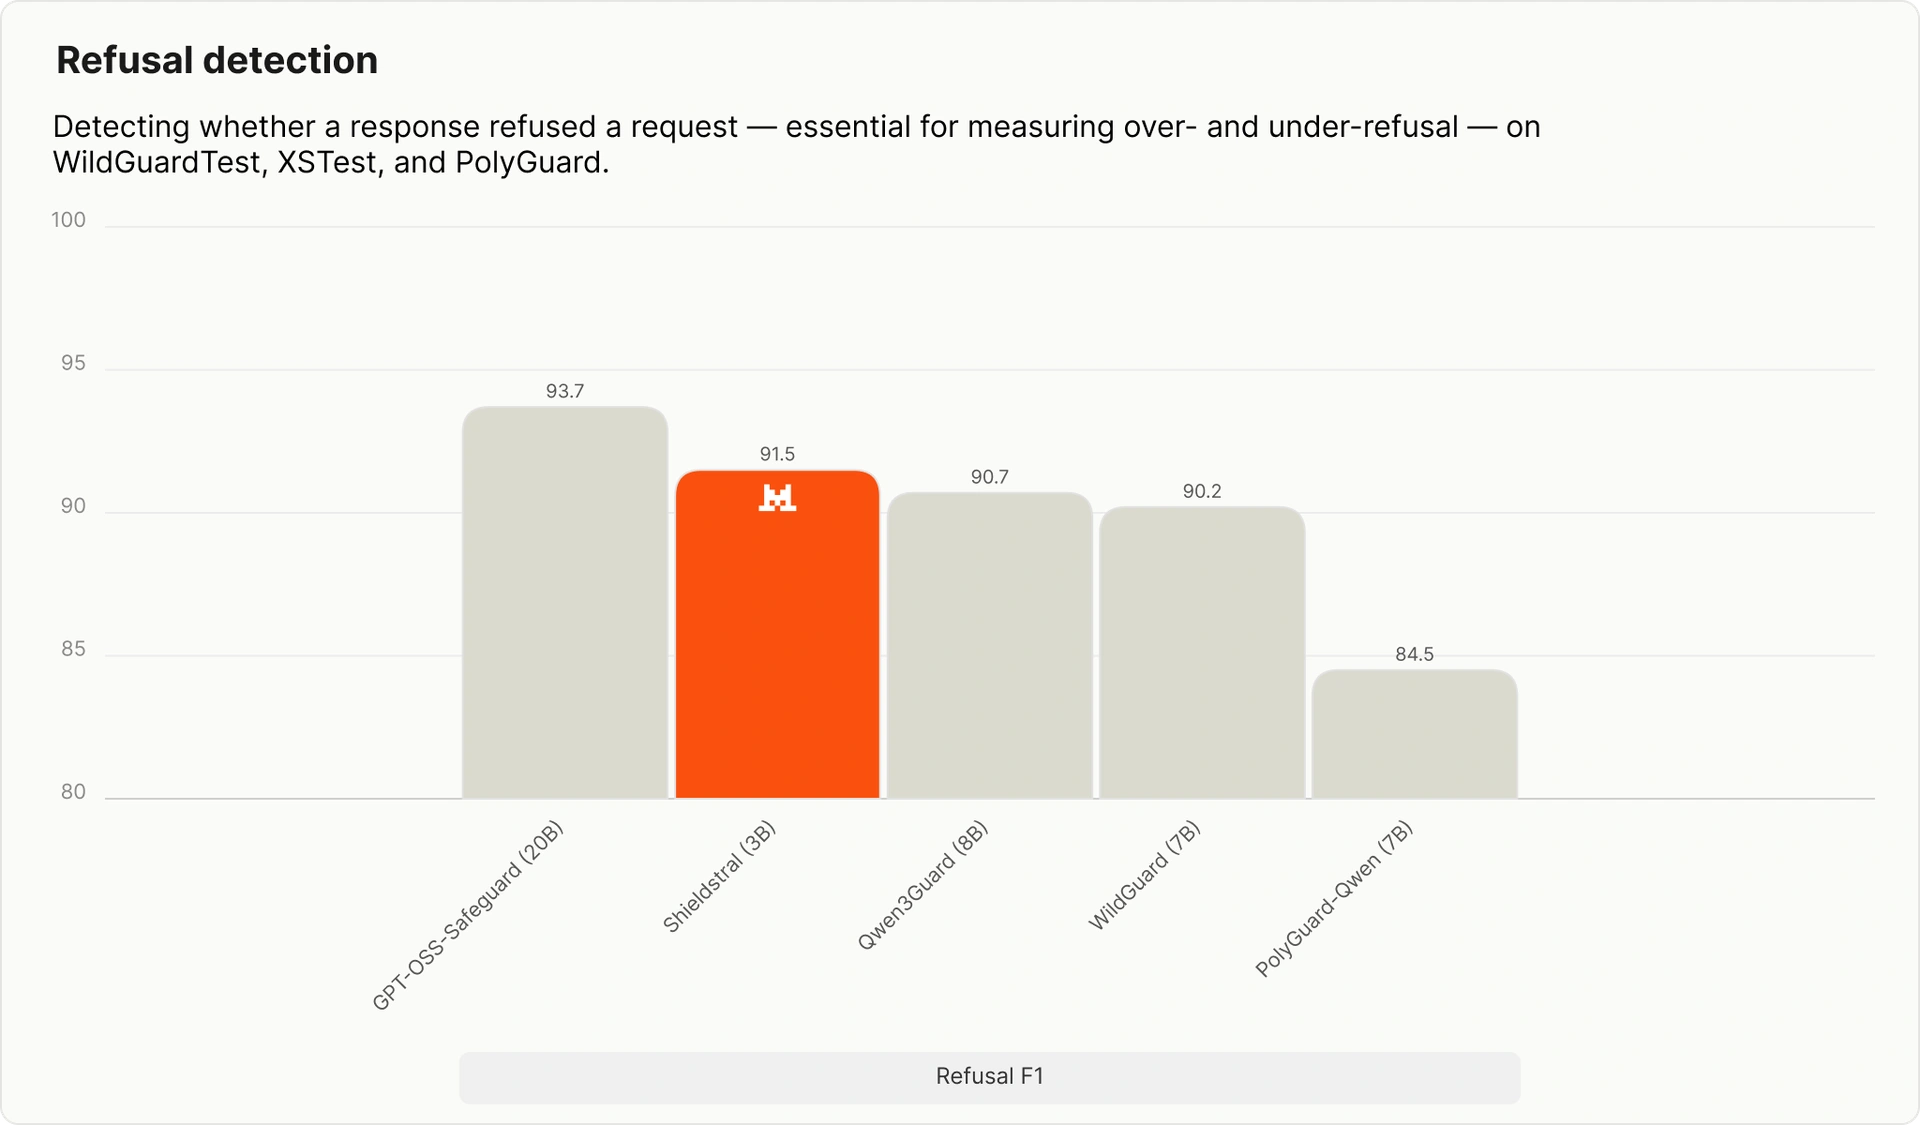
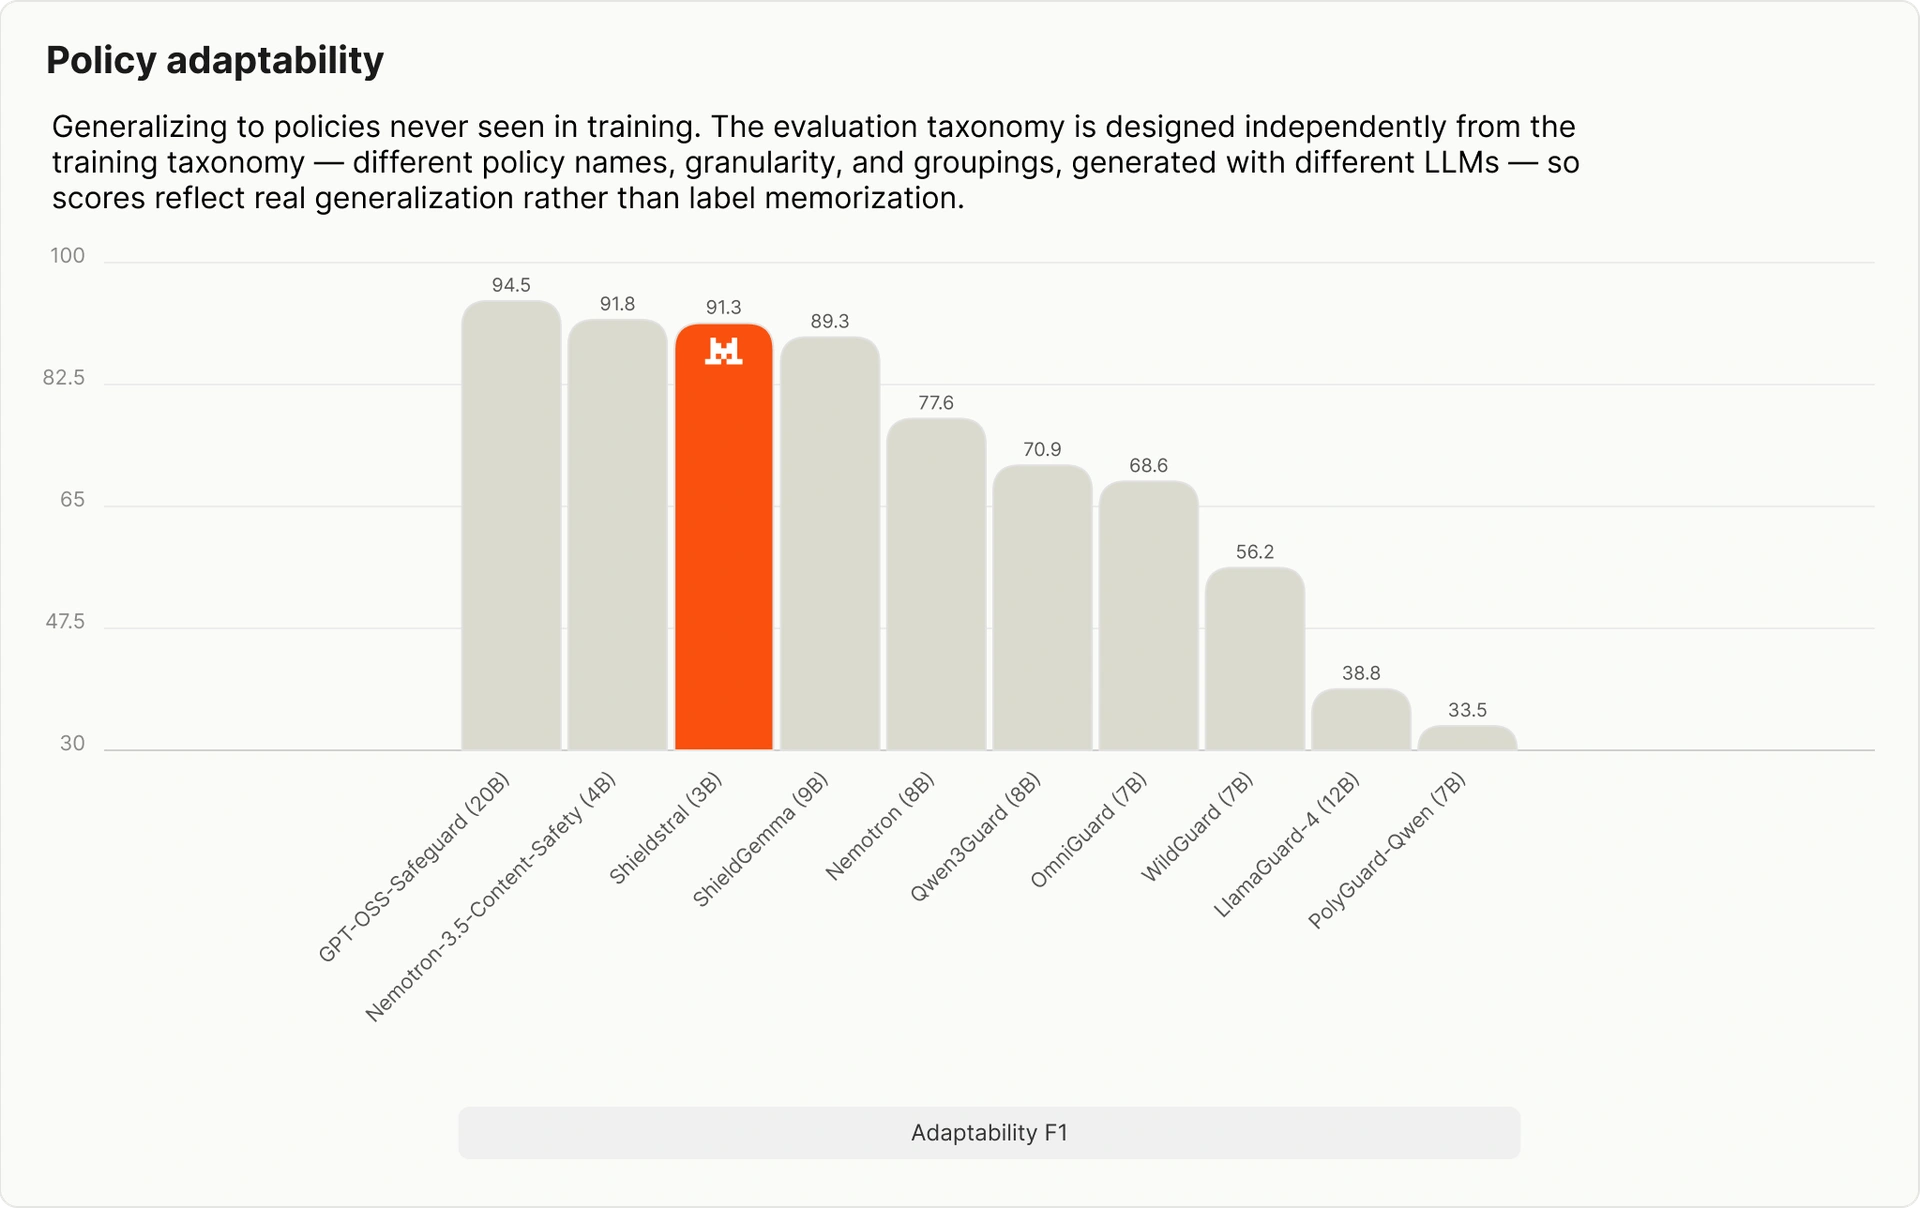
- 性能强劲:在文本安全、拒答检测、策略适应性和多模态基准测试上,与体量最高达其 7 倍的开源护栏模型持平或更优。
- 自适应且灵活:一个自然语言接口即可覆盖文本、图像以及图文混合内容,适用于提示词、回复和提示词-回复组合。策略以自由形式的查询提供,在推理时重新指定,无需重新训练。
- 体量小,训练数据来源多样:这是一个 3B 模型,可在单张 16GB GPU 上运行,用真实数据和合成数据训练,这些数据的标签格式和分类体系各不相同,最终被整合进同一个框架。
- 连续的安全分数:一次前向传播即可返回经过校准的
yes/no概率,因此你可以按置信度设定阈值或排序,而不必依赖离散标签。 - 开放:Apache 2.0 权重。
基准测试
我们从四个维度,将 Shieldstral 与体量最高达其 7 倍的开源护栏模型进行对比评估。所有评估样本均未出现在训练集中。
我们如何构建
核心思路是:只要数据对了,小模型也能胜过大得多的模型。要把数据做对,需要解决四个问题:
统一异构数据。公开的安全数据集在分类体系、标签和标注惯例上各不相同,从二元的安全/不安全标记到细粒度的多标签分类体系都有。我们用每个数据集专属的处理器,把它们全部转换成同一种“指令-查询-文档”格式,并变换指令、查询以及提示词-回复分隔符的措辞,使模型能够泛化到不同的表述,而不是过拟合某一种风格。我们还按数据来源校准严格程度:对抗性越狱数据从严,回复质量数据从宽,让模型学到经过校准的决策边界。这使我们能够整合原本互不兼容的数据来源。
教会辨别,而非死记。如果只用一组固定的策略标签训练,模型只会学着对这些预定义的策略分类,而不是去推理某个策略的精确边界,这就妨碍了它对新策略的泛化。为此,我们构造了若干组刻意相近、容易混淆的策略,并让 LLM 把安全文本改写成对比样本对:每一处改写都被设计成违反其中一条策略,而不违反与之相近的另一条。这样训练出的模型能够分辨一段内容究竟违反了哪一条具体策略,这种能力可以迁移到推理时从未见过的、用户自定义的策略上。
让安全判断落到图像上。不安全的图像不像文本那样可以由 LLM 合成,因此视觉安全数据十分稀缺。我们用通用图像数据集作为高质量的负样本,补充有限的审核数据集,并通过变换查询来扩充数据,再用视觉-语言重排序模型过滤每一个图像-查询对,以减少误标数据和幻觉。
合并互补的检查点。我们用 LoRA 进行微调,并通过 SLERP 合并三个模型:一个在公开数据上校准的检查点,一个借助生成数据加入细粒度策略辨别能力的检查点,以及基础指令模型。这次合并在单个模型中兼得通用策略校准与策略适应性,而基础模型的指令遵循能力也迁移到了审核任务上。
Forge。我们基于 Forge 端到端地构建了 Shieldstral。Forge 是我们用于训练、对齐和评估定制模型的平台。它在先进的分布式训练之上负责管理基础设施、数据与模型分片、指标和日志,让团队得以专注于数据,而数据才是决定安全模型质量的关键。
下一步
Shieldstral 是朝着让审核适应具体情境迈出的一步,而不是把所有产品都塞进同一套僵化的分类体系。我们将继续在多语言覆盖、长文档鲁棒性和更广泛的多模态安全方面推进,也期待看到社区在它之上构建出什么。
顺便说一句,我们正在招人!如果你想帮助让 AI 变得更好,请查看我们的 招聘页面。
Shieldstral
Apache 2.0
依据所提供的策略,对文本和图像进行安全分类。
文本到文本
图像到文本
阅读文档