
思考
摘要
遗留代码现代化颇具挑战,尤其是把复杂的 Fortran 77 系统迁移到现代 C++ 时。Mistral 成功迁移了一个物理计算密集的油藏模拟器的 4 万行代码:构建用于数值验证的一致性测试框架(parity harness),用 AI 智能体为代码库编写文档,并采用带有人工监督的结构化工作流,以确保代码质量高且可维护。主要经验包括:优先保证数值一致、迁移前先整理好文档,以及在智能体自主性与人工审查之间取得平衡。
遗留科学代码库历经数十年积累,一旦原作者离开,嵌在代码里的知识就很难恢复。此外,使用没有活跃开发者生态的语言,意味着错失在他人成果之上构建的机会。Mistral 帮助一家欧洲能源运营商把 4 万行 Fortran 77 迁移到 C++,这是一个物理计算密集的油藏模拟器,没有测试套件,也没有集中的文档。
超越代码翻译的遗留代码现代化。
把语法从一种语言翻译成另一种语言,基本上已是一个已解决的任务。让任何一个较新的模型把一段代码从某种并非完全冷门的语言翻译成另一种语言,大概几次迭代就能得到可接受的结果。然而,把整个系统从过程式语言迁移到面向对象的 C++,需要进行架构重构,这使任务变得并不简单。
顾名思义,Fortran 77 于 1977 年标准化,用它写的代码直接反映了当时的种种限制:没有模块、没有命名空间、没有结构化类型。状态保存在 COMMON 块中——在整个程序间共享的全局内存。变量按首字母隐式确定类型,因此拼错名字不会触发编译器报错,而是悄悄创建一个新变量。
举一个简单但有代表性的例子,看下面这个一阶泰勒展开的实现。输入和输出是 COMMON 块中的全局变量,而 IC 之所以是整数,仅仅因为它的名字以 I 到 N 之间的字母开头。变量名相当晦涩,因为长度被限制在 6 个字符以内。
   SUBROUTINE GASDEN
   INCLUDE 'common.h'
   DO 10 IC = 1, NCELL
10 RHOG(IC) = ROG(IV) + DROG(IV)*(P(IC)-PTAB(IV))
   END
在 C++ 中,我们可以利用显式类型,编写面向对象的代码,并返回一个值,而不是写入全局变量:
double gasDensity(const GasProperties& gas, double pressure) {
    size_t i = lookup(gas.pressure, pressure);
    return gas.density[i] + gas.slope[i] * (pressure - gas.pressure[i]);
}
分散的 COMMON 数组变成了单个 GasProperties 参数,网格循环也移到了调用方,因此没有逐行对应的关系可供核对,这正是验证迁移困难的原因。
这些结构上的差异,加上需要集成 PetSc 等现代科学计算框架,在迁移开始之前就引出了几个重要问题:
- 如何证明迁移后的代码库在数值上与遗留代码库一致
- 如何把迁移拆分成可管理的若干块
- 如何最好地利用自主智能体来加快这一过程
迁移遗留代码之前先构建一致性测试框架。
在放手让智能体工作之前,我们需要一种方法来证明两套代码库是一致的。这里的“一致”指输出在数值上相等——既包括最终结果,也包括客户的油藏工程师标记出的一组关键中间点。
我们添加了:
- 可导出 Fortran 代码库状态的子程序
- 用于把检查点加载到 C++ 中的测试框架
- Skill.md 文件,引导智能体正确使用它们
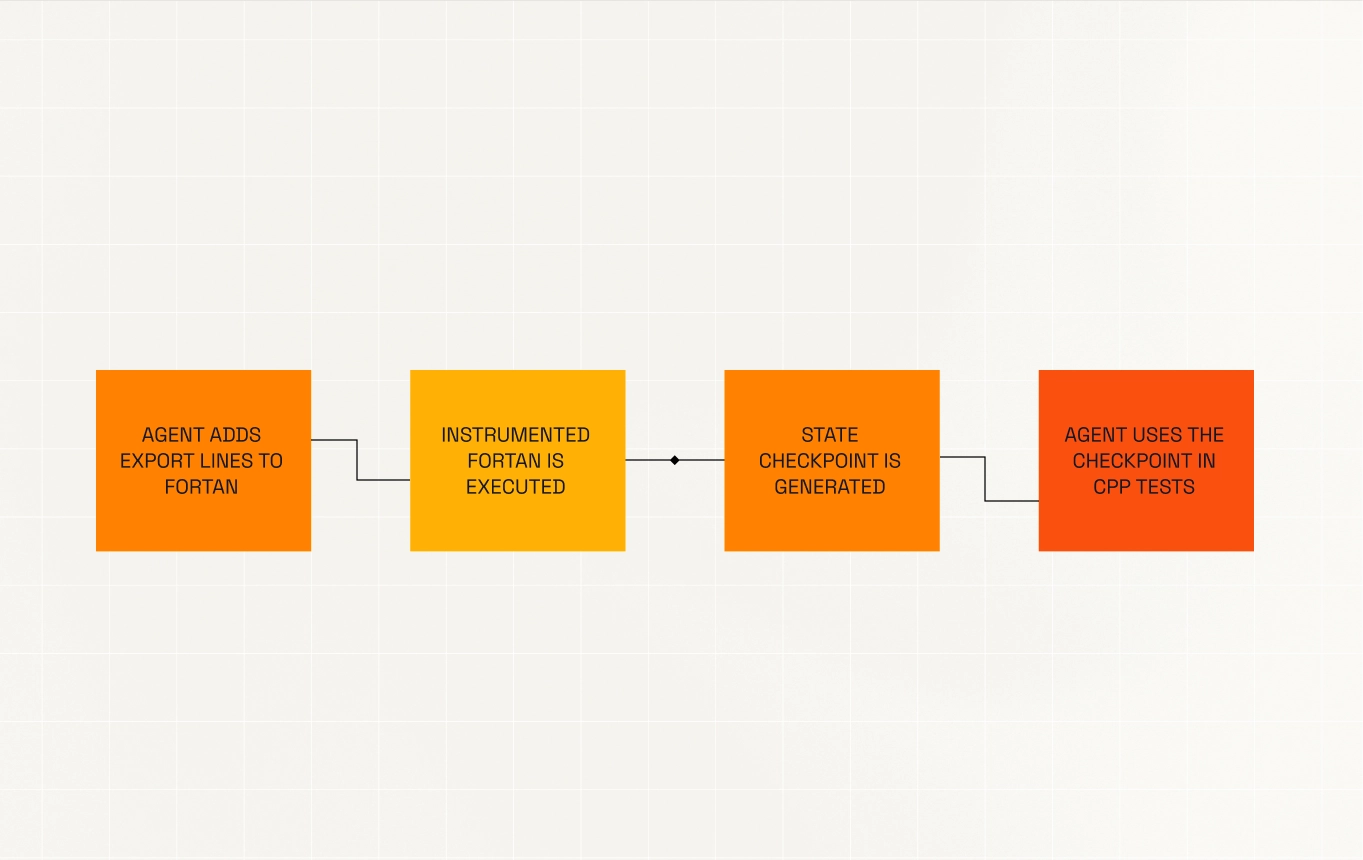
在迁移工作流中,智能体成功地对 Fortran 代码库插桩以转储状态快照,并使用 C++ 测试框架验证迁移后模块的正确性。
先构建这部分测试框架,对项目而言是一笔净收益的投资:它让长时间的智能体运行更安全,而数值一致也是一个易于验证、很有说服力的论据,足以证明一段代码已成功迁移。我们认为,这应该是任何代码现代化项目的首要步骤之一。
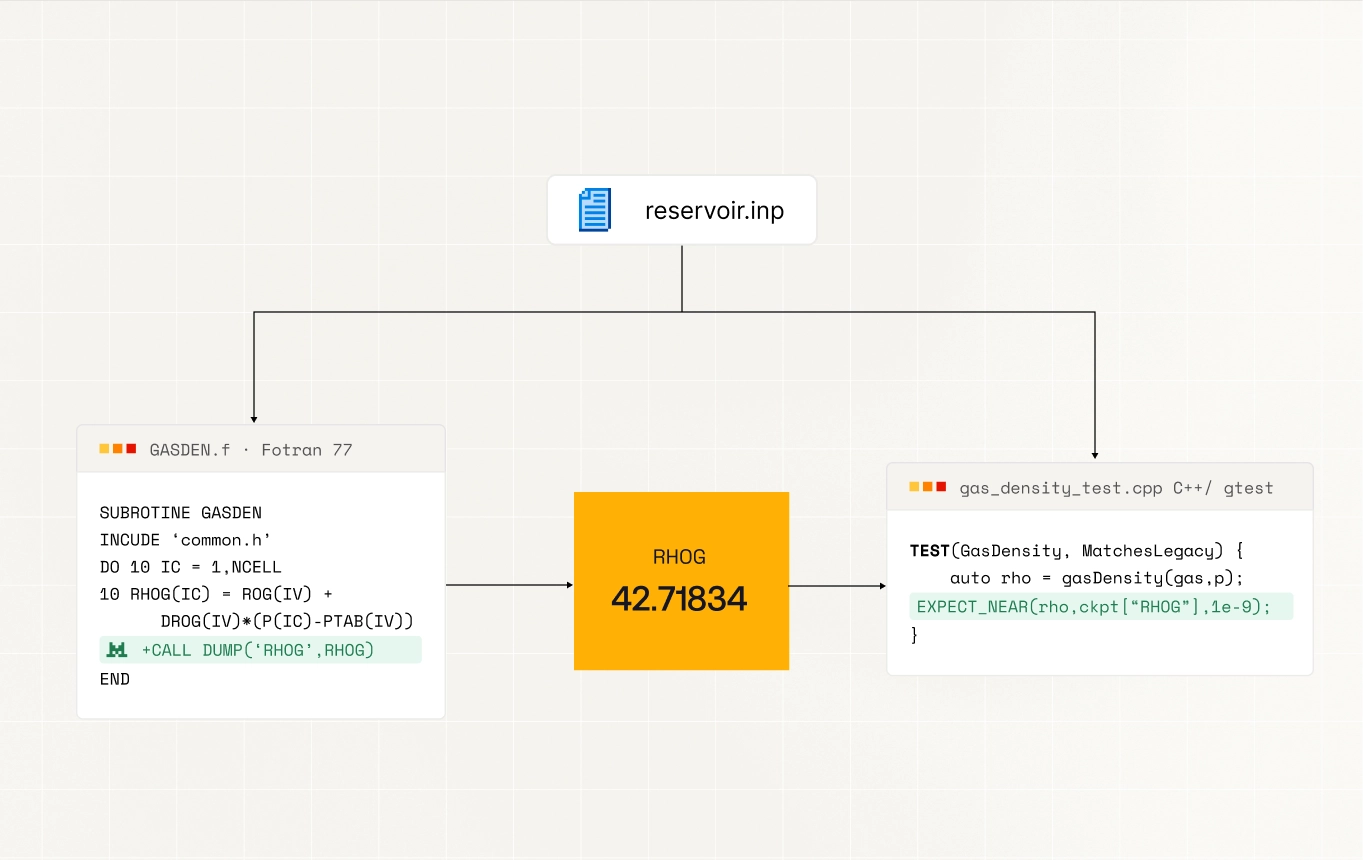
下面的例子说明了这一点。我们先在 Fortran 代码中插入一行,转储 RHOG 变量的值(本次运行中为 42.71834),然后在测试迁移后的 C++ 模块时,把同一个值用作参考检查点。
用 AI 智能体理解并记录遗留代码库。
项目的文档散落在旧的 PDF 以及埋在 Fortran 代码本身的注释里,而整个工作中最大的附带收获之一,就是把这些文档整合起来并移到代码旁边。
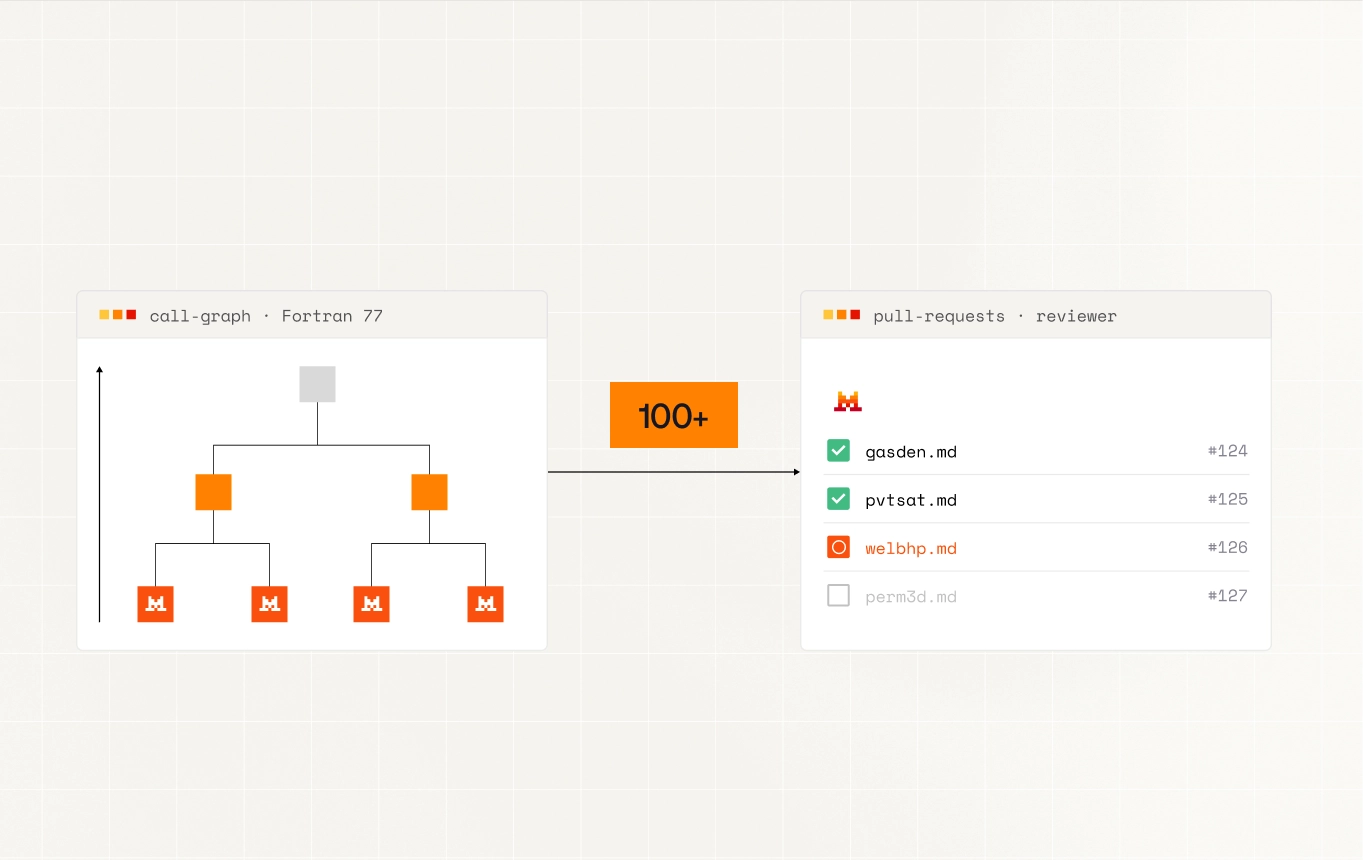
幸运的是,Fortran 这类过程式代码有一个方便的特性:整个程序可以画成一棵调用者-被调用者树。我们用自定义解析器解析代码库生成了这棵树,然后用 Vibe CLI 派生出上百个智能体为其编写文档。每个智能体都可以通过文档库和 Mistral OCR 引入相关的 PDF。
从树的叶子节点开始、逐层向上,每个节点都会派生一个子智能体为其编写文档,并向原仓库提交 PR。一个按 cron 计划循环运行的审查智能体会查找新开的 PR,对其进行审查,并在必要时安排修复任务。
利用 AI 智能体实现代码现代化。
第一次尝试时,我们给了智能体完全的自主权:每个 Fortran 子程序对应一个智能体,各自独立地用一周时间把自己的函数翻译成 C++。结果是可以运行的,但算不上代码现代化。COMMON 块被一一对应地变成了全局结构体。由 GOTO 驱动的控制流原样保留,没有被重构为循环或提前返回。它看起来像是用 C++ 语法重新敲了一遍的 Fortran,而不是现代化的代码。
第二次尝试中,我们的应对办法是给智能体提供结构,而不只是自主权:由规划者、编码者、测试者和代码质量审查者共同处理每个模块。代码质量相比第一次明显改善。但源代码的复杂度最终还是拖住了智能体。它们会遇到 bug,尝试几次修复后就停滞不前,却没有人能介入。
我们最终选择了折中方案:由一名人员操作由编码、测试和审查智能体组成的工作流,逐模块迁移代码库。这既保留了第二次尝试的代码质量,又增加了人工检查点,在智能体卡住时帮它们解困。下一节将详细介绍这一工作流。
为复杂的代码迁移运行结构化的 AI 智能体工作流。
在代码库有了文档、一致性测试框架也已就位之后,剩下有趣的部分,就是调整可以把多少自主权交给智能体,同时仍能产出可合并的代码。我们尝试了两个极端,从完全自主的运行到严密监督的手动会话。下面的结构化工作流,就是我们针对这一用例最终采用的方案。
我们与客户的油藏工程师合作,利用调用者-被调用者树来识别独立模块——规模可控的自包含子树(根据经验,少于约 10,000 行 Fortran)。每个模块都经过同一套工作流:
- 生成目标 C++ 架构。
- 与油藏工程师一起审查。
- 获批后,将其拆分为任务队列。
- 为每个任务运行一个实现子工作流:规划 → 实现 → 测试 → 重复。
- 由人工审查生成的 PR,并提出修改意见,直到合并。
认清 AI 辅助遗留代码现代化的局限。
第一个冲刺涵盖了核心功能:30 万行中的 4 万行。这个 Fortran 代码库是自包含且可运行的,这是一个有利的起始条件。如果迁移依赖外部系统、缺乏可运行的基线,或者其中编码的物理知识没有任何文档记载,则会带来本文未讨论的额外挑战。
应用三条原则来现代化复杂的遗留系统。
这个项目的三条经验应当适用于任何大型遗留代码迁移。
- 在编写迁移代码之前先构建一致性测试框架——数值一致是证明一个模块已完成的最廉价、最有说服力的方式。
- 在依赖智能体之前先把文档理顺,因为没人能读懂的代码是无法迁移的。
- 而在这个规模上,带有人工审查关卡的结构化工作流,胜过完全自主和人工手动驱动的会话。
我们在招聘!
Mistral 的应用 AI 团队由一群工程师组成,围绕 Mistral 模型和企业平台构建全栈解决方案。我们交付高风险、面向特定领域的解决方案,以解决世界上一些最棘手的问题。
如果你想参与这类工作,请申请加入我们的团队。