自 2024 年 TimesFM 问世以来,我们看到时间序列基础模型已被用于多个领域的真实时间序列预测任务,例如零售、金融、可观测性、制造、医疗健康和自然科学。
在 TimesFM-2.5(2025 年 9 月发布)之前,我们的模型严格局限于单变量预测,即只使用单个时间序列的历史进行预测。然而,现实中的大多数预测问题本质上都是多变量的:多个时间序列和外部辅助特征会共同影响某个时间序列的未来预测。以预测一家连锁零售商的冰淇淋销量为例,仅凭过去的销量很难说明全部情况。一个好的预测还应该参考相关产品(如蛋筒、糖浆)的销量、历史客流量,以及天气预报、促销和节假日等已知的未来事件。
今天,我们推出 TimesFM-3,这是我们时间序列基础模型的下一代,原生针对多变量预测进行了预训练。TimesFM-3 拥有 3.3 亿参数,在包含超过 1 万亿个时间点的真实与合成时间序列语料上完成预训练。在继承前代模型的高效率和零样本泛化能力的基础上,TimesFM-3 以零样本方式增加了对复杂多变量场景的稳健支持。它可以联合预测多个共同演化的时间序列,捕捉其中的依赖关系,从而提高整体准确率,而无需针对具体任务进行微调。该模型原生支持:
- 多目标:同时预测多个相关的时间序列(例如联合预测不同品牌的冰淇淋)。模型对所有目标都支持点预测和分位数预测。
- 过去协变量:引入只有历史数据可知的特征(例如过去的客流量)。
- 过去-未来(动态)协变量:利用已知的未来事件来指导预测(例如计划中的促销活动或天气预报)。
幕后原理:架构与推理
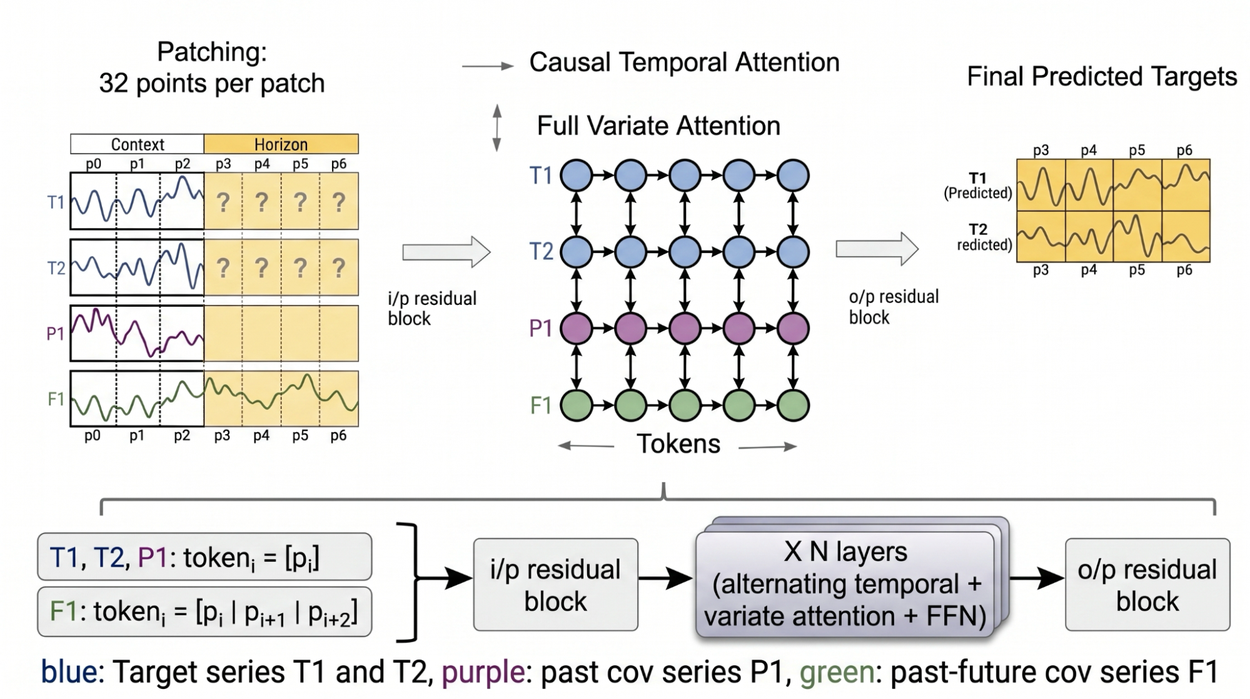
TimesFM-3 建立在前代模型久经验证的仅解码器(decoder-only)Transformer 架构之上。与之前的版本一样,我们把连续的数据点按 32 个时间步分组为 patch,以此高效处理时间序列。然后,我们对每个时间序列做归一化,方法类似 TimesFM-2.5 的做法,以应对尺度差异极大的时间序列。
多变量 token 的构建
对于目标序列和过去协变量序列,token 直接由单个 patch 构成。而对于过去-未来协变量,TimesFM-3 采用了一种巧妙的“前瞻”策略:每个 token 把当前 patch 与未来的 patch 拼接在一起,使模型能够提前看到即将到来的已知信号。
交替注意力架构
patch 完成词元化后,会经过一个输入残差块,进入主 Transformer 堆栈,该堆栈以二维网格的方式运行:
- 因果时间注意力:token 沿时间方向横向进行注意力计算。为防止数据泄漏,这种注意力是严格因果的:token 只能查看其自身所属时间序列中过去的 token。
- 全变量注意力:token 在序列之间纵向进行注意力计算。在任一时间步,token 都可以查看数据集中所有其他时间序列,使模型能够学习复杂的跨序列相关性(例如,一个序列中的促销如何影响另一个序列的销量)。
这两种注意力机制在若干层中交替进行,把时间模式与跨序列关系无缝融合。
非自回归解码:一次前向传播完成预测
之前版本的 TimesFM 每次生成一个 patch 的预测,带来了延迟、误差累积加剧和计算成本。TimesFM-3 采用连续 Patch 掩码(Contiguous Patch Masking)策略,在一次前向传播中生成整个预测范围。模型在已观测的上下文之后,为未来预测范围追加被掩码的占位 token。目标序列和过去协变量序列在预测范围内被掩码(因为它们的未来值未知),而过去-未来协变量则保持可见,从而向模型提供节假日或计划事件等已知的未来信号。通过交替注意力层,模型同时填充所有被掩码的预测范围 patch,无需迭代循环。模型会针对每个目标时间序列,在每个预测步给出 9 个分位数(从第 10 到第 90 百分位),提供对预测不确定性的完整概率视角。
Illustrative example for multivariate forecasting
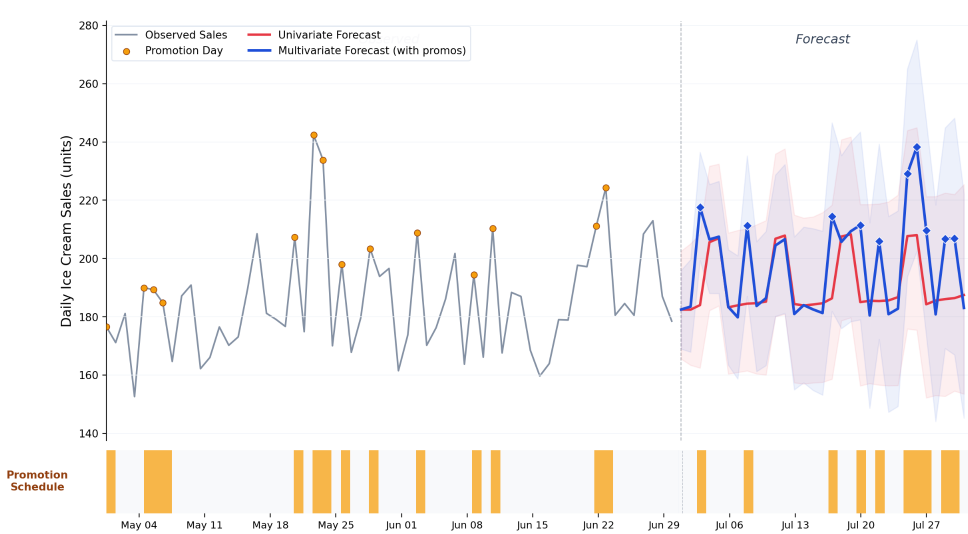
我们回到冰淇淋销量的例子。假设你正在制定下个月的促销计划,希望预测销量以便提前应对。标准的单变量模型(下图红线)会查看历史销量并向前延伸每周的规律,但它并不知道特定日期有计划中的促销。TimesFM-3 的多变量模式(下图蓝线)则采取不同的做法:通过把计划的促销安排作为过去-未来协变量传入,模型从历史上下文中学习促销与销量提升之间的关系,再把这一知识应用到有计划促销的未来日期上。结果是,预测会预见每个促销日约 20% 的销量增长。在下图中,促销协变量里的琥珀色方块标出了有促销的日子,蓝色预测对每一个促销日都有明显反应,而红色预测则没有。放眼整个月,这累积成对预期收入更准确的预测。
评估与基准测试
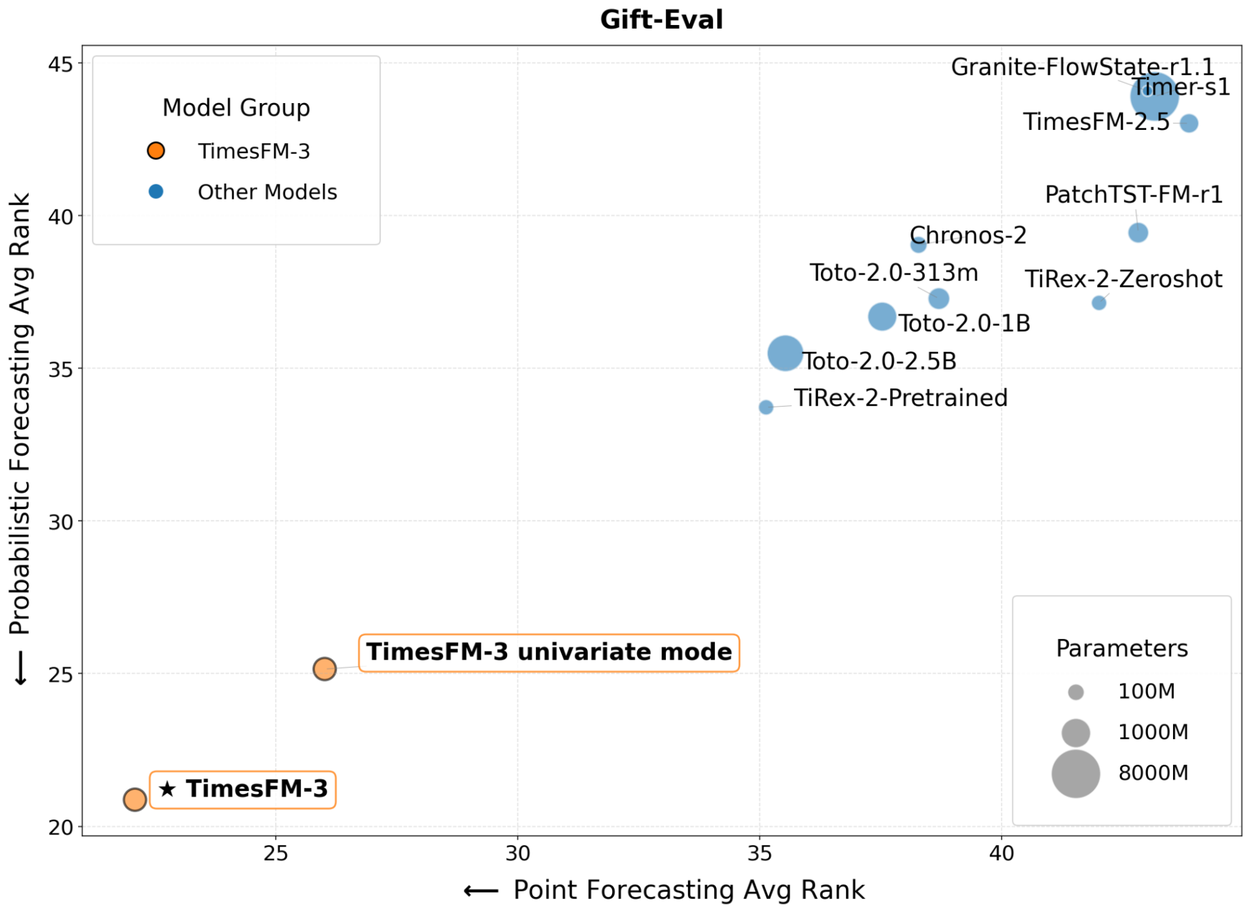
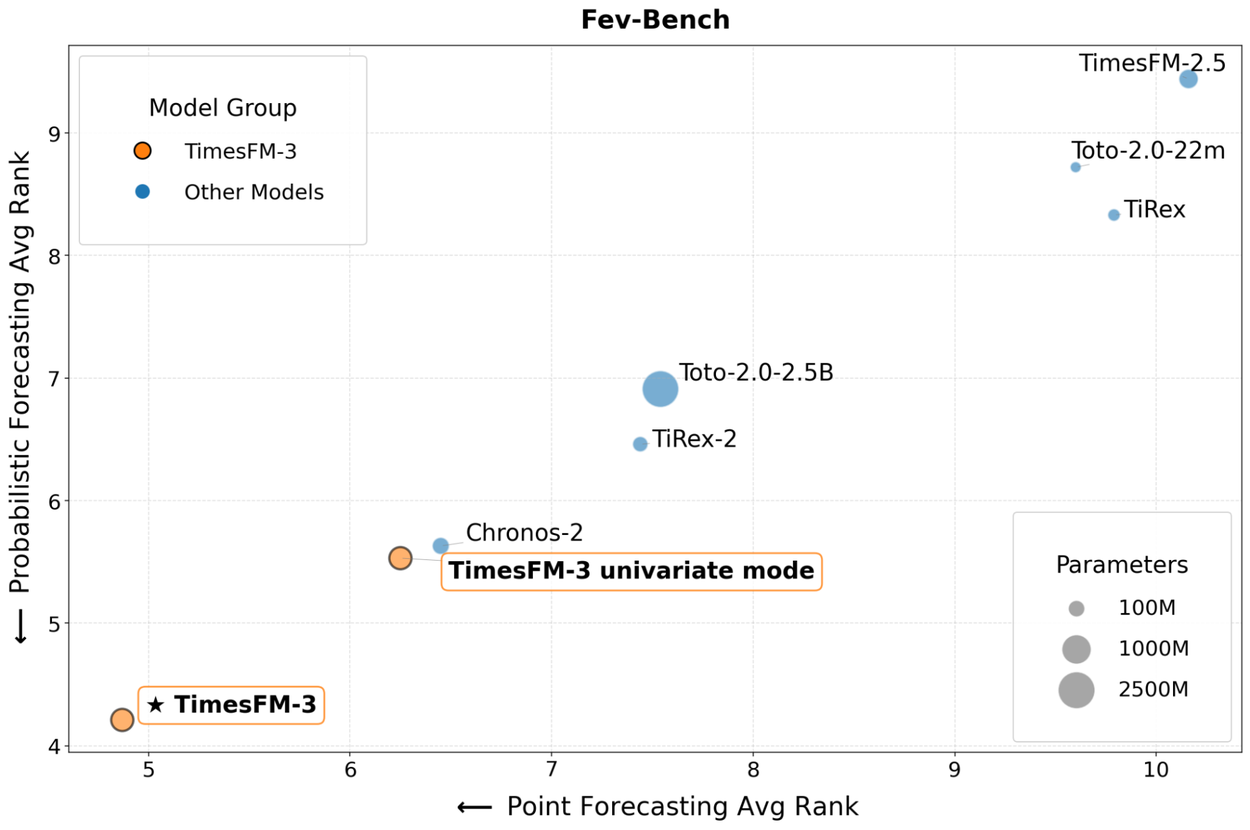
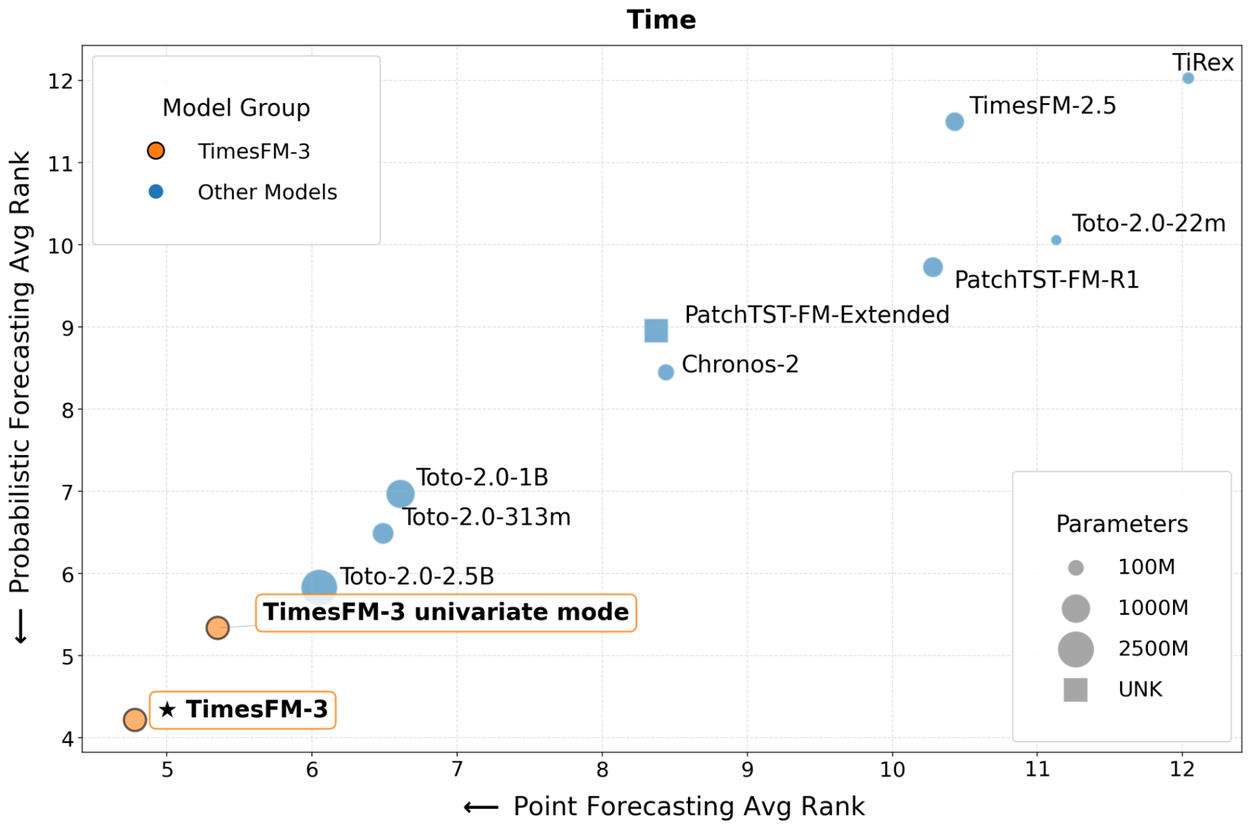
我们在三个全面的公开预测基准测试上评估了 TimesFM-3:Gift-Eval、FEV-Bench 和 Time。在这三个基准测试上,就点预测和概率预测指标而言,TimesFM-3 在所有预训练基础模型中都排名第一。下图展示了三个基准测试中,各任务上点预测准确度和概率预测质量的平均排名(越低越好)。我们对比了近期的基础模型,包括具备多变量能力的模型,如 Chronos-2 和 Toto 2.0 系列,以及我们之前的模型 TimesFM-2.5。
每张图中 TimesFM-3 都有两个条目。“单变量模式”一项展示的是在不使用任何协变量或跨序列信息的情况下评估模型的表现,即像传统单变量模型一样独立处理每个目标序列。即便在这种单变量模式下,TimesFM-3 也已经追平或超越其他竞争模型。切换到完整的多变量模式后,TimesFM-3 又向前跨出一大步,在点预测和概率预测上都取得了全面最佳的平均排名。
结论
我们推出了 TimesFM-3,这是 TimesFM 零样本时间序列基础模型家族的最新一代,在多个公开基准测试上取得了最先进的多变量和单变量预测性能。TimesFM-3 现已在 GitHub 和 Hugging Face 上提供,并已直接集成到 BigQuery 中。你可以在 BigQuery 中使用 AI.FORECAST 命令,立即在多变量和单变量任务上试用 TimesFM 3.0,无需机器学习专业知识。
致谢
该项目由 Yichen Zhou、Petros Mol、Abhimanyu Das 和 Samet Oymak 共同完成。