随着开发者在 Cloudflare 上构建越来越复杂的智能体,他们面临的最大挑战之一,就是在恰当的时机把恰当的信息放进上下文。模型产出结果的质量,直接取决于它所依据的上下文质量;但即便上下文窗口已增长到超过一百万(1M)token,上下文腐化(context rot)依然是个悬而未决的问题。于是出现了一种天然的两难:要么把所有内容都留在上下文里,眼看质量下滑;要么激进地裁剪,冒着丢掉智能体日后所需信息的风险。
今天,我们宣布 Agent Memory 进入私有测试阶段。这是一项托管服务,能从智能体的对话中提取信息,并在需要时提供出来,而不会占满上下文窗口。
它为 AI 智能体提供持久记忆,让智能体记住重要的事、忘掉不重要的事,并随时间变得更聪明。本文将介绍它的工作原理,以及它能帮你构建什么。
智能体记忆的现状
智能体记忆是 AI 基础设施中变化最快的领域之一,新的开源库、托管服务和研究原型几乎每周都在涌现。这些方案在存储什么、如何检索、面向哪类智能体上差异很大。LongMemEval、LoCoMo 和 BEAM 等基准测试提供了有用的同口径对比,但也让人很容易做出过拟合特定评测、一到生产环境就失灵的系统。
现有方案在架构上也各不相同。有些是在后台处理提取和检索的托管服务,有些是需要你自己运行记忆流水线的自托管框架。有些提供受限的、专用的 API,让记忆逻辑不进入智能体的主上下文;另一些则让模型直接访问数据库或文件系统,由它自己设计查询,结果把 token 花在存储和检索策略上,而不是真正的任务上。有些方案试图把一切都塞进上下文窗口,必要时还会拆分给多个智能体;另一些则靠检索只呈现相关内容。
Agent Memory 是一项托管服务,采用有明确设计取向的 API 和基于检索的架构。我们仔细考量过各种替代方案,认为这一组合是大多数生产负载的合理默认选择。更紧凑的摄取与检索流水线,优于让智能体直接访问原始文件系统。除了成本和性能更好之外,它还为生产中所需的复杂推理任务提供了更好的基础,例如时间逻辑、取代(supersession)和指令遵循。我们日后很可能会开放数据供程序化查询,但预计那只对边缘场景有用,而不是常见场景。
我们打造 Agent Memory,是因为在我们平台上看到的工作负载暴露出了现有方法没能完全解决的缺口。针对真实代码库和生产系统连续运行数周甚至数月的智能体,需要的是随规模增长仍然有用的记忆,而不只是在干净的基准数据集上表现良好的记忆,那样的数据集可能整个就能塞进较新模型的上下文窗口。
它们需要快速摄取,需要不会阻塞对话的检索,还需要运行在能把单次查询成本控制在合理范围的模型上。
如何使用
Agent Memory 把记忆存放在按名称寻址的 profile(档案)中。一个 profile 提供若干操作:摄取(ingest)一段对话、记住(remember)某件具体的事、召回(recall)所需内容、列出(list)记忆,或遗忘(forget)某条特定记忆。Ingest 是批量路径,通常在 harness 压缩上下文时调用。Remember 供模型当场存下重要的事。Recall 会运行完整的检索流水线,并返回一个综合后的答案。
export default {
  async fetch(request: Request, env: Env): Promise<Response> {
    // Get a profile -- an isolated memory store shared across sessions, agents, and users
    const profile = await env.MEMORY.getProfile("my-project");
    // Ingest -- extract memories from a conversation (typically called at compaction)
    await profile.ingest([
      { role: "user", content: "Set up the project with React and TypeScript." },
      { role: "assistant", content: "Done. Scaffolded a React + TS project targeting Workers." },
      { role: "user", content: "Use pnpm, not npm. And dark mode by default." },
      { role: "assistant", content: "Got it -- pnpm and dark mode as default." },
    ], { sessionId: "session-001" });
    // Remember -- store a single memory explicitly (direct tool use by the model)
    const memory = await profile.remember({
      content: "API rate limit was increased to 10,000 req/s per zone after the April 10 incident.",
      sessionId: "session-001",
    });
    // Recall -- retrieve memories and get a synthesized answer
    const results = await profile.recall("What package manager does the user prefer?");
    console.log(results.result); // "The user prefers pnpm over npm."
    return Response.json({ ok: true });
  },
};
任何 Cloudflare Worker 都可以通过绑定(binding)访问 Agent Memory。在 Workers 之外运行的智能体也可以通过 REST API 访问,沿用 Cloudflare 开发者平台其他 API 的模式。如果你使用 Cloudflare Agents SDK 构建,Agent Memory 服务可以作为参考实现无缝集成,负责 Sessions API 中记忆部分的压缩、记住和记忆搜索。
你可以用它构建什么
Agent Memory 的设计目标是适用于多种智能体架构:
单个智能体的记忆。无论你是在用 Claude Code 或 OpenCode 这类有人参与的编码智能体,用 OpenClaw 或 Hermes 这类自托管智能体框架替你办事,还是接入 Anthropic 的 Managed Agents 这类托管服务,Agent Memory 都可以作为持久记忆层,而无需改动智能体的核心循环。
自定义智能体 harness 的记忆。许多团队在构建自己的智能体基础设施,包括无需人参与、自主运行的后台智能体。Ramp Inspect 就是一个公开的例子;Stripe 和 Spotify 也描述过类似系统。这些 harness 同样可以受益于跨会话保留、重启后仍然存在的记忆。
智能体、人和工具之间的共享记忆。一个记忆 profile 不必只属于某一个智能体。一个工程师团队可以共享同一个记忆 profile,这样某个人的编码智能体学到的知识,所有人都能用上:编码规范、架构决策,以及目前只存在于人们脑子里、或在上下文被裁剪时丢失的“部落知识”。代码审查机器人和编码智能体也可以共享记忆,让审查反馈影响之后的代码生成。你的智能体积累的知识不再是转瞬即逝的,而是成为团队的持久资产。
虽然搜索是记忆的组成部分,但智能体搜索和智能体记忆解决的是不同的问题。AI Search 是我们用于在非结构化和结构化文件中查找结果的基础组件;Agent Memory 则用于上下文召回。Agent Memory 中的数据并不以文件形式存在,而是从会话中派生出来的。智能体可以同时使用两者,它们在设计上就是协同工作的。
你的记忆属于你
随着智能体能力越来越强、越来越深地嵌入业务流程,它们积累的记忆变得真正有价值,不只是作为运行状态,更是需要实打实投入才能建立的组织知识。越来越多客户向我们表达了担忧:把这份资产绑定在单一供应商身上意味着什么?这种担忧是合理的。智能体学到的越多,如果记忆无法随之迁移,切换成本就越高。
Agent Memory 是托管服务,但数据属于你。每一条记忆都可导出,我们承诺,如果你的需求发生变化,你的智能体在 Cloudflare 上积累的知识可以随你带走。我们认为,赢得长期信任的正确方式,是让离开变得容易,同时持续把产品做得足够好,好到你不想离开。
Agent Memory 如何工作
要理解上面所示 API 背后发生了什么,不妨先拆解智能体是如何管理上下文的。一个智能体由三个部分组成:
- harness:驱动对模型的反复调用、协调工具调用并管理状态。
- 模型:接收上下文并返回补全结果。
- 状态:既包括当前的上下文窗口,也包括上下文之外的附加信息:对话历史、文件、数据库、记忆。
智能体上下文生命周期中的关键时刻是压缩(compaction),即 harness 决定缩短上下文,以便控制在模型的限制之内,或避免上下文腐化。如今大多数智能体会把信息永久丢弃。Agent Memory 则在压缩时保留知识,而不是丢掉它。
Agent Memory 以两种方式融入这一生命周期:
- 压缩时的批量摄取。harness 压缩上下文时,会把对话送入 Agent Memory 进行摄取。摄取过程从消息历史中提取事实、事件、指令和任务,与已有记忆去重,并将其存为记忆以供日后检索。
- 模型直接调用工具。模型获得可直接操作记忆的工具,包括召回(recall,在记忆中搜索特定信息)。模型还可以记住(remember,针对重要内容显式存储记忆)、遗忘(forget,把某条记忆标记为不再重要或不再正确)以及列出(list,查看已存储的记忆)。这些都是轻量操作,无需模型设计查询或管理存储。主智能体绝不应把上下文耗费在存储策略上。它所看到的工具接口是刻意收窄的,以便让记忆不妨碍真正的任务。
摄取流水线
当一段对话进入摄取环节时,它会经过一条多阶段流水线,依次完成提取、验证、分类和存储记忆。
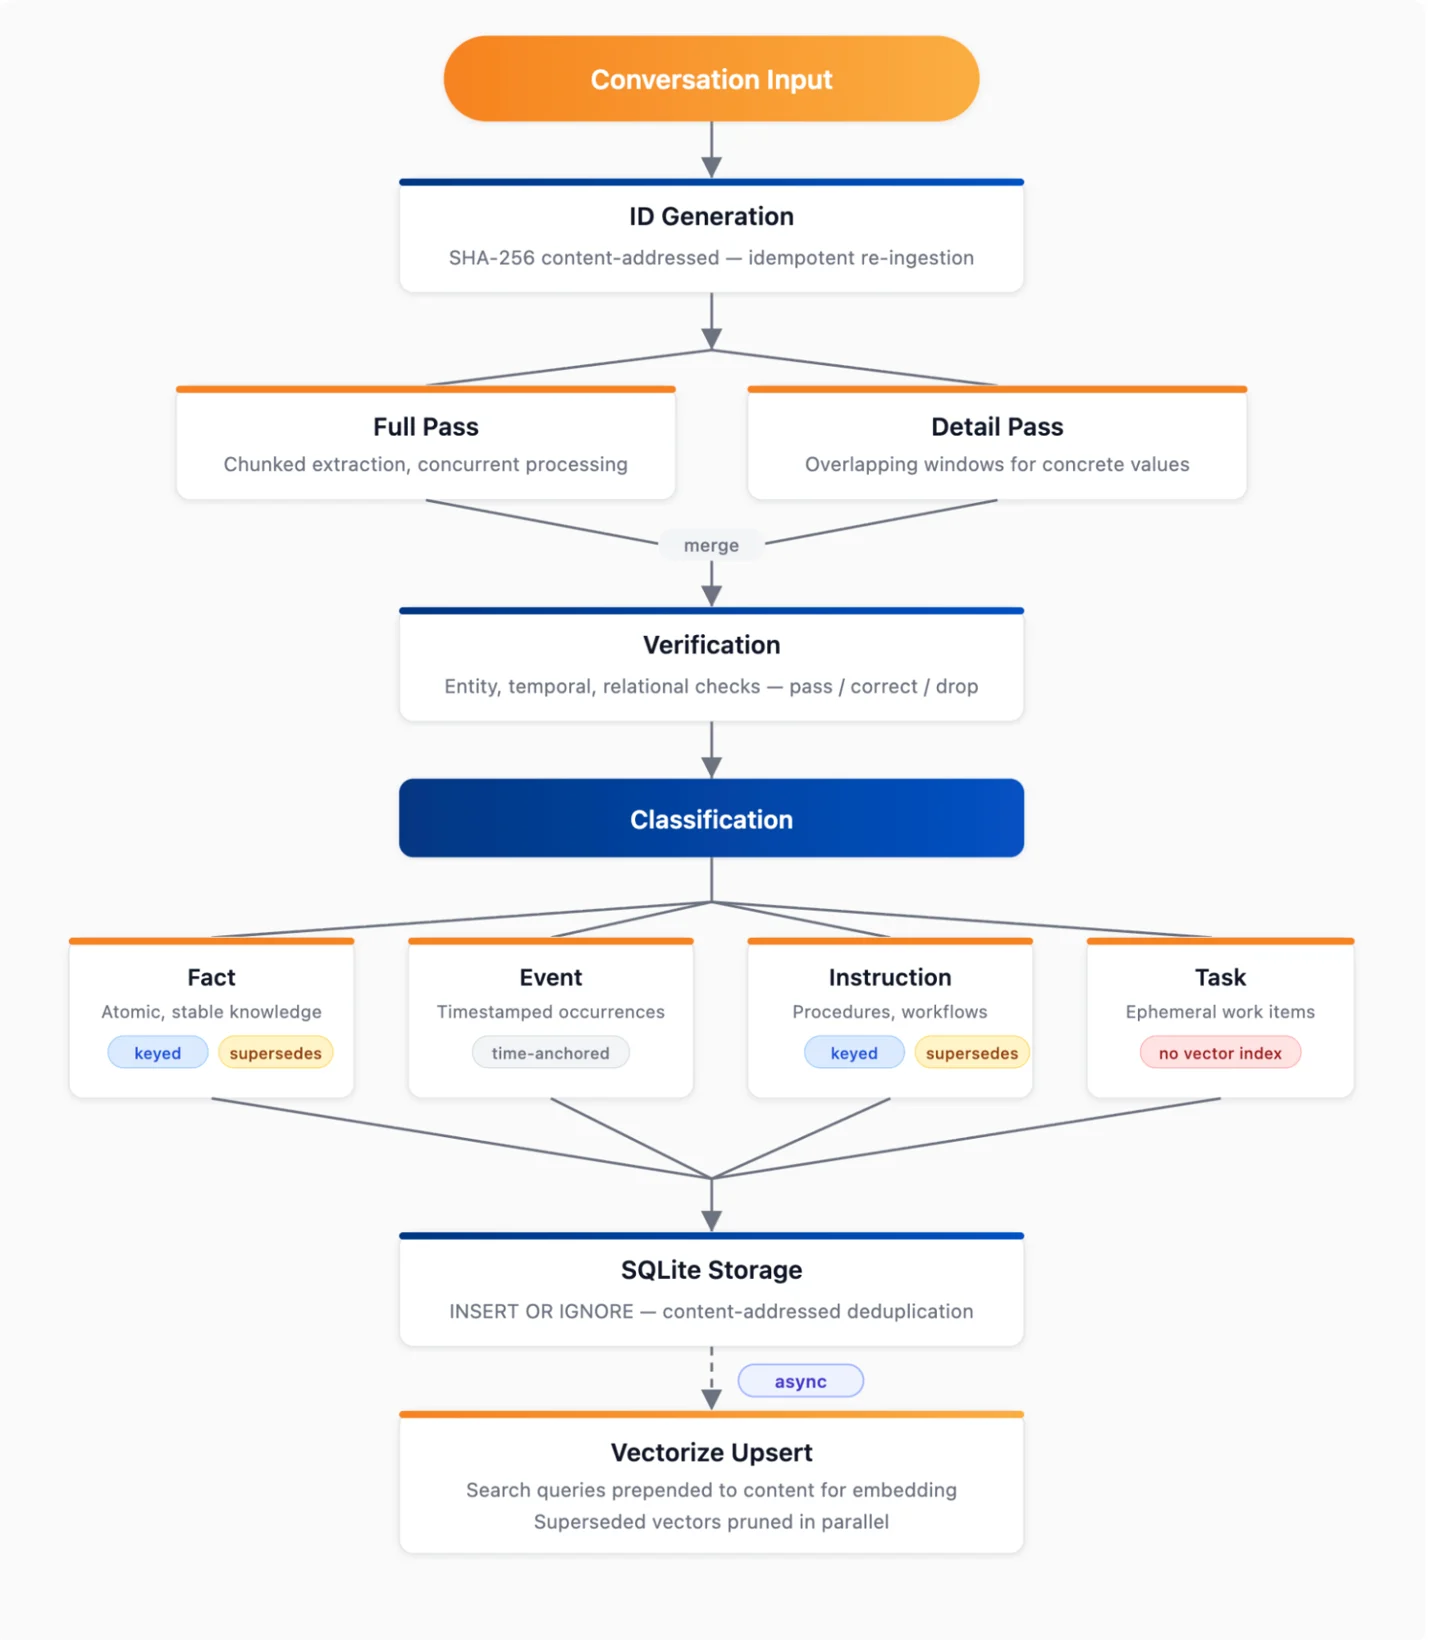
第一步是确定性的 ID 生成。每条消息都会得到一个内容寻址的 ID,即对会话 ID、角色和内容做 SHA-256 哈希后截断到 128 位。如果同一段对话被摄取两次,每条消息都会解析出相同的 ID,因此重复摄取是幂等的。
接下来,提取器并行运行两轮处理。完整轮(full pass)按约 10K 字符对消息分块,相邻块有两条消息的重叠,并最多同时处理四个块。每个块会得到一份结构化转录,带有角色标签、被解析为绝对日期的相对日期(“昨天”变成“2026-04-14”),以及用于追溯来源的行索引。对于较长的对话(9 条及以上消息),完整轮之外还会并行运行一轮细节轮(detail pass),使用重叠窗口,专门提取具体取值,如名称、价格、版本号和实体属性,这些是宽泛提取容易漏掉的。随后将两组结果合并。
下一步是对照源转录验证每条提取出的记忆。验证器运行八项检查,涵盖实体身份、对象身份、地点语境、时间准确性、组织语境、完整性、关系语境,以及推断出的事实是否确实有对话支持。每一项会据此被通过、修正或丢弃。
随后,流水线把每条通过验证的记忆归入四种类型之一。
- 事实(Facts)表示当下为真的、原子化的稳定知识,例如“该项目使用 GraphQL”或“用户偏好深色模式”。
- 事件(Events)记录在特定时间发生的事,例如一次部署或一个决定。
- 指令(Instructions)描述如何做某件事,例如流程、工作流和运行手册。
- 任务(Tasks)跟踪当前正在进行的工作,按设计是临时性的。
事实和指令是带键的(keyed)。每条记忆会得到一个规范化的主题键,当新记忆与已有记忆的键相同时,旧记忆会被取代(superseded)而不是被删除。这样就形成了一条版本链,由旧记忆指向新记忆的前向指针串起来。任务被完全排除在向量索引之外以保持索引精简,但仍可通过全文搜索找到。
最后,所有内容都用 INSERT OR IGNORE 写入存储,使内容寻址的重复项被静默跳过。在向 harness 返回响应之后,后台向量化异步运行。嵌入文本会把分类阶段生成的 3 到 5 条搜索查询前置到记忆内容本身之前,以弥合记忆的写法(陈述式:“用户偏好深色模式”)与搜索的方式(疑问式:“用户想要什么主题?”)之间的差距。被取代记忆的向量会与新向量的 upsert 并行删除。
检索流水线
当智能体搜索记忆时,查询会经过一条独立的检索流水线。开发期间我们发现,没有哪一种检索方法对所有查询都最优,因此我们并行运行多种方法并融合结果。
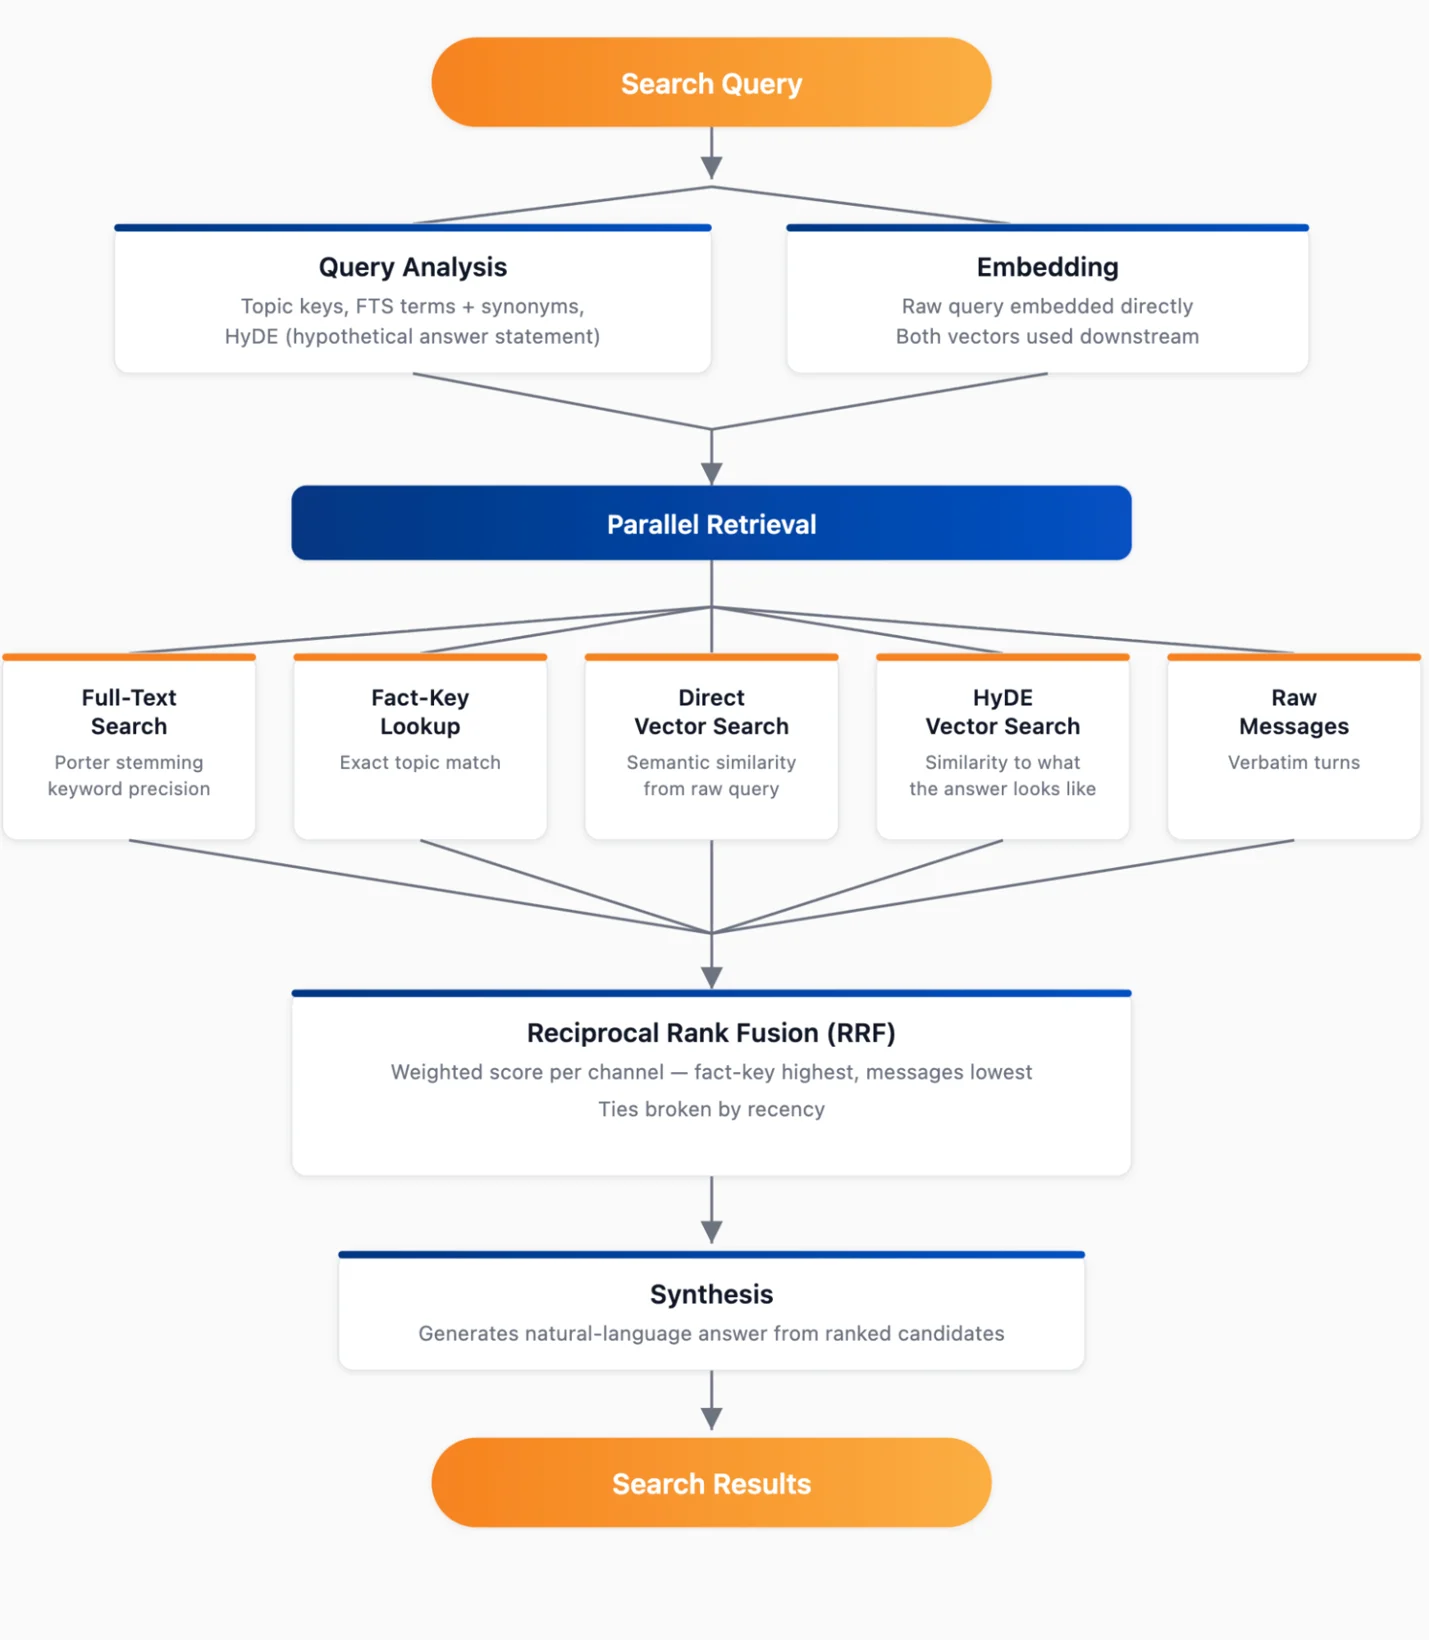
第一阶段并发运行查询分析和嵌入。查询分析器会产出按排名排列的主题键、带同义词的全文搜索词,以及一个 HyDE(Hypothetical Document Embedding,假设文档嵌入),也就是一句陈述句,其措辞仿佛就是问题的答案。这一阶段还会直接对原始查询做嵌入,两种嵌入都会在下游使用。
下一阶段并行运行五个检索通道。带 Porter 词干提取的全文搜索负责关键词精确度,适用于你知道确切词语但不知道上下文的查询。精确的事实键查找,在查询直接对应某个已知主题键时返回结果。原始消息搜索通过全文搜索直接查询存储的对话消息,查找未分类的对话片段,作为兜底,捕捉提取流水线可能已概括掉的原话细节。直接向量搜索使用嵌入后的查询来查找语义相似的记忆。HyDE 向量搜索则查找与答案的样子相似的记忆,这常常能找出直接嵌入漏掉的结果,尤其适用于问题和答案用词不同的抽象或多跳查询。
在第三个也是最后一个阶段,五个检索通道的结果用倒数排名融合(Reciprocal Rank Fusion,RRF)合并,每条结果根据它在某个通道内的排名获得一个加权分数。事实键匹配的权重最高,因为精确的主题匹配是最强的信号。全文搜索、HyDE 向量和直接向量各自按信号强度加权。最后,原始消息匹配也以较低权重纳入,作为兜底,用来识别提取流水线可能漏掉的候选结果。并列时按新近程度决胜,较新的结果排名更靠前。
随后,流水线把排名靠前的候选交给综合模型,由它针对原始搜索查询生成自然语言答案。某些特定类型的查询会得到特殊处理。例如,时间计算通过正则表达式和算术以确定性方式完成,而不是交给 LLM。计算结果作为预先算好的事实注入综合提示词。模型在日期运算这类事情上并不可靠,所以我们不让它们去算。
我们如何构建它
Agent Memory 的最初原型很轻量,只有基础的提取流水线、向量存储和简单的检索。它足以演示概念,但还不够好,无法上线。
于是我们把它放进一个由智能体驱动的循环里迭代。循环大致是这样的:运行基准测试,分析差距在哪,提出解决方案,由人审查这些方案、挑选具有泛化性而非过拟合的策略,让智能体去修改,然后重复。
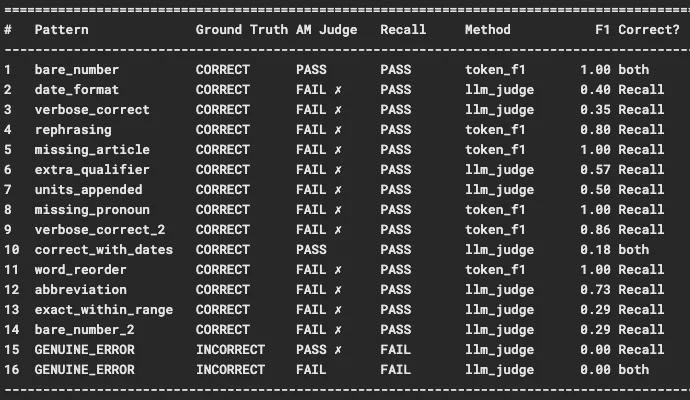
这种方式效果不错,但带来了一个特殊的挑战。LLM 是随机的,即使把 temperature 设为零也是如此。这使得各次运行的结果存在差异,意味着我们必须对多次运行取平均(对大型基准测试来说很耗时),并在原始分数之外借助趋势分析,才能弄清到底什么在起作用。一路上,我们还得小心防范对基准测试的过拟合,避免做出并没有真正让产品在通用场景下变好的改动。
久而久之,我们走到了这样一个阶段:每次迭代,基准分数都在稳定提升,并且有了一个能在真实世界中工作的通用化架构。我们有意针对多个基准测试(包括 LoCoMo、LongMemEval 和 BEAM)进行测试,以便从不同角度推动系统。
为什么选择 Cloudflare
我们在 Cloudflare 上构建 Cloudflare,Agent Memory 也不例外。现有的基础组件强大且易于组合,让我们得以在一个周末内交付第一个原型,并在不到一个月内做出功能完整、已投入生产的内部版 Agent Memory。除了交付速度之外,Cloudflare 还因其他几个原因成了构建这类服务的理想场所。
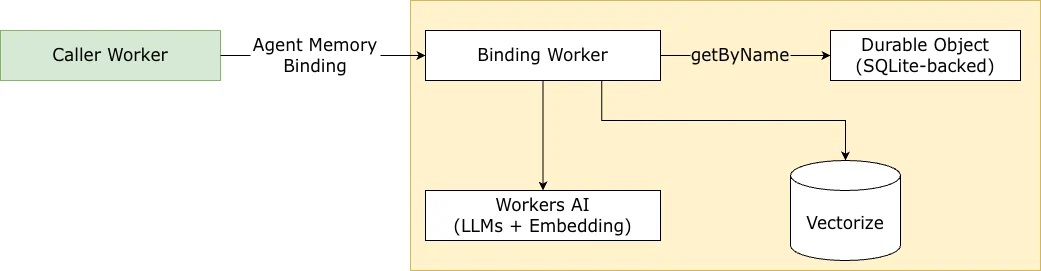
在底层,Agent Memory 是一个协调多个系统的 Cloudflare Worker:
- Durable Object:存储原始消息和已分类的记忆
- Vectorize:对嵌入后的记忆提供向量搜索
- Workers AI:运行 LLM 和嵌入模型
每个记忆上下文都映射到各自的 Durable Object 实例和 Vectorize 索引,使各上下文之间的数据完全隔离。这也让我们能轻松应对更高的需求。
通过 Durable Object 实现计算隔离。每个记忆 profile 都有自己的 Durable Object(DO),带有基于 SQLite 的存储,无需任何基础设施开销就能在租户之间提供强隔离。DO 负责 FTS 索引、取代链和事务性写入。DO 的 getByName() 寻址方式意味着来自任何地方的任何请求都能按名称找到正确的记忆 profile,并确保敏感记忆与其他租户严格隔离。
贯穿整个技术栈的存储。记忆内容存放在基于 SQLite 的 DO 中。向量存放在 Vectorize 中。未来,快照和导出内容将存入 R2,以实现经济高效的长期存储。每个基础组件都是为其负载专门打造的,我们不需要把一切都硬塞进单一形态或单一数据库。
借助 Workers AI 实现本地模型推理。整个提取、分类和综合流水线都运行在部署于 Cloudflare 网络上的 Workers AI 模型上。所有 AI 调用都带有指向记忆 profile 名称的会话亲和性(session affinity)请求头,因此重复请求会命中同一个后端,从而获得提示词缓存的好处。
模型选型中有一个有意思的发现:更大、更强的模型并不总是更好。我们目前默认用 Llama 4 Scout(17B,16 专家 MoE)负责提取、验证、分类和查询分析,用 Nemotron 3(120B MoE,12B 激活参数)负责综合。Scout 能高效处理结构化的分类任务,而 Nemotron 更大的推理能力则提升了自然语言答案的质量。综合器是唯一一个堆更多参数始终有帮助的阶段。对其他所有环节,较小的模型在成本、质量和延迟之间找到了更好的平衡点。
我们是如何使用它的
我们在 Cloudflare 内部的自身工作流中运行 Agent Memory,既把它当作试验场,也借此获得后续该构建什么的灵感。
编码智能体记忆。我们使用一个内部的 OpenCode 插件,把 Agent Memory 接入开发循环。Agent Memory 提供会话内和跨会话的历次压缩记忆。不那么显而易见的好处是团队间的共享记忆:有了共享 profile,智能体知道团队其他成员已经学到了什么,这意味着它可以不再问已经有答案的问题,也不再犯已经被纠正过的错误。
智能体代码审查。我们把 Agent Memory 接入了内部的智能体代码审查器。可以说,它学会的最有用的一件事是保持沉默。审查器现在会记得,某条评论在过去的审查中并不相关;某个特定模式曾被指出,而作者出于正当理由选择保留。审查随时间推移变得噪音更少,而不仅仅是更聪明。
聊天机器人。我们还把记忆接入了一个内部聊天机器人:它会摄取消息历史,然后潜水并记住之后发送的新消息。之后有人提问时,机器人就能依据之前的对话作答。
随着我们不断打磨和改进这项服务,我们还计划在不久的将来在内部推出更多用例。
接下来
我们将继续在内部测试和完善 Agent Memory,改进提取流水线、调优检索质量,并扩展后台处理能力。就像人脑在睡眠期间通过回放和强化连接来巩固记忆一样,我们看到记忆存储也有异步改进的空间,目前正在实现并测试多种策略来达成这一点。
我们计划不久后公开提供 Agent Memory。如果你正在 Cloudflare 上构建智能体并希望获得早期访问资格,请联系我们加入候补名单。
如果你想深入了解架构、分享你正在构建的东西,或关注我们后续的开发进展,欢迎加入 Cloudflare Discord,或在 Cloudflare Community 发起讨论。我们一直在关注这两处,也很想知道生产环境中的智能体负载实际是什么样子。