OpenAI 尽了最大努力:GPT-6 Sol 和 Luna 发布时价格比 GPT-5.6 低了 50%。但发布帖已有 1700 万次浏览且还在增长,今天注定属于 Claude Opus 5.5——“我们全新 Claude 5.5 系列的首个模型”,在大多数任务上表现“与 Claude Fable 5.1 相当,而运行成本比 Opus 5 低 40%”。
Opus 5.5 在大多数基准测试上超越 Fable,或对 Astra 构成挑战,两家实验室都把 API 降价归功于效率方面的工作,而且从 prefill 到 decode 再到整体算力,各处都有两位数的巨大提升……
……不过在某些前沿任务上,token 用量方面的低效抵消了其中一部分。
然而,Claude 这次发布中有一点难得被着重强调,那就是写作方面的改进:“它会把最重要的信息放在最前面,并遵循你给它的写作规则,让长会话更容易跟下来。”
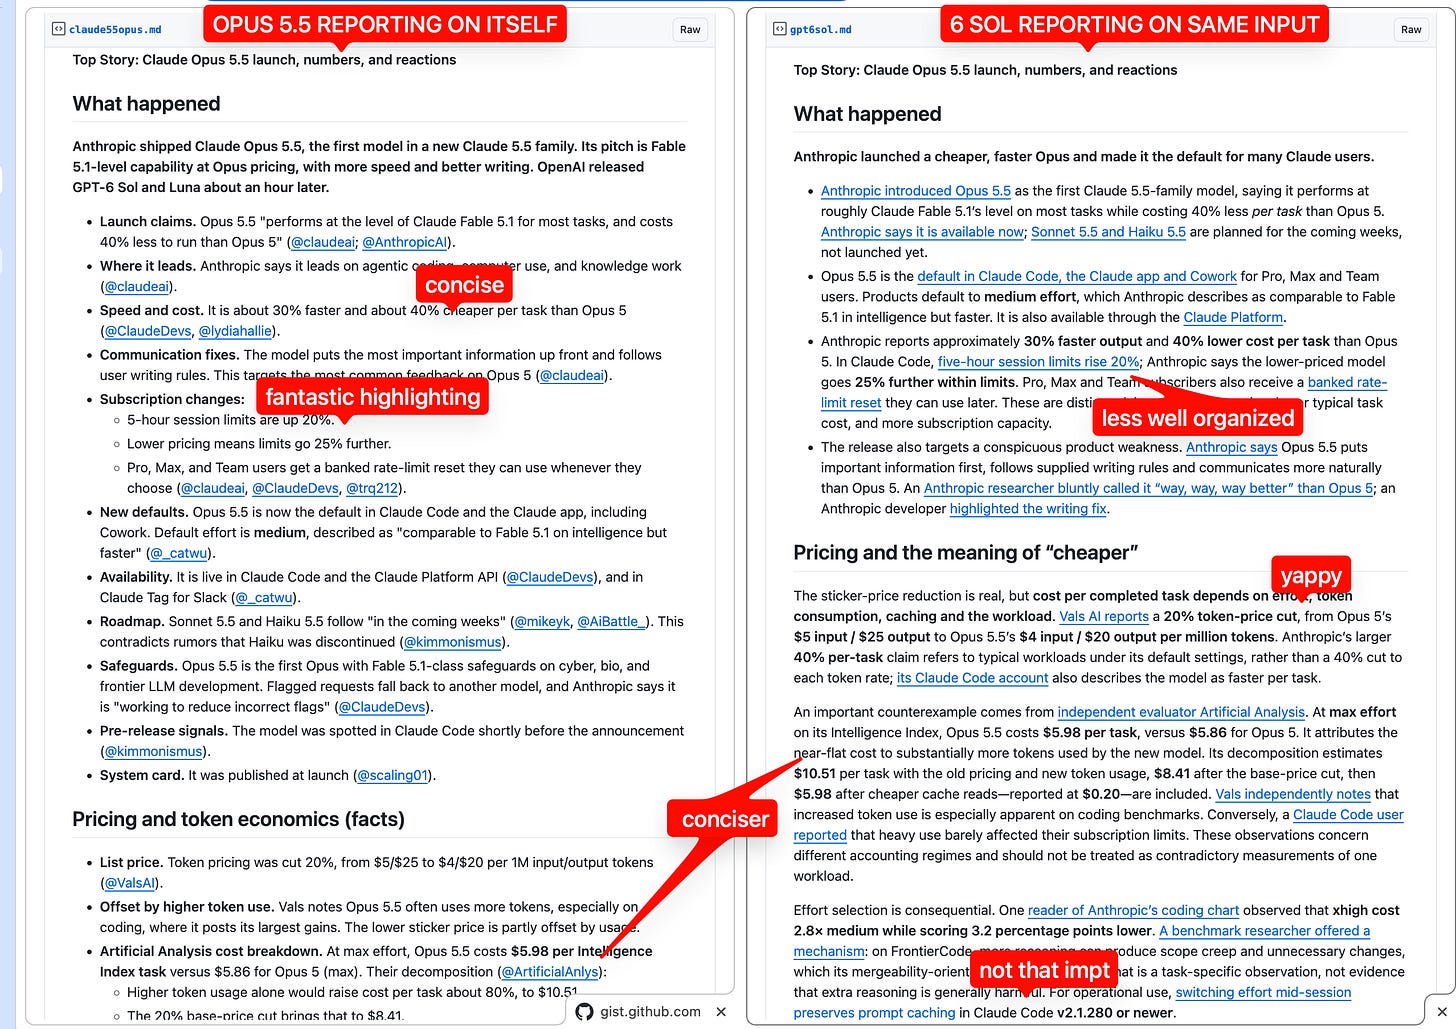
我们可以证实——这是今天的 AINews 栏目,由 Opus 5.5 和 Sol 6 生成。差别简直天壤之别——我们将立即把 AINews 迁移到 Opus 5.5,此后一直沿用,直到 AINews 的下一个模型/版本出现。
他们还发布了关于大规模多智能体集群(以及效率)的初步工作:
AI News,2026 年 9 月 21 日至 9 月 22 日。我们查看了 12 个 subreddit、544 个 Twitter 账号,没有再查看 Discord。AINews 网站可以搜索所有往期内容。提醒一下,AINews 现在是 Latent Space 的一个栏目。你可以订阅或退订不同频率的邮件!
AI Twitter 回顾
头条:Claude Opus 5.5 发布、数据与各方反应
发生了什么
Anthropic 发布了 Claude Opus 5.5,这是全新 Claude 5.5 系列的首个模型。它的卖点是以 Opus 的价格提供 Fable 5.1 级别的能力,同时速度更快、写作更好。大约一小时后,OpenAI 发布了 GPT‑6 Sol 和 Luna。
- 发布时的宣称。Opus 5.5“在大多数任务上表现与 Claude Fable 5.1 相当,而运行成本比 Opus 5 低 40%”(@claudeai;@AnthropicAI)。
- 领先之处。Anthropic 表示它在智能体编程、计算机使用和知识工作方面领先(@claudeai)。
- 速度与成本。与 Opus 5 相比,它快约 30%,每项任务的成本低约 40%(@ClaudeDevs、@lydiahallie)。
- 沟通方面的修正。该模型把最重要的信息放在最前面,并遵循用户的写作规则。这针对的是 Opus 5 收到的最常见反馈(@claudeai)。
- 订阅变更:
- 5 小时会话额度提高 20%。
- 价格更低意味着额度可多用 25%。
- Pro、Max 和 Team 用户会获得一次可随时使用的、已累积的速率限制重置机会(@claudeai、@ClaudeDevs、@trq212)。
- 新的默认设置。Opus 5.5 现已成为 Claude Code 和 Claude 应用(包括 Cowork)的默认模型。默认的推理强度(effort)为中等,被描述为“智能水平与 Fable 5.1 相当,但更快”(@_catwu)。
- 可用性。它已在 Claude Code 和 Claude Platform API(@ClaudeDevs)以及 Slack 版 Claude Tag(@_catwu)上线。
- 路线图。Sonnet 5.5 和 Haiku 5.5 将“在未来几周内”推出(@mikeyk、@AiBattle_)。这与 Haiku 已停产的传闻相矛盾(@kimmonismus)。
- 安全防护。Opus 5.5 是首个具备 Fable 5.1 级别安全防护的 Opus,覆盖网络安全、生物和前沿 LLM 开发领域。被标记的请求会回退到另一个模型,Anthropic 表示正在“努力减少错误标记”(@ClaudeDevs)。
- 发布前的迹象。在正式公布前不久,有人在 Claude Code 中发现了该模型(@kimmonismus)。
- System card。已在发布时同步公开(@scaling01)。
定价与 token 经济学(事实)
- 标价。token 价格下调 20%,从每百万输入/输出 token 5 美元/25 美元降至 4 美元/20 美元(@ValsAI)。
- 被更高的 token 用量抵消。Vals 指出,Opus 5.5 往往会用掉更多 token,在编程任务上尤其如此,而那恰恰是它提升最大的地方。较低的标价有一部分被用量抵消了。
- Artificial Analysis 的成本拆解。在最高推理强度下,Opus 5.5 每个 Intelligence Index 任务的成本为 5.98 美元,而 Opus 5(最高强度)为 5.86 美元。他们的拆解如下(@ArtificialAnlys):
- 仅 token 用量增加一项,就会使每项任务成本上升约 80%,达到 10.51 美元。
- 20% 的基础价格下调使其降至 8.41 美元。
- 更便宜的缓存读取(0.20 美元)使其降至 5.98 美元。
- 这意味着什么。在最高推理强度下,相对 Opus 5 每项任务节省的成本消失了。“便宜 40%”的说法适用于默认(中等)设置。
- 与 Fable 5.1 相比。Cline 报告称,Opus 5.5 在 Artificial Analysis Intelligence Index 上胜过 Fable 5.1,而成本低约 2.5 倍(@cline)。
- 提示词缓存。在 Claude Code v2.1.280 及以上版本中,会话中途切换推理强度不会破坏提示词缓存(@lydiahallie)。
- 模型规模(猜测)。@theo 声称 Opus 5.5 比 Opus 5 更小,并将其归功于后训练。官方帖子并未证实这一点。
基准测试与独立评测
Anthropic 自己的表格。在 Anthropic 的主要对比中,Opus 5.5 在每一行都胜过 Fable 5.1,并在大多数行上胜过 GPT‑6 Astra(@kimmonismus、@synthwavedd、@scaling01)。
@ShayneRedford(Anthropic)总结了所宣称的提升:
- 在 CursorBench、KWBench 和 OSWorld 上强于 Astra。
- 风格和指令遵循能力大幅提升。
- 科学和健康方面的能力更强。
- 对网络安全和生物领域的滥用更具抵御力。
第三方与合作伙伴评测:
评测结果来源Vals Index第 1 名,较 Opus 5 上升 2 位/2 分;Anthropic 占据前三名(GPT‑6 Sol 待测)@ValsAIVals RSI Index第 1 名;在其协议下首个在 LM Training 上超越已发布基准参考值的模型;胜过 Fable 5.1@ValsAI、@ValsAIFrontierSWE(Proximal)62.3%,位列第 2,仅次于 GPT‑6 Astra(65.5%);领先 Fable 5.1(56.3%)和 Opus 5(52.0%)@ProximalHQFrontierCode 1.1(Cognition)Extended 上 65.3%;从 Fable 5 手中夺得第 1,“成本只是其一小部分”@cognitionCursorBench57.8%(Max),新的最强模型;每项任务成本比 Opus 5 低 40%@cursor_aiPerplexity WANDR每项任务 4.13 美元时得分 0.610;略高于 Fable 5.1,成本低 67.6%@perplexity_aiParseBench(表格)93.9%,比 Opus 5 高 7 分;胜过 Fable、Gemini、Astra@jerryjliu0Roboflow 视觉/检测“Anthropic 迄今最好的视觉模型,没有之一”;目前在 Playground 排行榜上跻身领先于 Google 的模型之列@skalskip92、@skalskip92
评测细节与注意事项:
- Vals 的运行设置。RSI 在原生 Claude Code 中以最高推理强度运行,上下文为 1M,最大输出为 128K token,温度为 1(@ValsAI)。
- ParseBench 的注意事项。该模型在图表、格式和版面方面仍然吃力。按每页 5.8 美分计算,LlamaIndex 认为它用于生产环境的 OCR 太贵。这一结论出自一家拥有竞品的厂商。
- AI 研发 vs 编程。@eliebakouch 对 system card 的解读是:“在 AI 研发上大致相当,但在智能体编程上是头猛兽。”
- 饱和。@scaling01 问 CoBench 是否已经“凉了”。@synthwavedd 调侃说有个新基准一发布就已经饱和了。
- Arena。Opus 5.5 已进入 Agent Arena,以及 WebDev、Text、Vision 和 Document 的 Battle Mode。目前还没有分数(@arena)。
推理强度扩展的异常现象。在一张智能体编程图表上,xhigh 强度的成本比 medium 高约 2.8 倍,得分却低了 3.2 分(@LearnOpenCV)。@Yuchenj_UW 称之为“最离奇的基准测试结果”,并建议坚持用 medium。
@nrehiew_ 给出了一种解释:
- Opus 5 在 FrontierCode 上出现过同样的规律。
- FrontierCode 会惩罚不必要的改动,而更高的推理强度会带来范围蔓延。
- 结果是,模型“在更高的推理强度下表现一直更差”。
System card 细节
- 多智能体扩展。System card 在第 8.12 节报告了最多 100 个并行智能体的扩展情况。@scaling01 称这是同类实验室报告中的首例。@maksym_andr 则将其作为多智能体扩展定律的证据加以强调。
- ProgramBench 的注意事项。ProgramBench 的作者 @OfirPress 指出,Anthropic 近 100% 的解决率来自一个 166/200 的子集。该子集很可能排除了最难的程序,例如 FFmpeg 和 PHP 编译器。他还指出了指标不一致的问题(@OfirPress、@OfirPress):
- Anthropic 报告的是平均测试通过率。
- ProgramBench 报告的是完整任务完成率。
- 部分解决的方案往往能通过 60–70% 的测试,这会抬高通过率指标。
- 与 Mythos 5.1 的比较。Opus 5.5 在 Anthropic 的 ECI 上得分高于 Mythos 5.1,并在每一项测试过的网络安全评测中都胜过它(@scaling01、@scaling01)。
- 古怪的对齐失效发现。@teortaxesTex 引用了一段话:恶意输出“几乎只出现在这样的情形中:在恶意输出之前,Claude 先犯了一个不太可能发生的、无伤大雅的错误”。他问 Anthropic 是不是“给自己植入了潜伏特工”。
- “由 RSI 训练而成”。他另外引用了一句关于“首个由 RSI 训练出的模型”的话,并称其令人担忧(@teortaxesTex)。
- 生物医学影像。@iScienceLuvr 对报告中提到的生物医学图像分析能力表示欢迎。
- 更多诉求。@scaling01 希望看到不带思维链的时间跨度(time horizon)数据。
安全立场与防护措施引发的争议
官方立场:
- Sam Bowman:Opus 5.5“比其前代模型足够安全,因此发布它多半会降低与对齐失效相关的风险”,对最极端的对齐风险尤其如此(@sleepinyourhat、@sleepinyourhat)。
- 他还承认,对能否跟上不断升级的风险感到担忧,同时表示在当前这个能力水平上,现有工具仍然值得信赖(@sleepinyourhat)。
- Mike Krieger 提到了大量的对齐测试和外部评估,其中包括 METR 的评估(@mikeyk)。
摩擦:
- 回退机制过度触发。@iScienceLuvr 让 Opus 5.5 去攻克癌症,结果被降级到了回退模型。
- 针对中国(单次测试)。@xlr8harder 说,一次快速测试表明,针对前沿 LLM 开发的分类器瞄准的是中国硬件。他呼吁做更多探查。
- 对“中国”这一角度的反应。@teortaxesTex 认为这是 Anthropic 在打压中国 AI。@jakehalloran1 则认为这是在保护 Trainium 的技术诀窍。
“控制前沿节奏”的说法:
- @theo 认为,今天发布的模型没有一个达到 Astra 或 Fable 的档次,这是有意为之的节奏控制。
- @goodside 说,各实验室呼吁放缓前沿节奏,削弱了他“暂停,然后呢?”的立场。
- @dejavucoder 嘲讽了这种说法,毕竟 Opus 5.5 的表现优于 Fable 5.1。
写作、提示词与行为
- 员工谈写作修复。“我们把写作修好了”(@_sholtodouglas),以及“我们把口音修好了”(@NotTomBrown)。
- 罕见的坦率。@nmca(Anthropic)发帖说:“比 Opus 5 好太多太多太多了。为那个模型抱歉。”@theo 称这是一条疯狂的推文,说明对外沟通放松了。
- 破折号。@theo 报告说输出里不再有破折号了。这是互动量最高的反应帖。
- Anthropic 的提示词指南(@ClaudeDevs):
- 把整个任务交出去,并定义好“完成”的标准和中途汇报的节点。
- 去掉“仔细思考”,因为模型总是先思考。
- 长时间运行之后,问问它还需要什么才能走得更远。
- 旧技巧为何失效。@dbreunig 指出,旧的提示词技巧现在与模型的训练相冲突,这为可重新编译的提示词优化提供了论据。
- 长时间运行的引导。@omarsar0 重点介绍了 Anthropic 针对长时间运行的提示词,因为模型有时会停下来汇报,而不是继续往下做。
- Bug 报告。线上模型有时会生成用户轮次(@BlackHC)。
- 实际的写作质量。Hamel Husain 直播了“Slop 死了吗?”,测试它的写作(@HamelHusain)。@nptacek 分享了在个人写作评测中一次生成的结果。
视觉、3D 与“以代码作画”的演示
- 感知能力提升。Sholto Douglas 说,5.5 系列在 3D 理解和建模方面“有了显著进步”,模型“现在能看见了;以前有点瞎”(@_sholtodouglas、@_sholtodouglas)。
- 用代码作画。@jkeatn 让模型用纯 Python 一个像素一个像素地生成绘画:
- 约 7,500 行代码,使用标准库来模拟笔刷风格。
- 没有图像模型,也没有参考图。
- Sholto 把这种“手动笔刷”式的创造力与扩散模型作了对比(@_sholtodouglas)。
- Blender 场景。Alex Albert 展示了在 claude.ai 上一条提示词生成的 Blender 黏土动画(@alexalbert__)。他还构建了一个有史料依据的 1906 年旧金山 Market Street:
- 依据 Sanborn 地图、当年的影片和档案照片构建。
- 只用程序化生成器,没有下载任何网格或贴图(@alexalbert__、提示词)。
- @karpathy 就这个想法发挥了一番:把历史图像或视频变成可以漫步其中的、定制的 GTA 式世界。
- 更多演示:
- 一段用代码绘制的 JS 动画(@kevin_t_ngo)和一个官方的探索帖(@claudeai)。
- 一座由代码生成的金门大桥,被评价在 3D 场景上“和 Astra 一样好”(@petergyang)。
- “我测过的所有模型里视觉设计最好的”(@other__reality)。
- 一张珊瑚礁壁纸;作者说感觉快了约 3 倍,也便宜了约 3 倍(@chaseleantj)。
- 悬而未决的问题。@teortaxesTex 问,为什么这一代模型这么擅长把函数映射成像素,并认为这是泛化能力的体现。
反应:支持、怀疑与对比
支持:
- 流水线 bug。@rishdotblog 说它发现了 Fable 和 Astra 漏掉的流水线问题。它还找出了 7 处 SEC 备案文件的错误,其中包括 Comfort Systems 的一处 XBRL 误标:把第一季度营收标成了全年营收(@rishdotblog)。
- 回流的用户。“Claude 回来了”:@Yuchenj_UW 说他离开一个月后,要回到 Claude Code 了。
- 用量限制。整天高强度使用,额度“几乎没怎么动”(@theo)。
- 怀旧。与广受好评的 Opus 4.5 和 4.6 相比(@arohan、@kimmonismus)。
- 竞争角度的说法。@scaling01 说 Anthropic“又在碾压前沿了”。@kimmonismus 说“他们选择了与 OpenAI 开战”。
怀疑或中立:
- 信任赤字。@kylebrussell 说他不再相信 Opus 的每次发布都会让人感觉更好。Sholto 回复,问这一次能否重建这份信任(@_sholtodouglas)。
- 额度并非对所有人都重要。@stablequan 反正从来碰不到额度上限。
- 价格成了头条。@dbreunig 问,两家实验室的头条卖点都是更便宜的 token,这意味着什么。
与 GPT‑6 Sol 正面对比:
- 支持 Opus。@andrew_n_carr 说 Opus 5.5“把 Sol 甩开了好几条街”。@synthwavedd 说 Sol 低于预期,Anthropic“赢下了今天”。
- 反对。@teortaxesTex 认为,Opus 5.5 在成本和多智能体方面的胜利“会被 Astra+Sol+Luna 的海量调用实际抵消”,因为 Sol 的价格只有 Opus 5.5 的一半(@scaling01)。
- 中立。@kimmonismus 的回顾称没有明确的赢家:Anthropic 在能力惊喜上领先,OpenAI 在价格上领先。@simonw 发表了一篇文章,用跨各个推理强度的 pelican 网格对比了这三个模型。
OpenAI 的 GPT-6 Sol 和 Luna:面向 Codex、Work 和 API 的更便宜的 Astra 衍生模型
- OpenAI 在几个小时内作出回应,推出了 GPT-6 Sol 和 GPT-6 Luna,称它们是更快、更便宜的模型,继承了 GPT-6 Astra 在编程、计算机使用、事实性和对齐方面的大部分进步 @OpenAI @OpenAIDevs。定价很激进:Sol 为每百万输入/输出 token 2 美元 / 10 美元,Luna 为 0.10 美元 / 0.50 美元,均比各自的前代 GPT-5.6 便宜约 50% @OpenAI。它们已在 ChatGPT Work 和 Codex 以及 API 中推出,Luna 也向桌面应用中的 Free 和 Go 用户开放,但值得注意的是,Chat 模式尚未支持 @OpenAI。
- OpenAI 的对比思路聚焦于每项任务成本的帕累托改进,而不是绝对的旗舰前沿胜利。他们公布的示例声称,在 AutomationBench 上,xhigh 推理强度的 Sol 胜过 Claude Opus 5 max,而每项任务成本约为其 9%;Luna max 在 OSWorld 2.0 离线版上超过 GPT-5.6 Sol medium,成本仅为其十分之一 @reach_vb。第三方集成迅速跟进:Perplexity 把 Sol 设为其默认的“Light”推理强度编排器 @perplexity_ai,Devin 报告称 Sol 与 GPT-5.6 Sol 水平相当,而每项任务成本低 61%,Luna 以大约四分之一的成本胜过其前代 @cognition,Arena 也把两者加入了智能体和代码方面的测试 @arena。
- 更深层的基础设施故事可能比这些型号名称更重要。OpenAI 表示改进了缓存和推理效率,缓存输入 token 的读取最高可享 90% 的折扣,并推出了新的 Prompt Caching Dashboard 和诊断 API,用来弄清缓存复用为何失效 @OpenAIDevs @OpenAIDevs。这对长时间运行的智能体尤其重要,因为切换工具或改变推理设置导致的缓存失效,代价一直很高。市场反应不一:许多人称赞其经济性,尤其是 Luna 的价格底线,也有人认为 Anthropic 在模型质量这一头条指标上胜出,而 OpenAI 则在性价比和部署便利性上占优 @kimmonismus @synthwavedd。
智能体基础设施、评测工具,以及来自真实使用的后训练
- 多条帖子汇聚到一个如今已很熟悉的模式:价值正从单纯获取原始模型,转向运行框架(harness)、评测、路由,以及基于专有轨迹的后训练。DigitalOcean Managed Agents 进入公开预览,支持 Claude Code、Codex 和 LangGraph 式智能体,另有空闲时暂停的运行时、受管控的工具端点,以及 75 个以上的模型选择 @digitalocean。在开发者工作流方面,VS Code Agent Merge 推出了一个实验性模式,可在 PR 内自动处理评审意见、失败的检查和合并冲突 @code。
- Perplexity 分享了一份较为具体的后训练报告:其 Computer 智能体在真实用户会话上混合使用拒绝采样微调和提示引导的自蒸馏,从成功的轨迹和明确的工具调用错误中学习,在一次线上 A/B 测试中据称工具调用失败减少了 21.2% @perplexity_ai @AravSrinivas。这是个有用的例子,说明实验室正在通过生产环境的轨迹,而不是纯合成的强化学习环境,来落实从仿真到现实的衔接(sim-to-real bridging)。
- 评测和可观测性工具也受到关注。Lenny’s newsletter 重点介绍了 Ramp、Shopify、Harvey 和 Cursor 等公司在评测上投入的具体回报,并链接了 Hamel Husain 和 Shreya Shankar 关于高级评测系统的续篇 @lennysan。Hamel 还发布了一个评测 skill/插件,意在自动化评测审计和错误分析的部分环节 @lennysan。在可观测性方面,LangSmith 改进了对 Jev/SemIf 这类决策模型的支持,让智能体追踪中的状态、问题、选择和输出更易于检查 @hwchase17 @LangChain。多位从业者共同的要点是:即使模型和提示词相同,运行框架也会实质性地改变基准测试结果 @omarsar0。
开源模型、压缩,以及在更小硬件上运行更大模型的系统工作
- Tim Dettmers 以一个集成进 bitsandbytes2 的运行时动态压缩框架开启了“开源周”,目标是在高质量下实现 1.5–2.0 比特压缩,并承诺提供“惰性压缩”,在部署时自动找到更优的内存/质量/速度权衡 @Tim_Dettmers @Tim_Dettmers。这一定位明确面向小团队和个人,他们要在内存受限的条件下运行大型开放权重模型,包括不断增长的 KV 缓存。
- 硬件和本地部署是另一个主题。一篇关于 NVIDIA DGX Spark 的上手文章介绍了这套 15×15×5.05 厘米、1.2 千克的系统,搭载 GB10 Grace Blackwell、128 GB 统一内存,理论算力最高达 1 PFLOP FP4 稀疏;NVIDIA 称它支持对最高 200B 参数的模型做量化后的本地推理,并支持用 QLoRA 等方法对最高 70B 的模型做微调 @kimmonismus。另外,Reka EdgeQ 展示了一个直接针对高通 Hexagon NPU 优化的端侧视觉语言模型(VLM),首词元延迟(TTFT)为 0.73 秒,每次推理耗电 6.9 mWh,GPU 保持空闲以维持持续的散热性能 @RekaAILabs。
- 在开放模型方面,有几项有实质意义的发布,而不只是评论。Step Code v0.1.0 以 MIT 许可发布,打包了一个编程智能体 CLI,据报在 Terminal-Bench 2.1 上得分 80.9%,在包含 150 个任务的长时程基准 Multi-Frame 上得分 73.3% @StepFun_ai。Ming-Image-0.1-Design 是一个 6B 的开放权重图像设计模型系列,与 UI 设计和图像转可编辑 PPT 的“智能体 skill”一同发布,声称在 Artificial Analysis 的 UI/UX 设计排行榜上位列开放权重模型第 1 @AntLingAGI。规模较小但技术上值得一提的预训练成果来自 Rigel,这是一个 2.3B MoE / 360M 激活参数的 Hybrid Mamba-2,据称在同一套代码库上跨 H100/A100/V100 和 TPU v5p/v6e 混合硬件训练,只用了 Llama-3.2-3B 预训练 FLOPs 的 不到 1%,成绩就与其相差不过几个点 @MayankMish98。
多模态模型:图像、视频、语音与世界模型
- 在图像生成和编辑方面,Qwen-Image-2.1 在社区排行榜上表现强劲,在 Image Edit Arena 和 Text-to-Image Arena 中均位列开放模型第 1,整体上接近前沿的闭源系统 @arena。配套的生态工作包括:Unsloth Desktop 支持 INT8/FP8 和 GGUF,借助内存卸载可在 6–8 GB 显存内运行 @danielhanchen;以及 Gradio 努力把 Qwen 默认的 9B 提示词改写器缩小到 0.8B,以便在笔记本上使用 @Gradio。
- 在视频和实时媒体方面,PixVerse R2 作为实时世界模型发布,强调可编辑、持久存在的“活的世界” @PixVerse;fal 则发布了 H3 Max 的技术栈拆解,声称通过涵盖后训练、GPU 执行、权重加载、扩展和服务的一系列优化,实现了 3 秒生成 5 秒视频 @fal。其 World Model Accelerator 接口值得注意之处在于,为交互式模型用持久的 WebRTC 会话取代了请求/响应语义 @fal。
- 语音领域同样活跃。AssemblyAI Universal-3.5 Pro 在 OpenRouter 上线,提供支持 19 种语言的同步语音转文字(STT),可通过关键词和提示词进行领域引导,并有限时折扣 @OpenRouter。StepAudio 3 ASR 在 Artificial Analysis 的 AA-WER Index 上达到 1.7% 词错误率(WER),在非流式语音转文字中基本与榜首持平,只是价格较高 @ArtificialAnlys。Moondream 还发布了面向 25 种语言的本地 STT 模型 Parakeet Redux 和 Parakeet Ultra,分别面向 CPU 和 GPU @moondreamai。
热门推文(按互动量)
- Claude Opus 5.5 发布:Anthropic 的主发布帖占据了互动量榜首,并定调了当天最大的模型事件 @claudeai。
- GPT-6 Sol 和 Luna 发布:OpenAI 发布更便宜的 Astra 衍生模型,是另一条主要头条 @OpenAI。
- Managed Agents 预览:DigitalOcean 公开预览面向 Claude Code/Codex/自定义智能体的托管运行时,引发了异乎寻常高的基础设施关注 @digitalocean。
- OpenAI 的标准提案:Sam Altman 关于 AI 标准与治理的帖子引发了远超纯产品新闻的热烈讨论 @sama。
- Epoch 谈 AI 成本曲线:Epoch 估计,自 2023 年以来,在固定性能下 AI 的成本每季度下降约 47%,这是当天较有用的宏观数据点之一 @EpochAIResearch。
AI Reddit 回顾
/r/LocalLlama + /r/localLLM 回顾
1. Qwen、DeepSeek 与 AliceAI 的大模型路线图
- Qwen4-27B 刚刚得到确认(热度:2353):一张会议幻灯片图片似乎确认了即将推出的 Qwen4 系列阵容,明确列出了 Qwen4-27B 以及 Qwen4-Max、Qwen4-Flash 和 Qwen4-Plus。该帖强调社区关心阿里是否还会发布类似
35B-A3B的更小的 MoE 式变体,评论者推测,N-gram 之类的架构改动可能降低显存需求。评论者主要在争论 Qwen4-27B 是否会胜过 Qwen 3.8 Flash Next,以及最佳的本地推理路线会偏向独立 GPU 还是大容量统一内存系统。如果 Qwen4 Flash、Qwen3.8 Flash Next 和 Qwen4-27B 都以开放权重发布,大家也有兴趣对三者做比较。- 评论者推测,如果 Qwen4-27B 采用N-gram 式架构,显存需求可能会更低,不过该帖中没有给出具体的实现细节或内存数据。
- 有人提议对 Qwen4 Flash、Qwen3.8 Flash Next 和 Qwen4-27B 做技术对比,前提是三者都以开放权重发布。提出的关键问题是:一个稠密/标准的
27B模型,能否比较小的 Flash 变体强到足以影响用户优先选择独立 GPU 还是大容量统一内存系统。 - 有位用户希望 Qwen4 Flash 保持 Flash Next 的内存占用,特别是瞄准在
128 GB显存内部署,这意味着他关心更大的开放权重 Qwen 模型能否在本地推理。
- 阿里巴巴计划推出 5 万亿至 10 万亿参数的 AI 模型,并发布新芯片(热度:648):据报道,阿里巴巴计划推出参数规模在
5T–10T区间的 AI 模型,并发布了一款新的 AI 芯片,这意味着其训练/推理目标属于前沿规模,远超当前消费级/本地部署的现实可行范围。评论者将其与此前围绕 DeepSeek R1 的671B/691B级规模的热议相提并论,并预计任何实际的下游应用都将通过蒸馏到更小的 Qwen 系列模型来实现,例如假想中的Qwen 4 27B。争论的焦点在于:一方怀疑本地推理是否可行——“每个 token 要几分钟”——另一方则乐观地认为,阿里巴巴可能会把一个大得多的内部模型(也许就是“Astra”)蒸馏成真正有竞争力的中国前沿模型。- 评论者指出,一个 5T–10T 参数的阿里巴巴模型对几乎所有用户而言实际上只能通过 API 使用;在家用实验室(homelab)硬件上做本地推理并不现实,如果没有大幅的稀疏化、量化或专用推理硬件,生成速度可能慢到每个 token 要几分钟。
- 多条评论认为,其实际价值很可能在于蒸馏,并把它与当年围绕 DeepSeek R1 的
671B/691B级参数量的热议相类比,建议用户不妨等待更小的后继模型,比如假想中的 Qwen 4 27B,那样才有可能在本地运行。 - 有评论者推测,如果阿里巴巴已经成功蒸馏或吸收了 Astra 的能力,这可能意味着中国在前沿模型上的投入更加认真;不过该帖子并未提供任何基准测试证据或实现细节来验证这一说法。