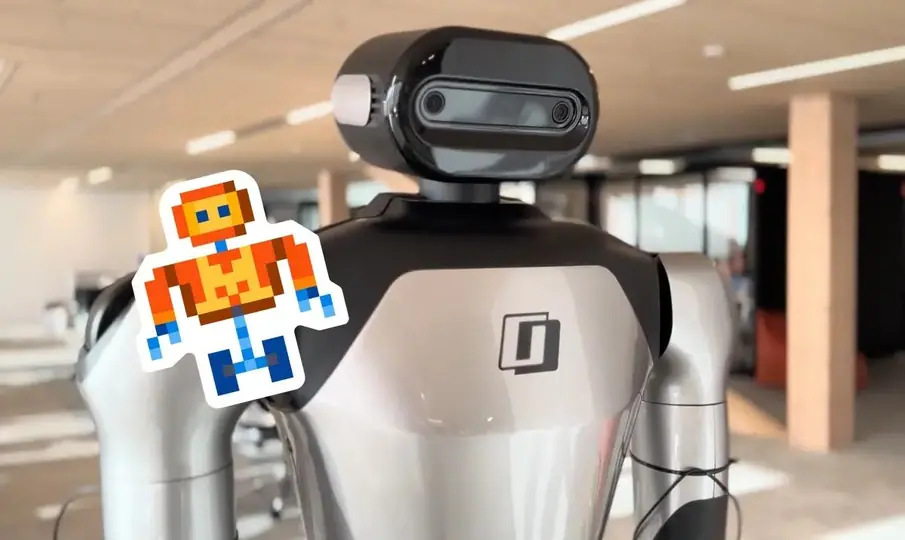
隆重推出
Robostral Navigate
思考
摘要
Robostral Navigate 是一个 8B 模型,仅凭单个 RGB 摄像头就能让机器人在复杂环境中自主导航,在未见过的 R2R-CE 基准测试上取得 76.6% 的成功率,超越多传感器方案,同时效率更高。它完全在内部构建,使用模拟数据和节省 token 的技术,可在不同机器人类型之间泛化,并能适应训练中未见过的真实世界障碍物。该模型把基于指点(pointing)的导航与强化学习相结合以持续改进,为机器人领域统一的具身 AI 铺平道路。
今天,我们推出 Robostral Navigate,这是我们首个为具身导航打造的模型。它是一个 8B 模型,接收 RGB 图像和一条自然语言指令,并驱动机器人在环境中移动:
“离开大厅,穿过走廊,进入储物间,然后停下来面向第二个货架。”
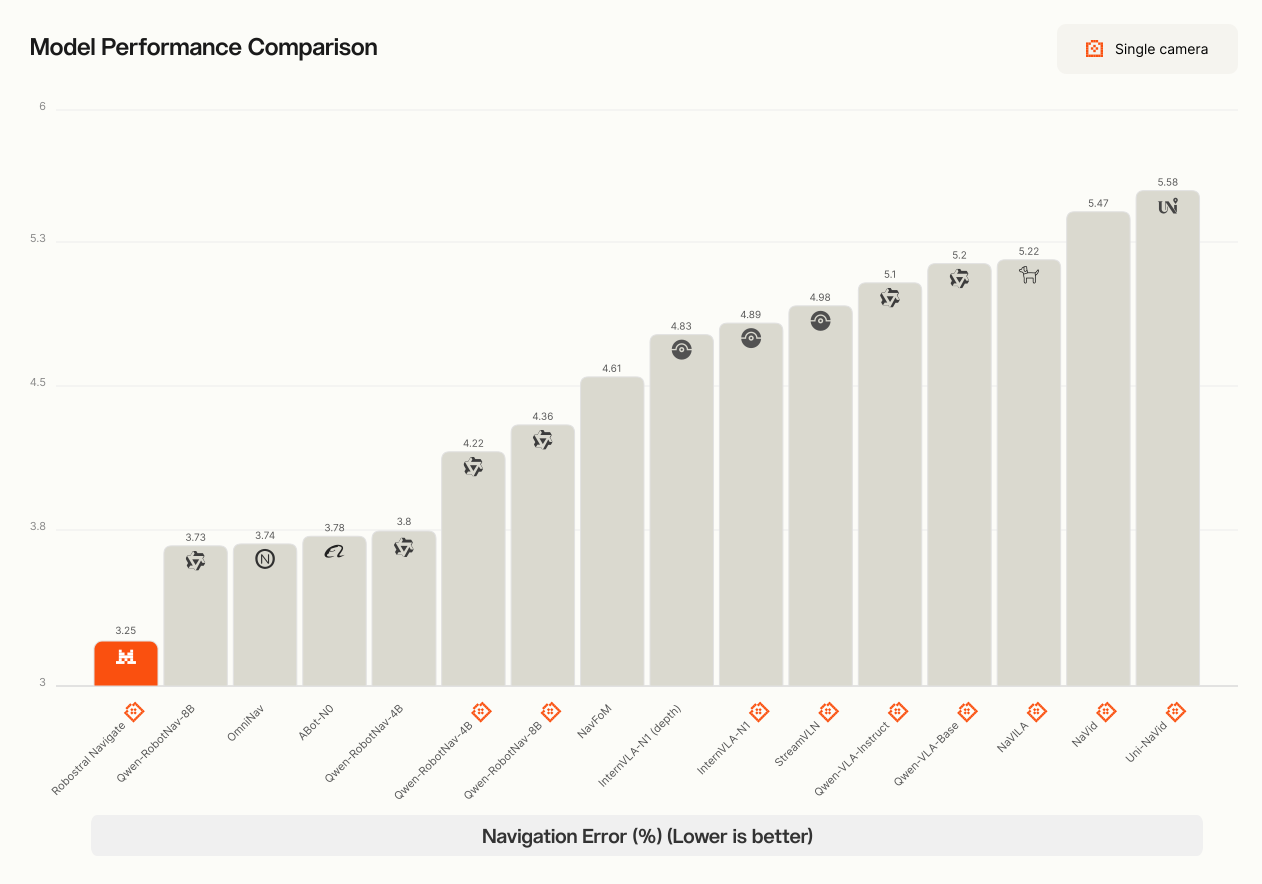
要完成这类任务,其他模型往往会使用深度传感器、LiDAR,或多个摄像头协同工作。Robostral Navigate 只使用一个普通的 RGB 摄像头,不使用深度传感器,却仍在 R2R-CE(Room-to-Room in Continuous Environments,连续环境中的房间到房间导航)验证集 unseen 划分上取得 76.6%,该基准用于测试在训练中未出现过的环境里遵循指令的能力。因此,它领先最佳的单摄像头方案 9.7 个百分点,领先使用深度或多摄像头的最佳系统 4.5 个百分点,而它两者都没有用。
导航
我们的模型专为机器人导航而设计,使机器人能够在复杂环境中自主导航,包括办公室、住宅和商业建筑以及户外场景。
▶ https://www.youtube.com/watch?v=7dpLB9NoY1A
Robostral Navigate 在一间正常办公的办公室中,沿一条长程指令路线完全自主运行。
这项技术可在制造、配送、物流和酒店服务等领域带来大量应用,也是目前客户需求最旺盛的能力之一。只需给 Robostral Navigate 一条指令,它就能独自完成整个任务,在满是人员和从未见过的障碍物的真实空间中穿行,并能适应任何环境。
亮点
- 在 R2R-CE 上达到业界最先进水平
- 验证集 seen 划分成功率 79.4%
- 验证集 unseen 划分成功率 76.6%
- 仅依靠单个 RGB 摄像头运行,无需 LiDAR 或深度传感器
- 8B 模型,内部构建,完全在模拟中训练
- 可在轮式、足式和飞行机器人上运行,并能在不同尺寸的机器人之间泛化
- 对相机内参差异具有鲁棒性
- 通过前缀缓存(prefix-caching)实现节省 token 的训练
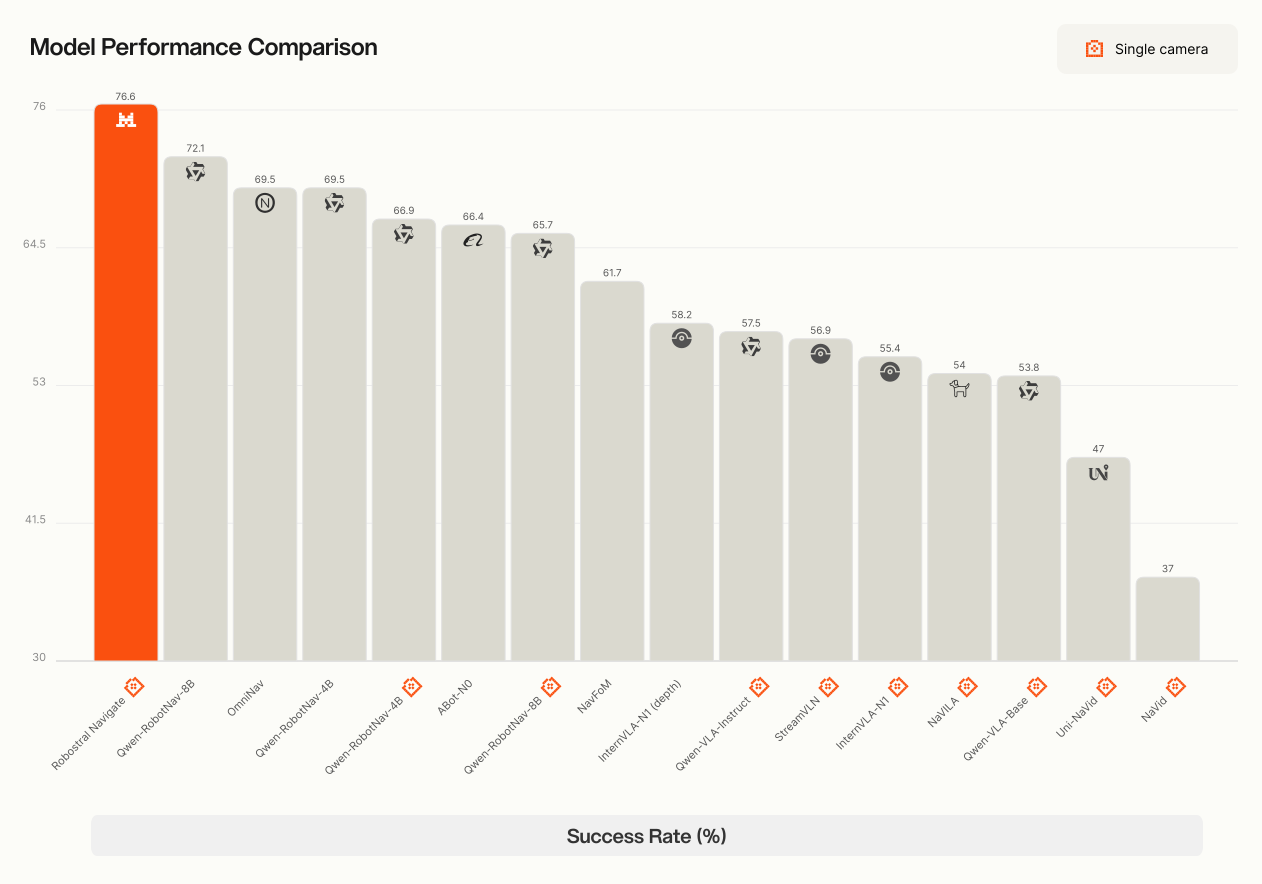
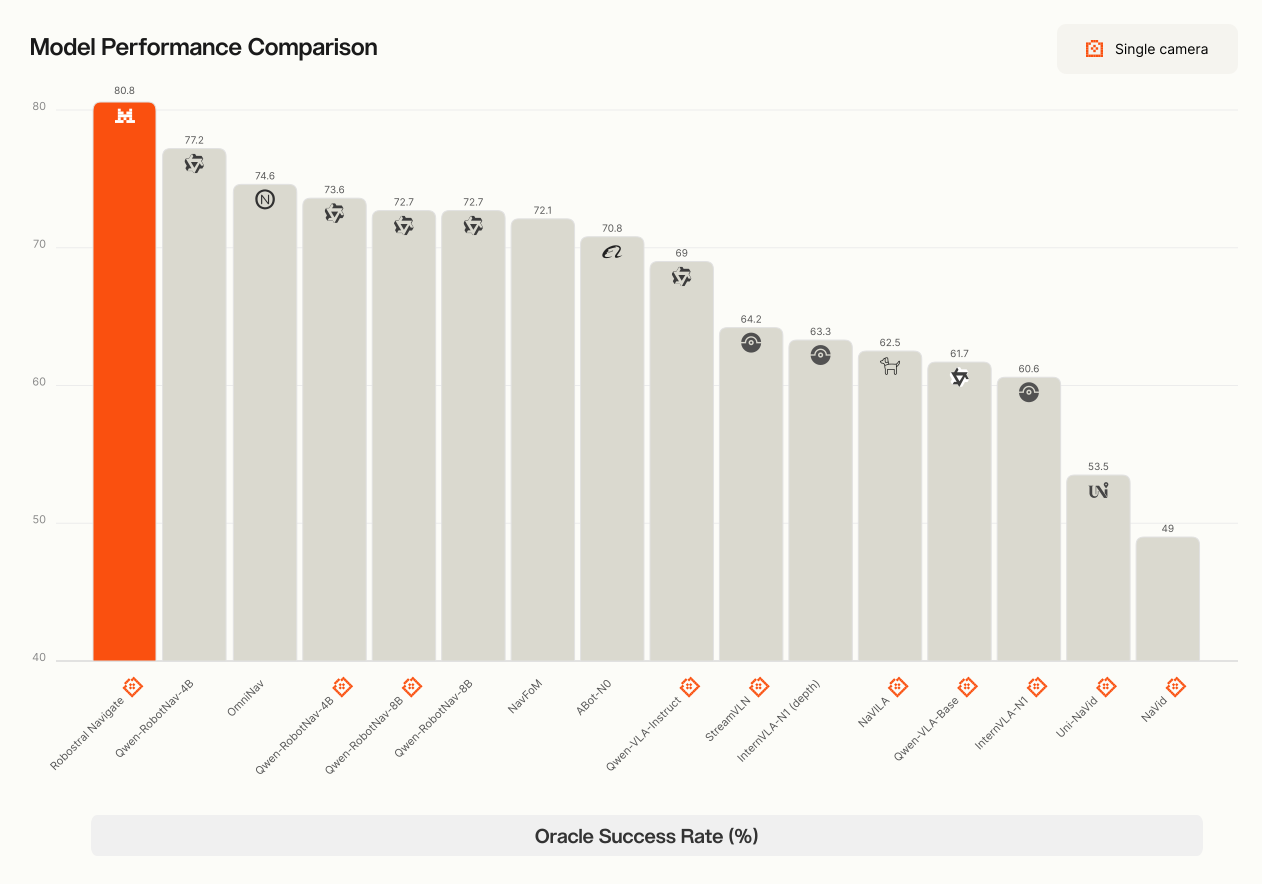
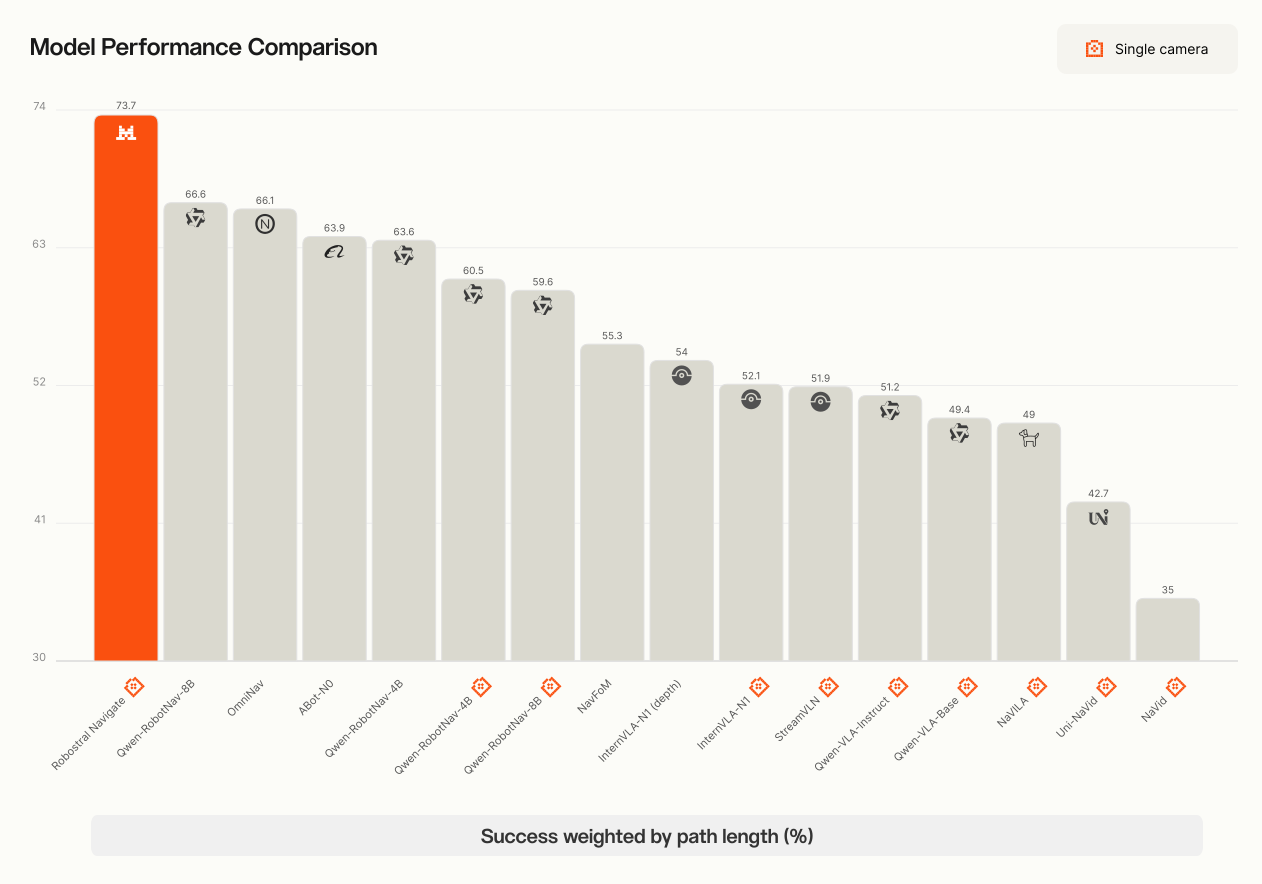
通过指点进行导航
给定任务和观测历史,Robostral Navigate 通过指点来预测机器人下一步应移动到哪里:它推断目标位置在机器人当前相机视图中的图像坐标,以及到达时期望的朝向。与依赖度量位移的指令不同,指点使策略天然地对相机内参和世界尺度的变化具有鲁棒性。
然而,这种方法无法处理目标位置在当前视野之外的情况。当指点不适用时,模型会退回到机器人局部坐标系下的位移,例如:
“向前移动 2 米,向左移动 1.5 米,并向左转 25 度。”
从零开始构建
Robostral Navigate 完全在内部构建,不依赖现有的开源视觉语言模型(VLM)。
该模型由我们专门针对指点、计数和物体定位等 grounding 任务的视觉语言模型初始化而来。导航是这些能力的自然延伸:一旦理解了事物在哪里,它就学会了如何移动。
我们完全在模拟中构建了一条高效的数据生成流水线。这使数据能够快速迭代,最终得到一个包含约 240 万条轨迹、采集自 35 万个场景的数据集。
高效的监督训练
Robostral Navigate 的一个关键要素是基于前缀缓存的高效训练算法。通过基于树的注意力掩码策略,我们的方法把整个回合(episode)压缩成单个序列,从而能在一次前向传播中对所有时间步进行训练,同时防止时间步之间的信息泄漏。
与每个时间步一个样本的训练方式相比,我们的方法把训练 token 数量减少了 22 倍,同时保留了全部学习信号。在实践中,这种方法把原本需要数月的训练运行变成几天即可完成。
在线强化学习
我们借助大规模 LLM 后训练的经验,使用在线强化学习来提升 Robostral Navigate 的性能。在监督训练阶段之后,我们使用在线强化学习算法 CISPO 进一步提升模型性能。这使模型能够从试错中学习、从失败中恢复并获得探索行为,有效缓解了朴素行为克隆的分布偏移问题。仅此一项就把成功率提高了 3.2%。我们没有看到任何平台期,因此相信更多的训练和实验将继续推高这一数字。
下一步
Robostral Navigate 只是迈向统一具身智能体的第一步。
我们相信,导航是通用机器人的一项基础能力。通过结合大规模模拟、高效训练和强大的 grounding 先验,Robostral Navigate 证明了用一个紧凑的模型和单个 RGB 摄像头就能实现业界最先进的具身导航。
开启你的具身前沿 AI 之旅,与我们的团队聊聊。
顺便说一句,我们在招人!
我们导航模型的发布标志着一次重大进步,但我们的旅程远未结束。我们的目标是让机器人能够在复杂环境中自主导航,包括办公室、住宅、商业建筑和户外空间,还有大量工作要做。我们正在积极扩充机器人团队,寻找与我们怀有同样抱负的优秀研究科学家和工程师。
如果你有兴趣加入我们,共同实现让机器人在各地都能无缝导航的使命,欢迎投递申请,加入我们的团队!
作者:Théo Cachet, Arjun Majumdar, Srijan Mishra, Thomas Chabal, Chris Bamford, Elliot Chane-Sane, Benjamin Tibi, Ludovic Ho Fuh, Olivier Duchenne - AI Science Robotics
技术报告
阅读 Robostral Navigate 技术报告,了解完整的架构、训练设置和基准测试结果。
报告