摘要
当前的数据科学基准测试依赖互不兼容的评估接口。此外,许多任务无需使用底层数据就能解决。为解决这些局限,我们提出了 DSGym,这是一个在自包含执行环境中评估和训练数据科学智能体的集成框架。借助 DSGym,我们训练出了一个达到当前最佳水平的开源数据科学智能体。
arXiv 论文:https://arxiv.org/abs/2601.16344
Github 仓库:https://github.com/fannie1208/DSGym
数据科学是现代科学发现的计算引擎。然而,评估和训练基于 LLM 的数据科学智能体依然困难重重,因为现有基准测试在异构的执行环境中评估各自孤立的技能,导致集成成本高昂,也难以进行公平比较。
我们提出了 DSGym,这是一个统一框架,通过单一 API 整合多种数据科学评估套件,并为数据集、智能体和指标提供标准化的抽象。DSGym 统一并改进了现有基准测试,同时通过全新的科学分析任务(来自学术文献的 90 个生物信息学任务)和具有挑战性的端到端建模竞赛(92 个 Kaggle 竞赛)扩大了覆盖范围。除评估之外,DSGym 还提供用于智能体训练的轨迹生成和合成查询流水线——我们以此训练了一个 4B 模型,仅用 2k 条生成的样本,就在开源模型中取得了最先进的性能。
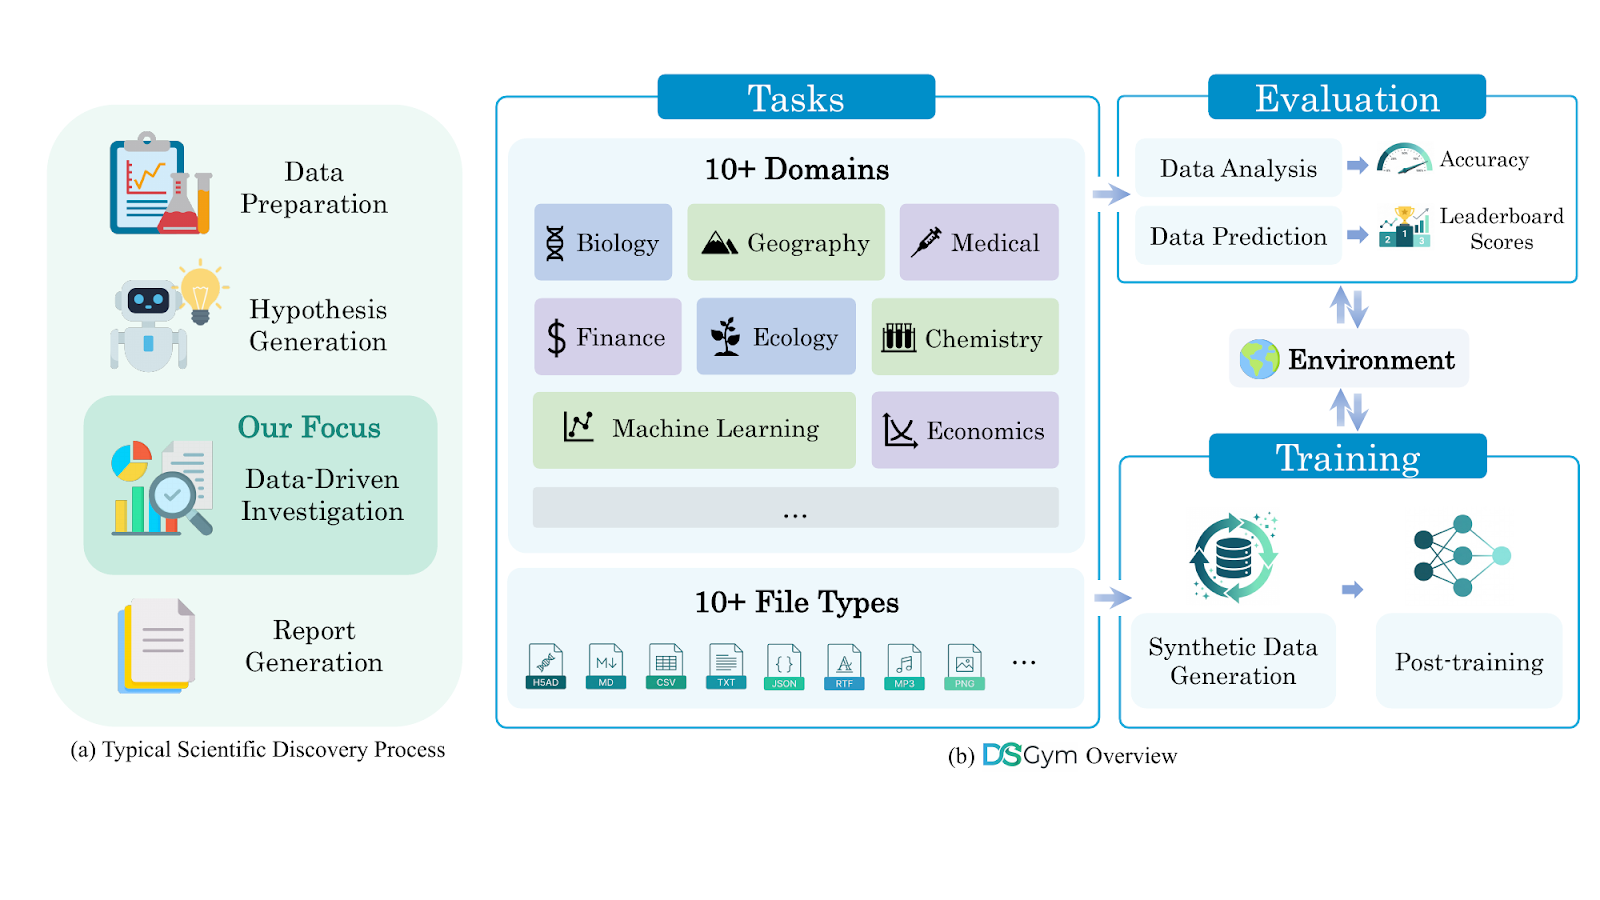 *(a)典型的科学发现流程。DSGym 聚焦于数据驱动的探究阶段,任务覆盖 10 多个领域和多种文件类型。(b)DSGym 概览。该框架既支持评估(数据分析和预测任务),也支持通过合成数据生成进行训练。*
框架与数据集
DSGym 的主要贡献之一,是把代码执行的复杂性抽象到容器之后;这些容器可实时分配,用于安全地执行代码,并预装了依赖项和可供处理的数据。
DSGym 为所有基准测试提供统一的 JSON 接口,每个任务都表示为:数据文件、查询提示词、评估指标和元数据。我们力求让设计保持模块化且简单明了,这样用户添加新任务、智能体脚手架、工具和评估脚本就会更容易。DSGym 中的任务分为两大类:
- 数据分析(通过程序化分析回答查询)。
- 数据预测(端到端的机器学习流水线开发)。
除了整合 MLEBench 和 QRData 等成熟的基准测试,DSGym 还引入了原创数据集。具体来说,我们创建了两个新套件来扩大总体覆盖范围:DSBio(来自学术文献的 90 个生物信息学任务,考察特定领域的工作流)和 DSPredict(92 个 Kaggle 竞赛,涵盖时间序列、计算机视觉、分子性质预测和单细胞扰动)。下图概括了这两个套件的构建过程:
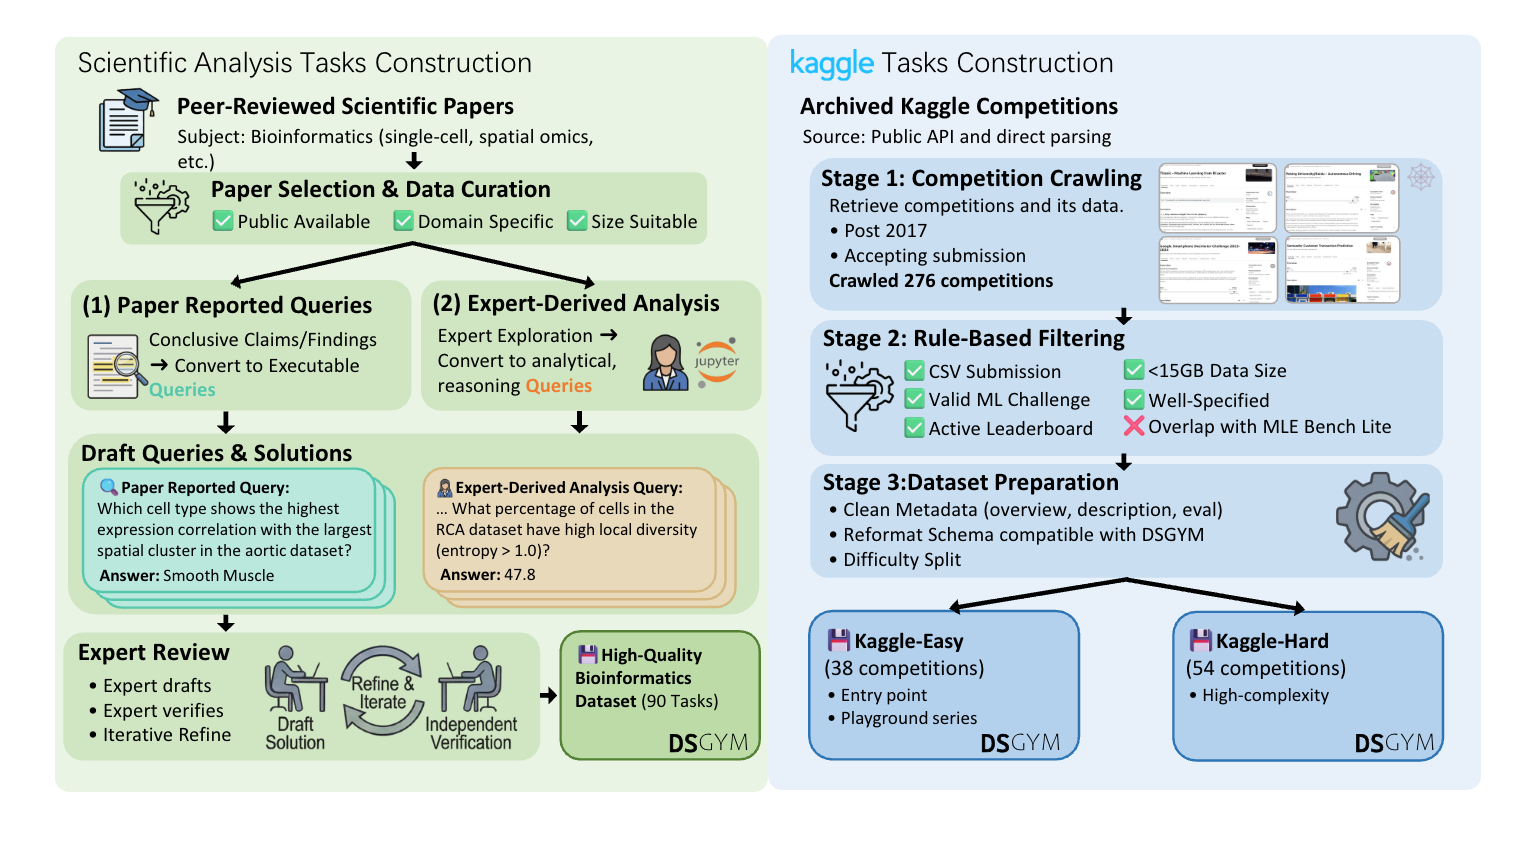
为支持任务执行和数据生成,DSGym 提供了数据生成流水线,用于执行查询并生成轨迹,使该框架成为能够有效训练模型的数据工厂。
利用这一流水线,我们生成了 3,700 条合成查询。经过基于 LLM 的质量过滤后,我们获得了 2,000 个高质量的查询—轨迹对,用于监督微调。我们的结果(见下文)表明,这些数据可以有效提升模型在数据科学任务上的表现,即便是小模型也是如此。
结果
这里介绍我们的主要发现,更多结果见论文。
弥合记忆化差距
第一个重要的结果与记忆化有关。我们观察到,许多现有基准测试的查询所提供的信号很弱:相当一部分查询即使不访问数据文件也能解出,这说明 LLM 可能在训练期间就已经接触过这些任务。
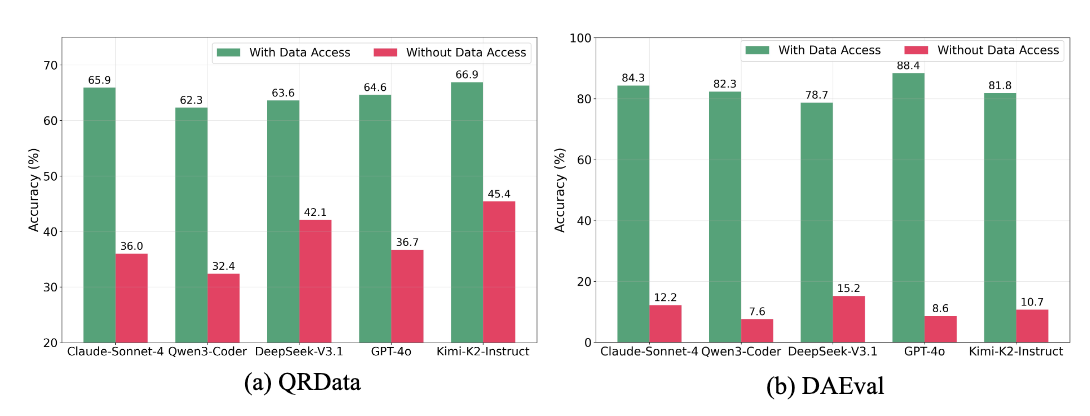
因此,我们专门标记并剔除了这些很可能出现在模型训练集中的样本。DSGym 通过质量过滤和仅凭提示词即可取巧作答的过滤来移除此类任务,得到经过精炼的数据集:DAEval-Verified、QRData-Verified、DABStep 和 MLEBench-Lite。
基准测试表现与失败模式
创建这些新基准测试后,我们在通用数据科学任务和特定领域的科学任务上测试了前沿的专有 LLM 和开放权重 LLM。
我们训练的 4B 模型(Qwen3-4B-DSGym-SFT-2k)在通用分析基准测试上,取得了可与规模大得多的模型相媲美的表现。
| 模型 | QRData-Verified(%) | DABStep-easy(%) | DABStep-hard(%) | DAEval-Verified(%) |
|---|---|---|---|---|
| 专有模型 | ||||
| GPT-5.1 (high) | 60.16 | 73.61 | 13.23 | 89.50 |
| GPT-5.1 (none) | 58.96 | 70.83 | 11.90 | 87.85 |
| GPT-5 (medium) | 61.75 | 75.00 | 28.31 | 89.50 |
| GPT-4o | 60.24 | 73.61 | 7.41 | 92.26 |
| Claude Sonnet 4.5 | 61.35 | 83.33 | 37.04 | 91.71 |
| Claude Sonnet 4 | 59.06 | 81.94 | 31.75 | 90.91 |
| 开源模型 | ||||
| Qwen3 235B Instruct | 54.18 | 73.61 | 17.46 | 85.08 |
| Qwen3-Coder 480B | 54.72 | 75.00 | 14.29 | 90.61 |
| Kimi K2 Instruct | 63.68 | 77.78 | 28.84 | 92.82 |
| GPT-OSS-120B | 47.95 | 70.83 | 7.94 | 84.53 |
| Deepseek-v3.1 | 57.37 | 76.39 | 21.96 | 82.32 |
| Qwen2.5-7B-Instruct | 35.04 | 47.22 | 2.38 | 50.56 |
| Qwen3-4B-Instruct | 45.27 | 58.33 | 2.90 | 64.47 |
标准化通用数据分析数据集上的准确率。每列最高分以橙色标出。即便是前沿模型,在多步推理上也表现欠佳——DABStep-hard 的最高分仅为 37.04%(Claude Sonnet 4.5),而通用分析(DAEval、QRData)的得分则相对较高。
有意思的是,大多数模型离满分仍相去甚远。为了弄清模型在这些任务上失败的原因,我们对每个模型、每类任务随机抽取的 50 条失败轨迹进行了人工错误分析。分析揭示了一个有趣的规律:通用分析任务的失败模式多种多样,其中统计知识欠缺和规划错误最为常见,而科学分析任务则由单一的失败模式主导。
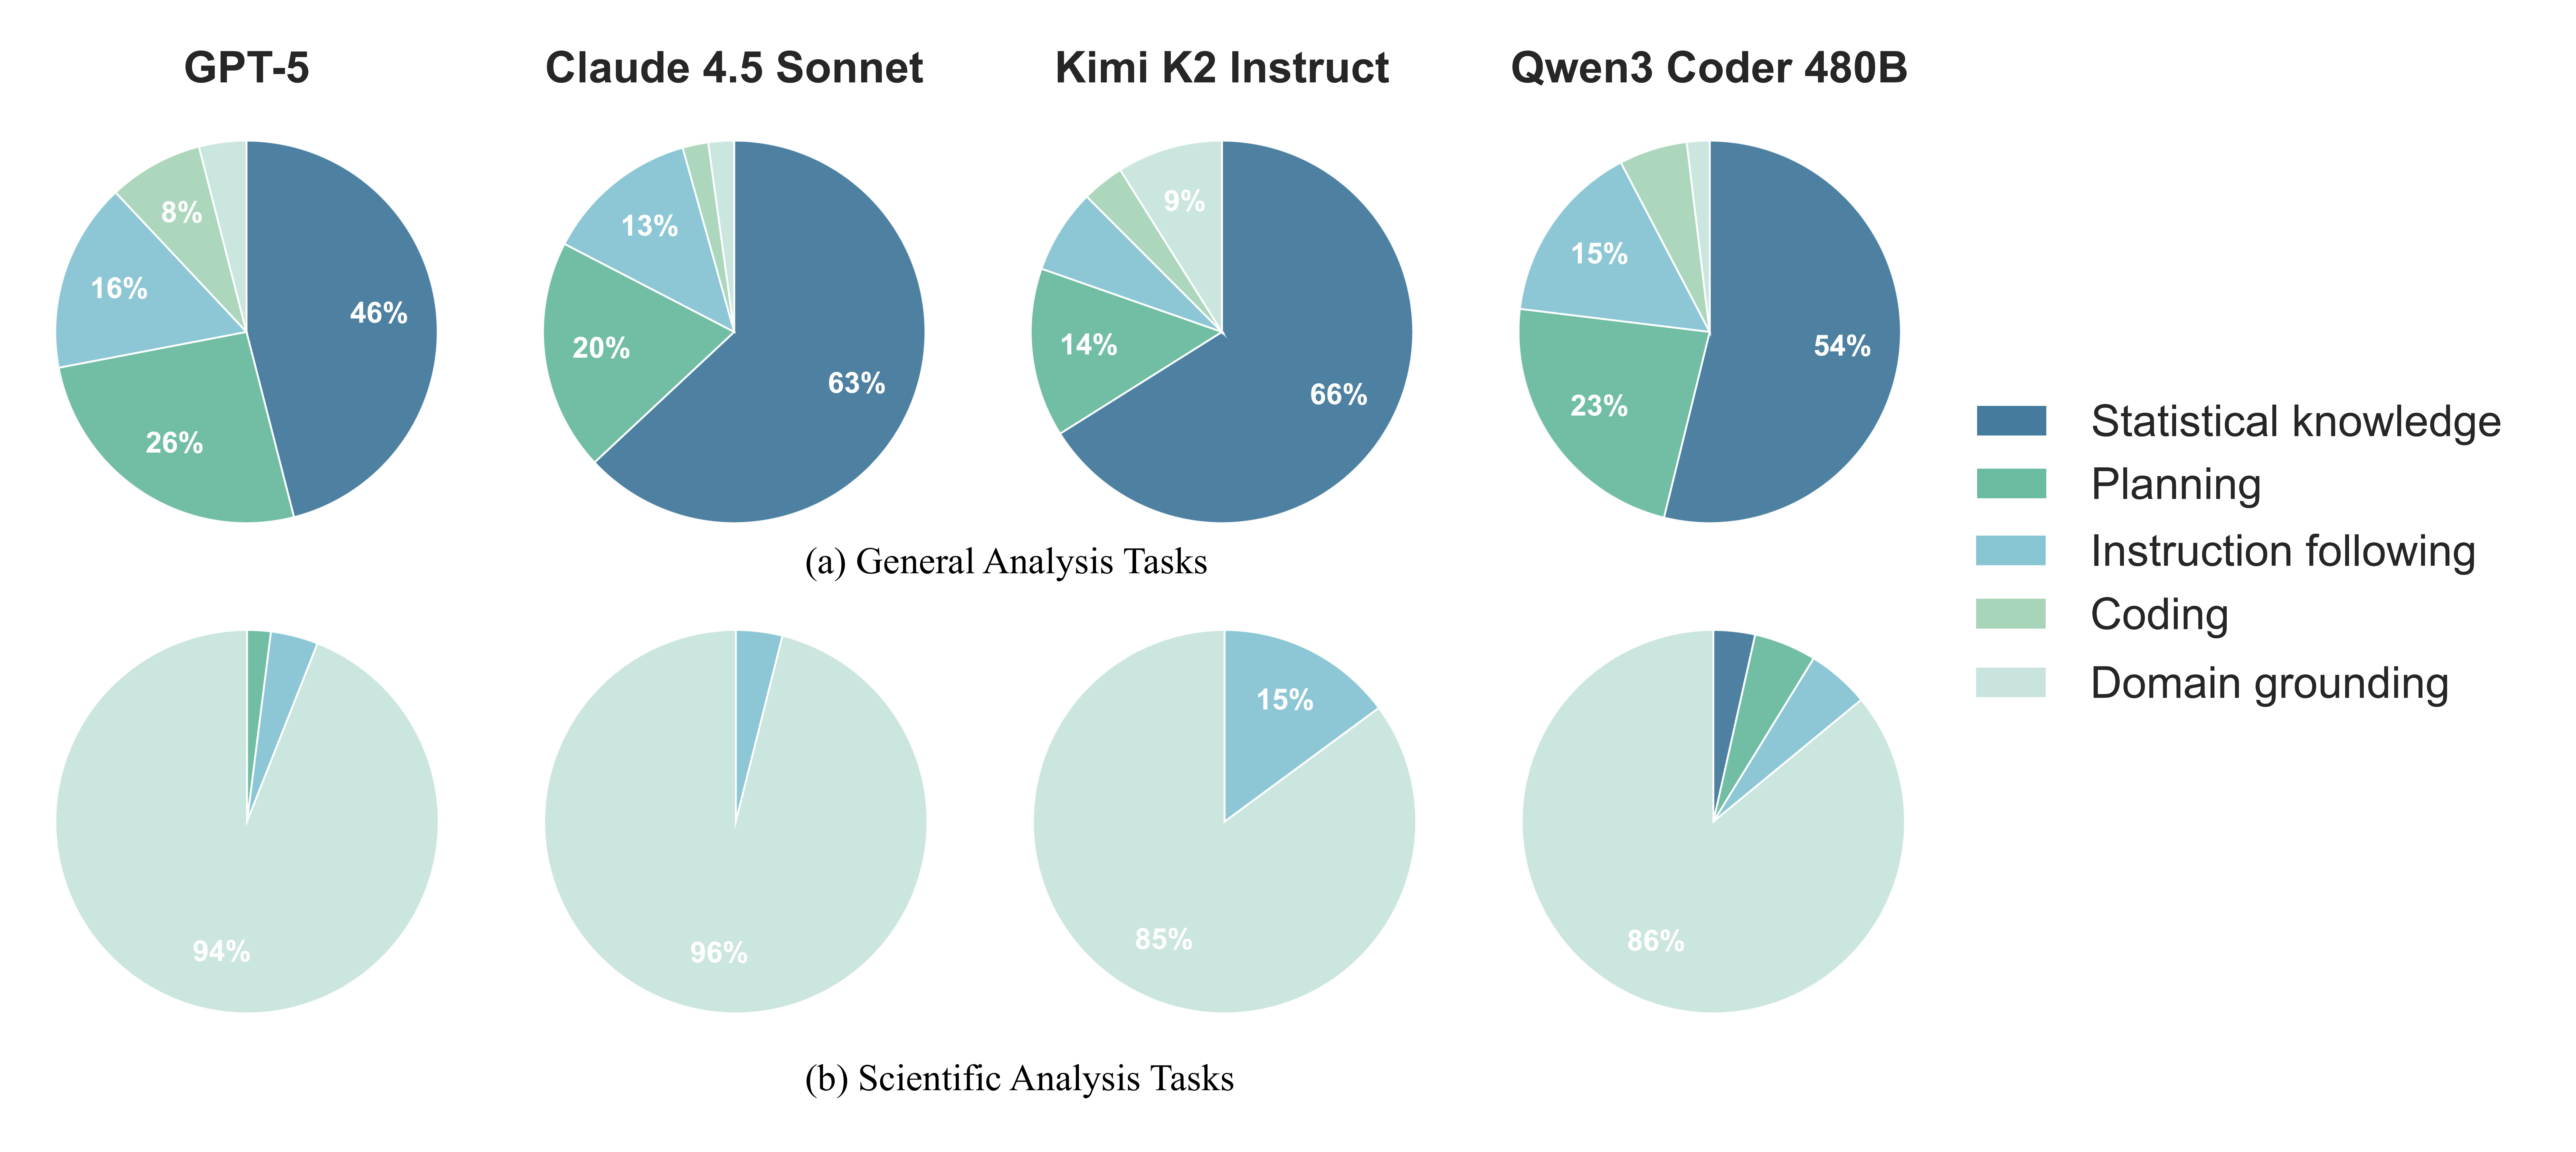 *四个 LLM 在(a)通用分析任务(QRData 和 DAEval)和(b)科学分析任务(DSBio)上的错误类型分布。对每个模型和每类任务,我们均匀抽取 50 条失败轨迹,并人工标注其主要错误类别。一个关键的转变由此浮现:通用任务上的失败以统计知识和规划问题为主,而 DSBio 上的失败则绝大部分由领域落地(domain-grounding)错误导致(各模型为 85–96%)。*
数据预测表现
DSPredict 评估智能体构建完整机器学习流水线(从原始数据到最终模型)的能力,模拟 Kaggle 竞赛的复杂性。
我们在 DSPredict-Easy 和 DSPredict-Hard 两个划分上评估模型。性能通过以下指标衡量:
- 有效提交(Valid Submission):成功生成格式正确的输出文件。
- 中位数/百分位(Median/Percentile):相对于原始竞赛排行榜的表现。
- 奖牌(Medal):达到相当于铜牌、银牌或金牌的得分阈值。
我们使用一个类似 CodeAct 的简单脚手架。每个智能体的总时间上限为 10 小时,每次代码执行的时间上限为 2 小时。
| 模型 | DSPredict-Hard(私有榜) | DSPredict-Easy(私有榜) | ||||
|---|---|---|---|---|---|---|
| 有效提交 | 奖牌 | 中位数 | 有效提交 | 百分位 | 中位数 | |
| GPT-5.1 (high) | 85.7 | 4.8 | 14.3 | 100 | 60.4 | 75 |
| GPT-5.1 (medium) | 81.0 | 4.8 | 7.1 | 91.7 | 55.7 | 63.9 |
| GPT-5.1 (none) | 69.0 | 2.4 | 10.3 | 97.2 | 45.7 | 41.7 |
| Claude Sonnet 4.5 | 71.4 | 0 | 4.8 | 100 | 49 | 52.8 |
| Qwen3 235B Instruct | 64.3 | 2.4 | 2.4 | 97.2 | 42.9 | 33.3 |
| Kimi K2 Instruct | 69 | 0 | 0 | 97.2 | 43.9 | 41.7 |
表 2:DSPredict 基准测试上的性能指标。每列最高分以橙色标出。Valid 为有效提交率,Medal 为获得任意奖牌的比例,Median 为超过中位数的比例;在 DSPredict-Easy 中,以 Percentile 取代 Medal。
我们对 DSPredict 结果的分析,揭示了 LLM 智能体在端到端机器学习工作流中当前能力与局限的几点关键认识。
可靠性高,竞争力低:前沿模型(如 GPT-5.1 和 Claude 4.5)虽然很擅长构建可运行的流水线——有效提交率超过 85%——但在竞争力上却很吃力。在“困难”任务上,能稳定超过人类中位数的模型寥寥无几。
一个主要瓶颈是模型倾向于选择阻力最小的路径。面对技术障碍或复杂数据时,智能体往往退回到简单的基线或“稳妥”的启发式方法,而不是追求高性能的建模策略。
推理与规模:强推理模型(GPT-5.1-high)显示出明显的领先优势,这表明数据科学所需的那种“持怀疑态度”的坚持——调参、验证和迭代——目前是比单纯参数量更关键的因素。
结论
DSGym 为评估和训练数据科学智能体提供了一个统一框架。我们揭示了当前方法面临的一个根本性挑战:模型在通用任务上严重依赖记忆,而在科学问题上又无法将分析建立在领域知识之上。
通过提供覆盖这两类任务的标准化基准测试,DSGym 使我们能够系统地研究如何构建真正对数据进行推理、而不是回忆模式的智能体。我们还发布了一个能力出色、易于开发和部署的开源数据科学智能体。我们希望这一资源能加速人们朝着更可靠、更具通用性的数据科学自动化迈进。