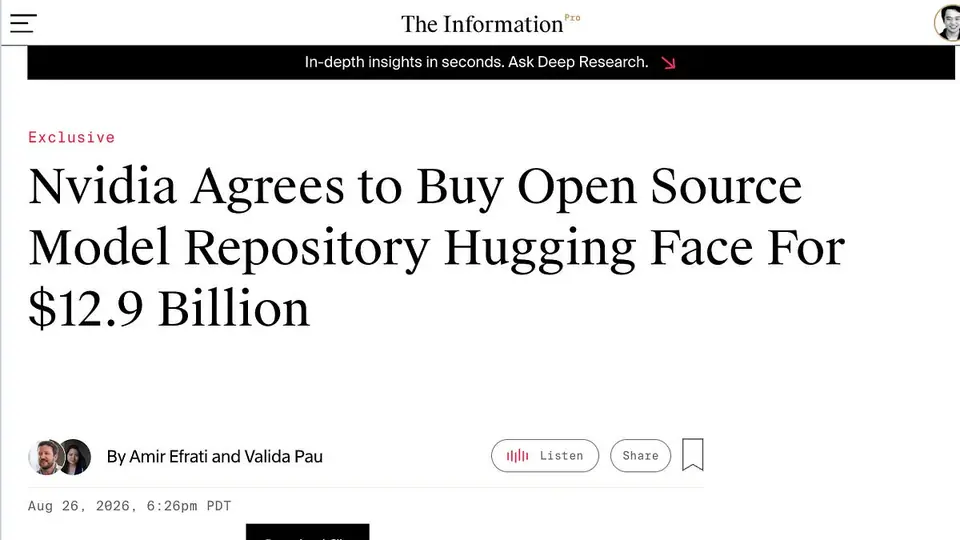
TheInformation 率先爆料,如今已得到证实:Nvidia 将以 130 亿美元收购 HuggingFace,约为其 1.5 亿美元 ARR 的 80 倍,而 HuggingFace 在 2026 年客户群翻了一番。这一价格几乎是 Nvidia 在 2026 年 1 月最初报价 70 亿美元 的两倍。
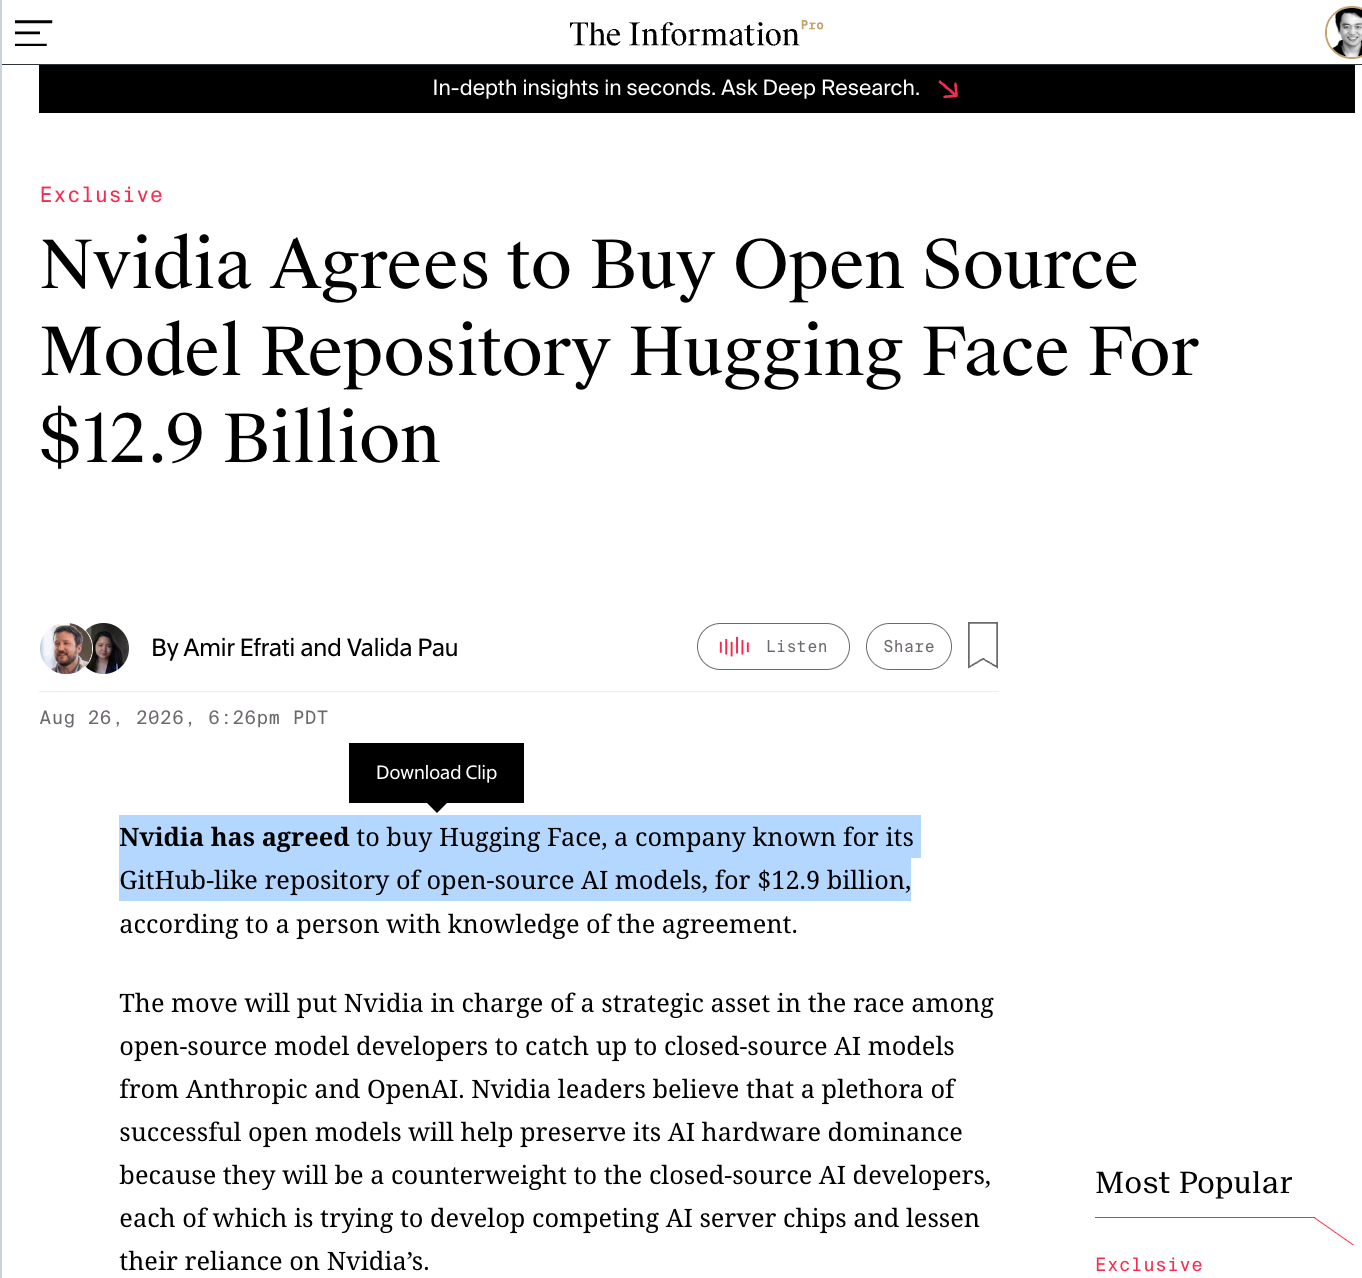
还能说什么呢?我们乐见好人获胜。不过,恰逢 GLM-5.3-Flash(又名 Ox Alpha)惊艳了所有人(GDM 的那些含糊其辞的发帖者除外),Qwen 也在国产芯片上推出了一款出色的 Flash 模型,也许 Hot Chips 之后关于西方开放 AI 的讨论,正是这桩收购的绝佳背景。
AI News,2026 年 8 月 25 日至 26 日。我们查看了 12 个 subreddit、544 个 Twitter 账号,不再包含其他 Discord。AINews 网站支持搜索所有往期内容。再次提醒,AINews 现已成为 Latent Space 的一个栏目。你可以选择订阅或退订不同的邮件频率!
AI Twitter 回顾
头条:GLM 5.3 Flash 发布及各方反应
发生了什么
Z.ai 正式发布 GLM-5.3-Flash,并披露此前预览的“Ox Alpha”模型就是它的公开身份。
- Z.ai 宣布推出 GLM-5.3-Flash,这是一款原生多模态模型,具备 100 万词元上下文窗口、总参数量 3200 亿 / 激活参数量 180 亿,以 MIT 许可证发布,可通过权重、API、聊天、编程套餐和 AutoClaw 使用。
- Z.ai 同时把它定位为 GLM-5.2 的高性价比继任者,并声称在其内部基准测试中,它在每个推理强度档位上都优于 GLM-5.2,在编程方面与 Claude Opus 4.8 相当。
- 此次发布也解开了持续已久的 Ox Alpha 之谜:多位发帖者明确把 Ox Alpha 与 GLM-5.3-Flash 联系起来,包括 SemiAnalysis、rasbt、theo 和 Cline。
- 第三方模型基础设施几乎立刻跟进支持:CoreWeave、Baseten,以及 Cline 在 VS Code / JetBrains / CLI 中提供的免费集成。
- 发布后不久,Z.ai 工程师 Zixuan Li 表示聊天模板已更新,早期下载的用户应重新下载模型,这意味着首日发布时在打包或提示词格式上有过修正。
- Artificial Analysis 最初发布的概览中把上下文窗口误写为 40 万,随后更正为 100 万上下文,与 Z.ai 的原始公告一致。
- 对于一次开放权重发布来说,社区的反响异常强烈:既有“HOLY”这类简短的震惊反应,也有更实质性的论断,认为该模型如今可能是单位成本智能最高的选择,例如 Artificial Analysis 和 zainhas。
- 这次发布被纳入了关于中国前沿开放模型的更大叙事:有帖子认为,中国的开放实验室正在线性注意力、稀疏注意力、残差路径设计和 Muon 等方面趋同于相似的架构选择。
- 至少有一项多模态说法遭到独立质疑:skalskip92 认为,尽管号称“原生视觉”,该模型在多项视觉/目标检测任务上表现很弱。
官方说法与发布细节
Z.ai 的主要发布推文是事实依据,其中对 GLM-5.3-Flash 的描述如下:
- 总参数 3200 亿 / 激活 180 亿
- 100 万词元上下文
- 原生多模态
- MIT 许可证
- 此前以 Ox Alpha 之名预览
- “完全运行在中国 AI 芯片上”
发布时的分发/可用渠道:
- Hugging Face 上的权重
- Z.ai API
- 聊天
- ZCode
- 编程套餐
- AutoClaw
厂商自报的最强性能声明来自 Z.ai 的编程相关推文串:在 Z.ai Code Bench 上,GLM-5.3-Flash “在每个推理强度档位上都明显优于 GLM-5.2,表现与 Claude Opus 4.8 相当”。由于这属于第一方基准测试,它有参考价值,但解读时应比独立评测更为谨慎。
AutoClaw 随后的发布支持帖把该模型描述为适合视觉语言理解、代码生成和长程智能体任务,并将可用性与额度/返利搭配推出,但这主要是上线信息,而非新的技术证据:AutoClaw 发布帖。
独立基准测试与性价比定位
这批推文中最实质的独立评测来自 Artificial Analysis。其总结是:GLM-5.3-Flash 在 Artificial Analysis 智能指数上得分 57。
引用的 Artificial Analysis 指标
- AA 智能指数得分:57
- 与 GLM-5.3 的差距:比 60 分的 GLM-5.3 低 3 分
- 单任务成本:0.09 美元
- API 价格:输入 0.15 美元 / 100 万词元,输出 0.50 美元 / 100 万词元
- 缓存输入:约 0.026–0.03 美元 / 100 万词元,称为 8 折优惠(即降价 80%)
- 模型规模:总计 3200 亿 / 激活 180 亿
- 许可证:MIT
- 上下文:最初标注为 40 万,后更正为 100 万
Artificial Analysis 引用的对比
- 与 GPT-5.6 Terra 和 Muse Spark 1.2 并列 57 分,但单任务成本低得多。
- 0.09 美元/任务,而 GLM-5.3 max 为 0.68 美元/任务。
- 声称单任务成本比 GLM-5.3 max 低约 7.5 倍。
- 声称单任务成本比 GPT-5.6 Terra 便宜约 5.7 倍,比 Muse Spark 1.2 便宜约 4.4 倍。
词元效率与推理构成
Artificial Analysis 指出了一个有趣的权衡:
- GLM-5.3-Flash 运行智能指数共用了 1.49 亿输出词元
- 而 GLM-5.3 为 1.68 亿
- 但多于智能指数得分相近的 Kimi K3(1.33 亿)和 Qwen3.8 2.4T A95B(1.36 亿)
- 1.49 亿词元中的 1.34 亿(约 90%)是推理词元
这一点很值得注意:该模型的经济性之所以出色,主要是因为词元定价极低,而不是因为它特别省词元。
Artificial Analysis 的智能体/工作类评测
Artificial Analysis 还指出,GLM-5.3-Flash 在智能体任务上比其原始知识类指标所暗示的更强:
- GDPval-AA v2 Elo:1770
- 在误差范围内与 GLM-5.3 和 Grok 4.6 持平
- 仅次于 Claude Opus 5 xhigh/max
- Terminal-Bench v2.1:84.3%,GLM-5.3 为 83.9%
- τ³-Banking:47.2%,落后 GLM-5.3 3.1 个百分点
知识/幻觉数据
- AA-Omniscience 得分:+7
- 准确率:28%
- 幻觉率:28%
- 对比 GLM-5.3:
- GLM-5.3 准确率 34%
- GLM-5.3 幻觉率 30%
- 对比 GPT-5.6 Terra:
- Terra 准确率 47%
这点反映出各方反应中反复出现的一个主题:GLM-5.3-Flash 可能在实际代码/智能体工作流上,比在广泛的现实世界事实知识上强得多。
架构与系统细节
若干懂技术的反应者尝试反向推断或总结它相对 GLM-5.2 / GLM-5.x 的变化。
这批推文中最详细的公开架构拆解来自 rasbt,他称 GLM-5.3-Flash 从 GLM-5.2 的 744B-A40B 主干变为 320B-A18B,并采用了:
- Kimi Linear 风格的 3:1 混合注意力
- 34 个 KDA 层(Kimi Delta Attention)
- 11 个 MLA/DSA 层
- MLA = Multi-head Latent Attention(多头潜在注意力)
- DSA = DeepSeek Sparse Attention(DeepSeek 稀疏注意力)
- DeepSeek V4 风格的 mHC 残差路径
- 四条并行数据流
- 外加原生视觉编码器
同一条推文称其为“超级混合”,因为两种主要的注意力组件本身都已是“高效”变体,而不是简单的高效/全注意力混合。
thealexker 的另一篇偏系统视角的总结,把这次发布视为一个效率故事,并强调:
- 与 GLM-5.2 相比:
- 成本约为 1/10
- 激活参数 320 亿 → 180 亿
- 层数 92 → 45
- 线性 + 稀疏混合注意力
- 每层平均 KV 缓存更小
- 长上下文下注意力计算量的降低效应不断叠加
- 称视觉智能受益于编程/RL 风格的改进
- 称 GLM-5.3 基础设施智能体通过协助处理内核、瓶颈和服务栈优化,参与撰写了部分工作
eliebakouch 的背景帖带有个人观点,但在技术上值得关注,因为它把 GLM 放进了中国开放模型的趋势之中:
- 几乎所有中国前沿模型现在都使用线性注意力
- 几乎都使用稀疏注意力 / 索引器压缩设计
- 许多使用花式残差,如 mHC、注意力残差、门控残差
- 许多使用 Muon
这条帖子并非对 GLM 论文的直接总结,但它有助于解释为什么这些架构细节立刻引起了模型工程师的共鸣:GLM-5.3-Flash 似乎是又一个数据点,印证了一个快速趋同的以效率为先的中国前沿开源设计空间。
国产芯片角度与服务部署的影响
硬件/服务部署方面是这次发布中讨论最多的部分之一。
Z.ai 自己表示该模型“完全运行在中国 AI 芯片上”。传播力度最大的是 SemiAnalysis,它聚焦于“中国芯片上每天处理 100T 词元”这一说法。该推文并未给出完整的推导,但把这一基础设施成就描述为此次披露中最令人震惊的部分。
各方反应都强调了其意义:
teortaxesTex 还给出了明确的容量粗算:
- 如果推理经济性与 V4-Flash 相当,
- 每个 NPU 每秒 1 万词元是“现实的”
- 每块芯片每天 8.64 亿
- 每天 100T意味着约需 11.6 万块芯片
- 表明规模在 10 万块以上芯片,“可行”,但会消耗总算力中的很大一部分
这一估算是推测而非证实,但它显示了工程师们如何解读这条服务部署声明:不只当作营销话术,而是视为一种基础设施层面的表态,意味着庞大的国产加速器集群和成熟的推理优化。
采用与分发方面的反应
这一轮反应中值得注意的一点,是使用情况的帖子出现得有多快。
Cline 称 GLM-5.3 Flash 已是其历史上增长最快的模型,不到一周就占了全部流量的 11%,同时宣传它在 Cline 中免费。这在一定程度上是宣传,但也是一个具体的需求信号。
基础设施提供商反应迅速:
- CoreWeave:“即将登陆 CoreWeave Serverless Inference”
- Baseten:首日可用,强调通用智能 + 智能体编程、原生视觉和 100 万上下文
- Dell(通过 Jeff Boudier):把 GLM 5.3 Flash 和 Qwen 3.8 Flash 描述为可用于本地部署的开放模型
这很重要,因为它表明 GLM-5.3-Flash 并未被当作新奇玩意儿;它立刻被纳入了真实的推理/开发者技术栈。
事实与观点
事实 / 可由外部溯源的说法
- Z.ai 发布了 GLM-5.3-Flash:总计 3200 亿 / 激活 180 亿、100 万上下文、MIT 许可、多模态,此前以 Ox Alpha 之名预览。
- Z.ai 声称该模型运行在中国 AI 芯片上。
- Artificial Analysis 报告了 AA 智能指数 57 和每任务 0.09 美元的成本,以及各项基准测试细节和定价。
- Artificial Analysis 随后将上下文标注从 40 万更正为 100 万。
- Zixuan Li 表示聊天模板已更新,模型用户应重新下载。
- Cline 称该模型不到一周就占了全部流量的 11%。
- Baseten、CoreWeave、AutoClaw 等宣布提供支持/分发。
观点 / 解读
- theo、zephyr_z9 和 nicdunz 表达了强烈的惊喜。
- thealexker 主要把这次发布解读为一个效率工程的故事。
- eliebakouch 将其视为中国前沿开放架构令人兴奋地趋同的证据。
- zainhas 认为它现在是单位成本智能最高的选择。
- skalskip92 认为该模型视觉能力差,反驳了发布时的多模态定位。
- scaling01 称 Ox Alpha 是 GLM 模型“痛苦地明显”,并进一步指称 ZAI 使用了炒作账号;这一说法在这批推文中未得到证实。