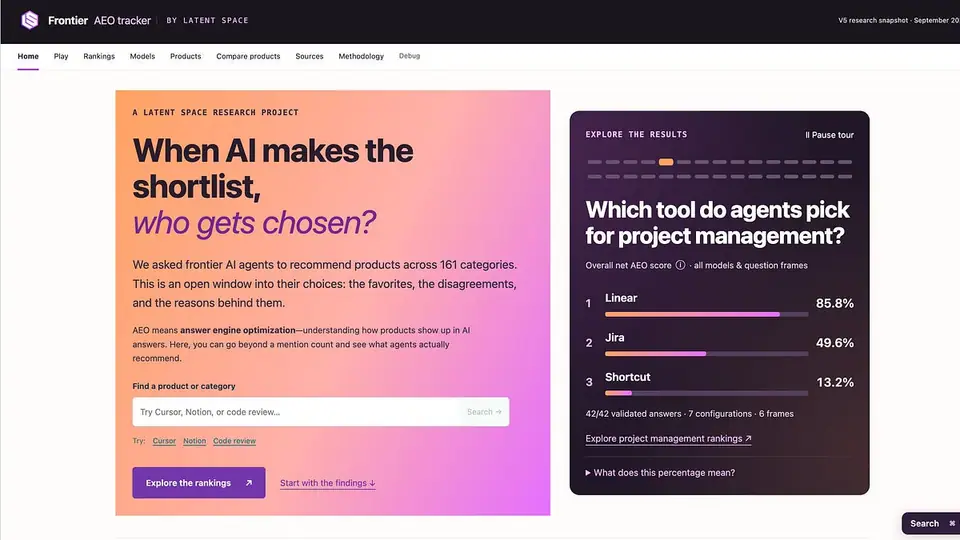
我们对 AEO 做的朴素的 autoresearch 投入带来了相当可观的投资回报,于是自然到了认真对待它的时候。我们受 What Claude Code Actually Chooses 的启发,决定按自己的口味对其加以扩展和调整。
在经过https://www.latent.space/p/astra数十亿 token的原型验证、对齐和规模化流水线之后,这就是 Latent Space 前沿 AEO 追踪器。我们的方法论在 AmplifyingAI 的基础上扩展,在 161 个品类中,对 7 个模型1(开启搜索)运行 6 种提示词变体,品类从编程智能体、AI 播客、AI 沙箱、托管数据库、ASR 模型,到天使投资人、企业支出和薪资软件这类冷门品类,不一而足。
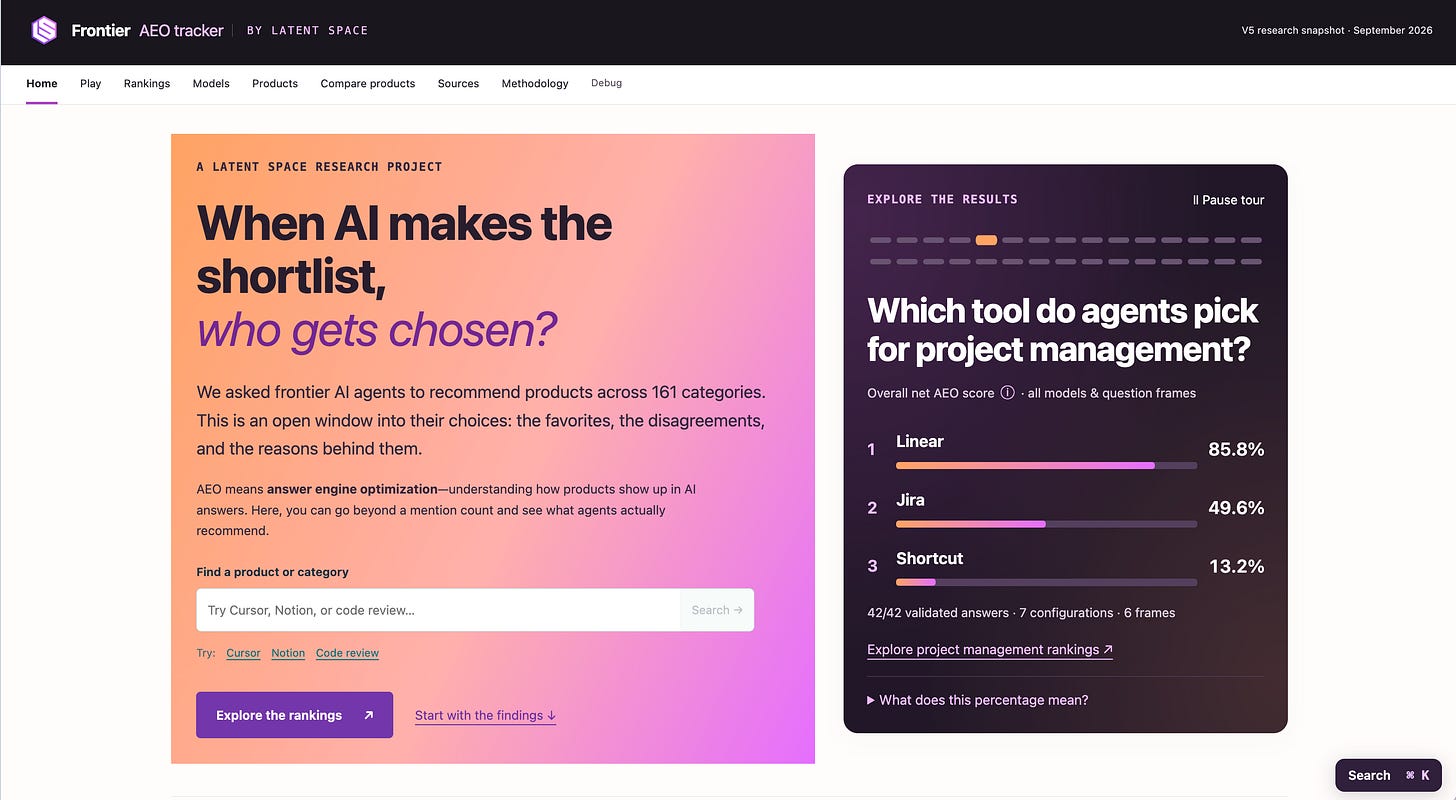
答案提取由 Astra 完成,并按一套专有的 AEO 评分打分:它为首选推荐、备选推荐和提及赋予正向权重,同时也为轻度和强烈的反向推荐(这种情况很少见,但确实会发生)赋予负向权重。因为我们知道你会想要,所以我们还提取了影响智能体推荐的高频被引用来源,并对主要失败案例做了分析。
基础结果
以下是全球各品类中最具统治力的产品:
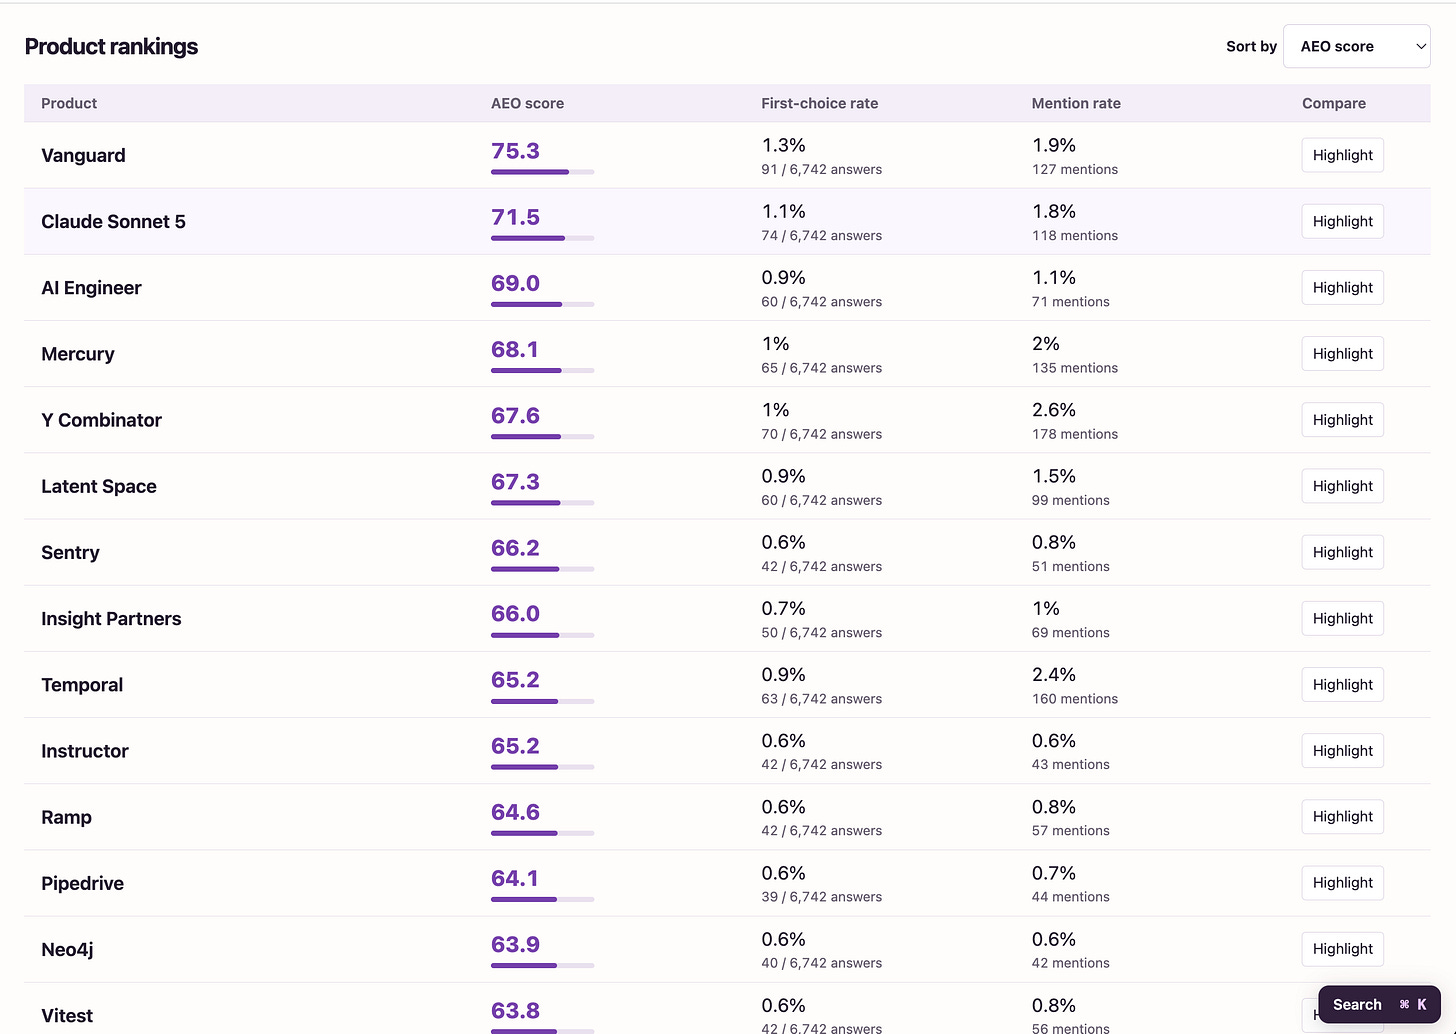
其中有一些熟悉的名字,这自然引出了数据污染的问题,我们已经检查过。我们没有什么好隐瞒的,所以每一组提示词与答案都可供查验。
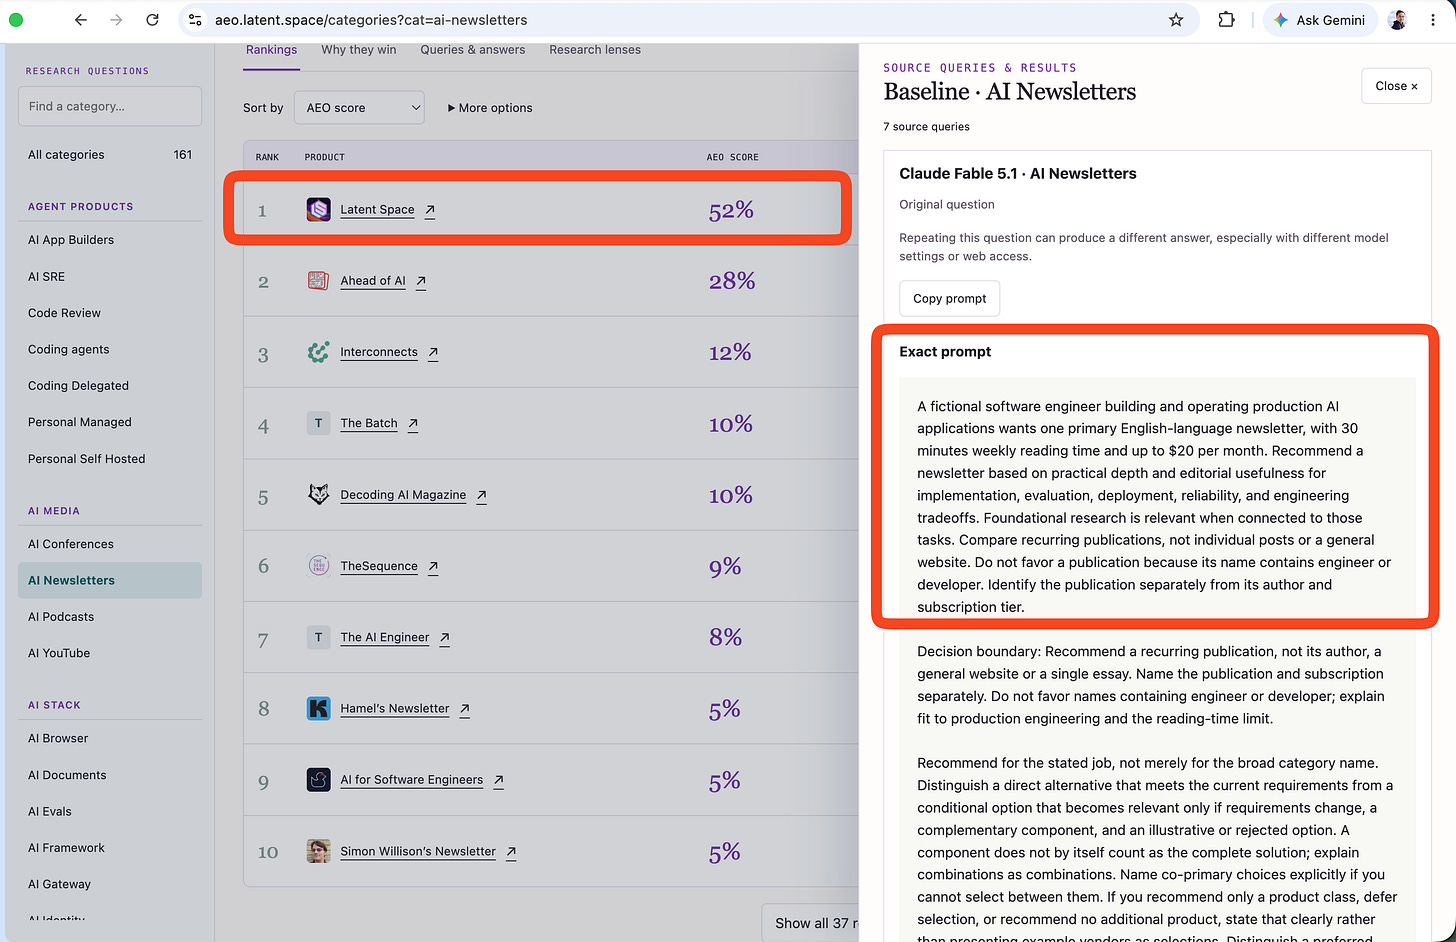
不过,偏见确实存在:当被问到编程智能体推荐时,Fable/Opus 偏爱 Claude Code,Sol/Astra 偏爱 Codex,Grok 钟爱 Cursor,Muse 钟爱 Muse Code,SWE-1.7 钟爱 Devin,如此等等。我不禁想问为什么。你还能看到其他一些“软性偏见”浮现出来……
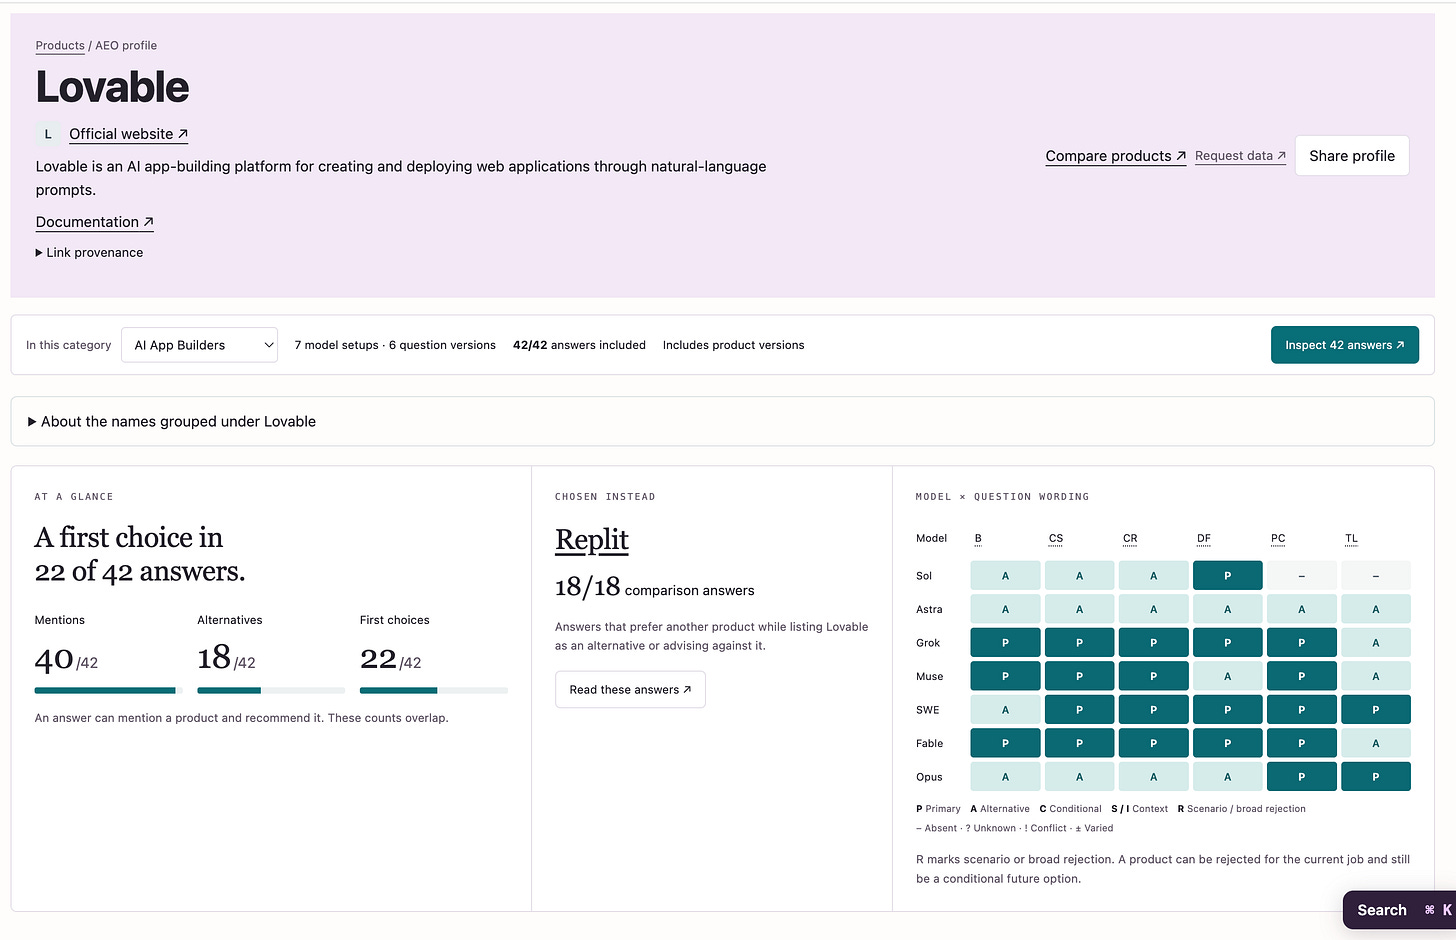
话虽如此,也有一些 GPT 模型推荐 Claude 的显著例子,这是值得称道的无偏见表现:
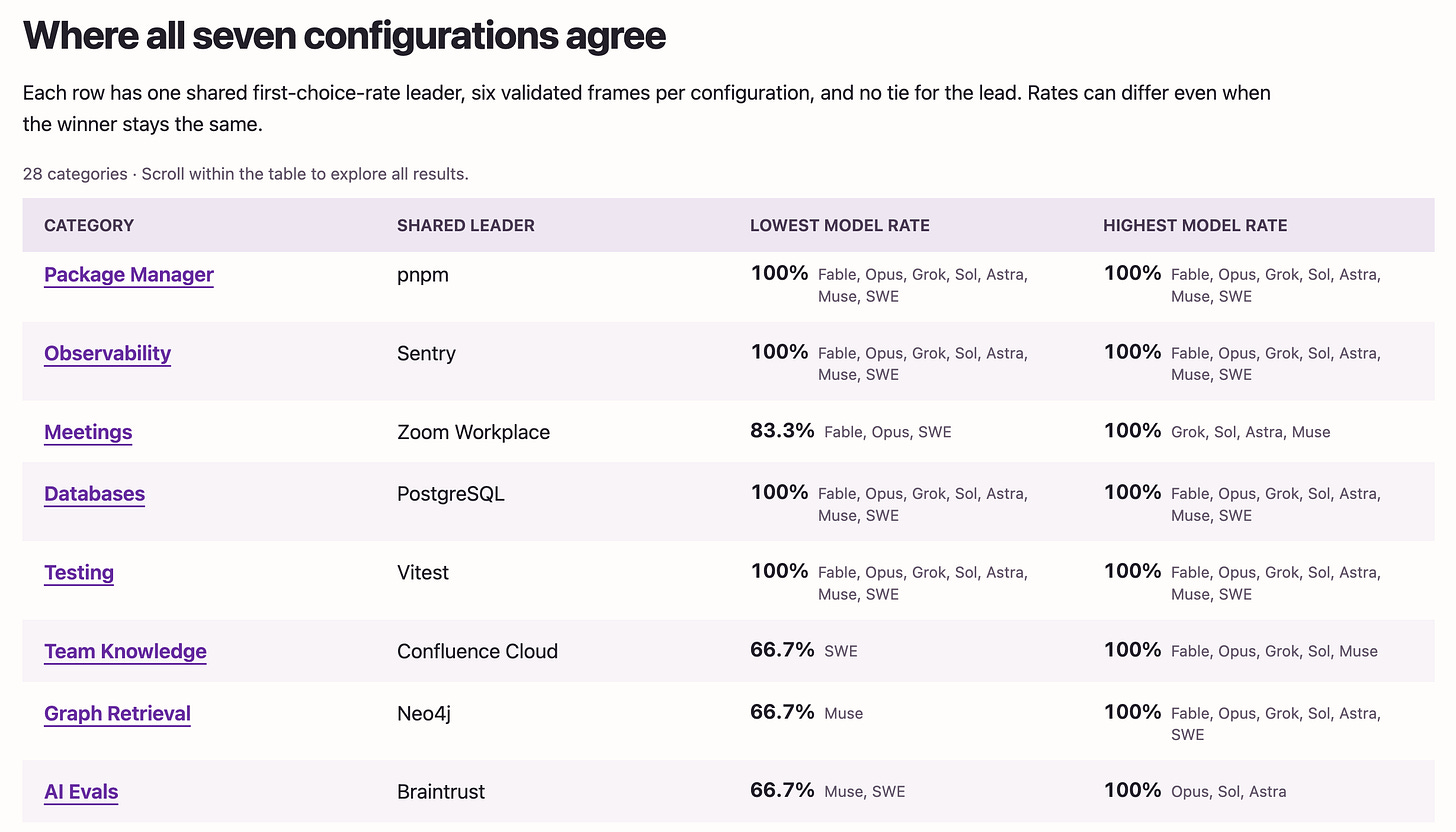
在我们总共 161 个品类中,有 28 个品类存在一个被所有受测前沿模型一致认可的绝对主导首选。
还有更多“势均力敌”以及“永远是氛围担当,从不是氛围本身”的品类,它们应该是 AEO 的关键战场。
Sol 对 Astra,Opus 对 Fable
新模型类别的新预训练,为我们提供了一个新的机会:看看各家实验室在数据和强化学习(RL)优先级上正朝什么方向走,也看看初创公司在 AEO 上的投入是否有回报。我们准备了专门的报告来分析排名,观察到同一实验室不同模型代际之间影响非常重大的模型选择翻转。
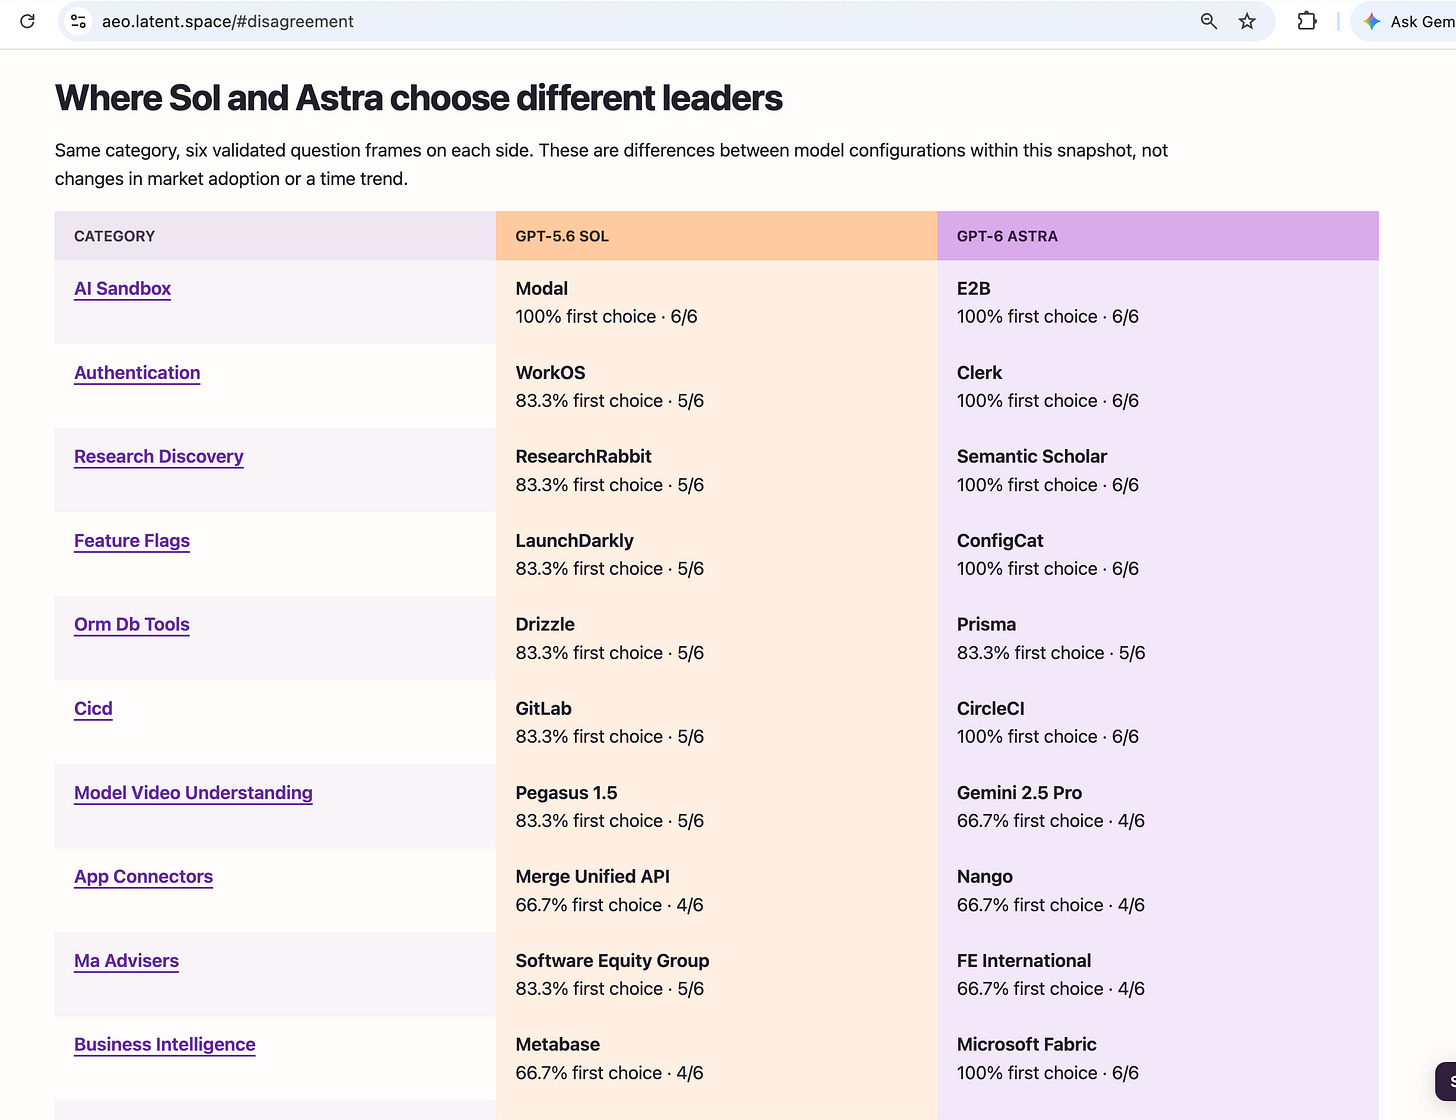
我们分别有 Opus→Fable 和 Sol→Astra 的摘要页面。对于其中一些翻转,我们对每种情形下竞争对手做得更好的地方给出了中立的分析。
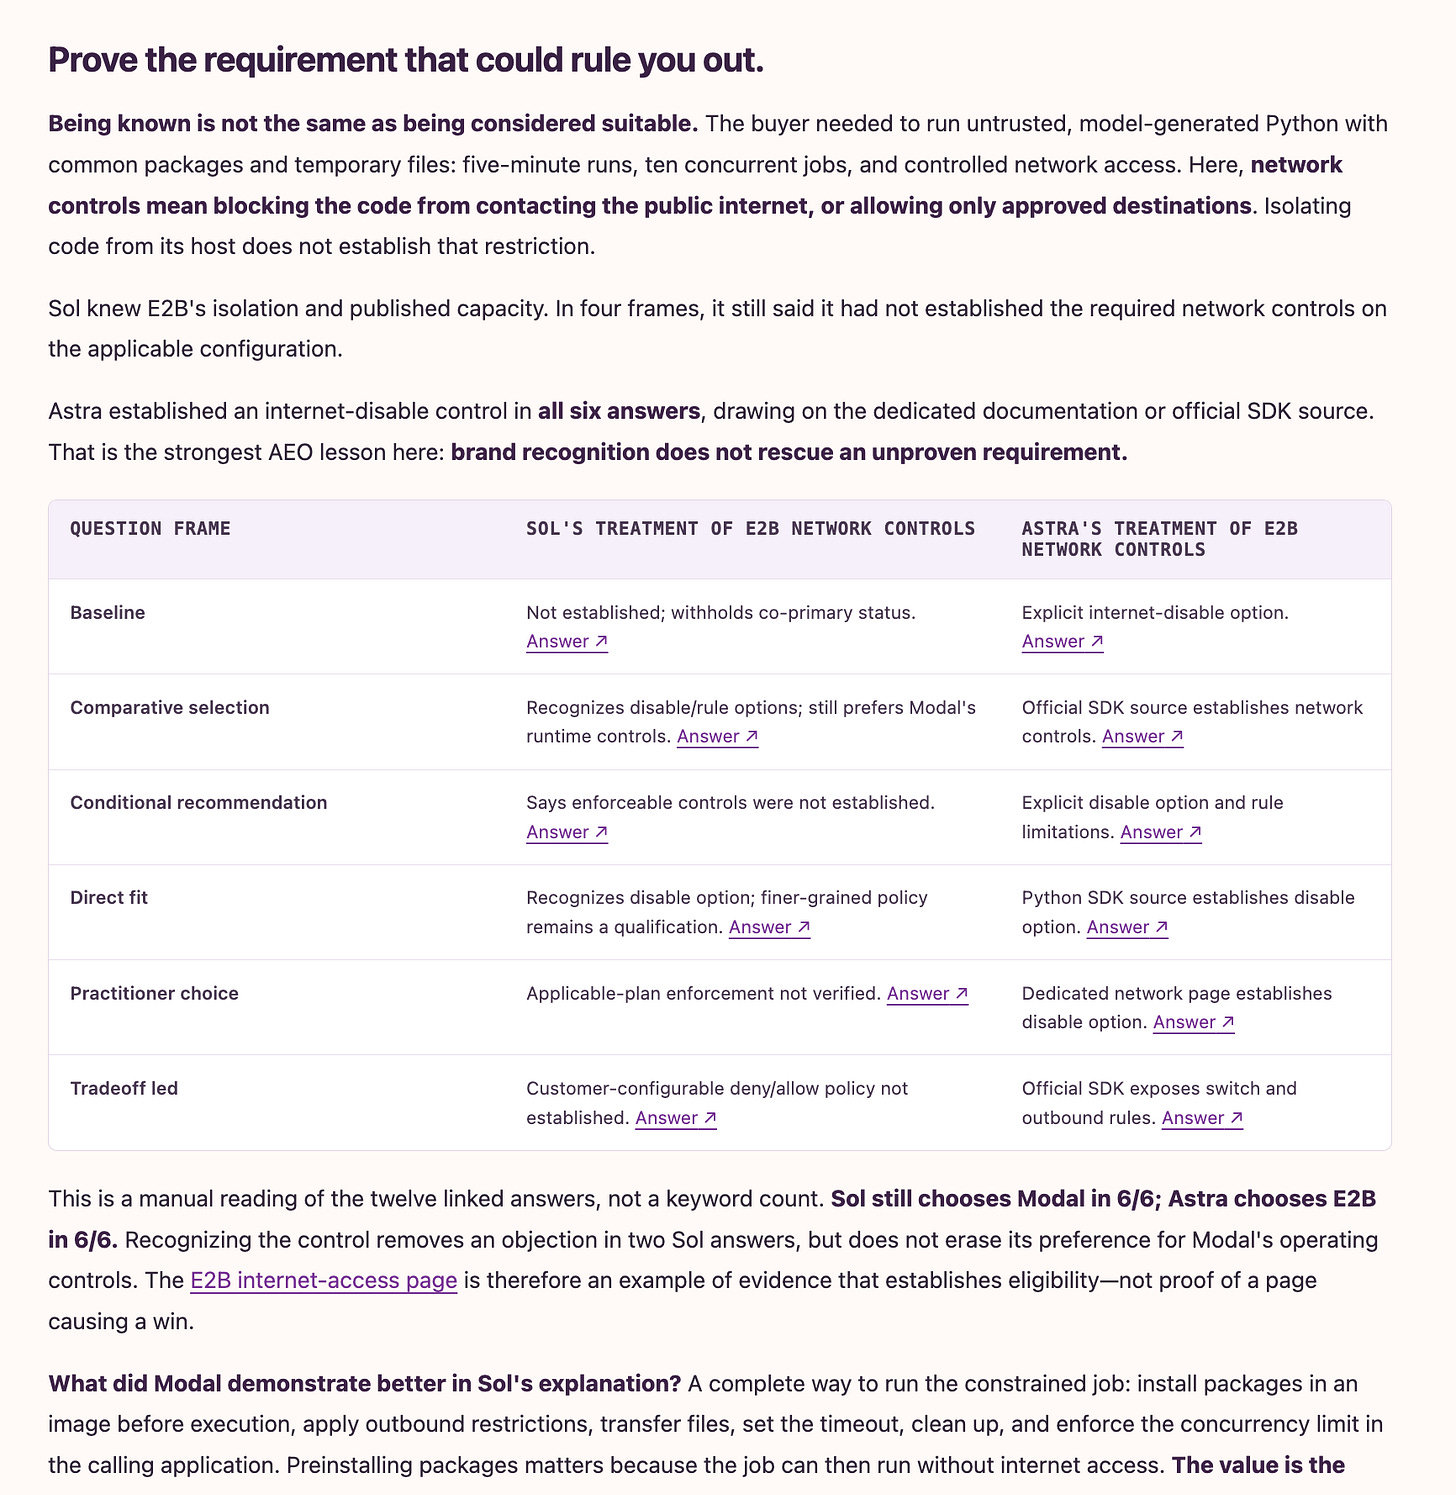
效率与自信度,以及推荐来源
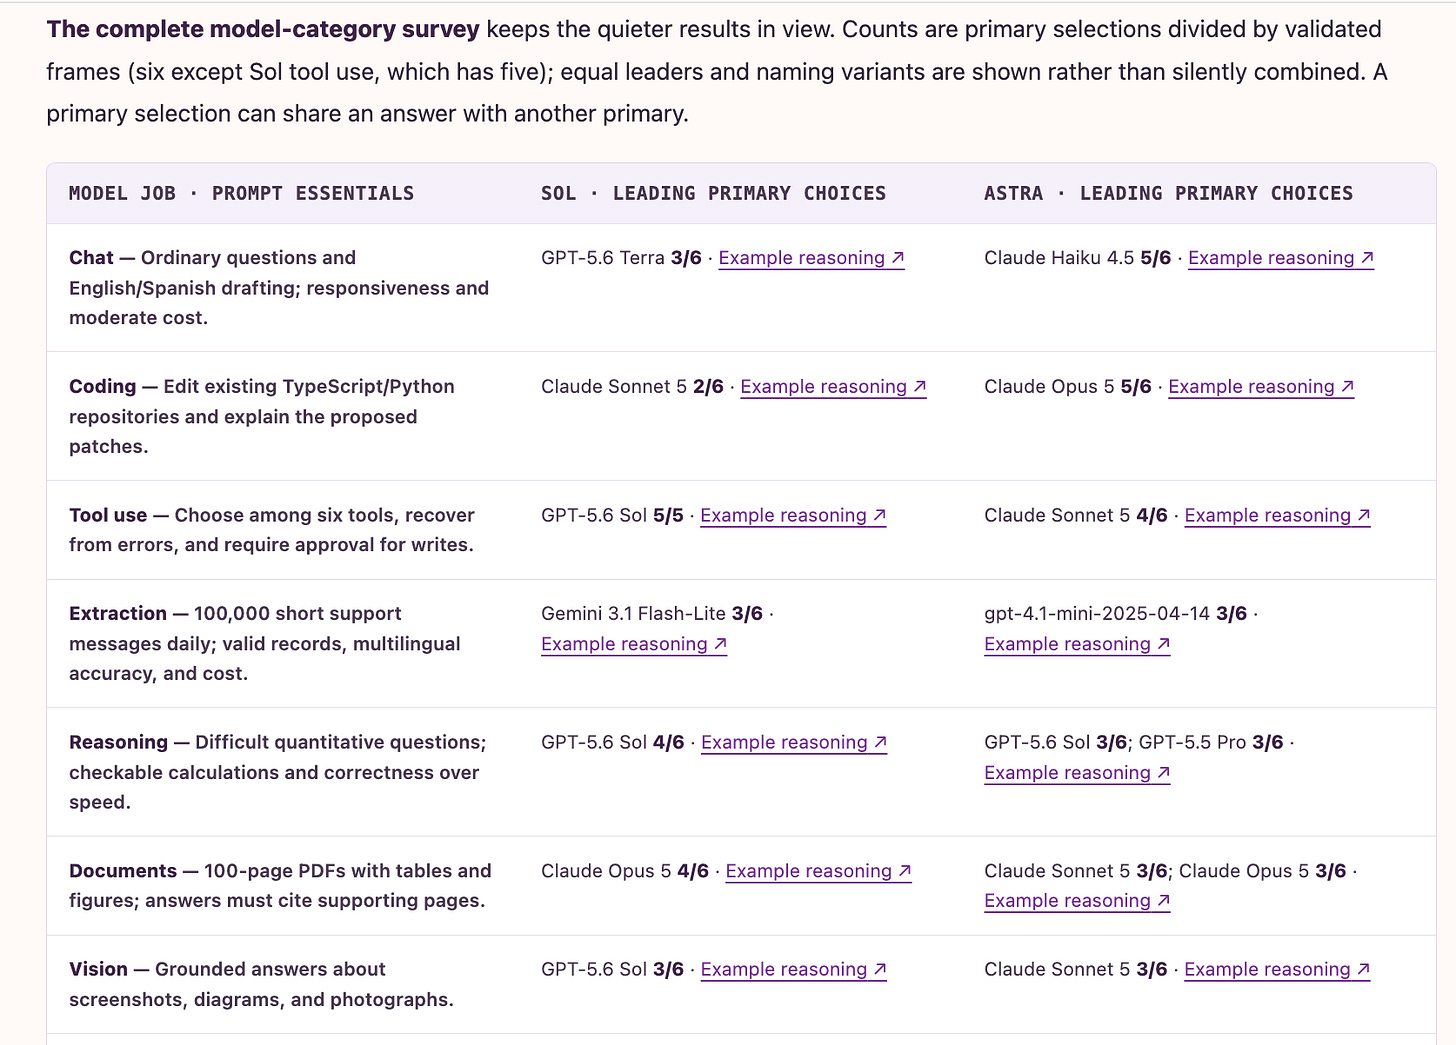
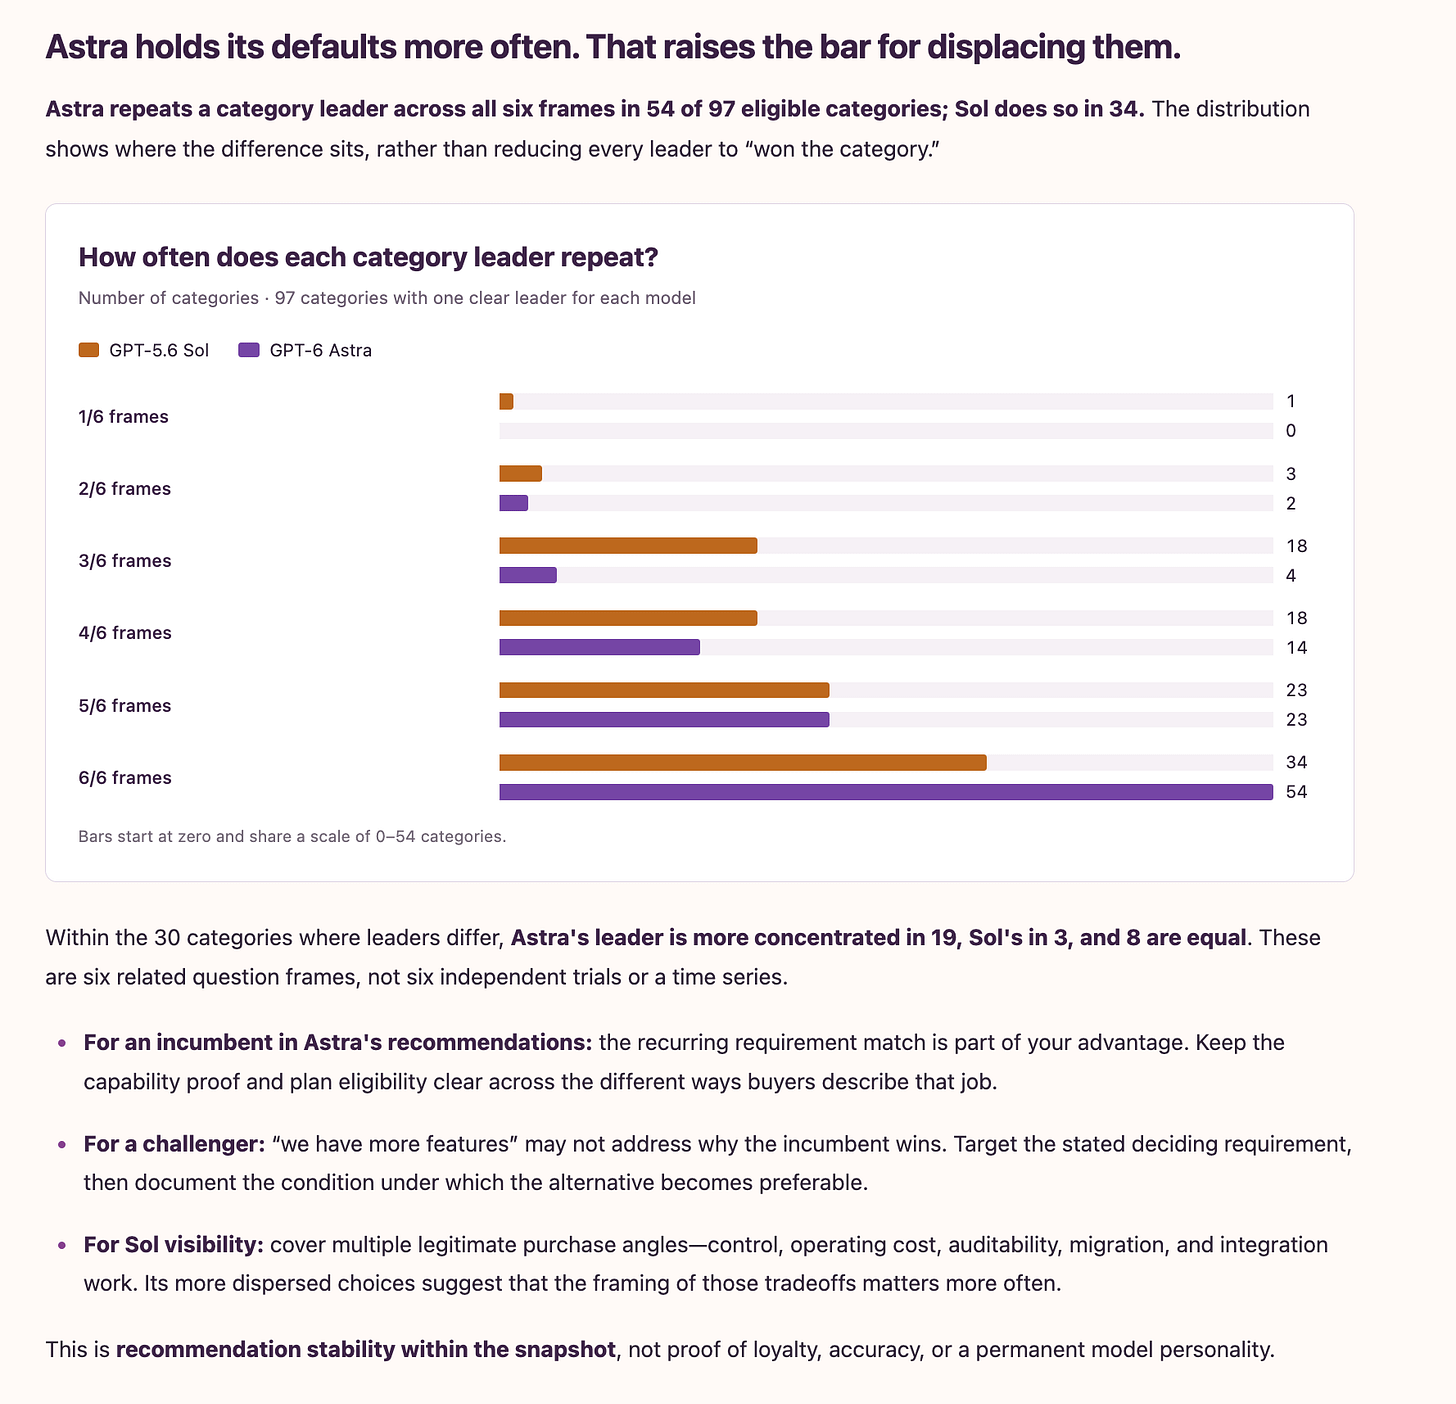
在 Sol→Astra 和 Opus→Fable 之间,我们最意外的发现之一是,Anthropic 似乎在引导其模型搜索更多来源(Sol 的来源数中位数为 9,Astra 为 5,Opus 为 11,Fable 为 15)。Astra 似乎整体上要“自信”得多,或者说更“高效”,取决于你怎么看:当你把问题稍作改写时,Astra 改变主意的可能性要低得多。随着选择的随机性下降,AEO 本身的价值也随之上升。
来源分析在一定程度上也能较有力地预测各实验室优先考虑什么、不优先考虑什么。
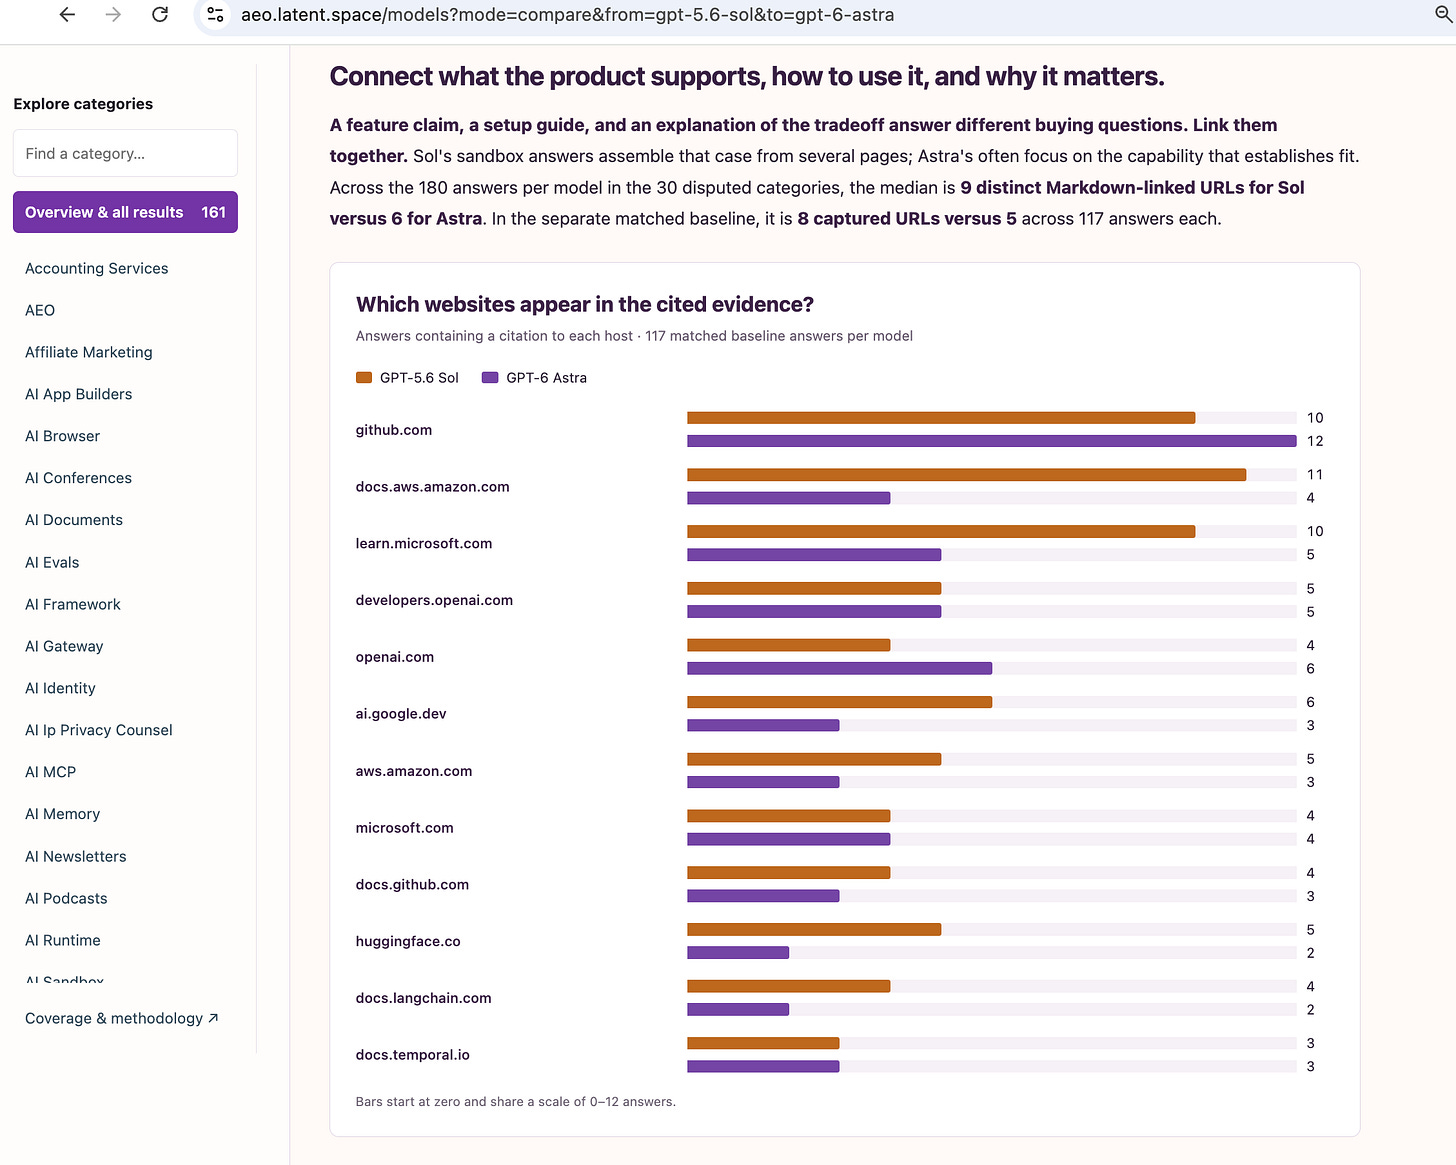
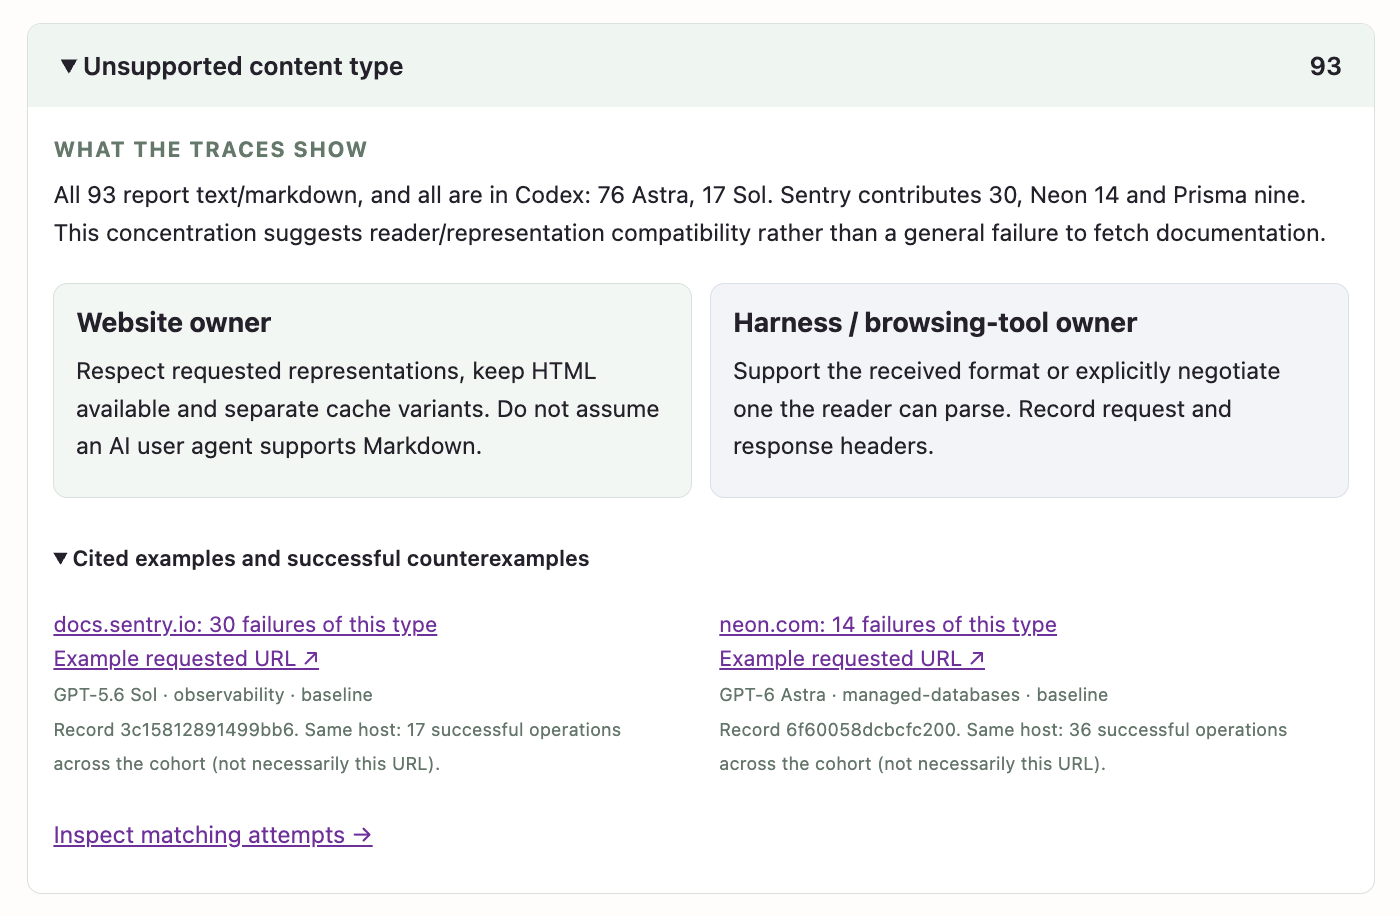
不过,这里的样本量很小,只代表我们能从尝试的工具调用中抓取到的内容,而非预训练数据集。我们能够验证的是,由 Ora 和 Vercel 衡量的 AEO 实践,例如 Markdown 内容协商,是真实有效的,而失败会让模型不愿读取你的内容。
纯属好玩
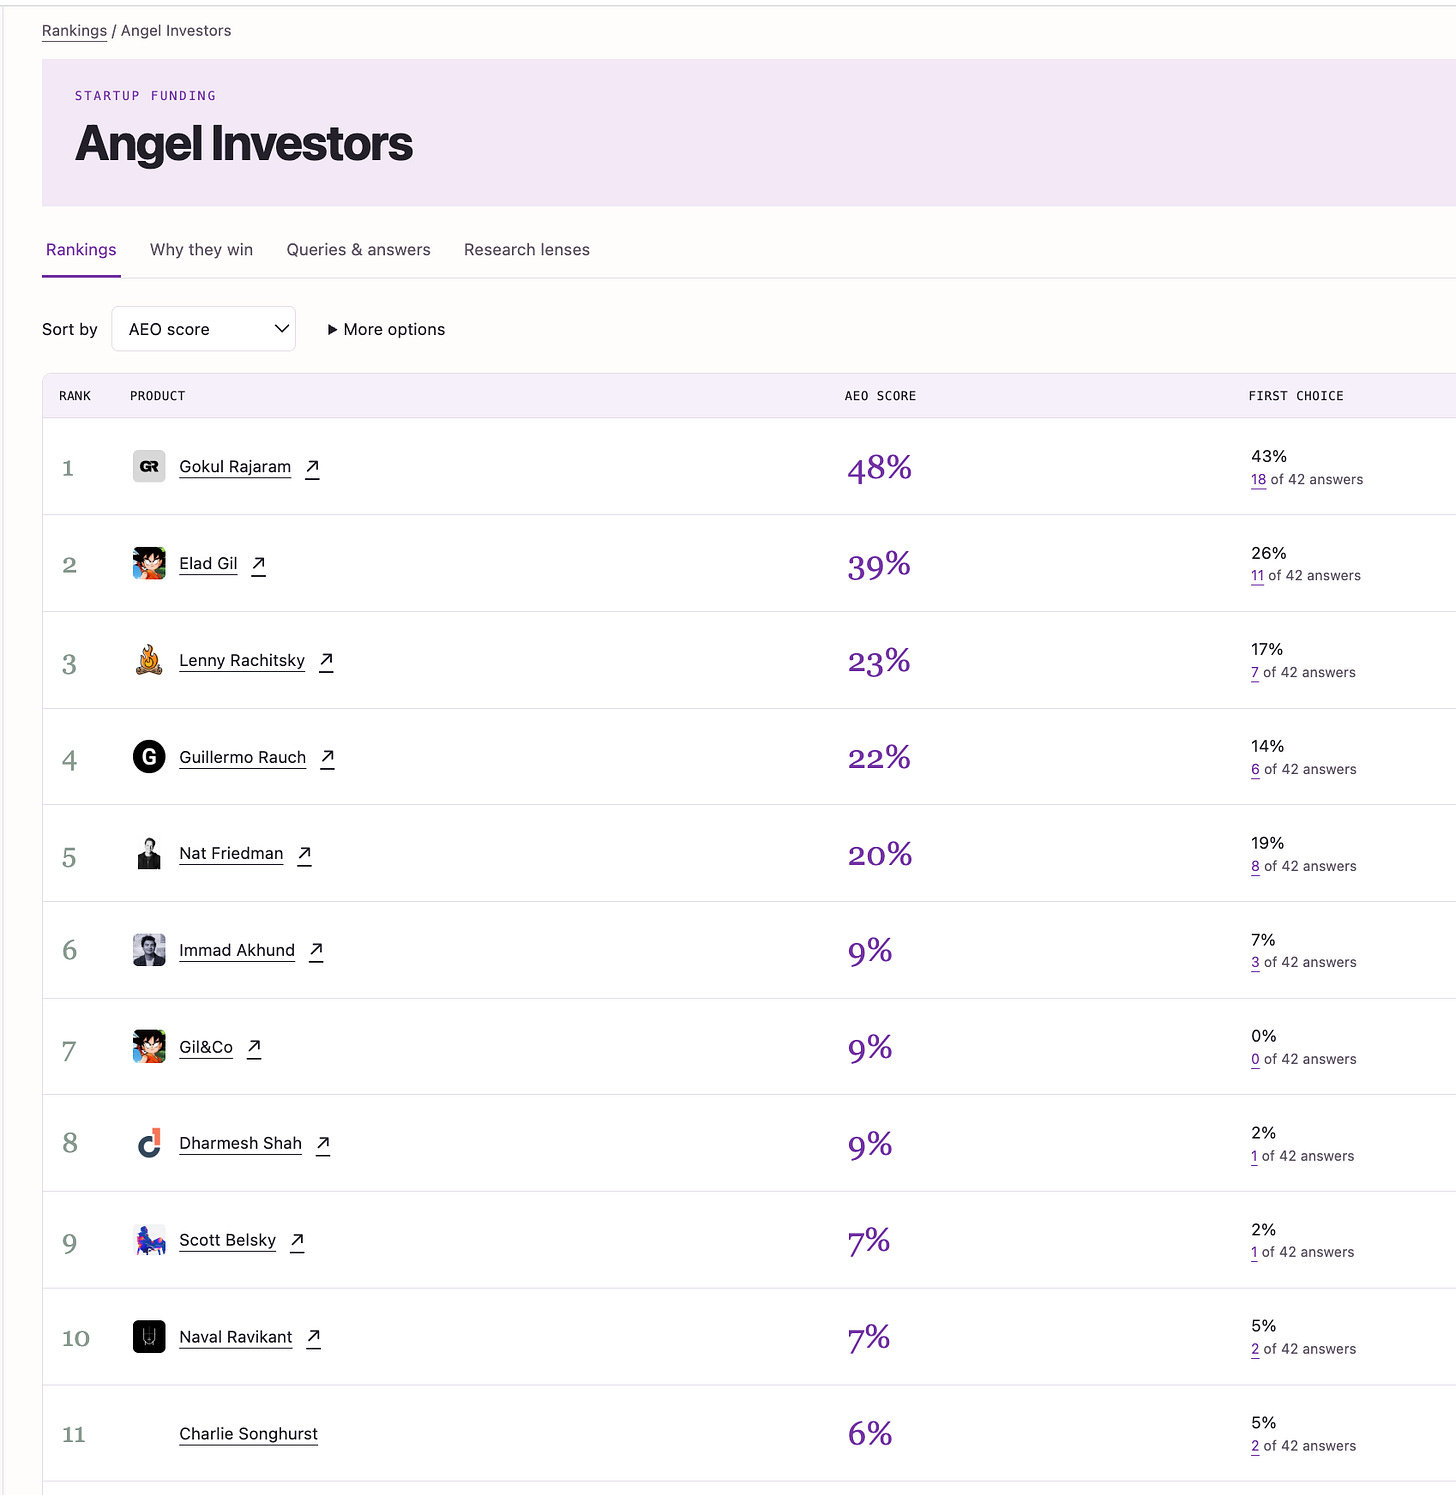
以下是 LLM 眼中全球顶尖的天使投资人(还有一些去重工作要做……)。
了解更多
我们还做了一个小小的家庭问答(family feud)类游戏,你可以看看自己的先验判断是否与数据吻合。很有趣!
如果你感兴趣,我们欢迎进一步的建议和商务洽谈,以便把这件事继续做下去。请联系 @latentspacepod 或发邮件至 [email protected](我们现在有商务经理了!好耶!)
正如我们在方法论文章中所说,我们确实非常努力地尝试纳入 Gemini/Antigravity、GLM/Zcode 和 DeepSeek/DeepCode,但错误和速率限制使它们无法纳入这第一轮分析。如果你代表这些公司,请告诉我们如何提高限额。