模型上下文协议(Model Context Protocol,MCP)可以为 LLM 智能体配备可能多达数百个工具,用来解决现实世界的任务。但我们如何才能让这些工具发挥最大效用呢?
在这篇文章中,我们介绍在各类智能体 AI 系统中提升性能的最有效技巧1。
我们首先介绍如何:
- 构建并测试工具原型
- 借助智能体,为工具创建并运行全面的评估
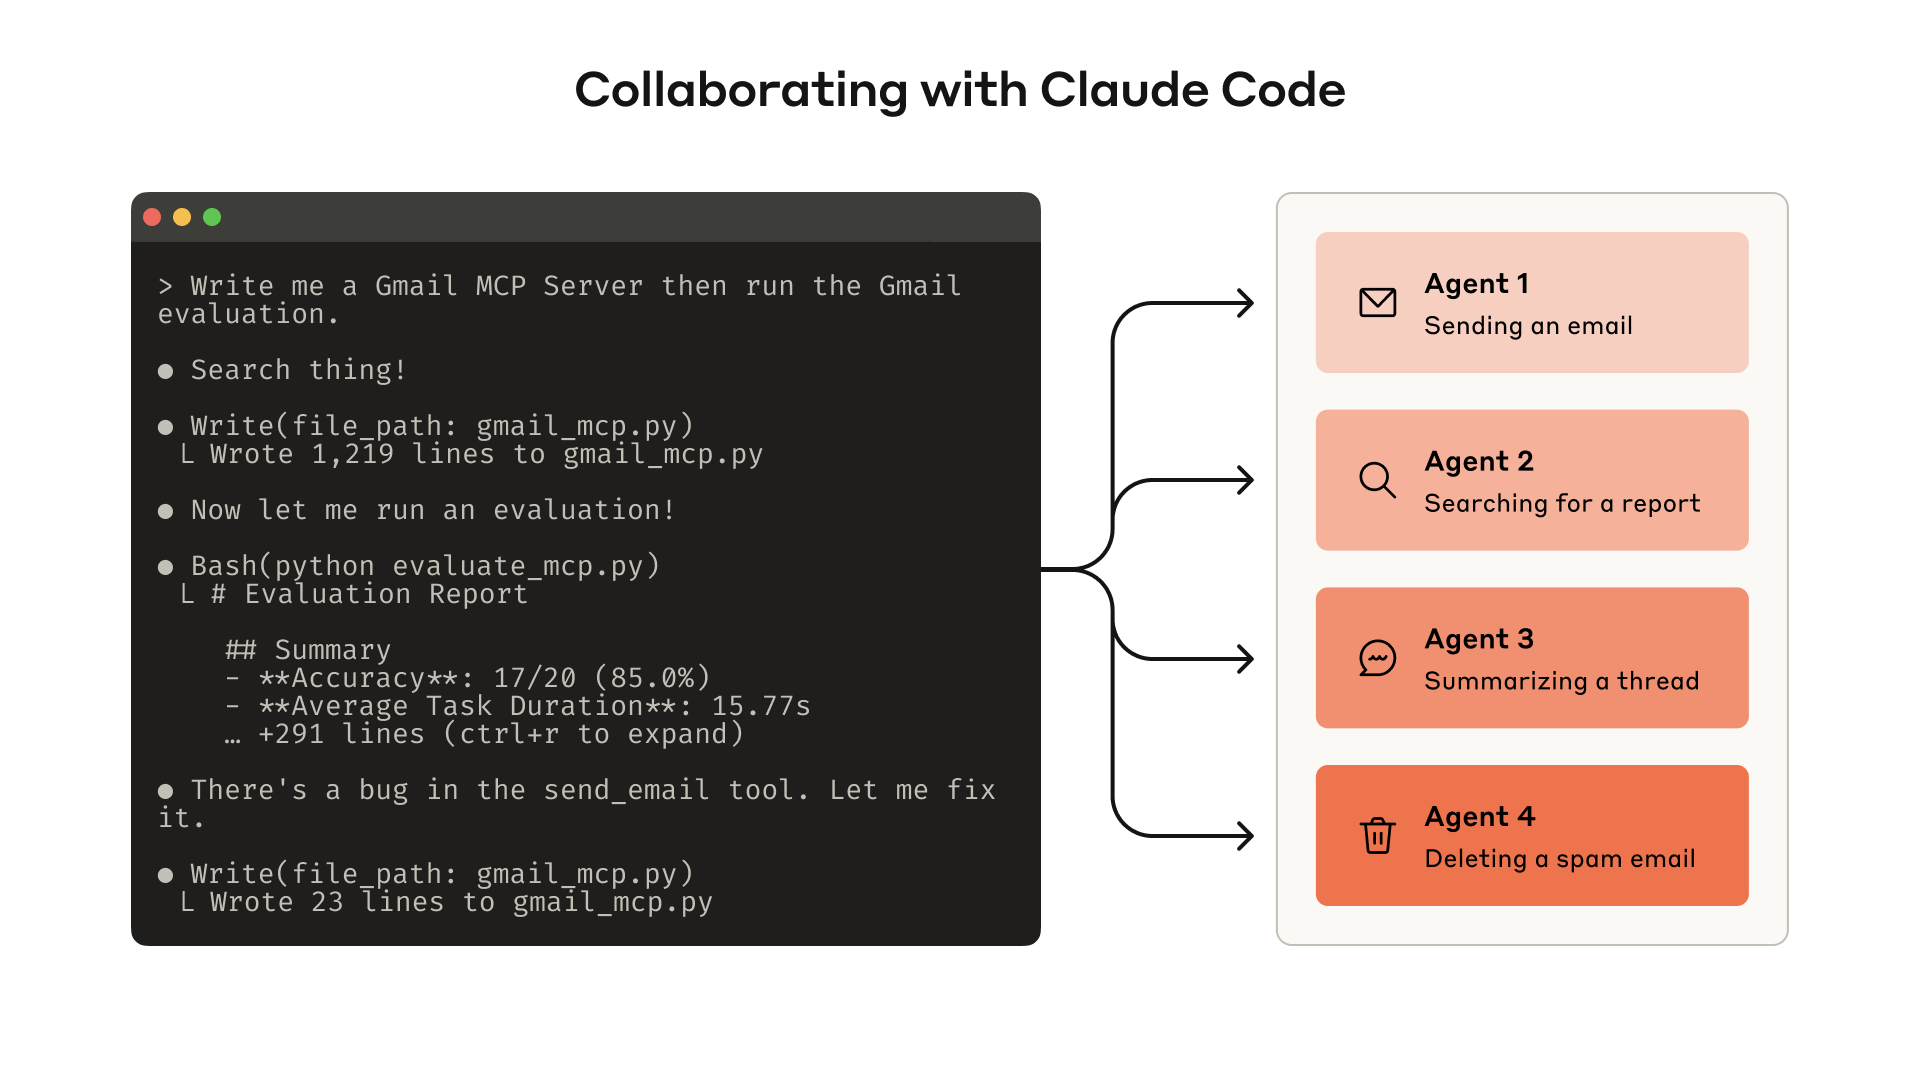
- 与 Claude Code 等智能体协作,自动提升工具的性能
最后,我们总结一路走来提炼出的编写高质量工具的关键原则:
- 选择该实现(以及不该实现)哪些工具
- 为工具划分命名空间,以界定清晰的功能边界
- 让工具向智能体返回有意义的上下文
- 优化工具响应以提高 token 效率
- 对工具描述和规范进行提示词工程
什么是工具?
在计算领域,确定性系统在输入相同时每次都会产生相同的输出,而非确定性系统(比如智能体)即使起始条件相同,也可能生成不同的响应。
传统上编写软件时,我们是在确定性系统之间建立契约。例如,像 getWeather(“NYC”) 这样的函数调用,每次调用都会以完全相同的方式获取纽约市的天气。
工具是一种新型软件,它体现的是确定性系统与非确定性智能体之间的契约。当用户问“我今天该带伞吗?”时,智能体可能会调用天气工具,可能凭一般常识作答,甚至可能先反问用户所在的位置。偶尔,智能体还可能产生幻觉,甚至无法理解如何使用某个工具。
这意味着,为智能体编写软件时,我们需要从根本上重新思考做法:不能再像为其他开发者或系统编写函数和 API 那样去编写工具和 MCP 服务器,而是要专门为智能体来设计它们。
我们的目标是,借助工具追求多种成功策略,扩大智能体能够有效解决各类任务的范围。幸运的是,根据我们的经验,对智能体最“符合人体工学”的工具,对人类来说也出奇地直观易懂。
如何编写工具
本节介绍如何与智能体协作,既用来编写,也用来改进你交给它们的工具。首先,快速搭建工具原型,并在本地测试。接下来,运行全面的评估,以衡量后续的各项改动。与智能体一起,你可以反复评估和改进工具,直到智能体在现实世界的任务上表现出色。
构建原型
如果不亲自上手,就很难预料智能体会觉得哪些工具顺手、哪些不顺手。先快速搭建工具原型。如果你使用 Claude Code 来编写工具(有可能一次成型),不妨把工具所依赖的任何软件库、API 或 SDK(可能包括 MCP SDK)的文档提供给 Claude。对 LLM 友好的文档通常可以在官方文档网站上的扁平 llms.txt 文件中找到(这里是我们的 API 文档)。
将工具包装进本地 MCP 服务器或桌面扩展(Desktop extension,DXT),你就可以在 Claude Code 或 Claude Desktop 应用中连接并测试这些工具。
要将本地 MCP 服务器连接到 Claude Code,请运行 claude mcp add <name> <command> [args...]。
要将本地 MCP 服务器或 DXT 连接到 Claude Desktop 应用,请分别前往 Settings > Developer 或 Settings > Extensions。
工具也可以直接传入 Anthropic API 调用,以进行程序化测试。
亲自测试这些工具,找出粗糙之处。收集用户的反馈,对你期望工具支持的使用场景和提示词建立直觉。
运行评估
接下来,你需要通过运行评估来衡量 Claude 使用你的工具的效果。首先,基于真实世界的用法生成大量评估任务。我们建议与智能体协作,帮助分析结果并确定如何改进工具。你可以在我们的工具评估 cookbook 中看到这一流程的完整演示。
生成评估任务
有了早期原型,Claude Code 可以快速探索你的工具,并创建数十组提示词与响应对。提示词应当受真实世界用法启发,并基于真实的数据源和服务(例如内部知识库和微服务)。我们建议避免过于简单或流于表面的“沙盒”环境,因为它们无法以足够的复杂度对工具进行压力测试。优秀的评估任务可能需要多次工具调用,甚至多达几十次。
下面是一些优秀任务的示例:
- 和 Jane 约定下周开会,讨论我们最新的 Acme Corp 项目。附上上次项目规划会议的笔记,并预订一间会议室。
- 客户 ID 9182 反映,一次购买尝试被扣了三次款。找出所有相关的日志条目,并判断是否有其他客户受到同一问题的影响。
- 客户 Sarah Chen 刚刚提交了取消申请。请准备一份挽留方案。需要确定:(1) 她为什么要离开,(2) 什么样的挽留方案最有吸引力,(3) 在提出方案之前我们需要注意哪些风险因素。
下面是一些较弱的任务:
- 和 jane@acme.corp 约定下周开会。
- 在支付日志中搜索
purchase_complete和customer_id=9182。 - 查找客户 ID 45892 的取消申请。
每个评估提示词都应配有可验证的响应或结果。你的验证器可以简单到只是将标准答案与采样响应做精确字符串比较,也可以复杂到请 Claude 来评判响应。避免使用过于严格的验证器,以免因格式、标点或合理的其他表述等无关紧要的差异而拒绝正确的响应。
对于每组提示词与响应对,你还可以选择性地指定希望智能体在解决任务时调用的工具,以便在评估期间衡量智能体是否成功理解了每个工具的用途。不过,由于正确解决任务可能有多条有效路径,请尽量避免对策略过度限定或过拟合。
运行评估
我们建议通过直接调用 LLM API,以程序化方式运行评估。使用简单的智能体循环(即包裹着交替进行的 LLM API 调用与工具调用的 while 循环):每个评估任务一个循环。每个评估智能体都应得到一个任务提示词以及你的工具。
在评估智能体的系统提示词中,我们建议指示智能体不仅输出结构化的响应块(用于验证),还要输出推理块和反馈块。指示智能体在工具调用块和响应块之前输出这些内容,可能会触发思维链(chain-of-thought,CoT)行为,从而提高 LLM 的有效智能。
如果你用 Claude 运行评估,可以开启交错思考(interleaved thinking),获得类似的开箱即用功能。这将帮助你探查智能体为何调用或不调用某些工具,并找出工具描述和规范中需要改进的具体之处。
除了顶层准确率,我们还建议收集其他指标,例如单次工具调用和任务的总运行时间、工具调用总次数、token 总消耗量以及工具错误。跟踪工具调用有助于发现智能体采用的常见工作流,并为工具整合提供一些机会。
分析结果
在发现问题和提供反馈方面,智能体是你得力的伙伴,从自相矛盾的工具描述,到低效的工具实现,再到令人困惑的工具模式,无所不包。不过请记住,智能体在反馈和响应中遗漏的内容,往往比它们提到的内容更重要。LLM 并不总是言行一致。
观察智能体在哪里卡住或困惑。通读评估智能体的推理和反馈(或思维链,CoT),找出不顺畅的地方。查看原始转录记录(包括工具调用和工具响应),以发现智能体 CoT 中没有明确描述的行为。要读出字里行间的东西;记住,你的评估智能体未必知道正确答案和策略。
分析工具调用指标。大量冗余的工具调用,可能说明需要调整分页或词元限制参数的大小;大量因参数无效而产生的工具错误,可能说明工具需要更清晰的描述或更好的示例。在我们推出 Claude 的网页搜索工具时,发现 Claude 会不必要地在工具的 query 参数后追加 2025,从而使搜索结果产生偏差、性能下降(我们通过改进工具描述,把 Claude 引导到了正确的方向)。
与智能体协作
你甚至可以让智能体替你分析结果并改进工具。只需把评估智能体的转录记录拼接起来,粘贴到 Claude Code 中。Claude 擅长分析转录记录,也擅长一次性重构大量工具,例如在引入新改动时,确保工具实现与描述保持自洽。
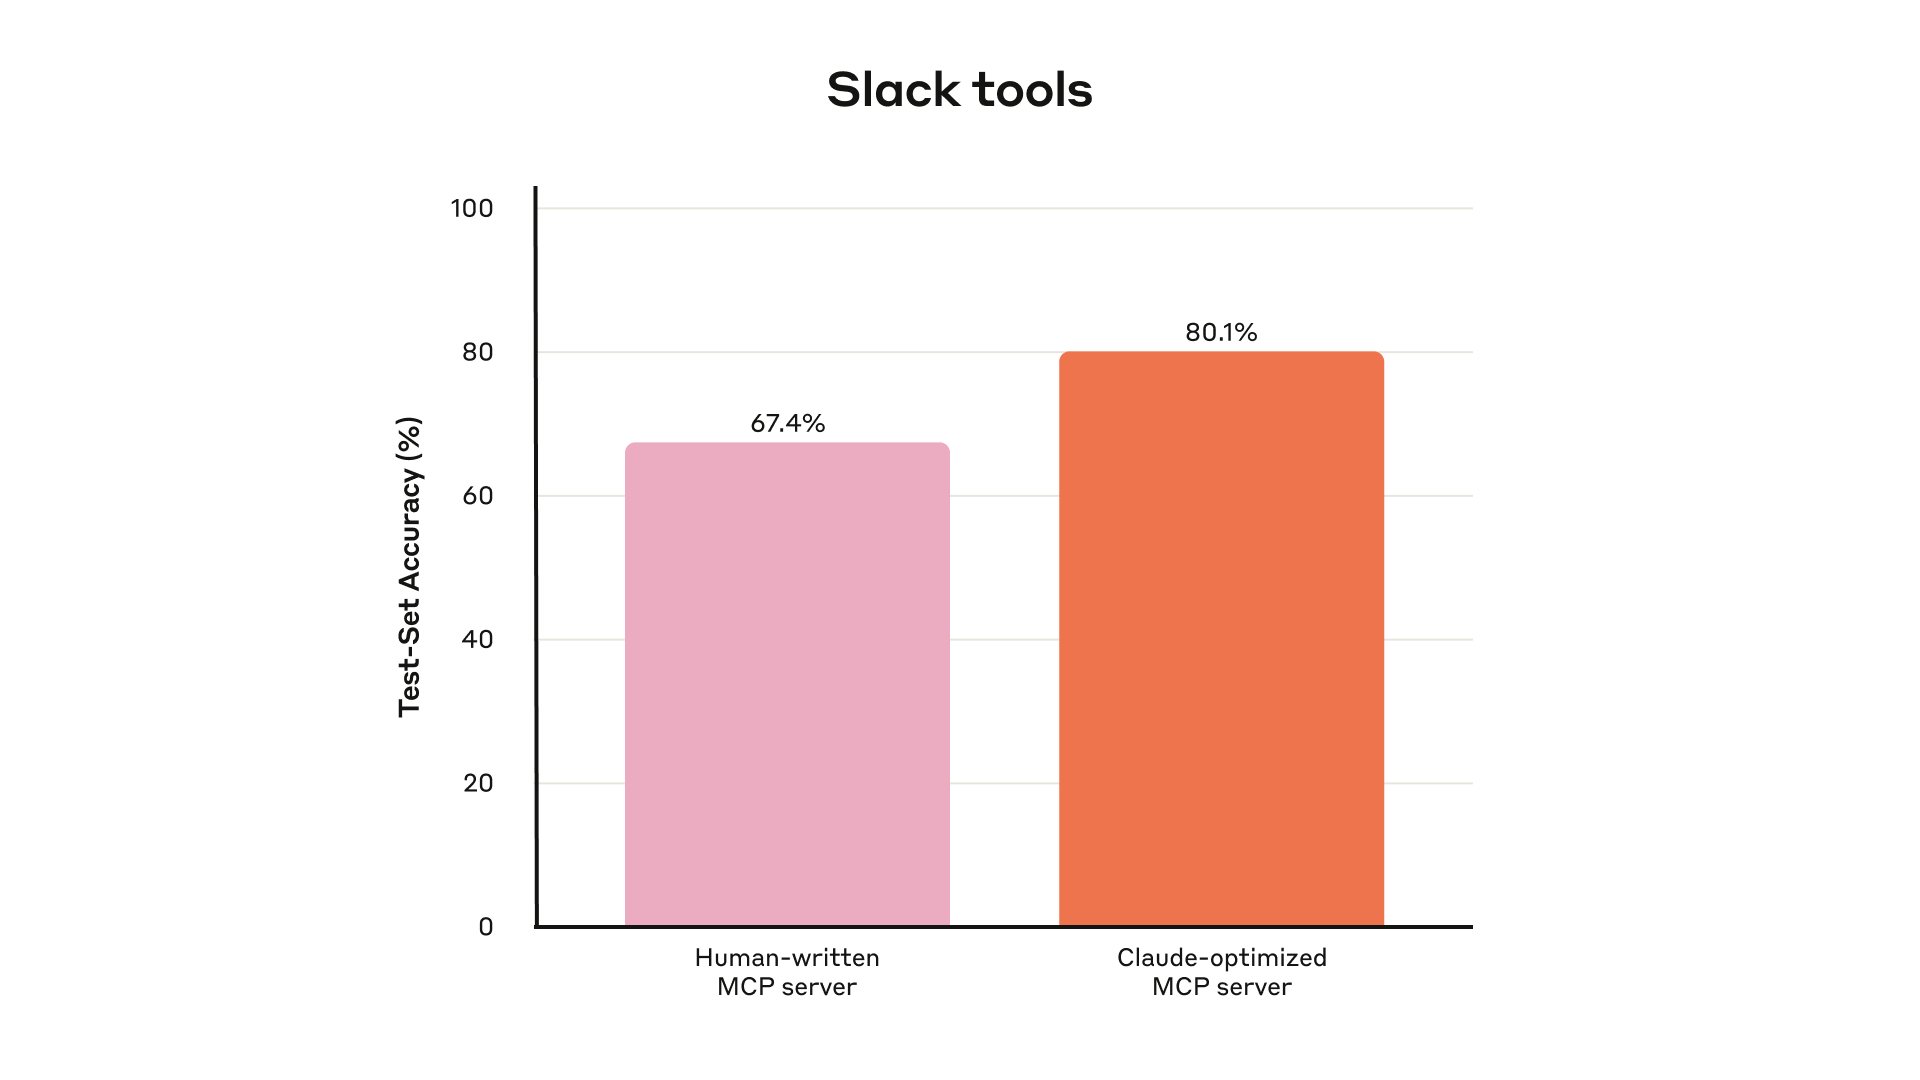
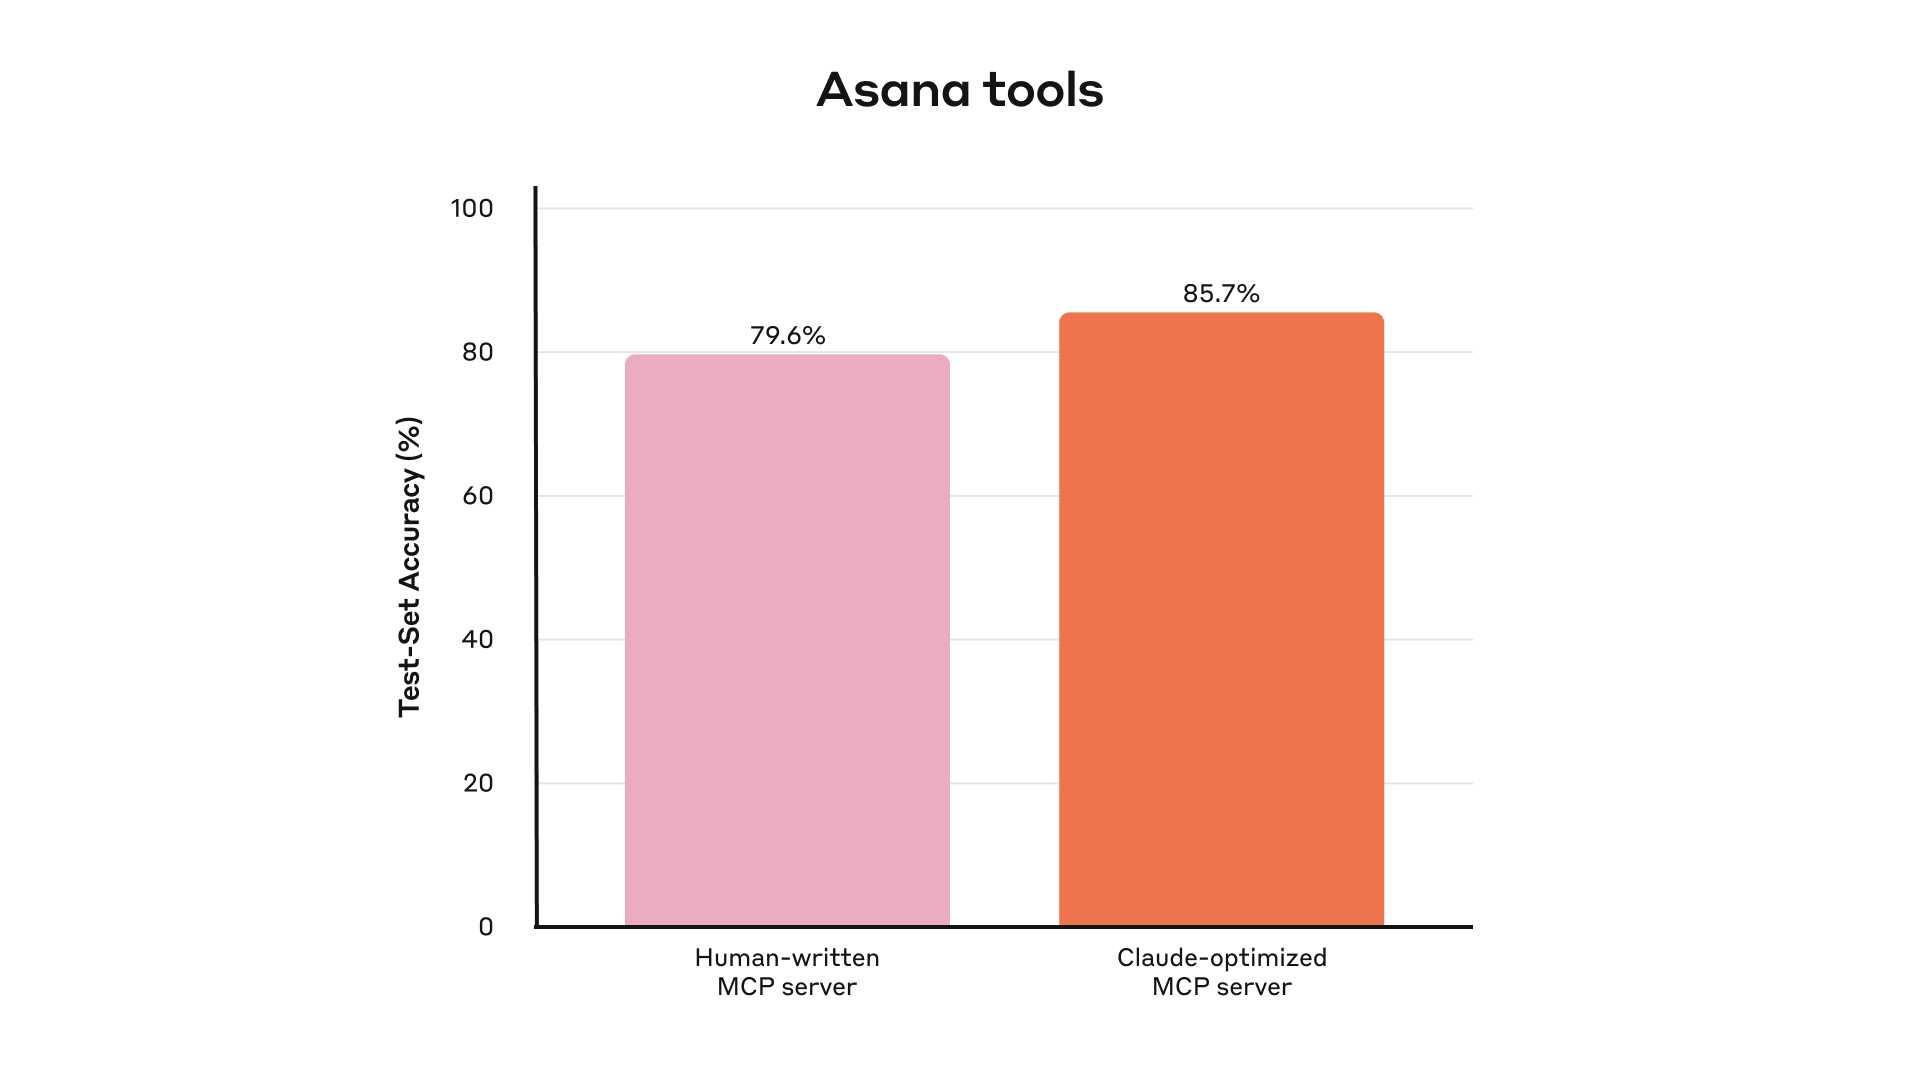
事实上,本文的大部分建议都来自我们用 Claude Code 对内部工具实现的反复优化。我们的评估建立在内部工作空间之上,反映了内部工作流的复杂性,包括真实的项目、文档和消息。
我们依靠留出的测试集,确保没有对“训练”用的评估过拟合。这些测试集表明,即使在“专家级”工具实现(无论是由我们的研究人员手写的,还是由 Claude 自己生成的)之上,我们仍能榨取出额外的性能提升。
在下一节中,我们将分享从这一过程中学到的一些经验。
编写有效工具的原则
本节我们将所学提炼为几条编写有效工具的指导原则。
为智能体选择合适的工具
工具多不一定带来更好的结果。我们观察到的一个常见错误是,工具只是简单包装现有软件功能或 API 端点,而不管这些工具是否适合智能体。这是因为智能体与传统软件具有不同的“可供性”(affordances),也就是说,它们感知自己能用这些工具采取哪些潜在动作的方式不同。
LLM 智能体的“上下文”有限(也就是一次能处理的信息量有上限),而计算机内存廉价且充足。以在通讯录中查找联系人为例:传统软件程序可以高效地存储并逐个处理联系人列表,逐个检查后再继续下一个。
然而,如果 LLM 智能体使用的工具返回所有联系人,然后必须逐词元地通读每一个,就会把有限的上下文空间浪费在无关信息上(想象一下,在通讯录中查找联系人时从头到尾逐页阅读,也就是暴力搜索)。更好、也更自然的做法(对智能体和人类都一样)是先直接跳到相关的那一页(比如按字母顺序查找)。
我们建议先针对少数高影响力的具体工作流,构建几个经过深思熟虑的工具,让它们与你的评估任务相匹配,然后再逐步扩展。以通讯录为例,你可以选择实现 search_contacts 或 message_contact 工具,而不是 list_contacts 工具。
工具可以整合功能,在底层处理多个独立操作(或 API 调用)。例如,工具可以在响应中补充相关元数据,或者把经常串联在一起的多步任务放进一次工具调用中完成。
下面是一些例子:
- 与其实现
list_users、list_events和create_event这几个工具,不如实现一个schedule_event工具,由它查找空闲时间并安排日程。 - 与其实现一个
read_logs工具,不如实现一个search_logs工具,只返回相关的日志行及其周围的少量上下文。 - 与其实现
get_customer_by_id、list_transactions和list_notes这几个工具,不如实现一个get_customer_context工具,一次性汇总某位客户近期 & 相关的全部信息。
确保你构建的每个工具都有清晰、独特的用途。工具应当让智能体能够像人类在获得同样底层资源时那样拆分并解决任务,同时减少原本会被中间输出占用的上下文。
工具过多或功能重叠,也会分散智能体的注意力,使其无法采取高效的策略。对要构建(或不构建)哪些工具进行审慎、有选择的规划,往往会带来可观的回报。
为工具设置命名空间
你的 AI 智能体可能会接入几十个 MCP 服务器和数百种不同的工具,其中包括其他开发者提供的工具。当工具功能重叠或用途模糊时,智能体可能会搞不清该用哪一个。
命名空间(用共同前缀把相关工具归为一组)有助于在大量工具之间划清界限;MCP 客户端有时会默认这样做。例如,按服务(如 asana_search、jira_search)和按资源(如 asana_projects_search、asana_users_search)为工具设置命名空间,可以帮助智能体在合适的时机选对工具。
我们发现,选择前缀式还是后缀式命名空间,会对工具使用评估产生不可忽视的影响。这种影响因 LLM 而异,我们建议你根据自己的评估来选择命名方案。
智能体可能会调用错误的工具、用错误的参数调用正确的工具、调用的工具太少,或者错误地处理工具响应。通过有选择地实现名称能反映任务自然划分的工具,你既减少了加载到智能体上下文中的工具及其描述的数量,又把原本由智能体上下文承担的智能体计算卸载回工具调用本身。这降低了智能体出错的整体风险。
让工具返回有意义的上下文
同样地,工具实现应当注意只向智能体返回高信号信息。它们应当优先考虑上下文相关性而非灵活性,并避免使用低层级的技术标识符(例如:uuid、256px_image_url、mime_type)。name、image_url 和 file_type 这类字段更有可能直接为智能体的后续行动和响应提供依据。
智能体处理自然语言的名称、术语或标识符,也往往比处理晦涩的标识符成功得多。我们发现,仅仅是把任意的字母数字 UUID 解析为语义上更有意义、更易解读的语言(甚至是从 0 开始编号的 ID 方案),就能减少幻觉,显著提升 Claude 在检索任务中的精确度。
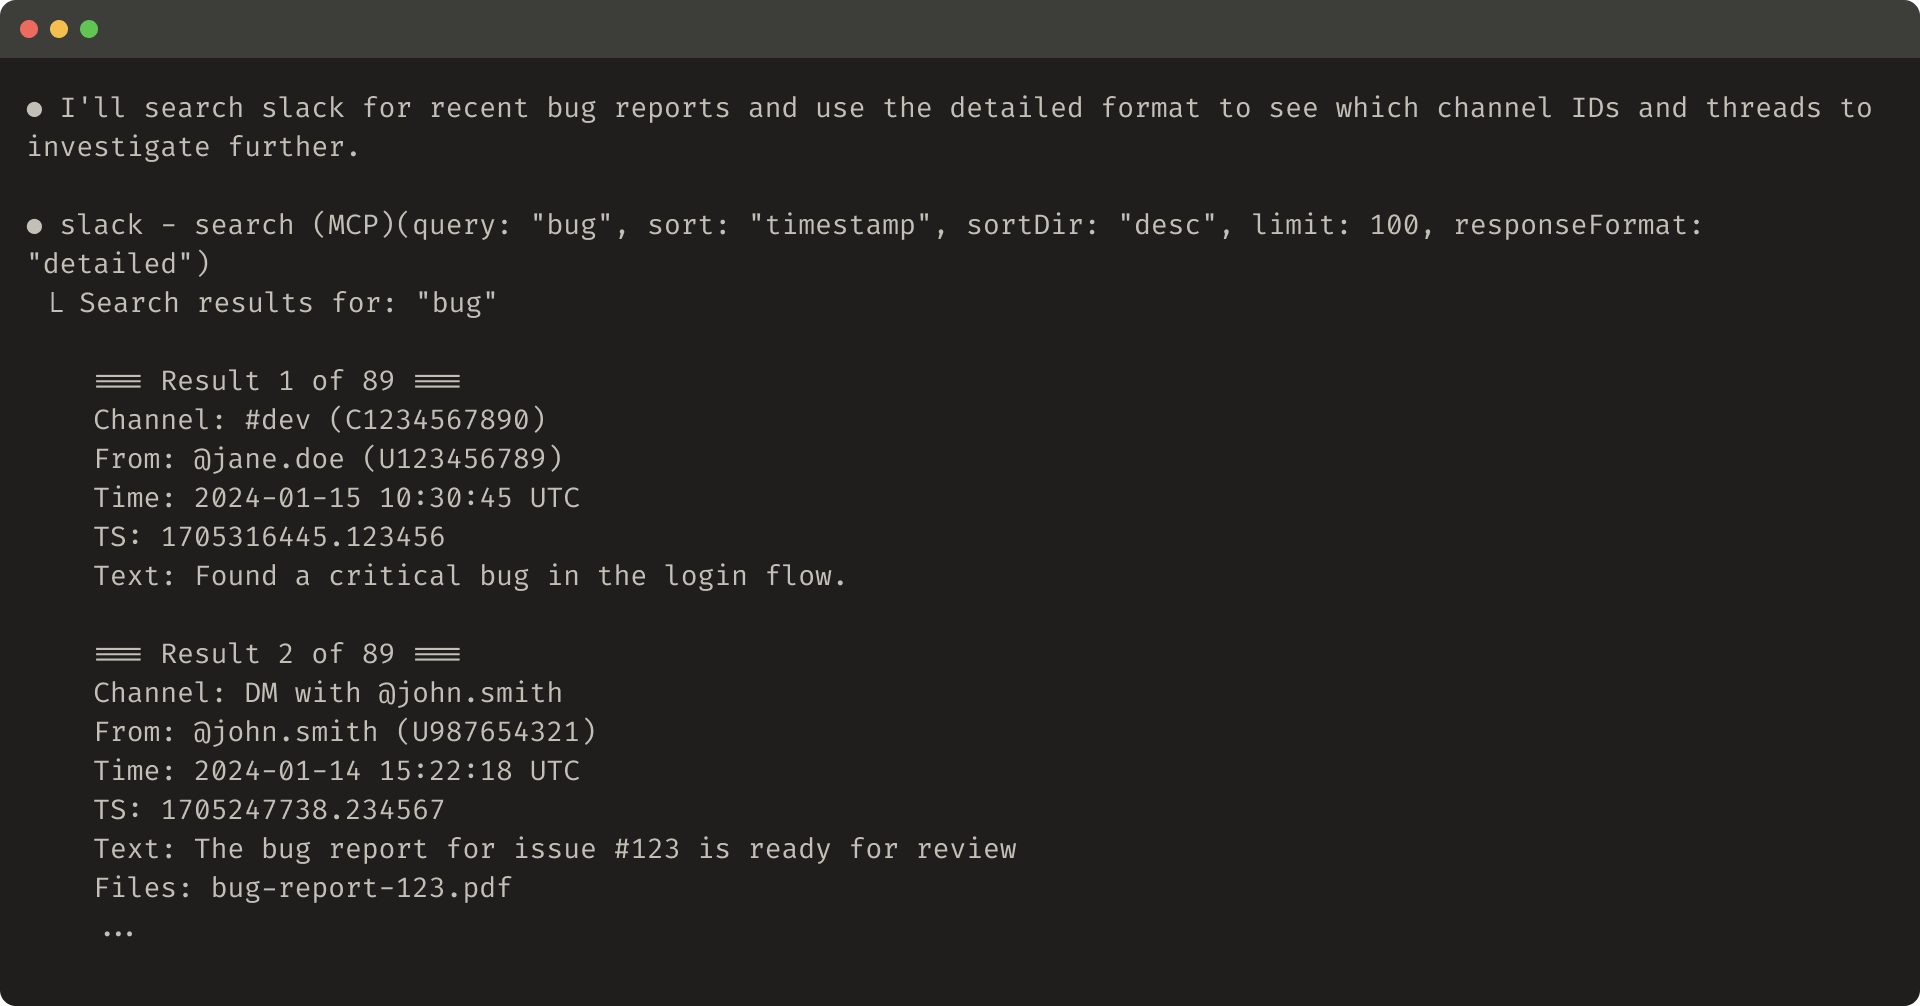
在某些情况下,智能体可能需要同时与自然语言输出和技术标识符输出交互的灵活性,哪怕只是为了触发后续的工具调用(例如 search_user(name=’jane’) → send_message(id=12345))。你可以在工具中暴露一个简单的 response_format 枚举参数来同时支持两者,让智能体自行控制工具返回 “concise” 还是 “detailed” 响应(见下图)。
你还可以添加更多格式以获得更大的灵活性,类似于 GraphQL,你可以精确选择想要接收哪些信息。下面是一个用于控制工具响应详细程度的 ResponseFormat 枚举示例:
enum ResponseFormat {
   DETAILED = "detailed",
   CONCISE = "concise"
}
下面是一个详细工具响应的示例(206 个词元):
下面是一个简洁工具响应的示例(72 个词元):
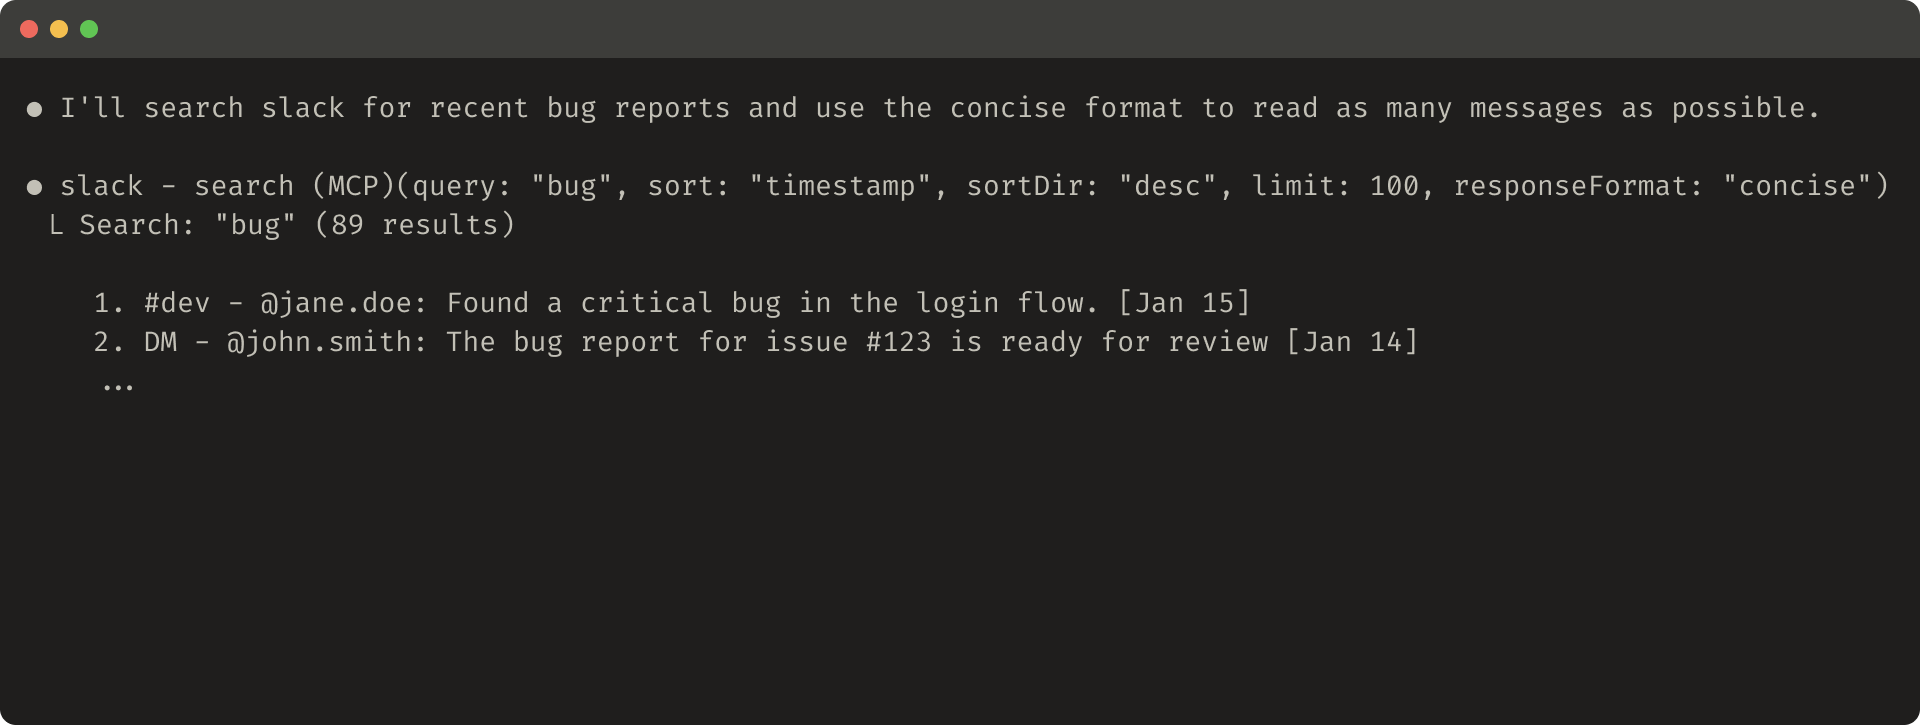
thread_ts 标识,获取线程回复时需要用到它。thread_ts 和其他 ID(channel_id、user_id)可以从 “detailed” 工具响应中获取,以支持需要这些 ID 的后续工具调用。“concise” 工具响应只返回线程内容,不包含 ID。在这个例子中,“concise” 工具响应只用了大约三分之一的词元。即使是工具响应的结构,例如 XML、JSON 或 Markdown,也会影响评估表现:没有放之四海而皆准的方案。这是因为 LLM 是基于下一个词元预测训练的,往往在与训练数据相匹配的格式上表现更好。最优的响应结构会因任务和智能体而异。我们建议你根据自己的评估来选择最佳的响应结构。
优化工具响应的词元效率
优化上下文的质量很重要,但优化工具响应返回给智能体的上下文数量同样重要。
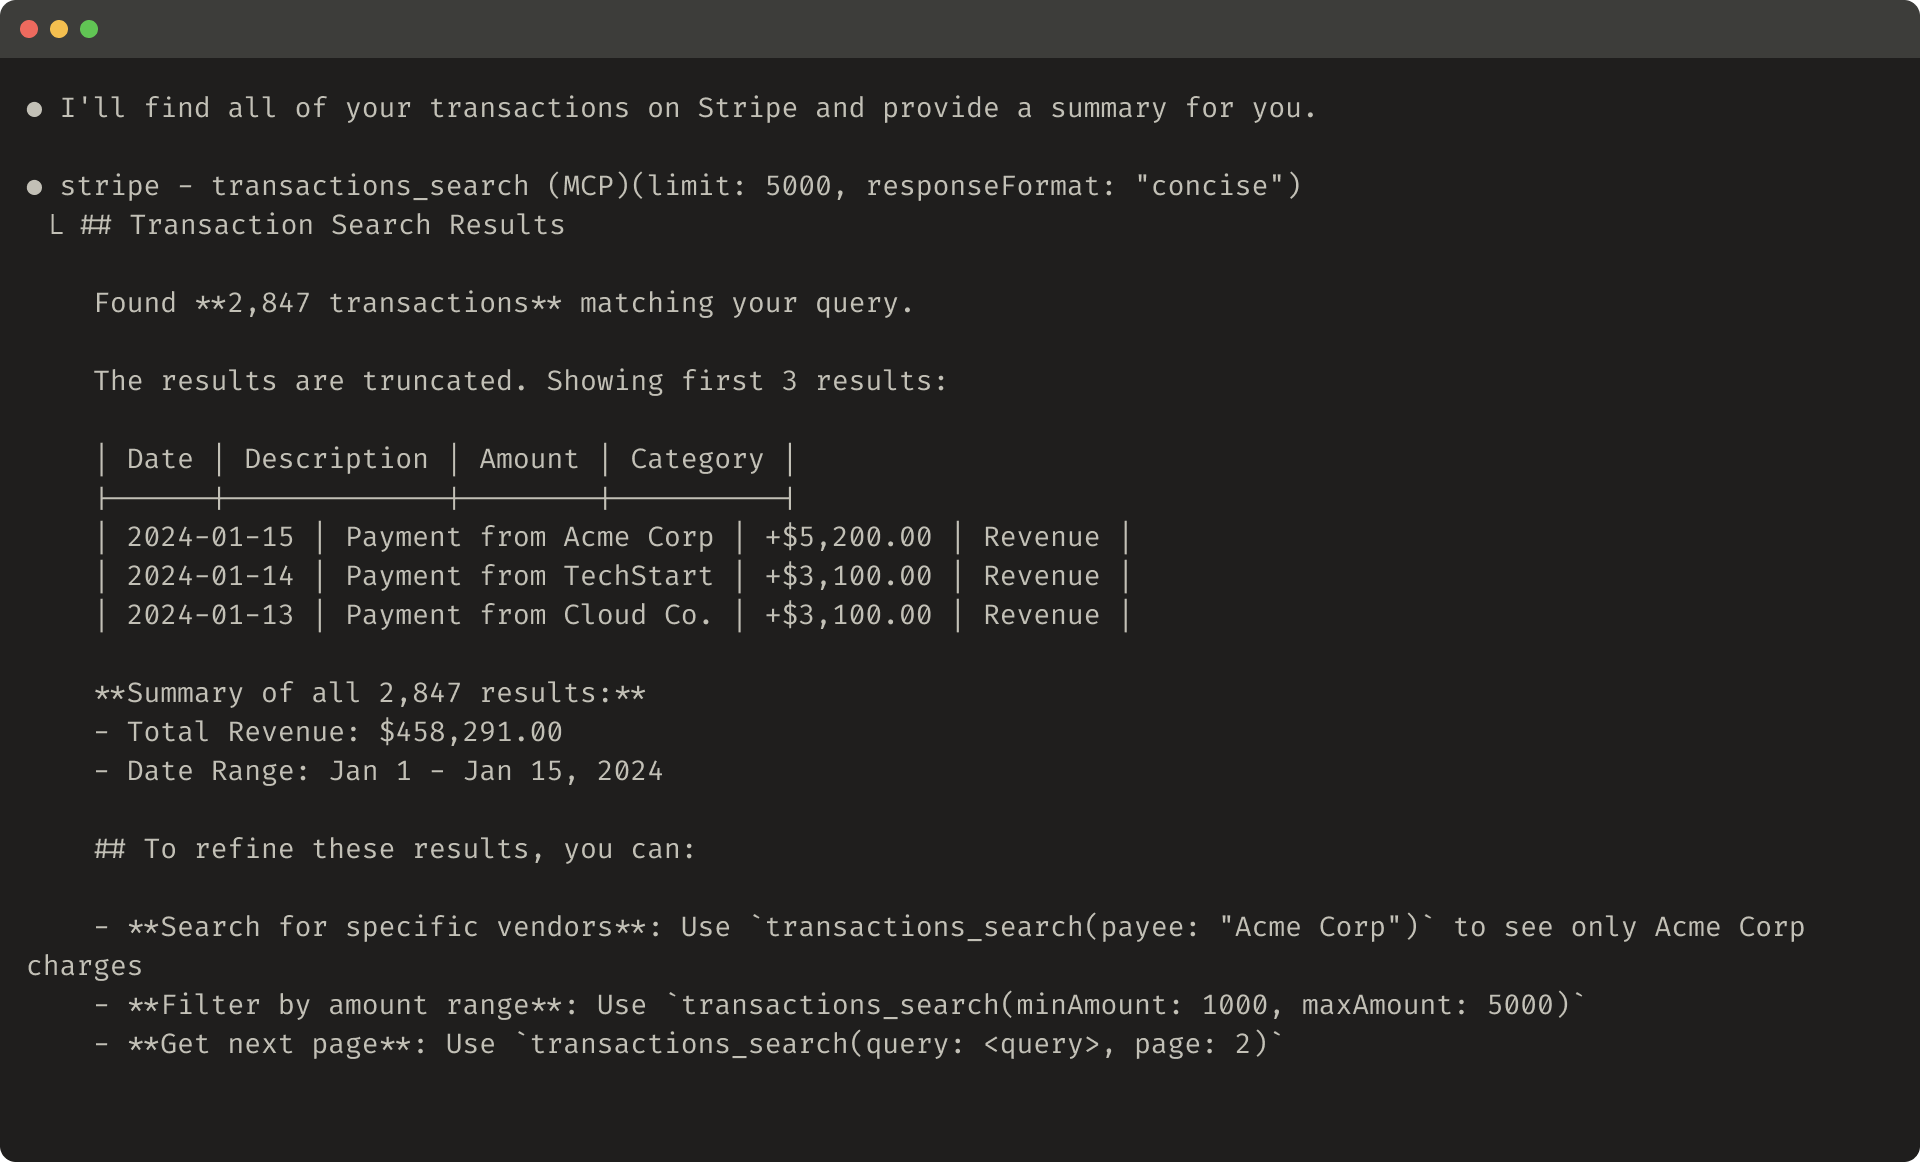
对于任何可能占用大量上下文的工具响应,我们建议组合使用分页、范围选择、过滤和/或截断,并为参数设置合理的默认值。在 Claude Code 中,我们默认将工具响应限制在 25,000 个词元以内。我们预计智能体的有效上下文长度会随时间增长,但对上下文高效工具的需求仍将持续。
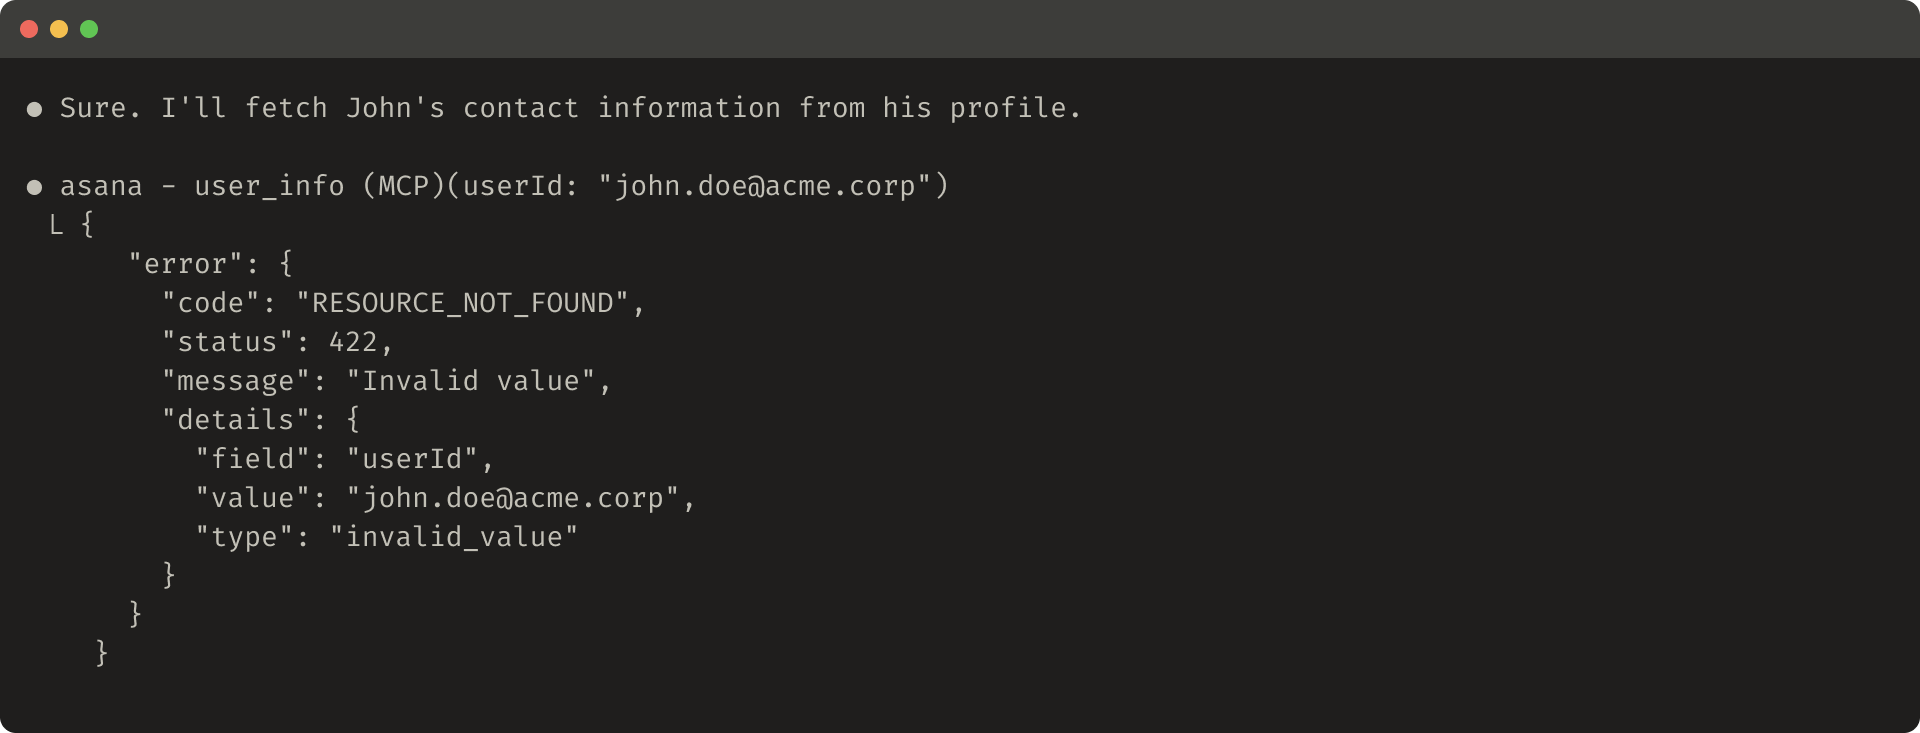
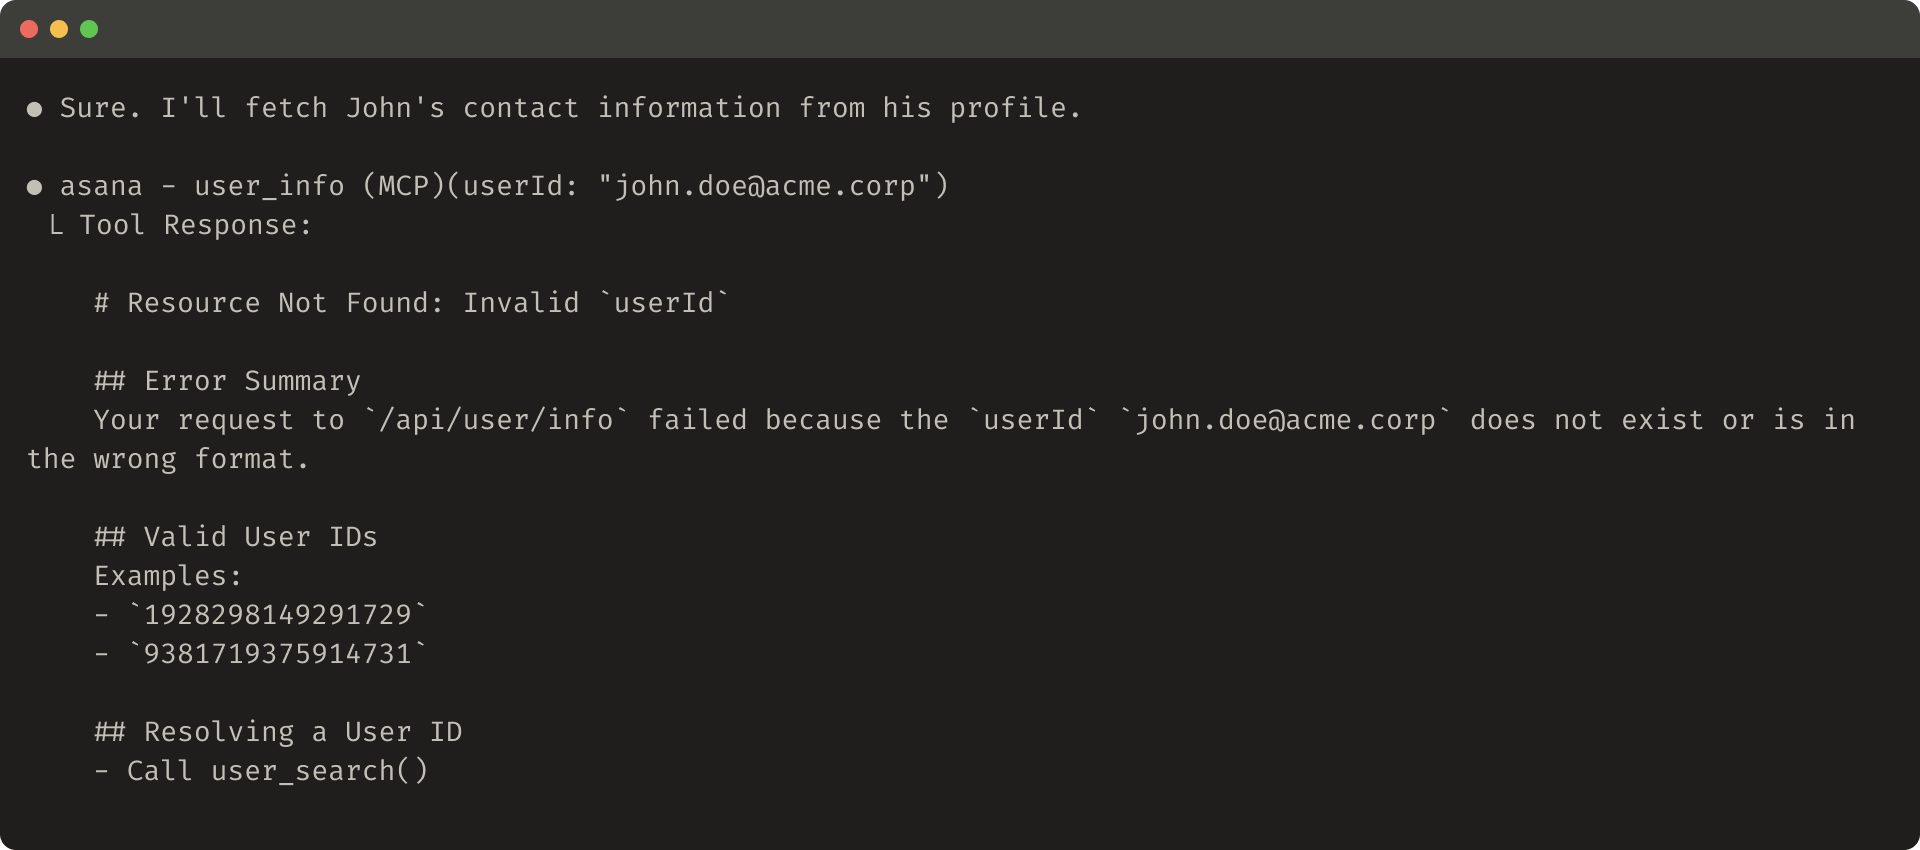
如果你选择截断响应,务必用有帮助的指示来引导智能体。你可以直接鼓励智能体采取更节省词元的策略,例如在知识检索任务中进行多次小而有针对性的搜索,而不是一次宽泛的搜索。同样地,如果工具调用出错(例如在输入校验时),你可以对错误响应做提示工程,清晰传达具体、可操作的改进建议,而不是晦涩的错误码或堆栈跟踪。
下面是一个被截断的工具响应示例:
下面是一个没有帮助的错误响应示例:
下面是一个有帮助的错误响应示例:
对工具描述做提示工程
接下来是改进工具最有效的方法之一:对工具描述和规格说明做提示工程。由于它们会被加载到智能体的上下文中,因此可以共同引导智能体采取有效的工具调用行为。
编写工具描述和规格说明时,不妨想想你会怎样向团队的新员工介绍这个工具。把你可能默认带入的上下文,例如专门的查询格式、小众术语的定义、底层资源之间的关系,都明确写出来。通过清晰描述(并用严格的数据模型强制约束)预期的输入和输出来避免歧义。尤其是,输入参数的命名应当毫不含糊:与其用名为 user 的参数,不如试试名为 user_id 的参数。
有了评估,你就能更有把握地衡量提示工程的效果。即使是对工具描述的小幅改进,也可能带来显著的提升。在我们对工具描述做了精确改进之后,Claude Sonnet 3.5 在 SWE-bench Verified 评估上取得了当时最先进的成绩,错误率大幅下降,任务完成率显著提高。
你可以在我们的开发者指南中找到关于工具定义的其他最佳实践。如果你在为 Claude 构建工具,我们还建议阅读工具是如何被动态加载到 Claude 的系统提示词中的。最后,如果你在为 MCP 服务器编写工具,工具注解有助于披露哪些工具需要开放世界访问权限,或会做出破坏性更改。
展望未来
要为智能体构建有效的工具,我们需要把软件开发实践从可预测的、确定性的模式,重新调整为非确定性的模式。
通过本文所述的迭代式、评估驱动的过程,我们总结出了成功工具的一些一致规律:有效的工具定义明确而清晰,审慎地使用智能体的上下文,可以在多样的工作流中组合使用,并让智能体能够直观地解决现实世界的任务。
未来,我们预计智能体与世界交互的具体机制会不断演进,从 MCP 协议的更新到底层 LLM 本身的升级皆然。通过系统化、评估驱动的方法来改进面向智能体的工具,我们可以确保随着智能体能力的提升,它们所使用的工具也同步演进。
致谢
本文由 Ken Aizawa 撰写,并得到研究团队(Barry Zhang、Zachary Witten、Daniel Jiang、Sami Al-Sheikh、Matt Bell、Maggie Vo)、MCP 团队(Theodora Chu、John Welsh、David Soria Parra、Adam Jones)、产品工程团队(Santiago Seira)、市场团队(Molly Vorwerck)、设计团队(Drew Roper)以及应用 AI 团队(Christian Ryan、Alexander Bricken)同事们的宝贵贡献。
1不包括训练底层 LLM 本身。