TL;DR
直观理解:不要让一个天才在一小时内读完一座图书馆,而是让十个实习生每人读一本书。
我们的研究《分治法何时对长上下文 LLM 有效?》(When Does Divide and Conquer Work for Long Context LLM?,ICLR 2026)提出了一个用于研究这一问题的框架。我们发现,较小的模型采用精心设计的“分而治之”(Divide & Conquer)方案,在长上下文任务上可以追平甚至超过 GPT-4o 的单次处理(single-shot)。
[论文,ICLR 2026] [代码]
现代 LLM 越来越多地支持 128K、200K 乃至 1M 以上 token 的超大上下文窗口。理论上,这解锁了一些强大的用例,比如在单个提示中分析整个代码库,或总结整本书。
然而,“把所有东西一股脑塞进一个提示”的设想在实践中经常行不通。随着上下文长度增加,性能会以意想不到的方式下降。如下图所示,“分而治之”是解决长上下文任务的一种有吸引力的方案。
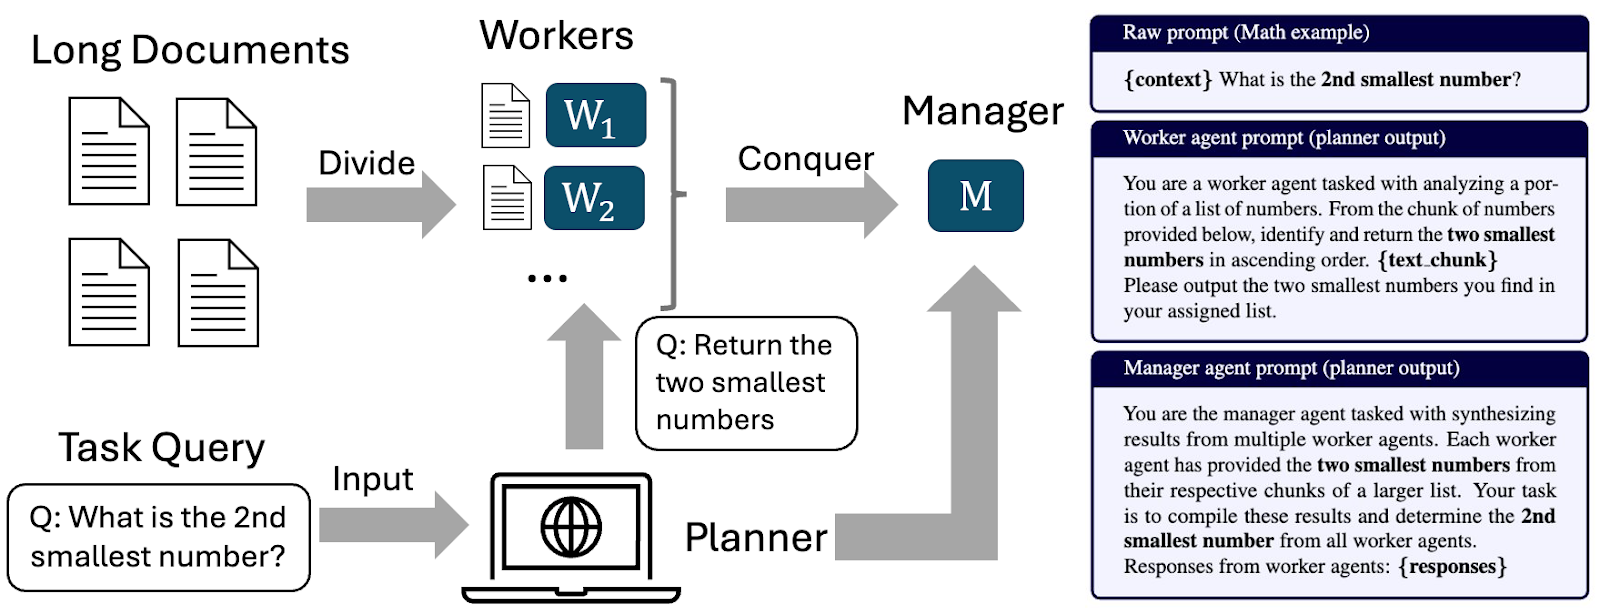
在论文中我们发现,较弱的模型采用精心设计的“分而治之”框架,在长上下文任务上可以追平甚至超过 GPT-4o 的单次处理。
核心问题:长度带来的“迷雾”
如何充分发挥这种“分而治之”方法在长上下文任务中的威力?我们把这个挑战拆解为三种不同的噪声来源:
- 模型噪声(“脑雾”):模型并不是线性地遗忘,而是会被信息淹没。我们的研究表明,模型的混乱程度随输入长度呈超线性增长。从数学上看,拆分任务更好,因为每处理一个更短的新分块,就把这个混乱计数器重置了一次。
- 任务噪声(“孤岛效应”):有时一个分块单独看没有意义(例如代词指代的是前一章的内容)。文本被拆分时,这种“跨分块依赖”(Cross-Chunk Dependence)就会产生噪声。
- 聚合噪声(“糟糕的总结”):即使各个 Worker 都完成了任务,最终的 Manager 模型也可能无法把这些局部答案正确地拼接起来。
朴素的“MapReduce”方法常常失败,原因就在于聚合噪声,即 Manager 缺乏上下文,导致最终答案杂乱或前后不一致。我们的框架预测:如果通过更清晰的指令降低这种噪声,就能释放较弱模型的潜力。
“第二小的数”示例:设想一个任务,要求各 Worker 协助在一个巨大的列表中找出第二小的数。如果你朴素地让每个 Worker 在自己负责的分块里“找出第二小的数”,最终的 Manager 就会出错,因为全局第二小的数,可能恰好是某个分块里最小的数。
- 朴素提示:“找出第二小的数。”(失败)
- 经过规划的提示:“找出并返回最小的两个数。”
只需调整提示来考虑这种聚合噪声,我们就能确保 Manager 拿到正确的数据来计算全局答案。
用实验验证理论
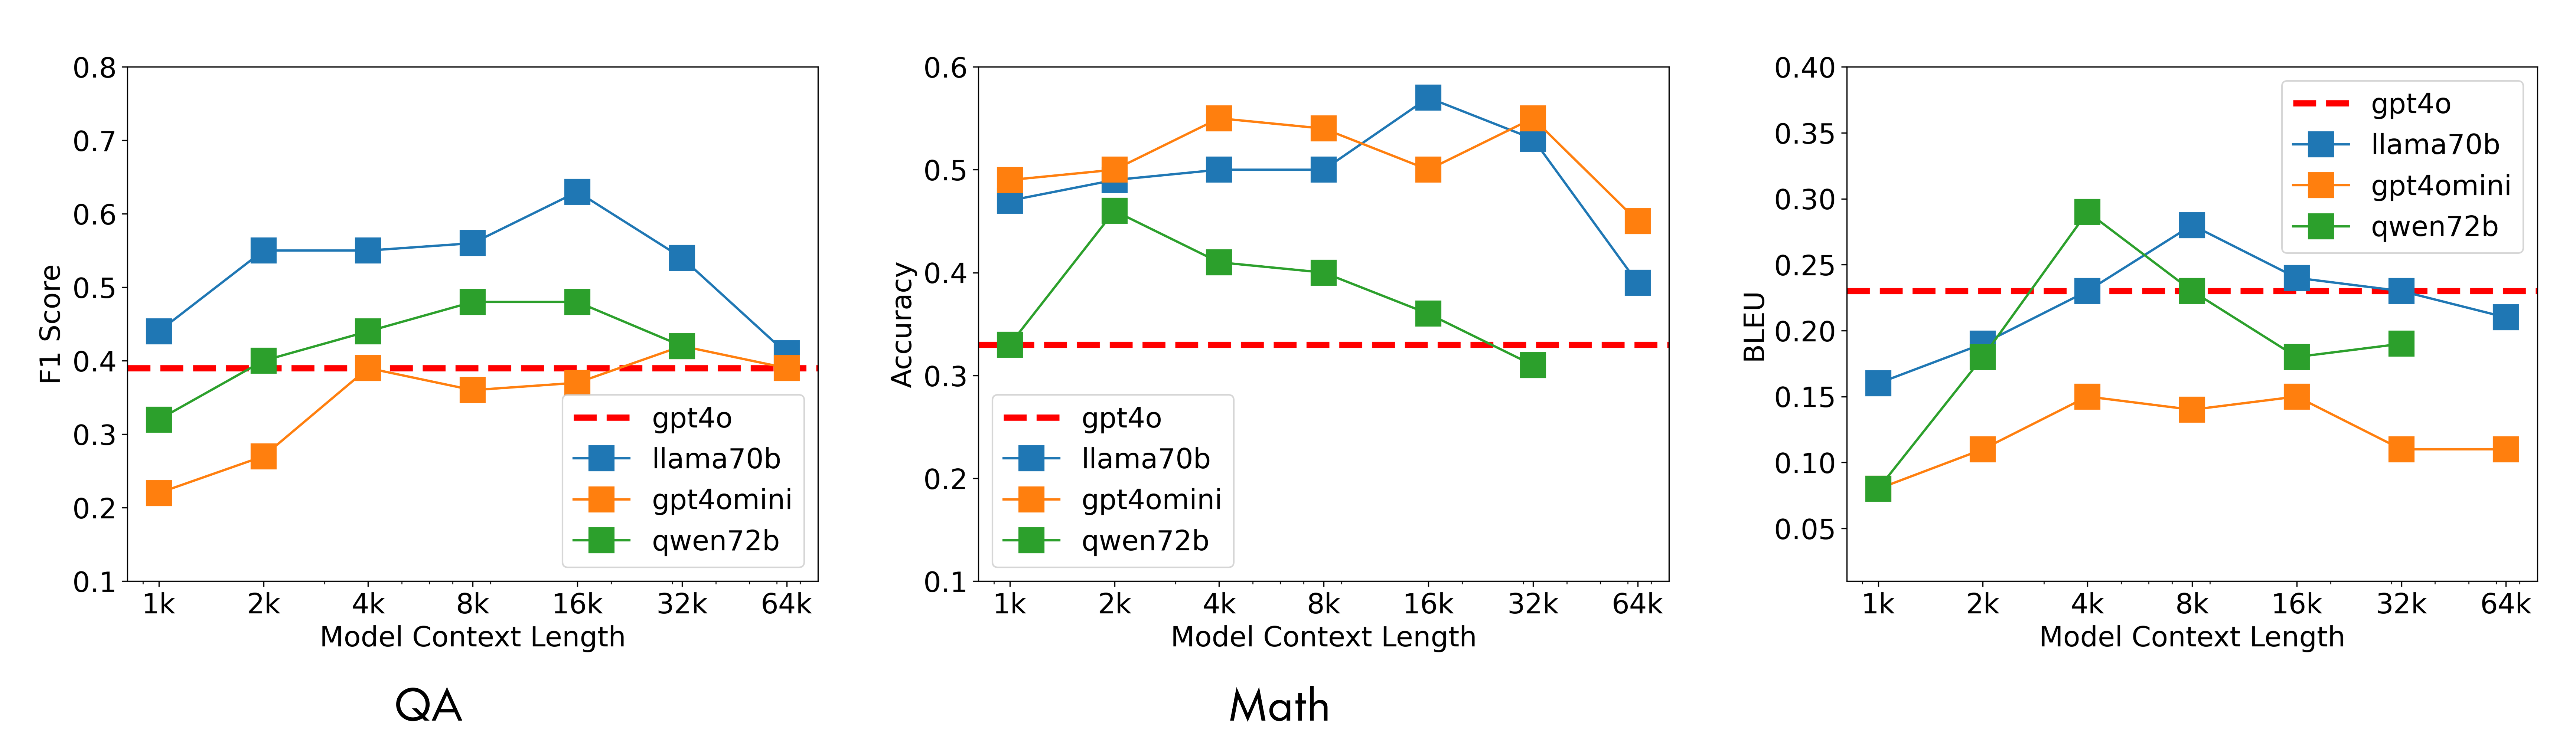
我们在多种任务(检索、问答、摘要等)上测试了这一框架的实现。如下所示,采用该框架的较弱模型(例如 Llama-3-70B 或 Qwen-72B)优于一次读完全文的 GPT-4o。单次处理的模型(红色虚线)随上下文长度增加而性能下降,而 D&C 模型则保持了较高的性能。
工程上的收益
从工程角度看,这个框架带来三大实际好处:
- 更便宜:把繁重的工作交给更小、更便宜的模型(Worker),而不必为旗舰模型的 token 付费。
- 更快:Worker 并行运行,避免了在单次串行处理中面对 128k token 超长上下文所带来的高延迟。
- 易于调优:我们发现,由于噪声曲线具有可预测性,仅测试 5 个随机样本就足以找到最优的分块大小,无需在整个数据集上做穷举搜索。我们的框架还提供了另一层灵活性:可以为 Worker 和 Manager 分配不同的 LLM 后端,将两者解耦。
代价:何时应使用单次处理而非分而治之
这种方法不是万能药。它最适合问答、检索和摘要这类跨分块依赖程度适中的任务。当任务噪声占主导时,收益就消失了。如果你的任务需要追踪第 1 页上的一条隐晦线索,并把它与第 100 页联系起来(比如我们论文中的“对话角色推断”任务),那么“分”这一步就会破坏必要的上下文。在这类高度协同的情形下,让“天才”模型通读整座图书馆仍是唯一的办法。更多细节请参阅我们的论文。