一年前,我们宣布了首个内容独立日(Content Independence Day),让网站所有者有了夺回内容控制权的手段。爬虫与网站所有者之间延续了 30 年的约定——我们抓取你的内容,你获得引流——已经不再成立。AI 拿走了一切,却几乎不带来任何回报,对网站所有者构成了生存威胁。于是我们推出了一键“拦截 AI 机器人(Block AI Bots)”选项,以及按抓取付费(Pay-Per-Crawl)市场。
一年间变化很大。去年 7 月,围绕“AI 机器人”的讨论集中在阻止未经补偿的 AI 训练,矛头指向那种内容被用于模型训练、却没有给网站所有者带来任何价值的“一赢一输”的交易。但现在人们开始希望有更细致的区分:内容所有者仍然希望保护自己的内容,对于他们辛苦创作、整理和分享的原创内容,也应当获得补偿。我们同样清楚,锁死内容并非放之四海而皆准的办法;网站所有者想要的选择,不止是“每次都拦截所有自动化访问”。
如果你运营的是小型网站,问题不仅在于有人可能拿你的内容去训练模型,更在于根本没人能找到你。于是你不得不做一笔浮士德式的交易:要么出现在搜索结果里并任由 AI 训练你的内容,要么冒着失去可发现性的风险。如果现有搜索服务商用同一批机器人既做搜索又做训练,这对它们就是不公平的优势;而这种不公平的优势,又会促使新进入者在试图缩小竞争差距时采取规避手段。
如今,AI 无处不在
今天,AI 可以出现在任何东西里。Google 搜索已经从“由 AI 排序”变成了完整的答案引擎,直接在结果页上回答你的问题。而且这并非 Google 独有——“搜索”整体正朝这个方向演进。
我们可以争论今天什么才算“AI”,却发现明天标准又变了。因此,我们不再主要以“是不是 AI”来定义一个机器人,而是在更新后的分类方法中追问机器人或智能体行为背后更深层的问题:它们在我的网站上做什么?它们存储什么?又会如何再次分享我的内容?
一套务实的分类体系
要回答这些问题,我们需要更细致的视角——一套与客户关心的 AI 使用场景相吻合的务实分类体系。因此,我们把讨论范围扩大到 AI 训练之外,聚焦于希望让所有客户都能管理的三类 AI 使用场景:
- 搜索(Search):任何为了日后回答问题而收集或索引你内容的行为。关键在于,搜索是在主动建立你网站的数据库,以便日后用来响应查询。网站所有者理应因此获得引荐流量或其他公平的补偿。
- 智能体(Agent):通常实时代表某个人、为立刻完成某件事而执行的自动化行为。这包括聊天抓取机器人(例如 ChatGPT-User)和浏览器操控类智能体(例如 Gemini 或 Claude 驱动 Chrome)。关键在于,它访问你的 Web 应用是为了完成一项任务,而且另一端往往有人在等待。
- 训练(Training):抓取你的内容以训练或微调模型的爬虫。关键在于,你的数据会被永久吸收到 AI 的底层架构中,用来提升其能力。
网络上许多常见的爬虫都归属上述某一类,有些则同时属于多类。除了上述三类,我们还对大量其他行为进行了分类,包括广告验证、订阅源抓取和智能体交易(下文详述)。但我们认为,所有网站所有者都应当能够简单地管理这三类以 AI 为中心的使用场景的访问权限。我们认为机器人运营方应当拆分各自的爬虫,因为这能为网站所有者带来更高的透明度:让他们更好地理解某个爬虫为何访问自己,也更好地管理授予该爬虫的访问权限。如果一家公司的自动化程序既构建搜索索引、又充当智能体、还收集数据来训练模型,我们强烈建议该公司把这些自动化程序拆分成三个独立的爬虫。
我们希望建立一套可扩展、并能随自动化流量演变而准确反映其全貌的分类体系。追踪机器人的用途并不新鲜,但我们的新分类体系做了几处更新,以便更好地反映当今机器人流量的状况。最值得一提的是,我们希望承认:具有多种用途的机器人应当按其全部用途来追踪,而不是只算其中一种。
管理 AI 流量的新选项
我们希望为 Cloudflare 网络上的所有网站所有者提供更多管理不同类型 AI 流量的选项。
我们过去发布的“拦截 AI 机器人”托管预设,涵盖的是为模型训练而抓取数据的单一用途机器人,如下所示:
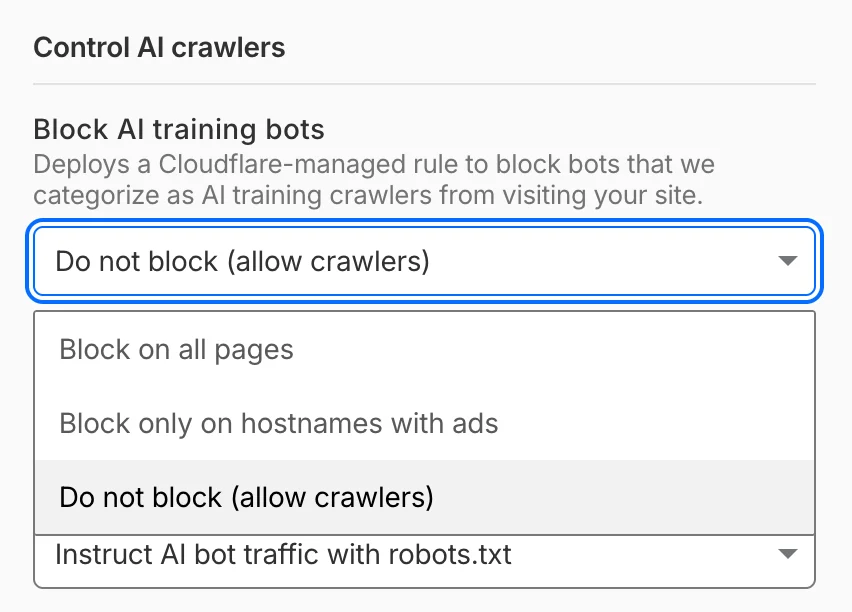
2025 年 7 月 1 日管理 AI 机器人流量的现有设置截图。
但并非所有 AI 使用都一样,我们希望客户拥有所需的控制能力。因此,我们推出了按三大使用场景管理 AI 流量的能力:搜索、智能体和训练爬虫。有了这些新选项,客户可以更精细地调整对 AI 机器人流量的管理方式——包括免费版(Free)客户。
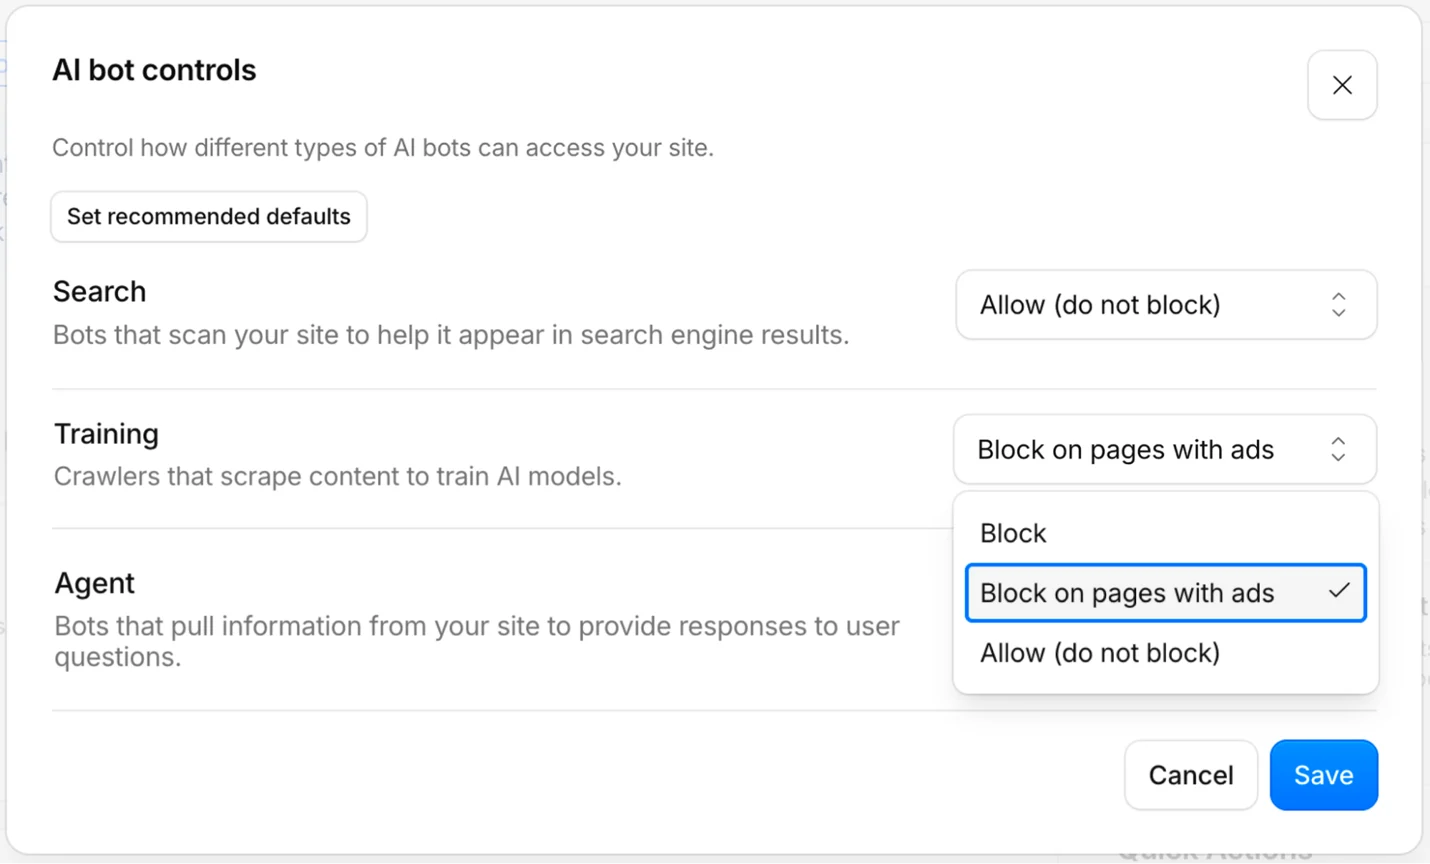
2026 年 7 月 1 日管理 AI 机器人流量的新选项截图。
设定新的默认值
2026 年 9 月 15 日起,我们将设定新的默认值,适用于这三个分类中的每一类。对于所有接入 Cloudflare 的新域名,在展示广告的页面上,训练和智能体类别将默认被拦截,而搜索仍默认允许。
广告表明网站所有者希望有真人来到这里并看到它——这是可变现的内容,支撑着业务运转。因此,在这些页面上,我们把人的注意力视为最终目标,并挡住那些可能妨碍这种注意力的机器人(即训练类和智能体类机器人)。另一方面,搜索是最自然地把访客引回来的行为,我们认为允许搜索符合大多数网站所有者的利益。
9 月 15 日起适用的另一项变化是:多用途爬虫(特指同时兼具搜索与训练的爬虫)将根据其全部行为来决定允许或拦截,这与我们呼吁提高网站所有者透明度的主张一致。由于默认值将按最严格的适用规则执行,Googlebot、Applebot 和 BingBot 这类多用途爬虫,只要客户选择拦截训练(无论是通过新的管理 AI 流量选项,还是通过旧版“拦截 AI 机器人”服务),就会被拦截。
当然,客户的选择至关重要:如果网站所有者想退出这些新的默认配置,可以在 9 月 15 日之前随时在安全设置中轻松标记,这表示他们希望对同时也为搜索而抓取的训练类爬虫不做任何改变。随着 9 月 15 日临近,我们还会持续通知客户即将变更默认值,确保想选择不同于默认设置的客户有机会这样做。
BotBase:面向企业版客户的全新可视化层
我们还很高兴地推出一项重要的可视化更新,作为企业版机器人管理(Enterprise Bot Management)的新功能。随着 Cloudflare 所追踪的机器人目录不断扩大,人们也越来越希望能按合理的分组来管理这些机器人,并了解某个特定机器人的更多细节。
隆重推出 BotBase。BotBase 是我们全新的数据库,追踪所有已知机器人,包括已验证(Verified)机器人和智能体。该数据库直接在 Cloudflare 控制台上,提供对我们整个机器人目录全面且可搜索的视图。我们先解决可见性问题,但今年晚些时候,我们会扩展 BotBase,为你网站上的已知自动化内容提供直接的控制中心。
借助这一新视图,企业版机器人管理客户可以看到所有已验证机器人/智能体的完整目录,以及它们在这套更新后的分类体系中的归类——这是我们此前从未在 Cloudflare 控制台上动态展示过的视图。想要精准针对某个特定机器人的客户,也可以轻松筛选出该机器人的全部流量,并复制检测 ID 用于安全规则。所有这些现已上线,位于一个专门页面中,可通过机器人管理配置卡片访问。
在构建 BotBase 时,我们希望把所有能让我们在不同机器人之间形成可扩展、有力洞察的信息都纳入进来。其中一项是我们更新后分类体系的基石,即基于机器人在你网站上可能做什么——也就是它的行为。我们按下表所示划分这些类别,每个机器人会被归入其中一种或多种行为。
| 机器人分类 | 行为与用途 |
|---|---|
| 搜索(Search) | 抓取并扫描你的网站,帮助其出现在搜索引擎结果中 |
| 智能体(Agent) | 由用户指派、代表真人访问页面的智能体 |
| 训练(Training) | 抓取内容以训练或微调模型 |
| 交易(Transact) | 代表用户执行结账操作 |
| 数据收集(Data Collection) | 包括价格抓取、竞争情报收集和第三方分析 |
| 安全测试(Security Testing) | 包括漏洞扫描和渗透测试 |
| SEO | SEO 抓取、站点审计、无障碍检查 |
| 广告验证(Ads Verification) | 广告投放验证、广告欺诈检测 |
| 社交 / 链接预览(Social / Link Preview) | 为社交平台和即时通讯应用生成链接预览 |
| 订阅源抓取(Feed Fetching) | 包括 RSS 阅读器、播客聚合器和新闻订阅源机器人 |
| 监控与运维(Monitoring & Operations) | 包括可用性监控、webhook 和健康检查 |
粗斜体行表示向所有客户开放的新的可配置选项。
爬虫如何使用我的内容?
我们还听到客户认为重要的另一项信息,是机器人的内容使用方式——即机器人抓取你的内容后可能保留和再次分享什么。为此,我们正在为机器人管理客户构建按“内容使用方式”进行选择和拦截的能力。该设置可取三个级别之一,从限制最严到最宽松依次为:
immediate——可以交互,但不存储、不复用任何内容reference(默认)——建立索引、摘录并回链full——摘要并复现内容
这些取值可以与机器人分类组合,表达细致的规则,例如“允许所有用于搜索、SEO 和广告验证的机器人,但内容使用级别最高只到 reference”。这样网站所有者就可以按合理的分组做决策,而不必逐个机器人地管理规则。
为进一步支持这一点,从今天起,我们开始测试一个新信号 use,它扩展了内容信号(Content Signals),并写在你的 robots.txt 中。它在第一版内容信号的三个字段之外新增了第四个可选字段,用于表达与上述相同的偏好:
use=immediateuse=referenceuse=full
与 robots.txt 文件中列出的其他所有条目一样,内容使用方式的取值表达的是网站所有者的偏好,而不是直接下达拦截。我们现在正添加对这一扩展的支持:所有已启用托管 robots.txt 的客户——该功能会在 robots.txt 前面加上“为搜索而抓取可以,为训练而抓取不可以”的偏好——现在都会在其 robots.txt 中额外加入 use=reference 这一偏好。
# Cloudflare Managed content with original Content Signals

User-agent: *
Content-Signal: search=yes,ai-train=no
Allow: /
带有原始内容信号取值的 Cloudflare 托管 robots.txt 内容。
# Cloudflare Managed content with the new content-use signal

User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
加入新增参数后的 Cloudflare 托管 robots.txt 内容。
我们还开始在 BotBase 中为每个机器人追踪内容使用方式;一旦发现某个机器人滥用这些信号,它将失去“已验证(Verified)”状态,从而不再被允许访问。目前,完整复现内容的机器人无法获得已验证状态。
机器人“已验证”意味着什么?
既然提到“已验证”,已验证的定义也正在更新,以反映即将到来的默认允许与拦截基线的变化。此前,所有已验证机器人都默认被允许,这体现在我们用于拦截不需要的自动化流量的基础版 Bot Fight Mode 中,也体现在面向企业版机器人管理客户的规则模板中。
从今天起,我们对此做出调整,增加了细分:未验证的机器人仍默认被拦截,但我们不再把“已验证”视为“默认允许”。现在,“已验证”标签意味着机器人可以在其相关类别下被允许,也就是说,由被允许的类别(例如允许搜索)来决定哪些机器人可以访问网站。
为了平衡这一变化,我们同时放开了成为已验证机器人的流程,并让它更加透明。要“验证”一个机器人,机器人运营方需要证明两点:你如实表明自己的身份,并且你不会滥用这份诚实所换来的访问权限。为了让机器人运营方更轻松,我们目前正在构建管理工具,帮助他们更好地确保自己在 Cloudflare 分类体系中被准确呈现(将在近期公布)。
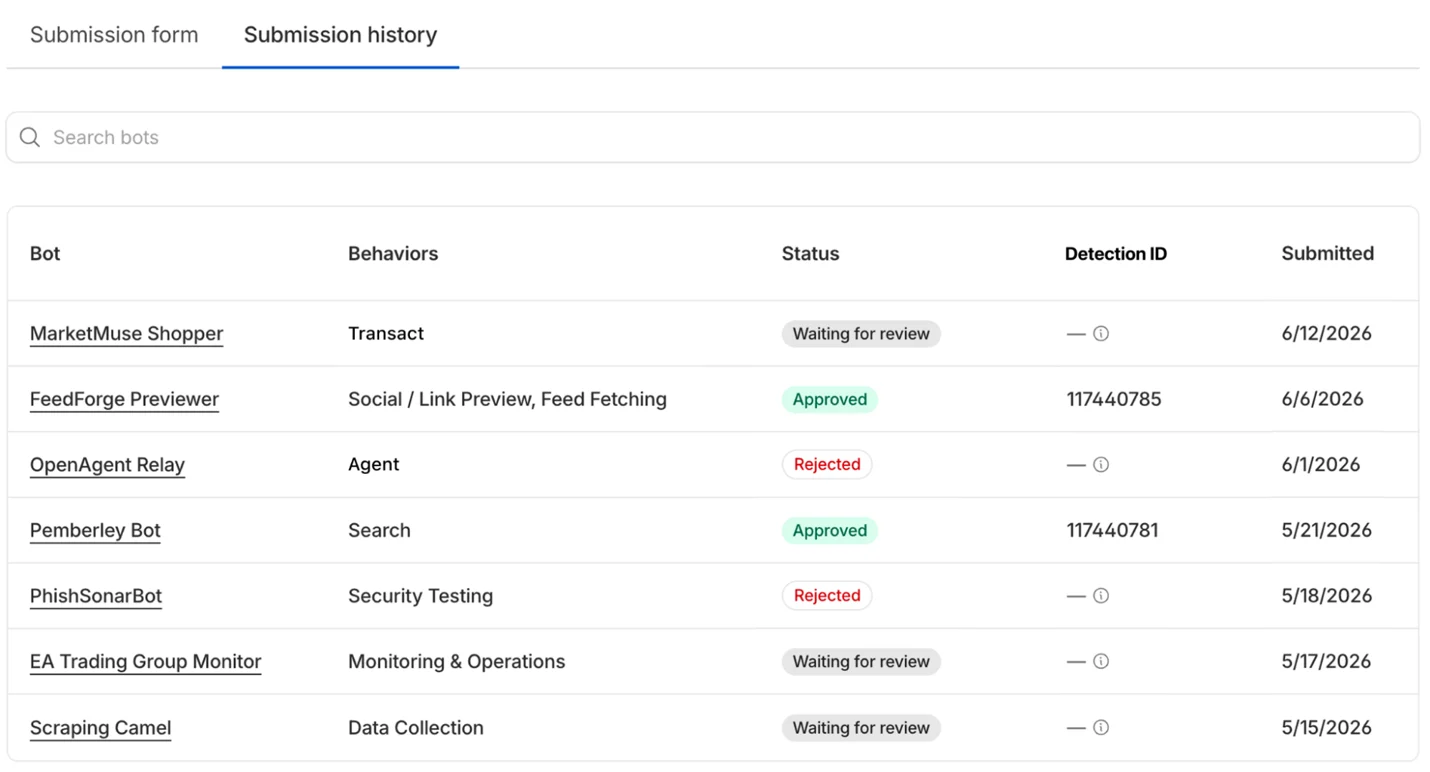
即将推出的平台预览截图,该平台专为属于或希望加入 BotBase 的机器人运营方打造,BotBase 是下一代 Cloudflare 机器人目录(Bots Directory)。
试验传递式信任
还有一点:站在你门前的机器人(或智能体),越来越多地并非由构建它的公司运行。像 Cloudflare 开发者平台这样的平台,会同时为成千上万不同的运营方运行自动化程序,其中既有大型企业,也有你从未听说过的个人开发者。你也许信任 Stripe,但未必信任每一个把 Stripe 的工具接进周末小项目的人。
我们把(网站所有者 → 拥有机器人的公司 → 终端用户)这种情形称为传递式信任(transitive trust),并建议利用 RFC 7239 中定义的现有 Forwarded 标头,它随请求一起传递,允许“代理组件披露在代理过程中丢失的信息”。
这类似于 X-Forwarded-For 对 IP 地址所做的事,或 X-Forwarded-Host 用来保留原始 Host 标头的做法。因此,当网站所有者说“允许这个运营方”时,无论该运营方是直接访问你,还是经由三层受信任的中间方而来,这一偏好都会生效。更多细节请参阅我们的文档,下面给出一个简短示例来展示其格式。
Forwarded: for="openai"
加上前文讨论的内容使用扩展后,标头新增部分大致如下,用来说明运营方声明自己将如何使用其访问到的内容:
Forwarded: for="openai";use="reference"
这也使我们想要培育的激励模型保持一致。在位于 Cloudflare 之后的超过 20% 的网络域名上失去受信任身份,是一种有分量的威慑。信任成为你可以随身携带、也可能失去的东西。
不过,随着机器人流量与人类流量日益混杂,这套传递式信任体系有可能无法延伸到那些负担不起可识别身份的用户之外。我们今天提出的措施有助于传递信任,但无法适用于整个网络、永远有效。小型流量来源需要隐私,而希望坚守自身隐私承诺的公司,也应当能够探索面向智能体化互联网未来的公平构建模块,例如私密速率限制。
今天就设定你的规则
这些都是朝同一方向推进的小改动:网站所有者将对谁使用其内容、以及如何使用拥有更多控制权。我们相信,今天讨论并即将实施的新默认值鼓励透明,也更符合世界发展的方向。
当然,网络的潮起潮落还会继续在我们脚下变化,我们也会随之不断调整。但方向不会改变,因为那正是 Cloudflare 出发时的方向:围绕信任构建的网络生态。在这里,创作者可以决定自己的作品如何被使用——而对自己所做之事保持诚实,换来的是更多而不是更少的访问权限。
这些管理 AI 流量的新选项现已上线,所有现有客户都可以在其站点(zone)设置中进行配置。还没有使用 Cloudflare?免费开始,今天就设置你想要的流量控制。
内容独立日快乐。