AI 基础设施已悄然成为生产基础设施。团队不再只是用寥寥几块 GPU 做实验。一个单节点原型,很快就可能发展成横跨数百块加速器的分布式训练任务。服务真实用户的推理系统,可能遭遇难以预测的流量高峰。而随着集群变成共享环境,运维门槛对所有人都变了——从机器学习研究员到企业平台工程师,无一例外。
但随着这类基础设施不断扩大,手动管理就成了负担。静态预配既低效又昂贵。权限管理变得脆弱。可观测性的缺口掩盖了性能瓶颈,而当 GPU 硬件出现故障时(这终究难免),一个不稳定的节点就可能毁掉数小时的训练时间。
今天,我们为 Together GPU Clusters(原 Instant Clusters)推出多项重要的企业级增强。我们把自动扩缩容、基于角色的访问控制(RBAC)、全栈可观测性、自助节点修复和主动健康检查直接整合进核心集群体验中,让团队既拥有虚拟化栈的弹性,又保有裸金属的性能表现。
自动扩缩容:无需过度预配的弹性容量
你不必再按峰值负载静态分配 GPU 容量,只需启用“自动扩缩容”,让集群根据实时资源需求扩张或收缩。
该功能由 Kubernetes Cluster Autoscaler 驱动,它会监控来自分布式训练或突发推理流量的、受 GPU 资源限制的工作负载(处于 pending 状态的 pod)。需求激增时,会自动上线更多节点;需求消退后,容量随之缩减。
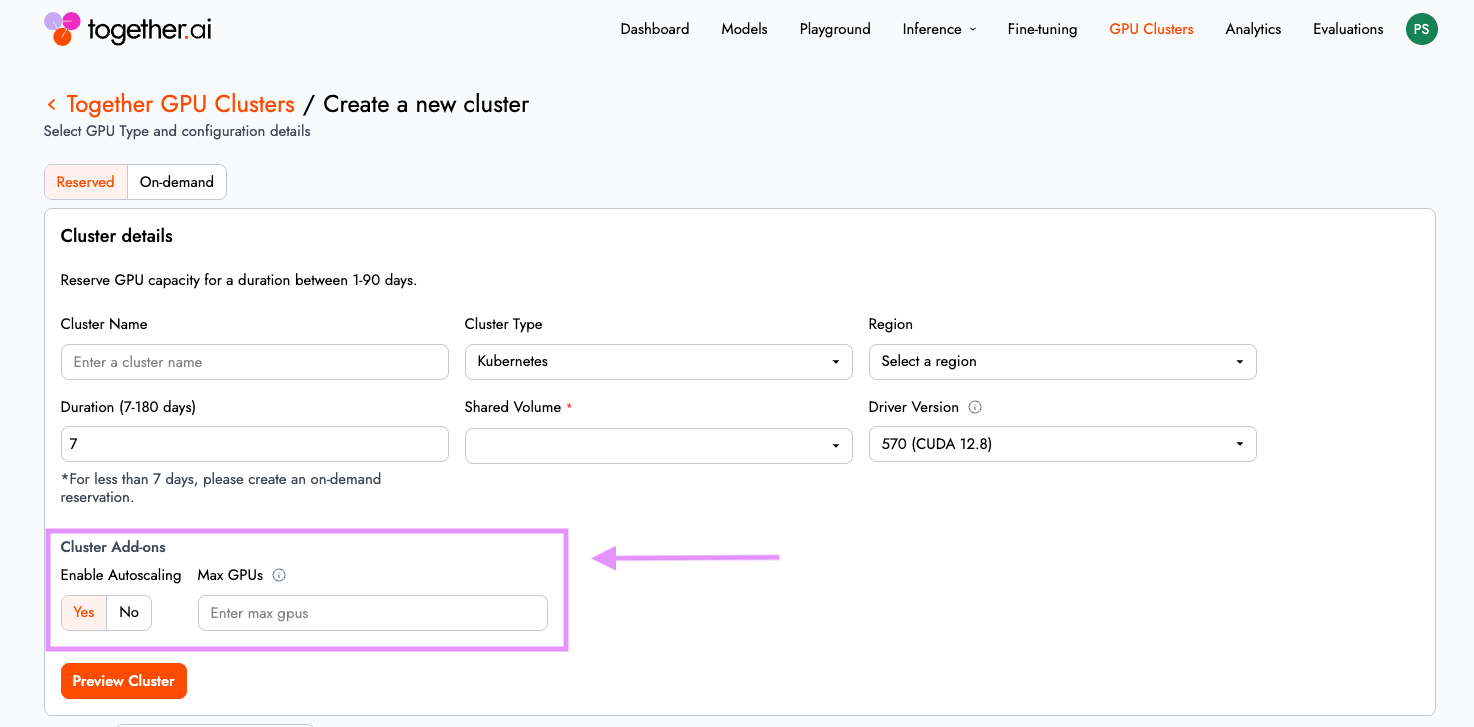
结果很直接:负载下性能不打折,闲置的 GPU 节点也无需付费。这使 Together GPU Clusters 既适合长时间运行的训练任务,也适合负载多变的推理场景。想进一步了解该功能,请访问我们的文档。
主动健康检查、更深入的验收测试与自助节点修复:缩短故障的 MTTR
在大型 GPU 集群中,硬件不稳定并非假想的风险,而是运维中的现实。对于分布式训练工作负载,单个节点故障就可能让整次任务运行作废。
Together GPU Clusters 现已提供自助式主动健康检查。在启动大型训练任务之前,用户可以直接在 UI 中触发各类测试,从基础的 DCGM Diag 3,到多节点 NCCL 或 InfiniBand 写带宽测试,并获得带详细输出的通过/失败结果。
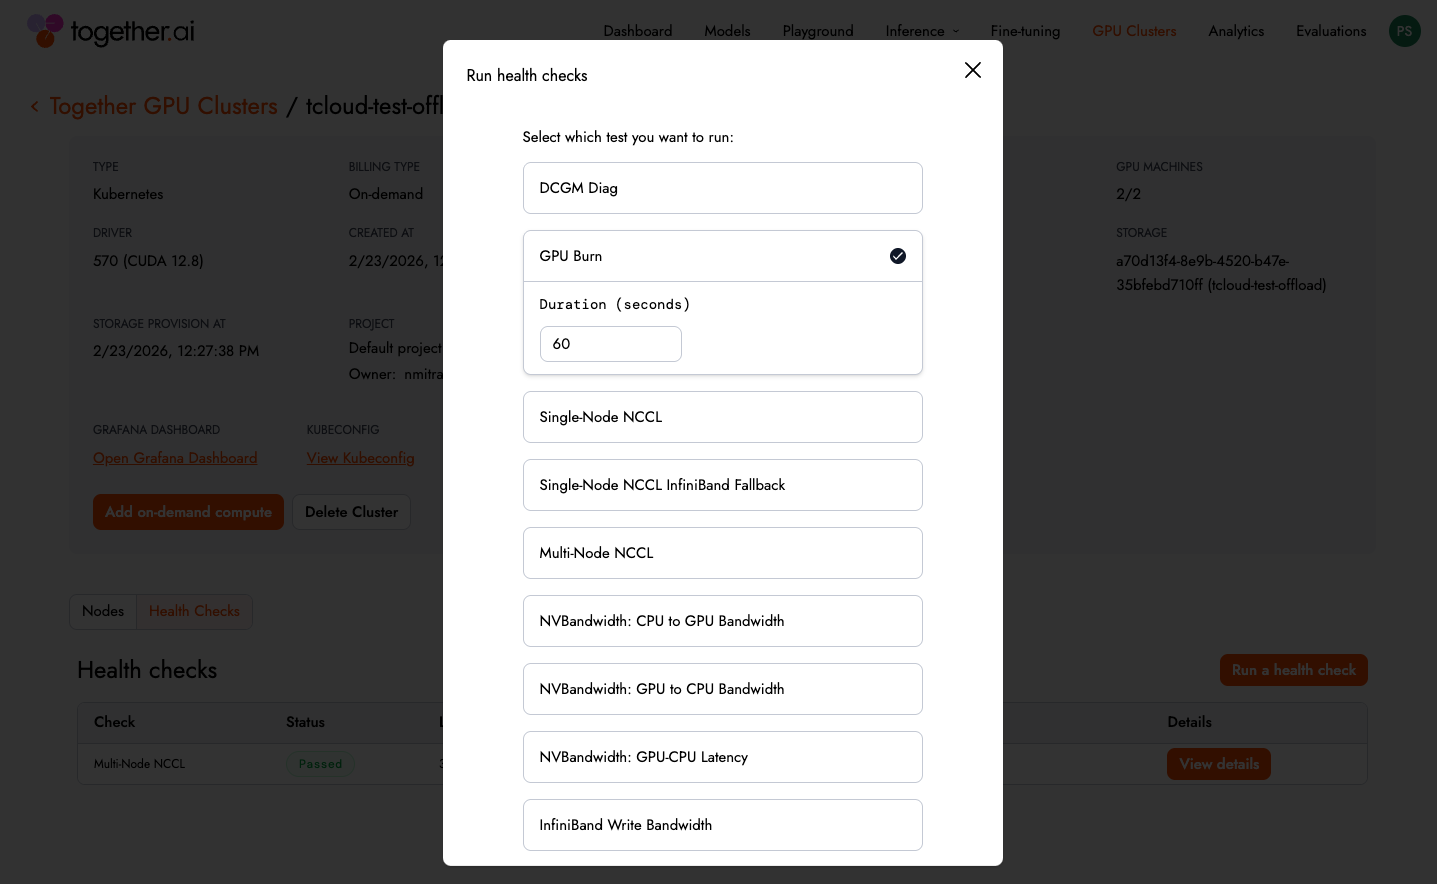
这一能力对分布式训练工作负载尤为关键,因为单个节点故障就可能让整次任务运行作废。用户现在可以在启动大型训练任务之前,对基础设施执行一系列深度检查,从而保障工作负载的连续性,减少浪费的计算周期。
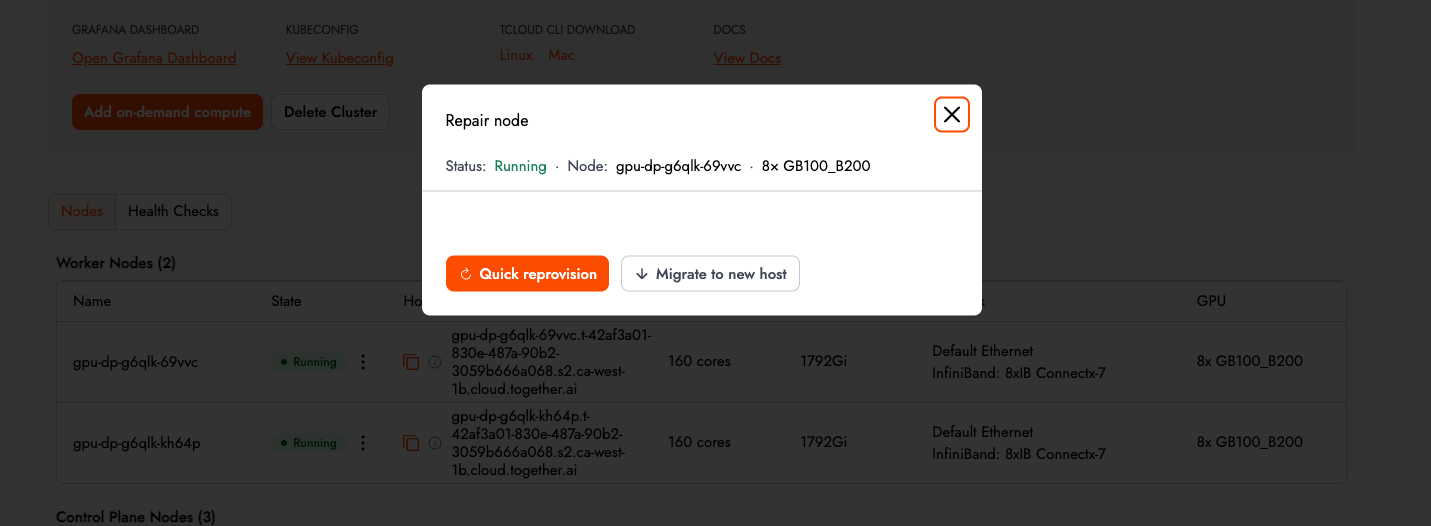
如果某个节点出现故障,用户点三下即可完成自助修复。控制平面会自动对该节点执行 cordon、drain,并在新的或现有的主机上重建节点,在几分钟内让集群恢复健康状态。验收测试现在会在预配过程中自动运行,通过之前集群不会被标记为 Ready。完整的验收测试列表请见此处的文档。
基于角色的访问控制:结构化的多团队治理
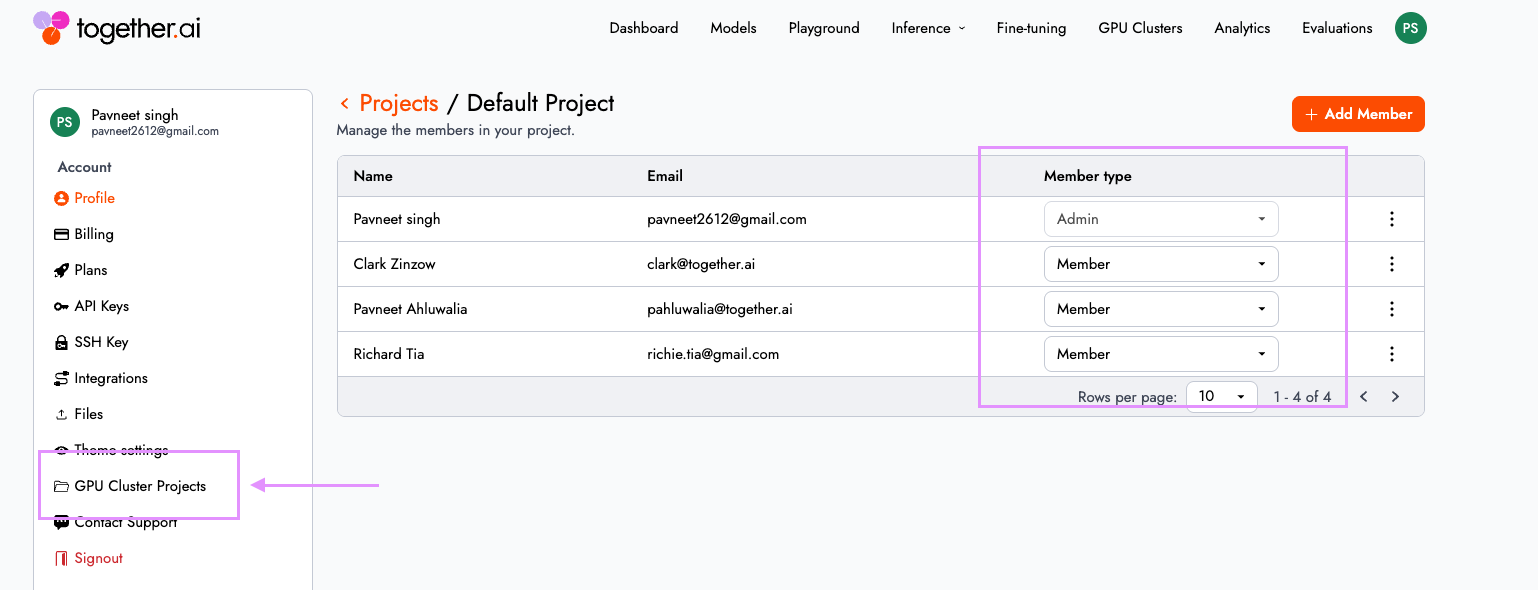
当集群从实验阶段走向共享基础设施,访问控制就成了基础。在 Together GPU Clusters 中,“项目(Project)”现在定义了团队间的协作与隔离边界,集群和存储卷都严格限定在各自的项目范围内。
管理员可以实施与企业治理要求相符的结构化访问控制。默认情况下,项目包含两种角色:
- Admin:对控制平面拥有完整的读写权限(创建/删除集群),并对 Slurm 集群拥有 sudo 权限。
- Member:对数据平面拥有写权限(可访问 GPU 工作节点并运行工作负载)。
这种清晰的划分让平台工程师可以锁定基础设施的预配权限,同时让研究和应用团队在各自的边界内自由、安全地运行工作负载。
你可以在云控制台中管理项目成员和用户角色,路径为 Settings > GPU Cluster Projects
想进一步了解该功能,请访问我们的文档此处。
全栈可观测性(私有预览)
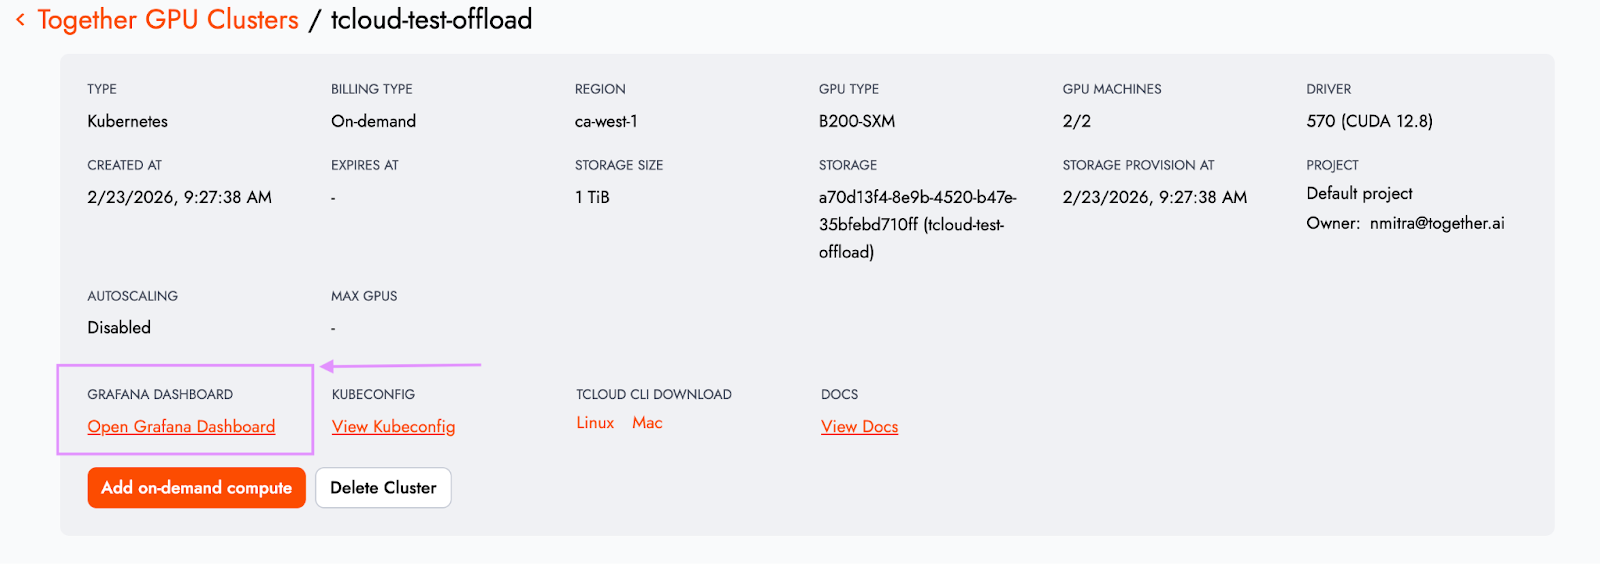
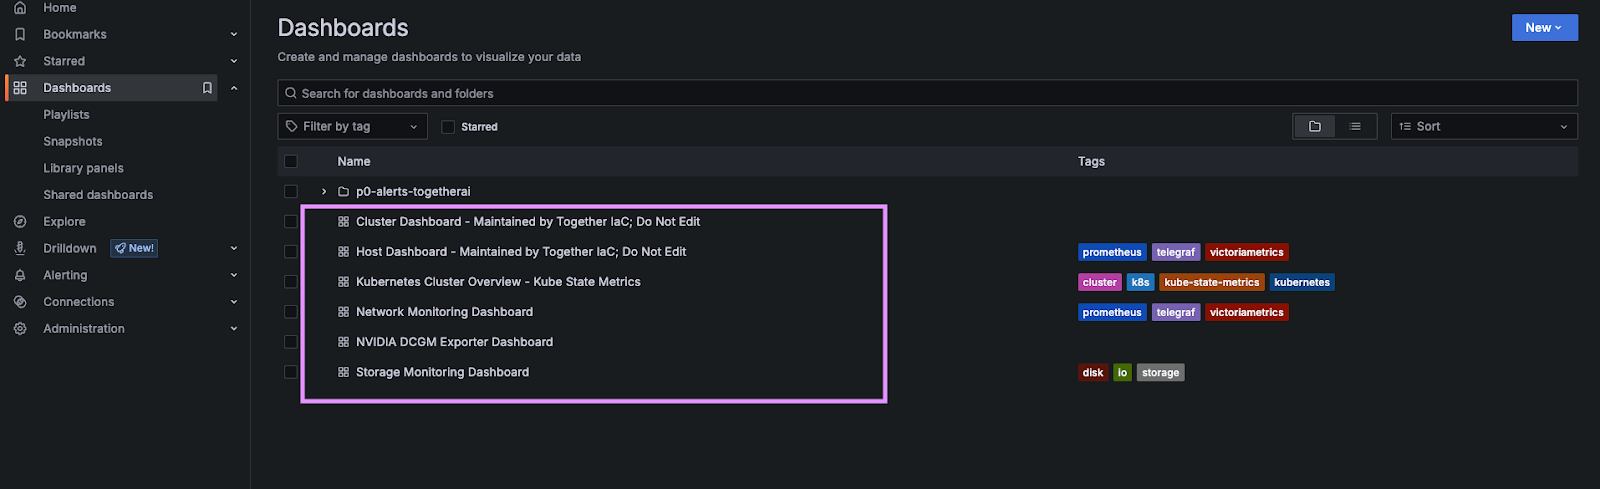
每个 Together GPU Cluster 项目现在都包含一个专属的 Grafana 实例,内置预设仪表盘,可直接从集群详情页访问。
遥测数据覆盖整个技术栈:
- GPU 利用率:DCGM 指标可直接反映加速器的健康状况和性能。
- 网络:InfiniBand 和网卡(NIC)级别的遥测数据展示吞吐量与带宽模式。
- 存储 & 编排:I/O 性能指标能暴露隐藏的瓶颈,而 Kubernetes 遥测数据则让你看清编排的健康状况和资源分配。
集群一经预配,遥测数据即可使用。对平台团队来说,这能加速调试和性能调优;对财务和运营团队来说,则有助于改善容量规划和成本效率。
从实验走向运营
有了自动扩缩容、RBAC、可观测性、开箱即用的健康检查和修复机制,Together GPU Clusters 不再只是提供原始的 GPU 预配,而是迈向了可用于生产、完全托管的基础设施。
这让团队可以放心地运行大规模分布式训练任务,不必担心硬件故障连锁引发算力损失。它也为组织内的不同角色带来了各自的价值:
- 平台工程师可以在共享环境中安全地支持多个内部相关方。
- 运维人员可以在网络或存储瓶颈拖累模型性能之前就将其定位。
- 财务团队可以让 GPU 支出更贴近实际的利用率模式。
最重要的是,组织可以从实验性的 AI 系统迈向可运营的 AI 平台,而无需拼凑第三方工具,也无需从零搭建内部控制平面。
开始使用
这些能力现已在 Together GPU Clusters 中提供。