2026 年是智能体框架(harness)走向生产的一年。控制模型访问外部世界的软件,如 Codex、Claude Code、OpenCode、Pi 和 Project Think 这类 harness,已经成熟到团队开始把智能体当作真正承重的基础设施来部署,而不再只是原型。
但要构建能扛住生产环境的智能体并不容易。
我们在构建自家的第一方智能体 harness Project Think 时亲身体会到了这一点。在与客户一起让智能体在生产环境中运行的过程中,我们发现每个智能体在云端运行时都会遇到一组共同的分布式系统问题。智能体被中断时,如何自动、平稳地从中断处恢复,既不丢失上下文,也不浪费词元(token)?智能体如何安全地运行不受信任的代码?智能体如何使用它们训练时所熟悉的工具?
单靠 harness 无法解决这些问题。它们与状态、存储和计算息息相关,因此取决于智能体所运行的平台。这就是为什么我们要把为生产环境加固 Project Think 所得的经验,作为基础层带入 Cloudflare Agents SDK。持久化执行、动态代码执行、持久化文件系统和动态工作流,现在对任何基于 Agents SDK 构建的 harness 都可用。
与此同时,harness 之上出现了新的一层。Flue 这类框架在 harness 外面包上项目结构、约定、集成和开发者体验,让智能体的构建更高效。
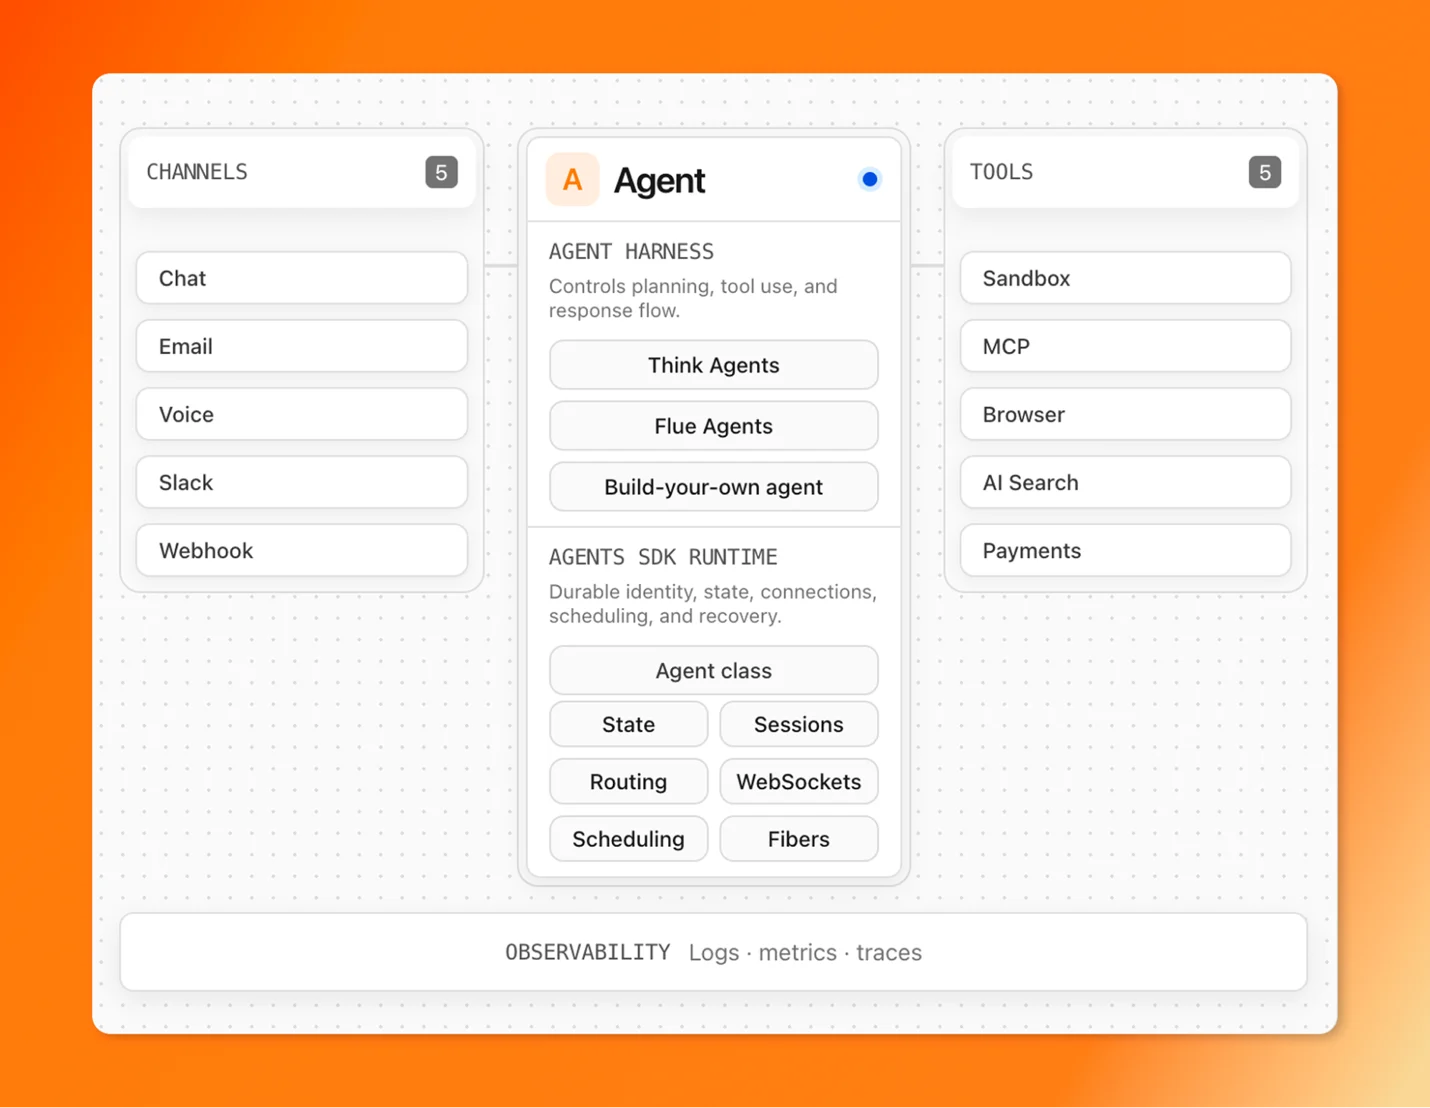
为应对这些规模化挑战,一种新的三层技术栈正在形成,用于构建生产级 AI。下面按从面向用户的开发者体验到底层平台原语的顺序,说明各部分如何配合:
- 框架(Flue):用于构建智能体的项目结构、约定、集成、CLI 和开发者体验。
- Harness (Pi、Project Think):智能体循环,负责调用工具、读取结果、管理上下文,并持续运行直到任务完成。
- 运行时/平台 (Cloudflare Agents SDK):上面所有层所依赖的计算、状态和存储原语
Agents SDK 就是最底层:它让持久化执行等原语可供任何 harness 和任何框架使用。Flue 是来自 Astro 团队的全新开源框架,也是第一个基于它构建的框架。具体如下。
Flue
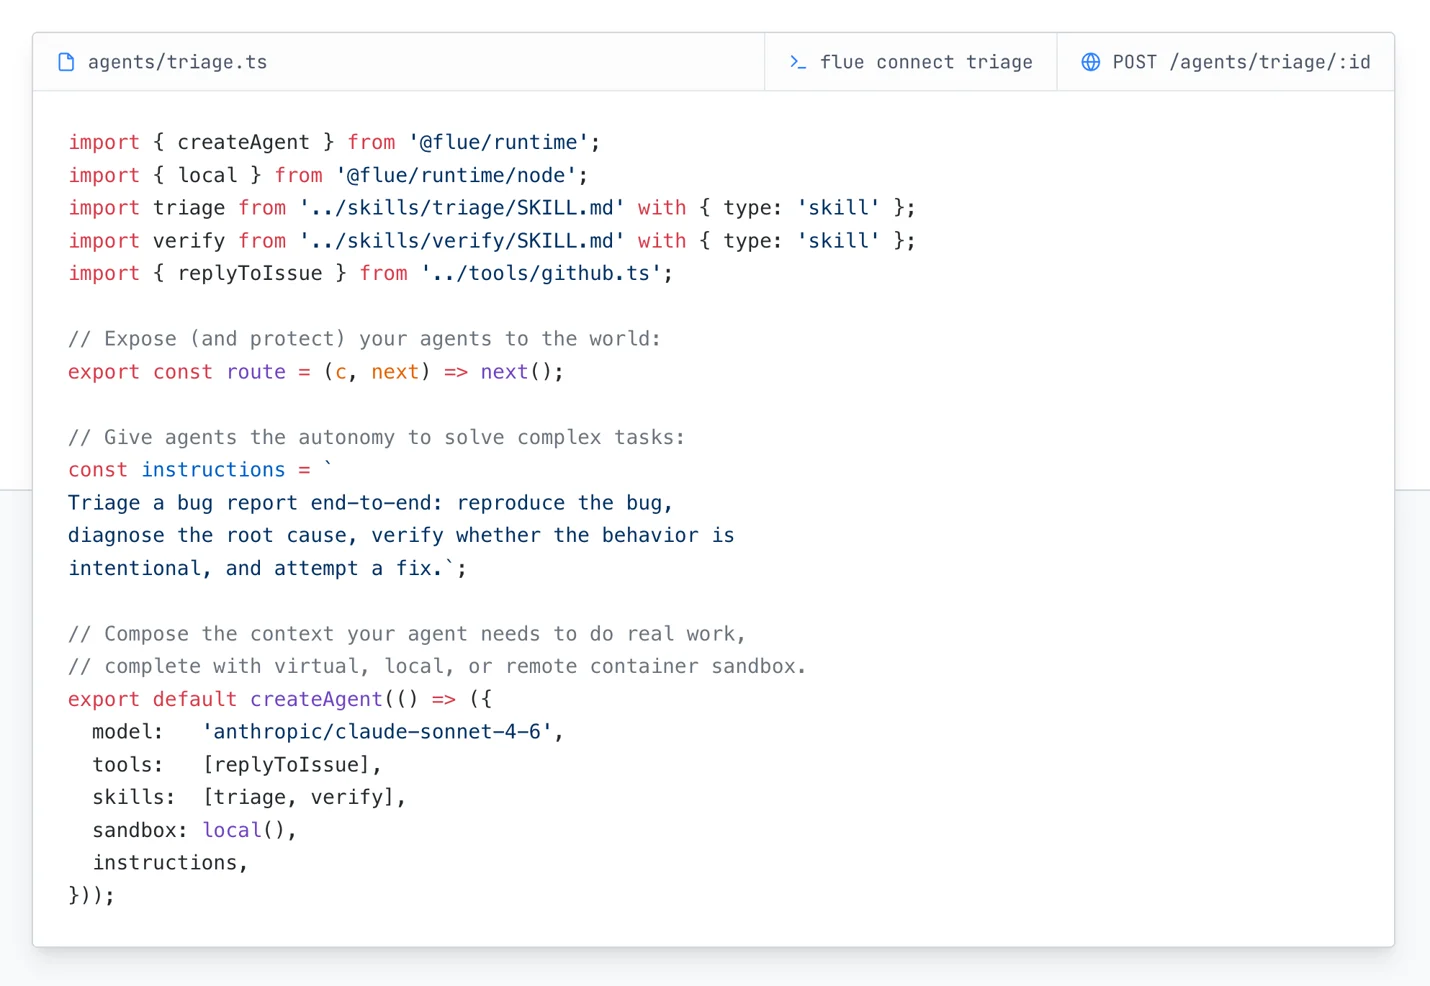
Flue 本周发布了 1.0 Beta,基于 Pi harness 构建,OpenClaw 也是基于同一个 harness。它作为智能体框架的与众不同之处在于思路:你不必编写智能体做什么,只需描述它知道什么。定义智能体所需的上下文,包括模型、技能、沙箱和指令,它就会自主完成你交给它的任何任务。无需编写编排循环。
这种声明式模型让编写智能体变得容易。下面这个分诊智能体能拦截一份缺陷报告,在沙箱中复现问题并诊断原因,代码不到 25 行。
Flue 的开发者体验
Flue 的强大之处在于,智能体并不孤立存在。它们生来就是要置身于用户已有的工作场所,并与你偏好的工具集成:
- 无处不在的智能体:通过预配置的 Channels,把智能体接入 Slack、GitHub、Linear 或 Discord,事件验证和分发的样板代码由它自动处理。
- 无界面运行,也随时可接 UI:智能体不应活在黑盒里。Flue 智能体可以完全无界面地运行后台任务,同时 @flue/react 提供原生前端 hook,把智能体的状态、工具执行和实时消息直接流式推送到你的前端应用,你无需从零自建实时通信管道。
- 生态就绪:Flue 让添加和升级集成变得简单,只需使用
flue add channel slack之类的命令,它会生成一份 Markdown 蓝图,你自己的编码智能体可以阅读、修改,并干净地集成进你的代码库。
为生产而设计,而不只是原型
把智能体从本地终端搬进生产生态,会带来传统分布式系统中的各种故障。主机崩溃、LLM 提供商的 API 超时和意外重启,都可能抹掉正在运行的智能体回合的短期记忆。
Flue 通过持久化流(Durable Streams)解决这个问题。执行历史中的每个事件都会追加到一个只追加日志中。每条提示词、每次工具响应和每个模型选择都作为不可更改的账本来处理,因此智能体的状态永远不会是易失的。如果一个进程挂掉,另一个进程只需接过日志,从中断的那一步继续即可。
可部署在任何地方,包括 Cloudflare
Flue 是一个多云框架。在 Node.js 上,每个智能体作为长期运行的进程运行。你可以把它部署到任何虚拟机或容器、在 GitHub Actions 中运行,或嵌入现有服务器。而当你以 Cloudflare 为目标时,每个智能体都会成为一个 Durable Object。
由于每个 Flue 智能体都运行在自己的 Durable Object 中,Cloudflare 可以按你的需要自动扩展到任意数量的智能体,每个都有各自隔离的存储和计算。你无需配置服务器、管理粘性会话,也不用担心吵闹邻居问题。当 Flue 智能体部署到 Cloudflare 时,它们通过 Agents SDK 的 runFiber()、stash() 和 onFiberRecovered() 方法获得持久化执行能力。Flue 还使用 @cloudflare/codemode 和 @cloudflare/shell,在持久化工作区上进行沙箱化代码执行。
Harness 需要智能体平台提供什么
Flue 的 Cloudflare 目标之所以如此高效,是因为它与我们内置于 Agents SDK 的核心原语完美对应。你甚至可以深入阅读 Flue 的源代码,了解底层 harness Pi 是如何适配到 Cloudflare Agents SDK 上运行的。
下面介绍 Flue 在底层如何利用 Agents SDK,以及要让任何现代智能体 harness 可靠地大规模运行需要哪些条件。
每个智能体 harness 都需要持久化执行
一个智能体回合并不是单个请求。模型流式输出词元、调用工具、等待结果,也许还要请求人类批准,或把工作委派给子智能体。这个过程可能持续几秒或几分钟,随时可能被中断或崩溃。一旦发生这种情况,内存中的所有智能体状态都会丢失:流式连接、待处理的工具调用,以及智能体在回合中进行到哪一步。诚然,对话历史会持久化到磁盘,但用户看到的是一个永远转不完的加载图标。这是糟糕的用户体验。
Fibers 通过在智能体底层的 Durable Object 内部直接提供原生检查点机制来解决这个问题。runFiber() 会在智能体回合的工作开始之前,把进度记录到 Durable Object 的 SQLite 存储中,并随着回合推进用 stash() 设置检查点。当中断后启动一个全新的智能体实例时,onFiberRecovered() 会交付最近一次的检查点,因此你的智能体知道某个回合曾被中断、进行到了哪里,并可以决定如何继续。
import { Agent } from "agents";
import type { FiberRecoveryContext } from "agents";

class MyAgent extends Agent {
  async doWork() {
    await this.runFiber("my-task", async (ctx) => {
      const step1 = await expensiveOperation();
      ctx.stash({ step1 });

      const step2 = await anotherExpensiveOperation(step1);
      this.setState({ ...this.state, result: step2 });
    });
  }

  async onFiberRecovered(ctx: FiberRecoveryContext) {
    if (ctx.name !== "my-task") return;

    const { step1 } = (ctx.snapshot ?? {}) as { step1?: unknown };
    if (step1) {
      const step2 = await anotherExpensiveOperation(step1);
      this.setState({ ...this.state, result: step2 });
    }
  }
}
Flue 在其 Cloudflare 目标上正是为此使用 runFiber()。借助 onFiberRecovered() 钩子,你的 harness 可以决定如何恢复该回合的执行:是像 Project Think 那样尝试完整重建模型、修复回合状态,还是重放回合中的某些部分。
执行代码比给智能体堆砌工具更好
智能体 harness 通过工具让模型访问外部世界。但工具面增长很快,随着列表变长、上下文窗口被工具定义填满,模型选对工具的能力会变差。更好的模式是:只给模型一个执行代码的工具。模型编写一个调用所需 API 的 TypeScript 函数,由 harness 运行。我们在介绍 Code Mode 时写过这一点。
问题在于这些代码在哪里运行。要安全地运行 LLM 生成的代码,你需要沙箱。但对每次工具调用都用典型沙箱来运行,既慢、成本又高、效率也低。因此 Agents SDK 提供了 @cloudflare/codemode,它封装了 Dynamic Workers,在独立的 Worker 隔离环境(isolate)中执行 LLM 生成的代码,且只提供你给定的绑定。
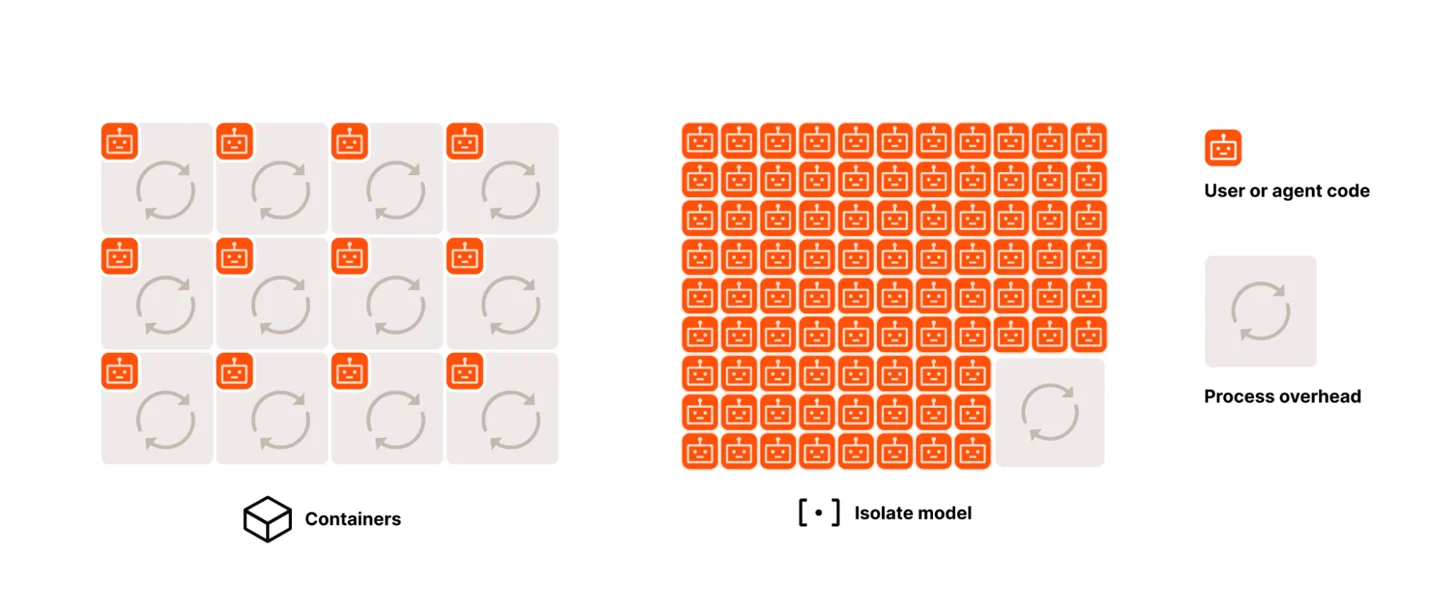
Code Mode 为每个代码片段创建一个全新的 Dynamic Worker,运行后即丢弃。隔离环境的启动时间在 10ms 以内,每次加载 $0.002,相比每次智能体要执行一小段代码就启动一个容器,执行速度快得多,成本也低得多。Flue 在其 Cloudflare 目标上使用 @cloudflare/codemode 来驱动其代码工具。智能体针对工作区编写 JavaScript,并通过 Code Mode 运行。
大多数工作区任务并不需要完整的容器
智能体 harness 往往需要文件系统,用来读取文件、写出结果、搜索代码和理解差异。编码智能体尤其离不开文件系统。但如果 harness 运行在无服务器环境中,怎么才能获得一个跨执行持久保存的文件系统呢?
通常的答案是容器。这样可行,但对智能体大多数时候要做的事来说成本太高。智能体一个回合中的文件系统操作,大部分是文本操作。想想一个审查智能体,它读取文件、在源代码中 grep,或许还会写一个补丁。这些并不需要完整启动一个 Linux。
@cloudflare/shell 在智能体的 Durable Object 内部,为它提供一个由 SQLite 支撑的持久化虚拟文件系统。它提供带类型的文件操作,包括读取、写入、编辑、搜索、grep 和 diff,智能体 harness 可以把它们当作工具使用。
运行在 Cloudflare 目标上的 Flue 智能体不是调用一个个单独的工具,而是针对工作区虚拟文件状态 API 编写 JavaScript。通过在 Durable Object 内运行更多操作,智能体受益于隔离环境模型更高效的执行过程,完全避免了容器开销:
async () => {
  const files = await state.glob("src/**/*.ts");
  const results = [];
  for (const file of files) {
    const content = await state.readFile(file);
    const todos = content.match(/\/\/ TODO:.*/g);
    if (todos) results.push({ file, todos });
  }
  return results;
}
对于需要运行 shell 和文件系统操作才能完成工作的智能体,这意味着更快、更具成本效益的沙箱环境。而对于需要完整操作系统来运行 npm install、git 或编译器的智能体,Cloudflare Containers 可以满足。我们也在构建 @cloudflare/workspace,让某个 Durable Object 的虚拟文件系统与容器的文件系统保持同步,从而只在需要时才从轻量的 Workers 无缝切换到 Linux 环境。
动态工作流(Dynamic Workflows):让智能体编写自己的工作流,以稳定地重复执行任务
但如果智能体要做的不止是读取文件或执行单个代码片段,会怎样?如果它需要编排一条庞大的多步骤流水线,并且这条流水线必须随时间稳定地重复运行,比如能成功解决缺陷的代码审查,或能产出良好结果的研究工作流,又会怎样?harness 自己无法提供持久化的多步骤执行。它需要平台来持久化每个步骤、重试失败,并在中断后恢复。
这种模式正在受到关注。Claude Code 最近发布了动态工作流:Claude 在运行时编写一个 JavaScript 脚本,把工作交给数十个子智能体,由运行时以持久化方式执行。@cloudflare/dynamic-workflows 为任何运行在 Agents SDK 上的 harness 提供了这种能力。你的智能体在运行时生成工作流,Workflows 引擎会持久化每个步骤、重试失败,并且可以休眠数小时,或等待人工批准之类的外部事件。
在 Agent 类中,runWorkflow() 把你的智能体连接到 Workflows 引擎。智能体启动工作流后即可进入休眠。工作流通过 RPC 回调智能体,以报告进度、更新状态或请求批准。工作流结束时,智能体带着结果被唤醒。
直接访问 Cloudflare 生态
除了计算和存储,智能体 harness 还需要访问外部能力:网页浏览、电子邮件、记忆、搜索和推理。harness 不应该为这些能力逐一做集成、为每一项管理 API 密钥,或者担心凭据通过智能体生成的代码泄露。
Agent 类通过绑定(bindings)让你的 harness 访问 Cloudflare 的其余能力:用 AI Gateway 按智能体追踪花费并设置限额,用 Browser Run 做网页自动化,用 Email Service 处理收件箱工作流,用 Agent Memory 实现持久记忆,用 AI Search 做检索,用 Containers 运行需要完整操作系统的工作负载,并通过 14 家以上的模型提供商进行推理。绑定在不暴露凭据的前提下授予能力:你的智能体可以使用它们,但密钥永远不会进入智能体生成的代码。
把你的智能体带到智能体云
我们知道这种方法行得通,因为它正是我们构建第一方智能体 harness Project Think 时所用的架构基础。Project Think 仍是我们为原生 Cloudflare 智能体体验打造的、开箱即用的高度优化方案,而 Agents SDK 则确保更广泛的开源生态,包括 Flue 在内,也能利用这些同样经过实战检验的原语。
如果你现在正在用 Flue 构建智能体,只需点几下就能部署到 Cloudflare。如果你在构建自己的智能体 harness 或智能体框架,那就以 Agents SDK 为目标,免费获得平台集成。
- Agents SDK:developers.cloudflare.com/agents
- Flue:flueframework.com、
npm install @flue/runtime - Think:文档
- Cloudflare 社区:community.cloudflare.com