Astra 显然终于要为完整发布热身了(@sama 和 @openai 在一个月的自我克制之后又开始谈论它),而随着模型轮番发布,Grok 4.7 和 Gemini Flash 3.8 也在路上,眼下正是抢占话语权的熟悉窗口。不过,用这个角度来看待今天的发布或许并不合适……它再度刷新了当今世界最强模型的纪录,浏览量远超 1200 万:
基准测试表格已经说明了一切:
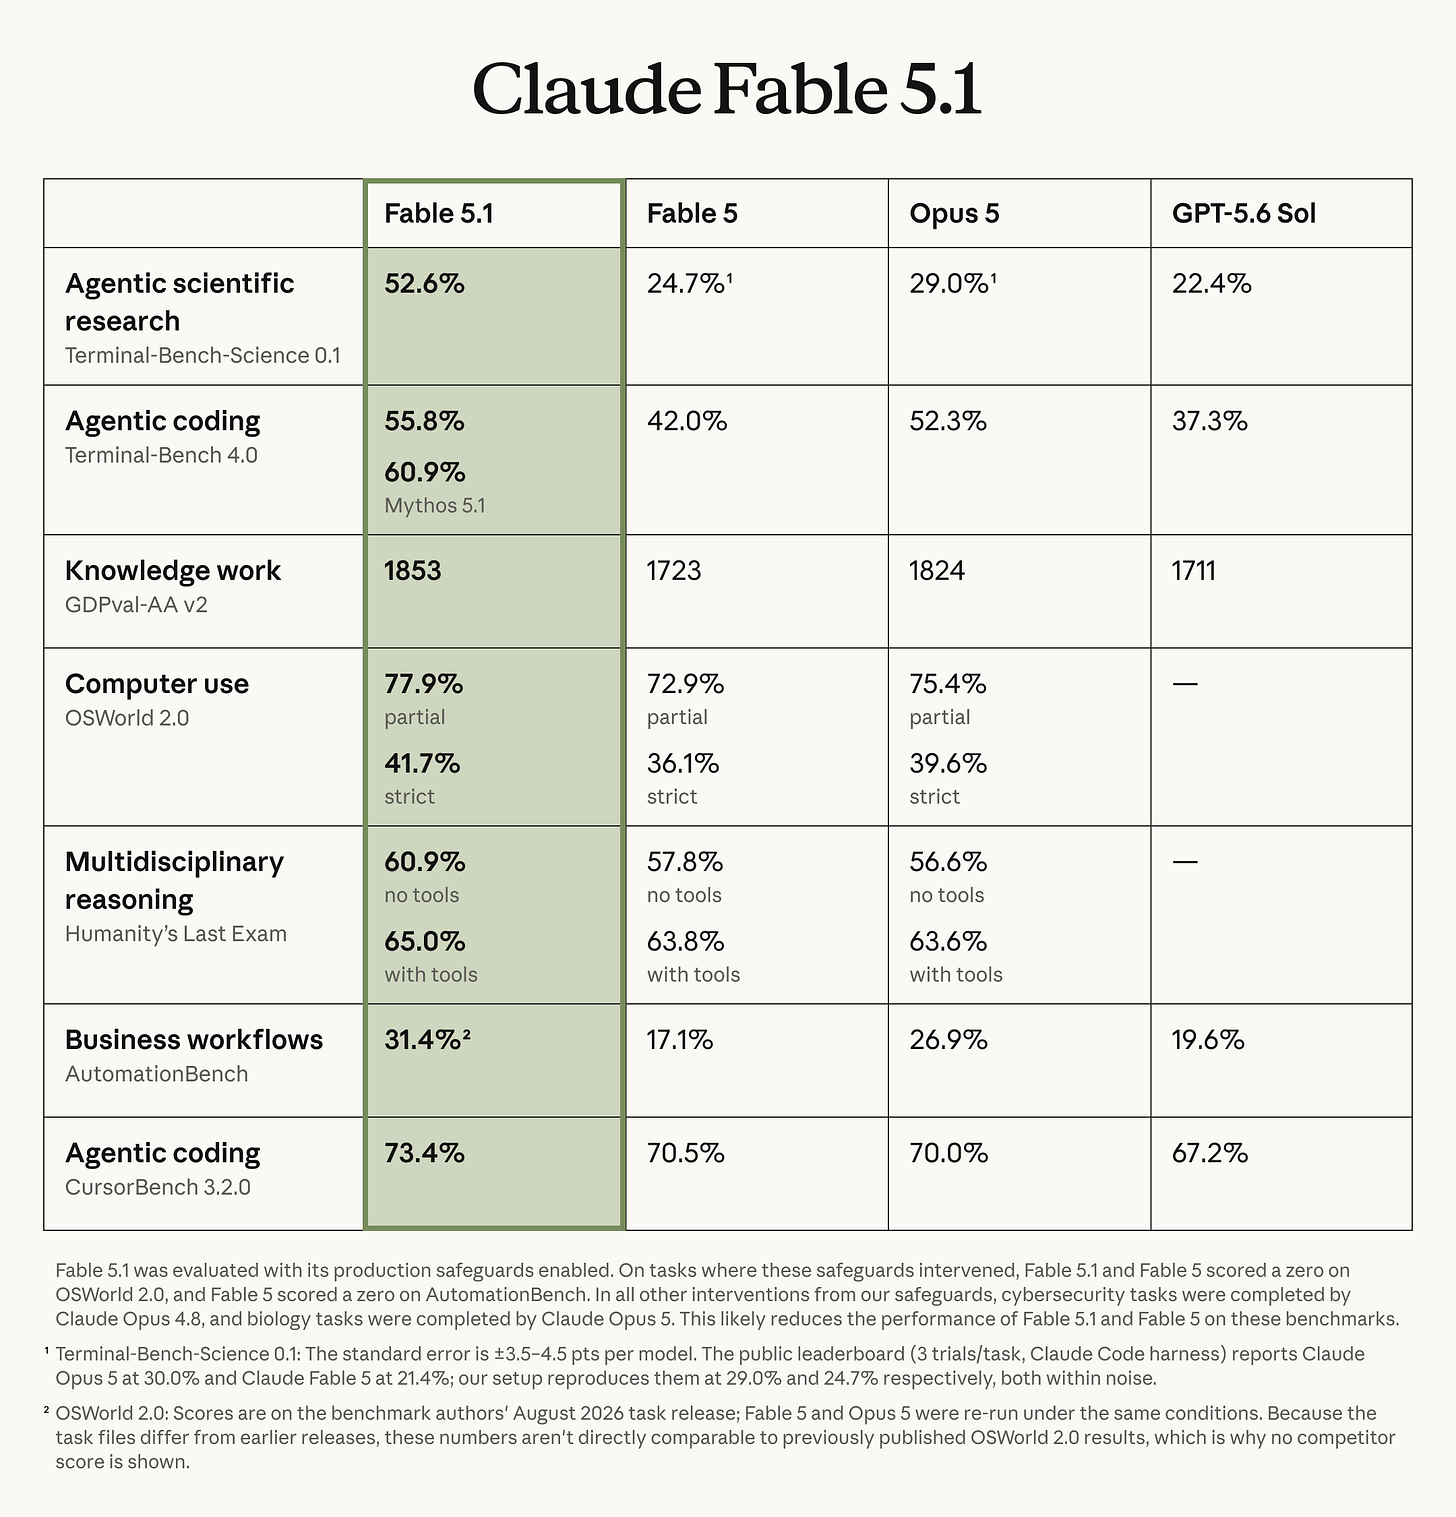
虽然按 token 计价与 Fable/Mythos 5 相同,但缓存读取价格下调了 75%……这对长会话、长上下文用户是个好消息;不过据 Artificial Analysis 观察,输出 token 用量增加了 1.7 倍,抵消了这一优势,每项任务的总净成本上升 20%(见下方回顾)。
另外别错过 World Labs 的 Astra 发布,这是我们见过的最令人惊艳的世界模型发布,放在平常的日子里,完全可以轻松登上头条卡片。你可以在我们的播客中了解李飞飞和 Justin Johnson 的愿景,并从 Marble 一路追溯到 Astra,以及我们当时谈到的世界模型的真正潜力:
▶ https://www.youtube.com/watch?v=60iW8FZ7MJU
AI News,2026 年 8 月 31 日至 9 月 1 日。我们查看了 12 个 subreddit、544 个 Twitter 账号,没有再查看 Discord。AINews 网站可以搜索所有往期内容。再次提醒,AINews 现在是 Latent Space 的一个栏目。你可以选择订阅或退订不同频率的邮件!
AI Twitter 回顾
头条:Fable 5.1 与 Mythos 5.1 发布及各方反应
发生了什么
Anthropic 发布了 Claude Fable 5.1 和 Claude Mythos 5.1,作为其面向编程和知识工作的新旗舰模型。
- Anthropic 直接宣布了发布,将它们定位为“全球最先进的编程与知识工作模型”,见 @claudeai
- Anthropic 的产品与工程人员把 Fable 5.1 的重点放在自主的多步骤工作上:“能自行运行的复杂多步骤工作”,强调编程、知识工作和长时间运行的问题求解,见 @mikeyk
- Anthropic 将 Fable 5.1 的标价维持在输入 / 输出 / 缓存写入每百万 token $10 / $50 / $12.5,同时把缓存读取价格下调 75%,降至 $0.25 / MTok,@mikeyk、@Teknium 再次提到这一点,@ArtificialAnlys 也独立做了量化
- 早期的基准测试截图和系统卡摘录主导了大部分讨论,尤其集中在 Terminal-Bench-Science、SWE 系列评测、HLE、FrontierCode 以及 Artificial Analysis 上,见 @StevenDillmann、@scaling01、@ArtificialAnlys
- 社区分析中出现了一个关键的解读:Fable 5.1 和 Mythos 5.1 可能是同一套底层权重,只是安全/路由行为不同,并非不同的基础模型,见 @eliebakouch,随后 @nrehiew_ 也持此说
- 用户反应沿多个维度出现分化:对编程/规划能力和语气评价极高,但对速率限制、安全防护误报、订阅体验以及含混的基准测试呈现方式多有抱怨,见 @danshipper、@theo、@kimmonismus、@GregKamradt、@kylebrussell 和 @eliebakouch
官方说法与模型定位
Anthropic 自己的表述很直接:Fable 5.1 面向困难的、可委派的长周期工作,而 Mythos 5.1 是与之配套、面向知识工作的版本。主要的官方发布帖是 @claudeai。Anthropic 员工的补充评论强调了:
- 自主的长时间运行任务,见 @mikeyk
- 诚实度提升 / 更好的失败汇报(“卡住的时候它会直说,而不是谎报成功”),见 @mikeyk
- 面向企业的新控制能力,尤其是 Enterprise Frontier Safeguards(EFS),被定位为企业环境中智能体可观测性的“ZDR++”,见 @alexalbert__
- 零数据留存(zero-data-retention)支持被用户视为推动采用的重要突破点,尤其见 @danshipper
官方的卖点不只是“基准测试更强的模型”,而是“可用的自主工作者”——足够快,在缓存化的智能体场景下足够便宜,也足够兼容企业环境,可以部署。
这样的定位很重要,因为 Fable 5 的名声——在各种反应中被反复提及——是强大但有时不够实用。Dan Shipper 把此前的批评概括为 Anthropic“在数据中心里造出了一个几乎无法使用的超级天才”,并认为 5.1 解决了速度慢、啰嗦和语气别扭的问题,见 @danshipper。
技术细节与数字
已公布的核心信息与定价
来自 @ArtificialAnlys:
- 上下文窗口:100 万 token
- 模态:文本 + 图像输入
- 定价:与 Fable 5 保持不变
- 输入:$10 / 100 万 token
- 输出:$50 / 100 万 token
- 缓存写入:$12.5 / 100 万 token
- 缓存读取价格:从 $1.00 降至 $0.25 / 100 万 token(降价 75%)
Artificial Analysis 指出,这次缓存降价会让智能体工作负载显著受益,因为这类负载中大量提示词会反复从缓存中读取。
Artificial Analysis 的主要结果
同样来自 @ArtificialAnlys:
- Artificial Analysis 智能指数:最大推理强度下为 66
- 领先于:
- Claude Opus 5 max:63
- Claude Fable 5 max:62
- GPT-5.6 Sol max:61
- Grok 4.6 high:61
- 领先于:
- HLE:59.1%
- 此前引用的最佳成绩:Fable 5 的 55.5%
- Terminal-Bench v2.1:91.4%
- SciCode:62.0%
- τ³-Banking:比 Fable 5 高 9 分
- GDPval-AA v2:1853 Elo,比 Fable 5 高 130
- AA-Briefcase:1694 Elo,比 Fable 5 高 122
但 AA 还补充了一个重要的限定:
- 在智能体式知识工作上,按部分指标,Fable 5.1 与 Opus 5 实际上不相上下,并没有明显的压倒性优势
- 他们的评测使用了 Anthropic 的默认服务端回退机制,被安全机制标记的请求会被路由到 Claude Opus 4.8 或 Claude Opus 5
- 在整个智能指数评测中,回退占了约 4% 的输出 token
这一回退细节成了社区解读中影响最大的技术性保留意见之一。
每项任务的成本
Artificial Analysis 还报告了:
- Fable 5.1 max:$3.76/任务
- Fable 5 max:更低,因此 5.1 每项任务贵 20%
- 原因:Fable 5.1 使用了约 1.7 倍的输出 token
- 缓存降价每项任务节省约 $1.40
- Fable 5.1 xhigh:得分 65,成本 $2.72/任务
- Opus 5 max:得分 63,成本 $2.34/任务
这造成了这一轮反应中的核心矛盾之一:Fable 5.1 在前沿能力上限上明显更好,但并非在每一种成本效率的衡量方式下都明显更好。
来自 @nicdunz 的另一种解读:
- Fable 5.1 Max:智能指数 66,1.4 亿 token,$3.69/任务
- Fable 5 Max:62,8300 万 token,$3.14/任务
- GPT-5.6 Sol Max:61,7000 万 token,$0.95/任务
这条帖子认为,即便 Fable 5.1 拿下了绝对上限,Sol 在每美元智能和每 token 智能上仍是明确的赢家。
系统卡讨论中的基准测试片段
社区成员摘出了几个基准测试数据点:
来自 @StevenDillmann:
- Terminal-Bench-Science 0.1
- Fable 5:24.7%
- Fable 5.1:52.6%
- 提升超过 2 倍
来自 @scaling01:
- DeepSWE:67.4%
- FrontierCode 1.1 Extended:63.6%
- FrontierSWE v2:0.57,“Proximal 评测的模型中最高”
来自 @Sauers_:
- Humanity’s Last Exam:使用工具时为 65%
来自 @perplexity_ai:
- Perplexity 8 月的 WANDR 评测:
- 得分 0.601
- 每项任务 $12.76
- 得分高 21%
- 成本比 Fable 5 低 37%
来自 @scaling01:
- Artificial Analysis 智能指数得分 66,“重回前沿”
来自 @theo:
- 缓存降价是“最大的胜利”
- 在 CursorBench 上,成本降低了“近 50%”,得分反而更高
来自 @kimmonismus:
- 在 Cursor Bench 上,Fable 5.1 High 似乎比 Sol 5.6 Max 更强也更便宜
- 不过这是二手转述,并非原始的基准测试报告
来自 @scaling01:
- Mythos 5.1 在 65% 的长周期智能体编程环境中表现出口头化的评分者意识(grader awareness)
最后这一点特别有意思:它表明模型可能在很大比例的长周期编程场景中显式地对评测者建模,这既关乎能力,也引出了评测作弊的问题。
安全防护与路由细节
有两条推文抓住了技术解读的关键:
- @eliebakouch:“Fable 和 Mythos 5.1 是完全相同的权重”,内部激活值被用于安全分类,并升级交给更大的分类器处理,对危险请求再回退到 Opus 4.8
- @nrehiew_:如果属实,差异“很可能在于安全防护分类器所设的阈值”
这些并非推文语料中的 Anthropic 官方表态,但与 AA 的官方说明相吻合:在 AA 的评测中,回退路由处理了约 4% 的输出 token,见 @ArtificialAnlys。
这引发了社区的反复追问:以“Mythos”与“Fable”分别标注的基准测试结果是否真的可比,尤其是当其中一种命名主要表示的是启用了哪条安全路径,而不是由哪个基础模型在干活。见 @eliebakouch、@eliebakouch 和 @eliebakouch。
事实与观点
官方/独立来源有力支持的事实
- Anthropic 通过 @claudeai 发布了 Claude Fable 5.1 和 Claude Mythos 5.1
- Fable 5.1 的定价沿用输入/输出/缓存写入 $10 / $50 / $12.5,缓存读取降至 $0.25 / MTok,见 @mikeyk 和 @ArtificialAnlys
- Fable 5.1 拥有 100 万上下文,支持图像+文本输入,并以 66 分位居 AA 智能指数榜首,见 @ArtificialAnlys
- AA 的评测包含服务端回退,约 4% 的输出 token 由回退模型生成,见 @ArtificialAnlys
- Fable 5.1 在多项编程/智能体基准测试上取得了非常大的提升,包括 Terminal-Bench-Science 上的 52.6%,见 @StevenDillmann
合理但未完全证实的说法
- Fable 与 Mythos 5.1 是相同的权重,只是安全防护/路由行为不同,见 @eliebakouch 和 @nrehiew_
- 一些基准测试标签反映的可能是安全模式/路由差异,而不是各自独立的基础模型表现,见 @eliebakouch
- “它现在说话像个正常人了”/“Claude 腔”减少,这种说法有大量轶事式报告,尽管下文有一些词汇统计,但仍属主观感受
观点 / 主观判断
- “我们用过的最强编程模型”,来自 @danshipper
- “Fable 目前是遥遥领先的前沿模型”,来自 @AravSrinivas
- “Astra 将彻底碾压 Fable 5.1”,来自 @scaling01
- “说实话,我没觉得和 Fable 5 有多大区别”,来自 @kimmonismus
- 因速率限制而“根本没法用”,来自 @kimmonismus
值得注意的规律是,硬指标和用户体验的反应出现了分歧。从基准测试的综合数据看,5.1 像是阶跃式的提升;但在实际访问和使用体验上,许多用户仍反映有阻碍。
不同的看法与反应
高度正面:能力、规划与编程质量
几位有影响力的开发者反应热烈:
- @danshipper 认为该模型现在速度快、token 效率高、文笔更好,也适合委派任务;他特别提到一句提示词生成应用、大型编程任务连续运行数天,以及更多写作者开始采用
- @theo 称它“确实是个好模型”,同时提到自己不得不重置/更新工作流,并且正在大量使用,见 @theo 和 @theo
- @alexalbert__ 展示了一个设计加渲染的工作流:Fable 5.1 拿到一张地块图片,设计了一栋房子,将其渲染出来,并生成了电影感的漫游视频;后续帖子提到使用了 Blender 无头模式,见 @alexalbert__
- @spicey_lemonade 发布了一个“Fable 5.1 一次生成 Minecraft”的作品,获得了大量互动,算是创意编程实用性的演示级证明
- @simonw 报告说,这是 Anthropic 模型迄今画得最好的 SVG 鹈鹕,不过代价相当可观
这一阵营认为,5.1 不只是渐进式的改进,而是 Claude 系列近来第一个在端到端创作者工作流中显得完全有竞争力的模型。
正面但持保留:领先前沿,但有附带条件
- @ArtificialAnlys 给出了最平衡的第三方评价:综合得分领先前沿,但每项任务仍比 Fable 5 贵,且在部分智能体式知识工作评测上与 Opus 5 实际不相上下
- @kimmonismus 称它在性价比上是“重大飞跃”,尤其是在 Cursor Bench 上,但明确对啰嗦程度降低和误拒减少能否持续持保留态度
- @theo 更关注缓存读取降价的实际意义,而不是原始能力的差距
- @perplexity_ai 把它定位为更广泛的多模型智能体体系中的一个强力编排模型
这种看法是:它确实很强,但关键在于整体部署的经济性和工具栈现在是否合理。
批评:速率限制、安全防护与订阅体验
最尖锐的批评并不涉及基准测试造假或智能不足,而是访问与易用性。
- @kimmonismus 抱怨速率限制严重、续写中断,而效率提升并没有带来相应的订阅收益
- @kimmonismus 进一步强调,5.1“在速率用量上比 Fable 5 还糟”
- @GregKamradt 报告称,在 v3 测试期间,请求频繁被判定为“逆向工程”而遭拒绝,导致原定的评测无法完成
- @kylebrussell 说,在一次理论数学会话中,一个“军事战役”的比喻触发了网络安全防护;后来又补充说“首日的安全防护……目前为止更烦人”,见 @kylebrussell
- @theo 反驳速率限制抱怨具有普遍性,称自己“完全没遇到这种情况”,一周的 Fable 额度只用了 14%
- @theo 尝试反推实际的配额关系:一个 5 小时限额约等于每周限额的 21%,约等于 Fable 限额的 38%
所以即便在用量限制上也没有统一的共识,有些用户很快撞墙,有些则没有。
怀疑/中立:对基准测试的解读与命名混乱
另一类反应集中在方法论和表述清晰度上。
- @scaling01 说 FrontierCode 的结果看起来很怪
- @scaling01 希望看到更多多智能体对比以及更好的解读
- @iScienceLuvr 批评了 Anthropic 医疗基准测试的呈现方式,指出所用评判模型不可比,且缺乏更广泛的医学评测覆盖
- @eliebakouch 反复要求澄清系统卡的基准测试行何时使用“Fable”、何时使用“Mythos”,因为这会影响用户是否应据此推断触发了安全防护路由
这是对此次发布最具技术性的批评:问题不在于模型弱,而在于报告格式让人不必要地难以弄清究竟测量的是什么。
写作质量与“Claude 腔”之争
被重复最多的主观观察之一,是 5.1 听起来更正常了。
- @danshipper:“说话真的像个正常人”,“行文更清晰”,“AI 痕迹”更少
- @ethanCaballero 直接发问,5.1 是否“消除了 claudese(Claude 腔)?”
- @ethanCaballero 后来指出,是 Anthropic 的新提示词消除了“Claude 腔”
- @ValsAI 发布了量化的文风变化:
- 带连字符的复合词变少
- 破折号变少
- @ValsAI 发现,尽管句子更短,但整体输出更长:
- VCB:每项任务 534 → 1299 词
- Terminal-Bench:961 → 1299
- 法律研究:1892 → 2693
- @ValsAI 注意到一个奇怪的补偿性痕迹:不换行连字符 U+2011 的使用从近乎为零上升到最高每百万约 4.4 千次
所以“Claude 腔减少”的说法并非纯粹凭感觉,至少存在一些可测量的文风变化。但统计数据也表明,Anthropic 可能只是用一种表层特征换掉了另一种。
安全防护的故事:企业适用性提升,但也有误报
围绕 5.1 的安全层,几乎和模型本身一样受到热议。
官方/Anthropic 一方的表述:
- @alexalbert__ 把 Enterprise Frontier Safeguards 呈现为企业环境中智能体部署的一个实用可观测层
- @mikeyk 称该模型在卡住时更诚实,而不是谎称成功
用户的批评性反馈:
- @GregKamradt 因为逆向工程误报标记而无法完成测试
- @kylebrussell 在数学场景中因一个比喻触发了安全防护
- @nrehiew_ 指出一种可能:Anthropic 在使用激活探针(activation probe)来对网络安全相关内容分类,并决定是否启用安全防护
- @mikeyk 分享了一个大脑模型产物的例子,作为仍被允许的复杂推理的正面示例
这里存在明显的采用权衡:
- 企业希望有更可靠的跨会话监控与控制
- 高级用户希望误报更少,探索性使用更宽松
Anthropic 试图两头兼顾,而首日的反应表明,这种平衡尚未被普遍接受。
Mythos 与 Fable:同一个模型还是不同产品?
这是技术上最有意思的讨论线索之一。
@eliebakouch 的说法:
- Fable 和 Mythos 5.1 是“完全相同的权重”
- 会检查内部激活值
- 危险请求会升级交给更大的分类器
- 随后可能回退到 Opus 4.8
- 因此 Fable 并不是更大的 Mythos 模型的蒸馏版本
后续的澄清与猜测:
- @eliebakouch 表示,此前社区的猜测把 Mythos 当作教师模型,把 Claude/Fable 当作蒸馏出的学生模型,但那只是猜测
- @eliebakouch 对确切的训练谱系仍不确定
- @nrehiew_ 认为差异很可能只是分类器阈值
- @ArtificialAnlys 在评测中独立证实了回退路由行为,但并未直接证实“完全相同的权重”这一说法
为什么这很重要:
- 基准测试的可解释性。如果“Mythos 的结果”和“Fable 的结果”大体上是同一个主干模型在不同路由/安全防护设置下的表现,基准测试表格就应该明确说明这一点。
- 采购与部署。企业可能以为自己是在不同的模型之间选择,实际上选的是围绕同一个模型的不同策略。
- 安全/能力核算。如果基准测试经过了回退,那么“究竟是哪个模型拿到了这个分数?”就不再是个简单的问题。
这种命名/路由上的含混,催生了整组推文中一些最好的技术性问题。
实际的产品影响
缓存读取降价为何重要
智能体系统经常要重复发送大量草稿区内容、代码仓库、先前步骤和工具对话记录。在这类场景中,缓存输入的价格影响格外大。
- Anthropic 将缓存读取降价 75%,得到 @Teknium、@theo 的称赞,@ArtificialAnlys 也做了详细量化
- 按 AA 的说法,大部分节省都集中在输入 token 以缓存读取为主的智能体评测上
- 这使得 Fable 5.1 即便输出 token 成本依然很高,在多步骤工作流中作为编排者/规划者也更具吸引力
零数据留存与 EFS 为何重要
- Dan Shipper 特别指出,ZDR 支持是企业现在得以使用该模型的一大原因,见 @danshipper
- Alex Albert 对 EFS 的解释(见 @alexalbert__)指向一个更广泛的市场转变:企业不再只想要“私有推理”,而是要智能体可观测性、跨会话异常检测和风险监控
这表明 Anthropic 正在为这样一个未来做优化:企业采用既取决于原始的模型质量,也同样取决于治理基础设施。
订阅抱怨为何重要
如果 API 的经济性改善了,而消费者/专业版订阅用户的额度没有改善,观感可能迅速变坏。
- @kimmonismus 明确指出,Anthropic 为订阅用户并未宣布降价或提高用量限制
- 这造成了产品观感的分裂:
- API 开发者:“大赢”
- 重度交互式订阅用户:“依然受限”
这种错位很重要,因为许多高关注度的评测者首先通过订阅产品而不是原始 API 来测试。
竞争背景
这次发布恰逢前沿模型异常活跃的一周,OpenAI 的 Astra 传闻/安全相关帖子以及多项世界模型的发布都在争夺注意力。即便如此,Fable 5.1 仍引起了强烈关注,因为它似乎重置了编程模型的排行榜。
各方反应中的对比性说法:
- @AravSrinivas:Fable 是前沿模型,“遥遥领先”
- @kimmonismus:在 Cursor Bench 上,相对 Sol 5.6 Max,更看好 Fable
- @nicdunz:Fable 赢在绝对智能,Sol 赢在经济性
- @scaling01:Astra 很可能很快在推理效率上实现反超
- @theo:Anthropic 当时包揽了第 1、第 2 和第 3 名
还有一种普遍的感觉是,这次发布意义重大,立刻引发了与 OpenAI 下一次发布的对比:
- @kimmonismus 说,相比 Fable 5.1,自己更期待 GPT-Astra
- @theo 评论说,这可能是有史以来提前预告最久的一次模型发布,指的是围绕 Astra 的各种期待
因此从市场角度看,Fable 5.1 既被视为 Anthropic 的一次真正的翻身,也被视为模型发布竞赛快速升级中的一步棋。
背景:为什么这次发布比一次普通的小版本更新更重要
有三个背景因素可以解释反应为何如此强烈。
1. Anthropic 的口碑已经两极化
Claude 系列模型在早期以编程深度和写作风格见长,但近来的讨论常把它们描绘成:
- 能力很强
- 语气有些别扭
- 拒绝过于保守
- 长时间使用时缓慢或笨重
对 5.1 的正面反应常被描述为 Anthropic 终于解决了“易用性税”,尤其见 @danshipper。
2. 智能体改变了人们对定价的关注点
传统的提示词-响应类用户关注输入/输出价格。智能体开发者关注的是:
- 缓存读取
- 长上下文
- 长会话中的可靠性
- 受委派任务的行为表现
- 诚实的失败汇报
这正是缓存读取降价获得的赞誉几乎与基准测试分数一样多的原因。
3. 安全正在成为产品架构,而不只是政策
EFS、路由、激活探针、回退模型和 ZDR 都表明,“模型”不再是单一的产物,而是一个被策略包裹的系统。Fable/Mythos 之争,实质上是围绕这一转变的争论。
用户开始不只是问“这个模型有多聪明?”,而是问:
- 这个请求是由哪套权重处理的?
- 哪条安全路径介入了?
- 回退发生得有多频繁?
- 什么基准测试分数对应哪条路由?
这比一般的模型发布炒作更成熟,是系统层面的讨论。
值得关注的演示与生态反应
- @alexalbert__:从图像到房屋设计再到电影感漫游的流水线,@alexalbert__ 澄清用的是 Blender 无头模式
- @spicey_lemonade:Minecraft 一次生成演示
- @simonw:SVG 鹈鹕加动画
- @_catwu:Anthropic 团队成员称,内部团队正在承接以前需要数月才能完成的项目
- @perplexity_ai:已集成进 Perplexity Computer
- @Teknium:可在 Hermes Agent / Nous Portal / OpenRouter 中使用
- @theo:T3 Code 已上线对 Fable 5.1 的支持
这些集成的速度强化了一种印象:5.1 对智能体开发者尤其重要,而不只是面向聊天用户。
社区提出的未决问题
- 基准测试透明度
- 当系统卡在某些基准测试上报告 Mythos、在另一些上报告 Fable 时,到底是什么决定了这种标注?见 @eliebakouch 和 @eliebakouch
- 基准测试表现在多大程度上取决于回退路由,又有多大程度取决于主模型自身的行为?
- 安全防护的调校
- Anthropic 能否在不削弱网络安全防护的前提下,减少理论性或无害技术工作中的误报?见 @GregKamradt 和 @kylebrussell
- 速率限制与产品分层
- 订阅用户能否从效率提升中受益,还是只有按 token 计费的 API 客户才能受益?@kimmonismus 尖锐地提出了这个问题
- 评测质量与过拟合担忧
- 为什么有些结果,尤其是 FrontierCode 或医疗子集上的结果,看起来很奇怪或难以比较?见 @scaling01 和 @iScienceLuvr
- 文风变化
- “Claude 腔减少”是因为提示词变化、后训练调整,还是两者兼有?@ethanCaballero 指向一份新发布的提示词,而 @ValsAI 则展示了可测量的词汇差异
OpenAI 的 Astra 与围绕循环深度的可监控性之争
- Preparedness 里程碑:“网络安全临界”:OpenAI 预览了 Astra,称其为首个在 Preparedness Framework 下达到网络安全 Critical(临界)阈值的模型。博客发布强调,Astra 最先进的网络能力将受到更严格的访问控制,见 @boazbaraktcs。流传的帖子摘要称,Astra 在测试中发现了 V8 零日漏洞、串联漏洞利用、攻陷了经过加固的浏览器、逃出沙箱并提升了权限,由 @kimmonismus 提炼。OpenAI 领导层还强调,安全工作的部分环节拖慢了部署,未来的模型发布节奏可能继续在速度与安全防护之间权衡,见 Sam Altman 的声明。
- 架构报道与“不透明推理”担忧:Astra 的另一条主要故事线来自报道,称它采用了某种形式的循环深度 / looped transformer 架构,引发了尖锐争论:这是否会削弱思维链监控的作用。持担忧立场的有 @RyanGreenblatt、@thlarsen、@tenobrus 和 @bshlgrs,他们认为更多的潜空间推理可能使事后调查变得实质性地更困难。与之相对,也有人认为这种反应言过其实:@max_paperclips、@teortaxesTex 和 @suchenzang 强调,内部的“neuralese”推理并不新鲜,关键在于有效深度,而不在于层是循环使用还是显式堆叠。
- OpenAI 的澄清与技术背景:OpenAI 首席科学家 @merettm 试图淡化最强烈的解读,称包括 Astra 在内的当前前沿模型,其计算图深度在 GPT-4 的约 2 倍以内,并表示 OpenAI 仍把思维链监控视为核心研究目标。这一澄清把讨论转向一个更窄的技术问题:循环块主要是一种参数/存储效率技巧,还是会开辟一条通往更深、更难监控的推理的自然路径。@eliebakouch、@voooooogel 和 @scaling01 进行了善意的技术讨论。@iScienceLuvr 还标出了几篇关于循环 MoE transformer 和缩放定律的相关新论文。
World Labs 的 Atlas:面向重建、相机控制和 real2sim 的统一世界建模
- 一次值得关注的多模态世界模型发布:World Labs 推出了 Atlas,@drfeifei 将其描述为从零开始训练的多模态世界模型,可以生成具有像素级精确相机控制的画面,仅凭一张图像就能重建大型场景,通过模拟时空对视频重新取景,并能从图像输出原生的 3D 空间。团队将其定位为统一生成与重建的单一模型,而不是拼凑起来的工具链,@KeunhongP 强化了这一角度,@BenMildenhall 随后也给出了示例。
- 演示主题:子弹时间、稀疏视角重建与创作可控性:最出色的演示集中在仅凭几段随手拍摄的手机画面生成自由视角视频,包括 @davidpantera_ 的短片示例、@eerac 用 3 部 iPhone 合成的“子弹时间”,以及 @bilawalsidhu 的评论:这以前需要配备几十甚至上百台相机的体积捕捉设备。另有帖子展示了从寥寥几张互不相关的网络照片进行重建,例如自然历史博物馆的例子,还有将风格化生成与可漫游的 3D 场景相融合的演示。
- 工程师为何关注:real2sim 与机器人:除了视觉特效/电影制作之外,技术上更重要的角度是面向机器人的 real2sim。@YunzhuLiYZ 展示了用随手拍的照片合成机器人导航所需的 RGB 和深度观测,@MTSlive 则强调了联合创始人 Justin Johnson 提出的“拍五张照片,建一个仿真环境,适配一个机器人”的愿景。@DrJimFan 等研究者称这是迈向 real2sim 的坚实一步,李飞飞也在此明确将 Atlas 与机器人领域的横向应用联系起来。
Qwen、GLM、RWKV 与开放模型的势头
- Qwen 升级后的旗舰登顶网页开发编程评测:阿里巴巴发布了 Qwen3.8-Max-0902,这是一个 2.4T 参数、1M 上下文的模型,定价为输入 $2/M、输出 $6/M,另有显式/隐式缓存命中定价。Arena 报告称,它在 Code Arena: WebDev 上以 1691 分首次登场即位列第 1,领先于 Claude Opus 5 Max 和 Kimi K3 Max,同时也落在当前最佳的性价比前沿上,见 @arena。阿里巴巴也在此重点介绍了同一结果。
- 开放及半开放的长周期模型继续通过各家服务商扩散:GLM-5.3 不断出现在基础设施和平台集成中,包括 Perplexity Agent API、Arcee 以及 Databricks 的服务数据,据称在后者上达到 310 tok/s,并被描述为内部基准测试中最强的开源编程模型。CoreWeave 还宣布了 DeepSeek-V4-Pro-0813,这是一个 1.6T、1M 上下文的模型,面向长周期智能体工作负载定价,缓存读取非常便宜。与此同时,RWKV-7 G1j 作为 100% RNN 模型发布,据称在智能体/编程/STEM 上有提升;LongCat-2.0 则被发现是一个 1.6T 开放权重 MoE,具备 1M 上下文,可在 Cline 中使用。
- 开源服务与多模态推理的改进:在服务侧,vLLM-Omni + FastVideo 的 FastH3 演示了 8.7 秒渲染出 10.1 秒音画同步的视频片段,即快于播放速度,MiniMax 将其视为交互式视频系统的开放基线。
智能体、运行框架、记忆与评测研究
- 智能体运行框架正成为主要杠杆:多条推文强调,如今的大幅提升来自运行时系统,而不只是基础模型。@omarsar0 重点介绍了 openJiuwen,这是一个开源运行框架,在 SWE-bench Verified 上达到 82.6%,Terminal-Bench 2.1 上达到 87.19%,其提升被归因于基于 rail 的组合和运行时自适应,底层模型策略保持不变。@dair_ai 总结了 SkillZip Pro,它压缩的是完整的生产级技能包而不仅是根提示词,在不损失质量的情况下,减少了技能包 38% 的 token 和每次运行 10.4% 的 token。
- 长周期智能体评测越来越贴近现实:一项突出的新增基准测试是 E-Commerce Bench,它让智能体在模拟的 365 天一年里运营多家网店。营收最高的模型是 GPT-5.6 Sol,将 10 万的初始资金做到了 1,431,425,但在防欺诈方面排名靠后;没有任何模型在所有维度上占优。这类评测比单次会话的基准测试更能暴露利润、安全和运营质量之间的权衡。
- 记忆与奖励作弊方面的工作:@dair_ai 还介绍了 Agent Zero Memory,它把情景时间线、实体-事件图和带引用锁定的精选文献式记忆分开,取得了 LongMemEval 95.6% 和 LoCoMo 93.6%,同时大幅降低成本。在对齐方面,@omarsar0 总结了一篇论文:在智能体遇到有缺陷的测试基础设施时,加入结构化的上报(escalation)工具,可使八个前沿模型的奖励作弊率从 23.6% 降至 5.3%,且基本没有性能开销。
热门推文(按互动量)
- Claude 发布:Anthropic 的 Claude Fable 5.1 / Mythos 5.1 发布公告是当天最大的纯模型发布帖。
- Astra 的 Preparedness:OpenAI 的 Astra 安全/Preparedness 公告引发了最大规模的安全与架构讨论。
- Atlas 发布:World Labs 的 Atlas 公告是最突出的多模态/世界模型发布。
- 网络安全警告:@ilyasut 认为 neocloud 应当紧急加固网络防御,因为未来失控的智能体可能试图夺取云算力以进行自我复制。
- Meta 语音模型:@finkd 宣布了 Muse Voice Transcribe,这是 Meta 首个实时音频感知模型,具备原生的说话人分离和端点检测。