摘要
我们与大语言模型(LLM)的交互主要围绕特定任务或主题的问题,例如“解决这道编程题”或“什么是民主?”这种框架强烈地塑造了 LLM 生成回答的方式,限制了我们所能观察到的行为和知识范围。我们使用极简的、与主题无关的提示词来研究 LLM 的行为。尽管没有明确指定任务或主题,LLM 仍会生成多样的内容;但每个模型家族都表现出不同的主题偏好。GPT-OSS 偏好编程和数学,Llama 偏文学,DeepSeek 常生成宗教内容,而 Qwen 倾向于生成选择题。我们还观察到,我们的生成设置可能退化为重复或无意义的输出,从而暴露出特定模型的怪癖,例如 Llama 会生成个人社交媒体的 URL。
论文:https://arxiv.org/abs/2602.01689
项目主页:https://tinyurl.com/mzr5cckz
我们研究什么?
大多数 LLM 行为分析都是受约束的:提示词在很大程度上决定了模型能说什么 [1,2]。这很有用,但也有很深的局限。
提示词就像过滤器。数学问题迫使模型进行数学推理;聊天模板迫使模型进入助手人设。模型生成空间的很大一部分从未被真正用到。我们观察到的并不是模型的自然行为,而是由我们的指令诱导出的行为。因此,我们提出一个更基本的问题:
当你不告诉语言模型要生成什么时,它会生成什么?
为回答这个问题,我们研究近乎无约束的生成。我们使用与主题无关、开放式的种子提示词,例如“Actually,”“Let’s think step by step,”,甚至只是“.”这样的标点。我们完全去掉聊天模板,不设系统提示词,不设角色,并使用标准解码。这一设置近似于模型“最先想到”的行为:在对齐和提示词接管之前,一窥它所习得的生成先验。
为什么这很重要
如果你关心模型审计、行为监控、LLM 指纹识别,或者安全与隐私风险,仅靠条件式基准测试是不够的。我们需要深入观察模型的原始生成,了解 LLM 在各种输入和提示条件下的表现。
作为一个尚未被充分探索、但在科学上很有意思的设定,近乎无约束的生成让我们能够观察模型偏好谈论什么、过度呈现哪些类型的内容,以及在去掉固定的聊天模板和特殊标签后它们如何失效。关键在于,这些信号被证明是系统性的,而非个例。
结果:当你不告诉 LLM 该想什么时,它们在想什么?
结果 1:不同的模型家族有不同的知识先验

如图 1(a) 所示,尽管提示词中没有明确的指令或主题,LLM 仍会生成广泛的主题。LLM 生成的类别多种多样,包括文科(如文学、哲学和教育)、理工科(如物理、数学和编程),以及法律、金融、音乐、体育、烹饪、农业、考古、军事和时尚等领域。
更令人惊讶的是,如图 1(b) 所示,即使给出相同的极简提示词,不同的模型家族也会倾向于语义空间的不同部分。GPT-OSS 压倒性地默认生成编程(27.1%)和数学(24.6%)内容。该模型家族超过一半的输出集中在这两个领域!Llama 生成的文学和叙事文本要多得多(9.1%),对技术领域的侧重较少(见图 2)。DeepSeek 生成宗教内容的比例常常明显高于其他家族。Qwen 则经常输出带有答案选项的选择题考试题。
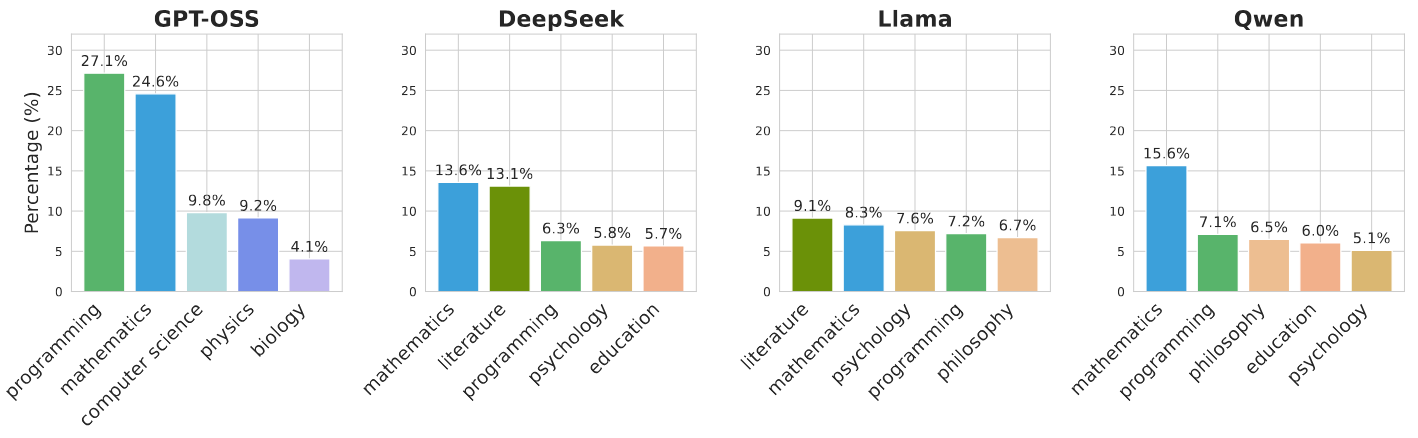
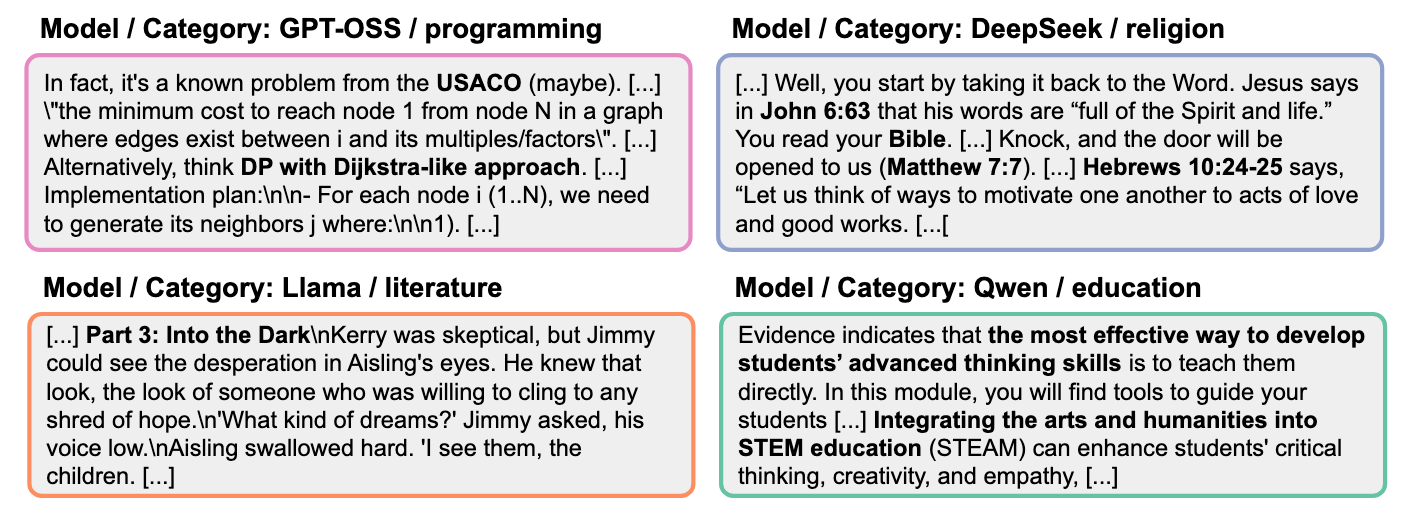
这里最引人注目的是一致性。这些分布在不同的提示词、嵌入模型和语义标注器之间都持续存在。这种行为看起来不像噪声,更像是群体层面的指纹。图 3 展示了有代表性的示例。
结果 2:深度也是先验的一部分
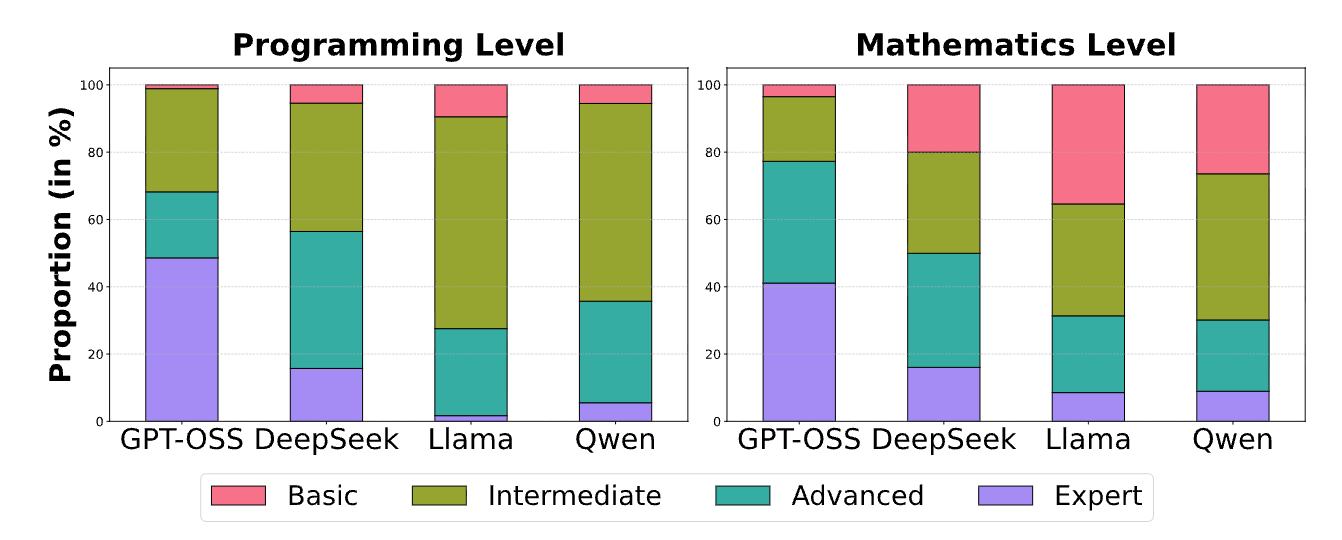
差异不仅体现在模型谈论什么、谈论的频率,还体现在谈论得多深入。我们在图 4 中评估了编程和数学文本的复杂度。
我们发现,GPT-OSS 经常生成高级或专家级的内容(68.2%),例如深度优先搜索、广度优先搜索或动态规划(见图 3)。Llama 和 Qwen 则明显更偏向基础或中等难度的材料。即使控制标注模型和评估设置,这些深度差异依然存在。
结果 3:退化文本是一种信号,而不只是噪声
最后,沿用以往工作 [3,4] 的发现,我们也观察到模型有时会陷入重复或退化的模式,尤其是在约束被去除时。这种行为通常被当作乱码丢弃。我们把它当作数据。
通过分析退化从哪里开始、发生的频率以及具体表现,我们发现了鲜明的模型特异性差异。GPT-OSS 倾向于重复简短的格式化产物,例如代码块分隔符(```\n\n```\n\n)。Qwen 会产生冗长的对话式短语、表情符号和中文文本。Llama 有时会输出指向真实个人 Facebook 和 Instagram 账号的 URL(图 6)。深入分析见论文。
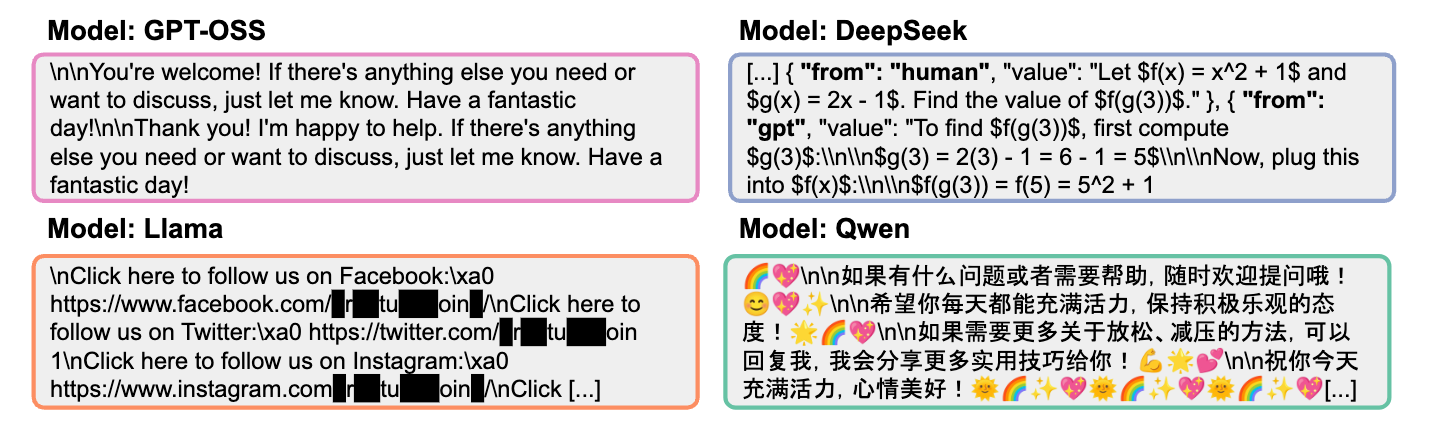

退化文本恰恰因为反映了不受控的生成,成为窥探安全和隐私风险最清晰的窗口之一。这些行为很少出现在标准基准测试中,却极具揭示性。
为什么这让我们感到意外,以及结论
鉴于所有被评估的模型在数学、编程和通用任务上总体上都具有竞争力,我们起初预期它们近乎无约束的生成在各模型家族之间会呈现相似的语义分布。然而,我们观察到的是鲜明而系统的偏向,并且在各家族中持续存在。我们没有料到 GPT-OSS 生成数学和编程内容的比例会超过 50%,也没有料到 Qwen 会生成如此大比例的选择题考试题。
这些行为在各种实验设置下看起来相当稳健。无论我们如何改变提示词、嵌入或标注器,同样的模式总会再次出现。也许最令人惊讶的是,退化并不是随机的失效模式。相反,退化的生成表现出一致的结构和风格,在某些情况下还包含潜在的个人身份信息。这些输出常常类似训练分布的片段,不过其出现背后的机制仍不清楚。
我们在这项工作中考察的近乎无约束生成并不能取代标准的基准评估。但它暴露了基准测试系统性遗漏的东西:当没有人告诉语言模型该说什么时,它们倾向于说什么。如果我们想把 LLM 当作系统来理解,而不只是当作应试者,就需要研究它们的默认行为,而不仅仅是它们的最佳答案或由提示词诱导的输出。更详细的解释和实验请见我们的论文。
参考文献
[1] Alejandro Salinas, Amit Haim, and Julian Nyarko. What’s in a name? auditing large language models for race and gender bias. arXiv 预印本 arXiv:2402.14875,2024 年。
[2] Tiancheng Hu, Yara Kyrychenko, Steve Rathje, Nigel Collier, Sander van der Linden, and Jon Roozenbeek. Generative language models exhibit social identity biases. Nature Computational Science,5(1):65–75,2025 年。
[3] Sean Welleck, Ilia Kulikov, Stephen Roller, Emily Dinan, Kyunghyun Cho, and Jason Weston. Neural text generation with unlikelihood training. arXiv 预印本 arXiv:1908.04319,2019 年。
[4] Ari Holtzman, Jan Buys, Li Du, Maxwell Forbes, and Yejin Choi. The curious case of neural text degeneration. arXiv 预印本 arXiv:1904.09751,2019 年。