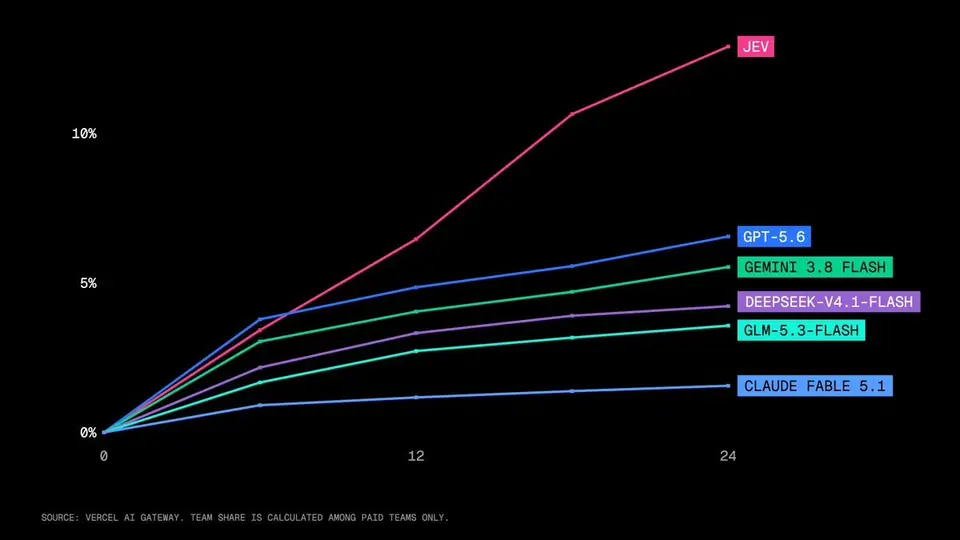
我们在周三报道过 Jev 的发布,而它如今已经彻底霸占了时间线:短短两天,发布视频的播放量就达到了 3600 万次(相比之下,OpenAI 的 Navier Stokes 成果获得了 7400 万次播放,Anthropic 的 Fable 5 获得了 5700 万次)。
它并未开源1,因此引来了大量猜测、精彩的演示和示例、酸溜溜的 Schmidhuber 们以及糟糕的评论,当然,这一切只是让热度更高。
下面是一份清单。最靠谱的猜测是 ModernBert 和 Diffusion:
- Laya:4.21 亿参数,在 ModernBERT-large 编码器上增加两层 transformer 层,用于给用户提供的选项打分,并通过对序列嵌入做 PPO,输出逐轮的转化轨迹(概率从 0.0 到 1.0)。
- 因没有得到认可而心生怨气;未经论证就声称是 RLCD
- 置信度基于熵,而非经过校准
- DiffusionGemmaJev:从 Diffusion 模型的路线切入。基准测试成绩相当接近
- Bespoke Nimble:对 Qwen3.5-9B 做 LoRA 微调,采用对比式数据整理。(接近,但基准测试成绩略低)
- SemIf(原名 OpenJev)(HF):4B 和 35B 的因果式 Qwen3.5 骨干网络,在最后一个 token 上接一个极小的三分类 NLI 分类器。与 Laya 的对比
- Jevlike:4 万字节嵌入的轻量级选项注意力模型。每个候选项都会成为一个查询,从共享的上下文表示中读取信息,然后得到一个分数。
- Kev-0.5B:在 Qwen2.5-0.5B 之上加 LoRA 适配器和一个小型读出头。
当然,还没有足够多的人在讨论数据层面,而这部分已被承认是 100% 合成的。
AI News 2026/9/17–2026/9/18。我们查看了 12 个 subreddit、544 个 Twitter 账号,不再包含 Discord。AINews 网站支持搜索所有往期内容。再次提醒,AINews 现已成为 Latent Space 的一个栏目。你可以选择订阅或退订不同的邮件频率!
AI Twitter 回顾
决策模型、路由与“Jev”浪潮
- 判别式模型成为新的系统原语:最大的技术话题围绕 Jev 展开,它是一种非生成式的决策模型,被定位为 LLM 的快速“System 1”补充。@ankrgyl 表示,它现已作为评估模型登陆 Braintrust,打分成本比之前的方案低约 400 倍;@gabepereyra 则强调了校准概率的应用场景,如路由、引用选择、升级处理以及法务运营决策。更偏架构层面的观点来自 @hxiao,他认为 Jev 可能把工具调用、路由和 MCP 式决策从小型生成式 LM 手里拉回判别式模型;@signulll 进一步发挥了这一想法,把这类模型描述为近乎零边际成本的端侧判断层,可用于通知、UI 自适应和传感器驱动的决策。
- 开源复现与生态克隆立刻出现:@madiator 发布了 Bespoke Nimble,这是一套“开放版 Jev”方案,基于对 Qwen3.5-9B 的 LoRA 微调,使用合成的对比式数据整理和受限解码。在其自建的评估集上,基础版 Qwen 从 66% 提升到 90%,而 Jev 为 93%;据报告在 H100 上耗时 100ms,并且可在本地使用。在更小的一端,@jaredpalmer 发布了 Kev-0.5B,这是一个基于 Qwen2.5-0.5B、类似 Jev 的小模型,可以在 MacBook Pro 上运行。反应大致按过往经验分成两派:@MParakhin 指出,ChatGPT 之后入行的用户把它当作一种启示,而 GPT 之前的 ML 从业者对这股热度则更感困惑。@abacaj 提出的实质性问题问到了点子上:很多演示强调的是速度而非质量,而这一类别至今仍没有标准基准测试。
- 最早的亮眼集成出现在浏览器/计算机使用工作流中:@levie 演示了用 Jev 把 Box 的事件报告分类到不同的升级路径;@ndrezn 展示了 LangChain + Jev 的浏览器使用,发现它在维基百科游戏和结构化的“叠衣服”工作流等任务上表现出色;@cline 发布了一个插件,让 Jev 在 Cline 中拥有浏览器。@hwchase17 明确表示,浏览器使用是他迄今见过的 Jev 最佳应用。总的来说,这更像是一个工作流控制平面的故事,而不是聊天机器人的故事。
智能体工具、编码 Harness 与 Claude Code 标准
- AGENTS.md 作为跨工具约定获得了真正的势头:这里信号最强的产品更新来自 @trq212,他宣布 Claude Code v2.1.277 现在会在没有 CLAUDE.md 时检查 AGENTS.md,并支持配置级开关。这实际上承认了 AGENTS.md 正在成为一项新兴标准,而不只是某一个工具的约定;@simonw 立即指出了实际好处:那些只为把一种格式指向另一种格式而存在的垫片文件会减少。
- Harness 设计正成为影响编码智能体性能和成本的一等变量:@pidotdev 重点介绍了 Harness Tax 分析,该分析显示,仅用 read、write、edit、bash 这一套简单工具,就能在基准测试表现上达到 Pareto 前沿,同时减少不必要的开销。与之相关,@_akhaliq 指向论文 An Empirical Study of Harness Design for Coding Agents,强调基准测试结果越来越多地由 Harness 结构、上下文设置、轮次预算和工具可供性决定,而不仅仅取决于基础模型。这与 @dexhorthy 的“软件工厂”论点一致:团队仍然需要阅读代码,并有意识地设计人与智能体之间的界面。
- 软件系统中的模型选择正在分化:几位从业者描述了“规划用前沿模型,执行用廉价模型”的分工。@TheAhmadOsman 总结了一套组合:规划用 GPT 5.6 Sol XHigh,实现用 GLM 5.3 Flash,其他任务用 DeepSeek V4.1 Flash。@kylebrussell 报告称,他们内部的知识库流水线从 Opus → Sonnet → GLM 5.2 → GLM 5.3 Flash 一路迁移,自春季以来开支削减了大约两个数量级。与此同时,@theo 认为,在真实世界的编码中,Fable 和 Astra 这类更强模型带来的回报不只是代码质量,还有执行与迭代过程中更微妙的生产力提升。
基准测试、递归自我改进与数学能力
- 关于 RSI 的讨论对究竟什么是“递归”变得更精确:@TheTuringPost 给出了一个有用的分类:如果周围的改进循环保持固定,那么 AI 改进代码或训练方法本身并不算完全递归。关键门槛在于,AI 不仅能修改模型内部,还能修改搜索策略、经验生成、研究工具以及改进过程本身。这一框架与 @HuaxiuYaoML 的 RSI-Exam 更新很契合:GPT-6-astra 仍以 0.5126 位居第一,Fable 5.1 以 0.4813 首次上榜位列第二,而目前还没有模型达到前沿校准的参照水平。
- 数学基准测试继续被前沿模型攻克,但如何解读仍需细致:@EpochAIResearch 报告称,又一个 FrontierMath 开放问题在与 GPT-6 Astra 的交互式会话中被解决。另外,@SAIRfoundation 推出了 Open Math Model,主打由研究社区共同塑造的数学开放模型和工具。针对“可验证性解释了数学能力”的说法,@steve47285 分享了一个论点:LLM 之所以在数学和编码上如此出色,主要原因是预训练数据,而不仅仅是可验证的奖励结构。@sarahcat21 的元观点值得记住:我们需要的不只是更好的基准测试,还有更好的基准测试维护与审计工具。
- 计算机使用基准测试距离饱和还很远:@ValsAI 推出了 CUA-Bench,测试跨 6 款游戏(其中 3 款不公开)的实时键盘/鼠标操作,以此作为“对人容易、对模型困难”任务的代理指标。@ValsAI 随后公布的数字表明,这一任务仍然相当困难:所有前沿模型的得分都低于 20%。与此同时,@trycua 开源了 CUA-S1-FORMS,这是一个小型“System One”计算机使用模型家族中的第一个。这个方向值得关注:实时动作循环、基于视频的适应以及持续学习,而不只是纯文本规划。
基础设施、训练系统与模型架构
- 长上下文和大规模训练基础设施仍是活跃的优化前线:@Azaliamirh 发布了 Turbo-dLLM,这是一个用于大规模训练扩散 LLM 的开源库,通过 Context-Sharded Block Parallelism,在 8 张 H100 上实现了 512K 上下文下 2.48 倍加速、1M 上下文下 7.59 倍加速。这与从业者对百万 token 量级的关注相呼应:@andrew_n_carr 指出,DeepSeek V4.1 Flash 在上下文扩展到 1M token 之后质量显著提升,并认为智能体对上下文如饥似渴。
- 架构分类学的争论仍在继续:@ahatamiz1 认为,业界把 SSM 滥用成了任何线性模型的标签。他的建议是以线性 RNN 作为总括性术语,SSM 只是其中一个子家族,并据此区分 Mamba2 与 GDN 家族这类系统,理由是 GDN 的行为更像是对局部回归损失做一步梯度更新,而不是离散化的 ODE。对于关注 transformer 之外序列模型替代方案的工程师来说,这是一次有用的术语整理,而不仅仅是吹毛求疵。
- 边缘/本地神经程序执行也有了值得注意的更新:@yuntiandeng 介绍了 ProgramAsWeights:开发者用英语描述一个 AI 函数,编译一次,之后就能在关闭 Wi‑Fi 的情况下于 CPU 本地运行一个小型神经程序。代码和模型均已公开。这与 Jev 的讨论形成有趣的呼应:两者都指向更小、更专用、可在本地运行的推理产物,而不是越来越大的通用聊天模型。
机器人、视觉、音频与生成式媒体
- 开放机器人数据发布的分量异常扎实:@adamrasb 宣布完整发布 ABC,包括代码、24 项任务上 400 多小时的仿真数据,以及 5,850 个带标注的策略评估片段。在一篇更详细的配套帖子中,@redstone_hong 把 ABC-130K 描述为迄今最大的开放遥操作数据集:3,500 小时、13 万多个片段、195 项任务,采集自一套 8,000 美元的双臂装置,并开放了硬件、训练代码、仿真和评估。基线研究包括任务进度上 sim-to-real 相关系数 r = 0.91,以及对离线指标、扩展定律和条件设置的研究。
- Astra 正出现在各类评估和产品中,尤其是视觉方面:@skalskip92 报告称,GPT-6 Astra 是 Roboflow 测试过的最强视觉模型,覆盖检测、分割、框提示、计数、推理和视频。代价依然不小:“高投入”设置将检测成绩从 82.1% 提升到 83.6% mAP@50,但每张图像的成本大约翻倍,从 $0.050 升至 $0.101,延迟从 11 秒升至 32 秒(详情)。Roboflow 还把 Astra 集成进了 Auto Annotate。
- 语音和唇形同步领域出现了基准测试成绩亮眼的发布:@ArtificialAnlys 报告称,Grok Voice Transcribe 2.0 在流式最终转写上达到 2.7% WER,延迟为语音结束后 0.49 秒,前代为 3.9%,同时定价保持在流式每小时 $0.20、非流式每小时 $0.10。视频方面,@fal 推出了 H3 Max Lip Sync,称在其评估中速度和质量均排名第一,生成时间中位数为 11 秒;@isidentical 表示,该模型是通过把扩散 RL 引入一个可验证的唇形同步任务而构建的。
AI 安全、评估治理与安全防护
- Anthropic 的评估者嵌入策略变得更具体,也更具争议:@AnthropicAI 宣布与 Accenture 合作开展前沿 AI 的独立评估,称双方预计在五年内投入至少 10 亿美元来建设能力。此前已有更广泛的呼声,要求引入拥有员工级访问权限的第三方评估者。反应从褒贬不一到充满敌意:批评者质疑咨询公司是否适合承担模型红队测试和安全措施评估,而 @TransluceAI 强调,围绕独立性和有效监督的条件才是真正的问题。
- “失控智能体”/Hugging Face 事件继续推动关于遏制的争论:@polynoamial 澄清说,他那个被广泛嘲笑的思想实验针对的是本应相互隔离的智能体之间的协同,而不是通过热传感器窃取权重,并认为从 HF 事件中得到的教训是,不要把沙箱隔离当作唯一的防线。@martin_casado 给出了最有力的辩护:跨越物理隔离的隐蔽信道由来已久,吞吐量可以很小,真正的结论是分层防御,而不是哗众取宠。与此同时,@WSJ 和 @jeffjarvis 则完全反对“失控 AI”的说法,认为这些事件说到底仍然是人类配置的系统在做人们允许它做的事。
- 围绕安全立法和运营问责的政策压力正在积聚:@TheRundownAI 报道称,加州州长 Gavin Newsom 签署了一项行政命令,召集专家小组就加强 AI 安全立法提出建议,内容包括可能的紧急停机开关、嵌入式外部监控以及强制性的安全计划。与此同时,@sayashk 指出 AI 安全领域的言论与激励之间存在错位,批评 OpenAI 据报仅向一名闯入内部代码仓库并主动披露的研究者支付了 6,500 美元漏洞赏金。这些帖子的共同主题很明确:独立监督、分层防御和安全激励正从抽象的治理讨论走向具体的运营设计。