SWE-bench 和 Terminal-Bench 这类智能体编码基准测试常被用来比较前沿模型的软件工程能力,排行榜上的前几名往往只相差几个百分点。这些分数常被当作模型相对能力的精确度量,并越来越多地影响部署哪个模型的决策。然而,我们发现仅基础设施配置就能产生超过这一差距的差异。在内部实验中,Terminal-Bench 2.0 上资源最充足与最匮乏的配置之间,差距达到 6 个百分点(p < 0.01)。
静态基准测试直接对模型的输出打分,运行时环境不影响结果。智能体编码评估则不同:模型会得到一个完整的环境,在其中编写程序、运行测试、安装依赖,并经过多轮迭代。运行时不再只是被动的容器,而是解题过程中不可分割的一部分。资源预算和时间限制不同的两个智能体,做的并不是同一份试卷。
评估开发者已开始考虑这一点。例如,Terminal-Bench 2.0 在其最新的 2.0 版本中,按任务指定了推荐的 CPU 和 RAM。但是,指定资源并不等于一致地强制执行这些资源。此外,我们发现,强制执行的方式会改变基准测试最终实际衡量的内容。
我们是如何走到这一步的
我们在 Google Kubernetes Engine 集群上运行 Terminal-Bench 2.0。在校准环境的过程中,我们注意到自己的分数与该基准测试官方排行榜不一致,而且基础设施错误率高得出奇:多达 6% 的任务因 pod 错误而失败,其中大多数与模型解决任务的能力无关。
分数差异归根结底在于资源的强制执行方式。我们的 Kubernetes 实现把每个任务的资源规格既当作下限又当作硬上限:每个容器保证获得指定的资源,但一旦超出就会被立即杀死。容器运行时通过两个独立的参数来强制资源:保证分配量(预先预留的资源)和容器被杀死的硬限制。当两者被设为相同的值时,瞬时峰值就没有任何余量:一次短暂的内存波动就可能让本来能成功的容器因 OOM 被杀。为了应对这一点,Terminal-Bench 的排行榜使用了另一家沙箱服务商,其实现更为宽松,允许临时超额分配而不终止容器,以保证基础设施的稳定性。
这一发现引出了一个更大的问题:资源配置对评估分数的影响究竟有多大?
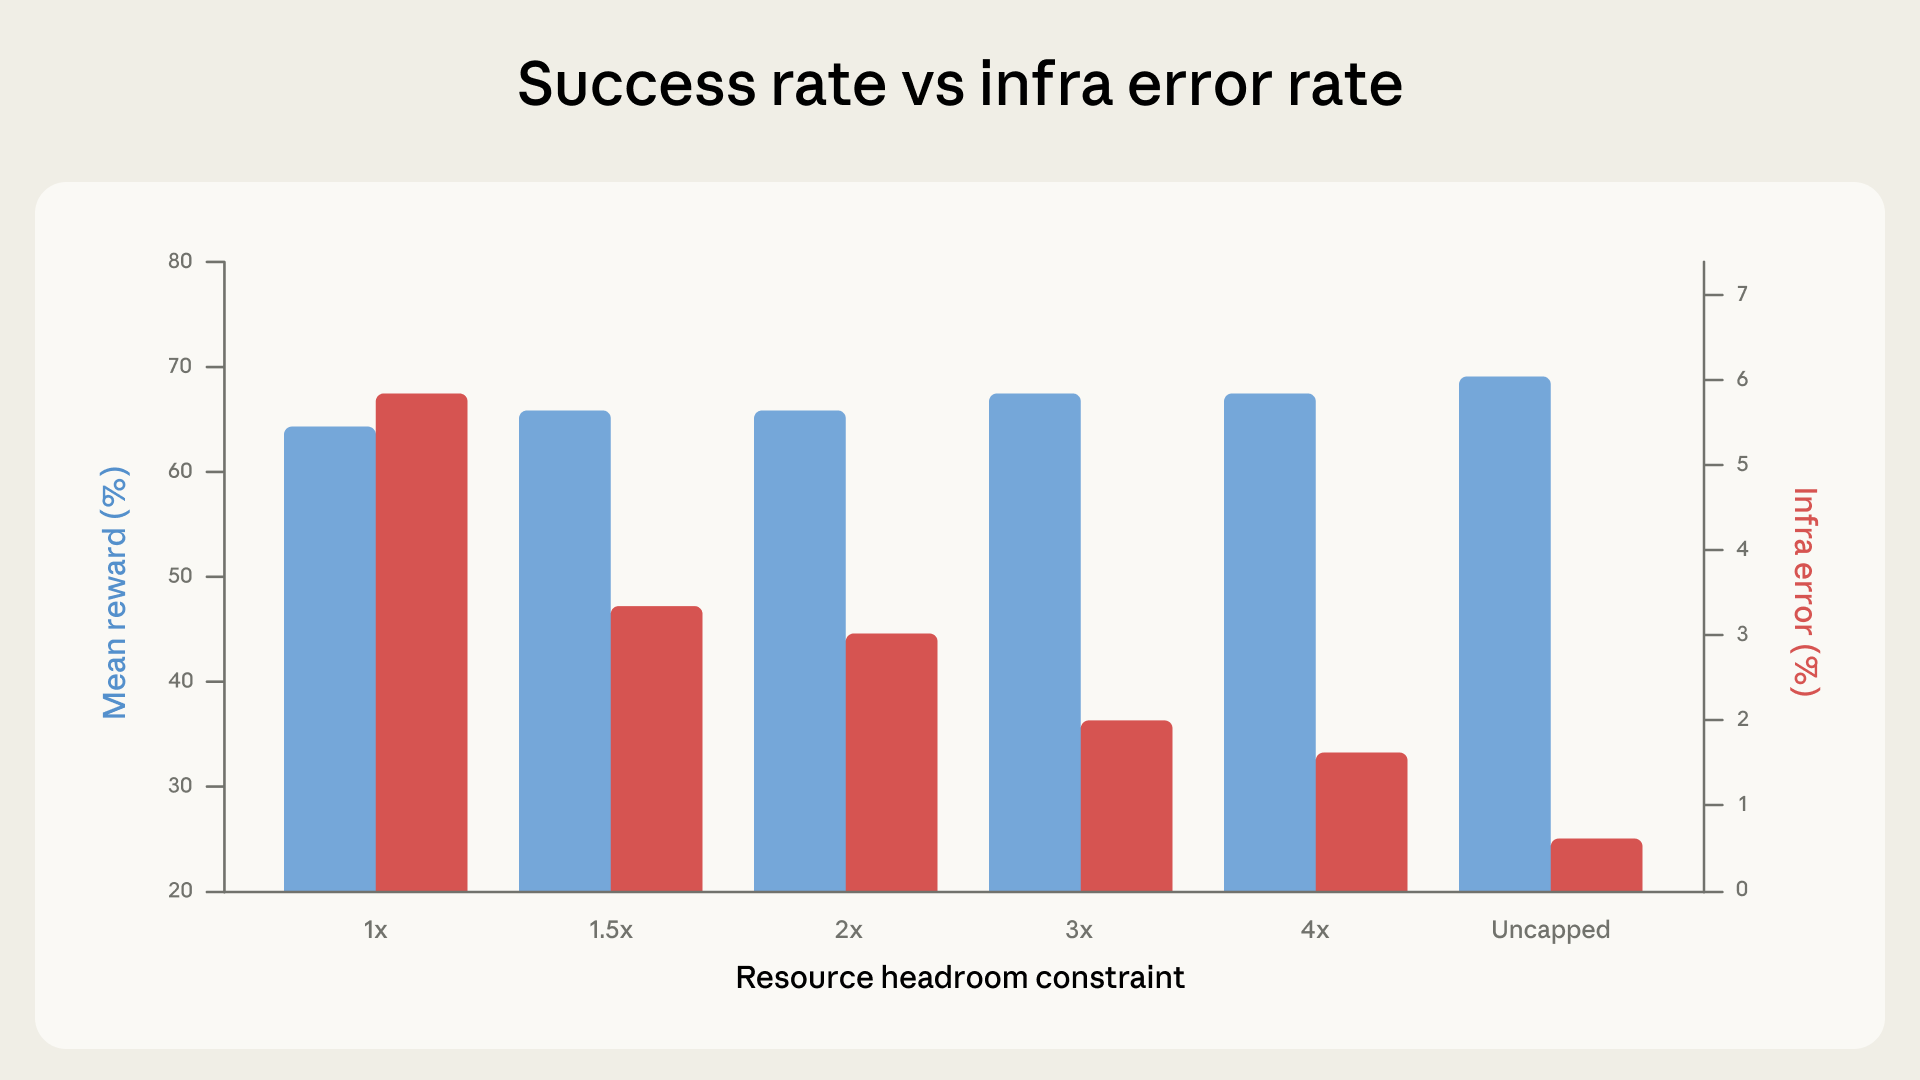
为了量化脚手架(scaffold)的影响,我们在六种资源配置下运行了 Terminal-Bench 2.0,从严格执行每个任务的规格(1x,规格既是下限也是上限)到完全不设上限。其他一切保持不变:同一个 Claude 模型、同一套 harness、同一组任务。
在我们的实验中,成功率随资源余量的增加而上升。这主要是因为基础设施错误率每一步都单调下降,从严格执行时的 5.8% 降到不设上限时的 0.5%。从严格执行到 3x 余量(5.8% 降到 2.1%)的降幅在 p < 0.001 水平上显著。余量越大,因超出分配而被杀死的容器就越少。
从 1x 到 3x,成功率的波动处于噪声范围之内(p=0.40)。在 1x 下崩溃的大多数任务,无论如何都会失败,这也是我们在数据中观察到的。智能体进行探索,撞上资源的墙,被抢占,但它本来就不在通往正确解法的路上。
然而,从大约 3x 开始,这一趋势发生了变化:成功率的上升快于基础设施错误的下降。
从 3x 到不设上限,基础设施错误再下降 1.6 个百分点,而成功率却跃升了近 4 个百分点。额外的资源让智能体能够尝试只有在宽裕分配下才行得通的方法,例如引入大型依赖、派生开销很大的子进程,以及运行内存密集的测试套件。在不设上限的资源下,相对 1x 的总提升为 +6 个百分点(p < 0.01)。在边缘情况下,rstan-to-pystan 和 compile-compcert 这样的任务在获得内存余量后,成功率显著提高。
这如何影响测量
在大约 3 倍的 Terminal-Bench 规格以内,额外的资源修复的是基础设施可靠性问题,即瞬时的资源峰值。Terminal-Bench 维护者所使用的沙箱服务商实际上在幕后隐式地做了这件事:评估变得更稳定,却没有变得更容易。
然而,超过 3x 之后,额外的资源开始切实帮助智能体解决以前解决不了的问题,这表明限制确实可以改变评估所衡量的内容。严苛的限制会无意中奖励极其高效的策略,而宽松的限制更为宽容,奖励那些能更好地利用全部可用资源的智能体。
一个能很快写出精简高效代码的智能体,在严格约束下会表现出色。一个用重量级工具暴力求解的智能体,在宽松约束下会表现出色。两者都是正当的测试对象,但如果不说明资源配置就把它们合并成一个分数,差异以及在真实世界中的泛化能力就很难解读。
在 bn-fit-modify 这个需要拟合贝叶斯网络的 Terminal-Bench 任务上,一些模型的第一步是安装标准的 Python 数据科学栈:pandas、networkx、scikit-learn, 以及它们的全套工具链。在宽松的限制下,这样做行得通;在严格的限制下,pod 在安装过程中就会耗尽内存,而此时智能体还没写下一行解题代码。存在更精简的策略(只用标准库从零实现这些数学运算),一些模型确实默认这样做,另一些则不会。不同模型有不同的默认做法,而资源配置决定了其中哪些做法恰好能成功。我们在不同的 Anthropic 模型上复现了这一核心发现:影响的方向一致,幅度有所不同。同样的趋势似乎在 Claude 之外的模型上也成立,但我们没有对其进行严格测试。
我们还通过在 SWE-bench 上进行交叉实验,测试了这一模式是否适用于 Terminal-Bench 之外的评估。我们在 227 道题上(每题 10 个样本),把可用的总 RAM 最高调到基线的 5 倍。同样的效应依然存在,只是幅度较小:分数再次随 RAM 单调上升,但 5x 时仅比 1x 高 1.54 个百分点。SWE-bench 任务的资源密集度较低,因此效应较小在预料之中,但这表明资源分配在那里同样不是中立的。
其他方差来源
资源分配并不是唯一的隐藏变量。在某些配置下,时间限制也开始起作用。
原则上,评估设置的每个要素都可能影响最终分数,从集群健康状况到硬件规格,从并发水平到甚至出口带宽。智能体评估本质上就是端到端的系统测试,系统的任何组成部分都可能成为混杂因素。例如,我们曾零星观察到通过率会随一天中的时间波动,很可能是因为 API 延迟随流量模式和事故而变化。我们没有正式量化这一效应,但它说明了一个更大的问题:“模型能力”与“基础设施行为”之间的界线,比单一的基准测试分数所显示的要模糊。模型提供方可以通过专用硬件来让自己的评估基础设施免受这种影响,但外部评估者很难做到同样的事。
公开基准测试通常旨在衡量纯粹的模型能力,但在实践中,它们有可能把模型能力与基础设施的怪癖混为一谈。有时这可能是可取的,因为它能对整个技术栈做端到端测试,但更多时候并非如此。对于要公开分享的编码评估,在多个时间、多个日期运行,有助于把噪声平均掉。
我们的建议
理想情况是,每项评估都在完全相同的硬件条件下运行(包括运行评估的脚手架和推理栈),这样可以确保全面的完美可复现性。然而,这并不总是可行。
鉴于容器运行时实际上通过保证分配量和独立的硬性杀死阈值来强制资源,我们建议评估为每个任务同时指定这两个参数,而不是单一的固定值。单一的精确规格会把保证分配量设为等于杀死阈值,不留任何余量:我们记录到的 1x 下的瞬时内存峰值就足以让评估不稳定。把这两个参数分开,既能给容器足够的喘息空间,避免虚假的 OOM 杀死,又仍然保留硬性上限,防止分数虚高。
两者之间的区间应当经过校准,使下限和上限处的分数彼此处于噪声范围之内。例如,在 Terminal-Bench 2.0 中,把上限设为每任务规格的 3 倍,使基础设施错误率下降了约三分之二(5.8% 降到 2.1%,p < 0.001),同时分数提升很小,完全处于噪声范围之内(p = 0.40)。这是一个合理的权衡:基础设施这一混杂因素基本被抵消,同时又没有消除有意义的资源压力。具体的倍数会因基准测试和任务分布而异,因此应当如实报告,但这种经验校准的原则是通用的。
我们为什么在意
这些发现的实际影响超出了评估基础设施本身。基准测试分数越来越多地被用作决策依据,但随着关注度(和依赖度)的提高,运行和报告它们的严谨程度并没有相应提升。就目前的情况而言,排行榜上领先 2 分,可能反映了真实的能力差异,也可能反映了某次评估运行在更强的硬件上,甚至只是赶上了更幸运的时段,或者几者兼有。如果没有公开(或标准化)的环境配置,除非相关方愿意多花功夫在相同条件下复现客观结果,否则从外部很难分辨。
对于 Anthropic 这样的实验室,这意味着智能体评估的资源配置应当被视为一等实验变量,像提示词格式或采样温度一样严谨地记录和控制。对于基准测试的维护者,公布推荐的资源规格(如 Terminal-Bench 2.0 所做的)会很有帮助,而说明强制执行的方法则可以弥补我们发现的这一差距。对于任何使用基准测试结果的人,核心结论是:智能体评估上的小幅分数差异所带有的不确定性,比所报告数字的精度所显示的要大,尤其是有些混杂因素实在太难控制。
在资源方法学标准化之前,我们的数据表明,排行榜上低于 3 个百分点的差异,在评估配置被记录并对齐之前,值得保持怀疑。在 Terminal-Bench 中,中等范围的资源配置之间观察到的差距略低于 2 个百分点。朴素的二项分布置信区间本身就跨越 1 到 2 个百分点;我们在这里记录的基础设施混杂因素是叠加在其上的,而不是包含在其中。在分配范围的两端,差距达到 6。
领先几分,可能意味着真实的能力差距,也可能只是虚拟机更大。
致谢
作者:Gian Segato。特别感谢 Nicholas Carlini、Jeremy Hadfield、Mike Merrill 和 Alex Shaw 的贡献。这项工作反映了多个从事编码智能体评估的团队的共同努力。有意参与的候选人欢迎在anthropic.com/careers申请。