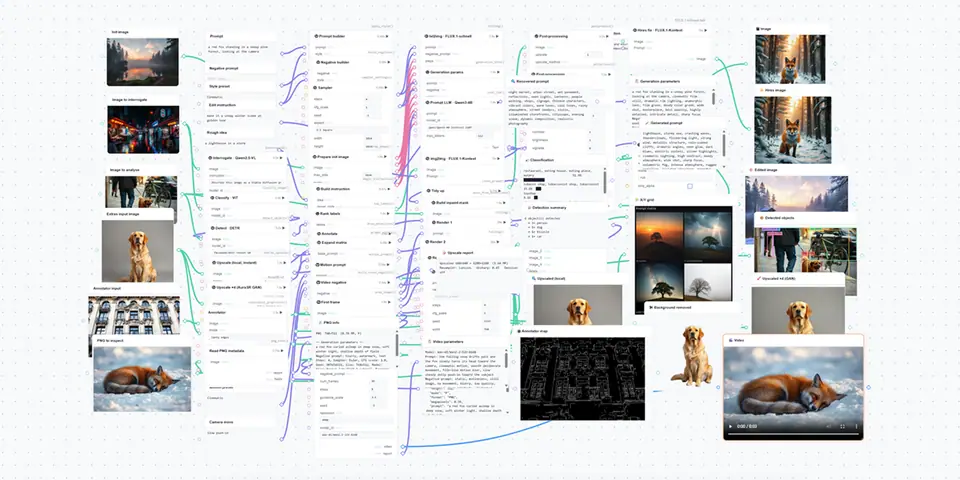
在上一篇文章中,我们搭建了五个小型 gr.Workflow 图,并提到要构建像 AUTOMATIC1111 的 stable-diffusion-webui 这样复杂的东西需要做些什么。本文将带你了解 Workflow1111,我们用一张工作流画布重建了 AUTOMATIC1111 的大部分功能。
Workflow1111 是一张由 73 个节点构成的图,包含 11 条媒体管道。它汇集了文生图、高分辨率修复、图生图、提示词矩阵网格、VLM 图像反推提示词、检测转局部重绘蒙版、ControlNet 风格的标注器、背景移除、PNG Info 信息存储以及图生视频等领域的 SOTA 模型。
你可以用 Hugging Face 账号登录或提供访问令牌来运行其中任意一条管道。登录后,模型调用将使用你自己的配额。
👉 试用 Workflow1111,或复制这个 Space,开始按你自己的用例重新接线。
下面我们来逛一逛这张画布。
画布上有什么
所有媒体管道都由同样四类算子构成,上一篇文章和官方指南中已有介绍。画布上的每个节点封装一个算子,算子的输入和输出就是你用来连边的端口。快速回顾这四类算子:fn 是 Python 函数,model 是通过 InferenceClient 调用的模型,space 是另一个 Gradio Space,dataset 是 Hub 数据集中的一行。
我们逐条来看这些管道。
文生图
这是核心管道。它具备你在 A1111 的 txt2img 标签页中会期待的各项控件:负面提示词、步数、CFG、种子、宽高,另有一个用于选择检查点的 model_id 字段。提示词首先经过一个提示词构建 fn 节点,该节点会附加所选的风格预设并清理文本,然后进入通过 Inference Providers 调用检查点的 model 节点。输出时,后处理 fn 节点会把生成参数写入 PNG 的元数据,PNG Info 管道之后就是读取这些数据。
高分辨率修复
在 Automatic1111 中,高分辨率修复先对 txt2img 的输出放大,再进行第二轮去噪。这里则改成了一个两节点的绕行。文生图的结果进入一个 FLUX.1-Kontext model 节点,附带一条精修指令(“enhance fine detail and micro-texture, keep the composition identical”),返回更清晰、更大的图像。
图生图
同一个 Kontext 节点也兼作图生图标签页。上传一张图像,描述你想要的改动,它就会返回编辑后的图像。
让 LLM 来写提示词
从一个粗略的提示词开始,比如“A lighthouse in a storm.”。该管道把它发送给一个 Qwen3-4B model 节点,再由一个小的 fn 节点把回复整理成干净的标签列表,上限四十个:“stormy sea, wet rocks, dramatic composition, low angle shot, volumetric lighting, ominous tone.”你可以把任意扩散模型节点连到这个输出上来渲染图像。
这里不涉及任何自定义节点,这点与 ComfyUI 不同。在 Gradio 工作流中,LLM 和扩散模型都是同一画布上的普通 model 算子。
把图像反推回提示词
这类似 AUTOMATIC1111 的 Interrogate 按钮,只不过反推的工作由 VLM 而非 CLIP 来完成。Qwen2.5-VL 查看一张夜市照片,写出一条可能生成该照片的提示词。一个 ViT 分类器节点读取同一张图像并返回标签:餐厅 51.9%,烟草店 15.6%,玩具店 9.1%。
两个节点使用同一个图像输入,因此 gr.Workflow 会并行运行它们,你大约只需运行一个节点的时间就能得到两个答案。
检测转局部重绘蒙版
AUTOMATIC1111 需要你手工绘制局部重绘蒙版。这条管道则改用检测器来生成。DETR 在一张街景照片中找到六个物体(三个人、一条狗、一辆自行车和一辆汽车),随后工作流分成两个分支:一个在原图上画出检测框,另一个把检测框转成蒙版,可供下游的局部重绘管道使用。
绘制和蒙版生成都在本地用 Pillow 和 NumPy 完成。只有检测调用会离开本机。
提示词矩阵
这类似 AUTOMATIC1111 的提示词矩阵。一个基础提示词“a lone oak tree”,由一个 fn 节点与四个后缀(at sunrise、in a thunderstorm、under the Milky Way、in autumn fog)组合,每个变体各自进入一个文生图节点。最后一个节点把四个结果拼成一张缩略图总览。
gr.Workflow 没有循环算子,所以四个文生图节点在画布上并排放置。由于它们处于相同的依赖深度,会并行运行,四张图同时开始生成。
放大与背景移除
这类似 Automatic1111 中的 Extras 标签页。这里有两个放大节点,走的是不同路线。第一个是 fn 节点中的本地 Lanczos 重采样,不需要网络调用,Pillow 缩放多快它就多快完成。第二个是 AuraSR ×4,它是画布上第一个 space 节点:它调用 Hub 上的一个 Space,并把结果当作任何其他节点的输出来处理。
背景移除的工作方式相同。BRIA RMBG-2.0 是另一个 space 节点,整个模型都在它自己的 Space 中,这张画布只是把它调用进来。
标注器
Canny、线稿、素描、亮度深度和色调分离,是你通常从 Automatic1111 的 ControlNet 扩展中获得的预处理器。在这里,每一个都是用纯 NumPy 编写的 fn 节点,背后没有任何模型。在一张预载的建筑立面示例照片上,每个标注器在 CPU 上大约耗时半秒。
应用中共有 36 个算子节点,其中 32 个是 fn 节点,这 32 个里有 22 个完全在进程内运行,无需网络调用。即使断网,画布大约三分之二的部分仍可继续工作。由于它们是普通的 Python 函数,你也可以直接测试它们,无需画布、服务器或 GPU。
PNG Info
AUTOMATIC1111 把生成细节存储在 PNG 的 parameters 文本块中,PNG Info 标签页再把它们读回来。Workflow1111 也是如此。文生图管道上的后处理节点写入元数据,这条管道再把它读出来,包括提示词、负面提示词、步数、CFG、种子、图像尺寸和模型。
图生视频
PNG Info 读取的那个图像节点还会输入给一个 Wan 2.2 I2V A14B 节点,由它让图像动起来;在演示示例中,一只沉睡的狐狸醒来并开始活动。这里没有第二个上传框,因为一个参考节点可以向任意多条下游管道供数,所以一次上传就能在同一张画布上既被读取元数据,又被生成动画。
在你自己的 GPU 上运行模型
到目前为止,每次模型调用都落在别人的硬件上,通过 Inference Providers 或 Space 完成。这就是为什么你无需自己的 GPU 就能构建并运行像 Workflow1111 这样的东西。
不过 fn 节点只是 Python,所以它同样可以在本地加载模型并在你自己的 GPU 上运行。FastVideo/fastvideo-fasth3-preview 就是一个这样做的 gr.Workflow 应用。它运行 FastH3(MiniMax-H3 的四步蒸馏版本),并在 ZeroGPU 上生成带配乐的视频。
整个应用归结为一个绑定的函数:
@spaces.GPU(duration=get_duration, size=GPU_SIZE)
def _generate(prompt_embeds, text_token_tags, height, width, num_frames, seed):
    ...

gr.Workflow(bind={"generate": generate, "status": status}).launch()
ZeroGPU 在函数需要时为其分配 GPU,调用结束后释放。gr.Workflow 完全不需要知道这些,它只是调用 fn 节点。
这也并不局限于 Spaces。把 bind= 指向一个加载本地检查点的函数,在你自己的机器上运行 .launch(),Workflow1111 画布就可以驱动你自己的 GPU。
每个输出都是一个 API
画布上的每个输出节点都会成为一个 REST 端点,无需手写任何路由。Workflow1111 暴露了其中九个:/image、/edited_image、/generated_prompt、/recovered_prompt、/detected_objects、/x_y_grid、/upscaled_local、/annotator_map 和 /png_info。
from gradio_client import Client

client = Client("ysharma/Workflow1111", oauth_token="hf_...")

image, params, hires = client.predict(
    "a red fox in a snowy pine forest",  # Prompt
    "",                                  # Negative prompt
    "Cinematic",                         # Style preset
    "enhance fine detail",               # Hires refine instruction
    api_name="/image",
)
同样的端点也是 MCP 工具。用 mcp_server=True(指南)启动后,每个输出节点都会成为 AI 助手可以调用的工具。把 Claude Code、Cursor 或任何 MCP 客户端指向服务器 URL:
{
  "mcpServers": {
    "workflow1111": {
      "url": "https://ysharma-workflow1111.hf.space/gradio_api/mcp/",
      "headers": { "X-HF-Token": "hf_..." }
    }
  }
}
现在,智能体可以把生成图像、反推提示词或运行检测作为更大任务中的步骤,无需任何胶水代码。每个调用方在 X-HF-Token 头中发送自己的令牌,因此 Space 本身不持有任何令牌。
与 ComfyUI 的关系
AUTOMATIC1111 给了我们功能清单,但 Gradio Workflow 真正会被拿来比较的工具是 ComfyUI,因为两者都是节点图。对于人们想要构建和发布的许多东西,gr.Workflow 覆盖了同样的范围。
- 节点可以是你并不拥有的硬件。它可以通过 Inference Providers 运行,调用 Hub 上的任意 Space 或任意 API,或从数据集中读取。这就是 Workflow1111 无需自己的 GPU 也能运行的原因。
- 每个输出都成为带类型的 REST 端点。这些端点由图自动生成。
- 访客可以以自己的身份运行工作流。开启 OAuth,分享公开 URL,任何人都可以登录并使用应用,无需安装任何东西。
- 在同一张画布上混合模型和模态。扩散模型、LLM、VLM、检测器和视频模型都可以成为同一个工作流的一部分。
- 需要定制?写个函数就行。自定义节点就是一个 Python 函数,所以 Python 能做的它都能做。
最终得到的是一条多模型管道:人们可以在浏览器中打开、登录、立即使用,也可以通过代码调用。
构建你自己的工作流
Workflow1111 有 73 个节点,但它最初只是这样:
import gradio as gr

def your_function(text: str) -> str:
    pass

gr.Workflow(bind=[your_function]).launch()
bind= 把你的函数变成节点,edges= 把它们连起来,.launch() 在浏览器中打开画布,方便你继续在那里编辑。准备好之后,gradio deploy 会把整个东西放到一个 Space 上。gr.Workflow 指南中有完整细节,包括 JSON schema 和所有算子类型。
如果你更想从一个已经能跑的东西开始,就打开 Workflow1111,点击 Duplicate,挑选十一条管道之一来改:删除节点、替换模型、重新接线。如果你想从更小的东西开始,上一篇文章里有五个工作流,每个大约一分钟就能跑起来。
无论你构建了什么,都欢迎发到 X 上并标记 @gradio。我们很乐意帮你扩散你的工作流。