思考中
摘要
在 FinanceBench 和 OfficeQA Pro 基准测试中,Mistral Agentic Search 在给出更准确搜索结果的同时,减少了轮次、token 用量和延迟。Agentic Search 是一个检索层,让 AI 系统能够在最复杂的文档内部进行导航、阅读和核实信息。可通过 Mistral Search Toolkit 和 Libraries 使用。

Mistral Agentic Search 让模型能够搜索并浏览组织内最复杂的数据和文档,帮助企业从 AI 系统中获得更好的结果。Agentic Search 引入了多步检索循环,用于在各个数据源中查找、查看并核实信息,无论这些信息存放在何处。Agentic Search 可通过 Mistral Search Toolkit 使用,也内置于 Studio 和 Vibe 中的 Libraries,它能为你带来:
- 支持敏感的领域专属数据。Mistral 可移植的开放工具让你在不突破云端或本地隔离边界的前提下,释放数据的价值。
- 更好的搜索结果。你的模型不再局限于检索到的片段,而是可以在长而密集的文档内部或跨多个数据源搜索和浏览数据。
- 复用现有索引。Agentic Search 基于你现有的搜索索引,使用五个工具:
search、open、navigate、read和grep。 - 更高的准确率。基于 FinanceBench,Agentic Search 在财务文件上的正确率提升至原来的 3 倍,从 26.7% 提高到 86%。在 OfficeQA Pro 基准测试中涉及大量表格的多文档问题上,我们测得 +45.6 个百分点的提升(从 6.3% 到 51.9%)。
- 更低的延迟和 token 用量。有针对性的导航使 Agentic Search 最多可将 p90 延迟降低 39.6%。更少的重复搜索使 token 消耗最多减少三分之一。
数据创造竞争优势
竞争优势建立在多年真实运营的积累之上——你的数据、你的流程和你的领域专长。专有知识对你的成功至关重要,同时高度机密,这意味着它存放在隔离边界、分段部署和自托管平台之内。这些知识沉淀在财务文件、法律合同、内部资料和政府记录中——传统搜索方法难以有效浏览这些又长又密的文档。
能够持续学习和改进的智能体可以帮助你不断放大竞争优势,但出于安全考虑,这些智能体往往与机密数据和专有知识相隔离。要让 AI 产生真正的影响,就需要把前沿的推理能力与能够安全触达最敏感材料的检索工具结合起来。
传统 RAG 的不足
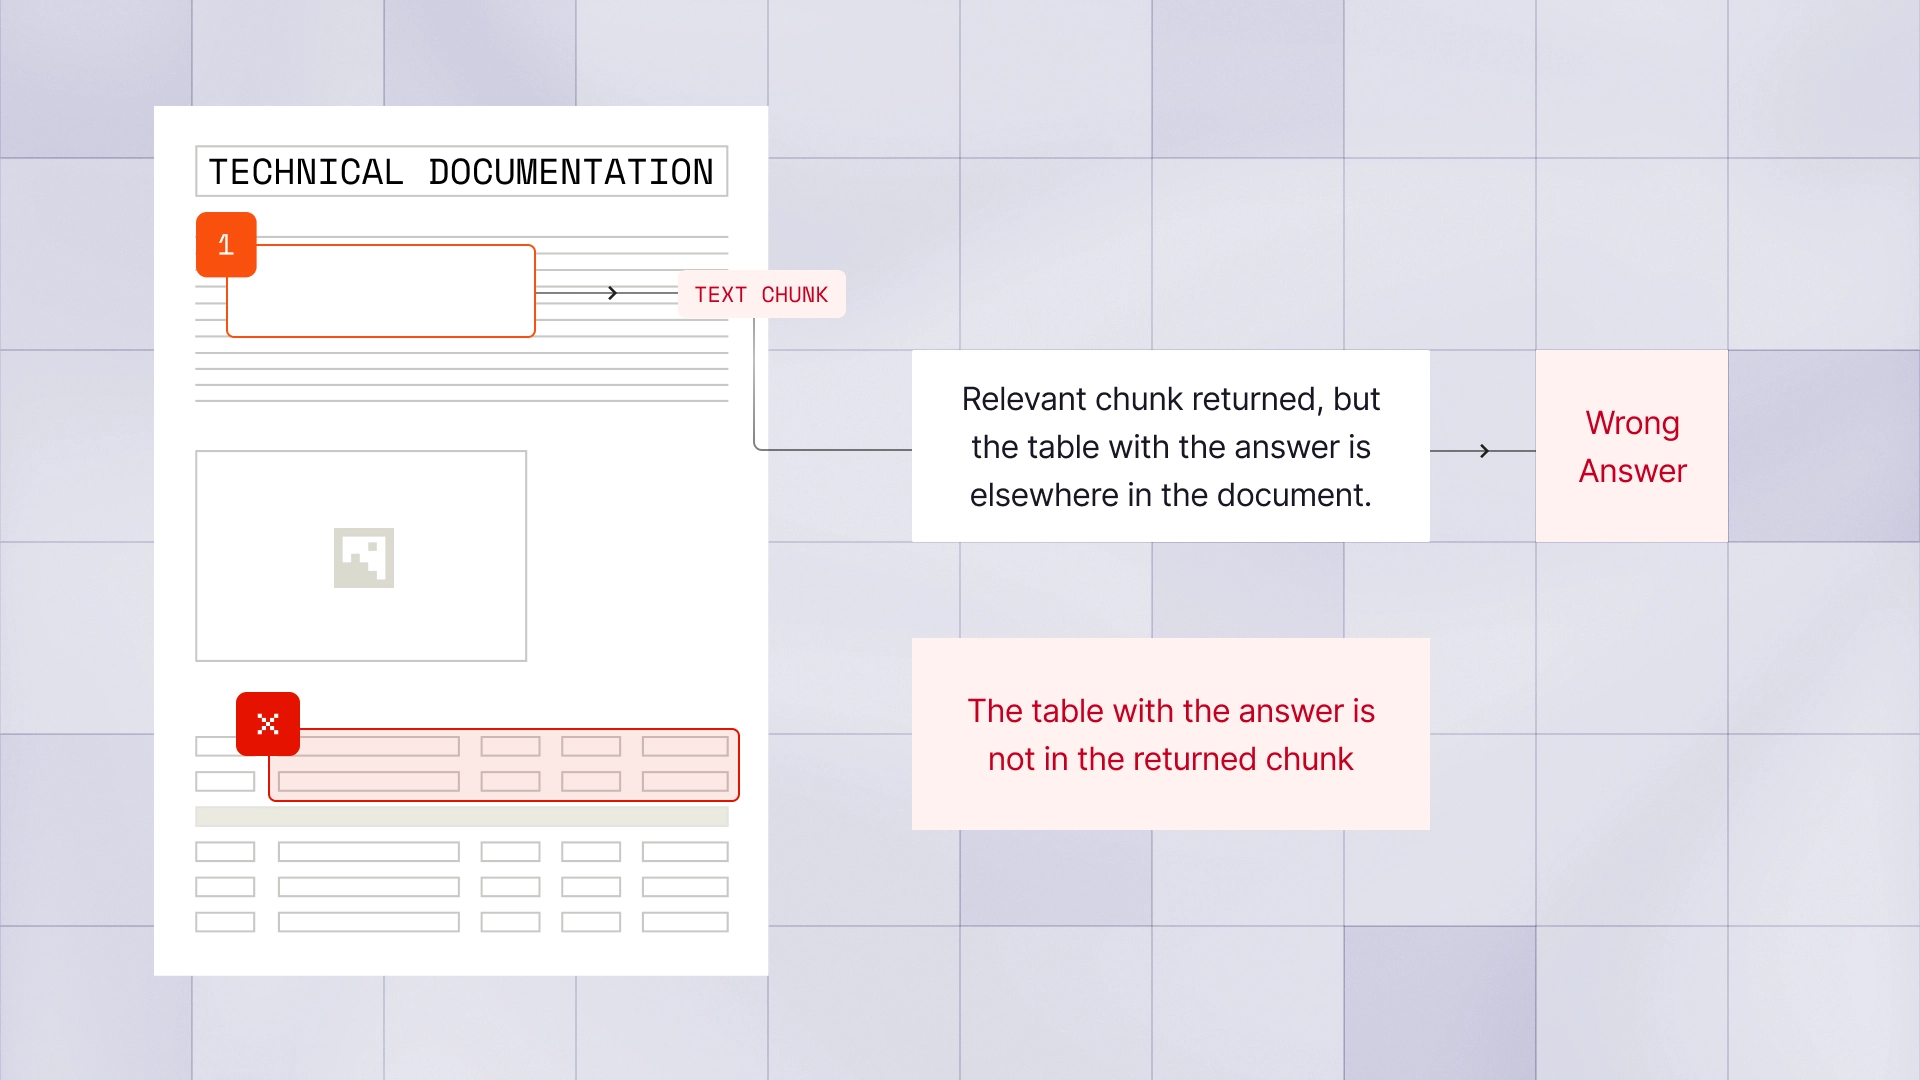
传统的一次性 RAG 检索一组固定的文本片段,让模型一次性作答。当答案出现在排名靠前的结果中时,这种方式有效,但当模型需要浏览一份长报告、追踪引用、比较多份文档或核实底层证据时,它就力不从心了。
在密集、复杂的数据和文档上,这一局限更为明显。回答一个问题所需的信息可能分散在多份文档中,或埋藏在某个表格、脚注或条款里。基于一次性 RAG 的搜索无法充分发挥前沿 AI 的能力,也无法提供可靠的答案,原因有三:
- 只有检索,没有推理:模型必须基于初次检索选出的片段作答,即使这些片段不完整或不相关。它无法判断自己需要另一份文档、另一个章节或更多上下文再作答,这限制了模型推理能力的发挥。
- 片段级的限制:关键数据往往存放在复杂的多模态文档中。当被问到“该公司第三季度的实际税率是多少?”时,索引可能找到正确的文档,却无法打开它、导航到表格、阅读周围的上下文或核实答案。
- 没有迭代:许多问题需要不止一轮检索才能得到正确答案。模型可能需要优化搜索、查看一份有希望的文档、追踪一个引用、比较多个来源、记录已看过的内容,并在最初的结果不足时尝试新的路径。一次性 RAG 没有办法采取这些后续步骤。
没有 Agentic Search(一次性检索)
仅使用 1953 年各个日历月份的报告值,美国国防及相关活动支出(以百万名义美元计)这些值的总和是多少?
轨迹 1 tool_call(仅搜索)
search("national defense expenditures monthly 1953") → 10 条结果:零散的月度公报(表 3),均按财政年度编排,只覆盖 1953 年的一部分。
我找到了 1953 年 1 月至 6 月的数据。但要算出答案,我还需要 1953 年 7 月至 12 月的月度数值。
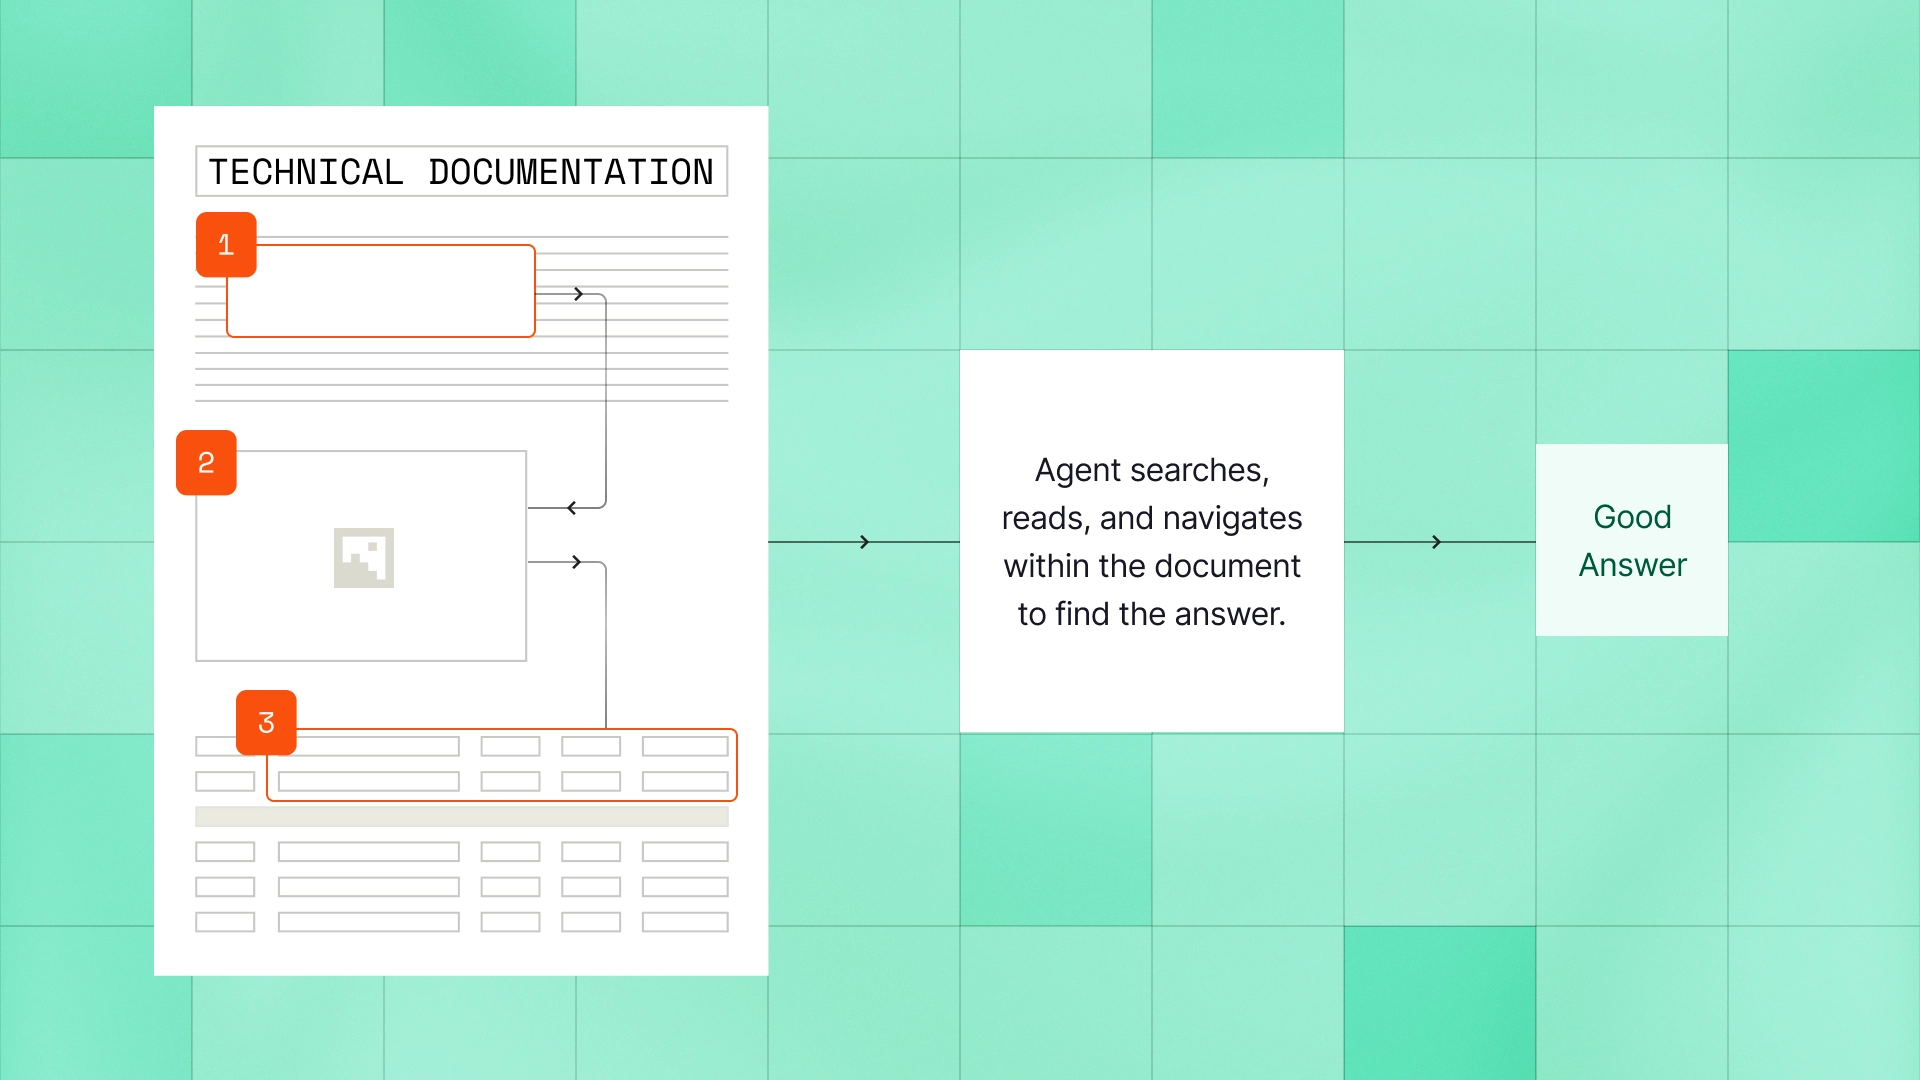
使用 Agentic Search
仅使用 1953 年各个日历月份的报告值,美国国防及相关活动支出(以百万名义美元计)这些值的总和是多少?
轨迹 3 次 tool_call(2 次搜索 → 读取)
search("national defense expenditures monthly 1953") → 按月公报(仅部分年份)
search("…1953 November December 1954 to date") → 找到 treasury_bulletin_1954_02.pdf第 15 页(表 3,涵盖 1953 年全部 12 个月)
read(treasury_bulletin_1954_02.pdf, p.15) → 取出完整的表 3
1953 年各月数值
表 3,单位:百万美元
| 1 月 | 2 月 | 3 月 | 4 月 | 5 月 | 6 月 | 7 月 | 8 月 | 9 月 | 10 月 | 11 月 | 12 月 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 3,632 | 3,501 | 3,789 | 3,891 | 3,746 | 4,056 | 3,890 | 3,519 | 3,787 | 3,647 | 3,540 | 3,465 |
总和 = 44,463。
Agentic Search 如何工作
Mistral Search Toolkit 提供开放模块,用于在云端或本地对关键而复杂的数据进行摄取、嵌入和索引。Agentic Search 在该索引之上,为模型提供五个类似常见文件系统操作的工具:
search利用现有索引在整个语料库中查找相关文档。open打开指定文档。navigate跳转到文档中的某个页面、章节或区域。read获取该位置的内容。grep在已打开的文档中查找某个模式。
模型不再只依据最初的 top-k 结果作答,而是可以查看自己找到的内容、优化搜索、打开相关文档、导航到具体章节,并在作答前阅读原始材料。索引负责找出可能的来源;Agentic Search 则决定在这些来源内部以及跨来源查看什么。
一次性 RAG
Agentic Search
这些工具不需要微调,也不需要针对特定模型的训练。随着模型的推理和工具使用能力不断提升,检索效果会随之提升,无需改动基础设施。这是一个关键特性:检索质量随模型能力而扩展,而不是被你的分块策略所封顶。
适合使用 Agentic Search 的场景
- 长文档。财报、合同、手册、技术规范和报告,答案可能出现在特定页面,或某个特定的表格、条款、图表或脚注中。
- 跨多个来源的问题。需要模型先从多份文档中查找、比较或核对证据,然后才能得出答案的研究。
- 必须核实的答案。财务数据、法律条款、监管引用和运营数据,其回答可以对应到某份文档中稳定、具体的位置。
- 表格和结构化文档。财务报表、政府记录和扫描版 PDF,其含义取决于行、列、页面位置或周围上下文,而不仅仅是叙述性文字。
索引式检索是合适起点的场景
- 直接查找。简短、干净的文档,答案很可能出现在最先检索到的片段中。
- 高并发搜索。只需返回相关段落、无需对其进行推理或导航的关键词或语义查找。
- 简单、可预测的问题。答案的可能来源和位置事先已知、额外的检索步骤不太可能改善结果的场景。
对这类搜索,一次性 RAG 通常就足够了。当问题要求模型超越最初的结果、深入调查原始材料时,再加上 Agentic Search。在这两种情况下,配置良好的索引仍然是合适的基础。
结果更相关,速度更快
我们在两项行业标准评测上对 Agentic Search 进行了基准测试,使用开箱即用的 Mistral Search Toolkit 技术栈:默认分块、默认排序、不做调优。这些结果是下限而非上限,也就是说,你可以通过针对具体用例的调优进一步提升结果质量。
在这些基准测试中,我们使用 Mistral Search Toolkit 测试了两个模型:Mistral Medium 3.5(MM 3.5)和 Z.ai GLM-5.2(GLM-5.2),分别展示较小模型(MM 3.5)和较大模型(GLM-5.2)的表现。
基准测试结果是一致的:智能体循环带来了实质性的质量提升,导航工具在提高准确率的同时减少了浪费的 token、轮次和延迟。我们在第一方和第三方模型上观察到相同的性能规律,这表明 Agentic Search 与模型无关,并且搜索质量应当会随新模型的出现而提升。
FinanceBench:368 份 SEC 文件,150 个问题
FinanceBench(Islam 等,2023)测试针对 368 份 SEC 文件(10-K / 10-Q / 8-K)的金融问答,平均每份约 147 页,总计约 53,900 页:篇幅长、表格多的财务文档。答案由经过人工标注校准的 LLM 评审打分。
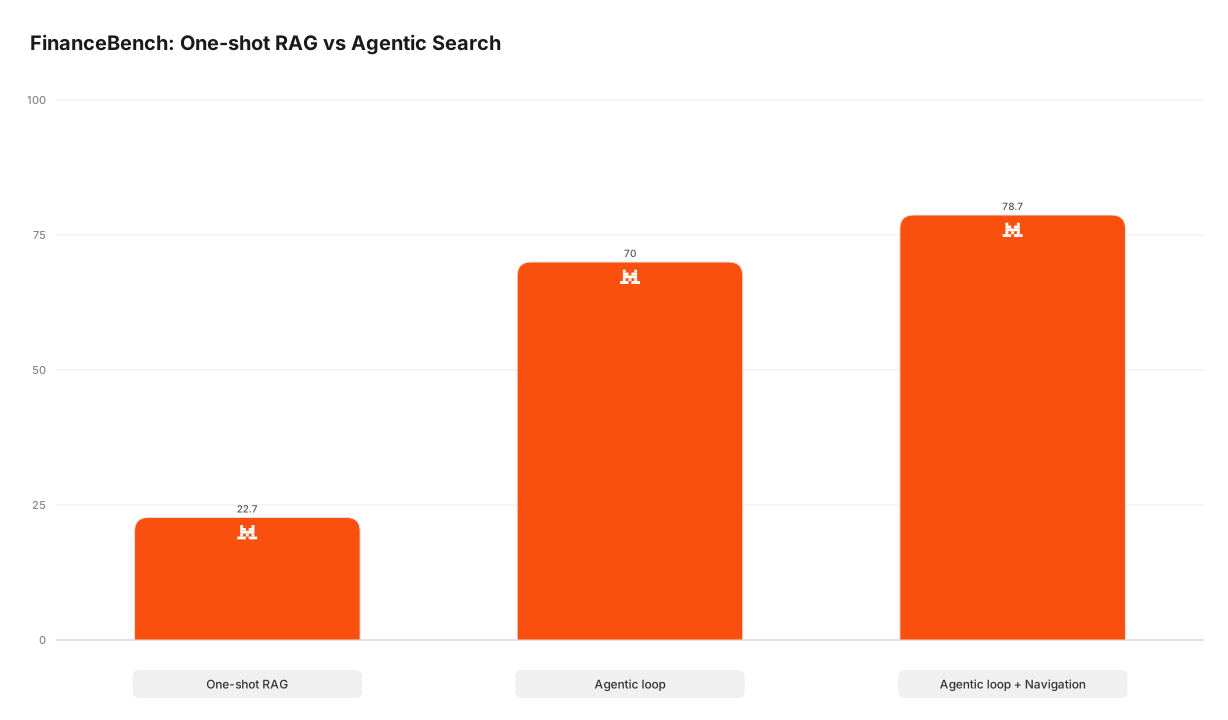
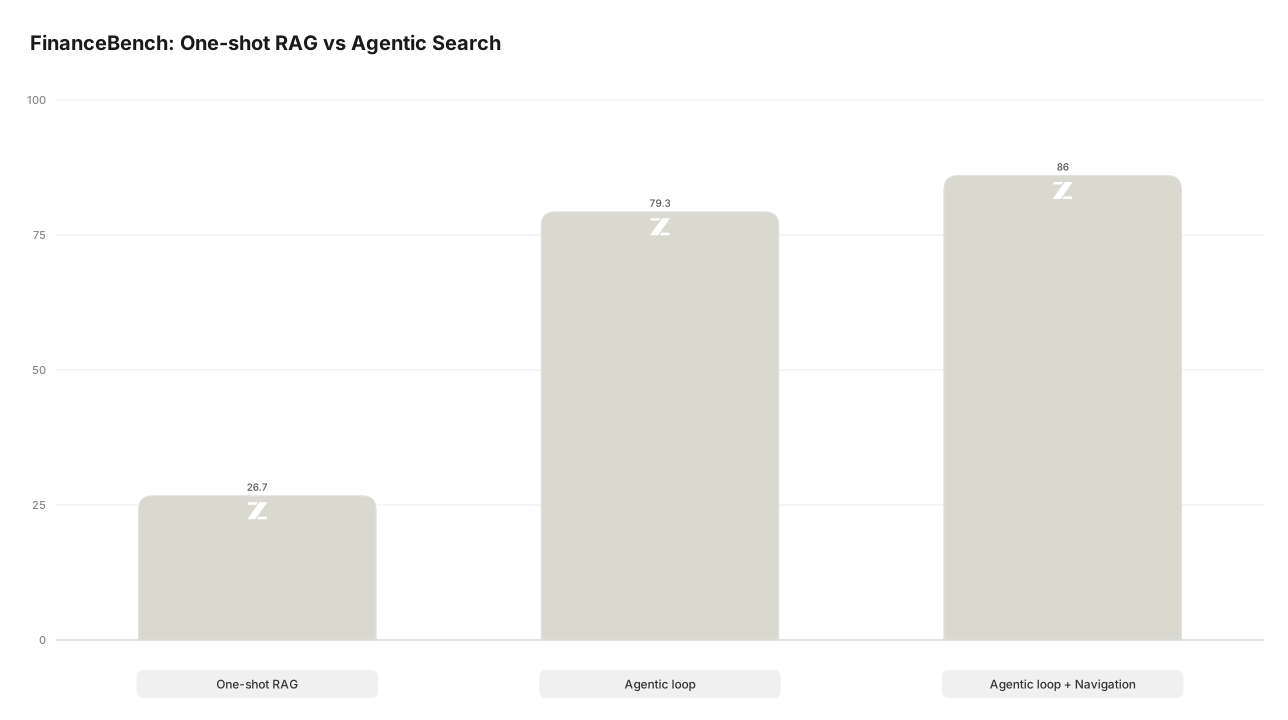
我们发现:
- 仅搜索的智能体循环是质量提升最大的杠杆。从一次性 RAG 转为仅搜索的循环,MM 3.5 的准确率提升 +47.3 个百分点,GLM-5.2 提升 +52.6 个百分点——两个模型都提升了约 3 倍。由于模型可以迭代搜索,它们能够从糟糕的初次结果中恢复、优化查询,并把索引当作一个主动使用的工具。
- 导航进一步提高准确率。加入 open、navigate、read 和 grep 之后,准确率再次提升(MM 3.5 为 +8.7 个百分点,GLM-5.2 为 +6.7 个百分点)。这意味着在复杂文档中,有针对性的深入搜索胜过反复的宽泛搜索。
- 更好的检索工具让 token 与性能效率同步提升。带导航的完整循环比仅搜索的循环答对更多问题,同时使用更少的 token(MM 3.5:token 用量 -23.9%,GLM-5.2:-33.7%)。这些检索工具并非额外开销——它们用精准的导航取代了浪费的搜索重试。
- 延迟在关键之处下降。在整个 FinanceBench 上,加入导航检索工具后延迟有所改善:p90 从 255 秒降至 154 秒,平均延迟从 108 秒降至 71 秒。总体而言,我们看到仅搜索的循环会进行重复的宽泛搜索,而导航则帮助模型更快地定位证据。
OfficeQA Pro:696 份美国财政部公报,133 个问题
OfficeQA Pro 是针对历史美国财政部公报的可验证数值型基准测试:语料库包含 696 份文档、约 89,000 页,均为扫描版、表格密集的政府财政类 PDF。我们报告 133 题“pro”子集的首轮结果。
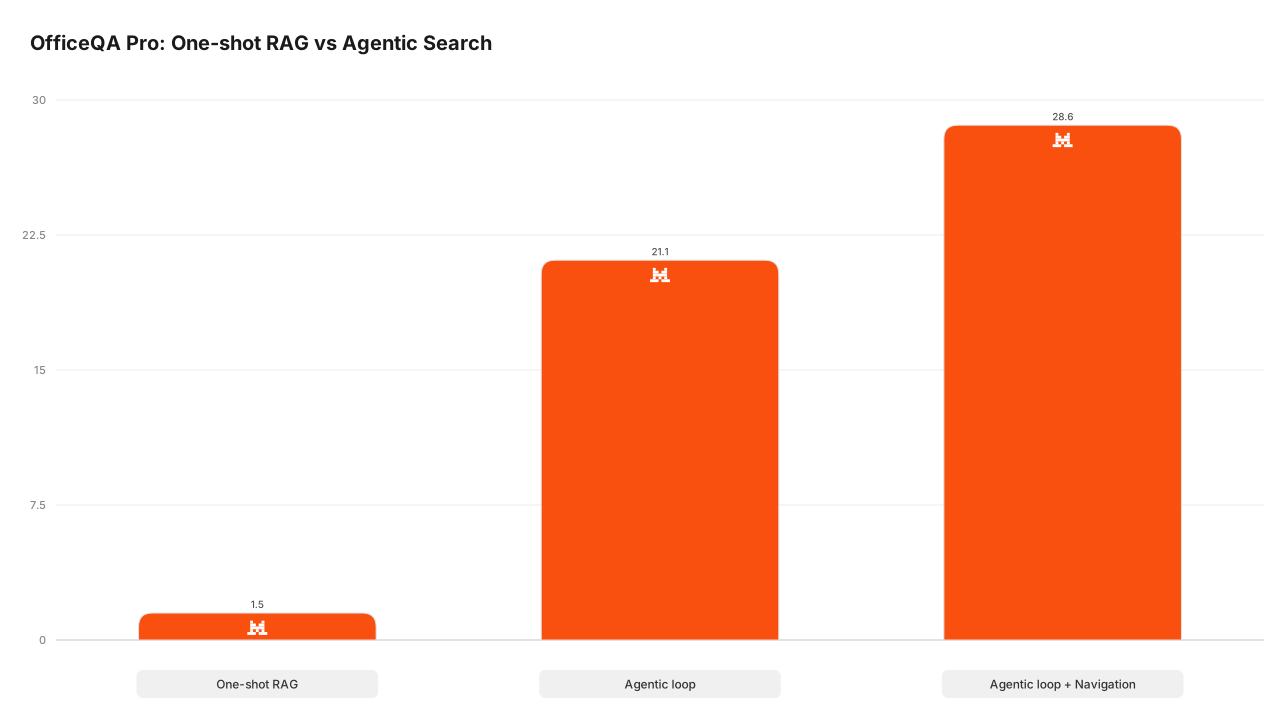
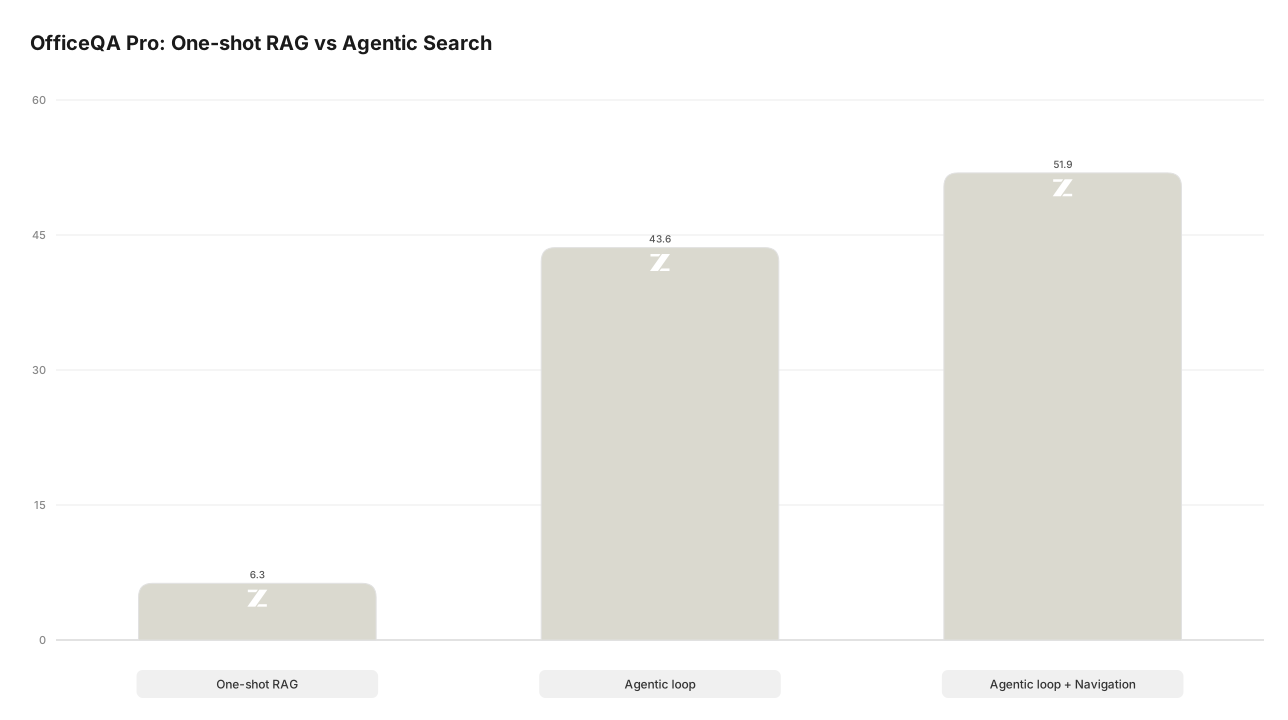
我们发现:
- 在难度更高、可验证的基准测试上,Agentic Search 以及智能体循环加导航都取得了成功。OfficeQA Pro 的答案为数值型,文档为扫描版 PDF,还需要深入的表格查找。即便如此,完整的智能体循环也相比一次性 RAG 大幅提升了准确率:GLM-5.2 达到 51.9%(+45.6 个百分点),MM 3.5 提升 +27.1 个百分点。
- 导航在提升质量的同时减少浪费。使用完整循环(智能体循环加导航)可将准确率最多提升 35.6%(MM 3.5 为 +7.5 个百分点;GLM-5.2 为 +8.3 个百分点,19.0%),同时降低 token 消耗。轮次最多减少 7.0%(MM 3.5;GLM-5.2 为 2.3%)。
- 基准测试越难,检索循环就越重要。OfficeQA Pro 围绕扫描版、表格密集文档中的数值型答案构建。一次性 RAG 几乎无从下手,而智能体循环让模型能够迭代搜索、查看证据,并带来显著的准确率提升。
- 工具栈对文档智能和搜索性能有重大影响。根据 Kimi 的研究,GLM-5.2 在 Claude Code 框架下的 OfficeQA Pro 得分为 41.4%,而在 Mistral 框架下为 51.9%——同一个底层模型,相差 +10.5 个百分点。
快速上手
请在文档中进一步了解 Agentic Search。无论是云端还是本地部署,你都可以通过以下任一方式开始:
- Mistral Search Toolkit。将 Agentic Search 集成到你自己的智能体、工作流和客户部署中。
- Libraries。在 Studio 和 Vibe 中开箱即用 Agentic Search,无需自己构建检索系统。
测试 Search Toolkit 最快的方式是使用 Search Starter App。它会用默认配置为你自己的语料库创建本地索引,因此你无需成为搜索专家就能试用 Agentic Search。当你准备好为自己的用例进行配置时,可以: